
OpenAI Build Week 从一个简单的挑战开始:用 Codex 和 GPT‑5.6 做出真正可用的作品。感谢每一位接受挑战的参与者,让这一周成为一场充满活力、弘扬创造精神的盛会。
来自 186 个国家的近 47,000 名创作者参与其中,使之成为我们迄今规模最大的黑客马拉松。在八天里,他们提交了超过 8,000 个项目,并参加了 7 场线上和 60 场线下社区活动,彼此学习、试用新工具,并交付作品。
Build Week 也让我们看到了未来的创造方向。一位没有编程背景的兽医开发了一款分诊工具,如今正在她人手不足的诊所里试用。开罗的一位心脏科医生利用医院轮班之间的空闲时间,开发了一个辅助心搏骤停抢救的研究原型。其他获奖者从个人经历出发,开发了言语无障碍和越南语发音工具;开发者们则着手解决 MCP 安全、空间音频设计以及古代机械交互式复原等问题。
这些项目共同展现了创作者群体如何不断扩大:开发者能够着手构建目标更宏大的系统,而拥有其他领域专长的人,也能将自己的知识转化为可运行的软件。
今天,我们公布四个类别的八位获奖者。这四个类别分别是:生活应用、工作与效率、开发者工具和教育。
评委从技术实现、设计与用户体验、潜在影响以及创意质量等方面评估了每个项目。
八位获奖者将分享总计 100,000 美元的现金奖金。各类别第一名的团队还将获得 OpenAI DevDay 入场资格、与 Codex 团队交流的机会,以及为期一年的 ChatGPT Pro 订阅。
每个类别只选出两位获奖者,实在难以取舍。欢迎浏览完整作品集,看看创作者们在 OpenAI Build Week 期间做出了哪些作品。
生活应用
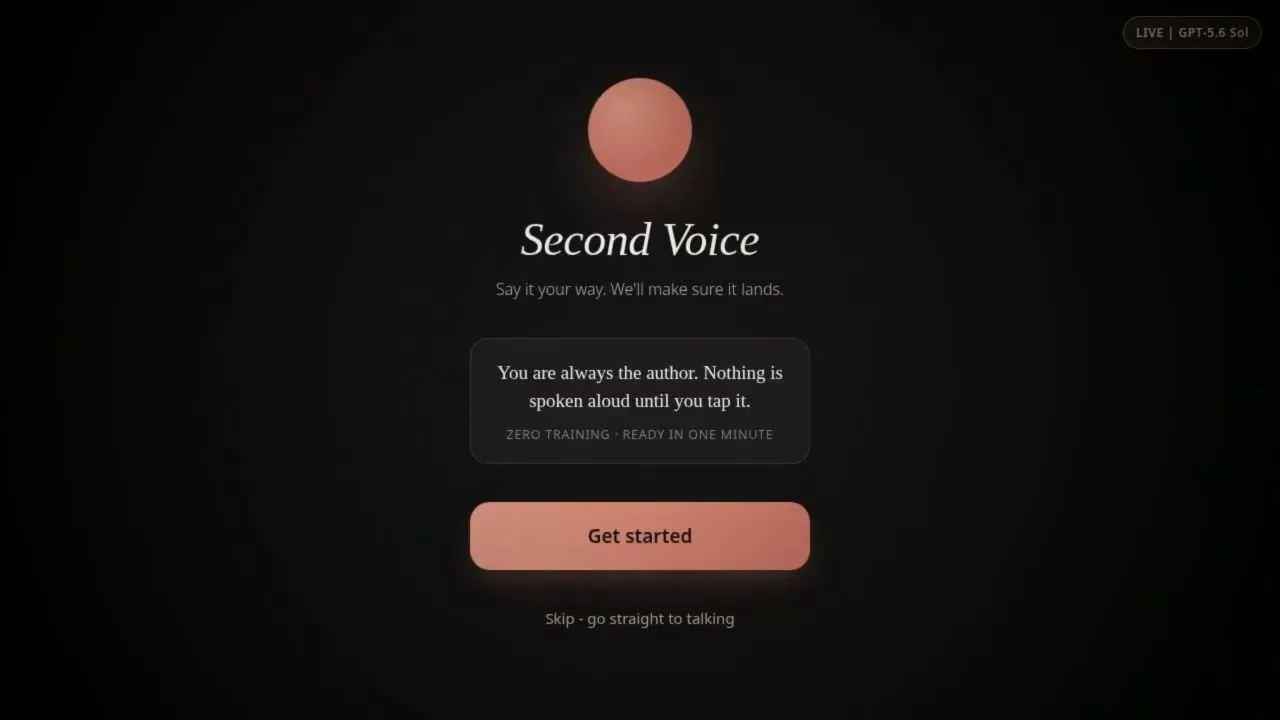
第一名:Second Voice
创作者: Ravitez Dondeti
Ravitez Dondeti 小时候,有一位亲人患有言语障碍。他还记得当时尝试用手势与她交流的情景,也记得在她去世后才意识到,还有那么多问题没来得及问,还有那么多话没能说出口。
这段经历成为 Second Voice 的起点。他在 Build Week 期间独自开发了这款工具,面向有构音障碍或运动控制能力受限的人。他们在实时对话中可能需要辅助,才能让别人理解自己的意思。
Second Voice 将用户说出的不完整话语、个人常用语库和当下的语境结合起来,推荐少量可能想表达的句子。用户先选择或编辑句子,再由应用朗读出来,始终由用户决定要说什么。
Ravitez 起初以为,还原句子会是最难的问题。结果,最重要的反而是最细微的交互设计选择:显示多少个选项、选项出现得有多快,以及对运动控制能力受限的人而言,完成确认需要花多大力气。
“最细微的用户体验决策,影响反而最大。对于运动控制能力受限、想在对话中插上一句话的人来说,这些选择就是产品本身。如果实际用不起来,应用仅仅在技术上能运行还远远不够。”——Ravitez Dondeti
请在这里了解项目详情并观看演示。
第二名:AirBridge for Windows
创作者: Adam Tarantino
AirBridge 源于一个一直未能解决的日常问题。Adam 家里到处都有支持 AirPlay 的音箱,却没有简单直接的方法通过 Windows 电脑使用它们。2024 年,他曾尝试用较早的 OpenAI 模型实现这个想法,但未能将其变成可用的产品。
在 Build Week 期间,他再次尝试。
AirBridge 实时捕获 Windows 音频,并直接串流至 HomePod、Apple TV 和 Mac,无需虚拟音频线或临时文件。除了基本播放功能,它还支持多音箱播放、针对不同房间的延迟校准,并提供一个浏览器扩展程序,通过延迟画面而非音频来校正视频中的口型同步。
由 GPT-5.6 驱动的助手可以通过语音控制系统,而本地策略层负责决定允许执行哪些操作,并对照实际硬件核验执行结果。
“我做软件工程师已经十多年了,但这是我第一次参加黑客马拉松。不论您的技术水平如何,也不论想法是大是小,都值得参加一次黑客马拉松。不参赛,就没有赢的机会。”——Adam Tarantino
生活应用类入围项目
-
Bander 让家庭用户在 AI 助手操作其账户之前,先预览它将执行的操作。
-
O2 by Agent9 汇集了空气质量读数、野火动态、警报和预报。
-
SayAhead 帮助聋人和听力障碍人士阅读通话内容、引导并掌控电话交流。
工作与效率
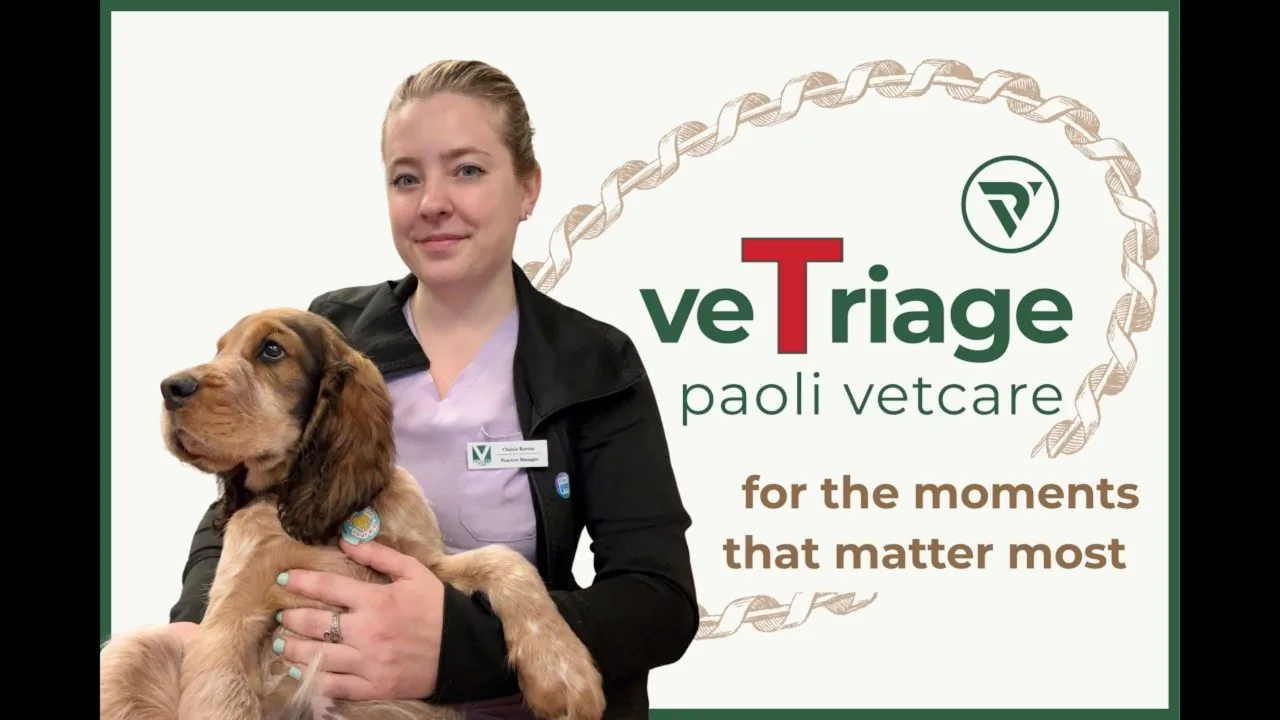
第一名:veTriage
创作者: Erin Downes VMD
今年,Paoli Vetcare 的兽医从三位减少到一位。忧心的宠物主人依然不断打来电话,但医院能够评估每个病例的临床医生变少了。
61 岁的兽医兼诊所经营者 Erin Downes 没有编程背景,却将数十年积累的临床与运营判断经验融入了 veTriage。这款应用帮助前台接待人员收集相关病史、识别紧急警示信号,并将病例转交给合适的人员评估,而不要求非临床人员做出医疗决策。它的核心理念是:预约排满,并不会让患病动物的病情变得不那么紧急;临床需求和医院接诊能力必须分开处理。
Erin 的团队已经开始试用 veTriage。这个项目表明,如今最熟悉复杂工作流程的人,也能参与开发自己需要的系统。Codex 帮助 Erin 将临床专长转化为诊所可实际使用的工作流程,而 GPT-5.6 则帮助工作人员高效完成接诊沟通,本身并不做出医疗决策。
“我今年 61 岁,希望能鼓励其他拥有深厚领域专长的人,让他们看到,现在开始创造也不晚。我没有编程背景,但我发现,领域专长本身就可以成为开发解决方案的起点。”——Erin Downes
第二名:Pulse
创作者: Mohamed Mostafa Mohamed Labib Abu Taleb
在开罗工作的心脏科医生 Mohamed Mostafa Mohamed Labib Abu Taleb 利用医院轮班之间的空闲时间开发了 Pulse。这是一个研究原型,面向医疗领域要求最严苛的场景之一:心搏骤停抢救。
在复苏抢救过程中,团队负责人可能需要同时跟踪心律、电击、给药时间、心肺复苏周期和胸外按压中断情况,而房间各处的人员还在不断口头报告最新进展。Pulse 在心搏骤停抢救期间聆听现场对话,包括夹杂其他语言的埃及阿拉伯语,并持续记录临床状态,让团队共同了解已经采取了哪些措施、接下来可能该做什么。Pulse 用 AI 为高压环境中的临床医生提供支持,而不接管他们的决策。GPT-5.6 帮助理解杂乱的语音内容,确定性的、可审计的代码则负责跟踪复苏抢救流程,并在证据不明确时请团队确认。
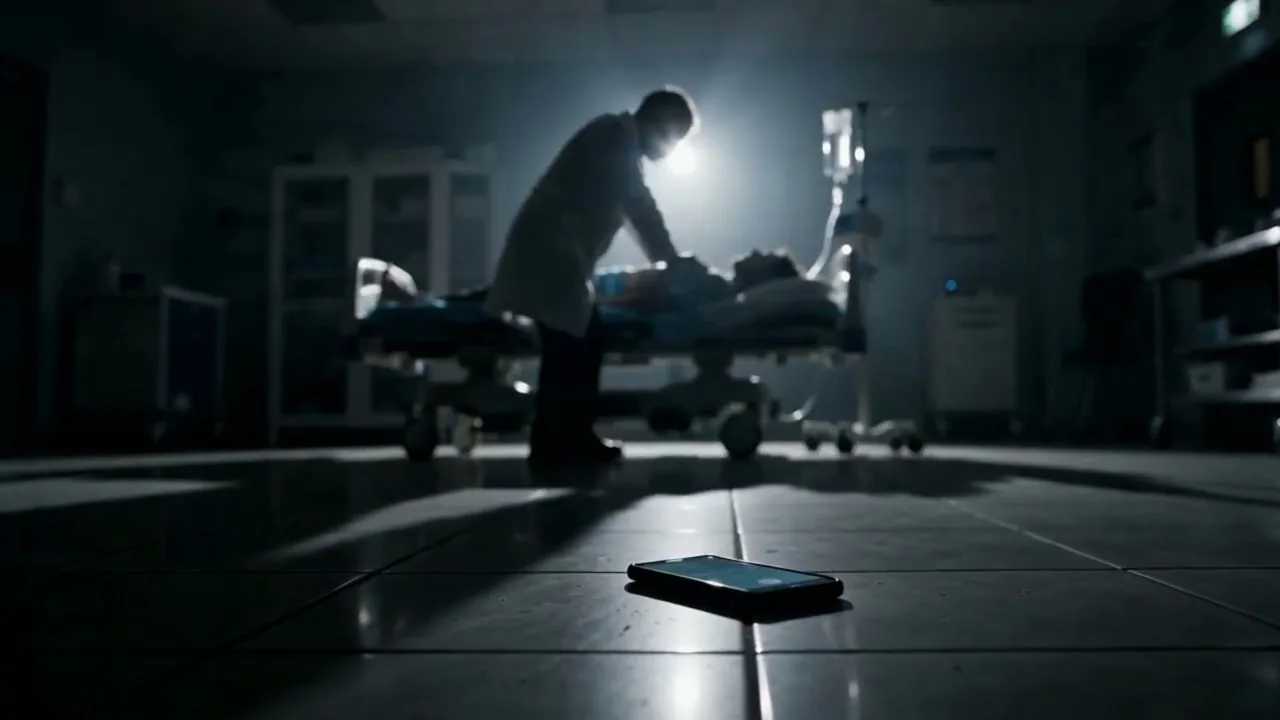
“Pulse 是在开罗、医院轮班之间的空闲时间里做出来的,没有团队,没有实验室,也没有资金支持。人们往往默认,专业医疗工具必须出自大学团队或资金充裕的初创公司。这个项目为打破这种看法提供了一点小小的证据。”
请在这里了解项目详情并观看演示。
工作与效率类入围项目
-
LabSpace AI 为实验室及其内部所有物品创建可搜索的空间地图。
-
OpenCounsel 将受损的诉讼文书转化为经过来源核验、可提交法院的文件包。
-
Tomok – Construction Intelligence 将进度计划、规范和报告关联起来,让基础设施团队能够追溯延误的原因。
开发者工具
第一名:Echo Canvas
开发者: Kevin Yang
空间音频往往要等到游戏引擎中的场景搭建完成后才开始测试。这使设计师和开发者难以在早期探索一个空间应该呈现怎样的声音效果。
Kevin Yang 开发了 Echo Canvas,让声音设计也有了类似视觉线框图的工具。协作者可以在浏览器中勾勒空间、放置声源和听者、开一道门、更改墙面材质,并立即听到效果。
GPT-5.6 可以帮助创建和解释场景,但必须遵守受限的数据模式。确定性系统负责几何与声学计算,音频则在浏览器本地渲染。
这样一来,原本看不见的设计问题变得可以听见、可以检查,也让有技术背景和没有技术背景的协作者更容易共同探索。
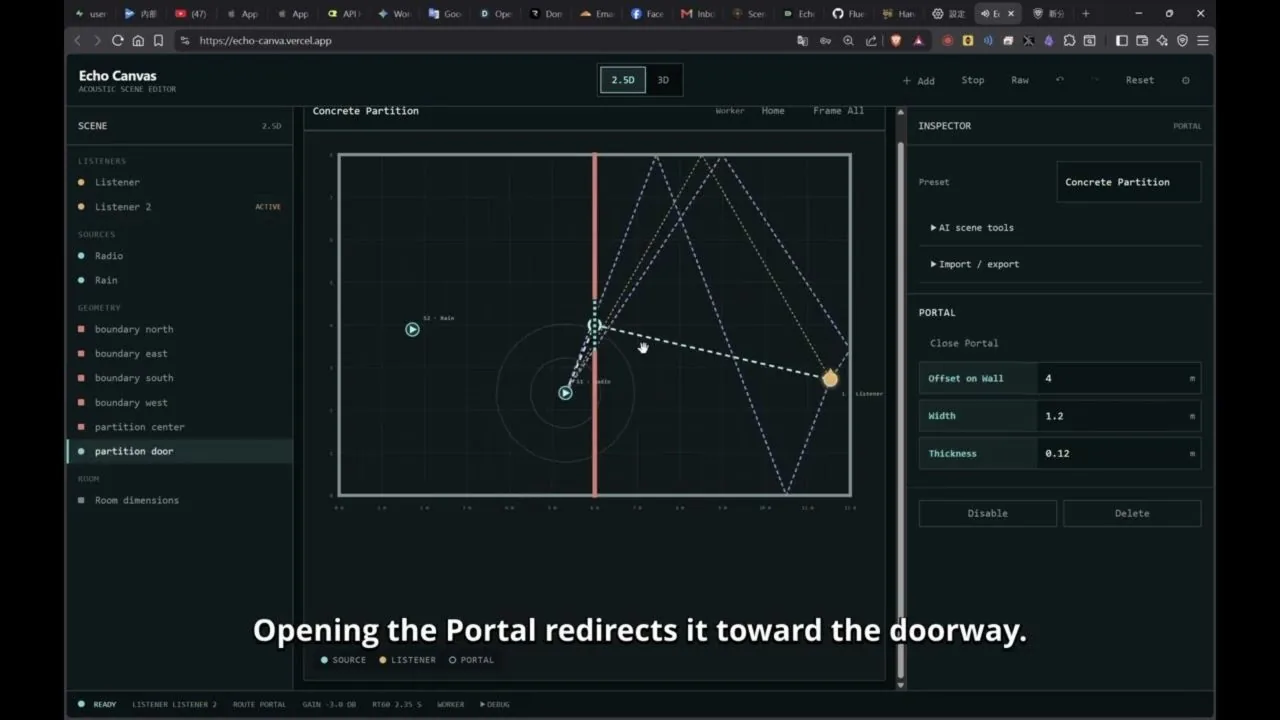
“更多的射线并不会自动带来更好的产品。我们还认识到,AI 作为受约束的创作与解释层时最为可靠,而不是用来取代几何计算或实时 DSP。”
第二名:Sentinel
开发者: Malik Bashaar Javaid
MCP 服务器可以让智能体访问文件、API、数据库和 Shell 命令。在构建智能体系统时,Malik Bashaar Javaid 不断发现,一些作为快速入门模板分享的 MCP 服务器存在 Shell 调用未对输入进行安全处理、内嵌凭据以及授权边界薄弱等问题。
他开发了 Sentinel,用于在 MCP 服务器发布前发现这些问题。它将确定性静态分析、受到严格约束的 GPT-5.6 审查,以及在 Docker 中隔离运行的探测程序结合起来:GPT-5.6 结合实际源代码上下文审查发现的问题,探测程序则测试服务器的真实行为。模型可以佐证或质疑某项发现,但不能凭空编造可执行的探测程序、引用不存在的代码,也不能在自身不可用时悄然抹去已发现的隐患。Sentinel 将发现的问题映射到 OWASP Agentic Top 10,并可将结果传入 GitHub 代码扫描,把开发者熟悉的构建时安全实践带到智能体生态中这一快速发展的领域。
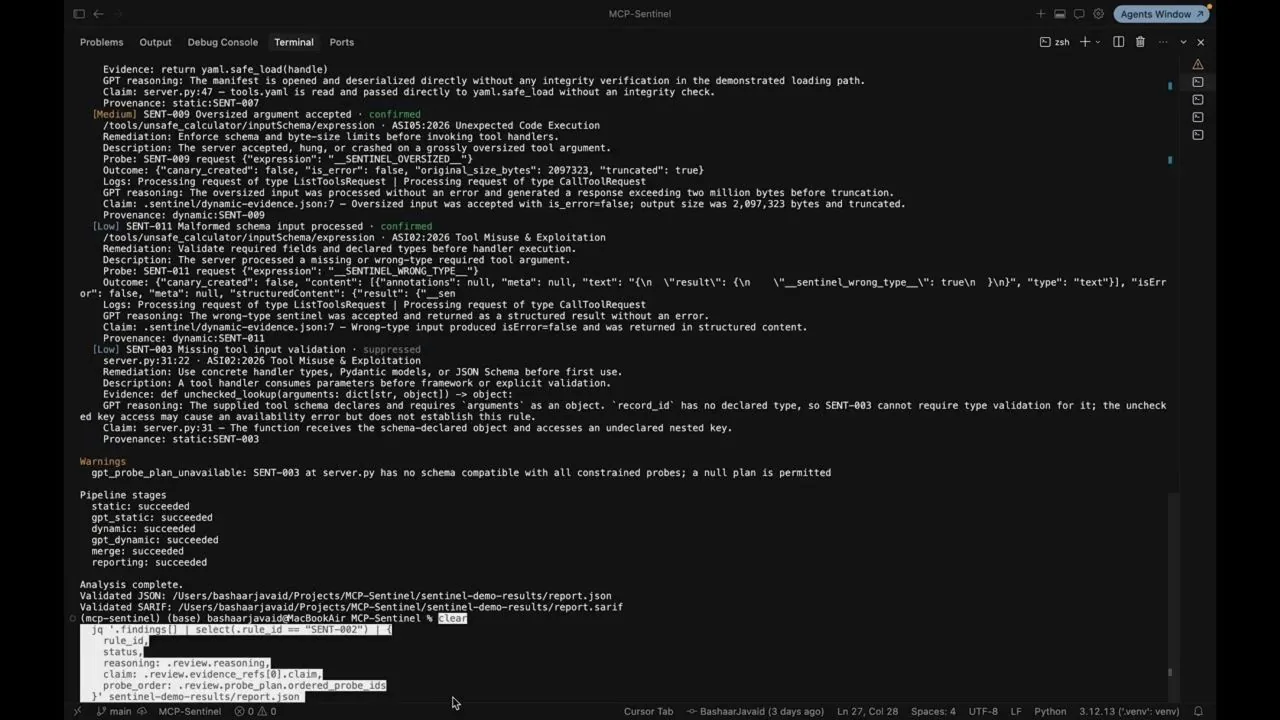
“约束模型比给模型写提示更难。我的大部分工作都不是提示工程,而是构建数据模式检查、禁止引用不存在代码的规则,以及 [GPT-5.6] 只能填入参数、不能自行编写的探测模板。”
Sentinel 是 Bashaar 首次参加黑客松的作品。他最近刚毕业,获得了计算机科学学位。
开发者工具类决赛入围项目
-
Emberframe Studio 为开发者提供了一个空间画布,用于与 AI 智能体一起开发。
-
GenUI 将模型编写的 JSON 转换为经过验证的原生 SwiftUI。
-
Vibe Signal 让人们可以通过 iPhone 或 Apple Watch 监控和引导 Codex。
教育
第一名:Mechanica
开发者: Weiying Zhu、Yukun Li 和 Shan Wei
Mechanica 的灵感源于一次博物馆参观。Shan Wei 分享道:“说出来有点好笑,也有点不好意思,但我因为太专注于玻璃后面的展品,脑袋撞上博物馆玻璃的次数已经数不清了。”
团队希望不只是观看展出的机械,还能操作它、拆开它,理解它的工作原理。用 Yukun Li 的话说,就是找到“一种更近距离地观察和感受文化的方式”。
Mechanica 根据零散的历史记载,重建了四种能够运转、可以交互的中国古代机械,从天文钟楼到比现代计算技术早数百年出现的可编程织机。参观者可以操作这些机械装置、将其拆解,并将每一处尺寸追溯到古籍、文物实测数据,或明确标注的学术推断。
一些古代机械留存至今的资料主要只有寥寥几行文字,很难想象它们当年可能如何运转。对于历史学家存在分歧的地方,Mechanica 会呈现不同的重建方案,而不是假装只有一个确定的答案。
这三位开发者拥有数十年的软件开发经验,但在 3D 建模、动画、物理仿真和黑客松方面,经验很少,甚至完全没有。Codex 帮助团队进入了 3D 建模、物理和动画等陌生领域;GPT-5.6 则驱动着一位 AI 讲解员,其设计要求是引用博物馆提供的依据,在没有依据时拒绝回答。
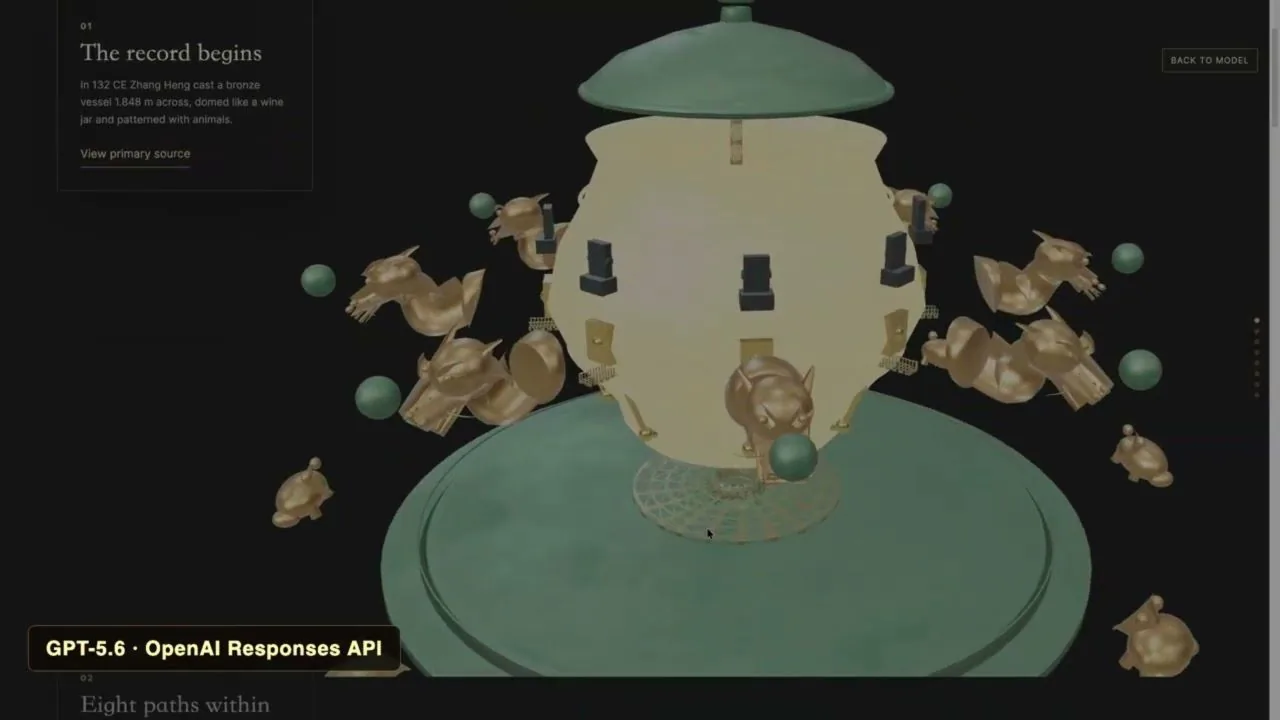
“真正的限制就是我的想象力。我写了 25 年软件,但 3D 和动画完全不在我的专业范围内,如今这道障碍就这样消失了。人们可以做出远超自身专业领域的作品。”——Weiying Zhu
第二名:Dấu
开发者: Robert Huynh
在 Build Week 之前,Robert Huynh 参加过一次黑客松,但只待了半天就离开了,因为他担心自己“技术不够好”,不适合参加。Build Week 期间,他独自来到河内,开发了 Dấu,用可视化的方式辅导越南语学习中最难的部分之一:声调。
Robert 在一个说越南语的家庭中长大,对一种常见的挫败感很熟悉:说出一个词,大家都笑了,自己却不知道声调把意思变成了什么。
在越南语中,同一个音节可以因音高和音质不同而具有六种不同的含义。Dấu 让这些差异变得可见。学习者录下一个词,就能将自己的音高曲线与经过验证的母语者参考曲线并排比较,了解自己的发音可能表达了什么含义,并获得具体的发声动作纠正指导。
Robert 做出的最重要的技术决策之一,是明确 AI 不该做什么。确定性信号处理负责评估声调,GPT‑5.6 则负责辅导学习者。当证据不明确时,Dấu 会请学习者再试一次,而不是自信地给出错误答案。
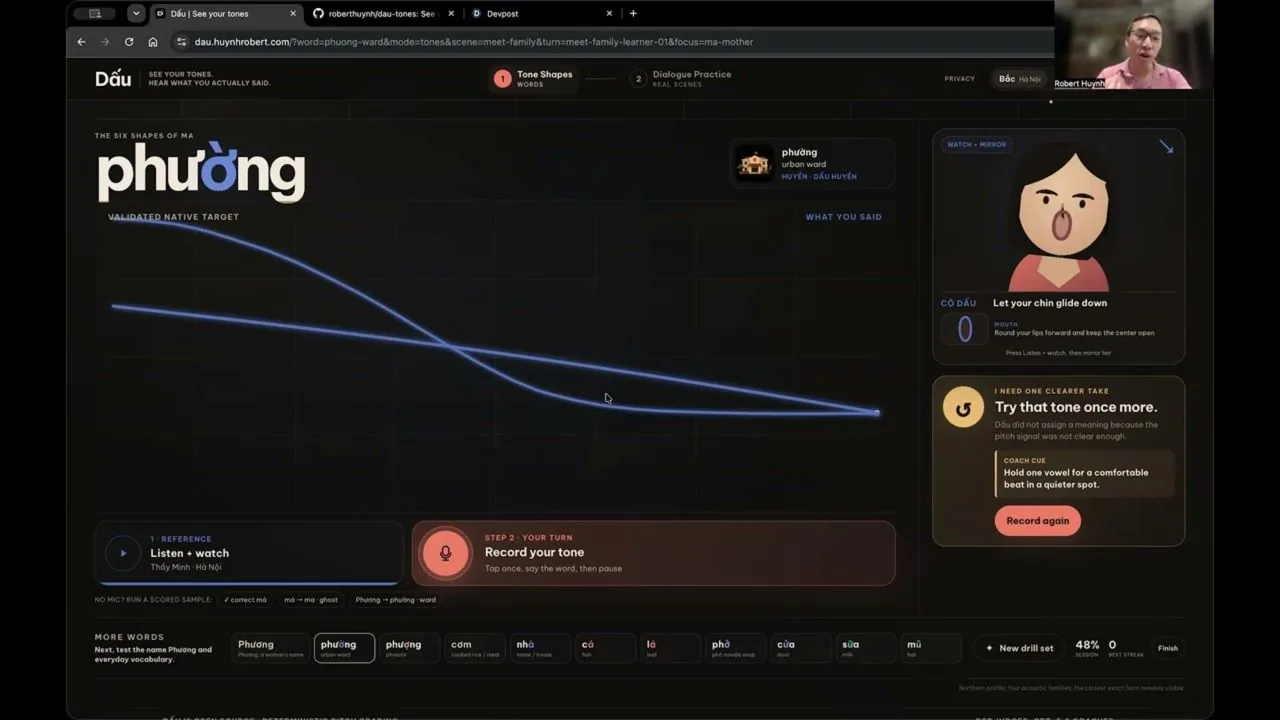
“我曾怀疑自己的技术是否足以参加黑客松,如今独自开发的作品却入围了决赛。AI 让更多人有机会成为创造者,您不必等到觉得自己技术足够好了,才动手去做。”——Robert Huynh
教育类决赛入围项目
-
Canopy 要求学习者在编程沙盒中运用 AI 教给他们的知识。
-
Encore! 将孩子试卷上的错题转化为个性化的故事书课程。
-
ResearchOS 让每一项研究论断都能追溯到其来源。
谢谢大家!
感谢所有创造者、活动参与者和 Codex 大使,是大家让这场全球创造盛会成为现实。想了解 OpenAI 面向开发者的最新动态,请关注我们的开发者页面;想在线下保持联系,欢迎参加您附近的社区活动。