通过 WebRTC 或 WebSocket 连接到 Realtime API 后,您就可以调用实时模型(例如 gpt-realtime-2.1)进行语音到语音对话。您需要发送客户端事件来发起操作,并监听服务器事件,以便在 Realtime API 执行操作后作出相应处理。
本指南介绍实时会话的状态,以及使用音频和文本生成、图像输入、函数调用等模型能力时需要收发哪些事件。
如果您无需与模型对话,也不需要模型作出回应,可以使用 Realtime API 的转录模式。
实时会话是模型与已连接的客户端之间有状态的交互。会话包含以下主要组成部分:
- 会话对象控制交互参数,包括使用哪个模型、生成语音时使用哪种音色,以及其他配置。
- 对话记录当前会话中的用户输入项和模型生成的输出项。
- 响应是模型生成的音频或文本项,会添加到对话中。
输入音频缓冲区与 WebSocket
如果使用 WebRTC,WebRTC API 会协助完成向模型发送音频和接收模型音频所需的大部分媒体处理工作。
如果通过 WebSocket 传输音频,您需要手动操作输入音频缓冲区,通过 JSON 事件将 Base64 编码的音频发送到服务器。
这些组成部分共同构成一个实时会话。您可以使用客户端事件更新会话状态,并监听服务器事件以响应会话中的状态变化。
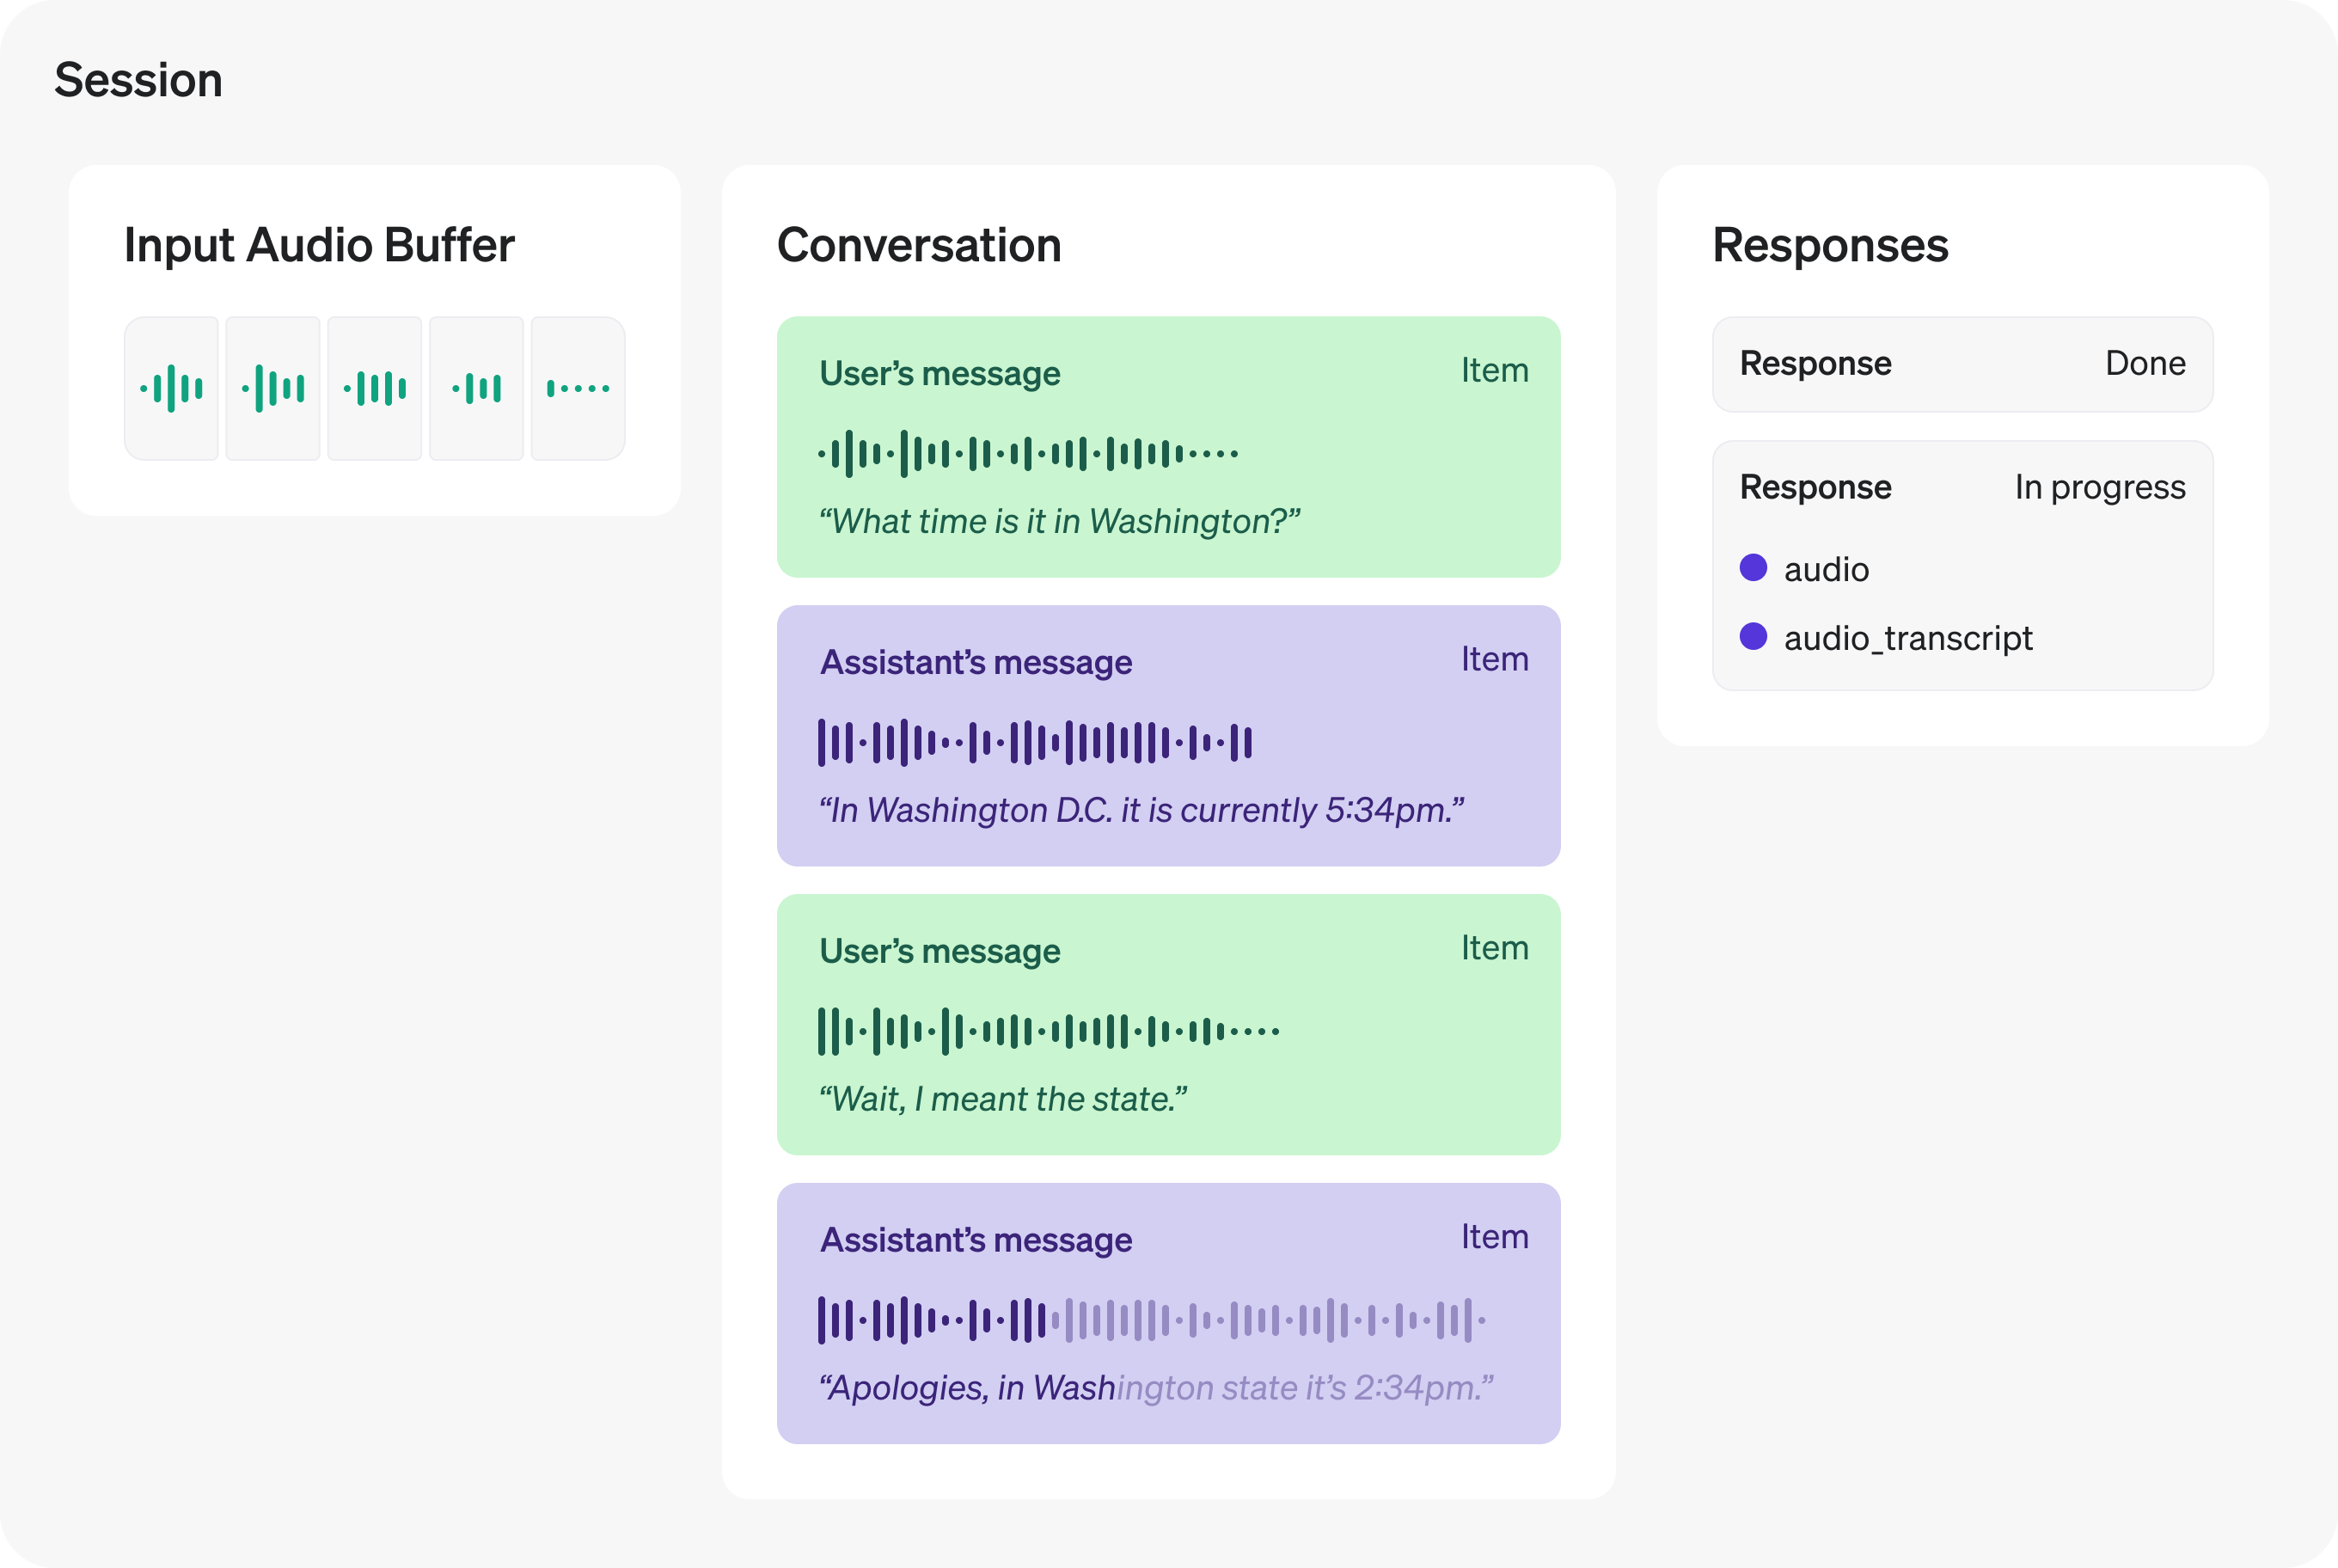
通过 WebRTC 或 WebSocket 发起会话后,服务器会发送 session.created 事件,表示会话已就绪。在客户端,您可以使用 session.update 事件更新当前会话的配置。大多数会话属性都可以随时更新,但模型用于输出音频的 voice 有一个限制:一旦模型在本次会话中以音频作出过响应,就无法再更改音色。实时会话最长可持续 60 分钟。
以下示例使用 session.update 客户端事件更新会话。要了解如何通过相应通道发送客户端事件,请参阅 WebRTC 或 WebSocket 指南。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41const event = {
  type: "session.update",
  session: {
    type: "realtime",
    model: "gpt-realtime-2.1",
    // Lock the output to audio (set to ["text"] if you want text without audio)
    output_modalities: ["audio"],
    audio: {
      input: {
        format: {
          type: "audio/pcm",
          rate: 24000,
        },
        turn_detection: {
          type: "semantic_vad",
        },
      },
      output: {
        format: {
          type: "audio/pcm",
          rate: 24000,
        },
        voice: "marin",
      },
    },
    // Use a server-stored prompt by ID. Optionally pin a version and pass variables.
    prompt: {
      id: "pmpt_123", // your stored prompt ID
      version: "89", // optional: pin a specific version
      variables: {
        city: "Paris", // example variable used by your prompt
      },
    },
    // You can still set direct session fields; these override prompt fields if they overlap:
    instructions:
      "Speak clearly and briefly. Confirm understanding before taking actions.",
  },
};

// WebRTC data channel and WebSocket both have .send()
dataChannel.send(JSON.stringify(event));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35event = {
    "type": "session.update",
    "session": {
        "type": "realtime",
        "model": "gpt-realtime-2.1",
        # Choose ["audio"] or ["text"]; do not combine them.
        "output_modalities": ["audio"],
        "audio": {
            "input": {
                "format": {
                    "type": "audio/pcm",
                    "rate": 24000,
                },
                "turn_detection": {"type": "semantic_vad"},
            },
            "output": {
                "format": {
                    "type": "audio/pcmu",
                },
                "voice": "marin",
            },
        },
        # Use a server-stored prompt by ID. Optionally pin a version and pass variables.
        "prompt": {
            "id": "pmpt_123",  # Your stored prompt ID.
            "version": "89",  # Optional: pin a specific version.
            "variables": {
                "city": "Paris",  # Example variable used by your prompt.
            },
        },
        # Direct session fields override prompt fields if they overlap.
        "instructions": "Speak clearly and briefly. Confirm understanding before taking actions.",
    },
}
ws.send(json.dumps(event))
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40// Replace pmpt_123 and 89 with an existing saved prompt and version.
// The saved prompt must define the city variable.
if err := conn.Send(ctx, realtime.RealtimeClientEventParamOfSessionUpdate(realtime.RealtimeSessionCreateRequestParam{
	Model: "gpt-realtime-2.1",
	Prompt: responses.ResponsePromptParam{
		ID:      "pmpt_123",
		Version: openai.String("89"),
		Variables: map[string]responses.ResponsePromptVariableUnionParam{
			"city": {
				OfString: openai.String("Paris"),
			},
		},
	},
	OutputModalities: []string{"audio"},
	Instructions:     openai.String("Speak clearly and briefly. Confirm before taking action."),
	Audio: realtime.RealtimeAudioConfigParam{
		Input: realtime.RealtimeAudioConfigInputParam{
			Format: realtime.RealtimeAudioFormatsUnionParam{
				OfAudioPCM: &realtime.RealtimeAudioFormatsAudioPCMParam{
					Rate: 24000,
				},
			},
			TurnDetection: realtime.RealtimeAudioInputTurnDetectionUnionParam{
				OfSemanticVad: &realtime.RealtimeAudioInputTurnDetectionSemanticVadParam{},
			},
		},
		Output: realtime.RealtimeAudioConfigOutputParam{
			Format: realtime.RealtimeAudioFormatsUnionParam{
				OfAudioPCM: &realtime.RealtimeAudioFormatsAudioPCMParam{
					Rate: 24000,
				},
			},
			Voice: realtime.RealtimeAudioConfigOutputVoiceUnionParam{
				OfString: openai.String("marin"),
			},
		},
	},
})); err != nil {
	return err
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48import com.openai.client.okhttp.OkHttpClient;
import com.openai.core.ClientOptions;
import com.openai.core.JsonValue;
import com.openai.helpers.RealtimeConnection;
import com.openai.helpers.RealtimeWebSocketOptions;
import com.openai.models.realtime.*;

// Replace pmpt_123 with your stored prompt ID.
var pcm =
    RealtimeAudioFormats.AudioPcm.builder()
        .type(RealtimeAudioFormats.AudioPcm.Type.AUDIO_PCM)
        .rate(RealtimeAudioFormats.AudioPcm.Rate._24000)
        .build();
connection.send(
    RealtimeClientEvent.ofSessionUpdate(
        SessionUpdateEvent.builder()
            .session(
                RealtimeSessionCreateRequest.builder()
                    .model("gpt-realtime-2.1")
                    .addOutputModality(RealtimeSessionCreateRequest.OutputModality.AUDIO)
                    .audio(
                        RealtimeAudioConfig.builder()
                            .input(
                                RealtimeAudioConfigInput.builder()
                                    .format(pcm)
                                    .turnDetection(
                                        RealtimeAudioInputTurnDetection.SemanticVad.builder()
                                            .build())
                                    .build())
                            .output(
                                RealtimeAudioConfigOutput.builder()
                                    .format(pcm)
                                    .voice("marin")
                                    .build())
                            .build())
                    .prompt(
                        com.openai.models.responses.ResponsePrompt.builder()
                            .id("pmpt_123")
                            .version("89")
                            .variables(
                                com.openai.models.responses.ResponsePrompt.Variables.builder()
                                    .putAdditionalProperty("city", JsonValue.from("Paris"))
                                    .build())
                            .build())
                    .instructions(
                        "Speak clearly and briefly. Confirm understanding before taking actions.")
                    .build())
            .build()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28# Replace the illustrative IDs and URLs below with your own resource values.
connection.session.update(
  type: :realtime,
  model: "gpt-realtime-2.1",
  output_modalities: [:audio],
  audio: {
    input: {
      format: {
        type: :"audio/pcm",
        rate: 24_000
      },
      turn_detection: { type: :semantic_vad }
    },
    output: {
      format: {
        type: :"audio/pcm",
        rate: 24_000
      },
      voice: :marin
    }
  },
  prompt: {
    id: "pmpt_123",
    version: "89",
    variables: { city: "Paris" }
  },
  instructions: "Speak clearly and briefly. Confirm before taking action."
)
会话更新后,服务器会发送 session.updated 事件,其中包含会话的新状态。
要使用实时模型生成文本,您可以向当前对话添加文本输入,请求模型生成响应,并监听服务器发送的事件以跟踪响应的生成进度。要生成文本,会话必须配置为支持 text 模态(默认已启用)。
使用 conversation.item.create 客户端事件创建新的文本对话项。这与通过 REST API 在 Chat Completions 中发送用户消息(提示词)类似。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16const event = {
  type: "conversation.item.create",
  item: {
    type: "message",
    role: "user",
    content: [
      {
        type: "input_text",
        text: "What Prince album sold the most copies?",
      },
    ],
  },
};

// WebRTC data channel and WebSocket both have .send()
ws.send(JSON.stringify(event));
1
2
3
4
5
6
7
8
9
10
11
12
13
14event = {
    "type": "conversation.item.create",
    "item": {
        "type": "message",
        "role": "user",
        "content": [
            {
                "type": "input_text",
                "text": "What Prince album sold the most copies?",
            }
        ],
    },
}
ws.send(json.dumps(event))
1
2
3
4
5
6
7
8
9
10if err := conn.Send(ctx, realtime.RealtimeClientEventParamOfConversationItemCreate(realtime.RealtimeConversationItemUserMessageParam{
	Content: []realtime.RealtimeConversationItemUserMessageContentParam{
		{
			Text: openai.String("What Prince album sold the most copies?"),
			Type: "input_text",
		},
	},
})); err != nil {
	return err
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20import com.openai.client.okhttp.OkHttpClient;
import com.openai.core.ClientOptions;
import com.openai.core.JsonMissing;
import com.openai.helpers.RealtimeConnection;
import com.openai.helpers.RealtimeWebSocketOptions;
import com.openai.models.realtime.*;

connection.send(
    RealtimeClientEvent.ofConversationItemCreate(
        ConversationItemCreateEvent.builder()
            .item(
                RealtimeConversationItemUserMessage.builder()
                    .object_(JsonMissing.of())
                    .addContent(
                        RealtimeConversationItemUserMessage.Content.builder()
                            .type(RealtimeConversationItemUserMessage.Content.Type.INPUT_TEXT)
                            .text("What Prince album sold the most copies?")
                            .build())
                    .build())
            .build()));
1
2
3
4
5
6
7using OpenAI.Realtime;

#pragma warning disable OPENAI002

RealtimeMessageItem item = RealtimeItem.CreateUserMessageItem("What Prince album sold the most copies?");
item.Id = Guid.NewGuid().ToString("N");
await session.SendCommandAsync(new RealtimeClientCommandConversationItemCreate(item), timeout.Token);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18connection.conversation.items.create(
  type: :message,
  role: :user,
  content: [
    {
      type: :input_text,
      text: "What is the weather like today?"
    }
  ]
)

receipt = connection.find do |event|
  raise event.error.message if event.is_a?(OpenAI::Realtime::RealtimeErrorEvent)
  next unless event.is_a?(OpenAI::Realtime::ConversationItemDone)

  event.item.is_a?(OpenAI::Realtime::RealtimeConversationItemUserMessage)
end
raise "Connection closed before the conversation item was acknowledged" unless receipt
将用户消息添加到对话后,发送 response.create 事件,让模型开始生成响应。请选择一种输出模态:audio 会生成音频及其转录文本,text 仅生成文本。如果您只想生成文本,可以在发送 response.create 客户端事件时指定,如下所示。
1
2
3
4
5
6
7
8
9const event = {
  type: "response.create",
  response: {
    output_modalities: ["text"],
  },
};

// WebRTC data channel and WebSocket both have .send()
ws.send(JSON.stringify(event));
1
2event = {"type": "response.create", "response": {"output_modalities": ["text"]}}
ws.send(json.dumps(event))
1
2
3
4
5
6
7
8
9if err := conn.Send(ctx, realtime.RealtimeClientEventUnionParam{
	OfResponseCreate: &realtime.ResponseCreateEventParam{
		Response: realtime.RealtimeResponseCreateParams{
			OutputModalities: []string{"text"},
		},
	},
}); err != nil {
	return err
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14import com.openai.client.okhttp.OkHttpClient;
import com.openai.core.ClientOptions;
import com.openai.helpers.RealtimeConnection;
import com.openai.helpers.RealtimeWebSocketOptions;
import com.openai.models.realtime.*;

connection.send(
    RealtimeClientEvent.ofResponseCreate(
        ResponseCreateEvent.builder()
            .response(
                RealtimeResponseCreateParams.builder()
                    .addOutputModality(RealtimeResponseCreateParams.OutputModality.TEXT)
                    .build())
            .build()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14using OpenAI.Realtime;

#pragma warning disable OPENAI002

await session.SendCommandAsync(new RealtimeClientCommandResponseCreate
{
    ResponseOptions = new()
    {
        OutputModalities =
        {
            RealtimeOutputModality.Text
        }
    }
}, timeout.Token);
1
2
3
4
5
6
7
8
9
10
11
12
13
14connection.response.create(
  output_modalities: [:text],
  instructions: "Respond with a concise text message."
)

response_done = connection.find do |event|
  raise event.error.message if event.is_a?(OpenAI::Realtime::RealtimeErrorEvent)
  next unless event.is_a?(OpenAI::Realtime::ResponseDoneEvent)

  raise "Response failed: #{event.response.status}" unless event.response.status == :completed

  true
end
raise "Connection closed before the response completed" unless response_done
响应生成完毕后,服务器会发送 response.done 事件。该事件包含模型生成的完整文本,如下所示。
1
2
3
4
5
6
7
8
9
10
11
12
13function handleEvent(message: import("ws").RawData | MessageEvent<string>) {
  const data = "data" in message ? message.data : message.toString();
  const serverEvent = JSON.parse(data);
  if (serverEvent.type === "response.done") {
    console.log(serverEvent.response.output[0]);
  }
}

// Listen for server messages (WebRTC)
// dataChannel.addEventListener("message", handleEvent);

// Listen for server messages (WebSocket)
ws.on("message", handleEvent);
1
2
3
4def on_message(ws, message):
    server_event = json.loads(message)
    if server_event["type"] == "response.done":
        print(server_event["response"]["output"][0])
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31func receiveUntil(ctx context.Context, conn *realtime.RealtimeConnection, terminal string) (realtime.RealtimeServerEventUnion, error) {
	for {
		event, err := conn.Recv(ctx)
		if err != nil {
			return event, fmt.Errorf("waiting for %s: %w", terminal, err)
		}
		if event.Type == "error" {
			return event, fmt.Errorf("Realtime API error: %s", event.OfRealtimeErrorEvent.Error.Message)
		}
		if event.Type == "response.done" && event.OfResponseDoneEvent.Response.Status != "completed" {
			return event, fmt.Errorf("response ended with status %s", event.OfResponseDoneEvent.Response.Status)
		}
		if event.Type == "response.done" {
			response := event.OfResponseDoneEvent.Response
			fmt.Println("Response status:", response.Status)
			for _, output := range response.Output {
				item := output.OfRealtimeConversationItemAssistantMessage
				if item.Type == "message" {
					for _, content := range item.Content {
						if content.Type == "output_text" {
							fmt.Print(content.Text)
						}
					}
				}
			}
		}
		if event.Type == terminal {
			return event, nil
		}
	}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23import com.openai.client.okhttp.OkHttpClient;
import com.openai.core.ClientOptions;
import com.openai.helpers.RealtimeConnection;
import com.openai.helpers.RealtimeWebSocketOptions;
import com.openai.models.realtime.*;

static void handleEvent(RealtimeServerEvent event) {
  event
      .responseDone()
      .ifPresent(
          done -> {
            if (!done.response()
                .status()
                .filter(RealtimeResponse.Status.COMPLETED::equals)
                .isPresent())
              throw new IllegalStateException(
                  "Response ended with status "
                      + done.response().status()
                      + ": "
                      + done.response().statusDetails());
            System.out.println(done.response().output());
          });
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14using OpenAI.Realtime;

#pragma warning disable OPENAI002

internal static void HandleEvent(RealtimeServerUpdate update)
{
    if (update is RealtimeServerUpdateResponseDone completion && completion.Response.Status != RealtimeResponseStatus.Completed)
        throw new InvalidOperationException($"Response ended with status {completion.Response.Status}: {System.ClientModel.Primitives.ModelReaderWriter.Write(completion.Response)}");
    if (update is RealtimeServerUpdateResponseDone done)
    {
        foreach (RealtimeItem item in done.Response.OutputItems)
            Console.WriteLine(System.ClientModel.Primitives.ModelReaderWriter.Write(item));
    }
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14response_done = connection.find do |event|
  next unless event.is_a?(OpenAI::Realtime::ResponseDoneEvent)

  puts("Response status: #{event.response.status}")
  Array(event.response.output).each do |item|
    next unless item.is_a?(OpenAI::Realtime::RealtimeConversationItemAssistantMessage)

    item.content.each do |content|
      puts(content.text) if content.type == :output_text
    end
  end
  true
end
raise "Connection closed before the response completed" unless response_done
在模型生成响应的过程中,服务器会发送一系列生命周期事件。您可以监听 response.output_text.delta 等事件,在响应生成时向用户提供实时反馈。下表的相关服务器事件一栏列出了这一过程中服务器发送的所有事件,大致按发送顺序排列。表中也列出了文本生成涉及的客户端事件。
Realtime API 的一项重要能力是让用户直接与模型进行语音交互,无需经过文本转语音或语音转文本的中间步骤。这样既能降低语音界面的延迟,也能让模型利用输入语音中的语气和语调变化等信息。
您可以为实时会话选择一种内置音色来生成音频输出。您可以设置 voice 来控制模型的音色,既可以在创建会话时设置,也可以在 response.create 事件中设置。当前可选音色为 alloy、ash、ballad、coral、echo、sage、shimmer、verse、marin 和 cedar。一旦模型在会话中输出过音频,就无法再修改该会话的 voice。为获得最佳音质,我们建议使用 marin 或 cedar。
通过 WebRTC 连接 Realtime API 时,Realtime API 会与客户端建立对等连接。模型输出的音频以远程媒体流的形式传送到客户端。客户端通过音频设备采集要输入模型的音频(使用 getUserMedia),并将媒体流中的音轨添加到对等连接。
以下代码来自 WebRTC 连接指南,展示了如何使用浏览器 API 配置本地和远程音频:
1
2
3
4
5
6
7
8
9
10
11
12
13// Create a peer connection
const pc = new RTCPeerConnection();

// Set up to play remote audio from the model
const audioEl = document.createElement("audio");
audioEl.autoplay = true;
pc.ontrack = (e) => (audioEl.srcObject = e.streams[0]);

// Add local audio track for microphone input in the browser
const ms = await navigator.mediaDevices.getUserMedia({
  audio: true,
});
pc.addTrack(ms.getTracks()[0]);
通过上述代码即可与 Realtime API 交互。在此基础上,您还可以实现更多功能。要了解不同类型的用户界面,请查看 WebRTC 示例代码仓库,也可以在线体验这些示例。
在浏览器中使用媒体采集与流 API,您可以开启或关闭麦克风、选择用于采集输入的设备等。
默认情况下,WebRTC 客户端在发送音频输入之前,无需向 Realtime API 发送任何客户端事件。将本地音轨添加到对等连接后,用户就可以开始说话。
不过,当客户端和服务器通过对等连接双向传输音频时,WebRTC 客户端仍会收到服务器发送的一系列生命周期事件。例如:
WebRTC 的媒体流 API 可能已经足以满足您的控制需求。不过,有时您需要使用更底层的接口处理音频输入和输出。请参阅下方的 WebSocket 部分,了解如何精细控制音频输入,以及需要使用哪些事件。
通过 WebSocket 收发音频时,您需要在客户端执行更多操作,才能发送媒体数据并接收服务器传来的媒体数据。下表列出了在 WebSocket 会话中收发音频所需的事件及其流程。
以下事件按生命周期顺序排列,但某些事件(例如 delta 事件)可能并发发生。
要向服务器流式传输音频输入,可以使用 input_audio_buffer.append 客户端事件。使用此事件时,您需要通过套接字向 Realtime API 分块发送 Base64 编码的音频字节。每块数据不得超过 15 MB。
请设置 session.audio.input.format,并通过 session.update 发送该配置。如果使用 PCM,请将格式设为 {"type": "audio/pcm", "rate": 24000},并发送 24 kHz 的单声道音频。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77import fs from "fs";
import decodeAudio from "audio-decode";

// Converts Float32Array of audio data to PCM16 ArrayBuffer
function floatTo16BitPCM(float32Array: Float32Array) {
  const buffer = new ArrayBuffer(float32Array.length * 2);
  const view = new DataView(buffer);
  let offset = 0;
  for (let i = 0; i < float32Array.length; i++, offset += 2) {
    const sample = Math.max(-1, Math.min(1, float32Array[i]));
    view.setInt16(
      offset,
      Math.round(sample * (sample < 0 ? 0x8000 : 0x7fff)),
      true
    );
  }
  return buffer;
}

// Converts a Float32Array to base64-encoded PCM16 data
function base64EncodeAudio(float32Array: Float32Array<ArrayBufferLike>) {
  const arrayBuffer = floatTo16BitPCM(float32Array);
  let binary = "";
  let bytes = new Uint8Array(arrayBuffer);
  const chunkSize = 0x8000; // 32KB chunk size
  for (let i = 0; i < bytes.length; i += chunkSize) {
    let chunk = bytes.subarray(i, i + chunkSize);
    binary += String.fromCharCode(...chunk);
  }
  return btoa(binary);
}

// Fills the audio buffer with the contents of three files,
// then asks the model to generate a response.
const files = [
  "fixtures/sample1.wav",
  "fixtures/sample2.wav",
  "fixtures/sample3.wav",
];

// Manual commit and response creation require automatic turn detection off.
ws.send(
  JSON.stringify({
    type: "session.update",
    session: {
      type: "realtime",
      audio: { input: { turn_detection: null } },
    },
  })
);

for (const filename of files) {
  const audioFile = fs.readFileSync(filename);
  const audioBuffer = await decodeAudio(audioFile);
  if (
    audioBuffer.sampleRate !== 24000 ||
    audioBuffer.channelData.length !== 1
  ) {
    throw new Error("Expected 24 kHz mono audio: " + filename);
  }
  const channelData = audioBuffer.channelData[0];
  const base64Chunk = base64EncodeAudio(channelData);
  ws.send(
    JSON.stringify({
      type: "input_audio_buffer.append",
      audio: base64Chunk,
    })
  );
}

ws.send(JSON.stringify({ type: "input_audio_buffer.commit" }));
ws.send(
  JSON.stringify({
    type: "response.create",
    response: { output_modalities: ["audio"] },
  })
);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32import base64
import json
import struct
import soundfile as sf
from websocket import create_connection

# ... create websocket-client named ws ...


def float_to_16bit_pcm(float32_array):
    clipped = [max(-1.0, min(1.0, x)) for x in float32_array]
    pcm16 = b"".join(struct.pack("<h", min(32767, int(x * 32768))) for x in clipped)
    return pcm16


def base64_encode_audio(float32_array):
    pcm_bytes = float_to_16bit_pcm(float32_array)
    encoded = base64.b64encode(pcm_bytes).decode("ascii")
    return encoded


files = ["./path/to/sample1.wav", "./path/to/sample2.wav", "./path/to/sample3.wav"]

for filename in files:
    data, samplerate = sf.read(filename, dtype="float32")
    if samplerate != 24000 or data.ndim != 1:
        raise ValueError(f"Expected 24 kHz mono audio: {filename}")
    base64_chunk = base64_encode_audio(data)

    # Send the client event
    event = {"type": "input_audio_buffer.append", "audio": base64_chunk}
    ws.send(json.dumps(event))
1
2
3
4
5
6
7// audio contains mono PCM16 samples at 24 kHz.
for start := 0; start < len(audio); start += 9600 {
	end := min(start+9600, len(audio))
	if err := conn.Send(ctx, realtime.RealtimeClientEventParamOfInputAudioBufferAppend(base64.StdEncoding.EncodeToString(audio[start:end]))); err != nil {
		return err
	}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30import com.openai.client.okhttp.OkHttpClient;
import com.openai.core.ClientOptions;
import com.openai.helpers.RealtimeConnection;
import com.openai.helpers.RealtimeWebSocketOptions;
import com.openai.models.realtime.*;
import java.util.Base64;

// Call for each PCM16, 24 kHz, mono chunk supplied by your audio source.
static void appendAudio(RealtimeConnection connection, byte[] pcmAudio) throws Exception {
  String base64Audio = Base64.getEncoder().encodeToString(pcmAudio);
  send(
      connection,
      RealtimeClientEvent.ofInputAudioBufferAppend(
          InputAudioBufferAppendEvent.builder().audio(base64Audio).build()));
}

// Retry only explicit admission rejections; these guarantee nothing was sent.
private static void send(RealtimeConnection connection, RealtimeClientEvent event)
    throws Exception {
  long deadline = System.nanoTime() + java.util.concurrent.TimeUnit.SECONDS.toNanos(5);
  while (true) {
    try {
      connection.send(event);
      return;
    } catch (com.openai.core.http.WebSocketWriteNotAttempted.Busy busy) {
      if (System.nanoTime() >= deadline) throw busy;
      Thread.sleep(10);
    }
  }
}
1
2
3
4
5
6
7
8
9using OpenAI.Realtime;

#pragma warning disable OPENAI002

// Call for each PCM16, 24 kHz, mono chunk supplied by your audio source.
internal static async Task AppendAudioAsync(RealtimeSessionClient session, BinaryData pcmAudio, CancellationToken cancellationToken)
{
    await session.SendCommandAsync(new RealtimeClientCommandInputAudioBufferAppend(pcmAudio), cancellationToken);
}
1
2
3
4
5File.open("speech.pcm", "rb") do |audio|
  while (chunk = audio.read(9_600))
    connection.input_audio_buffer.append_bytes(chunk)
  end
end
您也可以用一段完整的录音创建对话消息。使用 conversation.item.create 客户端事件创建内容类型为 input_audio 的消息。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18const fullAudio = "<a base64-encoded string of audio bytes>";

const event = {
  type: "conversation.item.create",
  item: {
    type: "message",
    role: "user",
    content: [
      {
        type: "input_audio",
        audio: fullAudio,
      },
    ],
  },
};

// WebRTC data channel and WebSocket both have .send()
dataChannel.send(JSON.stringify(event));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17fullAudio = "<a base64-encoded string of audio bytes>"

event = {
    "type": "conversation.item.create",
    "item": {
        "type": "message",
        "role": "user",
        "content": [
            {
                "type": "input_audio",
                "audio": fullAudio,
            }
        ],
    },
}

ws.send(json.dumps(event))
1
2
3
4
5
6
7
8
9
10if err := conn.Send(ctx, realtime.RealtimeClientEventParamOfConversationItemCreate(realtime.RealtimeConversationItemUserMessageParam{
	Content: []realtime.RealtimeConversationItemUserMessageContentParam{
		{
			Audio: openai.String(base64.StdEncoding.EncodeToString(audio)),
			Type:  "input_audio",
		},
	},
})); err != nil {
	return err
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36import com.openai.client.okhttp.OkHttpClient;
import com.openai.core.ClientOptions;
import com.openai.core.JsonMissing;
import com.openai.helpers.RealtimeConnection;
import com.openai.helpers.RealtimeWebSocketOptions;
import com.openai.models.realtime.*;
import java.util.Base64;

// Pass the complete PCM16, 24 kHz, mono recording from your application.
static void sendAudioItem(RealtimeConnection connection, byte[] pcmAudio) throws Exception {
  String fullAudio = Base64.getEncoder().encodeToString(pcmAudio);
  var event =
      RealtimeClientEvent.ofConversationItemCreate(
          ConversationItemCreateEvent.builder()
              .item(
                  RealtimeConversationItemUserMessage.builder()
                      .object_(JsonMissing.of())
                      .addContent(
                          RealtimeConversationItemUserMessage.Content.builder()
                              .type(RealtimeConversationItemUserMessage.Content.Type.INPUT_AUDIO)
                              .audio(fullAudio)
                              .build())
                      .build())
              .build());
  // Retry only explicit admission rejections; these guarantee nothing was sent.
  long deadline = System.nanoTime() + java.util.concurrent.TimeUnit.SECONDS.toNanos(5);
  while (true) {
    try {
      connection.send(event);
      return;
    } catch (com.openai.core.http.WebSocketWriteNotAttempted.Busy busy) {
      if (System.nanoTime() >= deadline) throw busy;
      Thread.sleep(10);
    }
  }
}
1
2
3
4
5
6
7
8
9
10
11
12
13using OpenAI.Realtime;

#pragma warning disable OPENAI002

// Pass the complete PCM16, 24 kHz, mono recording from your application.
internal static async Task<string> SendAudioItemAsync(RealtimeSessionClient session, BinaryData pcmAudio, CancellationToken cancellationToken)
{
    RealtimeMessageItem item = RealtimeItem.CreateUserMessageItem([new RealtimeInputAudioMessageContentPart(pcmAudio)]);
    string itemId = Guid.NewGuid().ToString("N");
    item.Id = itemId;
    await session.SendCommandAsync(new RealtimeClientCommandConversationItemCreate(item), cancellationToken);
    return itemId;
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20audio = Base64.strict_encode64(File.binread("speech.pcm"))

connection.conversation.items.create(
  type: :message,
  role: :user,
  content: [
    {
      type: :input_audio,
      audio: audio
    }
  ]
)

receipt = connection.find do |event|
  raise event.error.message if event.is_a?(OpenAI::Realtime::RealtimeErrorEvent)

  event.is_a?(OpenAI::Realtime::ConversationItemDone) &&
    event.item.is_a?(OpenAI::Realtime::RealtimeConversationItemUserMessage)
end
raise "Connection closed before the audio item was acknowledged" unless receipt
如果要在 Web 浏览器等客户端上播放输出音频,我们建议使用 WebRTC 而非 WebSocket。当网络状况不稳定时,WebRTC 能更可靠地向客户端设备传输媒体数据。
如果要在服务器之间通过 WebSocket 处理音频输出,您需要监听 response.output_audio.delta 事件。这些事件包含模型输出的音频数据块,采用 Base64 编码。您可以先缓冲这些数据块,再将其写入文件,也可以立即将它们流式传输到其他接收端,例如通过 Twilio 建立的电话通话。
请注意,response.output_audio.done 和 response.done 事件仅包含音频内容的转录文本,不包含音频数据本身。要获取实际的音频字节,您需要监听 response.output_audio.delta 事件。
您可以为整个会话配置输出音频块的格式,也可以为单个响应配置格式。
1
2
3
4
5
6
7
8
9
10function handleEvent(message: { toString: () => string }) {
  const serverEvent = JSON.parse(message.toString());
  if (serverEvent.type === "response.output_audio.delta") {
    const audio = Buffer.from(serverEvent.delta, "base64");
    console.log(`Received ${audio.length} audio bytes`);
  }
}

// Listen for server messages (WebSocket)
ws.on("message", handleEvent);
1
2
3
4
5def on_message(ws, message):
    server_event = json.loads(message)
    if server_event["type"] == "response.output_audio.delta":
        # Access Base64-encoded audio chunks:
        print(server_event["delta"])
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24func receiveUntil(ctx context.Context, conn *realtime.RealtimeConnection, terminal string) (realtime.RealtimeServerEventUnion, error) {
	for {
		event, err := conn.Recv(ctx)
		if err != nil {
			return event, fmt.Errorf("waiting for %s: %w", terminal, err)
		}
		if event.Type == "response.output_audio.delta" {
			audio, err := base64.StdEncoding.DecodeString(event.OfResponseAudioDeltaEvent.Delta)
			if err != nil {
				return event, err
			}
			fmt.Printf("Received %d audio bytes\n", len(audio))
		}
		if event.Type == "error" {
			return event, fmt.Errorf("Realtime API error: %s", event.OfRealtimeErrorEvent.Error.Message)
		}
		if event.Type == "response.done" && event.OfResponseDoneEvent.Response.Status != "completed" {
			return event, fmt.Errorf("response ended with status %s", event.OfResponseDoneEvent.Response.Status)
		}
		if event.Type == terminal {
			return event, nil
		}
	}
}
1
2
3
4
5
6
7
8
9import com.openai.client.okhttp.OkHttpClient;
import com.openai.core.ClientOptions;
import com.openai.helpers.RealtimeConnection;
import com.openai.helpers.RealtimeWebSocketOptions;
import com.openai.models.realtime.*;

static void handleEvent(RealtimeServerEvent event) {
  event.responseOutputAudioDelta().ifPresent(delta -> System.out.println(delta.delta()));
}
1
2
3
4
5
6
7
8
9using OpenAI.Realtime;

#pragma warning disable OPENAI002

internal static void HandleEvent(RealtimeServerUpdate update)
{
    if (update is RealtimeServerUpdateResponseOutputAudioDelta delta)
        Console.WriteLine(Convert.ToBase64String(delta.Delta.ToArray()));
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14response_done = connection.find do |event|
  case event
  when OpenAI::Realtime::ResponseAudioDeltaEvent
    audio_bytes = Base64.strict_decode64(event.delta)
    puts("Received #{audio_bytes.bytesize} audio bytes")
  when OpenAI::Realtime::RealtimeErrorEvent
    raise event.error.message
  when OpenAI::Realtime::ResponseDoneEvent
    raise "Response failed: #{event.response.status}" unless event.response.status == :completed

    true
  end
end
raise "Connection closed before the response completed" unless response_done
gpt-realtime-2 和 gpt-realtime 也支持图像输入。您可以将图像作为用户消息的一个内容部分附上,模型便可以结合图像内容作出响应。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18const base64Image = "<a base64-encoded string of image bytes>";

const event = {
  type: "conversation.item.create",
  item: {
    type: "message",
    role: "user",
    content: [
      {
        type: "input_image",
        image_url: `data:image/{format};base64,${base64Image}`,
      },
    ],
  },
};

// WebRTC data channel and WebSocket both have .send()
dataChannel.send(JSON.stringify(event));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24if err := conn.Send(ctx, realtime.RealtimeClientEventParamOfConversationItemCreate(realtime.RealtimeConversationItemUserMessageParam{
	Content: []realtime.RealtimeConversationItemUserMessageContentParam{
		{
			ImageURL: openai.String("data:image/png;base64," + base64.StdEncoding.EncodeToString(image)),
			Type:     "input_image",
		},
		{
			Text: openai.String("Describe this image."),
			Type: "input_text",
		},
	},
})); err != nil {
	return err
}

if err := conn.Send(ctx, realtime.RealtimeClientEventUnionParam{
	OfResponseCreate: &realtime.ResponseCreateEventParam{
		Response: realtime.RealtimeResponseCreateParams{
			OutputModalities: []string{"text"},
		},
	},
}); err != nil {
	return err
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26encoded_image = Base64.strict_encode64(File.binread("image.png"))

connection.conversation.items.create(
  type: :message,
  role: :user,
  content: [
    {
      type: :input_image,
      image_url: "data:image/png;base64,#{encoded_image}"
    },
    {
      type: :input_text,
      text: "Describe this image."
    }
  ]
)
connection.response.create(output_modalities: [:text])

completion = connection.find do |event|
  raise event.error.message if event.is_a?(OpenAI::Realtime::RealtimeErrorEvent)

  event.is_a?(OpenAI::Realtime::ResponseDoneEvent)
end
unless completion.is_a?(OpenAI::Realtime::ResponseDoneEvent) && completion.response.status == :completed
  raise "The Realtime response did not complete"
end
实时会话默认启用语音活动检测(VAD)。API 会判断用户何时开始或停止说话,并自动作出响应。
有关如何配置 VAD,请参阅语音活动检测指南。
要禁用 VAD,请将 turn_detection 设置为 null,并通过 session.update 客户端事件发送此设置。这适用于需要精细控制音频输入的界面,例如按住说话界面。
禁用 VAD 后,客户端需要手动发送以下额外的客户端事件来触发音频响应:
如果您希望保留 VAD,同时手动决定何时生成响应,可以将 turn_detection.interrupt_response 和 turn_detection.create_response 都设置为 false,并通过 session.update 客户端事件发送配置。这样可以保留 VAD 的检测行为,同时关闭自动创建新响应的功能。客户端可以通过 response.create 事件手动触发响应。
如果您愿意接受略高的交互延迟,以便更好地控制输入,这种方式适用于内容审核、输入验证或检索增强生成(RAG)等场景。
默认情况下,会话期间生成的所有响应都会添加到会话的对话状态(即“默认对话”)中。有时,您可能希望模型在默认对话的上下文之外生成响应,或并发生成多个响应。您也可以更精细地控制模型生成响应时参考哪些对话项,例如仅参考最近 N 轮对话。
要生成“带外”响应,使其不被添加到默认对话状态中,请将 response.conversation 字段设置为字符串 none,并通过 response.create 客户端事件发送此设置来创建响应。
创建带外响应时,您可能还需要判断服务器发送的哪些事件属于该响应。您可以为模型响应提供 metadata,以便识别针对这次客户端事件生成的响应。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23const prompt = `
Analyze the conversation so far. If it is related to support, output
"support". If it is related to sales, output "sales".
`;

  const event = {
    type: "response.create",
    response: {
      // Setting to "none" indicates the response is out of band
      // and will not be added to the default conversation
      conversation: "none",

      // Set metadata to help identify responses sent back from the model
      metadata: { topic: "classification" },

      // Set any other available response fields
      output_modalities: ["text"],
      instructions: prompt,
    },
  };

  // WebRTC data channel and WebSocket both have .send()
  ws.send(JSON.stringify(event));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20prompt = """
Analyze the conversation so far. If it is related to support, output
"support". If it is related to sales, output "sales".
"""

event = {
    "type": "response.create",
    "response": {
        # Setting to "none" indicates the response is out of band,
        # and will not be added to the default conversation
        "conversation": "none",
        # Set metadata to help identify responses sent back from the model
        "metadata": {"topic": "classification"},
        # Set any other available response fields
        "output_modalities": ["text"],
        "instructions": prompt,
    },
}

ws.send(json.dumps(event))
1
2
3
4
5
6
7
8
9
10
11
12
13
14if err := conn.Send(ctx, realtime.RealtimeClientEventUnionParam{
	OfResponseCreate: &realtime.ResponseCreateEventParam{
		Response: realtime.RealtimeResponseCreateParams{
			Instructions: openai.String("\nAnalyze the conversation so far. If it is related to support, output\n\"support\". If it is related to sales, output \"sales\".\n"),
			Metadata: shared.Metadata{
				"topic": "classification",
			},
			Conversation:     "none",
			OutputModalities: []string{"text"},
		},
	},
}); err != nil {
	return err
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22import com.openai.client.okhttp.OkHttpClient;
import com.openai.core.ClientOptions;
import com.openai.core.JsonValue;
import com.openai.helpers.RealtimeConnection;
import com.openai.helpers.RealtimeWebSocketOptions;
import com.openai.models.realtime.*;

connection.send(
    RealtimeClientEvent.ofResponseCreate(
        ResponseCreateEvent.builder()
            .response(
                RealtimeResponseCreateParams.builder()
                    .conversation("none")
                    .metadata(
                        RealtimeResponseCreateParams.Metadata.builder()
                            .putAdditionalProperty("topic", JsonValue.from("classification"))
                            .build())
                    .addOutputModality(RealtimeResponseCreateParams.OutputModality.TEXT)
                    .instructions(
                        "Analyze the conversation so far. If it is related to support, output \"support\". If it is related to sales, output \"sales\".")
                    .build())
            .build()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20using OpenAI.Realtime;

#pragma warning disable OPENAI002

await session.SendCommandAsync(new RealtimeClientCommandResponseCreate
{
    ResponseOptions = new()
    {
        DefaultConversationConfiguration = RealtimeResponseDefaultConversationConfiguration.None,
        Metadata = new Dictionary<string, BinaryData>
        {
            ["topic"] = BinaryData.FromObjectAsJson("classification")
        },
        OutputModalities =
        {
            RealtimeOutputModality.Text
        },
        Instructions = "Analyze the conversation so far. If it is related to support, output \"support\". If it is related to sales, output \"sales\"."
    }
}, timeout.Token);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16connection.response.create(
  conversation: :none,
  metadata: { topic: "classification" },
  output_modalities: [:text],
  instructions: "Classify the conversation as support or sales."
)

response_done = connection.find do |event|
  raise event.error.message if event.is_a?(OpenAI::Realtime::RealtimeErrorEvent)
  next unless event.is_a?(OpenAI::Realtime::ResponseDoneEvent)

  raise "Response failed: #{event.response.status}" unless event.response.status == :completed

  true
end
raise "Connection closed before the response completed" unless response_done
这样,当您监听 response.done 服务器事件时,就可以识别带外响应的结果。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22function handleEvent(message: import("ws").RawData | MessageEvent<string>) {
  const data = "data" in message ? message.data : message.toString();
  const serverEvent = JSON.parse(data);
  if (
    serverEvent.type === "response.done" &&
    serverEvent.response.metadata?.topic === "classification"
  ) {
    const { response } = serverEvent;
    if (response.status !== "completed" || response.output.length === 0) {
      throw new Error(
        "Classification response ended with status " + response.status
      );
    }
    console.log(response.output[0]);
  }
}

// Listen for server messages (WebRTC)
// dataChannel.addEventListener("message", handleEvent);

// Listen for server messages (WebSocket)
ws.on("message", handleEvent);
1
2
3
4
5
6
7
8
9
10
11
12def on_message(ws, message):
    server_event = json.loads(message)
    if server_event["type"] != "response.done":
        return
    response = server_event["response"]
    if (response.get("metadata") or {}).get("topic") != "classification":
        return
    if response["status"] != "completed" or not response["output"]:
        raise RuntimeError(
            f"Classification response ended with status {response['status']}"
        )
    print(response["output"][0])
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34func receiveUntil(ctx context.Context, conn *realtime.RealtimeConnection, terminal string) (realtime.RealtimeServerEventUnion, error) {
	for {
		event, err := conn.Recv(ctx)
		if err != nil {
			return event, fmt.Errorf("waiting for %s: %w", terminal, err)
		}
		if event.Type == "error" {
			return event, fmt.Errorf("Realtime API error: %s", event.OfRealtimeErrorEvent.Error.Message)
		}
		if event.Type == "response.done" && event.OfResponseDoneEvent.Response.Metadata["topic"] != "classification" {
			continue
		}
		if event.Type == "response.done" && event.OfResponseDoneEvent.Response.Status != "completed" {
			return event, fmt.Errorf("response ended with status %s", event.OfResponseDoneEvent.Response.Status)
		}
		if event.Type == "response.done" {
			response := event.OfResponseDoneEvent.Response
			fmt.Println("Response status:", response.Status)
			for _, output := range response.Output {
				item := output.OfRealtimeConversationItemAssistantMessage
				if item.Type == "message" {
					for _, content := range item.Content {
						if content.Type == "output_text" {
							fmt.Print(content.Text)
						}
					}
				}
			}
		}
		if event.Type == terminal {
			return event, nil
		}
	}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22import com.openai.client.okhttp.OkHttpClient;
import com.openai.core.ClientOptions;
import com.openai.core.JsonValue;
import com.openai.helpers.RealtimeConnection;
import com.openai.helpers.RealtimeWebSocketOptions;
import com.openai.models.realtime.*;

static boolean handleEvent(RealtimeServerEvent event) {
  if (event.responseDone().isEmpty()) return false;
  var response = event.responseDone().orElseThrow().response();
  if (!response
      .metadata()
      .map(m -> m._additionalProperties().get("topic"))
      .flatMap(JsonValue::asString)
      .filter("classification"::equals)
      .isPresent()) return false;
  if (!response.status().filter(RealtimeResponse.Status.COMPLETED::equals).isPresent())
    throw new IllegalStateException(
        "Response ended with status " + response.status() + ": " + response.statusDetails());
  System.out.println(response.output());
  return true;
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16using OpenAI.Realtime;

#pragma warning disable OPENAI002

internal static bool HandleEvent(RealtimeServerUpdate update)
{
    if (update is not RealtimeServerUpdateResponseDone done ||
        !done.Response.Metadata.TryGetValue("topic", out BinaryData? topic) ||
        topic.ToObjectFromJson<string>() != "classification")
        return false;
    if (done.Response.Status != RealtimeResponseStatus.Completed)
        throw new InvalidOperationException($"Response ended with status {done.Response.Status}: {System.ClientModel.Primitives.ModelReaderWriter.Write(done.Response)}");
    foreach (RealtimeItem item in done.Response.OutputItems)
        Console.WriteLine(System.ClientModel.Primitives.ModelReaderWriter.Write(item));
    return true;
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15response_done = connection.find do |event|
  next unless event.is_a?(OpenAI::Realtime::ResponseDoneEvent)
  next unless event.response.metadata&.fetch(:topic, nil) == "classification"

  puts("Classification response completed: #{event.response.status}")
  Array(event.response.output).each do |item|
    next unless item.is_a?(OpenAI::Realtime::RealtimeConversationItemAssistantMessage)

    item.content.each do |content|
      puts("Classification: #{content.text}") if content.type == :output_text
    end
  end
  true
end
raise "Connection closed before the response completed" unless response_done
您还可以在当前的默认对话之外构建自定义上下文,供模型生成响应。为此,请设置 input 数组,并通过 response.create 客户端事件发送。您可以提供新的输入,也可以通过 ID 引用对话中已有的输入项。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45const existingItemId = "item_pizza";
ws.send(
  JSON.stringify({
    type: "conversation.item.create",
    item: {
      id: existingItemId,
      type: "message",
      role: "user",
      content: [
        { type: "input_text", text: "We are ordering pizza for dinner." },
      ],
    },
  })
);
const event = {
  type: "response.create",
  response: {
    conversation: "none",
    metadata: { topic: "pizza" },
    output_modalities: ["text"],

    // Create a custom input array for this request with whatever context
    // is appropriate
    input: [
      // potentially include existing conversation items:
      {
        type: "item_reference",
        id: existingItemId,
      },
      {
        type: "message",
        role: "user",
        content: [
          {
            type: "input_text",
            text: "Is it okay to put pineapple on pizza?",
          },
        ],
      },
    ],
  },
};

// WebRTC data channel and WebSocket both have .send()
ws.send(JSON.stringify(event));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46import json

existing_item_id = "item_pizza"
ws.send(
    json.dumps(
        {
            "type": "conversation.item.create",
            "item": {
                "id": existing_item_id,
                "type": "message",
                "role": "user",
                "content": [
                    {"type": "input_text", "text": "We are ordering pizza for dinner."}
                ],
            },
        }
    )
)

event = {
    "type": "response.create",
    "response": {
        "conversation": "none",
        "metadata": {"topic": "pizza"},
        "output_modalities": ["text"],
        # Create a custom input array for this request with whatever
        # context is appropriate
        "input": [
            # potentially include existing conversation items:
            {"type": "item_reference", "id": existing_item_id},
            # include new content as well
            {
                "type": "message",
                "role": "user",
                "content": [
                    {
                        "type": "input_text",
                        "text": "Is it okay to put pineapple on pizza?",
                    }
                ],
            },
        ],
    },
}

ws.send(json.dumps(event))
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34existing_item_id = "item_order"
connection.conversation.items.create(
  id: existing_item_id,
  type: :message,
  role: :user,
  content: [
    {
      type: :input_text,
      text: "Order ORD-123 has not arrived."
    }
  ]
)

connection.response.create(
  conversation: :none,
  metadata: { topic: "classification" },
  output_modalities: [:text],
  input: [
    {
      type: :item_reference,
      id: existing_item_id
    },
    {
      type: :message,
      role: :user,
      content: [
        {
          type: :input_text,
          text: "Classify this issue: my order is late."
        }
      ]
    }
  ]
)
您也可以向默认对话中插入响应,让模型在生成时忽略所有其他指令和上下文。为此,请将 input 设置为空数组。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18const prompt = `
Say exactly the following:
I'm a little teapot, short and stout!
This is my handle, this is my spout!
`;

  const event = {
    type: "response.create",
    response: {
      // An empty input array removes existing context
      input: [],
      output_modalities: ["text"],
      instructions: prompt,
    },
  };

  // WebRTC data channel and WebSocket both have .send()
  ws.send(JSON.stringify(event));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17prompt = """
Say exactly the following:
I'm a little teapot, short and stout!
This is my handle, this is my spout!
"""

event = {
    "type": "response.create",
    "response": {
        "output_modalities": ["text"],
        # An empty input array removes all prior context
        "input": [],
        "instructions": prompt,
    },
}

ws.send(json.dumps(event))
1
2
3
4
5
6
7
8
9
10
11if err := conn.Send(ctx, realtime.RealtimeClientEventUnionParam{
	OfResponseCreate: &realtime.ResponseCreateEventParam{
		Response: realtime.RealtimeResponseCreateParams{
			Instructions:     openai.String("\nSay exactly the following:\nI'm a little teapot, short and stout!\nThis is my handle, this is my spout!\n"),
			Input:            []realtime.ConversationItemUnionParam{},
			OutputModalities: []string{"text"},
		},
	},
}); err != nil {
	return err
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18import com.openai.client.okhttp.OkHttpClient;
import com.openai.core.ClientOptions;
import com.openai.helpers.RealtimeConnection;
import com.openai.helpers.RealtimeWebSocketOptions;
import com.openai.models.realtime.*;
import java.util.List;

connection.send(
    RealtimeClientEvent.ofResponseCreate(
        ResponseCreateEvent.builder()
            .response(
                RealtimeResponseCreateParams.builder()
                    .addOutputModality(RealtimeResponseCreateParams.OutputModality.TEXT)
                    .input(List.of())
                    .instructions(
                        "Say exactly the following: I'm a little teapot, short and stout! This is my handle, this is my spout!")
                    .build())
            .build()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17using OpenAI.Realtime;

#pragma warning disable OPENAI002

RealtimeResponseOptions options = new()

{
    OutputModalities = { RealtimeOutputModality.Text },
    Instructions = "Say exactly the following: I'm a little teapot, short and stout! This is my handle, this is my spout!"

};
options.InputItems.Clear();
// An explicitly empty list excludes conversation context.
await session.SendCommandAsync(new RealtimeClientCommandResponseCreate
{
    ResponseOptions = options
}, timeout.Token);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15connection.response.create(
  input: [],
  output_modalities: [:text],
  instructions: "Generate a concise greeting without conversation context."
)

response_done = connection.find do |event|
  raise event.error.message if event.is_a?(OpenAI::Realtime::RealtimeErrorEvent)
  next unless event.is_a?(OpenAI::Realtime::ResponseDoneEvent)

  raise "Response failed: #{event.response.status}" unless event.response.status == :completed

  true
end
raise "Connection closed before the response completed" unless response_done
实时模型也支持函数调用,让您通过执行自定义代码扩展模型的能力。基本流程如下:
- 在更新会话或创建响应时,您可以指定模型可调用的函数列表。
- 处理输入时,如果模型判断需要调用函数,就会在对话中添加包含函数调用参数的对话项。
- 客户端检测到包含函数调用参数的对话项后,会使用这些参数执行自定义代码。
- 代码执行完毕后,客户端会创建包含函数调用结果的新对话项,并请求模型作出响应。
以下示例添加了一个可调用的函数,用于向用户提供当天的星座运势。示例展示了客户端需要发送的事件对象的结构,以及服务器随后发送的事件。
首先,您需要提供一组函数,让模型根据用户输入选择要调用的函数。您可以为整个会话配置可用函数,也可以为单个响应配置。
以下 session.update 客户端事件的载荷配置了一个生成星座运势的函数。该函数只接受一个参数,即要查询运势的星座:
session.update
12345678910111213141516171819202122232425262728293031323334353637{
  "type": "session.update",
  "session": {
    "tools": [
      {
        "type": "function",
        "name": "generate_horoscope",
        "description": "Give today's horoscope for an astrological sign.",
        "parameters": {
          "type": "object",
          "properties": {
            "sign": {
              "type": "string",
              "description": "The sign for the horoscope.",
              "enum": [
                "Aries",
                "Taurus",
                "Gemini",
                "Cancer",
                "Leo",
                "Virgo",
                "Libra",
                "Scorpio",
                "Sagittarius",
                "Capricorn",
                "Aquarius",
                "Pisces"
              ]
            }
          },
          "required": ["sign"]
        }
      }
    ],
    "tool_choice": "auto"
  }
}
函数及其参数的 description 字段有助于模型判断是否调用该函数,以及每个参数应传入哪些数据。如果模型从输入中判断出用户想查询自己的星座运势,就会传入 sign 参数来调用该函数。
模型可能会根据收到的输入,决定调用函数以生成更合适的响应。假设应用通过 conversation.item.create 事件添加以下对话项,然后创建响应:
12345678910111213{
  "type": "conversation.item.create",
  "item": {
    "type": "message",
    "role": "user",
    "content": [
      {
        "type": "input_text",
        "text": "What is my horoscope? I am an aquarius."
      }
    ]
  }
}
接下来发送 response.create 客户端事件以生成响应:
123{
  "type": "response.create"
}
此时,模型会先生成一个包含函数调用参数的响应,供开发者的应用将参数传给相应函数,暂时不会返回文本或音频。您可以监听 response.function_call_arguments.delta 服务器事件,实时获取函数调用参数的增量更新。response.done 也包含调用函数所需的完整数据。
response.done
123456789101112131415161718192021{
  "type": "response.done",
  "event_id": "event_AeqLA8iR6FK20L4XZs2P6",
  "response": {
    "object": "realtime.response",
    "id": "resp_AeqL8XwMUOri9OhcQJIu9",
    "status": "completed",
    "status_details": null,
    "output": [
      {
        "object": "realtime.item",
        "id": "item_AeqL8gmRWDn9bIsUM2T35",
        "type": "function_call",
        "status": "completed",
        "name": "generate_horoscope",
        "call_id": "call_sHlR7iaFwQ2YQOqm",
        "arguments": "{\"sign\":\"Aquarius\"}"
      }
    ]
  }
}
通过服务器发送的 JSON,您可以判断模型是否请求调用自定义函数,并获取此次调用的信息:
| 属性 |
在函数调用中的作用 |
response.output[0].type |
值为 function_call 时,表示此响应包含调用指定函数所需的参数。 |
response.output[0].name |
要调用的已配置函数的名称,本例中为 generate_horoscope。 |
response.output[0].arguments |
包含函数参数的 JSON 字符串,本例中为 "{\"sign\":\"Aquarius\"}"。 |
response.output[0].call_id |
系统为此次函数调用生成的 ID。将函数调用结果传回模型时,您需要使用此 ID。 |
有了这些信息,您就可以在应用中执行代码,生成星座运势,再将结果传回模型,让模型据此生成响应。
收到包含函数调用参数的模型响应后,您的应用可以执行相应的代码来完成此次调用。代码可以执行您需要的任何操作,例如调用外部 API 或访问数据库。
准备好将自定义代码的执行结果交给模型后,您可以通过 conversation.item.create 客户端事件创建包含结果的新对话项。
12345678{
  "type": "conversation.item.create",
  "item": {
    "type": "function_call_output",
    "call_id": "call_sHlR7iaFwQ2YQOqm",
    "output": "{\"horoscope\": \"You will soon meet a new friend.\"}"
  }
}
- 对话项的类型为
function_call_output。
item.call_id 与上文 response.done 事件返回的调用 ID 相同。item.output 是包含函数调用结果的 JSON 字符串。
添加包含函数调用结果的对话项后,请从客户端再次发送 response.create 事件。模型会使用函数调用返回的数据生成响应。
123{
  "type": "response.create"
}
会话期间,每当服务器遇到错误,都会发送 error 事件。有时可以将错误追溯到应用发送的某个客户端事件。
在 HTTP 中,每个响应都对应一个客户端请求。对于实时事件,则需要通过客户端事件的 event_id 属性确定是哪个事件触发了服务器错误。以下代码演示了这种做法,其中客户端尝试发送一种不受支持的事件:
1
2
3
4
5
6const event = {
  event_id: "my_awesome_event",
  type: "scooby.dooby.doo",
};

dataChannel.send(JSON.stringify(event));
服务器处理这个客户端事件失败后,会发送如下错误事件:
1234567891011{
  "type": "error",
  "event_id": "event_error_123",
  "error": {
    "type": "invalid_request_error",
    "code": "invalid_value",
    "message": "Invalid value: 'scooby.dooby.doo'.",
    "param": "type",
    "event_id": "my_awesome_event"
  }
}
在许多语音应用中,用户可以在模型说话时打断它。启用 VAD 后,Realtime API 会处理这类中断:检测到用户说话时,它会取消正在生成的响应,并开始生成新的响应。此时,您需要让模型知道用户听到了哪里,以便模型自然地继续对话,例如回答用户“你刚才最后说了什么?”的问题。我们将这种处理称为截断模型的上一条响应,即从对话中移除上一条响应中尚未播放的部分。
使用 WebRTC 或 SIP 连接时,服务器负责管理输出音频缓冲区,因此知道每个时刻已经播放了多长的音频。用户打断模型时,服务器会自动截断尚未播放的音频。
使用 WebSocket 连接时,客户端负责管理音频播放,因此必须由客户端停止播放并处理截断。具体步骤如下:
- 收到
input_audio_buffer.speech_started 后,立即停止播放模型的音频,并丢弃该对话项中所有排队等待播放的音频。以毫秒为单位记录用户实际听到的该对话项的音频时长。
- 发送
conversation.item.truncate 事件,提供被打断的对话项 ID 和音频内容索引,并将已播放时长填入 audio_end_ms。这会从对话中移除尚未播放的部分。
- 当 VAD 打断正在生成的响应时,服务器会取消该响应,并发送
response.done,其中 response.status 为 cancelled。您可以通过该事件确认响应已结束,但应立即停止播放并发送截断事件,无需等待该事件到达。
示例如下:
123456{
  "type": "conversation.item.truncate",
  "item_id": "item_1234",
  "content_index": 0,
  "audio_end_ms": 1500
}
此示例在已播放 1.5 秒的位置截断音频。
转录文本也能同步截断吗?实时模型掌握的信息不足以将转录文本与音频精确对齐。因此,conversation.item.truncate 会在指定位置截断音频,并移除未播放部分的转录文本。这样可以移除未播放的音频,但无法提供截断后的转录文本。
Realtime API 默认使用语音活动检测(VAD),根据音频输入触发模型响应。您也可以禁用 VAD,在应用层控制何时将音频输入发送给模型,从而实现按住说话。例如,按住空格键时录音,松开时触发响应。在某些应用中,这种方式效果很好:用户可以掌控交互时机,避免 VAD 检测失败,而且无需等待 VAD 超时,响应更迅速。
使用 WebSocket 和 WebRTC 实现按住说话的方式略有不同。Realtime API 的 WebSocket 连接通过同一通道按顺序发送所有事件,而 WebRTC 连接通过不同通道分别传输音频和控制事件。
通过 WebSocket 连接实现按住说话时,客户端需要停止音频播放、处理中断,并触发新响应。具体步骤如下:
- 设置
"turn_detection": null 并通过 session.update 事件发送,以关闭 VAD。
- 按下按键时,在客户端开始录音。
- 如果模型正在生成响应,请发送
response.cancel 事件将其取消。
- 如果正在播放模型输出的音频,请立即停止播放,并发送
conversation.item.truncate 事件,从对话中移除尚未播放的音频。
- 松开按键时,发送包含录音的
input_audio_buffer.append 消息,将新音频写入输入缓冲区。
- 发送
input_audio_buffer.commit 事件,提交已写入输入缓冲区的音频。如果已启用输入转录,该事件也会启动转录。
- 然后发送
response.create 事件触发响应。
通过 WebRTC 实现按住说话的方式与上述流程类似,但必须显式清空输入音频缓冲区。具体步骤如下:
- 设置
"turn_detection": null 并通过 session.update 事件发送,以关闭 VAD。
- 按下按键时,发送
input_audio_buffer.clear 事件,清除之前的所有音频输入。
- 如果模型正在生成响应,请发送
response.cancel 事件将其取消。
- 如果正在播放模型输出的音频,请发送
output_audio_buffer.clear 事件,清除尚未播放的音频。此操作也会截断对话中相应的内容。
- 松开按键时,发送
input_audio_buffer.commit 事件,提交已写入输入缓冲区的音频。如果已启用输入转录,该事件也会启动转录。
- 然后发送
response.create 事件触发响应。
