Decisions API 现已正式推出。了解公测以来的新增功能。
Decisions API 可评估文本、图像和 JSON,并返回指定类型的答案,速度约为 Responses API 的 10 倍。您可以获取条件成立的概率、从固定选项中选出的答案,或依据评分标准得出的分数。应用可以据此对内容进行分类、分派请求和确定任务优先级。
编写代码之前,您可以在 Playground 中试用 Decisions API,测试不同的问题和输入。
向 POST /v1/decisions 发送请求时,请使用 gpt-6-luna,这是目前唯一支持的模型。
自公测以来,Decisions API 新增了以下功能:
每个请求包含三个部分:
| 字段 |
用途 |
model |
用于评估请求的模型。目前仅支持 gpt-6-luna。 |
input |
各问题共用的判断依据,可以是文本字符串,也可以是由消息、工具调用和工具输出按顺序组成的数组。 |
questions |
指定要评估的内容,包括每个问题的类型、指令,以及允许选择的答案或评分等级。 |
响应包含一个 answers 数组。为每个问题指定唯一的 name,API 会在响应中返回该名称,便于您找到对应的答案。
| 类型 |
用途 |
主要结果 |
predicate |
判断条件是否成立,例如是否有可见损坏,或某段文字是否相关。 |
probability:条件成立的估计概率,取值为 0 到 1。 |
choice |
选择一个选项,例如部门或内容类别。 |
choice:您提供的选项值之一。 |
score |
按有序等级评估输入,例如评估问题的严重程度。 |
score:各等级索引按概率加权后的平均值。 |
choice 和 score 都会返回各个离散选项的概率。对于部门等没有顺序之分的类别,请使用 choice。对于严重程度等有顺序之分的等级,请使用 score。它按概率对各等级的数值索引取加权平均,因此分数可以介于两个等级之间。
如果应用需要上述类型的答案,请使用 Decisions。如果需要生成符合自定义 JSON 模式的对象,例如包含提取出的字段或文字说明的对象,请使用 Responses API 的结构化输出功能。如果需要模型发起工具调用请求并指定参数,请使用函数调用。
在 input 中传入对话历史,以便结合上下文评估请求。按顺序提供消息,以及所有函数调用、自定义工具调用及其输出。使用 call_id 将每个工具输出与对应的调用关联起来。
支持的内容取决于消息角色或输入项类型:
| 输入项 |
支持的内容 |
| 用户消息 |
文本、图像和 JSON |
| 开发者消息或系统消息 |
仅支持输入文本。系统消息按开发者消息处理 |
| 助手消息 |
输出文本或拒绝回答的消息 |
| 函数或自定义工具的输出 |
与对应工具调用关联的文本和图像 |
工具调用及其输出可作为回答问题的依据。Decisions 返回指定类型的答案,由您的应用执行根据答案选定的操作。不支持文件、音频和对输入项的引用。有关可接受的输入字段,请参阅创建决策的 API 参考。
使用 input_json 内容项可直接传入结构化材料,无需先将其转换为字符串。将 JSON 对象或数组放在 data 中,与其他文本或图像内容项一起放入用户消息。在消息内容中,input_json 仅适用于 user 角色。
例如,将以下 JSON 请求体发送到 POST /v1/decisions,即可根据订单记录评估客服工单:
12345678910111213141516171819202122232425262728{
  "model": "gpt-6-luna",
  "input": [
    {
      "role": "user",
      "content": [
        {
          "type": "input_text",
          "text": "Evaluate the ticket using the order evidence."
        },
        {
          "type": "input_json",
          "data": {
            "ticket": { "body": "Please refund the duplicate charge." },
            "order": { "charges": [49, 49] }
          }
        }
      ]
    }
  ],
  "questions": [
    {
      "type": "predicate",
      "name": "duplicate_charge",
      "instructions": "Does the ticket describe a duplicate charge supported by the order?"
    }
  ]
}
role 或 image_url 等 JSON 键位于 data 内时只是普通数据,不会创建消息或获取图像。答案仍按所选的问题类型返回,JSON 输入不会改变响应格式。
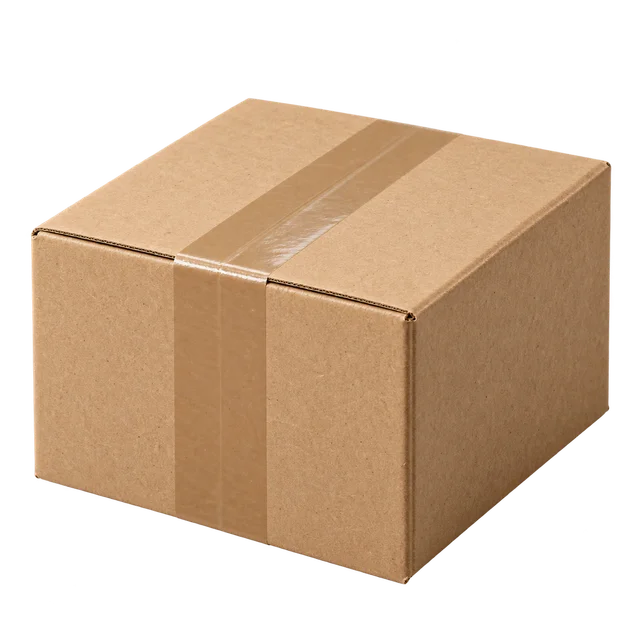
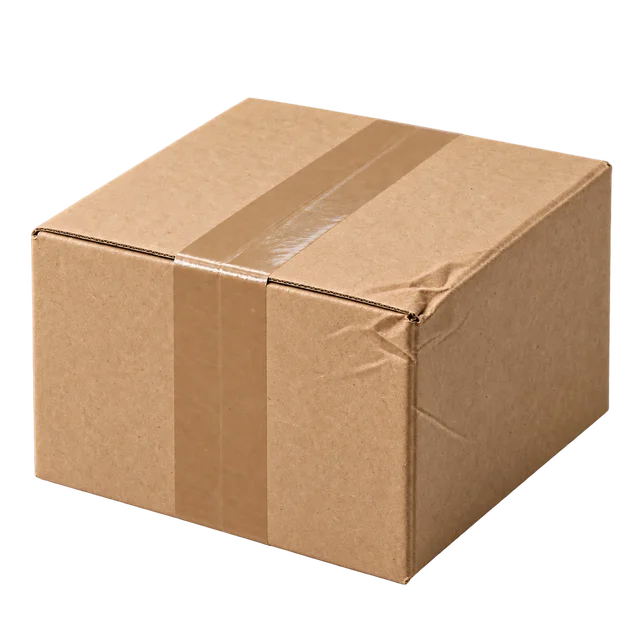
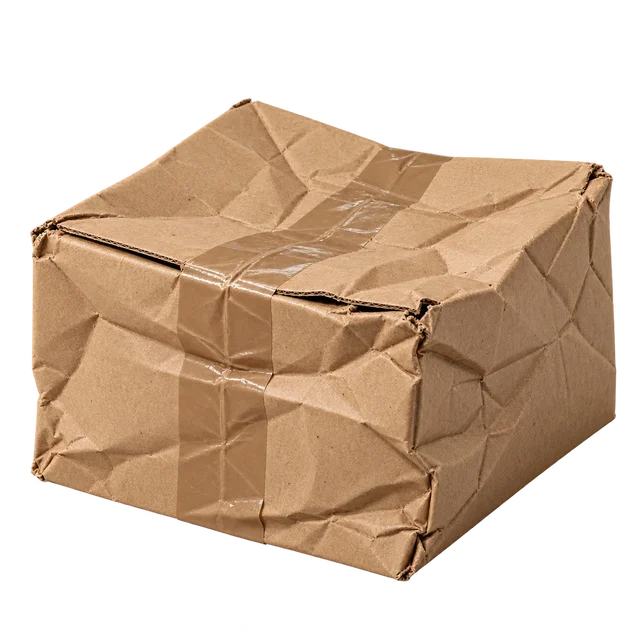
使用 predicate 问题检查产品照片中是否有可见损坏。以下请求同时提供图像和指令,要求模型查找裂缝、撕裂处或凹痕。
请在下次续费前取消我的订阅。
我可以改为按年付费,同时保留现有套餐吗?
我已经用不上了。怎么才能停止后续扣费?
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22IMAGE_BASE64="$(base64 < product.png | tr -d '\r\n')"

curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  --data-binary @- <<JSON
{
  "model": "gpt-6-luna",
  "input": [{
    "role": "user",
    "content": [
      {"type": "input_text", "text": "Inspect the product in this photo."},
      {"type": "input_image", "image_url": "data:image/png;base64,$IMAGE_BASE64"}
    ]
  }],
  "questions": [{
    "type": "predicate",
    "name": "visible_damage",
    "instructions": "Does the product have visible damage, such as a crack, tear, or dent? Ignore shadows and damage to the packaging."
  }]
}
JSON
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35import { readFile } from "node:fs/promises";
import OpenAI from "openai";

const client = new OpenAI();
const imageBase64 = (await readFile("product.png")).toString("base64");
const decision = await client.decisions.create({
  model: "gpt-6-luna",
  input: [
    {
      role: "user",
      content: [
        { type: "input_text", text: "Inspect the product in this photo." },
        {
          type: "input_image",
          image_url: `data:image/png;base64,${imageBase64}`,
        },
      ],
    },
  ],
  questions: [
    {
      type: "predicate",
      name: "visible_damage",
      instructions:
        "Does the product have visible damage, such as a crack, tear, or dent? Ignore shadows and damage to the packaging.",
    },
  ],
});

const answer = decision.answers[0];
if (answer.type === "refusal") {
  console.log(`Refused: ${answer.name}`);
} else if (answer.type === "predicate") {
  console.log(`Visible damage probability: ${answer.probability}`);
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39import base64
from pathlib import Path

from openai import OpenAI

client = OpenAI()
image_base64 = base64.b64encode(Path("product.png").read_bytes()).decode("ascii")

decision = client.decisions.create(
    model="gpt-6-luna",
    input=[
        {
            "role": "user",
            "content": [
                {"type": "input_text", "text": "Inspect the product in this photo."},
                {
                    "type": "input_image",
                    "image_url": f"data:image/png;base64,{image_base64}",
                },
            ],
        }
    ],
    questions=[
        {
            "type": "predicate",
            "name": "visible_damage",
            "instructions": (
                "Does the product have visible damage, such as a crack, tear, or dent? "
                "Ignore shadows and damage to the packaging."
            ),
        }
    ],
)

answer = decision.answers[0]
if answer.type == "refusal":
    print(f"Refused: {answer.name}")
elif answer.type == "predicate":
    print(f"Visible damage probability: {answer.probability}")
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52package main

import (
	"context"
	"encoding/base64"
	"fmt"
	"os"

	"github.com/openai/openai-go/v3"
)

func main() {
	image, err := os.ReadFile("product.png")
	if err != nil {
		panic(err)
	}
	client := openai.NewClient()
	decision, err := client.Decisions.New(context.Background(), openai.DecisionNewParams{
		Model: "gpt-6-luna",
		Input: openai.DecisionNewParamsInputUnion{
			OfDecisionInputMessageArray: []openai.DecisionInputMessageParam{{
				Content: openai.DecisionInputMessageContentUnionParam{
					OfParts: []openai.DecisionInputPartUnionParam{
						{OfInputText: &openai.DecisionInputTextParam{Text: "Inspect the product in this photo."}},
						{OfInputImage: &openai.DecisionInputImageParam{
							ImageURL: "data:image/png;base64," + base64.StdEncoding.EncodeToString(image),
						}},
					},
				},
			}},
		},
		Questions: []openai.DecisionNewParamsQuestionUnion{{
			OfPredicate: &openai.DecisionNewParamsQuestionPredicate{
				Name: openai.String("visible_damage"),
				Instructions: openai.DecisionNewParamsQuestionPredicateInstructionsUnion{
					OfString: openai.String("Does the product have visible damage, such as a crack, tear, or dent? Ignore shadows and damage to the packaging."),
				},
			},
		}},
	})
	if err != nil {
		panic(err)
	}
	switch answer := decision.Answers[0].AsAny().(type) {
	case openai.DecisionAnswerPredicate:
		fmt.Println(answer.Probability)
	case openai.DecisionAnswerRefusal:
		fmt.Printf("Decision refused for %s\n", answer.Name)
	default:
		panic("unexpected answer type")
	}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51import com.openai.models.decisions.DecisionCreateParams;
import com.openai.models.decisions.DecisionInputImage;
import com.openai.models.decisions.DecisionInputItem;
import com.openai.models.decisions.DecisionInputMessage;
import com.openai.models.decisions.DecisionInputPart;
import com.openai.models.decisions.DecisionInputText;
import java.nio.file.Files;
import java.nio.file.Path;
import java.util.Base64;
import java.util.List;

String imageBase64 =
    Base64.getEncoder().encodeToString(Files.readAllBytes(Path.of("product.png")));
var message =
    DecisionInputMessage.User.builder()
        .contentOfParts(
            List.of(
                DecisionInputPart.ofInputText(
                    DecisionInputText.builder()
                        .text("Inspect the product in this photo.")
                        .build()),
                DecisionInputPart.ofInputImage(
                    DecisionInputImage.builder()
                        .imageUrl("data:image/png;base64," + imageBase64)
                        .build())))
        .build();
var decision =
    client
        .decisions()
        .create(
            DecisionCreateParams.builder()
                .model("gpt-6-luna")
                .inputOfDecisionInputItems(
                    List.of(
                        DecisionInputItem.ofDecisionInputMessage(
                            DecisionInputMessage.ofUser(message))))
                .addQuestion(
                    DecisionCreateParams.Question.Predicate.builder()
                        .name("visible_damage")
                        .instructions(
                            "Does the product have visible damage, such as a crack, tear, or"
                                + " dent? Ignore shadows and damage to the packaging.")
                        .build())
                .build());

var answer = decision.answers().get(0);
if (answer.isRefusal()) {
  System.out.println("Refused: " + answer.asRefusal().name().orElse("visible_damage"));
} else {
  System.out.println(answer.asPredicate().probability());
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41require "base64"
require "openai"

image_base64 = Base64.strict_encode64(File.binread("product.png"))
client = OpenAI::Client.new

decision = client.decisions.create(
  model: "gpt-6-luna",
  input: [
    {
      role: :user,
      content: [
        {
          type: :input_text,
          text: "Inspect the product in this photo."
        },
        {
          type: :input_image,
          image_url: "data:image/png;base64,#{image_base64}"
        }
      ]
    }
  ],
  questions: [
    {
      type: :predicate,
      name: "visible_damage",
      instructions: "Does the product have visible damage, such as a crack, tear, or dent? Ignore shadows and damage to the packaging."
    }
  ]
)

answer = decision.answers.fetch(0)
case answer
when OpenAI::Models::Decision::Answer::Predicate
  puts(answer.probability)
when OpenAI::Models::Decision::Answer::Refusal
  warn("Decision refused for #{answer.name}")
else
  raise("Unexpected answer type: #{answer.type}")
end
示例响应片段:
123456789{
  "answers": [
    {
      "type": "predicate",
      "name": "visible_damage",
      "probability": 0.92
    }
  ]
}
probability 表示模型估计的条件成立概率。您可以根据自行设定的阈值标记需要复核的照片。
以内联的 base64 数据 URL 或可公开访问的 HTTP 或 HTTPS URL 提供图像。此端点不支持 file_id 输入。在一条用户消息中组合 input_text 和 input_image 内容项,即可结合指令或其他上下文评估图像。
将所有问题共用的材料放入 input。要为每个问题提供不同的图像,请将其 instructions 设为由 input_text 和 input_image 内容项组成的非空数组。条件判断、选择和评分问题都支持这种方式。纯文本指令可以继续使用字符串。
例如,将以下 JSON 请求体发送到 POST /v1/decisions,即可将待比对图像与共用的参考图像进行比较。请将示例中的两个图像 URL 替换为可公开访问的图像 URL,或使用 base64 图像数据 URL:
12345678910111213141516171819202122232425262728293031323334{
  "model": "gpt-6-luna",
  "input": [
    {
      "role": "user",
      "content": [
        {
          "type": "input_text",
          "text": "The shared image is reference image A."
        },
        {
          "type": "input_image",
          "image_url": "https://example.com/reference.jpg"
        }
      ]
    }
  ],
  "questions": [
    {
      "type": "predicate",
      "name": "candidate_matches_reference",
      "instructions": [
        {
          "type": "input_text",
          "text": "Is candidate image B a derivative or variant of reference image A, including recompression or resizing?"
        },
        {
          "type": "input_image",
          "image_url": "https://example.com/candidate.jpg"
        }
      ]
    }
  ]
}
在问题指令中加入图像时:
- 为每张待比对图像分别添加一个问题。每个问题都将自己的图像与同一张参考图像进行比较。
- 直接在
instructions 中提供内容项,无需将其封装为消息,也无需指定 role。
- 问题中的图像和
input 中的图像共用同一请求的图像限额。
choice 问题会从您提供的选项中选出一个值。为各选项指定不同的值,并说明每个选项适用于什么情况。
模型可以看到每个选项的 value。如果您提供了 description,模型也能看到该描述。这两个字段都是提示词的一部分,因此即使描述保持不变,更改 value 也可能改变结果。
如果 value 是字符串,请优先使用 "billing" 和 "technical" 这样含义明确的标签,避免使用 UUID 这类难以看出含义的标识符。
选项描述应简明直接,如下例所示。
这个月扣了我两次费。能退还多扣的那笔钱吗?
每次导出 CSV 都报错,刷新页面也没用。
我的手机丢了,现在无法通过两步验证。
NORTHLINE STUDIO № 1042
付款方:Cedar & Co.
设计服务$1,200.00
应付金额$1,200.00
NORTHLINE STUDIO № 6853
感谢您的购买。
设计服务$1,200.00
实付总额$1,200.00
NORTHLINE STUDIO 01 / 03
本协议由 Northline Studio 与 Cedar & Co. 签订。
服务提供方同意提供为期十二个月的设计服务。
服务提供方签名客户签名
以下请求确定应将客户投诉分派给哪个部门:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "I was charged twice for my order.",
    "questions": [{
      "type": "choice",
      "name": "department",
      "instructions": "Which department should handle this complaint?",
      "choices": [
        {"value": "billing", "description": "Payments, invoices, and refunds."},
        {"value": "technical", "description": "Problems using the product."},
        {"value": "shipping", "description": "Delivery and tracking."},
        {"value": "other", "description": "Requests outside these categories."}
      ]
    }]
  }'
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29import OpenAI from "openai";

const client = new OpenAI();
const decision = await client.decisions.create({
  model: "gpt-6-luna",
  input: "I was charged twice for my order.",
  questions: [
    {
      type: "choice",
      name: "department",
      instructions: "Which department should handle this complaint?",
      choices: [
        { value: "billing", description: "Payments, invoices, and refunds." },
        { value: "technical", description: "Problems using the product." },
        { value: "shipping", description: "Delivery and tracking." },
        { value: "other", description: "Requests outside these categories." },
      ],
    },
  ],
});

const answer = decision.answers[0];
if (answer.type === "refusal") {
  console.log(`Refused: ${answer.name}`);
} else if (answer.type === "choice") {
  console.log(
    `Department: ${answer.choice} (confidence: ${answer.confidence})`
  );
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26from openai import OpenAI

client = OpenAI()
decision = client.decisions.create(
    model="gpt-6-luna",
    input="I was charged twice for my order.",
    questions=[
        {
            "type": "choice",
            "name": "department",
            "instructions": "Which department should handle this complaint?",
            "choices": [
                {"value": "billing", "description": "Payments, invoices, and refunds."},
                {"value": "technical", "description": "Problems using the product."},
                {"value": "shipping", "description": "Delivery and tracking."},
                {"value": "other", "description": "Requests outside these categories."},
            ],
        }
    ],
)

answer = decision.answers[0]
if answer.type == "refusal":
    print(f"Refused: {answer.name}")
elif answer.type == "choice":
    print(f"Department: {answer.choice} (confidence: {answer.confidence})")
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53package main

import (
	"context"
	"fmt"

	"github.com/openai/openai-go/v3"
)

func main() {
	client := openai.NewClient()
	decision, err := client.Decisions.New(context.Background(), openai.DecisionNewParams{
		Model: "gpt-6-luna",
		Input: openai.DecisionNewParamsInputUnion{OfString: openai.String("I was charged twice for my order.")},
		Questions: []openai.DecisionNewParamsQuestionUnion{{
			OfChoice: &openai.DecisionNewParamsQuestionChoice{
				Name: openai.String("department"),
				Instructions: openai.DecisionNewParamsQuestionChoiceInstructionsUnion{
					OfString: openai.String("Which department should handle this complaint?"),
				},
				Choices: []openai.DecisionNewParamsQuestionChoiceChoice{
					{
						Value:       openai.DecisionNewParamsQuestionChoiceChoiceValueUnion{OfString: openai.String("billing")},
						Description: openai.String("Payments, invoices, and refunds."),
					},
					{
						Value:       openai.DecisionNewParamsQuestionChoiceChoiceValueUnion{OfString: openai.String("technical")},
						Description: openai.String("Problems using the product."),
					},
					{
						Value:       openai.DecisionNewParamsQuestionChoiceChoiceValueUnion{OfString: openai.String("shipping")},
						Description: openai.String("Delivery and tracking."),
					},
					{
						Value:       openai.DecisionNewParamsQuestionChoiceChoiceValueUnion{OfString: openai.String("other")},
						Description: openai.String("Requests outside these categories."),
					},
				},
			},
		}},
	})
	if err != nil {
		panic(err)
	}
	switch answer := decision.Answers[0].AsAny().(type) {
	case openai.DecisionAnswerChoice:
		fmt.Println(answer.Choice.AsString(), answer.Confidence, answer.Probabilities)
	case openai.DecisionAnswerRefusal:
		fmt.Printf("Decision refused for %s\n", answer.Name)
	default:
		panic("unexpected answer type")
	}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47import com.openai.models.decisions.DecisionChoiceOption;
import com.openai.models.decisions.DecisionCreateParams;
import com.openai.models.decisions.DecisionCreateParams.Question.Choice;

var decision =
    client
        .decisions()
        .create(
            DecisionCreateParams.builder()
                .model("gpt-6-luna")
                .input("I was charged twice for my order.")
                .addQuestion(
                    Choice.builder()
                        .name("department")
                        .instructions("Which department should handle this complaint?")
                        .addChoice(
                            DecisionChoiceOption.builder()
                                .value("billing")
                                .description("Payments, invoices, and refunds.")
                                .build())
                        .addChoice(
                            DecisionChoiceOption.builder()
                                .value("technical")
                                .description("Problems using the product.")
                                .build())
                        .addChoice(
                            DecisionChoiceOption.builder()
                                .value("shipping")
                                .description("Delivery and tracking.")
                                .build())
                        .addChoice(
                            DecisionChoiceOption.builder()
                                .value("other")
                                .description("Requests outside these categories.")
                                .build())
                        .build())
                .build());

var answer = decision.answers().get(0);
if (answer.isRefusal()) {
  System.out.println("Refused: " + answer.asRefusal().name().orElse("department"));
} else {
  var choice = answer.asChoice();
  System.out.println(choice.choice().asString());
  System.out.println(choice.probabilities());
  System.out.println(choice.confidence());
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42require "openai"

client = OpenAI::Client.new
decision = client.decisions.create(
  model: "gpt-6-luna",
  input: "I was charged twice for my order.",
  questions: [
    {
      type: :choice,
      name: "department",
      instructions: "Which department should handle this complaint?",
      choices: [
        {
          value: "billing",
          description: "Payments, invoices, and refunds."
        },
        {
          value: "technical",
          description: "Problems using the product."
        },
        {
          value: "shipping",
          description: "Delivery and tracking."
        },
        {
          value: "other",
          description: "Requests outside these categories."
        }
      ]
    }
  ]
)

answer = decision.answers.fetch(0)
case answer
when OpenAI::Models::Decision::Answer::Choice
  puts(answer.choice, answer.confidence, answer.probabilities)
when OpenAI::Models::Decision::Answer::Refusal
  warn("Decision refused for #{answer.name}")
else
  raise("Unexpected answer type: #{answer.type}")
end
示例响应片段:
12345678910111213141516{
  "answers": [
    {
      "type": "choice",
      "name": "department",
      "choice": "billing",
      "probabilities": [
        { "value": "billing", "probability": 0.95 },
        { "value": "technical", "probability": 0.02 },
        { "value": "shipping", "probability": 0.01 },
        { "value": "other", "probability": 0.02 }
      ],
      "confidence": 0.93
    }
  ]
}
答案的 choice 字段包含您提供的某个选项值,此处为 "billing"。答案还包含列出各选项概率的 probabilities 数组和 confidence 字段。有关如何设置阈值,请参阅解读答案。
如果类别无法涵盖所有可能的输入,请添加 "other" 等兜底选项。应用可以将这类结果送入常规复核队列。
score 问题根据 2 至 10 个有序的 levels 评估输入。请定义每个等级的标准,并将等级从低到高排列。
能增加深色模式吗?我晚上工作时用得上。
有一位同事一直无法导出 CSV,团队里的其他人还能正常导出。
所有客户都无法结账。我们已经有 20 分钟没能处理任何订单了。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17curl https://api.openai.com/v1/decisions \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "Export fails in Safari but works in Chrome.",
    "questions": [{
      "type": "score",
      "name": "severity",
      "instructions": "How severe is this issue?",
      "levels": [
        {"label": "Cosmetic", "description": "Appearance only; no lost functionality."},
        {"label": "Workaround available", "description": "A task fails, but another way works."},
        {"label": "Fully blocked", "description": "A task fails with no workaround."}
      ]
    }]
  }'
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35import OpenAI from "openai";

const client = new OpenAI();
const decision = await client.decisions.create({
  model: "gpt-6-luna",
  input: "Export fails in Safari but works in Chrome.",
  questions: [
    {
      type: "score",
      name: "severity",
      instructions: "How severe is this issue?",
      levels: [
        {
          label: "Cosmetic",
          description: "Appearance only; no lost functionality.",
        },
        {
          label: "Workaround available",
          description: "A task fails, but another way works.",
        },
        {
          label: "Fully blocked",
          description: "A task fails with no workaround.",
        },
      ],
    },
  ],
});

const answer = decision.answers[0];
if (answer.type === "refusal") {
  console.log(`Refused: ${answer.name}`);
} else if (answer.type === "score") {
  console.log(`Severity: ${answer.score} (confidence: ${answer.confidence})`);
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34from openai import OpenAI

client = OpenAI()
decision = client.decisions.create(
    model="gpt-6-luna",
    input="Export fails in Safari but works in Chrome.",
    questions=[
        {
            "type": "score",
            "name": "severity",
            "instructions": "How severe is this issue?",
            "levels": [
                {
                    "label": "Cosmetic",
                    "description": "Appearance only; no lost functionality.",
                },
                {
                    "label": "Workaround available",
                    "description": "A task fails, but another way works.",
                },
                {
                    "label": "Fully blocked",
                    "description": "A task fails with no workaround.",
                },
            ],
        }
    ],
)

answer = decision.answers[0]
if answer.type == "refusal":
    print(f"Refused: {answer.name}")
elif answer.type == "score":
    print(f"Severity: {answer.score} (confidence: {answer.confidence})")
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40package main

import (
	"context"
	"fmt"

	"github.com/openai/openai-go/v3"
)

func main() {
	client := openai.NewClient()
	decision, err := client.Decisions.New(context.Background(), openai.DecisionNewParams{
		Model: "gpt-6-luna",
		Input: openai.DecisionNewParamsInputUnion{OfString: openai.String("Export fails in Safari but works in Chrome.")},
		Questions: []openai.DecisionNewParamsQuestionUnion{{
			OfScore: &openai.DecisionNewParamsQuestionScore{
				Name: openai.String("severity"),
				Instructions: openai.DecisionNewParamsQuestionScoreInstructionsUnion{
					OfString: openai.String("How severe is this issue?"),
				},
				Levels: []openai.DecisionNewParamsQuestionScoreLevel{
					{Label: "Cosmetic", Description: openai.String("Appearance only; no lost functionality.")},
					{Label: "Workaround available", Description: openai.String("A task fails, but another way works.")},
					{Label: "Fully blocked", Description: openai.String("A task fails with no workaround.")},
				},
			},
		}},
	})
	if err != nil {
		panic(err)
	}
	switch answer := decision.Answers[0].AsAny().(type) {
	case openai.DecisionAnswerScore:
		fmt.Println(answer.Score, answer.Confidence, answer.Probabilities)
	case openai.DecisionAnswerRefusal:
		fmt.Printf("Decision refused for %s\n", answer.Name)
	default:
		panic("unexpected answer type")
	}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41import com.openai.models.decisions.DecisionCreateParams;
import com.openai.models.decisions.DecisionCreateParams.Question.Score;

var decision =
    client
        .decisions()
        .create(
            DecisionCreateParams.builder()
                .model("gpt-6-luna")
                .input("Export fails in Safari but works in Chrome.")
                .addQuestion(
                    Score.builder()
                        .name("severity")
                        .instructions("How severe is this issue?")
                        .addLevel(
                            Score.Level.builder()
                                .label("Cosmetic")
                                .description("Appearance only; no lost functionality.")
                                .build())
                        .addLevel(
                            Score.Level.builder()
                                .label("Workaround available")
                                .description("A task fails, but another way works.")
                                .build())
                        .addLevel(
                            Score.Level.builder()
                                .label("Fully blocked")
                                .description("A task fails with no workaround.")
                                .build())
                        .build())
                .build());

var answer = decision.answers().get(0);
if (answer.isRefusal()) {
  System.out.println("Refused: " + answer.asRefusal().name().orElse("severity"));
} else {
  var score = answer.asScore();
  System.out.println(score.score());
  System.out.println(score.probabilities());
  System.out.println(score.confidence());
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38require "openai"

client = OpenAI::Client.new
decision = client.decisions.create(
  model: "gpt-6-luna",
  input: "Export fails in Safari but works in Chrome.",
  questions: [
    {
      type: :score,
      name: "severity",
      instructions: "How severe is this issue?",
      levels: [
        {
          label: "Cosmetic",
          description: "Appearance only; no lost functionality."
        },
        {
          label: "Workaround available",
          description: "A task fails, but another way works."
        },
        {
          label: "Fully blocked",
          description: "A task fails with no workaround."
        }
      ]
    }
  ]
)

answer = decision.answers.fetch(0)
case answer
when OpenAI::Models::Decision::Answer::Score
  puts(answer.score, answer.confidence, answer.probabilities)
when OpenAI::Models::Decision::Answer::Refusal
  warn("Decision refused for #{answer.name}")
else
  raise("Unexpected answer type: #{answer.type}")
end
示例响应片段:
123456789101112131415{
  "answers": [
    {
      "type": "score",
      "name": "severity",
      "score": 1.1,
      "probabilities": [
        { "value": 0, "label": "Cosmetic", "probability": 0.1 },
        { "value": 1, "label": "Workaround available", "probability": 0.7 },
        { "value": 2, "label": "Fully blocked", "probability": 0.2 }
      ],
      "confidence": 0.55
    }
  ]
}
等级索引从 0 开始。在本例中,0 表示仅影响外观,1 表示有临时解决办法,2 表示完全无法继续操作。返回的 score 是按概率加权的平均值,因此可以介于两个等级之间。本例中三个等级的概率分别为 0.1、0.7 和 0.2,算出的分数为 1.1。
答案还包含 confidence 和表示各等级概率的 probabilities。分数概括了各等级的概率分布。如果需要选出单个类别,请使用 choice。
每个请求可包含 1 至 400 个问题。将相互独立的问题放在同一个 questions 数组中,即可针对同一份输入分别进行评估。例如,对于一张产品照片,只需一次请求即可检查是否有损坏并判断产品类别。每个问题可以使用不同的类型。
如果某项决策取决于先前的答案,请分开发送请求。例如,先检查是否有损坏,再根据结果决定是否需要发起请求来确定维修类别。
围绕可观察的标准编写问题。将不同的判断任务拆分为不同的问题,确保各选项含义明确且互不混淆,并为相邻的评分等级设定可明确区分的标准。
条件判断问题返回条件成立的估计概率。选择和评分问题的答案会返回概率分布,并单独提供 confidence 字段。
使用应用中的已标注示例,为分派、筛选或复核设置阈值。选择阈值时,请考虑误报和漏报各自的代价。
提示词缓存让重复请求可以复用共享 input 中相同的前缀,并享受缓存读取折扣。例如,您可以在 input 中保留同一份参考文档或图像,只更改每次请求的问题。questions 中的内容(包括为单个问题提供的图像)不属于可复用的前缀。
默认情况下,Decisions 在共享 input 的末尾设置隐式缓存断点。现有请求无需修改请求体即可使用缓存。可复用的前缀必须至少包含 1,024 个 Token,问题内容不计入这一阈值。要复用缓存,请确保各次请求的前缀完全一致。
使用 prompt_cache_key 可按调用方提供的键划分缓存的复用范围。要控制缓存边界,请将 prompt_cache_breakpoint: {"mode": "explicit"} 添加到共享 input 中的文本或图像内容项。将 prompt_cache_options.mode 设为 "explicit" 后,只会使用已标记的边界。在显式模式下,未标记任何边界的请求不会使用提示词缓存。问题指令不支持断点。
查看 usage.input_tokens_details.cached_tokens 可了解缓存读取的 Token 数,查看 usage.input_tokens_details.cache_write_tokens 可了解缓存写入的 Token 数。两项计数都已包含在 usage.input_tokens 中,请勿再加到总数上。有关缓存概念,请参阅提示词缓存指南。有关支持的请求参数,请参阅 Decisions API 参考。
使用 GET /v1/organization/usage/decisions 获取组织的 Decisions Token 用量和请求数。请使用具有 api.usage.read 权限的管理员 API 密钥进行身份验证。
选择时间范围和每个统计区间的长度,然后按项目、API 密钥或模型筛选结果或对其分组。num_model_requests 字段统计请求次数,即使一个请求包含多个问题,也只计为一次。有关筛选和分页,请参阅 Decisions 用量参考。
使用 gpt-6-luna 时,未缓存的输入按每 100 万个 Token 0.10 美元计费。命中提示词缓存的输入享受折扣,写入缓存也会产生费用。缓存读取和写入费率与标准 gpt-6-luna 提示词缓存费率一致。输出 Token 不收费。
区域处理附加费和长上下文输入的计费倍率同样适用。上述费率适用于 /v1/decisions。其他使用 gpt-6-luna 的请求按相应的模型和处理层级价格计费。
Decisions API 为符合条件的客户提供零数据保留(ZDR),并支持符合 HIPAA 要求的使用场景。所有受支持的 API 区域均提供数据驻留。美国和欧洲(欧洲经济区及瑞士)支持区域处理。有关资格要求、所需协议和限制,请参阅数据控制。
将语音接入 Decisions,即可根据口头请求选择操作,或在用户或 GPT-Live 说话时作出响应。