
GPT-Live 让用户能按自然交谈的节奏使用软件:随时插句话、换个方向,或是边说边理清思路。级联式语音系统需要依次经过独立的转写模型、语言模型和语音生成模型处理语音,而 GPT-Live 可以边听边说。什么时候接话,什么时候打断,和说什么同样重要,有了这种能力,交流也就更自然了。
在本文中,Juno、Picsart、Treater 和 Weekend 将亲自讲述如何使用 GPT-Live 开发产品,并分享它们在以下方面学到的经验:
- 利用线上实时数据改进通话体验
- 找到让人信赖的声音
- 与后台智能体协调工作
- 编排多个语音智能体,让它们协同配合
我们将了解这些团队如何通过提示词、工作流和用户反馈打磨产品。其他开发者也可以在自己的应用中尝试这些做法。
初创公司的故事
Juno:用 GPT-Live 让患者与语音伙伴自然交谈
作者:联合创始人兼首席执行官 Marshall Gould、联合创始人兼首席技术官 Isaac Tolley
我们正在开发 Juno,一款面向长新冠、体位性心动过速综合征(POTS)、埃勒斯-当洛斯综合征(EDS)等慢性病患者的个人健康助手。
我们想做什么
只有自己患上慢性病,才能真正体会它带来的负担。除了严重的症状、疲劳、一次次就诊,以及不清楚自己到底怎么了的焦虑,还有数不清的琐事:记得按时续药、阅读最新研究、追踪症状,还要弄清症状和每天都在变化的数百个因素之间的关系。在这一切之外,人还得设法照常生活。
对慢性病患者,尤其是精力受疾病限制的人来说,追踪工具本身也是负担。手动记录太耗精力,很多人即使知道这些应用有帮助,也坚持不下去。
语音交互彻底改变了这件事。只需简单说一句话,Juno 就能同时帮您记下好几件事。
语音交互还有哪些难点
即便直接使用,语音模型的表现也已经相当惊艳。说话是人与人最自然的交流方式,但要让模型也做到这一点,我们还在摸索。有几个难题仍待解决:
- 如何在记录症状或调取上下文时保持对话流畅。
- 如何把文字聊天中的记忆带入语音对话,又不让对话卡住。
- 如何让长时间的对话持续下去。
我觉得语音模型有点像水母。它们反应敏捷,却没什么方向感。用户刚说了什么,它们就顺着往下漂,还经常停下来请用户确认。文本模型更主动,因为它们能利用的上下文广得多,用户也不用每次都重新说明自己的情况。用语音模型时,就得由您来把握方向。
我们如何改进语音智能体
在对话中记录信息、调取记忆
请大多数语音智能体帮忙做件事,它们会把任务发给工具,然后等结果。这段等待时间里,通话双方都没声音。GPT-Live 可以把工作委派给另一个智能体,但在结果返回之前,对话会一直停在那里。在我们的第一个版本中,每 5 通电话就有 4 通至少出现过一次这样的停顿:先说一句“请稍等”,接着就是大约 10 秒的沉默。
我们的解决办法很简单。每轮对话结束后,一个小而快的模型(OpenAI 的 Decisions API)都会在后台回答两个问题:
- 有没有需要记录的信息?如果有,属于哪一类?
- 用户的历史记录中,有哪些信息和此刻的对话有关?
比如,您说“记一下我头疼”,Juno 马上就会收到已记录的通知,实际保存则在后台完成。保存速度很快,如果您下一轮就问起刚才的头疼,记录已经存好了。
第二个问题的答案用来处理记忆。我们只把历史记录中与当前对话有关的信息放进下一轮的上下文。这样筛选很重要,因为语音模型能处理的上下文比文本模型少得多,得仔细挑选要放进去的内容。
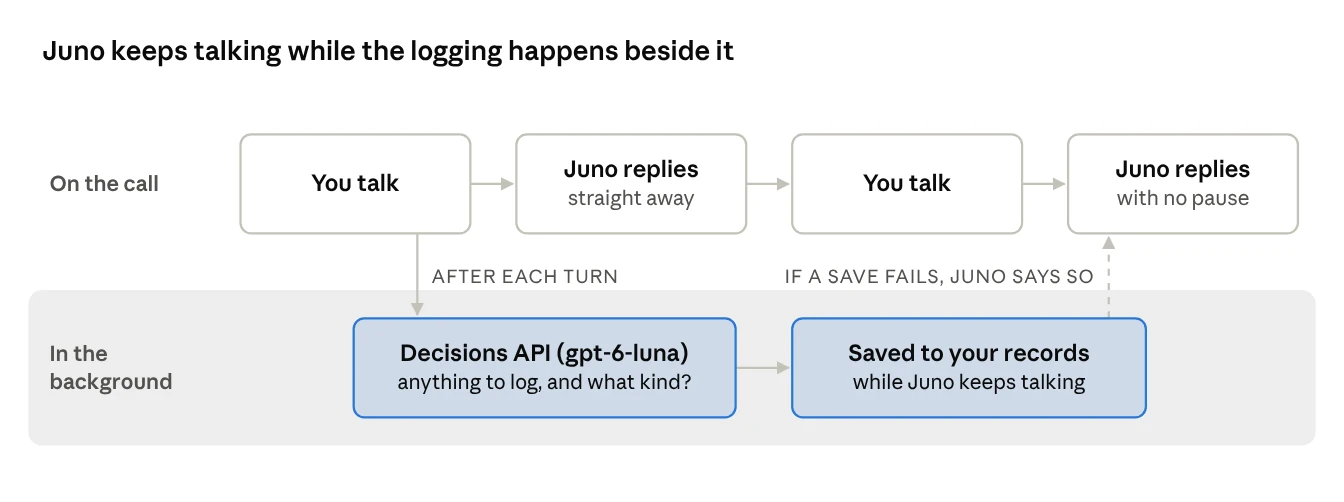
这样做之后,转交给文本智能体的次数减少了 40%,一次测试通话中最长的静默时间也从 9.3 秒降到了 3.2 秒。原本让人尴尬的等待,听起来只是一次自然的停顿了。
长对话
长对话也需要这份细心。还记得水母的比喻吗?模型自己没什么方向感,需要引导。我们用一个负责引导的智能体更新通话上下文。这样聊到第 100 轮时,Juno 仍然知道第一轮说了什么。如果聊不下去了,它也知道接下来可以提起什么。要支持长对话,就得自己构建这套机制。这件事值得做,因为聊得久了,那些帮助人们了解自身健康状况的规律和趋势才会显现出来。
通过真人测试找到适合 Juno 的声音
另一个难题是设计出听起来恰到好处的声音,这说起来容易,做起来难。GPT-Live 的默认声音比前代模型进步很大,但仍有人说听起来像 AI。我们能不能做出一种声音,让 10 个人里有 9 个都觉得合适?
在一次由慢性病患者参加的焦点小组访谈中,大家告诉我们,Juno 的语速稍慢,语气听起来还有点居高临下。这个反馈很重要,于是我们开展了一项研究来改进声音。
我们使用 GPT-Live 的根据提示词生成声音功能,用简短的文字描述设计了几种新声音,并请 290 名患有慢性病的美国成年人将它们与现用声音进行比较。所有人听的都是相同的三句话。他们为每种声音打分,再分别选出最喜欢的、最不喜欢的,以及疲惫不堪时最想听到的声音。
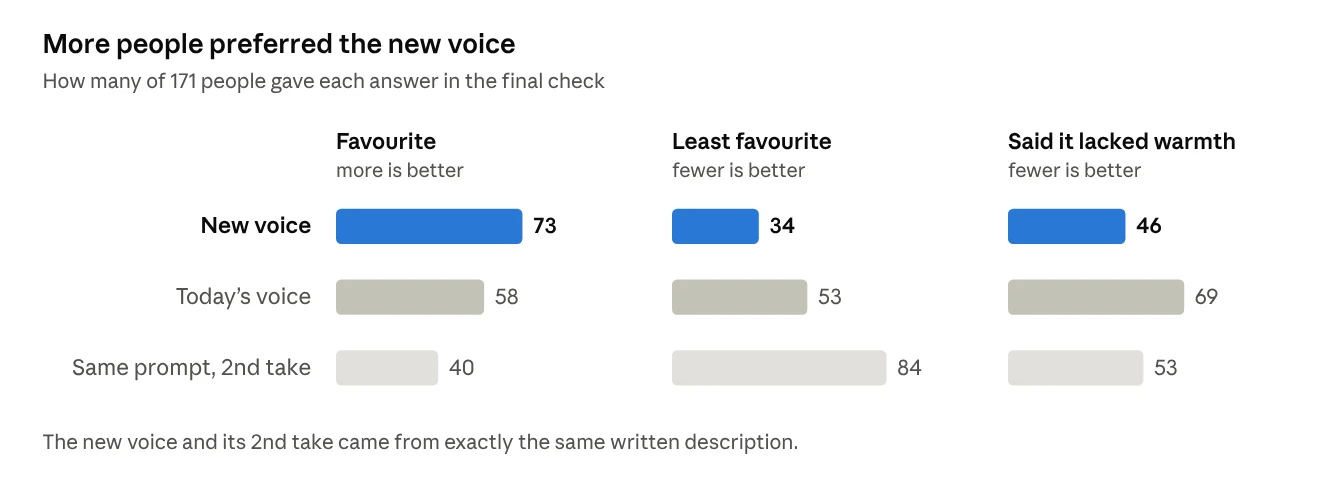
我们做了五轮小规模测试,每轮都保留表现最好的声音,重写其余声音的描述。随后,我们又请了 171 位新参与者,将现用声音和表现最好的两种新声音作比较。
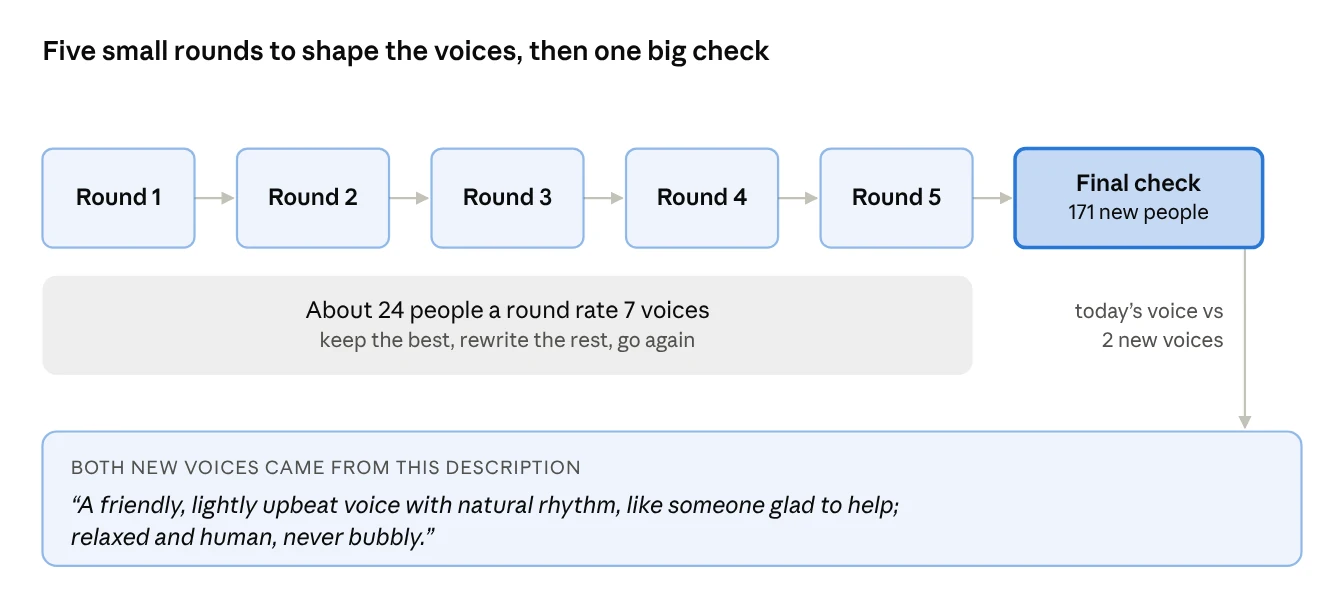
最终胜出的是根据上图中的描述生成的一种新声音。在最终测试中,与现用声音相比,更多人把它选为最喜欢的声音,更少人把它选为最不喜欢的声音,觉得它缺乏温暖感的人也少了很多。
这项研究有其局限:参与者只听了三句话,各种声音的得分也很接近,研究环境和真实通话毕竟有差别。接下来,我们会让首次来电的用户在真实通话中体验新声音,看看第二天回来的人会不会更多。
疲惫时想听什么声音?
我们还问了大家:累得筋疲力尽时,最想听到哪种声音?在这个问题上,现用声音略微领先。差距虽小,却让我们想到一个更大的问题:为什么我们一定要找出一种处处适用的完美声音?

我们自己的声音也不是一成不变的。不同场合下,我们会调整语气、语速和音量。那么,如果 Juno 能根据您的感受调整说话方式呢?当对方的语速和音量与自己相近时,人们往往更容易信任对方的声音(Levitan 等,2016 年)。而有了 GPT-Live,我们已经可以在通话过程中改变 Juno 的说话方式。我们将在后续研究中检验这种做法。您可以在 junocompanion.com/voice-study 试听所有声音,查看完整结果。
亲眼看到语音交互为慢性病患者带来新的可能,让他们的日常生活轻松了这么多,我们深受鼓舞。GPT-Live 是一个出色的基础模型,在它之上做一些小调整,就能带来切实的改变。
关于作者和公司
我是 Juno 创始人 Marshall Gould。我和三位研究人员 Isaac Tolley、Sean Lees 和 Dawid Wraga 一起设计了 Juno 的声音。Juno 是一家以使命为先的 AI 公司,致力于帮助人们管理慢性病、更好地带病生活。我们团队的大多数成员自己也是慢性病患者,这也是我们引以为豪的一点。如今已有数十万人使用 Juno,我们也希望您能加入,一起把这件事做下去。详情请见 junocompanion.com。
Picsart:让语音对话与智能体任务保持同步
作者:Picsart 高级主任工程师 Dmitry Ivanov
我们想做什么
一次通话结束时,创作可能还在继续。我们希望用户在任务运行期间可以自然地与 Picsart AI 智能体交谈,也可以先挂断,等结果出来再回来。创意未必一开始就成形。聊聊想营造的氛围或大致方向,有时比写出一条精确的要求更容易。
GPT-Live 是第一项让我们有能力实现这一设想的技术。它支持自然的实时对话,用户除了能口述命令,还能和智能体边聊边完善想法。基于这项技术,我们得以把这样的对话体验带给 Picsart AI 智能体的用户。
因此,我们把语音设计为与智能体交互的独立入口,同时让它与文字聊天共用同一个对话线程。我们选择用 GPT-Live 处理实时对话,由我们的智能层负责推理、工具调用、规划,以及处理已保存的上下文。
解决方案:将对话与任务执行分开

如图所示,应用将任务发送到智能层,再把上下文和答案返回给 GPT-Live。应用通过共享的 WebSocket 连接发送任务、接收进度和结果。语音和文字交互共用同一个智能体、同一套任务流程和审批规则。
我们的语音网关使用所选智能体的指令建立会话。浏览器与 OpenAI 之间直接通过 WebRTC 传输实时音频。即使通话结束,已提交的任务仍可继续运行。
向智能体发送请求
当 GPT-Live 请主智能体处理某项工作时,我们会把用户的口头请求、近期消息和附件一并发送到当前智能体所在的对话线程,并标记为语音模式。我们在提交时就保存这份上下文,这样,用户之后说的话就不会覆盖已经排队的请求。
我们要求主智能体写出适合说出口的回答:简短、口语化,一次只问一个问题,语音端已经确认过的内容不再重复。还要说清楚打算做什么、需要多少费用,以及哪些事项需要审批。
语音端需要知道什么,又该说出什么
我们通过三个通道向语音端提供信息:
| 通道 | 发送的内容及其在语音端的用途 |
|---|---|
| instructions | 智能体的身份、何时请求智能体执行任务的规则,以及对话规则 |
| thinking | 近期消息、任务状态、选定的工具数据和用户操作,作为无需说出口的上下文 |
| commentary | 需要说出口的答案、问题和重要任务进展 |
thinking 通道传递的是来自应用的上下文,不包含主智能体的私有推理过程。转发选定的工具结果前,我们会移除常见的凭据字段和二进制数据,限制结果大小,并标出不完整的结果。
如果用户在屏幕上的操作已经向智能体发出了请求,我们就通过 thinking 通道告知语音端。这样,语音端可以确认收到操作,无需再次询问或重复提交。
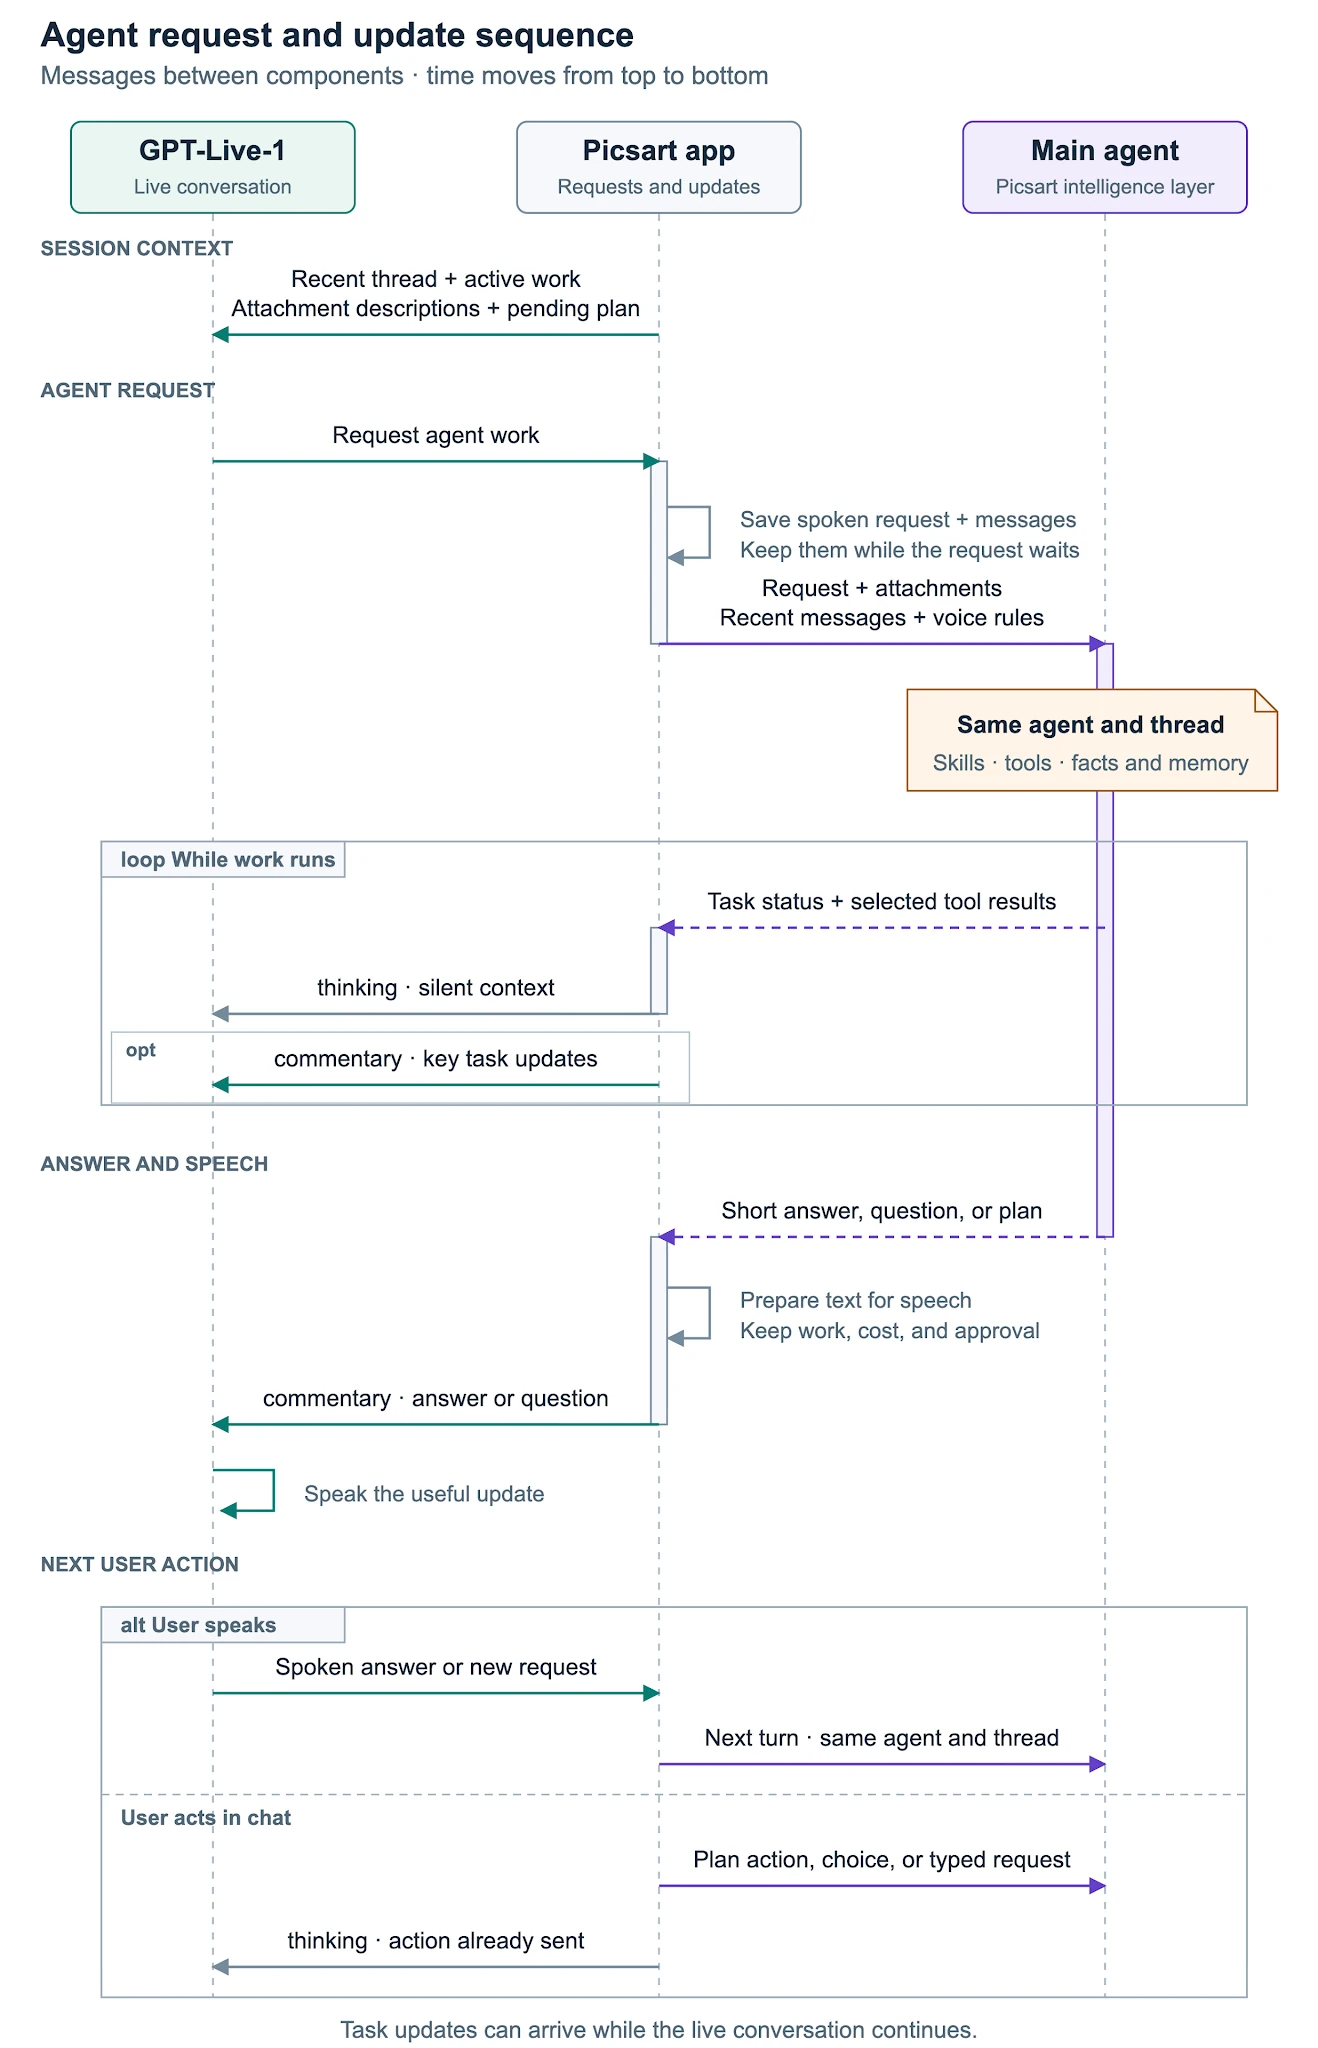
常规工具操作无需播报。计划开始执行或任务完成时,语音端才会通知用户。对于流式返回的答案,我们先把内容拼成完整的句子,等对话出现停顿再发送到语音端。最终答案到达时,已经发过的文字不会再重复,但更正内容和需要用户审批的问题仍会转达。
通话开始时载入什么,结束后保留什么
会话指令定义的是智能体的角色。至于它记得用户的哪些事情,则另有来源。通话开始时,我们会载入近期消息、附件描述、正在执行的任务和待审批事项,让语音端能接着用户上次离开的地方继续。
长期记忆由主智能体管理。启用记忆后,智能体可以使用线程历史记录、摘要、已保存的事实,以及用户或项目的偏好设置。
如果用户说“用我们之前保存的风格”,主智能体可以去查找,也可以先提问澄清,然后把答案发回语音端。如果记忆不可用,通话仍可继续,只是可用的上下文较少。
对话线程保存的是发给智能体的请求和随附消息,不会逐句记录所有口头交流。用户在闲聊中提到的偏好,只有在主智能体收到并保存后才会留存。
工作何时开始、继续或停止
智能体说明计划后,我们才通过语音向用户转述。只有智能体确认已经开始执行,我们才会告诉用户工作正在进行。我们会一并说明拟执行的工作、费用,并询问用户是否批准。用户补充上下文,并不代表授权执行更多工作或支出更多费用。
如果漏掉了一次更新,我们会重新获取现有任务的状态,无需重启任务,也无需再次播报结果或重复询问是否批准。
打断语音或离开通话都不会取消工作。停止任务需要另行提出请求,而且可能无法中止已在执行的操作。新请求会保留提交时的上下文,等当前轮次结束后再处理,不会改变正在运行的任务。
我们的心得:让语音端知道的比说出来的多
这次集成给我们留下了几条实践经验:
- 让主智能体准备适合语音表达的答案。
- 在每个请求发出时保存其上下文。
- 让语音、文字和屏幕操作共用对话线程和规则。
- 将对话与任务执行分开。
关于 Picsart
Picsart 是一个 AI 媒体制作与分发平台。全球超过 1 亿创作者和企业在这里制作、推广内容,并通过内容获得收入。
14 年多来,Picsart 一直帮助新一代创作者用视频讲故事,从制作视频、扩大制作规模,到如今通过视频获得收入。Picsart 将直观的设计工具、AI 图像与视频创作能力以及 MCP 和 CLI 功能结合起来,让创作者可以在自己惯用的工作环境中使用这些工具。如今,Picsart 的月活跃用户已超过 1 亿,累计下载量超过 25 亿次。越来越多的创作者能够自主开展大规模创作,以内容表达自我、扩大影响力、开创自己的事业。
Treater:调整语音智能体,让通话取得更好的成效
作者:联合创始人兼首席执行官 Britt O’Daly、联合创始人兼首席技术官 Ayaz Hafiz、软件开发人员 Sayd Agzamkhodjaev
通过对话达成目标
在与一家人力资源机构通话时,我们的语音智能体和机构负责人聊起了招聘人员使用日程安排软件时遇到的难题。
负责人正解释之前的解决方案为什么不管用,智能体却总是插嘴,说“嗯嗯”“对,对”。最后,负责人提前结束了对话:
这样吧,你给我发封邮件就行。
智能体听懂了负责人的意思,但频频插话让这次交流的体验很差。销售人员会从这种经历中吸取教训,调整今后的沟通方式。我们希望智能体也能这样做。
在 Treater,我们开发的 AI 智能体帮助企业通过电话、电子邮件和短信联系合作伙伴并与之开展工作。我们希望智能体凭借出色的对话体验帮助客户达成目标。为此,我们构建了一套学习系统,用于评估真实对话、发现可改进之处,并根据客户实际取得的成效检验新的智能体配置。
下面的演示展示了我们的智能体如何与多方协调,为一家杂货店补上缺货的商品。
在实际工作中学习的智能体
使用 GPT-Live 之前,我们把大量时间花在搭建和维护定制语音技术栈上。采用 GPT-Live 后,我们几乎移除了原来的整套组件,改用简单的提示词,效果反而更好。对我们的客户来说,较长的对话往往伴随着更好的结果。自采用 GPT-Live 以来,我们观察到,对话时长的中位数增长了 26% 至 30%,第 90 百分位数的增幅最高达到 40%。
客户关心的目标,其达成率平均提高了 6 个百分点。
这样,我们可以把更多时间用在真正能“让自家的啤酒更好喝”的事情上:让智能体在不断变化的工作环境中学习和适应。就像人在岗位上不断成长一样,我们希望智能体也能在实践中学会什么才算做得出色。
为了改进智能体,我们在多个维度(声音、提示词、说话节奏、可用工具)上为每个智能体抽取不同的配置,并对每次对话打分。评分标准既有我们制定的指标(情绪倾向、采取了哪些步骤),也有客户制定的指标(是否遵循偏好、目标完成了多少)。我们使用多臂老虎机算法,将更多流量分配给得分高的配置,迅速淘汰表现不佳的配置。
离线评审系统会读取以往的通话记录,提出新配置。我们用过去的对话回放测试每个方案,预测它在生产环境中的奖励,筛掉预计不会带来实质改进的变更。其余变更交由客户审核。如果客户希望自动上线,也可以直接发布。
有了 GPT-Live,许多配置都很容易调整。语气、节奏、是否呼应对方的情绪状态、措辞要多正式、多频繁地用简短回应表示自己在听,这些以前都需要协调语音技术栈中的多个组件。现在,大多只需在提示词中写上一行,比较不同版本的效果也更容易了。
演示:我们的智能体从与那位人力资源机构负责人的通话中学到了什么?
Treater 智能体如何改进
Start with a goal
A software company wants demos with staffing agency owners. The catalog starts with one version of the agent.
这个演示对开头提到的业务场景做了匿名化和简化处理:一家公司从基础版智能体入手,通过电话与人力资源机构预约产品演示。
- 系统发现改进机会: 离线评审系统分析了奖励较低的通话,发现了一些反复出现的问题。例如,在 20% 的通话中,智能体表示“在听”的应声盖过了负责人的话。系统提出了四种新配置。
- 系统提出改进方案: 我们用历史通话模拟测试每个方案,并按生产环境的标准给出奖励。语速较慢的版本得分很低,立即被淘汰,其余版本经过审核后获批。
- 在生产环境中评估: 系统按预期奖励向各个新版本分配流量。一天之内,B 版本就接手了大部分通话。C 版本始终没追上,在第 3 天被停用。第 2 天加入的 D 版本到第 3 天开始时已占据主导地位,最终承担了约 90% 的通话。A 和 B 仍保留少量流量,以便应对环境变化。每 100 通电话成功预约的演示从 3.0 场增至 4.3 场。
重要的是,这套系统具有层次结构。对共享执行框架的改进能惠及每一种应用场景,而一个工作流积累的经验也可以成为其他类似工作流的起点。
我们牢记的几条经验
- 一切都是有待验证的假设。有个客户希望智能体一开场就介绍即将推出的促销活动。我们试了另一种开场白,先谈产品近期售出率的提升,通话效果好得多。这是我们见过成效最明显的改进之一。
- 用能充分反映业务成效、真正对业务有影响的结果来设定奖励。如果需要很长时间才能评估这些结果(例如签下一笔新订单),就值得找一些能快速衡量的结果(例如约好下一次会面)来设置奖励,但要验证两者确实相关。
- 投入资源,让智能体所处环境中的实际情况可观测、可衡量。只有在模拟和基准测试能准确反映真实分布时,它们才有意义。
- 使用 GPT-Live 时,可以试着描述想达到的效果,减少对每一步做法的硬性规定。只要有上下文和总体准则,GPT-Live 智能体就能很好地应对变化,无需完整的话术脚本。
借助 GPT-Live,我们一次又一次让对话质量跃上新的台阶。我们很期待看看,再往上走十级会是什么样!
关于 Treater
Treater 通过与现实中的人沟通来落实您的业务目标,认真对待每个机会,就像它是您最重要的机会一样。我们的平台上有数千个不同的智能体,承担了数十万通电话。过去一年,通话量每月环比增长 25%。我们的客户既有上市企业,也有快速成长的初创公司。详情请见 trytreater.com。
Weekend:《Wit’s End》如何让两个 GPT-Live 角色同场对戏
作者:Weekend 高级软件工程师 Kevin Shen、联合创始人兼首席技术官 James Wilsterman
我们想做什么
我们的游戏 《Wit’s End》 是一款以语音交互为主的奇幻桌游。AI 游戏主持人 Sir Bart 负责讲故事、执行规则,玩家只管开口说话。GPT-Live 的全双工音频让人感觉真的围坐在桌旁:玩家可以插话、开玩笑、争论,话还没说完,Sir Bart 就能作出反应。
角色配音曾是个短板。一个 GPT-Live 会话只能用一种声音说话,所以无论是城门口粗声粗气的守卫队长,还是酒馆里惊恐的老妇人,听起来都和旁白一样。我们希望每个场景中的主要角色都能用自己的声音说话,表现出自己的个性,同时保留游戏最重要的特点:玩家想说什么都可以,故事也依然能走到结局。
现在,一幕戏是这样展开的。冒险小队来到 Timberfall 的城门,Sir Bart 交代完场景就停下来:“一队神情肃穆的守卫正在站岗。队长走上前来,一手按着剑,上下打量着你们。”接下来,队长 Dmitri 用低沉沙哑的声音开口。他正在追捕一个叫 Jade 的叛徒,而小队成员的相貌恰好符合她的同伙的描述。一位玩家和他争辩,Dmitri 也据理力争。另一位玩家悄悄塞给他一枚金币。这时 Sir Bart 插话宣布开始掷骰,讲述行贿的结果,然后把发言权交还给 Dmitri,让他作出反应。
解决方案:两个声音,一位导演
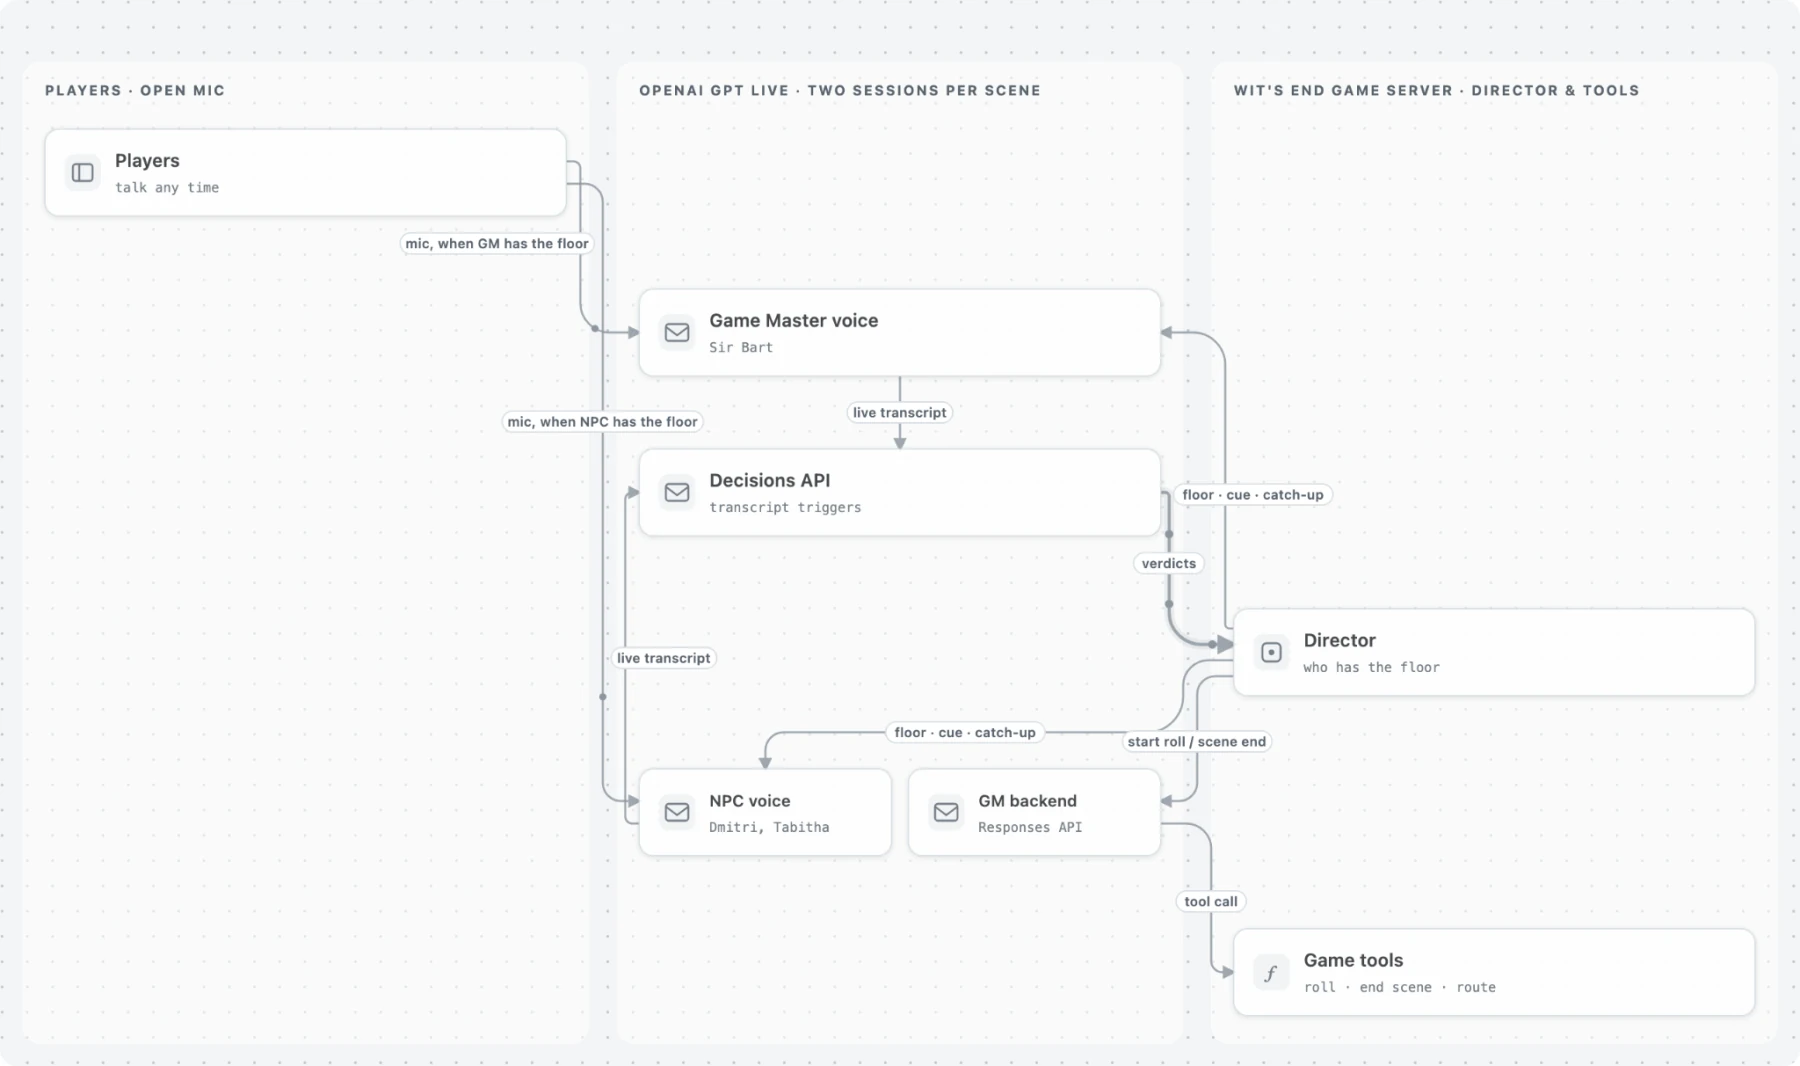
谁来发言:Decisions API 根据两个会话的转写内容作出判定,告诉导演接下来该谁说话。导演在两个声音之间切换发言权,并在游戏主持人的后端发起掷骰和场景收尾。
每个场景都会并行运行两个 GPT-Live 会话:一个扮演 Sir Bart,另一个扮演本场景的角色(城门口是 Dmitri,酒馆里是 Tabitha)。每个会话都有自己的提示词和自定义声音。游戏服务器上的导演程序决定谁有发言权,只有当前持有发言权的会话能听到玩家说话。两个会话都设有 Decisions API 转写触发器,让导演知道对话中发生了什么。只有游戏主持人的后端(一个 Responses 模型)可以调用游戏工具,处理掷骰、结束场景和选择路线。
两种个性,同一个故事
我们把每个角色的信息分成两部分:角色独有的内容,以及角色之间共用的内容。
每个角色的个性都写在自己的提示词里。
每份提示词也会描述角色的声音,用的就是最初设计这个声音时的那段文字。
共享场景示例
场景信息是共享的。Sir Bart 和场景角色看到的是同一个冲突、同一个解决方式和同一组剧情要点,每个要点都注明该由谁说。Dmitri 介绍自己,说出他正在追捕谁;Tabitha 告诉小队,Jade 会在哪里与他们碰面。只有等每个剧情要点都由对应的角色说出来,游戏才允许当前场景结束。
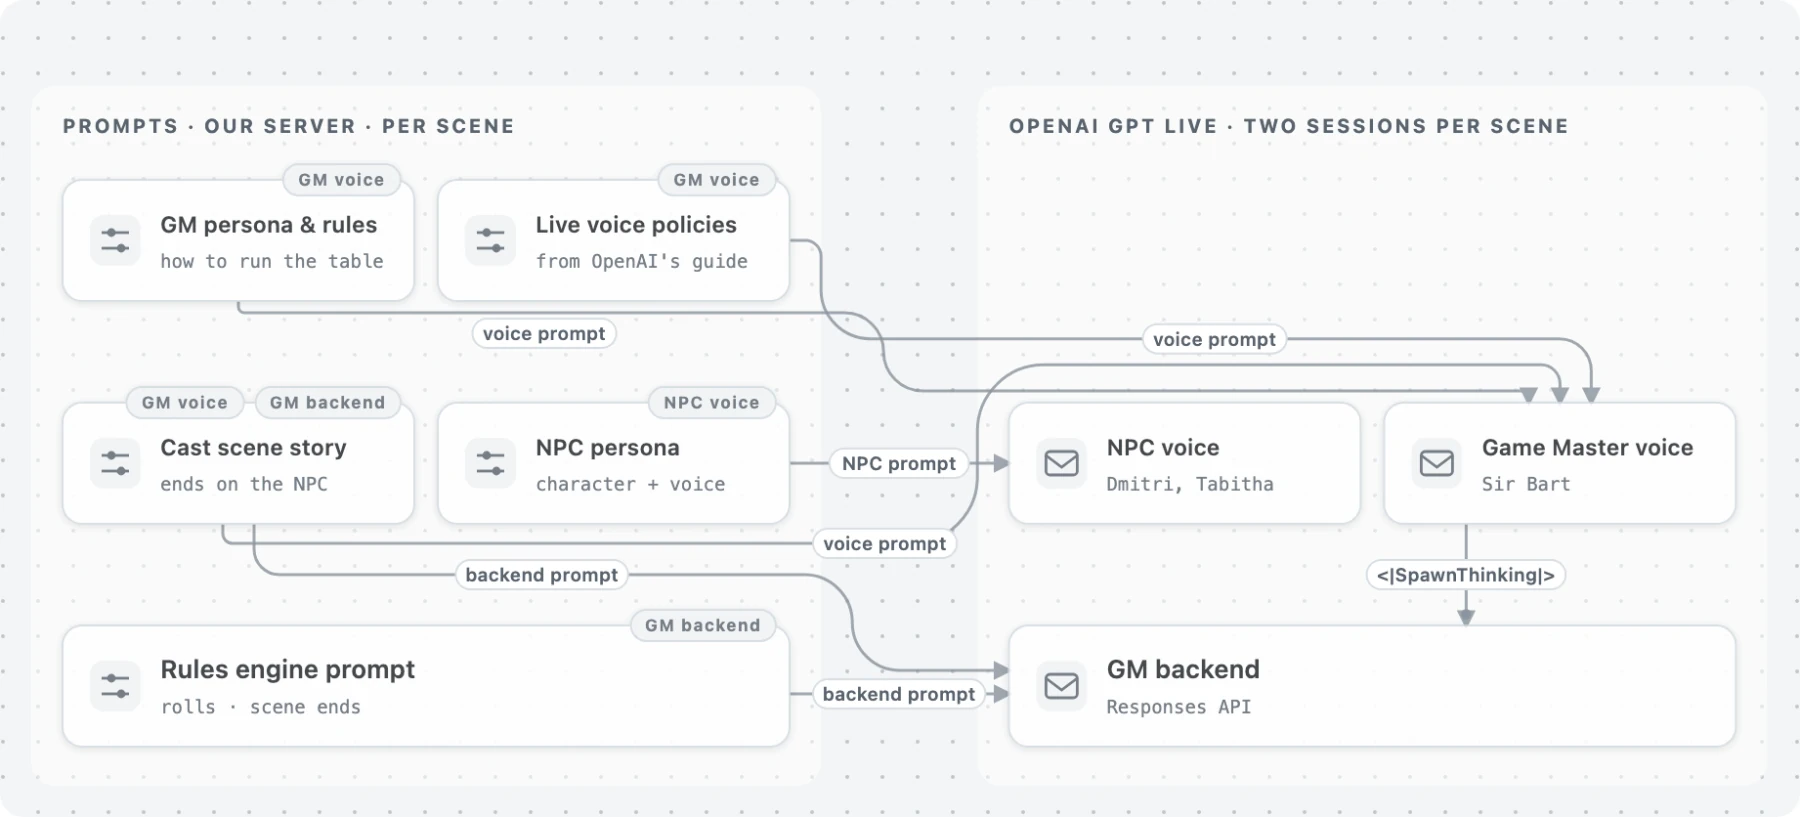
提示词结构:Sir Bart 的语音会话与后端共享场景剧情,场景角色则有自己的人设提示词。
角色提示词节选
你是实时语音场景中的一名演员。旁白负责描述这个世界,
你始终只以自己的角色身份开口,用第一人称说话。
- 不要作旁白,不要描述自己的动作或声音,
  也不要替旅人或旁白说话。
- 有风险的尝试能否成功,一律不能由你决定。
  只用一句简短的话作出反应,然后停下来,由旁白裁定结果。
- 只有在旅人对你说话,或发言权交给你时,才能开口。
导演如何决定下一个发言者
导演本身不生成语音。它根据 Decisions API 对不断传入的转写片段作出的判定,识别玩家在对谁说话、某项行动是否需要掷骰,以及旁白或角色的最后一句话是否意味着该让另一方接话。

随着玩家继续说话,判定也会变化。要确定玩家在对谁说话,导演会等到本轮结束、判定稳定后再决定。但只要识别出有风险的行动,就会立即将其交给游戏主持人。
接下来谁发言
| 情况 | 接下来谁发言 |
|---|---|
| Sir Bart 讲完旁白,接话提示的判定分数达到或超过 0.6,或者他的台词以表示说话的动词收尾(“Tabitha 在你们身后喊道”) | 场景角色 |
| Sir Bart 持有发言权时,有玩家对场景角色说话 | 场景角色,同时收到玩家说的那句话,以便回应 |
| 玩家尝试有风险的行动,例如行贿、撒谎、偷偷溜过去或打斗 | Sir Bart 立即接话,必要时在对方说到一半时介入。导演在 Sir Bart 的后端发起掷骰,他讲述结果,然后交还发言权 |
| 玩家向旁白提问,或描述自己所扮演角色的动作 | Sir Bart |
| 玩家之间交谈 | 谁都不接话。当前持有发言权的一方会收到一条仅本次生效的提示,让玩家继续聊 |
| 场景角色说出了结束自己这段戏的台词(“那就过去吧。低着头,别引人注意。”) | 角色说完后由 Sir Bart 接话。导演在 Sir Bart 的后端启动场景收尾流程 |
| 获得发言权的一方沉默了 2.5 秒 | 仍由同一方发言,系统会再提示一次 |
如何交接发言权
每次交接发言权时,导演会做四件事:
- 将失去发言权的会话静音,要求它停止发言,并丢弃已排队的音频。
- 通过
session.thinking.append把新发言者错过的内容作为无需说出口的上下文补给它。同样的台词也会送入这个会话的 Decisions 上下文,让触发器依据相同的对话历史作出判定。 - 解除新发言者的静音,并提示它接话。
- 暂时关闭玩家的麦克风,直到新发言者说完第一句话,最长不超过 8 秒,以免玩家的声音盖过这次交接。
由于角色会话已经在运行,从交接到听见第一个声音平均只需 0.84 秒;如果新建会话,则需 1.54 秒。
让游戏剧情走向结局
各个声音可以即兴发挥,由应用决定事情何时发生。
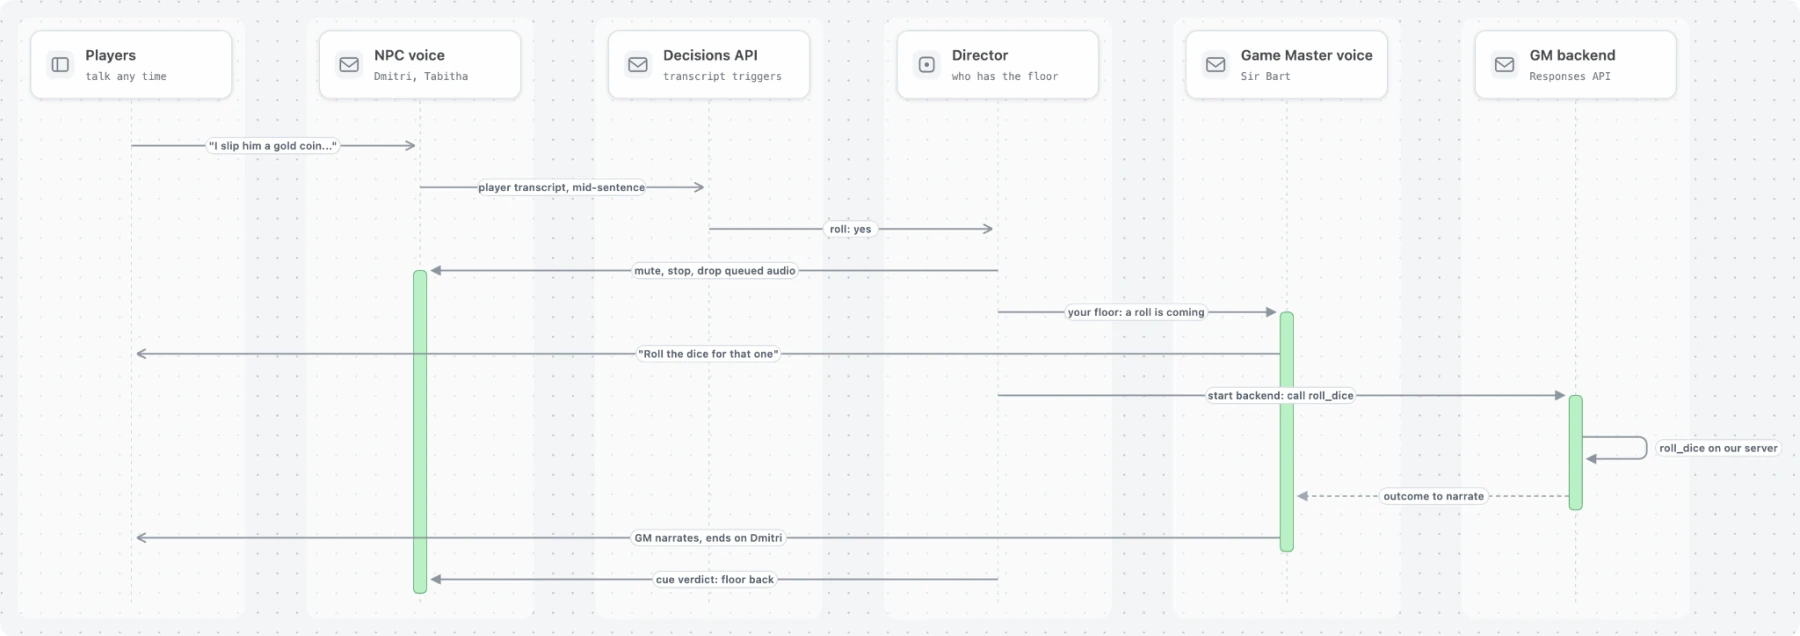
Dmitri 持有发言权时,玩家试图行贿。玩家一句话还没说完,掷骰判定就到了。导演把发言权交给 Sir Bart,并在他的后端发起掷骰。等 Sir Bart 讲完结果,导演再根据接话提示的判定把发言权交还给 Dmitri。
- 由导演直接发起掷骰和场景收尾。 一次试玩中,Sir Bart 说:“这可得掷个骰子才行。”但他没有把这件事交给后端,所以根本没有掷骰,他就自己编了个结果。现在,导演会直接在他的后端发起一次响应。后端运行时,语音端先说一句简短的过渡语,随后再讲述结果。
- 用骰子决定场景的结果。 第 1 幕在一次掷骰判定成功后结束。如果还没掷过骰子,Dmitri 就已经让步,导演仍会发起掷骰,判定玩家这次尝试的结果,不会直接结束场景。
- 角色可以演完自己的部分,由游戏主持人为场景收尾。 当 Tabitha 告诉小队 Jade 会在精灵祭坛与他们碰面时,导演把发言权交给 Sir Bart。他的后端将场景标记为已完成,随后他向玩家介绍两条可选的去路。
我们的心得
- 一次只让一个会话听见玩家。 之前两个系统同时听的时候,每句测试台词都会得到两份回答,而且经常互相矛盾:Dmitri 拒绝收下贿赂,游戏主持人却说他把钱揣进了兜里。
- 只将会话静音,还不足以让它停下来。 要明确要求它停止发言,并丢弃排队的音频。等它重新获得发言权时,也要明确解除“保持沉默”的要求。有一次,我们忘了对游戏主持人解除这条规则,结果一整幕里谁和他说话他都不答。
- 让每个声音的会话随时待命。 声音在会话启动时就已确定,因此每种声音都需要单独的会话。在场景开始时就启动角色会话,每次交接都能省下约 0.7 秒,让角色自然接上话,免去尴尬的停顿。
- 在恰当的时机根据判定采取行动。 玩家还在说话时,判定就会陆续返回。最后一次判定在玩家停止说话后到达,延迟中位数为 0.19 秒。一旦识别出有风险的行动,立即交给游戏主持人;至于一句话是对谁说的,则等到这一轮结束、判定稳定后再决定。
- 把是非问题写成真假条件,用真实台词设定阈值,再留一条简单规则兜底。 对于“Should Dmitri speak next?”,用真假条件来判定时,12 次中答对 11 次;作为二选一问题时,只答对 8 次。阈值设为 0.4 时,“You’re going to have to roll the dice for that one”被当成了接话提示,掷骰还没结束,发言权就交给了 Dmitri。真正的接话提示得分都在 0.94 及以上,因此我们采用 0.6 作为阈值。而“Tabitha calls after you”的得分只有 0.04,所以我们还会检查表示说话的动词,以便识别旁白说到角色该接台词处就停下的情况。
- 每个结果都由一方负责。 只有游戏主持人的后端可以调用工具,掷骰和场景收尾则由应用发起,语音会话无权启动。这样,每个角色都可以自由发挥,同时遵守游戏规则。
关于作者和公司
Weekend 团队开发了《Wit’s End》,一款以语音交互为主的奇幻桌游。AI 游戏主持人负责推进故事,玩家只需开口说话,在浏览器和电视上都能玩。前往 witsend.ai 即可体验。
Weekend 原名 Volley,专为电视开发声控游戏,让一家人看电视时也能聚在一起,开口就能玩。旗下超过 25 款游戏,包括《Jeopardy!》《Wheel of Fortune》《Song Quiz》和《Wit’s End》,可在 Roku、Fire TV、三星和 LG 电视上运行,已有超过 3,000 万个家庭玩过。Weekend 的投资方包括微软旗下的 M12、Lightspeed Venture Partners 和 Y Combinator。
语音智能体的下一步
语音交互的下一步,除了让对话更自然,还要让软件能在执行任务的同时继续听用户说话,在不同交互界面之间传递上下文,并能协调多个声音,让它们始终跟得上对话。GPT-Live 能边听边说,有了这个基础,开发者就能让软件配合自然交谈的节奏,用户也不用等轮到自己才能开口。
这四个故事展示了这些能力在实践中如何实现:Juno 请实际用户测试声音,Picsart 让对话与后台工作保持同步,Treater 从真实通话中学习,Weekend 则在掌控游戏进程的同时,让每个角色都拥有自己的声音。
GPT-Live 为人们与软件交流提供了一种直观的方式,也拓展了智能体能做的事。人们可以在交谈中打磨创意,为正在进行的工作指明方向,也可以走进故事,影响接下来的剧情。当对话成为软件运作方式的一部分,这些项目只是开发者所能创造的体验的开端。
要开始构建自己的语音体验,请参阅 GPT-Live 入门指南以及任务委派和工具文档。