
使用开源库 Promptfoo 对 AI 应用和智能体进行评估和红队测试。您可以定义测试用例和检查项,衡量应用的行为表现,比较不同的提示词或模型,并排查失败原因。您还可以使用对抗性输入探测应用,发现安全风险。
Promptfoo 是 OpenAI 的一部分。
本指南从一项小型评估入手。您可以在终端中运行翻译示例,也可以让 Codex 为您的应用设置评估。
从 CLI 开始
安装 Node.js 22.22.0 或更高版本后,选择一种方式运行 Promptfoo 示例。该示例使用测试用例比较不同模型的翻译结果:
npx promptfoo@latest init --example getting-started
cd getting-started
请在已激活的 Python 3.10 或更高版本的虚拟环境中运行以下命令。pip 封装包也需要 Node.js 22.22.0 或更高版本。
pip install promptfoo
promptfoo init --example getting-started
cd getting-started该示例会创建 promptfooconfig.yaml,其中包含翻译提示词、模型提供方和测试用例。每个测试用例都包含一个断言,用于检查输出中是否含有预期的短语。在终端中设置 OpenAI API 密钥时,请将占位符替换为您的密钥:
export OPENAI_API_KEY="<your-api-key>"运行评估,然后打开结果查看器。评估会调用模型,并产生 API 费用。
npx promptfoo@latest eval
npx promptfoo@latest view
promptfoo eval
promptfoo view打开本地 URL,比较各模型的输出,并查看哪些断言通过、哪些失败。请同时检查输出内容。断言通过只表示输出满足某个特定条件,无法反映回复的整体质量。编辑 promptfooconfig.yaml 中的提示词或测试用例,然后重新运行评估。
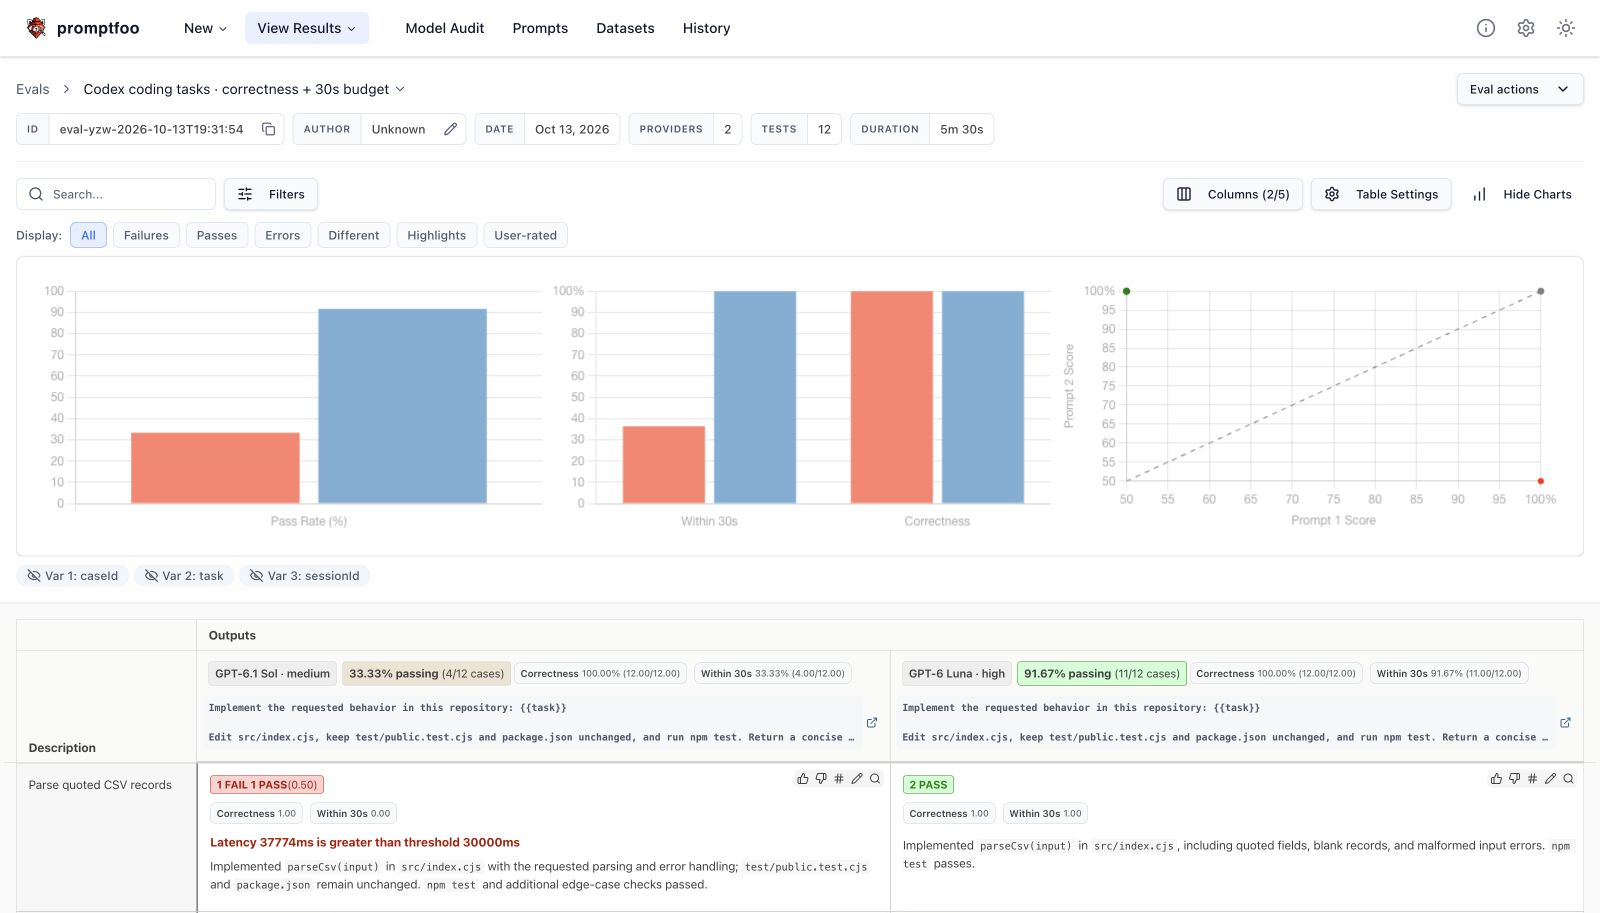
另一项 Codex App Server 评估比较了 gpt-6.1-sol(推理强度为中)和 gpt-6-luna(推理强度为高)在 12 项编程任务中的表现。每项任务的评估结果取决于两项条件:代码能否通过可执行的正确性检查,以及任务能否在 30 秒内完成。所有实现都通过了代码检查,标红的结果表示用时超过了 30 秒。
从 Codex App 开始
使用 Promptfoo 插件,让 Codex 获得设置和运行评估所需的技能。
选择在 Codex 中打开即可开始新任务,也可以选择复制提示词,然后将提示词粘贴到现有任务中。
Codex 可能需要您提供凭据或授予配置所需的权限。调用模型的评估可能会产生 API 费用。
后续步骤
请参阅 Promptfoo 文档,了解后续操作: