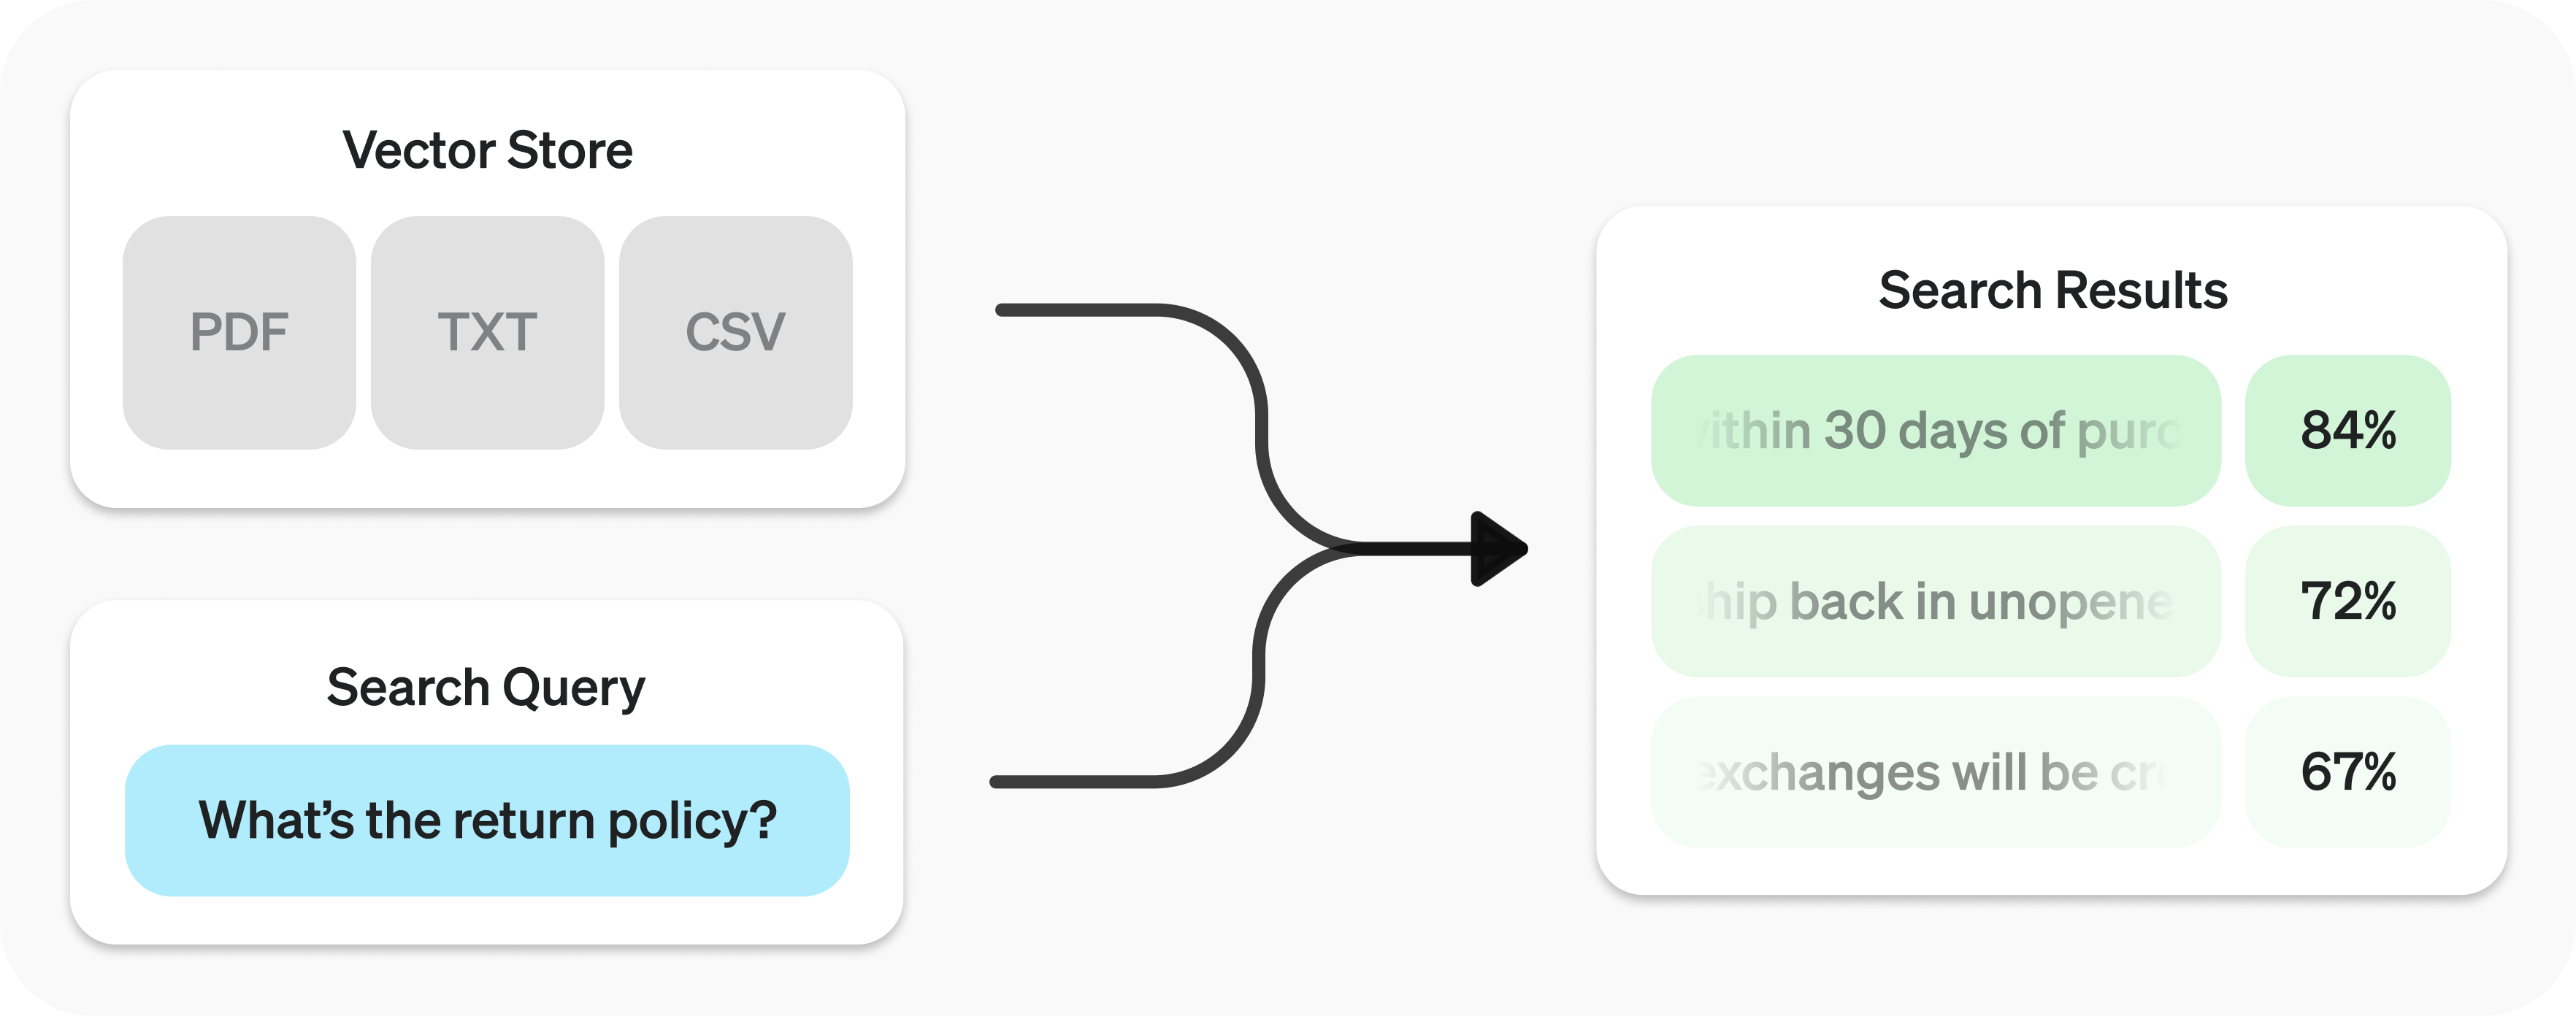
通过检索 API ,您可以对自己的数据执行语义搜索
检索 API 使用向量存储
创建向量存储 并上传文件。
1
2
3
4
5
6
7
8
9
10
11
12
13 import OpenAI from "openai";
const client = new OpenAI();
const vector_store = await client.vectorStores.create({
// Create vector store
name: "Support FAQ",
});
await client.vectorStores.files.uploadAndPoll(
vector_store.id,
// Upload file
fs.createReadStream("customer_policies.txt")
); 1
2
3
4
5
6
7
8
9
10
11
12 from openai import OpenAI
client = OpenAI()
vector_store = client.vector_stores.create( # Create vector store
name = "Support FAQ" ,
)
client.vector_stores.files.upload_and_poll( # Upload file
vector_store_id = vector_store.id,
file = open ( "customer_policies.txt" , "rb" )
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30 package main
import (
"context"
"fmt"
"os"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
vectorStore, err := client.VectorStores.New(context.Background(), openai.VectorStoreNewParams{Name: openai.String("Support FAQ")})
if err != nil {
panic(err)
}
file, err := os.Open("customer_policies.txt")
if err != nil {
panic(err)
}
defer file.Close()
_, err = client.VectorStores.Files.UploadAndPoll(context.Background(), vectorStore.ID, openai.FileNewParams{
File: openai.File(file, "customer_policies.txt", "text/plain"),
Purpose: openai.FilePurposeAssistants,
}, 1000)
if err != nil {
panic(err)
}
fmt.Println(vectorStore.ID)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.files.FileCreateParams;
import com.openai.models.files.FilePurpose;
import com.openai.models.vectorstores.VectorStoreCreateParams;
import com.openai.models.vectorstores.files.FileRetrieveParams;
import com.openai.models.vectorstores.files.VectorStoreFile;
import java.nio.file.Path;
var store =
client.vectorStores().create(VectorStoreCreateParams.builder().name("Support FAQ").build());
var uploaded =
client
.files()
.create(
FileCreateParams.builder()
.file(Path.of(System.getenv("OPENAI_EXAMPLE_FILE_PATH")))
.purpose(FilePurpose.ASSISTANTS)
.build());
var file =
client
.vectorStores()
.files()
.create(
store.id(),
com.openai.models.vectorstores.files.FileCreateParams.builder()
.fileId(uploaded.id())
.build());
while (file.status().equals(VectorStoreFile.Status.IN_PROGRESS)) {
Thread.sleep(1000);
file =
client
.vectorStores()
.files()
.retrieve(file.id(), FileRetrieveParams.builder().vectorStoreId(store.id()).build());
}
System.out.println(store.id()); 1
2
3
4
5
6
7
8
9
10
11
12
13 require "openai"
require "pathname"
client = OpenAI::Client.new
store = client.vector_stores.create(name: "Support FAQ")
file = client.vector_stores.files.upload_and_poll(
store.id,
file: Pathname("customer_policies.txt"),
timeout: 600
)
raise "File ingestion ended with status: #{file.status}" unless file.status == OpenAI::VectorStores::VectorStoreFile::Status::COMPLETED
puts(store.id) 发送搜索查询 以获取相关结果。
1
2
3
4
5 const userQuery = "What is the return policy?";
const results = await client.vectorStores.search(vector_store.id, {
query: userQuery,
}); 1
2
3
4
5
6 user_query = "What is the return policy?"
results = client.vector_stores.search(
vector_store_id = vector_store.id,
query = user_query,
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
results, err := client.VectorStores.Search(context.Background(), "vs_123", openai.VectorStoreSearchParams{
Query: openai.VectorStoreSearchParamsQueryUnion{OfString: openai.String("What is the return policy?")},
})
if err != nil {
panic(err)
}
fmt.Println(results.Data)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.vectorstores.VectorStoreSearchParams;
String vectorStoreId = "vs_123";
var results =
client
.vectorStores()
.search(
vectorStoreId,
VectorStoreSearchParams.builder().query("What is the return policy?").build());
System.out.println(results.data()); 1
2
3
4
5 require "openai"
client = OpenAI::Client.new
results = client.vector_stores.search("vs_123", query: "What is the return policy?")
puts(results.data&.first&.content) 语义搜索 利用向量嵌入 查找语义相关的结果。即使结果与查询只有少量共同关键词,甚至完全没有共同关键词,语义搜索也能找到这些传统搜索方法可能遗漏的结果。
例如,英文查询 "When did we go to the moon?"(我们是什么时候登上月球的?)可能得到以下结果:
文本
关键词相似度
语义相似度
The first lunar landing occurred in July of 1969.(人类于 1969 年 7 月首次登月。)
0%
65%
The first man on the moon was Neil Armstrong.(第一个踏上月球的人是 Neil Armstrong。)
27%
43%
When I ate the moon cake, it was delicious.(我吃月饼的时候,觉得它很好吃。)
40%
28%
(关键词相似度按交并比 计算。语义相似度按余弦相似度 计算,使用的嵌入模型为 text-embedding-3-small。)
在这个例子中,相关性最高的结果在英文原文中没有用到查询中的任何单词。凭借这种灵活性,语义搜索可以有效查询各种规模的知识库。
语义搜索依赖向量存储 ,本指南稍后会详细介绍。本节重点介绍如何执行和调整语义搜索。
您可以调用 search 函数,并用自然语言指定 query 来查询向量存储。函数会返回结果列表,每条结果都包含相关文本块、相似度得分和来源文件。
1
2
3 const results = await client.vectorStores.search(vector_store.id, {
query: "How many woodchucks are allowed per passenger?",
}); 1
2
3
4 results = client.vector_stores.search(
vector_store_id = vector_store.id,
query = "How many woodchucks are allowed per passenger?" ,
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
results, err := client.VectorStores.Search(context.Background(), "vs_123", openai.VectorStoreSearchParams{
Query: openai.VectorStoreSearchParamsQueryUnion{OfString: openai.String("How many woodchucks are allowed per passenger?")},
})
if err != nil {
panic(err)
}
fmt.Println(results.Data)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.vectorstores.VectorStoreSearchParams;
String vectorStoreId = "vs_123";
var results =
client
.vectorStores()
.search(
vectorStoreId,
VectorStoreSearchParams.builder()
.query("How many woodchucks are allowed per passenger?")
.build());
System.out.println(results.data()); 1
2
3
4
5
6
7
8 require "openai"
client = OpenAI::Client.new
results = client.vector_stores.search(
"vs_123",
query: "How many woodchucks are allowed per passenger?"
)
puts(results.data&.first&.content) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42 {
"object" : "vector_store.search_results.page" ,
"search_query" : "How many woodchucks are allowed per passenger?" ,
"data" : [
{
"file_id" : "file-12345" ,
"filename" : "woodchuck_policy.txt" ,
"score" : 0.85 ,
"attributes" : {
"region" : "North America" ,
"author" : "Wildlife Department"
},
"content" : [
{
"type" : "text" ,
"text" : "According to the latest regulations, each passenger is allowed to carry up to two woodchucks."
},
{
"type" : "text" ,
"text" : "Ensure that the woodchucks are properly contained during transport."
}
]
},
{
"file_id" : "file-67890" ,
"filename" : "transport_guidelines.txt" ,
"score" : 0.75 ,
"attributes" : {
"region" : "North America" ,
"author" : "Transport Authority"
},
"content" : [
{
"type" : "text" ,
"text" : "Passengers must adhere to the guidelines set forth by the Transport Authority regarding the transport of woodchucks."
}
]
}
],
"has_more" : false ,
"next_page" : null
} 默认情况下,每次响应最多包含 10 条结果。您可以通过 max_num_results 参数调整上限,最高可设为 50 条。
某些查询方式能得到更好的结果。您可以启用自动改写,让系统优化查询。将 rewrite_query=true 作为参数传给 search 即可启用此功能。
您可以在结果的 search_query 字段中查看改写后的查询。
原始查询 改写后的查询
我想知道主办公楼有多高。
主办公楼高度
运输危险品需要遵守哪些安全规定?
危险品安全规定
我该如何就服务问题提出投诉?
服务投诉流程
您可以设置筛选条件来缩小结果范围,例如只搜索特定日期范围内的文件。在执行语义搜索之前,您可以在 filters 中定义并组合条件,按属性筛选要搜索的文件。
使用比较筛选器 ,可以指定一个 key,将该键在文件的 attributes 中对应的值与给定的 value 进行比较。使用复合筛选器 ,可以通过 and 和 or 组合多个筛选器。
1
2
3
4
5 {
"type" : "eq" | "ne" | "gt" | "gte" | "lt" | "lte" | "in" | "nin" , // comparison operators
"key" : "attributes_key" , // attributes key
"value" : "target_value" // value to compare against
} 1
2
3
4 {
"type" : "and" | "or" , // logical operators
"filters" : [ ... ]
} 以下是一些筛选器示例。
下面按文件名筛选的示例匹配的是自定义 filename 属性。您必须为向量存储中的每个文件显式设置该属性,例如 {"filename": "example.txt"}。这些筛选器不会自动匹配上传文件的名称。
地区
1
2
3
4
5 {
"type" : "eq" ,
"key" : "region" ,
"value" : "us"
} 日期范围
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15 {
"type" : "and" ,
"filters" : [
{
"type" : "gte" ,
"key" : "date" ,
"value" : 1704067200 // unix timestamp for 2024-01-01
},
{
"type" : "lte" ,
"key" : "date" ,
"value" : 1710892800 // unix timestamp for 2024-03-20
}
]
} 文件名
1
2
3
4
5 {
"type" : "in" ,
"key" : "filename" ,
"value" : [ "example.txt" , "example2.txt" ]
} 排除文件名
1
2
3
4
5 {
"type" : "nin" ,
"key" : "filename" ,
"value" : [ "draft.txt" , "internal_notes.md" ]
} 组合条件
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35 {
"type" : "or" ,
"filters" : [
{
"type" : "and" ,
"filters" : [
{
"type" : "or" ,
"filters" : [
{
"type" : "eq" ,
"key" : "project_code" ,
"value" : "X123"
},
{
"type" : "eq" ,
"key" : "project_code" ,
"value" : "X999"
}
]
},
{
"type" : "eq" ,
"key" : "confidentiality" ,
"value" : "top_secret"
}
]
},
{
"type" : "eq" ,
"key" : "language" ,
"value" : "en"
}
]
}
如果文件搜索结果的相关性不够高,您可以调整 ranking_options 来改善返回结果的质量。您可以指定 ranker,例如 auto 或 default-2024-08-21,并将 score_threshold 设为 0.0 到 1.0 之间的值。提高 score_threshold 可以只保留相关性更高的文本块,但也可能排除一些有用的内容。如果设置了 ranking_options.hybrid_search,您还可以调整 hybrid_search.embedding_weight(rrf_embedding_weight)和 hybrid_search.text_weight(rrf_text_weight),控制倒数排名融合算法如何权衡语义嵌入匹配与稀疏关键词匹配。提高前者的权重会更看重语义相似度,提高后者的权重会更看重文本重合度。请确保至少有一个权重大于零。
向量存储是保存可搜索文件的容器,为检索 API 和文件搜索 工具提供语义搜索功能。将文件添加到向量存储后,系统会自动将文件分块、生成嵌入并建立索引。
向量存储包含 vector_store_file 对象,每个对象都关联一个底层 file 对象。
对象类型
说明
file表示通过文件 API 上传的内容。通常与向量存储配合使用,也可用于微调等场景。
vector_store用于存放可搜索文件的容器。
vector_store.file封装 file 的类型,表示该文件已分块、已生成嵌入,并已关联到一个 vector_store。attributes 映射。
费用按所有向量存储占用的总空间计算。占用空间取决于解析得到的文本块及其对应嵌入的大小。
存储用量
费用
1 GB 以内(所有向量存储合计)
免费
超出 1 GB 的部分
每 GB 每天 0.10 美元
创建
1
2
3
4 await client.vectorStores.create({
name: "Support FAQ",
file_ids: ["file_123"],
}); 1
2
3
4 client.vector_stores.create(
name = "Support FAQ" ,
file_ids = [ "file_123" ]
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
vectorStore, err := client.VectorStores.New(context.Background(), openai.VectorStoreNewParams{
Name: openai.String("Support FAQ"),
FileIDs: []string{"file_123"},
})
if err != nil {
panic(err)
}
fmt.Println(vectorStore.ID)
} 1
2
3
4
5
6
7
8
9
10
11
12
13 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.vectorstores.VectorStoreCreateParams;
String fileId = "file_123";
var store =
client
.vectorStores()
.create(
VectorStoreCreateParams.builder().name("Support FAQ").addFileId(fileId).build());
System.out.println(store.id()); 1
2
3
4
5
6
7
8 require "openai"
client = OpenAI::Client.new
store = client.vector_stores.create(
name: "Support FAQ",
file_ids: ["file_123"]
)
puts(store.id) 获取
1 await client.vectorStores.retrieve("vs_123"); 1
2
3 client.vector_stores.retrieve(
vector_store_id = "vs_123"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
vectorStore, err := client.VectorStores.Get(context.Background(), "vs_123")
if err != nil {
panic(err)
}
fmt.Println(vectorStore.ID)
} 1
2
3
4
5
6 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
String vectorStoreId = "vs_123";
System.out.println(client.vectorStores().retrieve(vectorStoreId).id()); 1
2
3
4
5 require "openai"
client = OpenAI::Client.new
store = client.vector_stores.retrieve("vs_123")
puts(store.id) 更新
1
2
3 await client.vectorStores.update("vs_123", {
name: "Support FAQ Updated",
}); 1
2
3
4 client.vector_stores.update(
vector_store_id = "vs_123" ,
name = "Support FAQ Updated"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
vectorStore, err := client.VectorStores.Update(context.Background(), "vs_123", openai.VectorStoreUpdateParams{
Name: openai.String("Support FAQ Updated"),
})
if err != nil {
panic(err)
}
fmt.Println(vectorStore.Name)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.vectorstores.VectorStoreUpdateParams;
String vectorStoreId = "vs_123";
var store =
client
.vectorStores()
.update(
vectorStoreId,
VectorStoreUpdateParams.builder().name("Updated knowledge base").build());
System.out.println(store.name()); 1
2
3
4
5 require "openai"
client = OpenAI::Client.new
store = client.vector_stores.update("vs_123", name: "Updated knowledge base")
puts(store.name) 删除
1 await client.vectorStores.delete("vs_123"); 1
2
3 client.vector_stores.delete(
vector_store_id = "vs_123"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
deleted, err := client.VectorStores.Delete(context.Background(), "vs_123")
if err != nil {
panic(err)
}
fmt.Println(deleted.Deleted)
} 1
2
3
4
5
6 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
String vectorStoreId = "vs_123";
System.out.println(client.vectorStores().delete(vectorStoreId).deleted()); 1
2
3
4
5 require "openai"
client = OpenAI::Client.new
deleted = client.vector_stores.delete("vs_123")
puts(deleted.deleted) 列出
await client.vectorStores.list(); client.vector_stores.list() package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
vectorStores, err := client.VectorStores.List(context.Background(), openai.VectorStoreListParams{})
if err != nil {
panic(err)
}
fmt.Println(vectorStores.Data)
} import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
System.out.println(client.vectorStores().list().data()); require "openai"
client = OpenAI::Client.new
stores = client.vector_stores.list(limit: 10)
puts((stores.data || []).length)
某些操作是异步的,可能需要一段时间才能完成。例如,create 用于创建 vector_store.file 对象,您可以使用 create_and_poll 等辅助函数阻塞等待,直到操作完成。您也可以自行查询操作状态。从向量存储移除文件采用最终一致性机制,因此移除文件后的一小段时间内,搜索结果仍可能包含该文件的内容。
添加文件的请求按向量存储 ID 实施速率限制。对于同一个向量存储,发往 /vector_stores/{vector_store_id}/files/vector_stores/{vector_store_id}/file_batches
创建
1
2
3 await client.vectorStores.files.createAndPoll("vs_123", {
file_id: "file_123",
}); 1
2
3
4 client.vector_stores.files.create_and_poll(
vector_store_id = "vs_123" ,
file_id = "file_123"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
file, err := client.VectorStores.Files.NewAndPoll(context.Background(), "vs_123", openai.VectorStoreFileNewParams{
FileID: "file_123",
}, 1000)
if err != nil {
panic(err)
}
fmt.Println(file.ID)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.vectorstores.files.FileCreateParams;
String vectorStoreId = "vs_123";
String fileId = "file_123";
var file =
client
.vectorStores()
.files()
.create(vectorStoreId, FileCreateParams.builder().fileId(fileId).build());
System.out.println(file.id()); 1
2
3
4
5
6
7
8
9 require "openai"
client = OpenAI::Client.new
file = client.vector_stores.files.create_and_poll("vs_123", file_id: "file_123")
unless file.status == OpenAI::VectorStores::VectorStoreFile::Status::COMPLETED
raise "File indexing did not complete: #{file.last_error&.message || file.status}"
end
puts(file.id) 上传
1
2
3
4 await client.vectorStores.files.uploadAndPoll(
"vs_123",
fs.createReadStream("customer_policies.txt")
); 1
2
3
4 client.vector_stores.files.upload_and_poll(
vector_store_id = "vs_123" ,
file = open ( "customer_policies.txt" , "rb" )
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26 package main
import (
"context"
"fmt"
"os"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
file, err := os.Open("customer_policies.txt")
if err != nil {
panic(err)
}
defer file.Close()
result, err := client.VectorStores.Files.UploadAndPoll(context.Background(), "vs_123", openai.FileNewParams{
File: openai.File(file, "customer_policies.txt", "text/plain"),
Purpose: openai.FilePurposeAssistants,
}, 1000)
if err != nil {
panic(err)
}
fmt.Println(result.ID)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.files.FileCreateParams;
import com.openai.models.files.FilePurpose;
import com.openai.models.vectorstores.files.FileRetrieveParams;
import com.openai.models.vectorstores.files.VectorStoreFile;
import java.nio.file.Path;
String vectorStoreId = "vs_123";
var uploaded =
client
.files()
.create(
FileCreateParams.builder()
.file(Path.of(System.getenv("OPENAI_EXAMPLE_FILE_PATH")))
.purpose(FilePurpose.ASSISTANTS)
.build());
var file =
client
.vectorStores()
.files()
.create(
vectorStoreId,
com.openai.models.vectorstores.files.FileCreateParams.builder()
.fileId(uploaded.id())
.build());
while (file.status().equals(VectorStoreFile.Status.IN_PROGRESS)) {
Thread.sleep(1000);
file =
client
.vectorStores()
.files()
.retrieve(
file.id(), FileRetrieveParams.builder().vectorStoreId(vectorStoreId).build());
}
System.out.println(file.id()); 1
2
3
4
5
6
7
8
9
10
11
12 require "openai"
require "pathname"
client = OpenAI::Client.new
vector_store_file = client.vector_stores.files.upload_and_poll(
"vs_123",
file: Pathname("customer_policies.txt"),
timeout: 600
)
raise "File ingestion ended with status: #{vector_store_file.status}" unless vector_store_file.status == OpenAI::VectorStores::VectorStoreFile::Status::COMPLETED
puts(vector_store_file.id) 获取
1
2
3 await client.vectorStores.files.retrieve("file_123", {
vector_store_id: "vs_123",
}); 1
2
3
4 client.vector_stores.files.retrieve(
vector_store_id = "vs_123" ,
file_id = "file_123"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
file, err := client.VectorStores.Files.Get(context.Background(), "vs_123", "file_123")
if err != nil {
panic(err)
}
fmt.Println(file.ID)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
String fileId = "file_123";
String vectorStoreId = "vs_123";
System.out.println(
client
.vectorStores()
.files()
.retrieve(
fileId,
com.openai.models.vectorstores.files.FileRetrieveParams.builder()
.vectorStoreId(vectorStoreId)
.build())
.id()); 1
2
3
4
5 require "openai"
client = OpenAI::Client.new
file = client.vector_stores.files.retrieve("file_123", vector_store_id: "vs_123")
puts(file.id) 更新
1
2
3
4 await client.vectorStores.files.update("file_123", {
vector_store_id: "vs_123",
attributes: { key: "value" },
}); 1
2
3
4
5 client.vector_stores.files.update(
vector_store_id = "vs_123" ,
file_id = "file_123" ,
attributes = { "key" : "value" }
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
file, err := client.VectorStores.Files.Update(context.Background(), "vs_123", "file_123", openai.VectorStoreFileUpdateParams{
Attributes: map[string]openai.VectorStoreFileUpdateParamsAttributeUnion{
"key": {OfString: openai.String("value")},
},
})
if err != nil {
panic(err)
}
fmt.Println(file.ID)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.core.JsonValue;
import com.openai.models.vectorstores.files.FileUpdateParams;
String fileId = "file_123";
String vectorStoreId = "vs_123";
var file =
client
.vectorStores()
.files()
.update(
fileId,
FileUpdateParams.builder()
.vectorStoreId(vectorStoreId)
.attributes(
FileUpdateParams.Attributes.builder()
.putAdditionalProperty("category", JsonValue.from("policy"))
.build())
.build());
System.out.println(file.id()); 1
2
3
4
5 require "openai"
client = OpenAI::Client.new
file = client.vector_stores.files.update("file_123", vector_store_id: "vs_123", attributes: { category: "policy" })
puts(file.id) 删除
1
2
3 await client.vectorStores.files.delete("file_123", {
vector_store_id: "vs_123",
}); 1
2
3
4 client.vector_stores.files.delete(
vector_store_id = "vs_123" ,
file_id = "file_123"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
deleted, err := client.VectorStores.Files.Delete(context.Background(), "vs_123", "file_123")
if err != nil {
panic(err)
}
fmt.Println(deleted.Deleted)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
String fileId = "file_123";
String vectorStoreId = "vs_123";
System.out.println(
client
.vectorStores()
.files()
.delete(
fileId,
com.openai.models.vectorstores.files.FileDeleteParams.builder()
.vectorStoreId(vectorStoreId)
.build())
.deleted()); 1
2
3
4
5 require "openai"
client = OpenAI::Client.new
deleted = client.vector_stores.files.delete("file_123", vector_store_id: "vs_123")
puts(deleted.deleted) 列出
1 await client.vectorStores.files.list("vs_123"); 1
2
3 client.vector_stores.files.list(
vector_store_id = "vs_123"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
files, err := client.VectorStores.Files.List(context.Background(), "vs_123", openai.VectorStoreFileListParams{})
if err != nil {
panic(err)
}
fmt.Println(files.Data)
} 1
2
3
4
5
6 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
String vectorStoreId = "vs_123";
System.out.println(client.vectorStores().files().list(vectorStoreId).data()); 1
2
3
4
5 require "openai"
client = OpenAI::Client.new
files = client.vector_stores.files.list("vs_123")
puts((files.data || []).length)
创建
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18 await client.vectorStores.fileBatches.createAndPoll("vs_123", {
files: [
{
file_id: "file_123",
attributes: { department: "finance" },
},
{
file_id: "file_456",
chunking_strategy: {
type: "static",
static: {
max_chunk_size_tokens: 1200,
chunk_overlap_tokens: 200,
},
},
},
],
}); 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19 client.vector_stores.file_batches.create_and_poll(
vector_store_id = "vs_123" ,
files = [
{
"file_id" : "file_123" ,
"attributes" : { "department" : "finance" }
},
{
"file_id" : "file_456" ,
"chunking_strategy" : {
"type" : "static" ,
"static" : {
"max_chunk_size_tokens" : 1200 ,
"chunk_overlap_tokens" : 200
}
}
}
]
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
batch, err := client.VectorStores.FileBatches.NewAndPoll(context.Background(), "vs_123", openai.VectorStoreFileBatchNewParams{
Files: []openai.VectorStoreFileBatchNewParamsFile{
{
FileID: "file_123",
Attributes: map[string]openai.VectorStoreFileBatchNewParamsFileAttributeUnion{
"department": {OfString: openai.String("finance")},
},
},
{
FileID: "file_456",
ChunkingStrategy: openai.FileChunkingStrategyParamUnion{OfStatic: &openai.StaticFileChunkingStrategyObjectParam{
Static: openai.StaticFileChunkingStrategyParam{MaxChunkSizeTokens: 1200, ChunkOverlapTokens: 200},
}},
},
},
}, 1000)
if err != nil {
panic(err)
}
fmt.Println(batch.ID)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.core.JsonValue;
import com.openai.models.vectorstores.StaticFileChunkingStrategy;
import com.openai.models.vectorstores.filebatches.FileBatchCreateParams;
import com.openai.models.vectorstores.filebatches.FileBatchRetrieveParams;
import com.openai.models.vectorstores.filebatches.VectorStoreFileBatch;
String vectorStoreId = "vs_123";
String fileId = "file_123";
String fileId2 = "file_456";
var first =
FileBatchCreateParams.File.builder()
.fileId(fileId)
.attributes(
FileBatchCreateParams.File.Attributes.builder()
.putAdditionalProperty("department", JsonValue.from("finance"))
.build())
.build();
var second =
FileBatchCreateParams.File.builder()
.fileId(fileId2)
.staticChunkingStrategy(
StaticFileChunkingStrategy.builder()
.maxChunkSizeTokens(1200)
.chunkOverlapTokens(200)
.build())
.build();
var batch =
client
.vectorStores()
.fileBatches()
.create(
vectorStoreId,
FileBatchCreateParams.builder().addFile(first).addFile(second).build());
while (batch.status().equals(VectorStoreFileBatch.Status.IN_PROGRESS)) {
Thread.sleep(1000);
batch =
client
.vectorStores()
.fileBatches()
.retrieve(
batch.id(),
FileBatchRetrieveParams.builder().vectorStoreId(vectorStoreId).build());
}
System.out.println(batch.status()); 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37 require "openai"
client = OpenAI::Client.new
batch = client.vector_stores.file_batches.create_and_poll(
"vs_123",
files: [
{
file_id: "file_123",
attributes: { department: "finance" }
},
{
file_id: "file_456",
chunking_strategy: {
type: :static,
static: {
max_chunk_size_tokens: 1_200,
chunk_overlap_tokens: 200
}
}
}
],
timeout: 600
)
raise "File ingestion ended with status: #{batch.status}" unless batch.status == OpenAI::VectorStores::VectorStoreFileBatch::Status::COMPLETED
raise "File ingestion failed for #{batch.file_counts.failed} file(s)" if batch.file_counts.failed.positive?
# Live validation of per-file batches returned default chunking despite overrides.
file = client.vector_stores.files.retrieve("file_456", vector_store_id: "vs_123")
strategy = file.chunking_strategy
unless strategy.is_a?(OpenAI::StaticFileChunkingStrategyObject) &&
strategy.static.max_chunk_size_tokens == 1_200 &&
strategy.static.chunk_overlap_tokens == 200
raise "Requested chunking was not applied to #{file.id}: #{strategy.to_json}"
end
puts(batch.status) 获取
1
2
3 await client.vectorStores.fileBatches.retrieve("vsfb_123", {
vector_store_id: "vs_123",
}); 1
2
3
4 client.vector_stores.file_batches.retrieve(
vector_store_id = "vs_123" ,
batch_id = "vsfb_123"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
batch, err := client.VectorStores.FileBatches.Get(context.Background(), "vs_123", "vsfb_123")
if err != nil {
panic(err)
}
fmt.Println(batch.ID)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
String fileBatchId = "vsfb_123";
String vectorStoreId = "vs_123";
System.out.println(
client
.vectorStores()
.fileBatches()
.retrieve(
fileBatchId,
com.openai.models.vectorstores.filebatches.FileBatchRetrieveParams.builder()
.vectorStoreId(vectorStoreId)
.build())
.status()); 1
2
3
4
5
6
7
8 require "openai"
client = OpenAI::Client.new
batch = client.vector_stores.file_batches.retrieve(
"vsfb_123",
vector_store_id: "vs_123"
)
puts(batch.status) 取消
1
2
3 await client.vectorStores.fileBatches.cancel("vsfb_123", {
vector_store_id: "vs_123",
}); 1
2
3
4 client.vector_stores.file_batches.cancel(
vector_store_id = "vs_123" ,
batch_id = "vsfb_123"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
batch, err := client.VectorStores.FileBatches.Cancel(context.Background(), "vs_123", "vsfb_123")
if err != nil {
panic(err)
}
fmt.Println(batch.Status)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
String fileBatchId = "vsfb_123";
String vectorStoreId = "vs_123";
System.out.println(
client
.vectorStores()
.fileBatches()
.cancel(
fileBatchId,
com.openai.models.vectorstores.filebatches.FileBatchCancelParams.builder()
.vectorStoreId(vectorStoreId)
.build())
.status()); 1
2
3
4
5
6
7
8 require "openai"
client = OpenAI::Client.new
batch = client.vector_stores.file_batches.cancel(
"vsfb_123",
vector_store_id: "vs_123"
)
puts(batch.status) 列出
1
2
3 await client.vectorStores.fileBatches.listFiles("vsfb_123", {
vector_store_id: "vs_123",
}); 1
2
3
4 client.vector_stores.file_batches.list_files(
"vsfb_123" ,
vector_store_id = "vs_123"
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
files, err := client.VectorStores.FileBatches.ListFiles(context.Background(), "vs_123", "vsfb_123", openai.VectorStoreFileBatchListFilesParams{})
if err != nil {
panic(err)
}
fmt.Println(files.Data)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
String fileBatchId = "vsfb_123";
String vectorStoreId = "vs_123";
System.out.println(
client
.vectorStores()
.fileBatches()
.listFiles(
fileBatchId,
com.openai.models.vectorstores.filebatches.FileBatchListFilesParams.builder()
.vectorStoreId(vectorStoreId)
.build())
.data()); 1
2
3
4
5
6
7
8 require "openai"
client = OpenAI::Client.new
files = client.vector_stores.file_batches.list_files(
"vsfb_123",
vector_store_id: "vs_123"
)
puts((files.data || []).length)
创建批次时,您可以提供 file_ids,并按需设置 attributes、chunking_strategy 或两者。您也可以通过 files 数组为每个文件传入一个对象,其中必须包含 file_id,还可按需设置 attributes 和 chunking_strategy。两种方式只能选其一:前者让所有文件共用相同设置,后者允许逐个文件覆盖设置。
如果您希望提高向单个向量存储导入文件的吞吐量,建议尽可能采用批量创建。一次批量请求最多可包含 500 个文件。与发送大量单文件创建请求相比,批量创建通常能减少资源争用,降低端到端延迟。
每个 vector_store.file 都可以关联一个 attributes 字典。执行语义搜索 时,您可以通过按属性筛选 来引用字典中的值。字典最多可包含 16 个键。每个键最长为 64 个字符,每个字符串值最长为 512 个字符。
1
2
3
4
5
6
7
8 await client.vectorStores.files.create("<vector_store_id>", {
file_id: "file_123",
attributes: {
region: "US",
category: "Marketing",
date: 1672531200, // Jan 1, 2023
},
}); 1
2
3
4
5
6
7
8
9 client.vector_stores.files.create(
vector_store_id = "<vector_store_id>" ,
file_id = "file_123" ,
attributes = {
"region" : "US" ,
"category" : "Marketing" ,
"date" : 1672531200 # Jan 1, 2023
}
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
file, err := client.VectorStores.Files.New(context.Background(), "<vector_store_id>", openai.VectorStoreFileNewParams{
FileID: "file_123",
Attributes: map[string]openai.VectorStoreFileNewParamsAttributeUnion{
"region": {OfString: openai.String("US")},
"category": {OfString: openai.String("Marketing")},
"date": {OfFloat: openai.Float(1672531200)},
},
})
if err != nil {
panic(err)
}
fmt.Println(file.ID)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.core.JsonValue;
import com.openai.models.vectorstores.files.FileCreateParams;
String vectorStoreId = "<vector_store_id>";
String fileId = "file_123";
var file =
client
.vectorStores()
.files()
.create(
vectorStoreId,
FileCreateParams.builder()
.fileId(fileId)
.attributes(
FileCreateParams.Attributes.builder()
.putAdditionalProperty("category", JsonValue.from("policy"))
.build())
.build());
System.out.println(file.id()); 1
2
3
4
5 require "openai"
client = OpenAI::Client.new
file = client.vector_stores.files.create("<vector_store_id>", file_id: "file_123", attributes: { category: "policy" })
puts(file.id) 您可以为 vector_store 对象设置 expires_after 来指定过期策略。向量存储过期后,系统会删除所有关联的 vector_store.file 对象,并停止对这些对象计费。
1
2
3
4
5
6 await client.vectorStores.update("vs_123", {
expires_after: {
anchor: "last_active_at",
days: 7,
},
}); 1
2
3
4
5
6
7 client.vector_stores.update(
vector_store_id = "vs_123" ,
expires_after = {
"anchor" : "last_active_at" ,
"days" : 7
}
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
vectorStore, err := client.VectorStores.Update(context.Background(), "vs_123", openai.VectorStoreUpdateParams{
ExpiresAfter: openai.VectorStoreUpdateParamsExpiresAfter{Days: 7},
})
if err != nil {
panic(err)
}
fmt.Println(vectorStore.ExpiresAfter)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.core.JsonValue;
import com.openai.models.vectorstores.VectorStoreUpdateParams;
String vectorStoreId = "vs_123";
var store =
client
.vectorStores()
.update(
vectorStoreId,
VectorStoreUpdateParams.builder()
.expiresAfter(
VectorStoreUpdateParams.ExpiresAfter.builder()
.anchor(JsonValue.from("last_active_at"))
.days(7)
.build())
.build());
System.out.println(store.expiresAfter().orElseThrow()); 1
2
3
4
5
6
7
8
9
10
11 require "openai"
client = OpenAI::Client.new
store = client.vector_stores.update(
"vs_123",
expires_after: {
anchor: :last_active_at,
days: 7
}
)
puts(store.expires_after) 单个文件最大为 512 MB。每个文件包含的 Token 数不应超过 5,000,000。添加文件时,系统会自动计算 Token 数。
默认情况下,max_chunk_size_tokens 为 800,chunk_overlap_tokens 为 400。这意味着系统会按每块 800 个 Token 拆分文件并建立索引,相邻文本块之间有 400 个 Token 重叠。
将文件添加到向量存储时,您可以设置 chunking_strategy
max_chunk_size_tokens 必须在 100 到 4096 之间(含两端)。chunk_overlap_tokens 必须为非负数,且不应超过 max_chunk_size_tokens / 2。
支持的文件类型 对于以 text/ 开头的 MIME 类型,编码必须是 utf-8、utf-16 或 ascii。
文件格式
MIME 类型
.ctext/x-c
.cpptext/x-c++
.cstext/x-csharp
.csstext/css
.docapplication/msword
.docxapplication/vnd.openxmlformats-officedocument.wordprocessingml.document
.gotext/x-golang
.htmltext/html
.javatext/x-java
.jstext/javascript
.jsonapplication/json
.mdtext/markdown
.pdfapplication/pdf
.phptext/x-php
.pptxapplication/vnd.openxmlformats-officedocument.presentationml.presentation
.pytext/x-python
.pytext/x-script.python
.rbtext/x-ruby
.shapplication/x-sh
.textext/x-tex
.tsapplication/typescript
.txttext/plain
执行查询后,如果您想根据结果生成回答,可以将搜索结果和原始查询一并提供给我们的模型,让模型给出有据可依的回答。
1
2
3
4
5
6
7
8
9 import OpenAI from "openai";
const client = new OpenAI();
const userQuery = "What is the return policy?";
const results = await client.vectorStores.search(vector_store.id, {
query: userQuery,
}); 1
2
3
4
5
6
7
8
9
10 from openai import OpenAI
client = OpenAI()
user_query = "What is the return policy?"
results = client.vector_stores.search(
vector_store_id = vector_store.id,
query = user_query,
) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19 package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
results, err := client.VectorStores.Search(context.Background(), "vs_123", openai.VectorStoreSearchParams{
Query: openai.VectorStoreSearchParamsQueryUnion{OfString: openai.String("What is the return policy?")},
})
if err != nil {
panic(err)
}
fmt.Println(results.Data)
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.vectorstores.VectorStoreSearchParams;
String vectorStoreId = "vs_123";
var results =
client
.vectorStores()
.search(
vectorStoreId,
VectorStoreSearchParams.builder().query("What is the return policy?").build());
System.out.println(results.data()); 1
2
3
4
5
6
7
8 require "openai"
client = OpenAI::Client.new
results = client.vector_stores.search(
"vs_123",
query: "What is the return policy?"
)
puts(results.data) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22 const formattedResults = formatResults(results.data);
// Join the text content of all results
const textSources = results.data
.map((result) => result.content.map((c) => c.text).join("\n"))
.join("\n");
const completion = await client.chat.completions.create({
model: "gpt-6.2-astra",
messages: [
{
role: "developer",
content:
"Produce a concise answer to the query based on the provided sources.",
},
{
role: "user",
content: `Sources: ${formattedResults}\n\nQuery: '${userQuery}'`,
},
],
});
console.log(completion.choices[0].message.content); 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20 # Use results and user_query from the preceding search step.
formatted_results = format_results(results.data)
" \n " .join( " \n " .join(c.text for c in result.content) for result in results.data)
completion = client.chat.completions.create(
model = "gpt-6.2-astra" ,
messages = [
{
"role" : "developer" ,
"content" : "Produce a concise answer to the query based on the provided sources." ,
},
{
"role" : "user" ,
"content" : f "Sources: { formatted_results }\n\n Query: ' { user_query } '" ,
},
],
)
print (completion.choices[ 0 ].message.content) 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46 package main
import (
"context"
"fmt"
"strings"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
userQuery := "What is the return policy?"
results, err := client.VectorStores.Search(context.Background(), "vs_123", openai.VectorStoreSearchParams{
Query: openai.VectorStoreSearchParamsQueryUnion{OfString: openai.String(userQuery)},
})
if err != nil {
panic(err)
}
completion, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{
Model: "gpt-6.2-astra",
Messages: []openai.ChatCompletionMessageParamUnion{
openai.DeveloperMessage("Produce a concise answer to the query based on the provided sources."),
openai.UserMessage(fmt.Sprintf("Sources: %s\n\nQuery: %q", formatResults(results.Data), userQuery)),
},
})
if err != nil {
panic(err)
}
fmt.Println(completion.Choices[0].Message.Content)
}
func formatResults(results []openai.VectorStoreSearchResponse) string {
var sources strings.Builder
sources.WriteString("<sources>")
for _, result := range results {
fmt.Fprintf(&sources, "<result file_id=%q file_name=%q>", result.FileID, result.Filename)
for _, content := range result.Content {
fmt.Fprintf(&sources, "<content>%s</content>", content.Text)
}
sources.WriteString("</result>")
}
sources.WriteString("</sources>")
return sources.String()
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44 import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.chat.completions.ChatCompletionCreateParams;
import com.openai.models.vectorstores.VectorStoreSearchParams;
import java.util.stream.Collectors;
String vectorStoreId = "vs_123";
String query = "What is the return policy?";
var results =
client
.vectorStores()
.search(vectorStoreId, VectorStoreSearchParams.builder().query(query).build());
String sources =
results.data().stream()
.map(
result ->
"<result file_id='"
+ result.fileId()
+ "' file_name='"
+ result.filename()
+ "'>"
+ result.content().stream()
.map(content -> "<content>" + content.text() + "</content>")
.collect(Collectors.joining())
+ "</result>")
.collect(Collectors.joining());
var completion =
client
.chat()
.completions()
.create(
ChatCompletionCreateParams.builder()
.model("gpt-6.2-astra")
.addDeveloperMessage(
"Answer the query concisely using only the provided sources.")
.addUserMessage(
"Sources: <sources>" + sources + "</sources>\n\nQuery: " + query)
.build());
completion.choices().stream()
.flatMap(choice -> choice.message().content().stream())
.forEach(System.out::println); 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24 require "openai"
client = OpenAI::Client.new
query = "What is the return policy?"
results = client.vector_stores.search("vs_123", query: query)
sources = (results.data || []).map do |result|
content = result.content.map { |part| "<content>#{part.text}</content>" }.join
"<result file_id='#{result.file_id}' file_name='#{result.filename}'>#{content}</result>"
end.join
completion = client.chat.completions.create(
model: "gpt-6.2-astra",
messages: [
{
role: :developer,
content: "Answer the query concisely using only the provided sources."
},
{
role: :user,
content: "Sources: <sources>#{sources}</sources>\n\nQuery: #{query}"
}
]
)
puts(completion.choices.fetch(0).message.content) "Our return policy allows returns within 30 days of purchase." 此示例使用 format_results 函数来格式化结果。该函数的一种实现如下:
1
2
3
4
5
6
7
8
9
10
11
12
13 function formatResults(results: {
data: import("openai/resources/vector-stores").VectorStoreSearchResponse[];
}) {
let formattedResults = "";
for (const result of results.data) {
let formattedResult = `<result file_id='${result.file_id}' file_name='${result.filename}'>`;
for (const part of result.content) {
formattedResult += `<content>${part.text}</content>`;
}
formattedResults += formattedResult + "</result>";
}
return `<sources>${formattedResults}</sources>`;
} 1
2
3
4
5
6
7
8
9
10 def format_results (results):
formatted_results = ""
for result in results.data:
formatted_result = (
f "<result file_id=' { result.file_id } ' file_name=' { result.filename } '>"
)
for part in result.content:
formatted_result += f "<content> { part.text } </content>"
formatted_results += formatted_result + "</result>"
return f "<sources> { formatted_results } </sources>" 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22 package main
import (
"fmt"
"strings"
"github.com/openai/openai-go/v3"
)
func formatResults(results []openai.VectorStoreSearchResponse) string {
var sources strings.Builder
sources.WriteString("<sources>")
for _, result := range results {
fmt.Fprintf(&sources, "<result file_id=%q file_name=%q>", result.FileID, result.Filename)
for _, content := range result.Content {
fmt.Fprintf(&sources, "<content>%s</content>", content.Text)
}
sources.WriteString("</result>")
}
sources.WriteString("</sources>")
return sources.String()
} 1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19 import com.openai.models.vectorstores.VectorStoreSearchResponse;
import java.util.List;
static String formatResults(List<VectorStoreSearchResponse> results) {
var formatted = new StringBuilder("<sources>");
for (var result : results) {
formatted
.append("<result file_id='")
.append(result.fileId())
.append("' file_name='")
.append(result.filename())
.append("'>");
for (var part : result.content()) {
formatted.append("<content>").append(part.text()).append("</content>");
}
formatted.append("</result>");
}
return formatted.append("</sources>").toString();
} 1
2
3
4
5
6
7
8 def format_results(results)
sources = results.map do |result|
content = result.content.map { |part| "<content>#{part.text}</content>" }.join
"<result file_id=\"#{result.file_id}\" file_name=\"#{result.filename}\">#{content}</result>"
end
"<sources>#{sources.join}</sources>"
end