
2025 年 9 月,OpenAI 推出了 GPT-5-Codex,这是 GPT-5 首个针对智能体编程优化的版本。同年 12 月,我们发布了 5.2。也正是从那时起,人们开始相信,可以放心地把编程工作交给自主智能体。其中一个特别明显的进步是,模型能够可靠遵循指令的时间大幅延长了。
我想看看它究竟能坚持多久,于是给了 Codex 一个空的代码仓库和完全访问权限,只交给它一项任务:从零开始构建一款设计工具。接着,我让它使用 GPT-5.3-Codex,把推理强度设为“极高”。Codex 连续运行了约 25 小时,消耗了约 1300 万个 Token,生成了约 3 万行代码。
这次运行仅用于实验。但在决定长时间跨度任务能否顺利完成的几个方面,Codex 表现得很好:它能遵循规格要求,始终围绕任务开展工作,运行验证,并在遇到问题时及时修复。

一次长时间运行的 Codex 会话是什么样的
我让 Codex 根据这次会话的数据生成了一个汇总页面:

下面是 CLI 中显示的会话统计数据和 Token 用量:

这些截图直观地呈现了智能体编程正在发生的变化:除了模型在单次尝试中能解决什么问题,它能胜任的任务有多大的时间跨度,也越来越重要。
真正的变化在于时间跨度
变化不只是“模型变聪明了”。在实际工作中,智能体现在能在更长时间内保持思路连贯,从头到尾完成更大规模的工作,即使出错,也能恢复并沿着原来的思路继续推进。
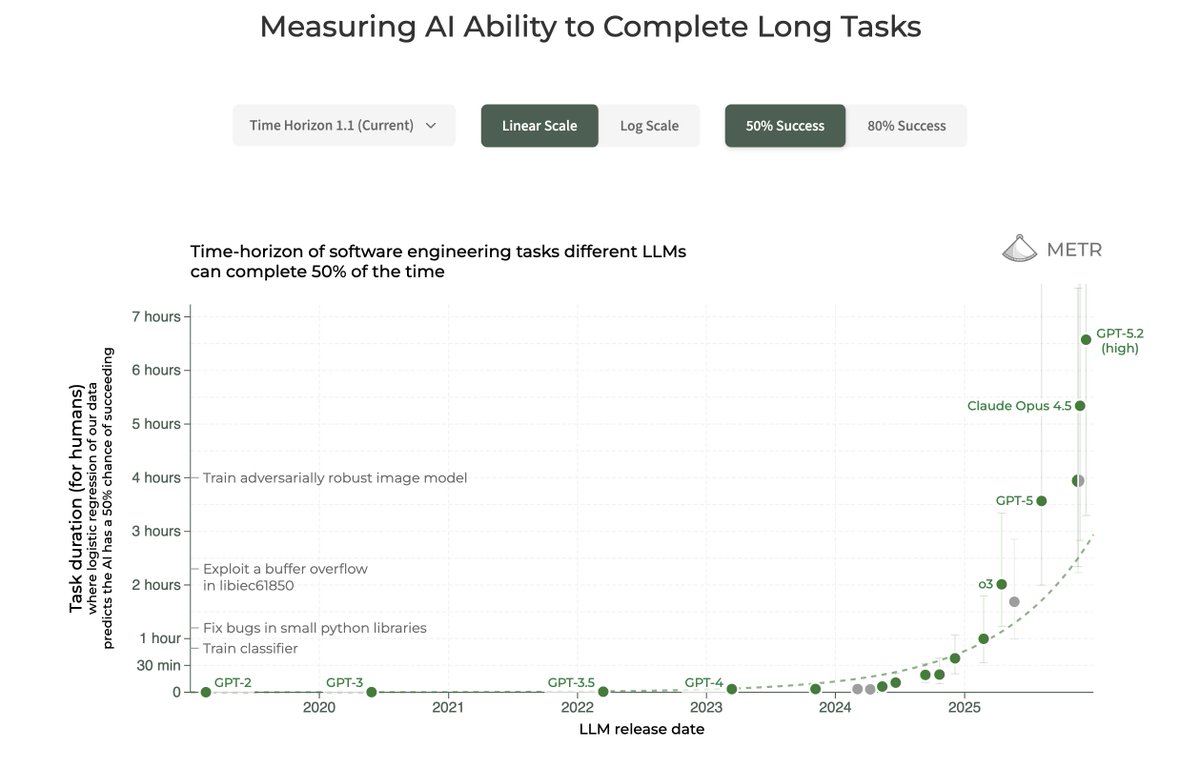
METR 的时间跨度基准测试有助于理解这一趋势:无论以约 50% 还是 80% 的成功率衡量,前沿智能体能完成的软件任务的时间跨度都在快速增长,大约每 7 个月翻一番。参见衡量 AI 完成长时间任务的能力(METR)。
正如我们最近在 GPT-5.3-Codex 的发布公告中介绍的,这款模型在智能体执行任务时带来了两项实际改进:
- 它更擅长分步执行任务(规划 → 实现 → 验证 → 修复)。
- 您更容易在任务执行过程中调整方向,无需从头再来(纠正方向时会保留已有进展)。
Cursor 关于长时间运行的自主编程系统的文章也给了我启发,其中就包括他们构建浏览器的实验:Cursor 如何构建网页浏览器(扩展智能体规模)。
Cursor 团队写道,OpenAI 模型“在长时间自主工作方面明显更出色:能遵循指令、保持专注、不偏离目标,还能准确、完整地实现各项要求”。
为什么 Codex 在长时间任务中能保持思路连贯
要让智能体长时间工作,比起编写一个很长的提示词,更重要的是模型如何通过智能体循环执行任务。
在 Codex 中,这个循环大致如下:
- 制订计划
- 编辑代码
- 运行工具(测试、构建、代码静态检查)
- 查看结果
- 修复发现的问题
- 更新文档和任务状态
- 重复上述步骤
这个循环很重要,因为它为智能体提供了:
- 来自实际执行过程的反馈(错误、代码差异、日志)
- 保存在模型之外的任务状态(代码仓库、文件、文档、工作树、输出结果)
- 在执行过程中持续接受引导的机会(您可以根据结果纠正方向)
这也解释了为什么在 Codex 的各个使用界面中,Codex 模型比在通用聊天窗口里更好用:执行框架提供结构化上下文(代码仓库元数据、文件树、代码差异、命令输出),并要求智能体按明确的流程检查是否满足完成条件。
我们最近发表了一篇文章,详细介绍了 Codex 的智能体循环。
我们还推出了 Codex App,让您能在日常工作中用上这个循环:
- 跨项目并行运行多个线程(长时间任务不会耽误您的日常工作)
- 技能(规范规划、实现、测试和报告流程)
- 自动化(在后台处理例行工作)
- Git 工作树(隔离各次运行,让代码差异便于审查,减少来回调整)

我如何设置这次测试
我选择构建设计工具来做这次“实验”,因为这项测试容不得敷衍:既要做好用户界面、数据模型和编辑操作,还要处理大量边界情况。靠表面功夫蒙混不过去,架构一旦有问题,工具很快就会出故障。
我给了 GPT-5.3-Codex 一份详细的项目规格,并将推理强度设为“极高”。它最终连续运行了约 25 小时,始终保持思路连贯,交付了高质量的代码。模型每完成一个里程碑,还会执行一轮验证(测试、代码静态检查、类型检查)。
关键做法:持久保存项目记忆
最重要的做法是让项目记忆能够持久保存。我把规格、计划、约束条件和进展都写进 Markdown 文件,供 Codex 随时回看。这样既能避免偏离目标,也能让“怎样才算完成”始终有一致的标准。
下面的链接指向代码仓库中的相应文件,这几份文件各有分工:
Prompt.md(规格和交付成果)
用途:明确并固定项目目标,避免智能体“做出的东西让人眼前一亮,却不符合需求”。
文件的主要内容:
- 项目目标,以及哪些内容不在目标之内
- 硬性约束(性能、确定性、用户体验、平台)
- 交付成果(完成时必须具备哪些内容)
- 完成条件(检查项和演示流程)
最初的提示词要求 Codex 将这份提示词文件视为完整的项目规格,并按里程碑制订计划:

Plan.md(里程碑和验证步骤)
用途:把开放式任务拆成一系列检查点,让智能体可以逐项完成并验证。
文件的主要内容:
- 每个里程碑的工作量要小到能在一轮循环内完成
- 每个里程碑的验收标准和验证命令
- 遇错即修的规则:如果验证失败,先修复再继续
- 记录已做出的决策,避免在方案之间来回摇摆
- 代码库的预期架构

我们最近在 Codex App、CLI 和 IDE 扩展程序中加入了原生计划模式。在做出更改之前,您可以用它把较大的任务拆成一系列清晰、可审查的步骤,提前与 Codex 确定实施方案。如果还有需要澄清的地方,Codex 会进一步提问。使用 /plan 斜杠命令即可启用计划模式。
Implement.md(以计划为依据的执行指令)
用途:这份操作手册明确告诉 Codex 应该怎么做:遵循计划,将代码改动限制在当前任务范围内,执行验证,并更新文档。
文件的主要内容:
- 逐个推进里程碑,以记录计划的 Markdown 文件为准
- 每完成一个里程碑就运行验证(发现问题立即修复)
- 将代码改动控制在既定范围内(不扩大任务范围)
- 持续更新用于记录项目进展的 Markdown 文件

Documentation.md(记录交付过程中的进展和决策)
用途:这份文件既是共享记忆,也是审计日志。即使我离开几个小时,回来后也能了解这段时间里发生了什么。
文件的主要内容:
- 当前里程碑的状态(已完成哪些工作,接下来要做什么)
- 已做出的决策及其原因
- 如何运行和演示(命令和快速冒烟测试)
- 已知问题和待跟进事项

在这次运行中,Codex 实际验证里程碑的过程如下:

每个里程碑都要验证
Codex 写完代码后并没有想当然地认为代码能用。每完成一个里程碑,它都会运行验证命令,修复发现的问题,然后再继续。
下面是我要求它运行的一些质量检查命令:

下面是 Codex 在代码静态检查失败后修复问题的一个例子:

智能体构建了什么
最终的设计工具还不完美,也没达到生产可用的标准,但已经可以实际操作和测试。这次运行的验收标准不止是“能编译”,还要看“它是否遵循了指令,做出来的东西是否真的能用”。
已实现的主要功能包括:
- 画布编辑(画框、编组、形状、文本、图像和图标、按钮、图表)
- 实时协作(跨标签页同步在线状态、光标位置、选中内容和编辑操作)
- 属性检查器控件(几何属性、样式、文本)
- 图层管理(搜索、重命名、锁定或隐藏、调整顺序)
- 参考线、对齐和吸附
- 保存和恢复历史快照
- 回放时间线,并从先前的时间点创建分支
- 原型模式(交互热区和流程导航)
- 评论(固定讨论线程,可标记为已解决或重新打开)
- 导出(支持保存、导入和导出,还可通过 CLI 导出为 JSON 或 React + Tailwind 代码)
用 Codex 执行长时间跨度任务的经验
这次运行能顺利完成,靠的不是某个巧妙的提示词,而是以下做法的配合:
- 明确目标和约束条件(规格文件)
- 为各个里程碑设置检查点和验收标准(
plans.md) - 用操作手册说明智能体应如何执行任务(
implement.md) - 持续验证(测试、代码静态检查、类型检查、构建)
- 随时更新任务状态和审计日志(
documentation.md),让整个运行过程都有据可查
这也是长时间跨度编程任务的发展方向:开发者可以在设定明确约束后,把更多工作委托给智能体,减少全程看管的时间。
让 Codex 试试您自己的长时间任务
这次持续 25 小时的 Codex 运行,让我们提前看到了软件开发可能走向何处。除了用单个提示词完成一次任务,或在结对编程中与模型频繁互动,我们现在还可以和智能体长期协作,把一项实际工作从头到尾交给它负责。您可以在各个里程碑调整方向,无需逐行盯着代码。
我们对 Codex 的期望很明确:让它更像一位能协作的队友,更好地结合您的实际工作上下文,并通过明确的约束和检查机制,让工作成果可靠、便于审查和交付。我们已经看到,智能体接手常规的实现和验证工作后,开发者能更快地推进项目,把精力留给最重要的部分:设计、架构、产品决策,以及那些没有现成模板的新问题。
受益的也不只是开发者。随着 Codex 更准确地理解意图,并通过计划、验证、预览和回滚等机制为安全操作提供支持,更多没有开发背景的人也能构建产品、持续迭代,无需整天待在 IDE 里。Codex 的各个使用界面和模型还会继续改进,但目标始终如一:让智能体逐渐成为您可以放心托付长时间跨度任务的队友,减少您盯着工具运行的时间。
如果您也想亲自试试,可以从以下资源入手: