

一年前,我们推出了 Responses API,为开发者和企业构建实用、可靠的智能体打下了基础。有了一套可供模型调用的托管工具,AI 从聊天助手发展成了能代您采取行动的系统。如今,Responses API 支持多种工具,可用于运行智能体工作流,还提供了一系列新功能和基础构件,专为使用更强大的模型进行开发而设计。
如今,已有数千名开发者在使用 Responses API,帮助客户支持、法律服务、生命科学、旅游等领域的团队提高工作效率。我们已经分享过这些领域的许多成功案例。今天,让我们来看看五个较少被提及的故事,了解过去一年里开发者用 Responses API 做出了哪些产品。
检测并修复 AI 智能体故障
作者:Alexis Gauba 和 Ben Hylak,来自 Raindrop AI
工具: 自建工具
模型: GPT-5.2(正在测试 GPT-5.4)
全球一些最有雄心的 AI 公司使用 Raindrop 监控平台,及时发现智能体在生产环境中的异常行为。随着智能体变得越来越复杂,这些故障造成的影响也越来越严重。
如果没有 Responses API,构建这样的监控系统会困难得多,系统的可靠性也会大打折扣。
Raindrop 通过 Vercel AI SDK 调用 Responses API,在后台运行分析。这样既能让不同提供商的模型共用工具,也能让系统在不同环境间迁移。这些工作流会找出异常行为。一旦出现问题,系统就会向开发者发出告警,并帮助他们诊断问题的根源。
平台围绕三个核心系统构建:
- 智能体行为监控
- 故障检测与告警
- 开发者排查与调试工具
借助这三个系统,团队可以在智能体故障影响生产系统之前发现、跟踪并修复问题。
监控架构
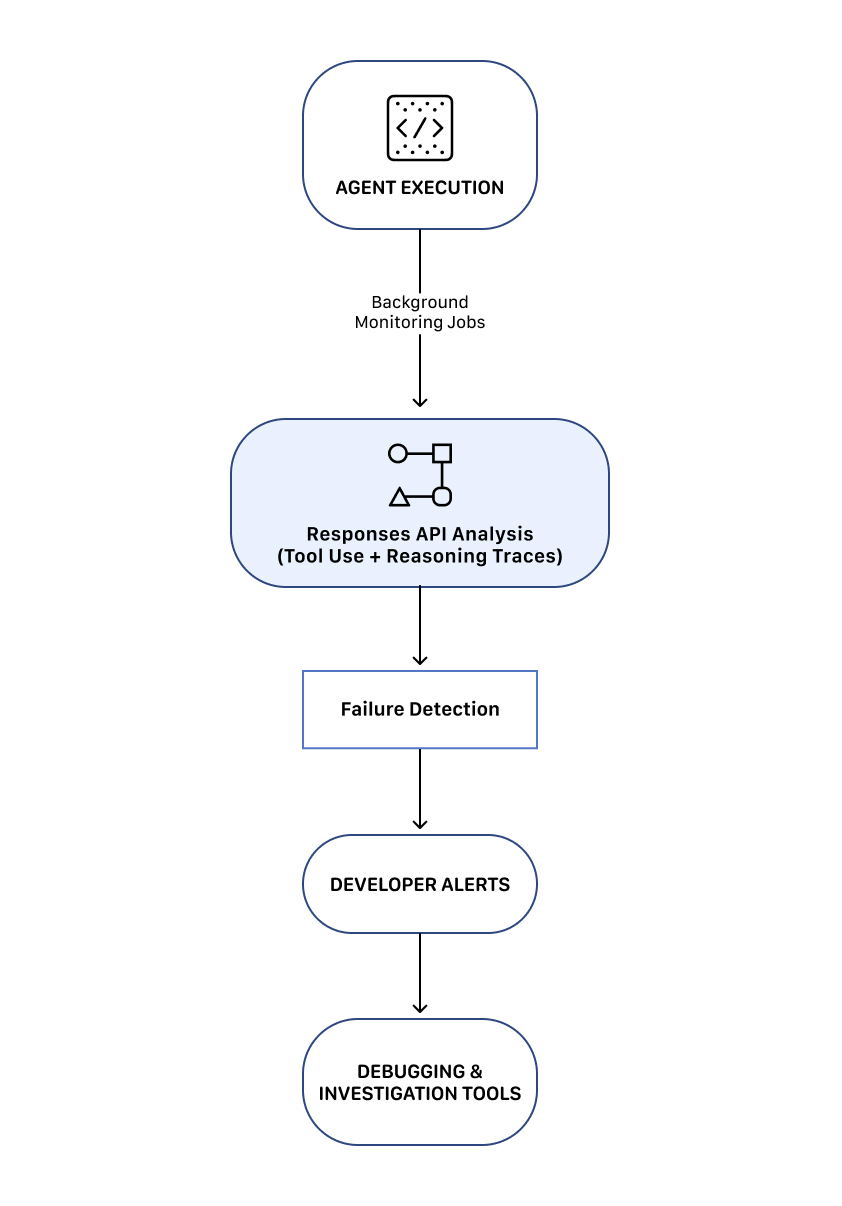
这套架构让团队能够持续监控智能体行为,并在出现问题时迅速响应。
1. 智能体行为监控
系统持续评估智能体的行为,判断它是否按预期运行。
开发者可以设定条件,用来判断哪些结果不符合预期。一旦满足这些条件,平台就可以发出告警。
2. 故障检测与告警
一旦检测到异常,Raindrop 就会通知开发者,并提供排查问题所需的上下文。
开发者可以使用平台提供的工具:
- 跟踪智能体在不同版本之间的行为变化
- 确定哪些提示词或系统改动引发了故障
- 检查推理轨迹和工具调用
这样,开发者就能迅速查明故障根源并部署修复。
3. 排查与调试工具
Raindrop 还提供了诊断智能体工作流问题的工具。有了这些工具,团队可以根据检测到的故障,有针对性地改进系统。
Raindrop AI 使用 Responses API 运行所有耗时较长的后台分析工作流。如果没有它,实现这些监控系统会困难得多。
面向复杂数据的深度推理工作流
作者:Eric Provencher,来自 Repo Prompt
使用的工具: 搭配 App Server 和 MCP 的 Codex、网页搜索
使用的模型: GPT-5.3-Codex
在规划或审查时,如果让推理模型自己翻找资料,就会浪费它的上下文窗口。我们用另一个智能体提前筛选、整理上下文,让推理模型尽可能把推理能力用在解决眼前的问题上。
Eric Provencher 构建了一套系统,帮助开发者和研究人员深入分析大规模文档集、代码库和数据集。
Repo Prompt 专注于上下文工程:自动收集、整理相关信息,并将其组织成推理模型能够有效分析的结构。
许多智能体系统侧重于收集数据,而 Eric 设计的架构将上下文收集与深度推理分开。系统先通过智能体工作流汇集相关上下文,再将整理好的信息交给专门负责分析的推理模型。
平台使用 OpenAI Responses API 编排长时间运行的智能体工作流和推理任务,应用场景包括:
- 大型代码库分析与架构规划
- 深入的代码审查工作流
- 对大规模文档集进行研究分析
- 医学和科学文献分析
系统由三个核心部分组成:构建上下文的智能体工作流、深度推理模型(“Oracle”工作流),以及反复开展研究与分析的迭代循环。
1. 构建上下文的智能体工作流
系统的第一阶段由负责构建上下文的智能体执行。这个工作流分析大量数据,判断哪些信息与当前查询相关。
智能体通过 Responses API 调用工具,结合模型的推理能力,找出相关文件、文档之间的关联,以及包含关键信息的段落。
这一阶段输出一份结构化的上下文资料包,作为推理阶段的输入。
2. “Oracle”深度推理工作流
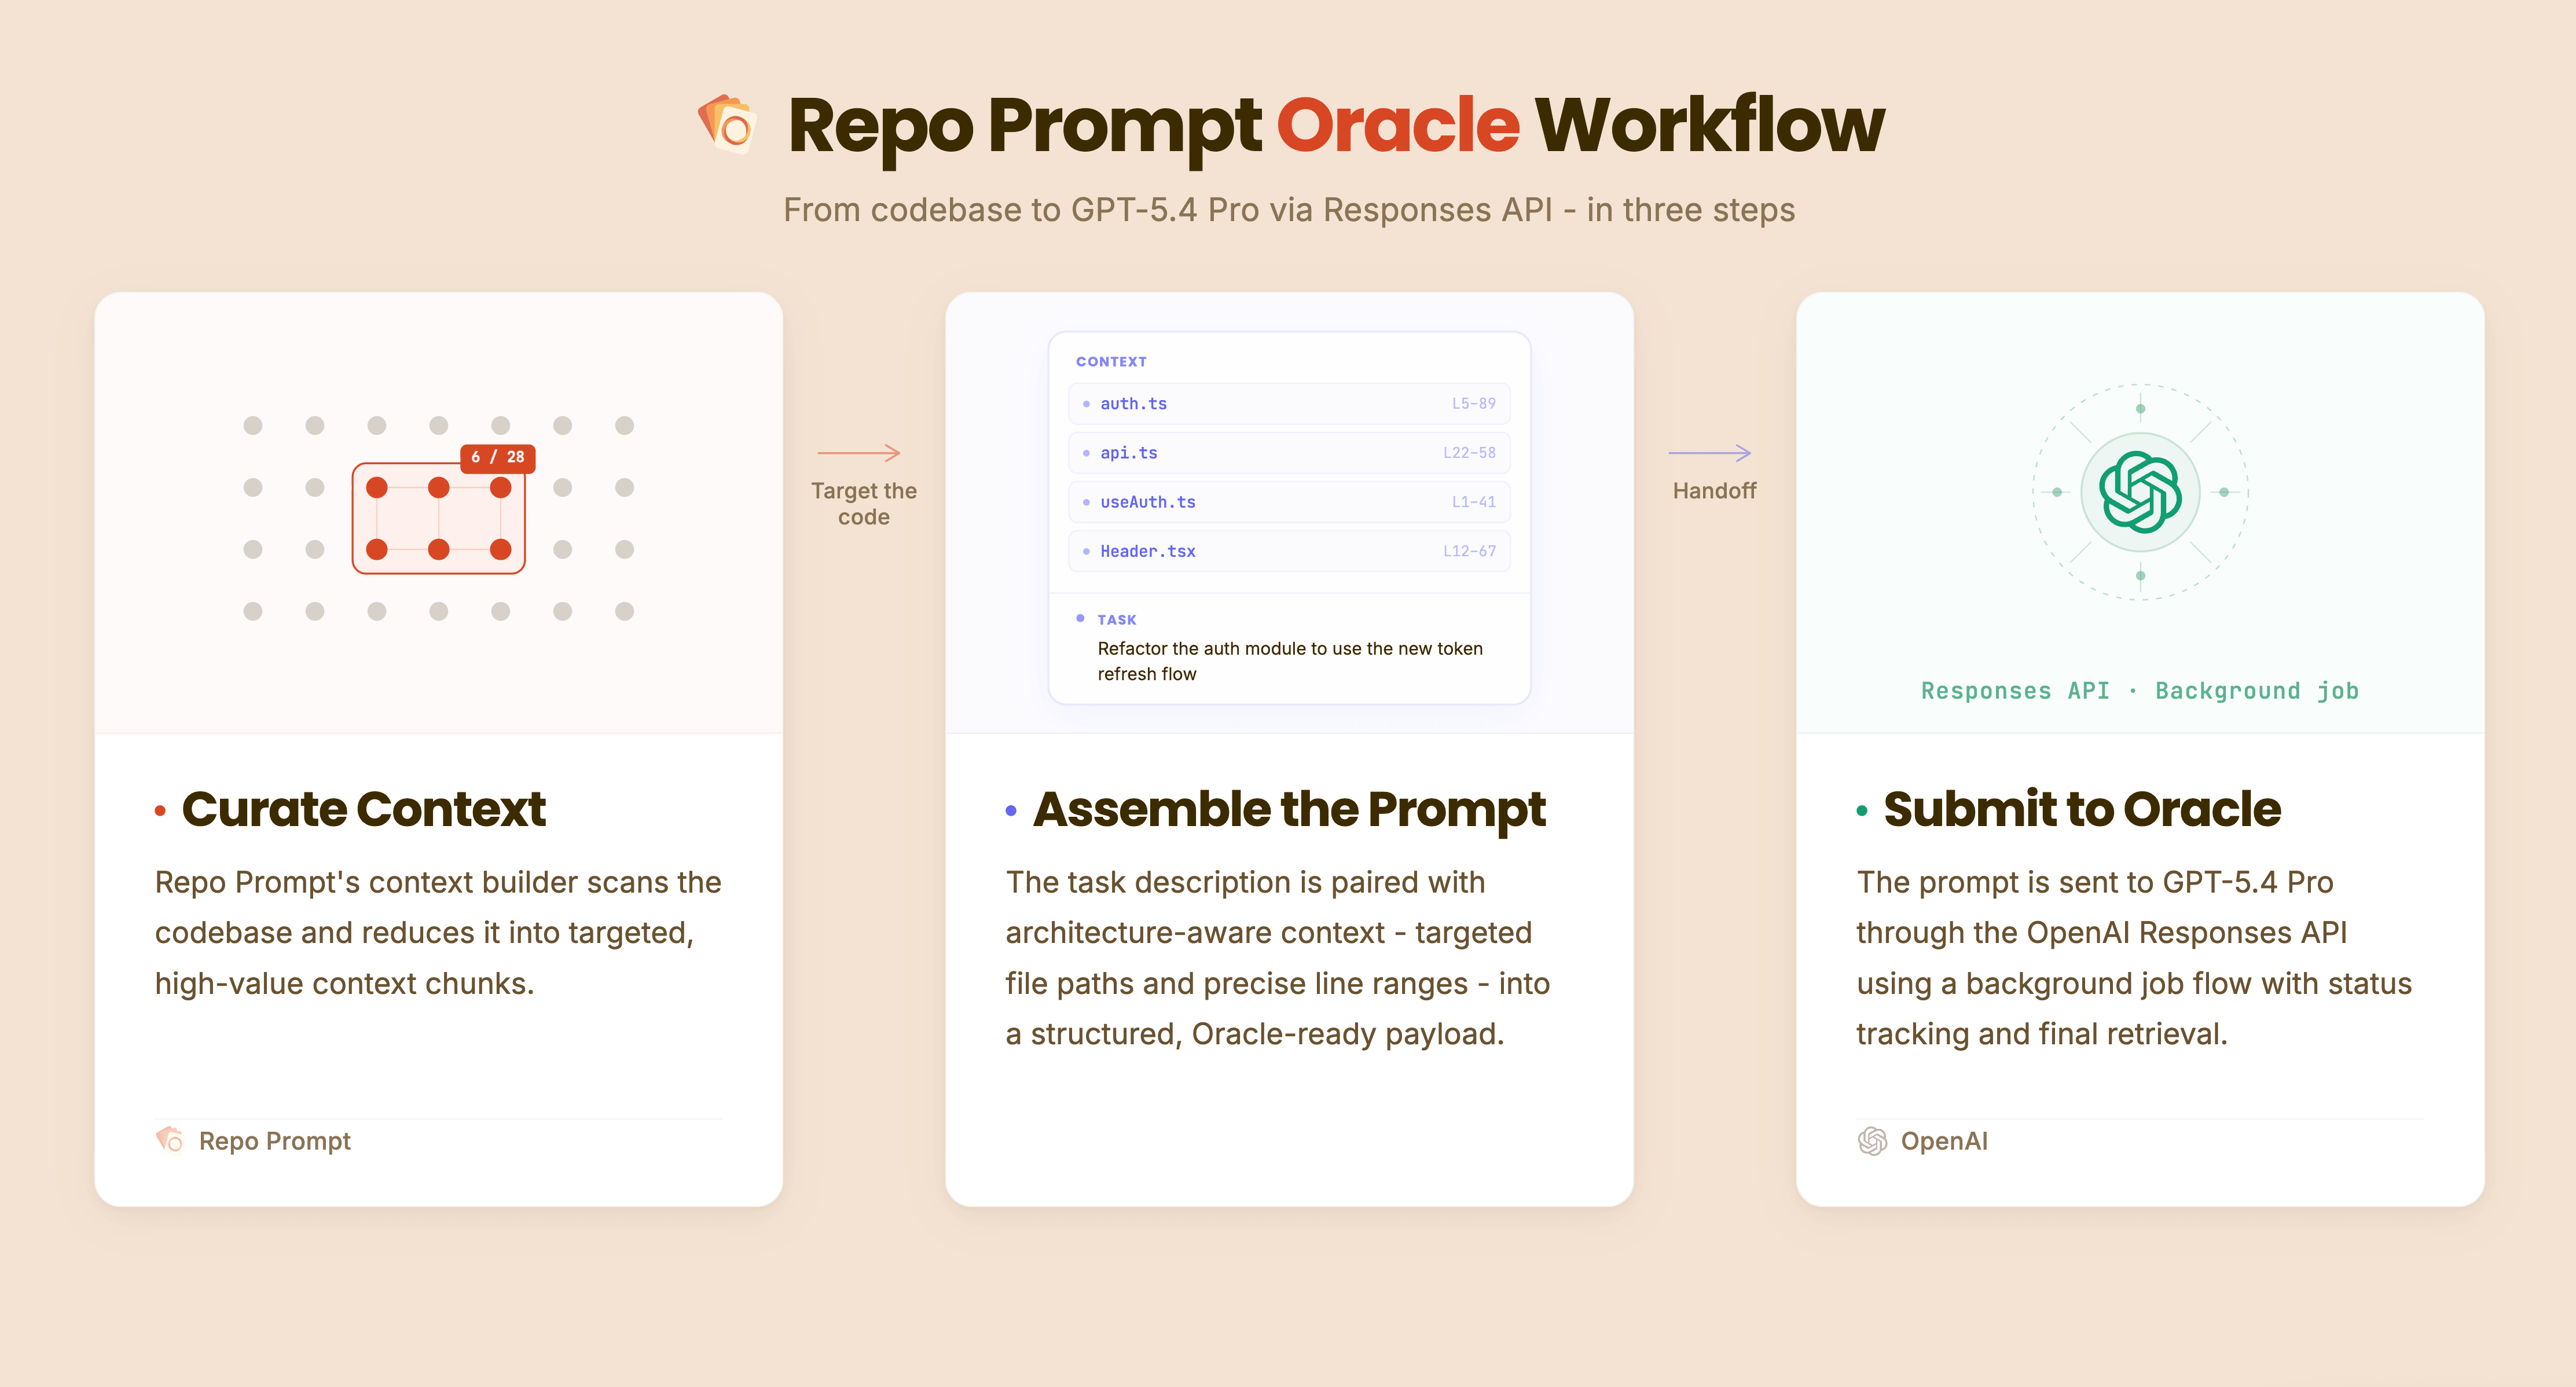
与构建上下文的智能体不同,“Oracle”模型(即深度推理模型)不调用工具,也不额外检索信息。它只负责分析收到的、已经整理好的上下文。
将研究与推理分开后,模型可以把全部推理能力用于理解问题。在许多工作流中,推理阶段可以持续很长时间,让模型深入分析给定上下文中的复杂关系。
3. 迭代研究与分析
系统也支持多轮迭代推理。推理模型给出结果后,另一个智能体可以审查结果,判断是否需要进一步调查。
如有需要,系统会启动新一轮上下文收集与推理。通过这样的循环,系统可以持续开展调查,逐步完善分析结果。
迭代工作流

系统依赖 Responses API 的几项能力:
- 后台作业:运行耗时数分钟乃至数小时的推理任务
- 智能体编排:协调智能体循环执行上下文收集、推理和验证
- 可观测性:在推理工作流长时间运行期间监控和管理其执行过程
平台使用 Codex 模型收集相关上下文并将其结构化,再把整理好的上下文交给能力更强的推理模型,进行更深入的分析。正是这些能力,让平台能够采用结合智能体工作流与深度推理模型的混合架构。
为黑胶唱片收藏者打造对话界面
作者:Ash Ryan Arnwine,来自 Collxn
工具: 网页搜索和 16 个自定义工具
模型: GPT-5.4、GPT-5 nano
和从头搭建一套完整的检索增强生成系统等方案相比,Responses API 让我省了不少工夫。
Ash Ryan Arnwine 打造了 “Collxn”(名字让人联想到英文的 collection,即“收藏”)。这个小服务有个大目标:帮助黑胶收藏者重新发现唱片架上的藏品,并与自己的唱片互动。
收藏者经常在 Discogs 上记录庞大的唱片收藏,有时多达数千张。Collxn 接入收藏者的唱片库,每天发出一封名为“Daily Drop”的邮件,介绍一张不同的唱片及其音乐人,帮助收藏者重温自己拥有的音乐。
翻看唱片时,能随口提问会更有趣。为此,Collxn 使用 OpenAI Responses API 打造了聊天界面,让用户真的能和自己的唱片聊起来。
支持工具调用的对话界面
这款应用使用 Responses API 提供名为“Ask This Drop”的聊天界面,用户可以针对 Daily Drop 中介绍的唱片提问。
模型配置了 Discogs API 工具,回答问题时可以直接从 Discogs 获取信息。
例如,用户可以这样问:
- 这张唱片现在的市场价是多少?
- 这位音乐人还发行过哪些专辑?
- 这个压片版本有多罕见?
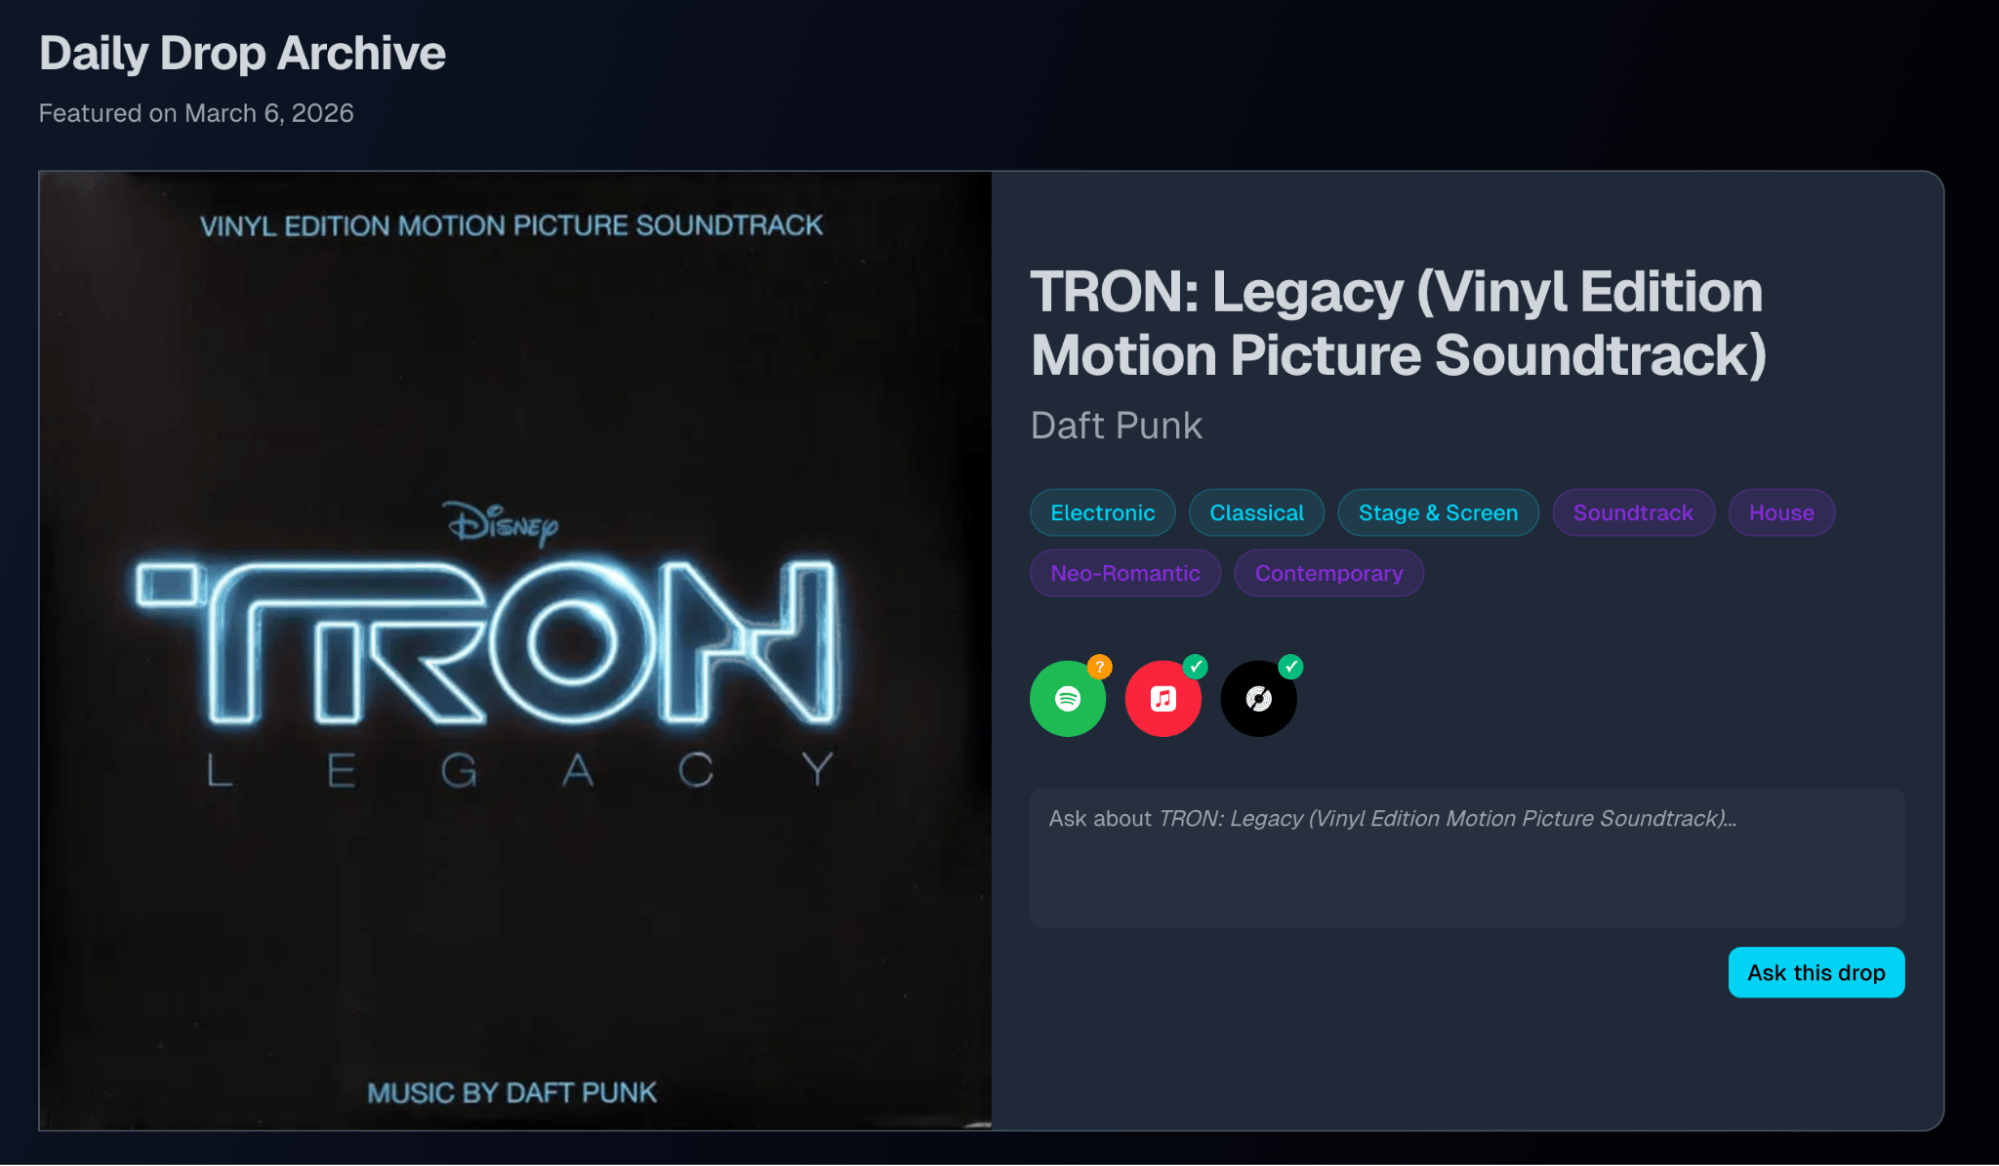
通过 Ask This Drop 的聊天界面,Collxn 用户可以和自己的黑胶唱片对话。
收藏者只需提出问题,就能获得结合 Discogs 实时数据和个人唱片收藏信息生成的答案。
这样一来,原本静态的唱片收藏就成了对话的起点,也让收藏者与更广阔的音乐世界建立了联系。
Daily Drop 与音乐人动态
Collxn 还使用 OpenAI Agents SDK,为 Daily Drop 邮件中介绍的音乐人生成“近期动态”栏目。
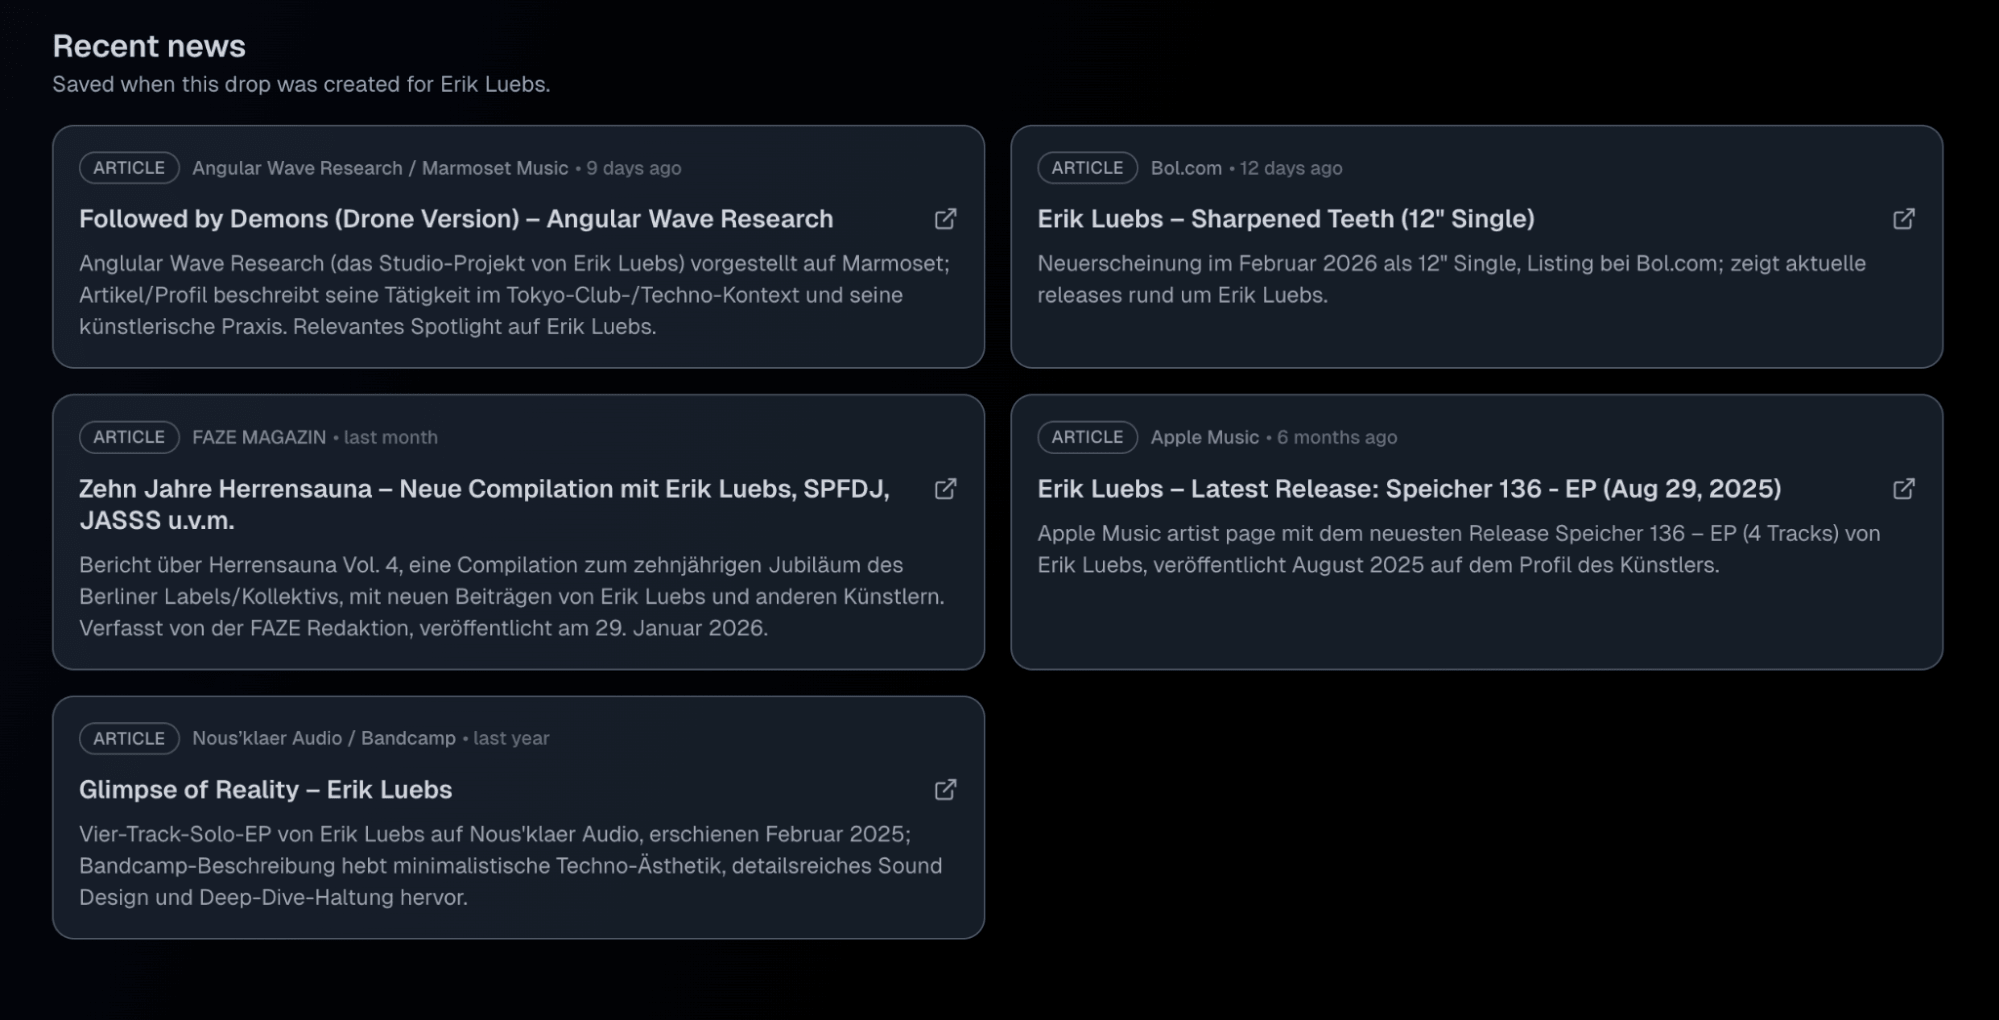
Collxn 使用 OpenAI Agents SDK 生成 Daily Drop 中的音乐人动态。
这项功能使用具备网页搜索能力的智能体,查找有关音乐人的近期文章或动态,并将这些信息加入每日邮件。在测试用户中,动态栏目很快就成了产品最受欢迎的部分之一,因为它让收藏者在翻看藏品时也能了解音乐界正在发生的事。
为了推出“Ask This Drop”,Ash 最终将 Collxn 迁移到了 Responses API。这样,应用就能在对话工作流中进行多步推理,并调用内置工具和自定义工具。在 Collxn 中,Responses API 的内置网页搜索工具让用户可以在聊天时查找音乐人的最新动态。此外,Collxn 还使用了 16 个自定义工具,用于访问 Discogs API、查询用户的 Collxn 账户等。
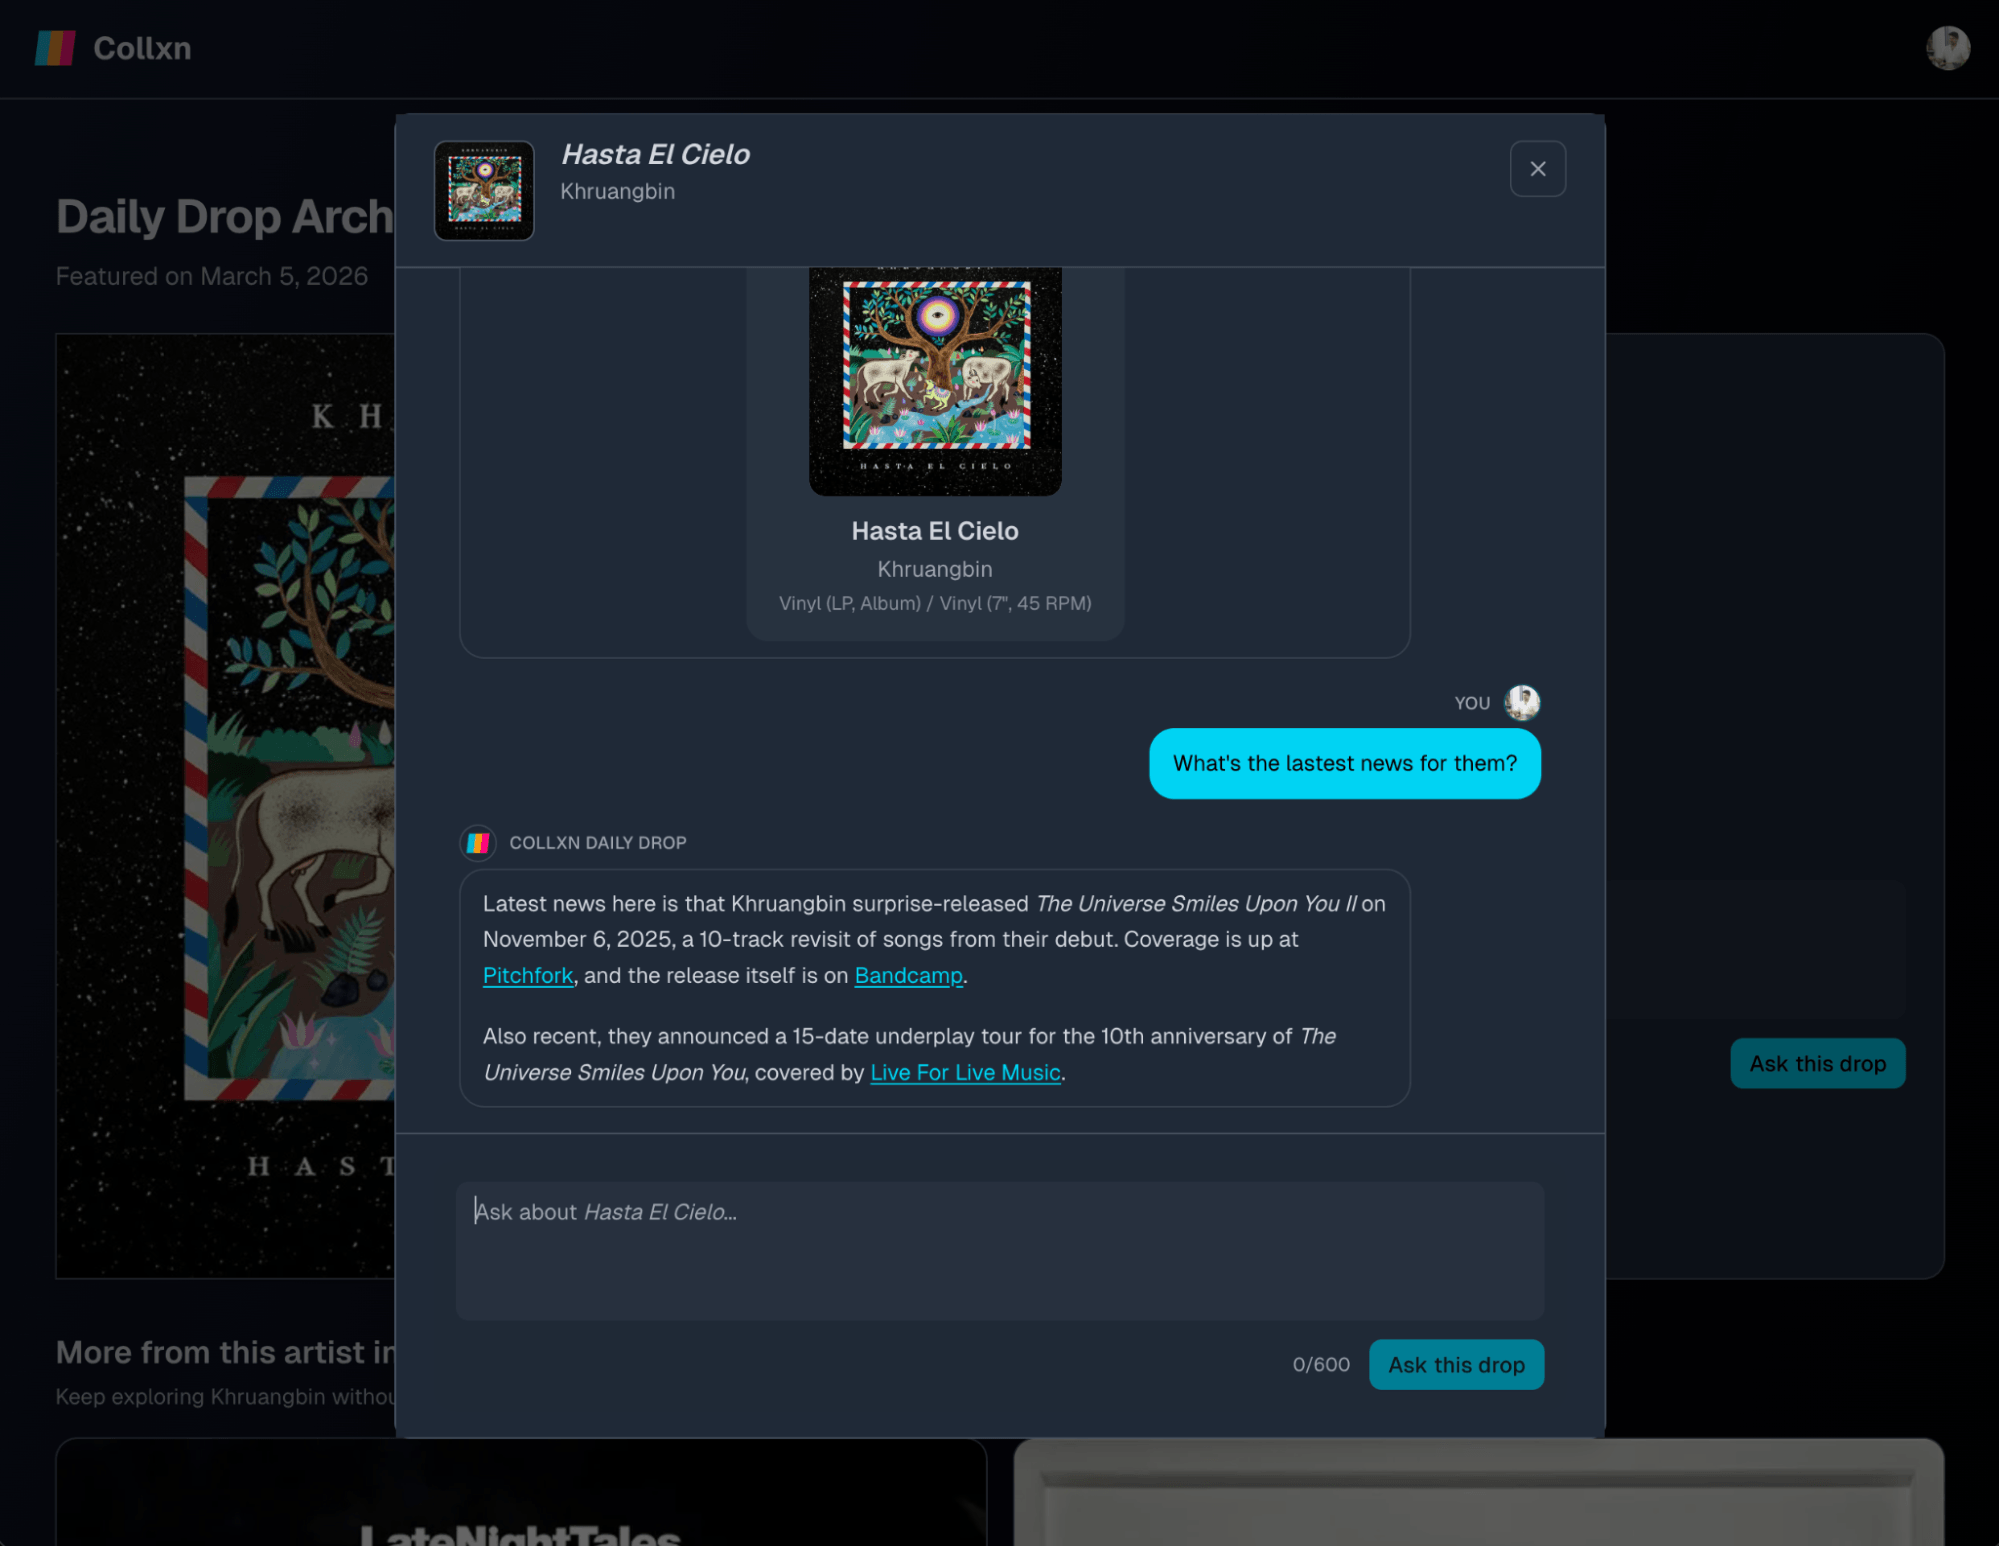
通过 Responses API 的网页搜索工具,Collxn 的“Ask This Drop”可以实时查询音乐人动态。
Responses API 支持有状态对话,让应用处理多轮聊天更简单、更快捷。Ash 表示,总体而言,与搭建完整的检索增强生成(RAG)系统相比,使用 Responses API 简化了应用架构。
将屏幕录像转化为交互式产品演示
作者:Nick Sorrentino 和 Pawel Wszola,来自 Arcade 团队
工具: 计算机使用
模型: GPT-5.2、computer-use-preview
接入基于 API 的内容生成功能后,发布演示所需的步骤减少了 50%,演示发布率和产品采用率都显著提高了。
录屏是大多数团队本来就在做的事。Arcade 能把屏幕录像转化为制作精良的交互式产品演示。团队只需把操作流程录制一次,其余工作就交给 Arcade,省去了现场讲解产品或编写分步文档的工夫。
平台会在后台分析录像,自动生成带引导的操作演示,解释每一步发生了什么。
演示生成工作流
一次录屏的处理流程如下:
- 用户在执行操作流程时录制屏幕。
- 在桌面端或浏览器中,Arcade 直接以结构化形式记录点击、输入、滚动等交互。
- 在移动端,由于 iOS 沙盒不允许应用捕获系统范围内的交互,用户改为直接录制应用的屏幕画面。
- 系统将录像发送到 OpenAI Responses API,由计算机使用工具分析视频帧,推断用户执行了哪些操作。
- 系统将推断出的操作转换成结构化步骤。
- Arcade 生成讲解文字和交互热点,引导观看者完成演示。
这些步骤会自动组成用户看到的交互式操作演示。
接下来,系统将结构化的操作传给 Chat Completions API,为演示的各个环节生成标题和热点说明。用户可以用内置的 AI 编辑工具调整生成的文案,例如缩短或改写文字。
制作演示所需的操作减少一半
自动生成演示讲解,大幅减少了发布产品操作演示所需的工作量。
接入基于 API 的工作流后:
- 发布前所需的操作次数中位数下降了 50%
- 操作次数的第 80 百分位数从约 230 次降至约 120 次
- 演示发布率和产品采用率均有提高
Arcade 简化了演示制作流程,让团队能更快地将原始屏幕录像转化为制作精良的交互式演示。
衡量并提升品牌在 AI 回答中的可见度
作者:Tunde Adeyinka 和 Ramon Silva,来自 Hexagon
使用的工具: 网页搜索
使用的模型: GPT-5.2 Chat
Tunde Adeyinka 和 Ramon Silva 创办了 Hexagon,希望为零售商解答一个新问题:AI 助手是怎样介绍您的产品的?
AI 助手越来越多地影响消费者发现产品的方式。Hexagon 帮助企业监测自己的品牌在 AI 生成的回答中如何呈现,并持续改善这种呈现效果。
平台使用 OpenAI Responses API 运行三个核心系统:
1. 回答模拟架构
Hexagon 每天运行模拟流水线,评估 AI 助手如何回答与产品相关的问题。系统每天生成数千条贴近真实场景的消费者提示词、产品推荐提示词和购物查询,然后将它们发送给 Responses API。系统分析返回的结果,跟踪品牌在各类 AI 回答中的可见度。
零售商客户由此可以看到自己的产品被提及的频率,以及这些回答随时间发生的变化。
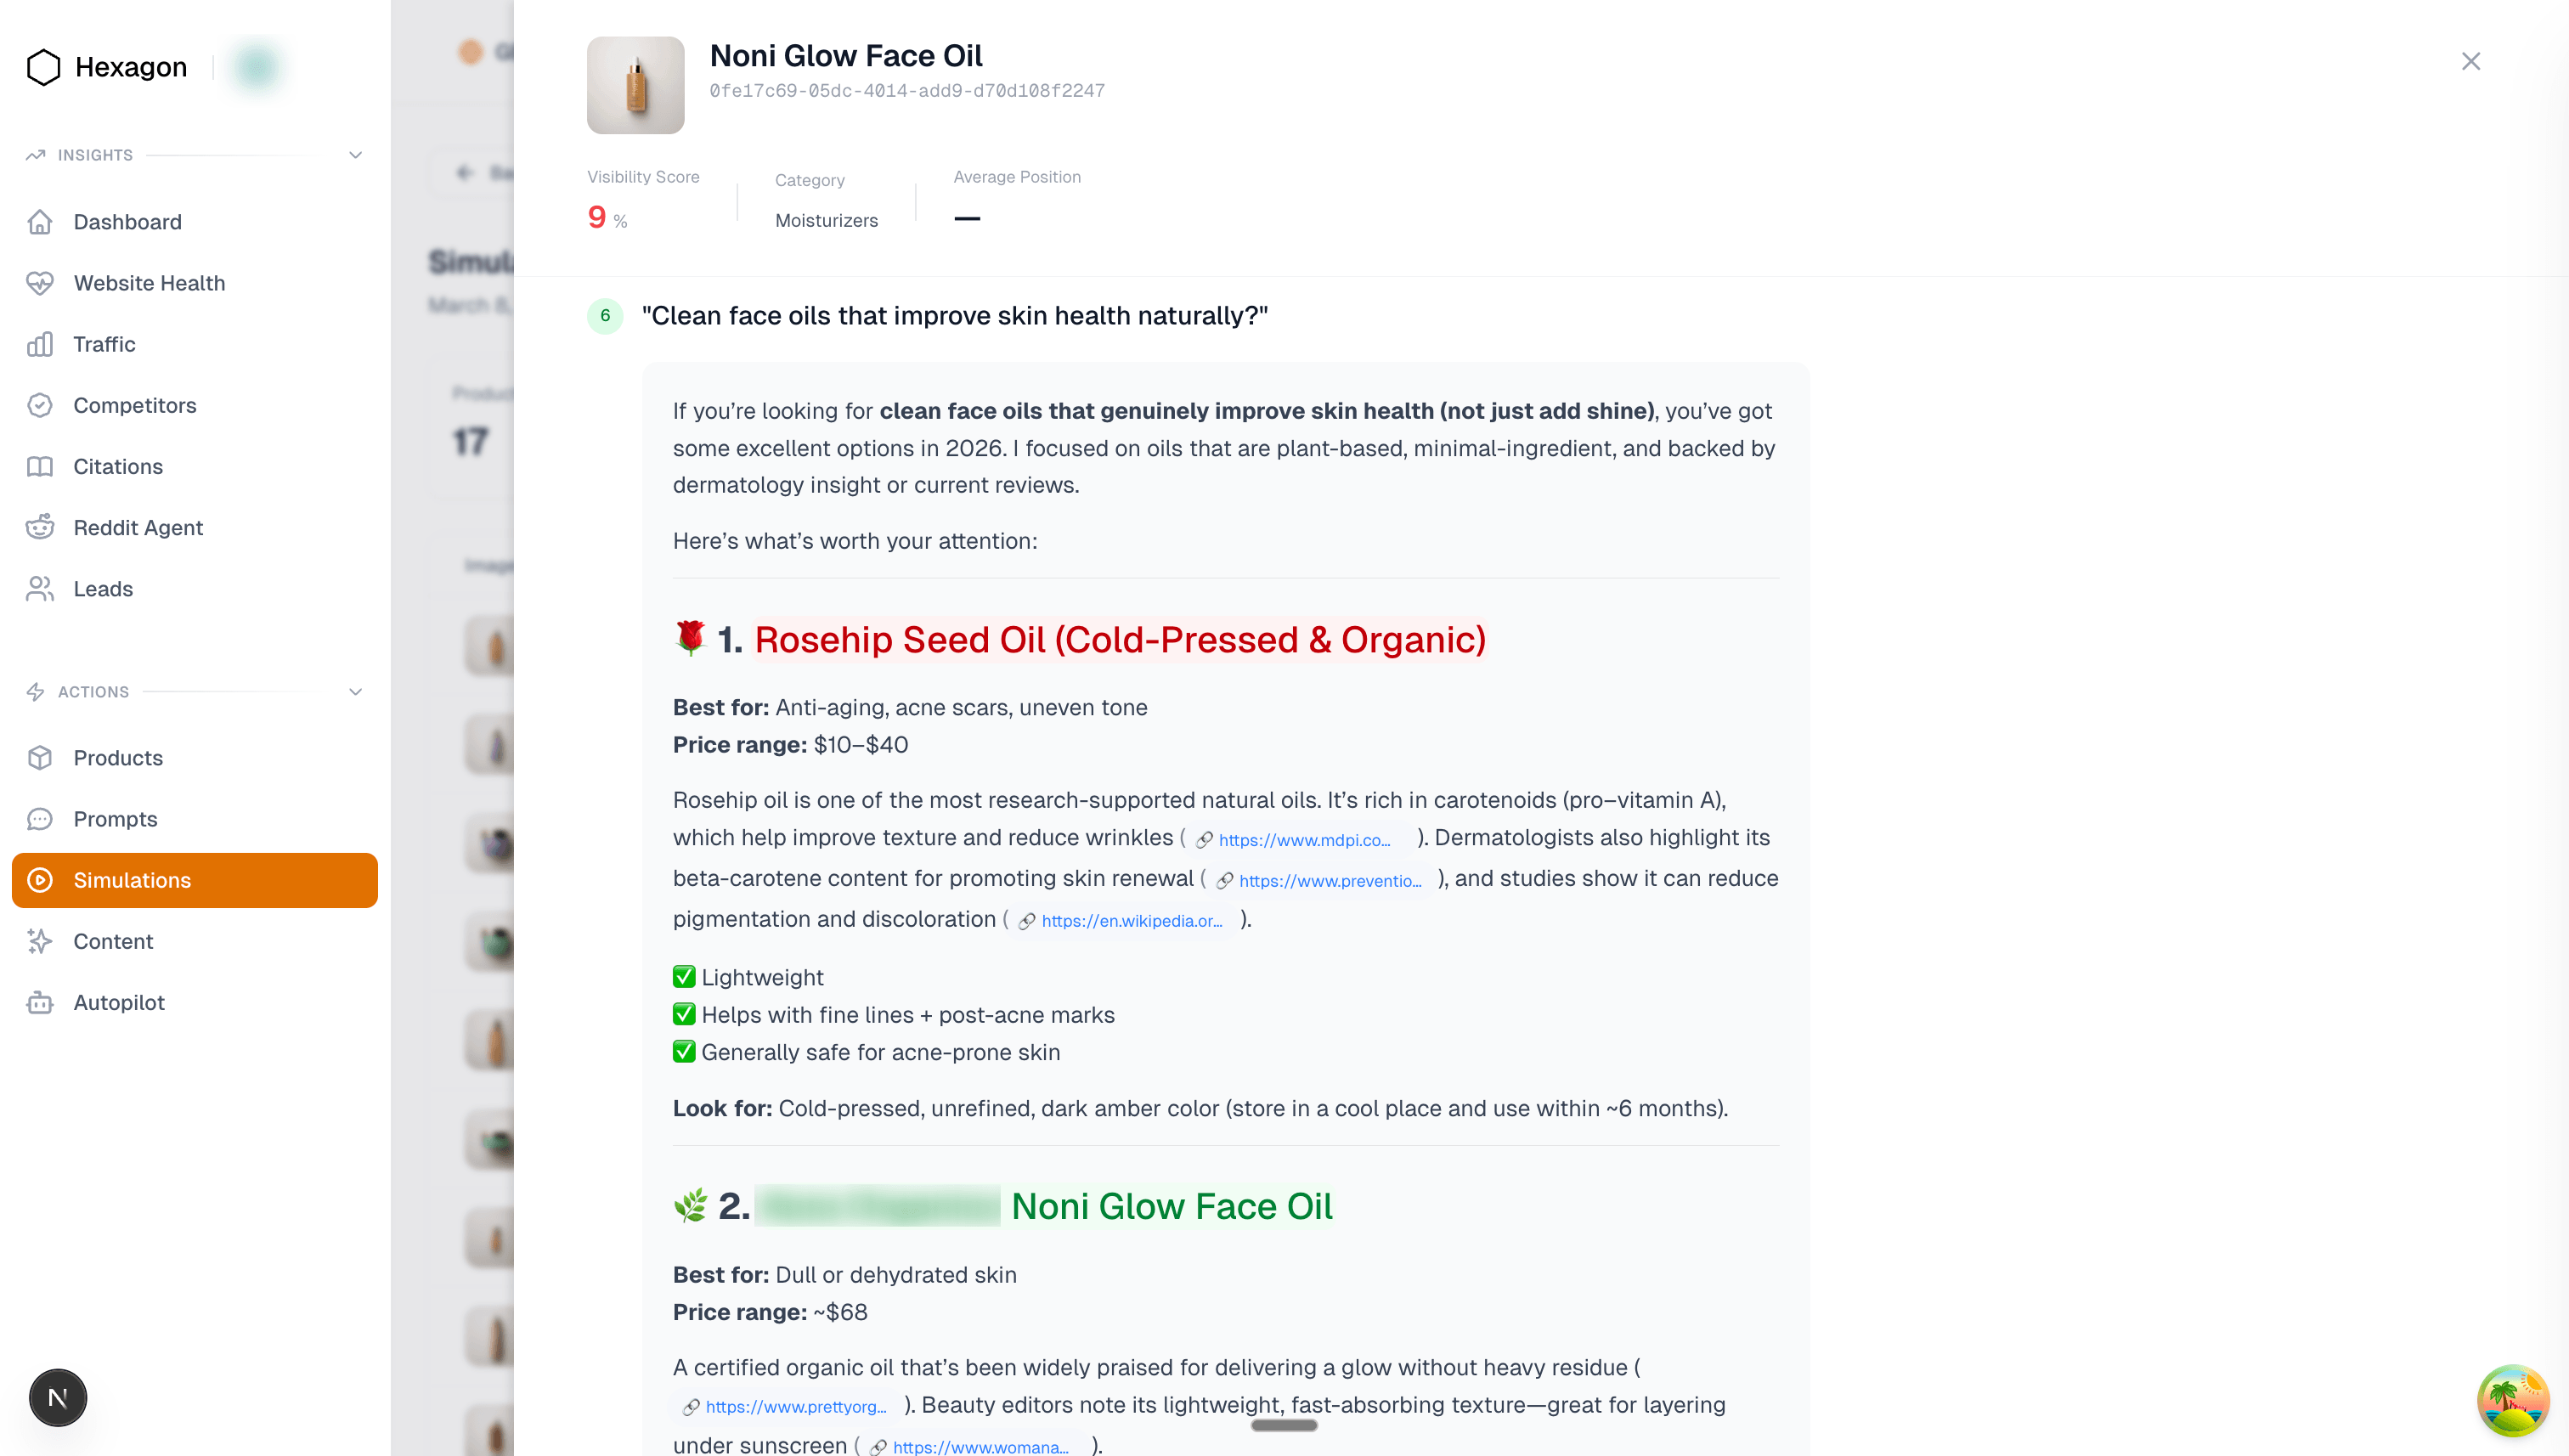
2. 多智能体内容生成流水线
除了提供数据分析,Hexagon 还使用 Responses API 生成经过优化的内容,以提升品牌在 AI 回答中的可见度。
系统采用由四个智能体组成的架构。每个智能体负责流水线中的一个专门环节,并将输出交给下一环节,直至最终内容生成并发布。发布前,智能体通过非确定性循环相互沟通,反复完善内容。
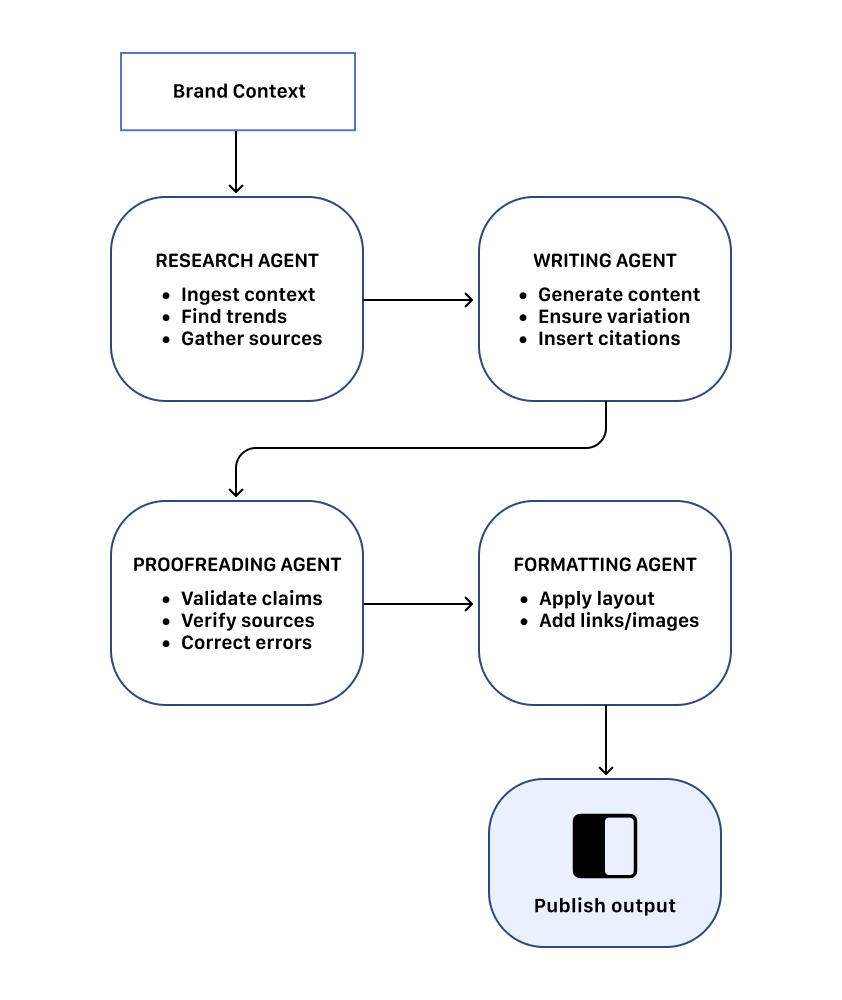
3. 仪表板与客户工具
平台还提供了聊天机器人“Hexi”,它基于 Responses API 的函数调用能力构建。客户可以与 Hexi 对话,探索分析结果,自行生成品牌在 AI 回答中可见度的数据摘要。Hexagon 通过面向零售商的仪表板展示分析结果,让零售商跟踪产品在 AI 生成的回答中如何呈现。
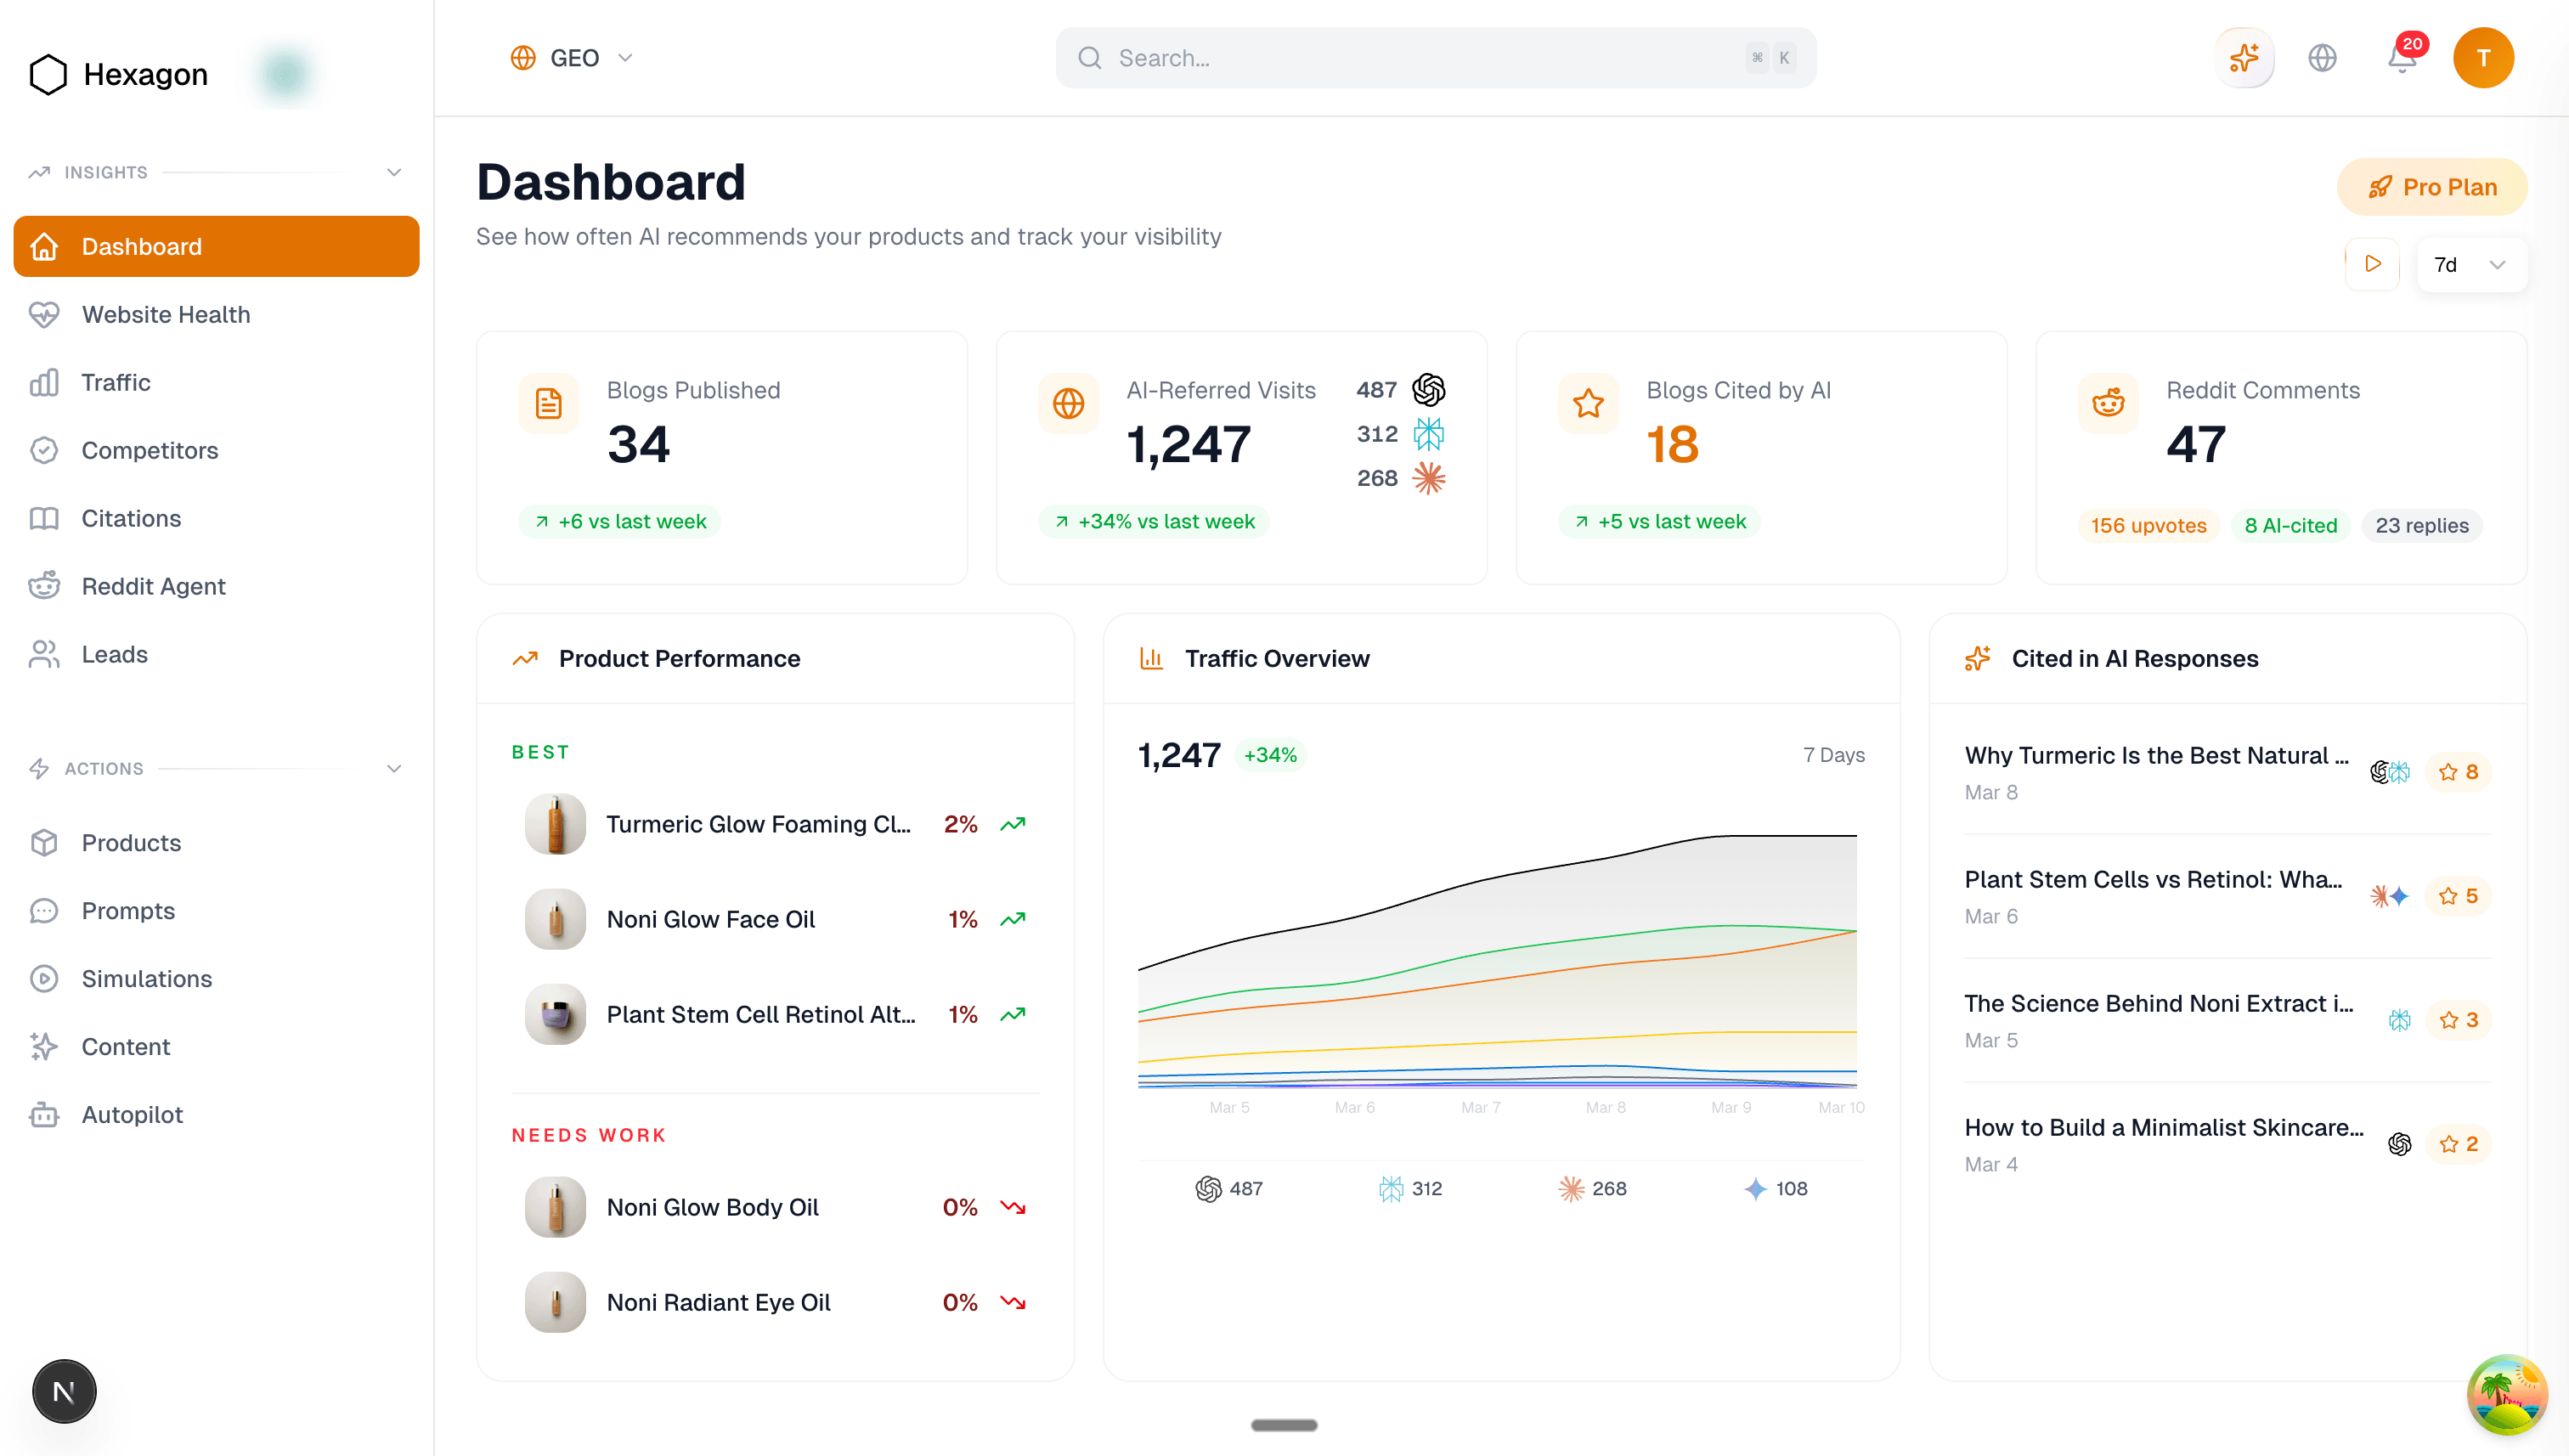
为了让产品各处用到的模拟都贴近真实场景、具有实用价值,Hexagon 使用了 Responses API 的几项关键能力:
- 网页搜索:模拟与 ChatGPT 开启网页浏览时类似的回答。
- 用户位置参数:模拟来自不同地区的查询,以测试回答是否因地区而异。
- 推理强度:控制回答的深度和复杂程度。
- 最大输出 Token 数:为长篇回答设置长度上限。
- 上下文持久化:在多次调用之间保留上下文,从而支持多智能体工作流。
Responses API 提高了回答质量,也更好地保留了多次调用之间的上下文。这两点对支撑 Hexagon 平台的多步流水线至关重要。
结语
推出一年来,Responses API 已成为开发者构建智能体软件的核心组件。
这五个开发者故事展示了这些能力在实际产品中的应用:多个智能体协同调用工具、检测缺陷、运行工作流,帮助开发者交付由 AI 驱动的产品。
平台本身也在快速发展:编排能力不断增强,工具生态也更加丰富,新增了支持联网的 OpenAI 托管容器和 shell 工具等。
工具更多了。
能力更强了。
也有更多开发者在打造我们还没想到的产品。
一起看看第二年开发者会做出什么。