
GPT-5 已经发布,我们想谈谈接入它的最佳方式,也就是使用 Responses API,并解释为什么我们要为推理模型和未来的智能体应用量身设计这个 API。
每一代 OpenAI API 的设计都围绕同一个问题展开:怎样才能让开发者以最简单、最强大的方式与模型交互?
模型本身的工作方式一直影响着我们的 API 设计。最早的 /v1/completions 端点很简单,能做的事也有限:您给模型一段提示词,它就顺着您的思路写下去。开发者可以通过少样本提示等技巧,尝试引导模型输出 JSON 或回答问题,但当时模型的能力远不及今天。
随后,RLHF 和 ChatGPT 相继出现,模型进入了后训练时代。原本只能续写半篇文章的模型,如今能像对话伙伴一样 回应 您。为了跟上这一变化,我们开发了 /v1/chat/completions(只用了一个周末,这段经历后来广为人知)。我们引入了 system、user、assistant 等角色,让开发者可以快速搭建聊天界面,并为其设置自定义指令和上下文。
模型的能力不断增强。很快,它们就能看、能听,也能说了。2023 年末推出的函数调用成了最受开发者喜爱的功能之一。大约在同一时期,我们发布了 Assistants API 的测试版,首次尝试打造一个全面支持智能体的接口,并提供代码解释器和文件搜索等托管工具。一些开发者很喜欢它,但与 Chat Completions 相比,这个 API 在设计上限制较多,接入也更困难,因此始终未能得到广泛采用。
到 2024 年末,我们已经明确需要一个统一的 API:它要像 Chat Completions 一样容易上手,像 Assistants 一样强大,还要专门针对多模态模型和推理模型来设计。于是就有了 /v1/responses。
/v1/responses 构成一个智能体循环
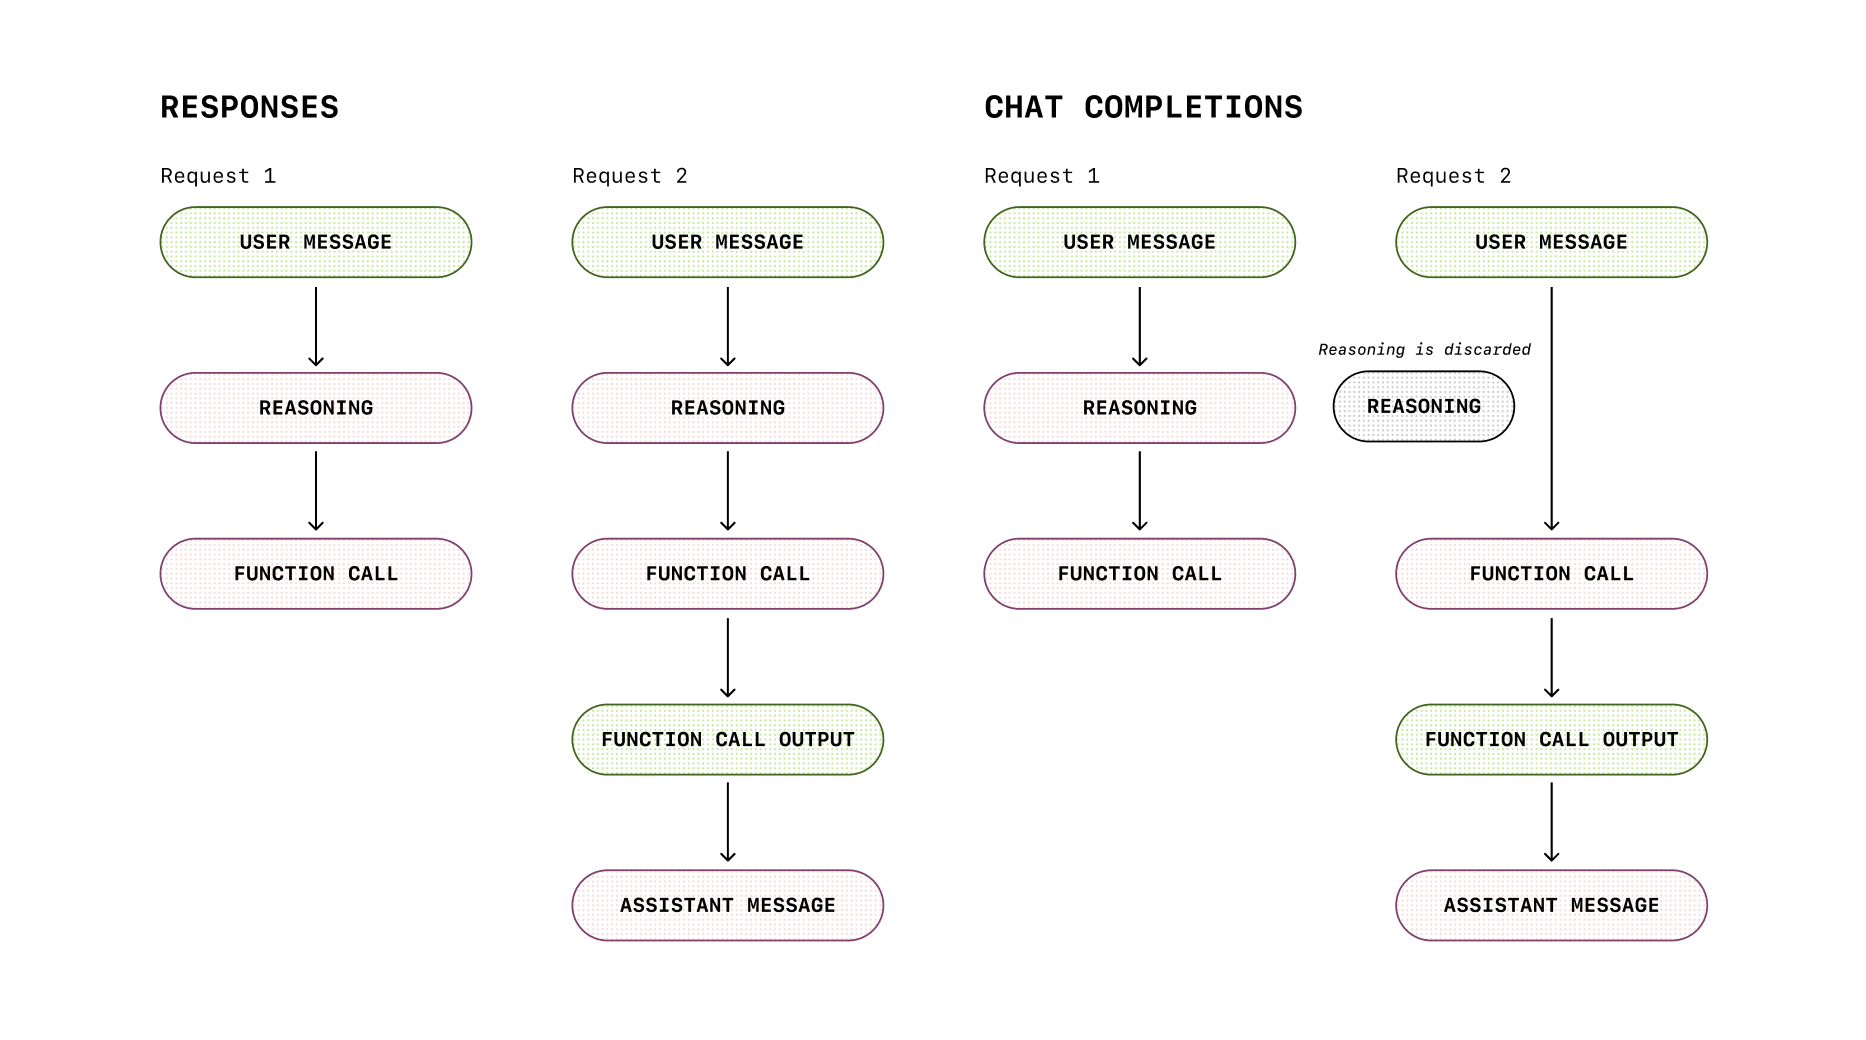
Chat Completions 提供了一个按轮次对话的简单接口。Responses 则让推理和行动在一个结构化循环中交替进行。这就像请侦探办案:您提供证据,侦探展开调查,必要时咨询专家(调用工具),最后向您汇报。每一步调查结束后,侦探都会保留自己的办案笔记(推理状态),但绝不会把笔记交给委托人。
这正是推理模型能够发挥优势的地方:Responses 会跨轮次保留模型的 推理状态。在 Chat Completions 中,上一次调用的推理不会保留到下一次,就像侦探每次走出房间都会忘记刚刚发现的线索。使用 Responses 时,笔记本始终摊开着,模型在下一轮可以接着前一轮的推理步骤往下走。基准测试反映了这一点(TAUBench 得分提高了 5%),缓存利用率也更高,延迟更低。
Responses 还可以返回多个输出项,既展示模型 说了什么,也展示它 做了什么。工具调用、结构化输出和中间步骤都有记录。就像拿到写好的文章时,还能看到草稿纸上的演算过程。这些记录可以帮助您调试、审计,也方便您构建能展示更多细节的用户界面。
{
  "message": {
    "role": "assistant",
    "content": "I'm going to use the get_weather tool to find the weather.",
    "tool_calls": [
      {
        "id": "call_88O3ElkW2RrSdRTNeeP1PZkm",
        "type": "function",
        "function": {
          "name": "get_weather",
          "arguments": "{\"location\":\"New York, NY\",\"unit\":\"f\"}"
        }
      }
    ],
    "refusal": null,
    "annotations": []
  }
} {
"id": "rs_6888f6d0606c819aa8205ecee386963f0e683233d39188e7",
"type": "reasoning",
"summary": [
{
"type": "summary_text",
"text": "**Determining weather response**\n\nI need to answer the user's question about the weather in San Francisco. ...."
},
},
{
"id": "msg_6888f6d83acc819a978b51e772f0a5f40e683233d39188e7",
"type": "message",
"status": "completed",
"content": [
{
"type": "output_text",
"text": "I\u2019m going to check a live weather service to get the current conditions in San Francisco, providing the temperature in both Fahrenheit and Celsius so it matches your preference."
}
],
"role": "assistant"
},
{
"id": "fc_6888f6d86e28819aaaa1ba69cca766b70e683233d39188e7",
"type": "function_call",
"status": "completed",
"arguments": "{\"location\":\"San Francisco, CA\",\"unit\":\"f\"}",
"call_id": "call_XOnF4B9DvB8EJVB3JvWnGg83",
"name": "get_weather"
},让托管工具承担更多工作
刚推出函数调用时,我们注意到一种典型用法:开发者既让模型调用 API,也让它搜索文档库,从中获取外部数据。后一种做法如今称为检索增强生成(RAG)。但对于刚起步的开发者来说,从零搭建检索流程难度大,成本也高。在 Assistants 中,我们推出了首批 托管 工具:file_search 和 code_interpreter,让模型可以使用 RAG,也可以编写代码来解决您提出的问题。在 Responses 中,我们进一步加入了网页搜索、图像生成和 MCP。使用代码解释器或 MCP 等托管工具时,工具会在服务端执行,调用无需再绕回您自己的后端,从而降低延迟,减少请求往返的开销。
安全地保留推理过程
为什么要费这么大工夫隐藏模型的原始思维链(CoT)?直接公开思维链,让客户端像处理其他模型输出一样处理它,岂不是更简单?简而言之,公开原始思维链存在多种风险。它可能包含幻觉,也可能包含模型在最终回复中不会生成的有害内容,还会给 OpenAI 带来竞争方面的风险。
去年晚些时候发布 o1-preview 时,我们的首席科学家 Jakub Pachocki 在博客中写道:
我们认为,隐藏的思维链为监测模型提供了独特的机会。如果思维链能如实反映模型的思考过程,而且可以读懂,我们就能通过它“读出模型的想法”,了解模型是如何思考的。例如,未来我们可能希望通过监测思维链来发现模型试图操纵用户的迹象。不过,要做到这一点,就必须让模型能够自由地表达未经修饰的想法。因此,我们不能通过训练让思维链遵循任何政策要求或迎合用户偏好。我们也不希望用户直接看到未经对齐的思维链。
Responses 的做法是:
- 在内部加密保存推理过程,使其对客户端不可见。
- 允许客户端通过
previous_response_id或推理项安全地延续推理,无需公开原始思维链。
为什么 /v1/responses 最适合用来开发应用
我们在设计 Responses 时就让它具备状态管理能力、原生支持多模态,并能高效运行。
- 智能体工具调用: 通过 Responses API,您可以轻松地将文件搜索、图像生成、代码解释器和 MCP 等工具用于智能体工作流,扩展智能体能完成的任务。
- 默认保留状态。 Responses 自动跟踪对话和工具的状态,让推理和多轮工作流的实现大为简化。通过 Responses 接入 GPT-5,仅凭保留下来的推理过程,其 TAUBench 得分就比通过 Chat Completions 接入时高出 5%。
- 从一开始就支持多模态。 文本、图像、音频、函数调用都享有同等地位。我们没有先做一个文本 API,再把其他模态拼上去。就像设计房子一样,我们从第一天起就规划了足够的房间。
- 成本更低,性能更好。 内部基准测试显示,与 Chat Completions 相比,Responses 的缓存利用率提高了 40% 至 80%。这意味着更低的延迟和成本。
- 设计更合理: 我们从 Chat Completions 和 Assistants 这两个 API 的设计中积累了不少经验,并对 Responses API 和 SDK 做了许多细节改进,让开发更方便,其中包括:
- 流式事件具有明确的语义。
- 多态对象通过内部字段标识类型。
- SDK 提供
output_text辅助方法(无需再使用choices.[0].message.content)。 - 多模态参数和推理参数的组织方式更清晰。
Chat Completions 还会保留吗?
Chat Completions 会继续提供。如果它能满足您的需求,请继续使用。如果您希望跨轮次保留推理过程,原生支持多模态交互,并且无需手动拼接各个环节就能实现智能体循环,Responses 就是合适的选择。
展望未来
就像 Chat Completions 取代 Completions 一样,我们预计,Responses 将成为开发者使用 OpenAI 模型构建应用的默认方式。简单的需求可以轻松实现,复杂的需求也有强大的功能支撑。它还足够灵活,能够适应下一次开发范式的变化。
未来几年,我们都会以这个 API 为基础继续开发。