Den vollständigen Index der Dokumentation findest du in llms.txt. Die Markdown-Version einer Dokumentationsseite erhältst du, indem du
.md an die URL der Seite anhängst.
Gib Modellen Zugriff auf zusätzliche Funktionen und Daten, mit denen sie Anweisungen befolgen und auf Prompts antworten können.
Responses
Funktionsaufrufe (auch Tool-Aufrufe genannt) bieten OpenAI-Modellen eine flexible Möglichkeit, mit externen Systemen zu interagieren und auf Daten zuzugreifen, die über ihre Trainingsdaten hinausgehen. In diesem Leitfaden erfährst du, wie du einem Modell Daten und Aktionen deiner Anwendung zur Verfügung stellst. Die Beispiele zeigen, wie du Funktionstools mit einem JSON-Schema definierst und wie du benutzerdefinierte Tools mit frei formulierten Texteingaben und -ausgaben verwendest.
Wie du für Sitzungen mit der Agents API Funktionen registrierst und Aktionsanfragen der Sitzung verarbeitest, erfährst du im Abschnitt Funktionen. Die Beispiele in diesem Leitfaden zeigen die Integration mit der Responses API und mit Chat Completions.
Wenn deine Anwendung viele Funktionen oder große Schemas hat, kannst du Funktionsaufrufe mit der Tool-Suche kombinieren. So kannst du selten genutzte Tools erst dann laden, wenn das Modell sie braucht. Nur gpt-5.4 und neuere Modelle unterstützen tool_search.
GPT-6 Astra und GPT-6.1 Sol benötigen für Tool-Aufrufe die Responses API. Die Beispiele für Chat Completions verwenden GPT-5.6 Terra mit deaktiviertem Reasoning. Wie du eine bestehende Integration aktualisierst, erfährst du im Migrationsleitfaden.
So funktionieren Tool-Aufrufe
Zunächst klären wir die wichtigsten Begriffe rund um Tool-Aufrufe. Anschließend zeigen praktische Beispiele, wie du Tool-Aufrufe umsetzt.
Eine Funktion oder ein Tool bezeichnet hier eine Fähigkeit, die du dem Modell zur Verfügung stellst und beschreibst. Wenn das Modell eine Antwort auf einen Prompt generiert, kann es feststellen, dass es Daten oder Funktionen eines Tools braucht, um die Anweisungen im Prompt zu befolgen.
Du könntest dem Modell beispielsweise Tools für folgende Aufgaben bereitstellen:
Das heutige Wetter für einen Ort abrufen
Kontodaten anhand einer Benutzer-ID abrufen
Eine Rückerstattung für eine verloren gegangene Bestellung veranlassen
Ebenso kannst du Tools für alle anderen Informationen oder Aktionen bereitstellen, die das Modell beim Beantworten eines Prompts nutzen können soll.
Wenn du einen Prompt per API an das Modell sendest, kannst du eine Liste von Tools mitgeben, die das Modell nutzen kann. Soll es beispielsweise Fragen zum aktuellen Wetter an beliebigen Orten beantworten können, kannst du ihm das Tool get_weather mit dem Argument location bereitstellen.
Ein Funktionsaufruf oder Tool-Aufruf ist eine besondere Art von Modellantwort. Das Modell gibt sie zurück, wenn es beim Auswerten eines Prompts feststellt, dass es eines der bereitgestellten Tools aufrufen muss, um die Anweisungen zu befolgen.
Erhält das Modell in einer API-Anfrage beispielsweise den Prompt „Wie ist das Wetter in Paris?“, kann es mit einem Aufruf des Tools get_weather antworten und Paris als Wert für das Argument location angeben.
Das Ergebnis eines Funktionsaufrufs oder Ergebnis eines Tool-Aufrufs ist die Antwort, die ein Tool aus den Eingaben erzeugt, die das Modell beim Aufruf übergibt. Das Ergebnis kann als strukturiertes JSON oder als einfacher Text vorliegen. Es sollte auf den zugehörigen Tool-Aufruf des Modells verweisen (in den folgenden Beispielen über call_id).
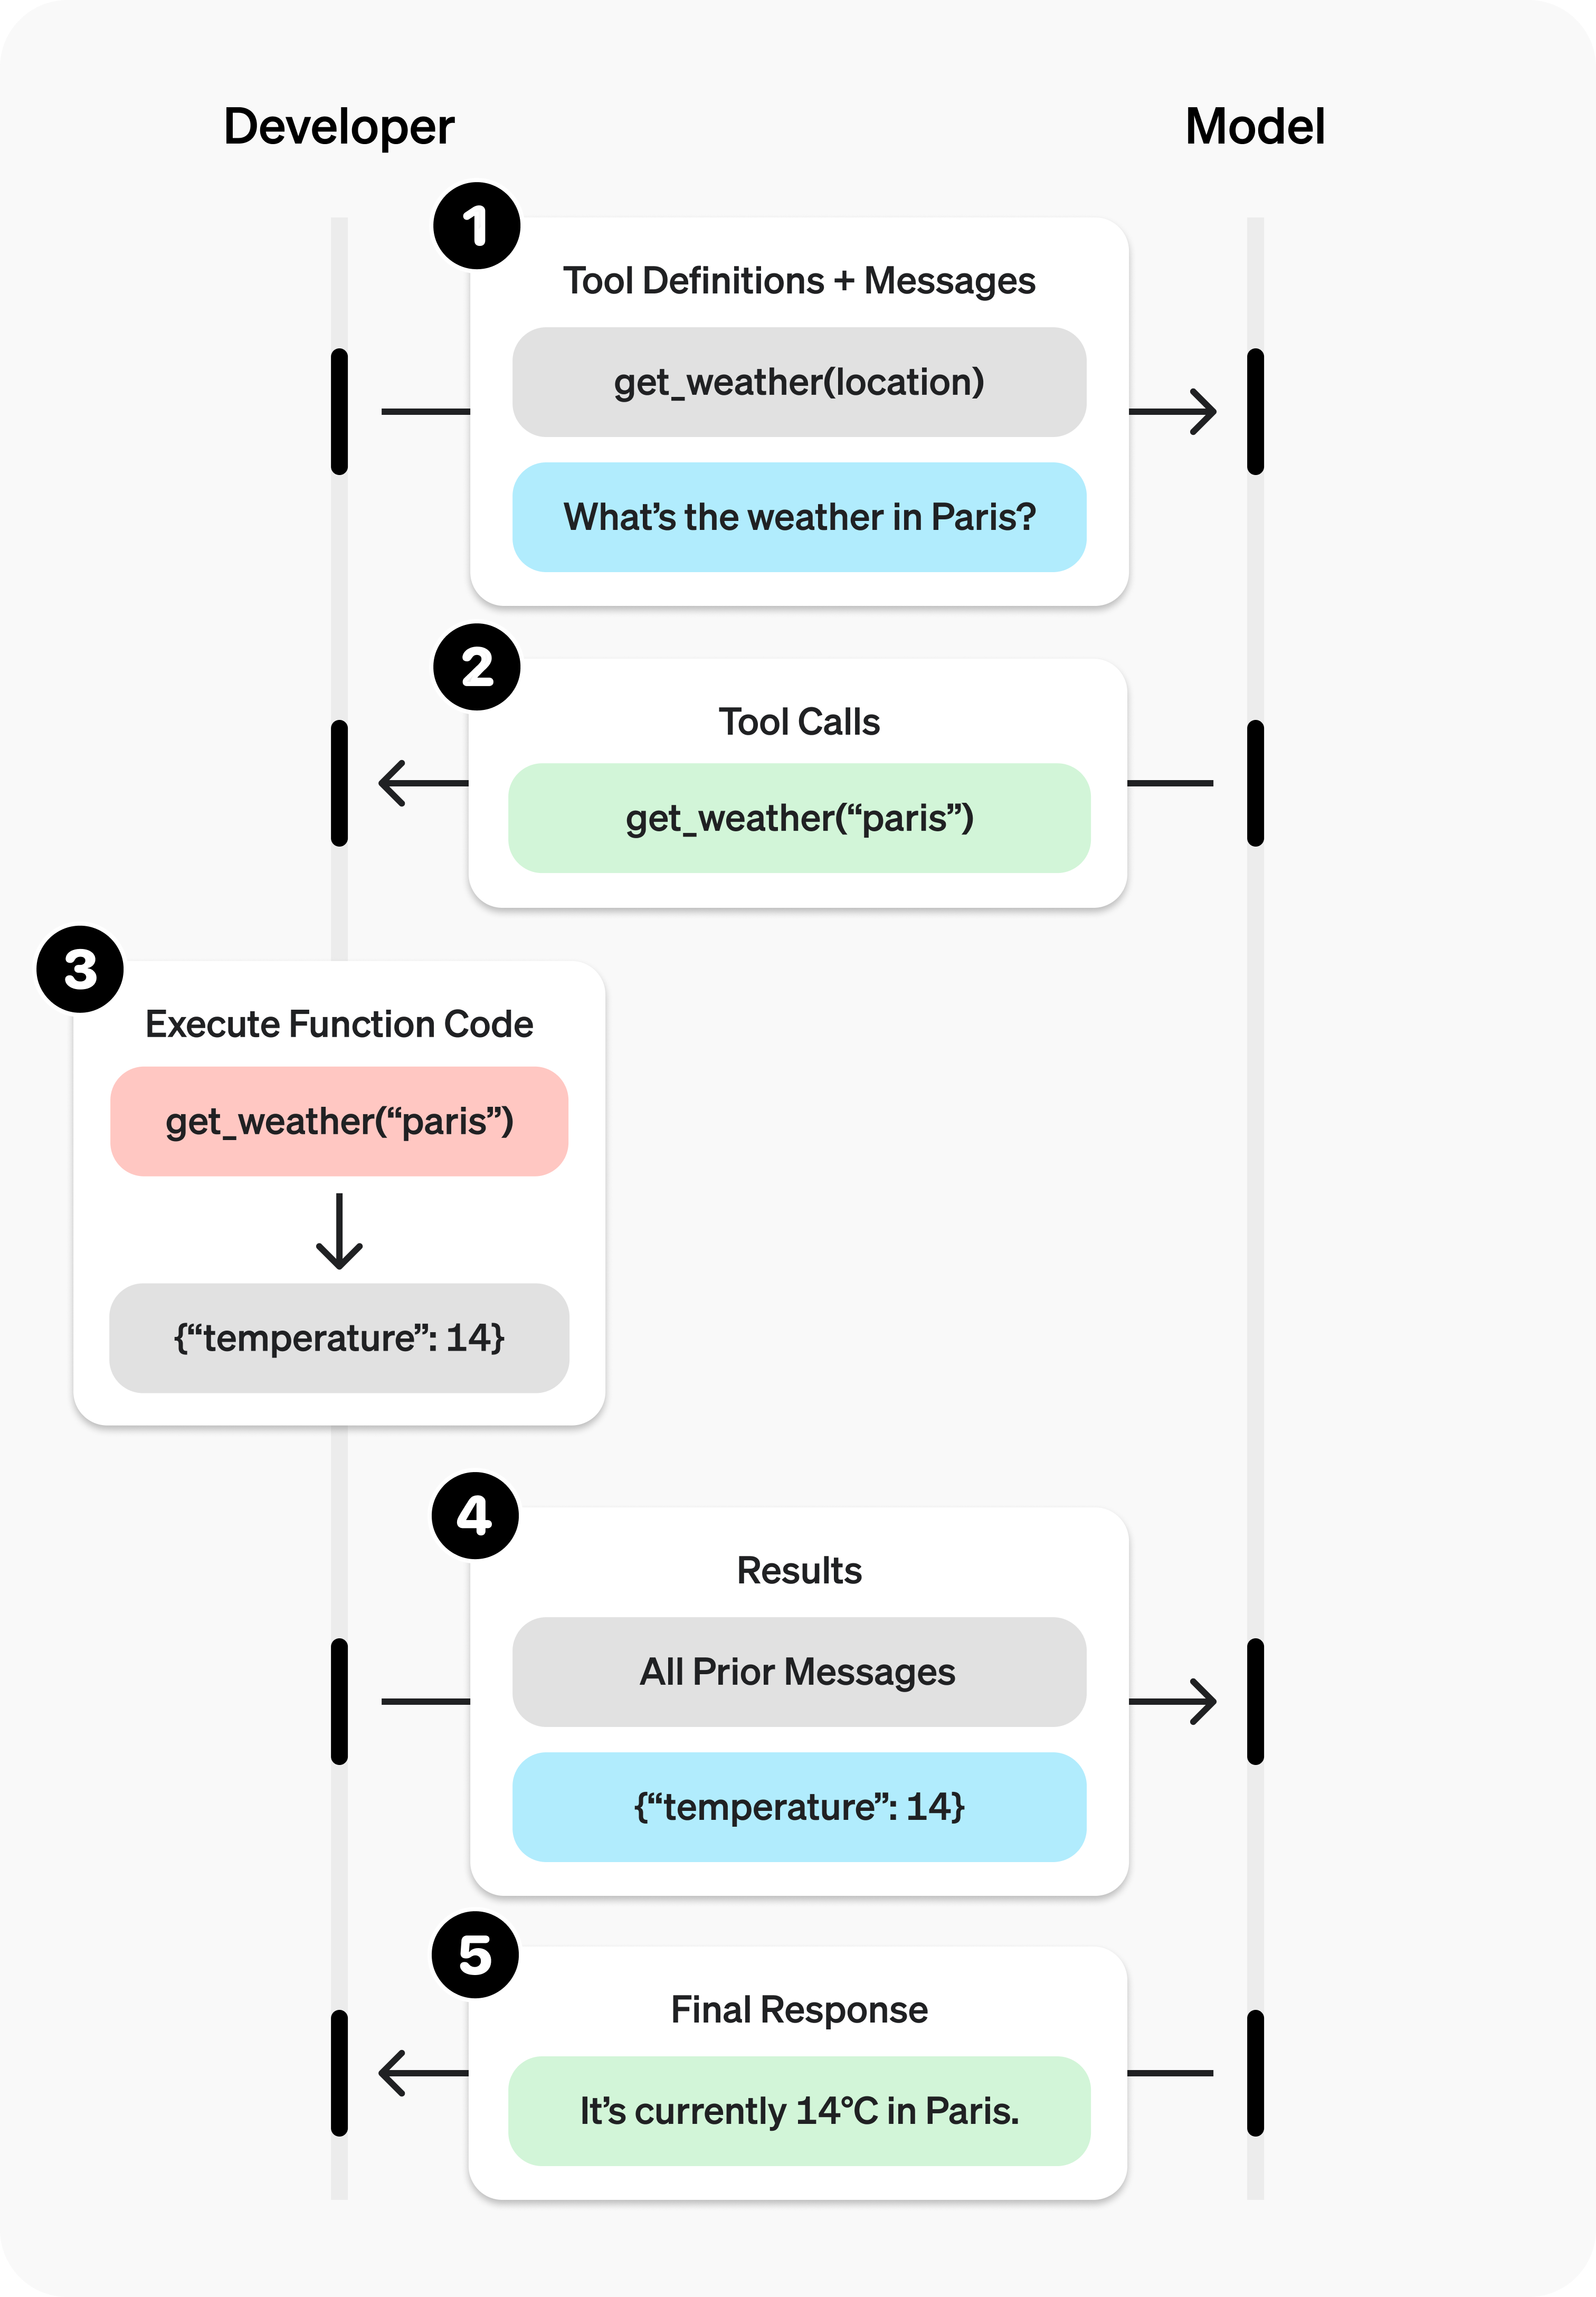
Für das Wetterbeispiel ergibt sich folgender Ablauf:
Dem Modell steht get_weather als Tool mit dem Argument location zur Verfügung.
Auf einen Prompt wie „Wie ist das Wetter in Paris?“ antwortet das Modell mit einem Tool-Aufruf, in dem das Argument location den Wert Paris hat.
Das Ergebnis des Tool-Aufrufs kann ein JSON-Objekt sein (etwa {"temperature": "25", "unit": "C"} für eine aktuelle Temperatur von 25 Grad). Auch Bildinhalte oder Dateiinhalte sind möglich.
Anschließend sendest du die Tool-Definition, den ursprünglichen Prompt, den Tool-Aufruf des Modells und das Ergebnis des Aufrufs zusammen an das Modell zurück. Daraufhin erhältst du eine Textantwort wie diese:
The weather in Paris today is 25C.
Eine Funktion ist ein Tool, das durch ein JSON-Schema definiert ist. Über die Funktionsdefinition kann das Modell Daten an deine Anwendung übergeben. Dein Code kann dann Daten abrufen oder vom Modell vorgeschlagene Aktionen ausführen.
Neben Funktionstools gibt es benutzerdefinierte Tools, die mit frei formulierten Texteingaben und -ausgaben arbeiten. Dieser Leitfaden beschreibt beide Varianten.
Bei Tool-Aufrufen tauschen deine Anwendung und das Modell über die OpenAI API in mehreren Schritten Nachrichten aus. Der Ablauf umfasst fünf Schritte:
Sende eine Anfrage mit den verfügbaren Tools an das Modell.
Empfange einen Tool-Aufruf vom Modell.
Führe in deiner Anwendung Code mit den Eingaben aus dem Tool-Aufruf aus.
Sende eine zweite Anfrage mit dem Ergebnis des Tools an das Modell.
Empfange die abschließende Antwort des Modells (oder weitere Tool-Aufrufe).
Mit der Responses API kann deine Anwendung diesen Ablauf wiederholen, bis alle für die Aufgabe nötigen Tool-Aufrufe abgeschlossen sind. Wenn du ein Framework suchst, das die wiederkehrende Koordination dieser Schritte übernimmt, lies den Vergleich der Responses API mit dem Agents SDK.
Beispiel für ein Funktionstool
Das folgende Beispiel zeigt den vollständigen Ablauf eines Tool-Aufrufs für die Funktion get_horoscope, die das Tageshoroskop für ein Sternzeichen abruft.
Vollständiges Beispiel für einen Tool-Aufruf
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72import OpenAI from "openai";const openai = new OpenAI();// 1. Define a list of callable tools for the modelconst tools: OpenAI.Chat.Completions.ChatCompletionTool[] = [ { type: "function", function: { name: "get_horoscope", description: "Get today's horoscope for an astrological sign.", parameters: { type: "object", properties: { sign: { type: "string", description: "An astrological sign like Taurus or Aquarius", }, }, required: ["sign"], additionalProperties: false, }, strict: true, }, },];function getHoroscope(sign: string) { return `${sign}: Next Tuesday you will befriend a baby otter.`;}const messages: OpenAI.Chat.Completions.ChatCompletionMessageParam[] = [ { role: "user", content: "What is my horoscope? I am an Aquarius." },];// 2. Prompt the model with tools definedlet response = await openai.chat.completions.create({ model: "gpt-5.6-terra", reasoning_effort: "none", messages, tools,});messages.push(response.choices[0].message);for (const toolCall of response.choices[0].message.tool_calls ?? []) { if (toolCall.type !== "function") continue; if (toolCall.function.name === "get_horoscope") { // 3. Execute the function logic for get_horoscope const args = JSON.parse(toolCall.function.arguments); const horoscope = getHoroscope(args.sign); // 4. Provide function call results to the model messages.push({ role: "tool", tool_call_id: toolCall.id, content: JSON.stringify({ horoscope }), }); }}response = await openai.chat.completions.create({ model: "gpt-5.6-terra", reasoning_effort: "none", messages, tools,});// 5. The model should be able to give a response!console.log(response.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69from openai import OpenAIimport jsonclient = OpenAI()# 1. Define a list of callable tools for the modeltools = [ {"type": "function","function": {"name": "get_horoscope","description": "Get today's horoscope for an astrological sign.","parameters": {"type": "object","properties": {"sign": {"type": "string","description": "An astrological sign like Taurus or Aquarius", }, },"required": ["sign"],"additionalProperties": False, },"strict": True, }, },]defget_horoscope(sign):returnf"{sign}: Next Tuesday you will befriend a baby otter."messages = [{"role": "user", "content": "What is my horoscope? I am an Aquarius."}]# 2. Prompt the model with tools definedresponse = client.chat.completions.create(model="gpt-5.6-terra",reasoning_effort="none",messages=messages,tools=tools,)messages.append(response.choices[0].message)for tool_call in response.choices[0].message.tool_calls or []:if tool_call.function.name =="get_horoscope":# 3. Execute the function logic for get_horoscope args = json.loads(tool_call.function.arguments) horoscope = get_horoscope(args["sign"])# 4. Provide function call results to the model messages.append( {"role": "tool","tool_call_id": tool_call.id,"content": json.dumps({"horoscope": horoscope}), } )response = client.chat.completions.create(model="gpt-5.6-terra",reasoning_effort="none",messages=messages,tools=tools,)# 5. The model should be able to give a response!print(response.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77import OpenAI from "openai";import { toResponseInputItems } from "openai/lib/responses/ResponseInputItems";const openai = new OpenAI();// 1. Define a list of callable tools for the modelconst tools: OpenAI.Responses.Tool[] = [ { type: "function", name: "get_horoscope", description: "Get today's horoscope for an astrological sign.", parameters: { type: "object", properties: { sign: { type: "string", description: "An astrological sign like Taurus or Aquarius", }, }, required: ["sign"], additionalProperties: false, }, strict: true, },];function getHoroscope(sign: string) { return `${sign}: Next Tuesday you will befriend a baby otter.`;}// Create a running input list we will add to over timelet input: OpenAI.Responses.ResponseInput = [ { role: "user", content: "What is my horoscope? I am an Aquarius." },];// 2. Prompt the model with tools definedlet response = await openai.responses.create({ model: "gpt-6-astra", tools, input,});// Preserve model output for the next turninput.push(...toResponseInputItems(response.output));for (const item of response.output) { if (item.type !== "function_call") continue; if (item.name === "get_horoscope") { // 3. Execute the function logic for get_horoscope const { sign } = JSON.parse(item.arguments); const horoscope = getHoroscope(sign); // 4. Provide function call results to the model input.push({ type: "function_call_output", call_id: item.call_id, output: horoscope, }); }}console.log("Final input:");console.log(JSON.stringify(input, null, 2));response = await openai.responses.create({ model: "gpt-6-astra", instructions: "Respond only with a horoscope generated by a tool.", tools, input,});// 5. The model should be able to give a response!console.log("Final output:");console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69from openai import OpenAIimport jsonclient = OpenAI()# 1. Define a list of callable tools for the modeltools = [ {"type": "function","name": "get_horoscope","strict": True,"description": "Get today's horoscope for an astrological sign.","parameters": {"type": "object","properties": {"sign": {"type": "string","description": "An astrological sign like Taurus or Aquarius", }, },"required": ["sign"],"additionalProperties": False, }, },]defget_horoscope(sign):returnf"{sign}: Next Tuesday you will befriend a baby otter."# Create a running input list we will add to over timeinput_list = [{"role": "user", "content": "What is my horoscope? I am an Aquarius."}]# 2. Prompt the model with tools definedresponse = client.responses.create(model="gpt-6-astra",tools=tools,input=input_list,)# Save function call outputs for subsequent requestsinput_list += response.outputfor item in response.output:if item.type =="function_call":if item.name =="get_horoscope":# 3. Execute the function logic for get_horoscope sign = json.loads(item.arguments)["sign"] horoscope = get_horoscope(sign)# 4. Provide function call results to the model input_list.append( {"type": "function_call_output","call_id": item.call_id,"output": horoscope, } )response = client.responses.create(model="gpt-6-astra",instructions="Respond only with a horoscope generated by a tool.",tools=tools,input=input_list,)# 5. The model should be able to give a response!print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75package mainimport ( "context" "encoding/json" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() tool := horoscopeResponseTool() response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Input: responses.ResponseNewParamsInputUnion{OfString: openai.String("What is my horoscope? I am an Aquarius.")}, Tools: []responses.ToolUnionParam{tool}, }) if err != nil { panic(err) } var functionOutput responses.ResponseInputItemUnionParam for _, output := range response.Output { if output.Type != "function_call" { continue } call := output.AsFunctionCall() if call.Name != "get_horoscope" { continue } var arguments struct { Sign string `json:"sign"` } if err := json.Unmarshal([]byte(call.Arguments), &arguments); err != nil { panic(err) } functionOutput = responses.ResponseInputItemParamOfFunctionCallOutput(getHoroscope(arguments.Sign)) functionOutput.OfFunctionCallOutput.CallID = openai.String(call.CallID) } if functionOutput.OfFunctionCallOutput == nil { panic("the model did not call get_horoscope") } response, err = client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", PreviousResponseID: openai.String(response.ID), Instructions: openai.String("Respond only with a horoscope generated by a tool."), Input: responses.ResponseNewParamsInputUnion{OfInputItemList: responses.ResponseInputParam{functionOutput}}, Tools: []responses.ToolUnionParam{tool}, }) if err != nil { panic(err) } fmt.Println(response.OutputText())}func horoscopeResponseTool() responses.ToolUnionParam { parameters := map[string]any{ "type": "object", "properties": map[string]any{ "sign": map[string]any{"type": "string", "description": "An astrological sign like Taurus or Aquarius"}, }, "required": []string{"sign"}, "additionalProperties": false, } tool := responses.ToolParamOfFunction("get_horoscope", parameters, true) tool.OfFunction.Description = openai.String("Get today's horoscope for an astrological sign.") return tool}func getHoroscope(sign string) string { return fmt.Sprintf("%s: Next Tuesday you will befriend a baby otter.", sign)}
Bei Reasoning-Modellen wie GPT-5 oder o4-mini musst du alle Reasoning-Elemente, die das Modell zusammen mit Tool-Aufrufen zurückgibt, gemeinsam mit den Ergebnissen der Aufrufe an das Modell zurücksenden. Wie du den Gesprächsverlauf beibehältst, aus dem diese Elemente hervorgegangen sind, erfährst du in den Empfehlungen für Änderungen am Präfix.
Funktionen definieren
Funktionen deklarierst du normalerweise im Parameter tools jeder API-Anfrage. Mit der Tool-Suche kann deine Anwendung Funktionen auch erst im weiteren Verlauf laden. In beiden Fällen hat das Schema jeder aufrufbaren Funktion dieselbe Struktur. Eine Funktionsdefinition enthält folgende Eigenschaften:
Feld
Beschreibung
type
Sollte immer den Wert function haben
name
Name der Funktion (zum Beispiel get_weather)
description
Angaben dazu, wann und wie die Funktion verwendet werden soll
parameters
JSON-Schema, das die Eingabeargumente der Funktion definiert
strict
Legt fest, ob der strikte Modus für den Funktionsaufruf erzwungen wird
So könnte die Definition der Funktion get_weather aussehen:
12345678910111213141516171819202122{ "type": "function", "name": "get_weather", "description": "Retrieves current weather for the given location.", "parameters": { "type": "object", "properties": { "location": { "type": "string", "description": "City and country e.g. Bogotá, Colombia" }, "units": { "type": "string", "enum": ["celsius", "fahrenheit"], "description": "Units the temperature will be returned in." } }, "required": ["location", "units"], "additionalProperties": false }, "strict": true}
Da du parameters mit einem JSON-Schema definierst, kannst du dessen Möglichkeiten nutzen, etwa Typen für Eigenschaften, Aufzählungen, Beschreibungen sowie verschachtelte und rekursive Objekte.
Namensräume definieren
Mit Namensräumen gruppierst du zusammengehörige Tools nach Bereichen wie crm, billing oder shipping. Das ist besonders hilfreich, wenn das Modell zwischen ähnlichen Tools für unterschiedliche Systeme oder Zwecke wählen muss, etwa zwischen einem Suchtool für dein CRM und einem für dein Support-Ticketsystem.
Wenn du dem Modell viele Tools bereitstellen möchtest, kannst du mit tool_search einige oder alle Tools erst bei Bedarf laden. Mit tool_search kann das Modell nach passenden Tools suchen, sie in seinen Kontext aufnehmen und anschließend verwenden. Nur gpt-5.4 und neuere Modelle unterstützen diese Funktion. Mehr dazu erfährst du im Leitfaden zur Tool-Suche.
Definiere deine Funktionsschemas möglichst direkt. Die Clientbibliotheken für Python und TypeScript bieten auch Hilfsfunktionen, die Objekte aus pydantic und zod in Schemas umwandeln. Diese Hilfsfunktionen unterstützen jedoch nicht alle Schemafunktionen.
Objekte für ein Funktionsschema definieren
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27import OpenAI from "openai";import { z } from "zod";import { zodFunction } from "openai/helpers/zod";const openai = new OpenAI();const GetWeatherParameters = z.object({ location: z.string().describe("City and country e.g. Bogotá, Colombia"),});const tools = [ zodFunction({ name: "getWeather", parameters: GetWeatherParameters }),];const messages: OpenAI.Chat.Completions.ChatCompletionMessageParam[] = [ { role: "user", content: "What's the weather like in Paris today?" },];const response = await openai.chat.completions.create({ model: "gpt-5.6-terra", reasoning_effort: "none", messages, tools, store: true,});console.log(response.choices[0].message.tool_calls);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20from openai import OpenAI, pydantic_function_toolfrom pydantic import BaseModel, Fieldclient = OpenAI()classGetWeather(BaseModel): location: str= Field(..., description="City and country e.g. Bogotá, Colombia")tools = [pydantic_function_tool(GetWeather)]completion = client.chat.completions.create(model="gpt-5.6-terra",reasoning_effort="none",messages=[{"role": "user", "content": "What's the weather like in Paris today?"}],tools=tools,)print(completion.choices[0].message.tool_calls)
Empfehlungen für Funktionsdefinitionen
Wähle aussagekräftige Funktionsnamen, beschreibe die Parameter genau und formuliere klare, detaillierte Anweisungen.
Beschreibe ausdrücklich den Zweck der Funktion und jedes Parameters, das jeweilige Parameterformat und die Bedeutung der Ausgabe.
Gib im System-Prompt an, wann das Modell die einzelnen Funktionen verwenden soll und wann nicht. Sage dem Modell möglichst genau, was es tun soll.
Nenne Beispiele und Grenzfälle, besonders wenn dieselben Fehler wiederholt auftreten. (Hinweis: Beispiele können die Leistung von Reasoning-Modellen beeinträchtigen.)
Gib bei nachladbaren Tools detaillierte Anweisungen in der Funktionsbeschreibung und halte die Beschreibung des Namensraums kurz. Anhand des Namensraums entscheidet das Modell, welche Tools es lädt. Die Funktionsbeschreibung hilft ihm, das geladene Tool richtig zu verwenden.
Orientiere dich an bewährten Methoden der Softwareentwicklung.
Verwende Aufzählungstypen und die Struktur deiner Objekte, um ungültige Zustände auszuschließen. Beispielsweise lässt toggle_light(on: bool, off: bool) ungültige Aufrufe zu.
Teste die Beschreibung mit jemandem im Praktikum. Kann die Person die Funktion allein mit den Angaben richtig verwenden, die auch das Modell erhält? (Falls nicht, welche Fragen stellt sie? Ergänze die Antworten im Prompt.)
Entlaste das Modell und nutze nach Möglichkeit Code.
Lass das Modell keine Argumente ausfüllen, deren Werte du bereits kennst. Wenn dir beispielsweise aus einer vorherigen Menüauswahl die order_id vorliegt, lass den Parameter order_id weg. Definiere stattdessen submit_refund() ohne Parameter und übergib die order_id in deinem Code.
Fasse Funktionen zusammen, die du immer nacheinander aufrufst. Wenn du beispielsweise mark_location() immer nach query_location() aufrufst, integriere die Logik zum Markieren direkt in die Abfragefunktion.
Stelle anfangs nur wenige Funktionen bereit, damit das Modell sie zuverlässiger aufruft.
Prüfe die Leistung mit unterschiedlich vielen Funktionen.
Stelle zu Beginn jedes Gesprächsschritts möglichst weniger als 20 Funktionen bereit. Diese Zahl dient als Richtwert.
Nutze die Tool-Suche, um umfangreiche oder selten genutzte Teile deines Tool-Angebots erst bei Bedarf zu laden.
Nutze die Ressourcen von OpenAI.
Erstelle und überarbeite Funktionsschemas im Playground.
Ziehe Fine-Tuning in Betracht, um die Genauigkeit von Funktionsaufrufen zu verbessern, wenn du viele Funktionen anbietest oder die Aufgaben schwierig sind. (Beispiel im Cookbook)
Token-Verbrauch
Die API fügt Funktionsdefinitionen in einer Syntax in die Systemnachricht ein, auf die das Modell trainiert wurde. Die Definitionen aufrufbarer Funktionen belegen daher Platz im Kontextfenster des Modells und werden als Eingabetoken abgerechnet. Wenn du an Tokengrenzen stößt, lade anfangs weniger Funktionen, kürze nach Möglichkeit die Beschreibungen oder nutze die Tool-Suche, um Tools erst bei Bedarf zu laden.
Wenn deine Tool-Spezifikation viele Funktionen definiert, kannst du den Token-Verbrauch auch mit Fine-Tuning senken.
Funktionsaufrufe verarbeiten
Wenn das Modell eine Funktion aufruft, musst du sie ausführen und das Ergebnis zurückgeben. Eine Modellantwort kann keinen, einen oder mehrere Aufrufe enthalten. Lege deinen Code daher für mehrere Aufrufe aus.
Die Antwort enthält ein Array von tool_calls. Jeder Aufruf hat eine id, über die du später das Funktionsergebnis übermittelst, sowie ein Objekt function mit einem Feld name und JSON-kodierten arguments.
Das Array output der Antwort enthält einen Eintrag, dessen Feld type den Wert function_call hat. Jeder solche Eintrag enthält eine call_id, über die du später das Funktionsergebnis übermittelst, sowie name und JSON-kodierte arguments.
Wenn du die Tool-Suche verwendest, können auch Elemente der Typen tool_search_call und tool_search_output vor einem function_call erscheinen. Sobald die Funktion geladen ist, verarbeitest du den Funktionsaufruf wie hier gezeigt.
Funktionsaufrufe ausführen und Ergebnisse anhängen
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31import com.fasterxml.jackson.databind.JsonNode;import com.fasterxml.jackson.databind.ObjectMapper;import java.util.Map;var argsJson = new ObjectMapper().readTree("{\"location\":\"Paris, France\"}");System.out.println(callFunction("get_weather", argsJson));// These local fixtures demonstrate dispatch; replace them with your application services.// The email fixture prints its inputs and does not send a message.static Map<String, Object> callFunction(String name, JsonNode arguments) { return switch (name) { case "get_weather" -> getWeather(arguments.get("location").asText()); case "send_email" -> sendEmail(arguments.get("to").asText(), arguments.get("body").asText()); default -> throw new IllegalArgumentException("Unknown function: " + name); };}private static Map<String, Object> getWeather(String location) { int temperature = switch (location) { case "Bogotá, Colombia" -> 18; case "Paris, France" -> 15; default -> 20; }; return Map.of("location", location, "temperature_celsius", temperature);}private static Map<String, Object> sendEmail(String to, String body) { System.out.println("Sending email to " + to + ": " + body); return Map.of("status", "sent");}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22using System.Text.Json;using JsonDocument arguments = JsonDocument.Parse("{\"location\":\"Paris, France\"}");Console.WriteLine(FunctionDispatcher.CallFunction("get_weather", arguments.RootElement));internal static class FunctionDispatcher{ // These local fixtures demonstrate dispatch; replace them with your application services. // The email fixture prints its inputs and does not send a message. internal static string CallFunction(string name, JsonElement arguments) => name switch { "get_weather" => GetWeather(arguments.GetProperty("location").GetString()!), "send_email" => SendEmail(arguments.GetProperty("to").GetString()!, arguments.GetProperty("body").GetString()!), _ => throw new ArgumentException($"Unknown function: {name}", nameof(name)) }; private static string GetWeather(string location) => JsonSerializer.Serialize(new { location, temperature_celsius = location switch { "Bogotá, Colombia" => 18, "Paris, France" => 15, _ => 20 } }); private static string SendEmail(string to, string body) { Console.WriteLine($"Sending email to {to}: {body}"); return "{\"status\":\"sent\"}"; }}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16def call_function(name, arguments) case name when "get_weather" FunctionCallingExample.get_weather( arguments.fetch("latitude"), arguments.fetch("longitude") ) when "send_email" FunctionCallingExample.send_email( arguments.fetch("to"), arguments.fetch("body") ) else raise ArgumentError, "Unknown function: #{name}" endend
Ergebnisse formatieren
Das Ergebnis, das du in der Nachricht function_call_output übergibst, sollte in der Regel eine Zeichenkette sein. Das Format bestimmst du selbst, etwa JSON, Fehlercodes oder einfacher Text. Das Modell interpretiert die Zeichenkette entsprechend.
Bei Funktionen, die Bilder oder Dateien zurückgeben, kannst du anstelle einer Zeichenkette ein Array von Bild- oder Dateiobjekten übergeben.
Hat deine Funktion keinen Rückgabewert (zum Beispiel send_email), gib eine Zeichenkette zurück, die Erfolg oder Fehlschlag anzeigt, etwa "success".
Ergebnisse in die Antwort einbeziehen
Hänge die Ergebnisse an messages an und sende die ergänzte Nachrichtenliste an das Modell zurück, um die abschließende Antwort zu erhalten.
"It's about 15°C in Paris, 18°C in Bogotá, and I've sent that email to Bob."
Weitere Konfigurationsmöglichkeiten
Tool-Auswahl
Standardmäßig entscheidet das Modell, wann und wie viele Tools es verwendet. Mit dem Parameter tool_choice kannst du ein bestimmtes Verhalten vorgeben.
Automatisch: (Standard) Das Modell ruft keine, eine oder mehrere Funktionen auf. tool_choice: "auto"
Erforderlich: Das Modell ruft mindestens eine Funktion auf.
tool_choice: "required"
Vorgegebene Funktion: Das Modell ruft genau eine bestimmte Funktion auf.
tool_choice: {"type": "function", "name": "get_weather"}
Zulässige Tools: Das Modell darf nur eine Teilmenge der verfügbaren Tools aufrufen.
Wann sich allowed_tools eignet
Mit einer allowed_tools-Liste kannst du pro Modellanfrage nur bestimmte Tools zulassen und trotzdem jedes Mal dieselbe vollständige Tool-Liste übergeben. So kannst du die Einsparungen durch Prompt-Caching maximieren.
Du kannst tool_choice auch auf "none" setzen. Das Modell verhält sich dann so, als hättest du keine Funktionen übergeben.
Auch bei der Tool-Suche gilt tool_choice für die Tools, die im aktuellen Gesprächsschritt aufrufbar sind. Das ist besonders hilfreich, wenn du nur bestimmte Tools geladen hast und das Modell auf diese Auswahl beschränken möchtest.
Parallele Funktionsaufrufe
Modelle ab GPT-5, die parallele Funktionsaufrufe unterstützen, können Funktionen auch dann parallel aufrufen, wenn integrierte Tools verfügbar sind. Eine Gruppe parallel aufgerufener Funktionen darf keine integrierten Tools enthalten.
Das Modell kann mehrere Funktionen in einem Gesprächsschritt aufrufen. Wenn du parallel_tool_calls auf false setzt, ruft das Modell höchstens ein Tool auf.
Hinweis: Wenn ein per Fine-Tuning angepasstes Modell mehrere Funktionen in einem Gesprächsschritt aufruft, wird der strikte Modus für diese Aufrufe derzeit deaktiviert.
Hinweis zu gpt-4.1-nano-2025-04-14: Dieser Snapshot von gpt-4.1-nano kann bei aktivierten parallelen Tool-Aufrufen gelegentlich dasselbe Tool mehrfach aufrufen. Wir empfehlen, parallele Tool-Aufrufe für diesen Snapshot zu deaktivieren.
Strikter Modus
Wenn du strict auf true setzt, halten Funktionsaufrufe das Funktionsschema zuverlässig ein. Ohne strikte Prüfung versucht das Modell, das Schema so gut wie möglich einzuhalten. Wir empfehlen, den strikten Modus immer zu aktivieren.
Setze additionalProperties auf false, und zwar für jedes Objekt in parameters.
Alle Felder in properties müssen als required gekennzeichnet sein.
Für optionale Felder kannst du null als zusätzlichen Typ unter type zulassen (siehe Beispiel unten).
Wenn du strict: true sendest und dein Schema diese Anforderungen nicht erfüllt, lehnt die API die Anfrage ab und gibt an, welche Vorgaben fehlen. Lässt du strict weg, hängt das Standardverhalten von der API ab. Bei Responses-Anfragen versucht die API, dein Schema für den strikten Modus zu normalisieren. Ist das nicht möglich, erfolgen Funktionsaufrufe ohne strikte Prüfung, und das Modell versucht, das Schema bestmöglich einzuhalten. In diesem Fall steht in der Tool-Definition der Antwort strict: false. Bei Chat Completions ist der strikte Modus standardmäßig deaktiviert. Wenn du auch bei Responses ausdrücklich Funktionsaufrufe ohne strikte Prüfung verwenden möchtest, setze strict: false.
Strikter Modus aktiviert
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24{"type": "function","function": {"name": "get_weather","description": "Retrieves current weather for the given location.","strict": true,"parameters": {"type": "object","properties": {"location": {"type": "string","description": "City and country e.g. Bogotá, Colombia" },"units": {"type": ["string", "null"],"enum": ["celsius", "fahrenheit"],"description": "Units the temperature will be returned in." } },"required": ["location", "units"],"additionalProperties": false } }}
Strikter Modus deaktiviert
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22{"type": "function","function": {"name": "get_weather","description": "Retrieves current weather for the given location.","parameters": {"type": "object","properties": {"location": {"type": "string","description": "City and country e.g. Bogotá, Colombia" },"units": {"type": "string","enum": ["celsius", "fahrenheit"],"description": "Units the temperature will be returned in." } },"required": ["location"], } }}
Strikter Modus aktiviert
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22{"type": "function","name": "get_weather","description": "Retrieves current weather for the given location.","strict": true,"parameters": {"type": "object","properties": {"location": {"type": "string","description": "City and country e.g. Bogotá, Colombia" },"units": {"type": ["string", "null"],"enum": ["celsius", "fahrenheit"],"description": "Units the temperature will be returned in." } },"required": ["location", "units"],"additionalProperties": false }}
Strikter Modus deaktiviert
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20{"type": "function","name": "get_weather","description": "Retrieves current weather for the given location.","parameters": {"type": "object","properties": {"location": {"type": "string","description": "City and country e.g. Bogotá, Colombia" },"units": {"type": "string","enum": ["celsius", "fahrenheit"],"description": "Units the temperature will be returned in." } },"required": ["location"], }}
Bei allen Schemas, die du im Playground generierst, ist der strikte Modus aktiviert.
Wir empfehlen den strikten Modus. Beachte dabei folgende Einschränkungen:
Einige Funktionen von JSON-Schema werden nicht unterstützt. (Siehe unterstützte Schemas.)
Für per Fine-Tuning angepasste Modelle gilt außerdem:
Bei der ersten Anfrage durchlaufen Schemas einen zusätzlichen Verarbeitungsschritt. Danach werden sie zwischengespeichert. Wenn sich deine Schemas von Anfrage zu Anfrage ändern, kann die Latenz steigen.
Da die Schemas aus Leistungsgründen zwischengespeichert werden, kommt die Option keine Datenaufbewahrung für sie nicht infrage.
Streaming
Mit Streaming kannst du den Fortschritt anzeigen. Während das Modell die Argumente erzeugt, siehst du bereits, welche Funktion es aufruft, und kannst sogar die Argumente in Echtzeit anzeigen.
Das Streaming von Funktionsaufrufen funktioniert ähnlich wie bei gewöhnlichen Antworten. Du setzt stream auf true und erhältst Teilstücke mit delta-Objekten.
Funktionsaufrufe streamen
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42import { OpenAI } from "openai";const openai = new OpenAI();const tools: OpenAI.Chat.Completions.ChatCompletionTool[] = [ { type: "function", function: { name: "get_weather", description: "Get current temperature for a given location.", parameters: { type: "object", properties: { location: { type: "string", description: "City and country e.g. Bogotá, Colombia", }, }, required: ["location"], additionalProperties: false, }, strict: true, }, },];const stream = await openai.chat.completions.create({ model: "gpt-5.6-terra", reasoning_effort: "none", messages: [ { role: "user", content: "What's the weather like in Paris today?" }, ], tools, tool_choice: "required", stream: true, store: true,});for await (const chunk of stream) { const delta = chunk.choices[0].delta; console.log(delta.tool_calls);}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37from openai import OpenAIclient = OpenAI()tools = [ {"type": "function","function": {"name": "get_weather","description": "Get current temperature for a given location.","parameters": {"type": "object","properties": {"location": {"type": "string","description": "City and country e.g. Bogotá, Colombia", } },"required": ["location"],"additionalProperties": False, },"strict": True, }, }]stream = client.chat.completions.create(model="gpt-5.6-terra",reasoning_effort="none",messages=[{"role": "user", "content": "What's the weather like in Paris today?"}],tools=tools,stream=True,)for chunk in stream: delta = chunk.choices[0].deltaprint(delta.tool_calls)
Bei einer Textantwort setzt du die Teilstücke zu einer einzigen content-Zeichenkette zusammen. Bei einem Funktionsaufruf ergeben sie das als JSON kodierte Objekt für arguments.
Ruft das Modell eine oder mehrere Funktionen auf, enthält das Feld tool_calls jedes delta-Objekts die entsprechenden Aufrufdaten. Jeder tool_call enthält folgende Felder:
Feld
Beschreibung
index
Gibt an, zu welchem Funktionsaufruf das delta gehört
id
ID des Tool-Aufrufs
function
Delta des Funktionsaufrufs (name und arguments)
type
Typ des tool_call (bei Funktionsaufrufen immer function)
Viele dieser Felder sind nur im ersten delta eines Tool-Aufrufs gesetzt, etwa id, function.name und type.
Das folgende Codebeispiel zeigt, wie du die delta-Objekte zu einem vollständigen tool_calls-Objekt zusammensetzt.
Mit Streaming kannst du den Fortschritt anzeigen. Während das Modell die Argumente erzeugt, siehst du bereits, welche Funktion es aufruft, und kannst sogar die Argumente in Echtzeit anzeigen.
Das Streaming von Funktionsaufrufen funktioniert ähnlich wie bei gewöhnlichen Antworten. Du setzt stream auf true und erhältst unterschiedliche event-Objekte.
Bei einer Textantwort setzt du die Teilstücke zu einer einzigen content-Zeichenkette zusammen. Bei einem Funktionsaufruf ergeben sie das als JSON kodierte Objekt für arguments.
Ruft das Modell eine oder mehrere Funktionen auf, erhältst du für jeden Funktionsaufruf ein Ereignis vom Typ response.output_item.added mit folgenden Feldern:
Feld
Beschreibung
response_id
ID der Antwort, zu der der Funktionsaufruf gehört
output_index
Index des Ausgabeelements in der Antwort. Er unterscheidet die einzelnen Funktionsaufrufe innerhalb der Antwort.
item
Element für den laufenden Funktionsaufruf mit den Feldern name, arguments und id
Danach erhältst du eine Reihe von Ereignissen des Typs response.function_call_arguments.delta. Sie enthalten jeweils das delta des Felds arguments. Diese Ereignisse haben folgende Felder:
Feld
Beschreibung
response_id
ID der Antwort, zu der der Funktionsaufruf gehört
item_id
ID des Elements für den Funktionsaufruf, zu dem das Delta gehört
output_index
Index des Ausgabeelements in der Antwort. Er unterscheidet die einzelnen Funktionsaufrufe innerhalb der Antwort.
delta
Delta des Felds arguments
Das folgende Codebeispiel zeigt, wie du die delta-Objekte zu einem vollständigen tool_call-Objekt zusammensetzt.
Sobald das Modell die Funktionsaufrufe abgeschlossen hat, erhältst du ein Ereignis des Typs response.function_call_arguments.done. Es enthält den vollständigen Funktionsaufruf mit folgenden Feldern:
Feld
Beschreibung
response_id
ID der Antwort, zu der der Funktionsaufruf gehört
output_index
Index des Ausgabeelements in der Antwort. Er unterscheidet die einzelnen Funktionsaufrufe innerhalb der Antwort.
item
Element für den Funktionsaufruf mit den Feldern name, arguments und id
Benutzerdefinierte Tools
Benutzerdefinierte Tools funktionieren ähnlich wie Funktionstools mit JSON-Schema. Du musst dem Modell jedoch nicht ausdrücklich vorgeben, welche Eingabe das Tool erwartet. Das Modell kann eine beliebige Zeichenkette als Eingabe an das Tool übergeben. So kannst du vermeiden, eine Antwort unnötig in JSON zu verpacken. Außerdem kannst du für die Antwort eine eigene Grammatik vorgeben (mehr dazu weiter unten).
Das folgende Codebeispiel erstellt ein benutzerdefiniertes Tool, das vom Modell eine Zeichenkette mit Python-Code erwartet.
Beispiel für den Aufruf eines benutzerdefinierten Tools
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16import OpenAI from "openai";const client = new OpenAI();const response = await client.responses.create({ model: "gpt-6-astra", input: "Use the code_exec tool to print hello world to the console.", tools: [ { type: "custom", name: "code_exec", description: "Executes arbitrary Python code.", }, ],});console.log(response.output);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16from openai import OpenAIclient = OpenAI()response = client.responses.create(model="gpt-6-astra",input="Use the code_exec tool to print hello world to the console.",tools=[ {"type": "custom","name": "code_exec","description": "Executes arbitrary Python code.", } ],)print(response.output)
Eine kontextfreie Grammatik (CFG) legt durch Regeln fest, wie gültiger Text in einem bestimmten Format entsteht. Mit einer CFG kannst du einschränken, welche Texteingaben das Modell an ein benutzerdefiniertes Tool übergeben kann.
Beim Konfigurieren eines benutzerdefinierten Tools gibst du deine CFG über den Parameter grammar an. Derzeit unterstützen wir zwei Syntaxvarianten für solche Grammatiken: lark und regex.
Du definierst Grammatiken mit einer Variante von Lark. LLGuidance beschränkt die Token-Auswahl des Modells. Einige Funktionen von Lark werden nicht unterstützt:
Lookaround-Ausdrücke in regulären Ausdrücken des Lexers
Nicht gierige Quantifizierer (*?, +?, ??) in regulären Ausdrücken des Lexers
Prioritäten für Terminalsymbole
Vorlagen
Importe (mit Ausnahme der integrierten common-Definitionen über %import)
%declare-Direktiven
Zum Ausprobieren eigener Grammatiken empfehlen wir die Lark IDE.
Komplexität der Grammatik begrenzen
Beschränke deine Grammatik auf die Regeln und Muster, die dein Tool benötigt. Bei zu komplexen Grammatiken kann die OpenAI API einen Fehler zurückgeben. Prüfe deshalb vor dem Einsatz, ob deine Grammatik mit der API kompatibel ist.
Es kann mehrere Anläufe brauchen, bis eine Lark-Grammatik wie gewünscht funktioniert. Einfache Grammatiken funktionieren am zuverlässigsten. Bei komplexen Grammatiken musst du häufig die Grammatik selbst, den Prompt und die Tool-Beschreibung überarbeiten, damit das Modell innerhalb der Verteilung bleibt, die es aus dem Training kennt.
Richtige und falsche Muster
So ist es richtig (ein einziges, klar abgegrenztes Terminalsymbol):
Vermeide die folgende Aufteilung auf mehrere Regeln und Terminalsymbole. Hier sollen Regeln den Freitext auf mehrere Terminalsymbole verteilen. Der Lexer erfasst jedoch für jedes Freitextstück möglichst viele Zeichen. Dadurch verlierst du die Kontrolle über die Aufteilung:
Nur die Definitionen der Terminalsymbole bestimmen, wie der Lexer die Eingabe zerlegt. Kleingeschriebene Regeln haben darauf keinen Einfluss. Wenn du „Freitext zwischen Ankern“ brauchst, definiere das gesamte Muster als ein einziges Terminalsymbol mit einem regulären Ausdruck. So erfasst der Lexer die gewünschte Struktur in einem einzigen Treffer.
Terminalsymbole und Regeln
Lark verwendet Terminalsymbole für Lexer-Token (üblicherweise UPPERCASE) und Regeln für Parserproduktionen (üblicherweise lowercase). Damit deine Grammatik nur unterstützte Funktionen nutzt und sich vorhersehbar verhält, definiere sie möglichst einfach und eindeutig. Trenne dabei die Aufgaben von Terminalsymbolen und Regeln klar voneinander.
Bevor eine CFG-Regel greift, erkennt der Lexer die Terminalsymbole. Dabei wählt er jeweils den längsten Treffer. Wenn du ein Terminalsymbol über mehrere Regeln verteilst, um seine Form vorzugeben, können diese Regeln den Lexer nicht steuern. Dafür sind allein die regulären Ausdrücke der Terminalsymbole maßgeblich.
Erfasse Muster in Freitext möglichst mit einem einzigen Terminalsymbol
Wenn du ein Muster in beliebigem Text erkennen möchtest, etwa in natürlicher Sprache mit beliebigen Zeichen zwischen Ankern, beschreibe es als ein einziges Terminalsymbol. Vermeide es, Freitext-Terminalsymbole und Parserregeln abwechselnd anzuordnen. Da der Lexer den längsten Treffer wählt, hält er die vorgesehenen Grenzen nicht ein. Das Modell verlässt dann mit hoher Wahrscheinlichkeit die ihm vertraute Verteilung.
Setze einzelne Token mit Regeln zusammen
Regeln eignen sich dafür, klar abgegrenzte Terminalsymbole wie Zahlen, Schlüsselwörter und Satzzeichen zu größeren Strukturen zusammenzusetzen. Um den Text zwischen zwei Terminalsymbolen einzuschränken, sind sie ungeeignet.
Definiere Terminalsymbole gezielt, begrenzt und in sich geschlossen
Verwende möglichst explizite Zeichenklassen und begrenzte Quantifizierer (etwa {0,10}, statt überall das unbegrenzte * zu verwenden). Wenn du „beliebigen Text bis zu einem Punkt“ erfassen möchtest, verwende eher einen Ausdruck wie /[^.\n]{0,10}*\./ als /.+\./, damit der erfasste Text nicht unkontrolliert wächst.
Nutze Regeln zum Kombinieren von Token und überlasse die Auswertung regulärer Ausdrücke dem Lexer
So kannst du Regeln sinnvoll einsetzen:
start: exprNUMBER: /[0-9]+/PLUS: "+"MINUS: "-"expr: term (("+"|"-") term)*term: NUMBER
Berücksichtige Leerraum ausdrücklich
Verlass dich nicht auf unbegrenzte %ignore-Direktiven. Solche Direktiven können die Grammatik zu komplex machen oder dazu führen, dass das Modell seine vertraute Verteilung verlässt. Füge stattdessen überall dort, wo Leerraum zulässig ist, ausdrücklich passende Terminalsymbole ein.
Fehlerbehebung
Lehnt die API die Grammatik als zu komplex ab, vereinfache die Regeln und Terminalsymbole und entferne unbegrenzte %ignore-Direktiven.
Wenn benutzerdefinierte Tools mit unerwarteten Token aufgerufen werden, prüfe, ob sich Terminalsymbole überschneiden und wie der Lexer den längsten Treffer bestimmt.
Wenn das Modell die ihm vertraute Verteilung verlässt (erkennbar an übermäßig langen oder repetitiven Ausgaben, die syntaktisch gültig, aber inhaltlich falsch sind):
Schränke die Grammatik stärker ein.
Überarbeite den Prompt und die Tool-Beschreibung. Ergänze Few-Shot-Beispiele im Prompt. Erkläre in der Tool-Beschreibung die Grammatik und weise das Modell an, sie beim Reasoning zu berücksichtigen und einzuhalten.
Probiere einen höheren Reasoning-Aufwand aus, etwa indem du von „Mittel“ auf „Hoch“ wechselst.
Regex-Grammatik
Beispiel für eine kontextfreie Grammatik mit regulären Ausdrücken
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import OpenAI from "openai";const client = new OpenAI();const grammar = "^(?P<month>January|February|March|April|May|June|July|August|September|October|November|December)\\s+(?P<day>\\d{1,2})(?:st|nd|rd|th)?\\s+(?P<year>\\d{4})\\s+at\\s+(?P<hour>0?[1-9]|1[0-2])(?P<ampm>AM|PM)$";const response = await client.responses.create({ model: "gpt-6-astra", input: "Use the timestamp tool to save a timestamp for August 7th 2025 at 10AM.", tools: [ { type: "custom", name: "timestamp", description: "Saves a timestamp in date + time in 24-hr format.", format: { type: "grammar", syntax: "regex", definition: grammar, }, }, ],});console.log(response.output);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23from openai import OpenAIclient = OpenAI()grammar =r"^(?P<month>January|February|March|April|May|June|July|August|September|October|November|December)\s+(?P<day>\d{1,2})(?:st|nd|rd|th)?\s+(?P<year>\d{4})\s+at\s+(?P<hour>0?[1-9]|1[0-2])(?P<ampm>AM|PM)$"response = client.responses.create(model="gpt-6-astra",input="Use the timestamp tool to save a timestamp for August 7th 2025 at 10AM.",tools=[ {"type": "custom","name": "timestamp","description": "Saves a timestamp in date + time in 24-hr format.","format": {"type": "grammar","syntax": "regex","definition": grammar, }, } ],)print(response.output)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses" "github.com/openai/openai-go/v3/shared")func main() { client := openai.NewClient() grammar := `^(?P<month>January|February|March|April|May|June|July|August|September|October|November|December)\s+(?P<day>\d{1,2})(?:st|nd|rd|th)?\s+(?P<year>\d{4})\s+at\s+(?P<hour>0?[1-9]|1[0-2])(?P<ampm>AM|PM)$` tool := responses.ToolParamOfCustom("timestamp") tool.OfCustom.Description = openai.String("Saves a timestamp in date and time format.") tool.OfCustom.Format = shared.CustomToolInputFormatParamOfGrammar(grammar, "regex") response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Input: responses.ResponseNewParamsInputUnion{OfString: openai.String("Use the timestamp tool to save a timestamp for August 7th 2025 at 10AM.")}, Tools: []responses.ToolUnionParam{tool}, }) if err != nil { panic(err) } fmt.Println(response.Output)}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.CustomToolInputFormat;import com.openai.models.responses.CustomTool;import com.openai.models.responses.ResponseCreateParams;String grammar = "^(January|February|March|April|May|June|July|August|September|October|November|December) " + "\\d{1,2}(st|nd|rd|th)? \\d{4} at (0?[1-9]|1[0-2])(AM|PM)$";ResponseCreateParams params = ResponseCreateParams.builder() .model("gpt-6-astra") .input("Use timestamp to save August 7th 2025 at 10AM.") .addTool( CustomTool.builder() .name("timestamp") .description("Saves a timestamp in date and time format.") .format( CustomToolInputFormat.Grammar.builder() .syntax(CustomToolInputFormat.Grammar.Syntax.REGEX) .definition(grammar) .build()) .build()) .build();client.responses().create(params).output().forEach(System.out::println);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22require "openai"client = OpenAI::Client.newgrammar = "^(January|February|March|April|May|June|July|August|September|October|November|December) \\d{1,2}(st|nd|rd|th)? \\d{4} at (0?[1-9]|1[0-2])(AM|PM)$"response = client.responses.create( model: "gpt-6-astra", input: "Use timestamp to save August 7th 2025 at 10AM.", tools: [ { type: :custom, name: "timestamp", description: "Saves a timestamp in date and time format.", format: { type: :grammar, syntax: :regex, definition: grammar } } ])puts(response.output)
Die vom Modell erzeugte Eingabe für das Tool sollte dann der von dir definierten Regex-Grammatik entsprechen:
Einige Funktionen regulärer Ausdrücke werden nicht unterstützt:
Lookaround-Ausdrücke
Nicht gierige Quantifizierer (*?, +?, ??)
Grundlagen und Empfehlungen
Das Muster muss in einer einzigen Zeile stehen
Wenn du einen Zeilenumbruch in der Eingabe erkennen möchtest, verwende die Escape-Sequenz \n. Verwende nicht den erweiterten Modus (Verbose/Extended), in dem sich Muster über mehrere Zeilen erstrecken können.