
Dieser Leitfaden beschreibt die grundlegenden Prinzipien, mit denen du die Latenz bei unterschiedlichsten Anwendungsfällen mit LLMs reduzieren kannst. Die Techniken stammen aus der Zusammenarbeit mit zahlreichen Kunden und Entwicklungsteams an Anwendungen im Produktivbetrieb. Sie sollten daher unabhängig davon anwendbar sein, was du entwickelst: vom kleinteiligen Ablauf bis zur vollständigen Chat-Anwendung.
Es gibt viele einzelne Techniken. Dieser Leitfaden fasst sie zu sieben Prinzipien zusammen, die einen Überblick über die verschiedenen Ansätze zur Latenzoptimierung geben.
Zum Schluss gehen wir ein Beispiel durch, um zu zeigen, wie sich diese Prinzipien anwenden lassen.
Sieben Prinzipien
- Token schneller verarbeiten.
- Weniger Token generieren.
- Weniger Eingabetoken verwenden.
- Weniger Anfragen senden.
- Parallelisieren.
- Wartezeiten für Nutzende verkürzen.
- Nicht standardmäßig ein LLM einsetzen.
Token schneller verarbeiten
Bei Latenz denkst du wahrscheinlich zuerst an die Inferenzgeschwindigkeit . Wie du gleich sehen wirst, ist sie aber längst nicht der einzige Faktor. Gemeint ist die tatsächliche Geschwindigkeit, mit der das LLM Token verarbeitet. Sie wird häufig in TPM (Token pro Minute) oder TPS (Token pro Sekunde) gemessen.
Den größten Einfluss auf die Inferenzgeschwindigkeit hat die Modellgröße. Kleinere Modelle sind meist schneller und kostengünstiger. Richtig eingesetzt können sie sogar bessere Ergebnisse liefern als größere Modelle. Um auch mit kleineren Modellen hochwertige Ergebnisse zu erzielen, kannst du Folgendes ausprobieren:
- einen längeren, detaillierteren Prompt verwenden,
- (weitere) Few-Shot-Beispiele hinzufügen oder
- Fine-Tuning / Destillation einsetzen.
Du kannst auch Inferenzoptimierungen wie unsere Funktion Vorhergesagte Ausgaben nutzen. Mit vorhergesagten Ausgaben lässt sich die Latenz der Generierung deutlich senken, wenn du den Großteil der Ausgabe bereits im Voraus kennst, etwa bei Aufgaben zur Codebearbeitung. Indem du dem Modell eine Vorhersage mitgibst, kann sich das LLM stärker auf die tatsächlichen Änderungen konzentrieren und weniger auf Inhalte, die unverändert bleiben.
Weitere Faktoren für die Inferenzgeschwindigkeit sind die verfügbare
Rechenleistung und zusätzliche
Inferenzoptimierungen, die du einsetzt.
Die meisten können diese Faktoren nicht direkt beeinflussen. Wenn du aber neugierig bist und
deine Infrastruktur zumindest teilweise selbst steuern kannst, lassen sich mit schnellerer Hardware oder
geringerer Auslastung der Inferenz-Engines möglicherweise etwas
höhere TPM-Werte erzielen. Wenn du dich noch tiefer mit der Technik beschäftigst, gibt es zahlreiche weitere
Inferenzoptimierungen
, die den Rahmen dieses Leitfadens sprengen würden.
Weniger Token generieren
Bei der Verwendung eines LLM verursacht die Tokengenerierung fast immer die größte Latenz. Als Faustregel gilt: 50 % weniger Ausgabetoken können die Latenz um etwa 50 % senken. Wie du den Umfang der Ausgabe reduzierst, hängt von der Art der Ausgabe ab:
Wenn du natürliche Sprache generierst, kann es helfen, das Modell zu kürzeren Antworten aufzufordern („unter 20 Wörtern“ oder „Fasse dich kurz“). Mit Few-Shot-Beispielen und/oder Fine-Tuning kannst du dem Modell ebenfalls kürzere Antworten beibringen.
Wenn du strukturierte Ausgaben generierst, versuche, die Ausgabesyntax möglichst knapp zu halten : Kürze Funktionsnamen, lasse benannte Argumente weg, fasse Parameter zusammen usw.
Schließlich kannst du auch max_tokens oder stop_tokens verwenden, um die Generierung vorzeitig zu beenden, auch wenn das eher unüblich ist.
Denk daran: Jedes eingesparte Ausgabetoken ist eine gewonnene (Milli-)Sekunde!
Weniger Eingabetoken verwenden
Weniger Eingabetoken senken zwar die Latenz, doch der Effekt ist meist gering: Ein um 50 % kürzerer Prompt kann die Latenz unter Umständen nur um 1–5 % verbessern. Sofern du nicht mit wirklich großen Kontextmengen arbeitest (Dokumente, Bilder), lohnt es sich möglicherweise eher, an anderer Stelle zu optimieren.
Wenn du allerdings tatsächlich mit sehr großen Kontextmengen arbeitest (oder das letzte Quäntchen Leistung herausholen möchtest und alle anderen Möglichkeiten ausgeschöpft hast), kannst du die Zahl der Eingabetoken mit folgenden Techniken reduzieren:
- Fine-Tuning des Modells, damit lange Anweisungen oder Beispiele nicht mehr nötig sind.
- Kontexteingaben filtern, etwa RAG-Ergebnisse kürzen, HTML bereinigen usw.
- Den gemeinsamen Prompt-Präfix maximieren, indem du dynamische Teile (zum Beispiel RAG-Ergebnisse und den Verlauf) weiter hinten im Prompt platzierst. So kann deine Anfrage den KV-Cache, den die meisten LLM-Anbieter nutzen, besser ausnutzen. Dadurch müssen bei jeder Anfrage weniger Eingabetoken verarbeitet werden.
In unserer Dokumentation erfährst du mehr darüber, wie das Caching von Prompts funktioniert.
Weniger Anfragen senden
Bei jeder Anfrage entsteht eine gewisse Latenz für den Hin- und Rückweg. Diese Zeiten können sich summieren.
Wenn das LLM mehrere Schritte nacheinander ausführen soll, musst du nicht für jeden Schritt eine eigene Anfrage senden. Erwäge stattdessen, alle Schritte in einem einzigen Prompt zusammenzufassen und sämtliche Ergebnisse in einer Antwort abzurufen. So vermeidest du zusätzliche Latenz für den Hin- und Rückweg und vereinfachst möglicherweise auch die Verarbeitung mehrerer Antworten.
Dazu kannst du die Schritte im kombinierten Prompt als nummerierte Liste aufführen und das Modell bitten, die Ergebnisse in benannten Feldern eines JSON-Objekts zurückzugeben. So kannst du jedes Ergebnis parsen und gezielt darauf zugreifen.
Parallelisieren
Wenn du mehrere Schritte mit einem LLM ausführst, kann die parallele Verarbeitung sehr effektiv sein.
Wenn die Schritte nicht zwingend nacheinander ausgeführt werden müssen, kannst du sie auf parallele Aufrufe verteilen. Zwei Hemden brauchen schließlich genauso lange zum Trocknen wie eines.
Wenn die Schritte hingegen zwingend nacheinander ausgeführt werden müssen, kannst du möglicherweise trotzdem spekulative Ausführung nutzen. Das ist besonders effektiv bei Klassifizierungsschritten, bei denen ein Ergebnis wahrscheinlicher ist als die anderen (zum Beispiel bei der Moderation).
- Starte Schritt 1 und Schritt 2 gleichzeitig (zum Beispiel die Moderation der Eingabe und die Generierung einer Geschichte)
- Überprüfe das Ergebnis von Schritt 1
- Wenn das Ergebnis nicht dem erwarteten entspricht, brich Schritt 2 ab (und versuche es bei Bedarf erneut)
Wenn deine Annahme für Schritt 1 stimmt, hast du ihn praktisch ohne zusätzliche Latenz ausgeführt!
Wartezeiten für Nutzende verkürzen
Es macht einen großen Unterschied, ob man wartet oder Fortschritte sieht. Sorge dafür, dass die Nutzenden Letzteres erleben. Hier sind einige Techniken dafür:
- Streaming: Der mit Abstand effektivste Ansatz, da er die Wartezeit auf eine Sekunde oder weniger verkürzt. (ChatGPT würde sich ganz anders anfühlen, wenn du erst etwas sehen würdest, sobald die jeweilige Antwort vollständig ist.)
- Abschnittsweise Verarbeitung: Wenn deine Ausgabe vor der Anzeige noch verarbeitet werden muss (Moderation, Übersetzung), erwäge, sie in Abschnitten zu verarbeiten , statt alles auf einmal zu bearbeiten. Streame sie dazu an dein Backend und sende die verarbeiteten Abschnitte anschließend an dein Frontend.
- Schritte anzeigen: Wenn du mehrere Schritte ausführst oder Tools verwendest, mache das für die Nutzenden sichtbar. Je mehr tatsächlichen Fortschritt du zeigen kannst, desto besser.
- Ladezustände: Ladeanimationen und Fortschrittsbalken helfen schon viel.
Beachte: Die Anzeige von Schritten und Ladezuständen wirkt vor allem psychologisch. Streaming und abschnittsweise Verarbeitung reduzieren dagegen tatsächlich die gesamte Latenz, wenn du App und Nutzende zusammen betrachtest: Die Antwort ist früher zu Ende gelesen.
Nicht standardmäßig ein LLM einsetzen
Sprachmodelle sind leistungsfähig und vielseitig. Deshalb werden sie manchmal auch dort eingesetzt, wo eine schnellere klassische Methode besser geeignet wäre. Wenn du solche Fälle erkennst, kannst du die Latenz möglicherweise deutlich senken. Hier sind einige Beispiele:
- Fest im Code hinterlegen: Wenn deine Ausgabe sehr engen Vorgaben folgt, brauchst du möglicherweise kein LLM, um sie zu erzeugen. Bestätigungen von Aktionen, Ablehnungen und Aufforderungen zu Standardeingaben eignen sich gut dafür, fest im Code hinterlegt zu werden. (Du kannst dabei auch auf die bewährte Methode zurückgreifen, für jeden Fall mehrere Varianten zu formulieren.)
- Vorberechnen: Wenn deine Eingabe auf bestimmte Möglichkeiten beschränkt ist (zum Beispiel die Auswahl einer Kategorie), kannst du mehrere Antworten im Voraus generieren. Anschließend musst du nur sicherstellen, dass du derselben Person nie zweimal dieselbe Antwort zeigst.
- Die Benutzeroberfläche nutzen: Zusammengefasste Kennzahlen, Berichte oder Suchergebnisse lassen sich manchmal mit klassischen, eigens dafür entwickelten UI-Komponenten besser vermitteln als mit LLM-generiertem Text.
- Klassische Optimierungstechniken: Eine LLM-Anwendung ist nach wie vor eine Anwendung. Binäre Suche, Caching, Hashmaps und Laufzeitkomplexität sind auch in einer Welt der Sprachmodelle weiterhin nützliche Konzepte.
Beispiel
Sehen wir uns nun eine Beispielanwendung an, suchen nach Möglichkeiten zur Latenzoptimierung und schlagen passende Lösungen vor!
Wir analysieren die Architektur und die Prompts eines hypothetischen Kundenservice-Bots, der sich an realen Anwendungen im Produktivbetrieb orientiert. Der Abschnitt Architektur und Prompts stellt die Ausgangslage vor. Im Abschnitt Analyse und Optimierungen gehen wir die Latenzoptimierung Schritt für Schritt durch.
Dieses Beispiel behandelt nicht jedes einzelne Prinzip. Genauso wenig musst du in der Praxis bei jedem Anwendungsfall alle Techniken einsetzen.
Architektur und Prompts
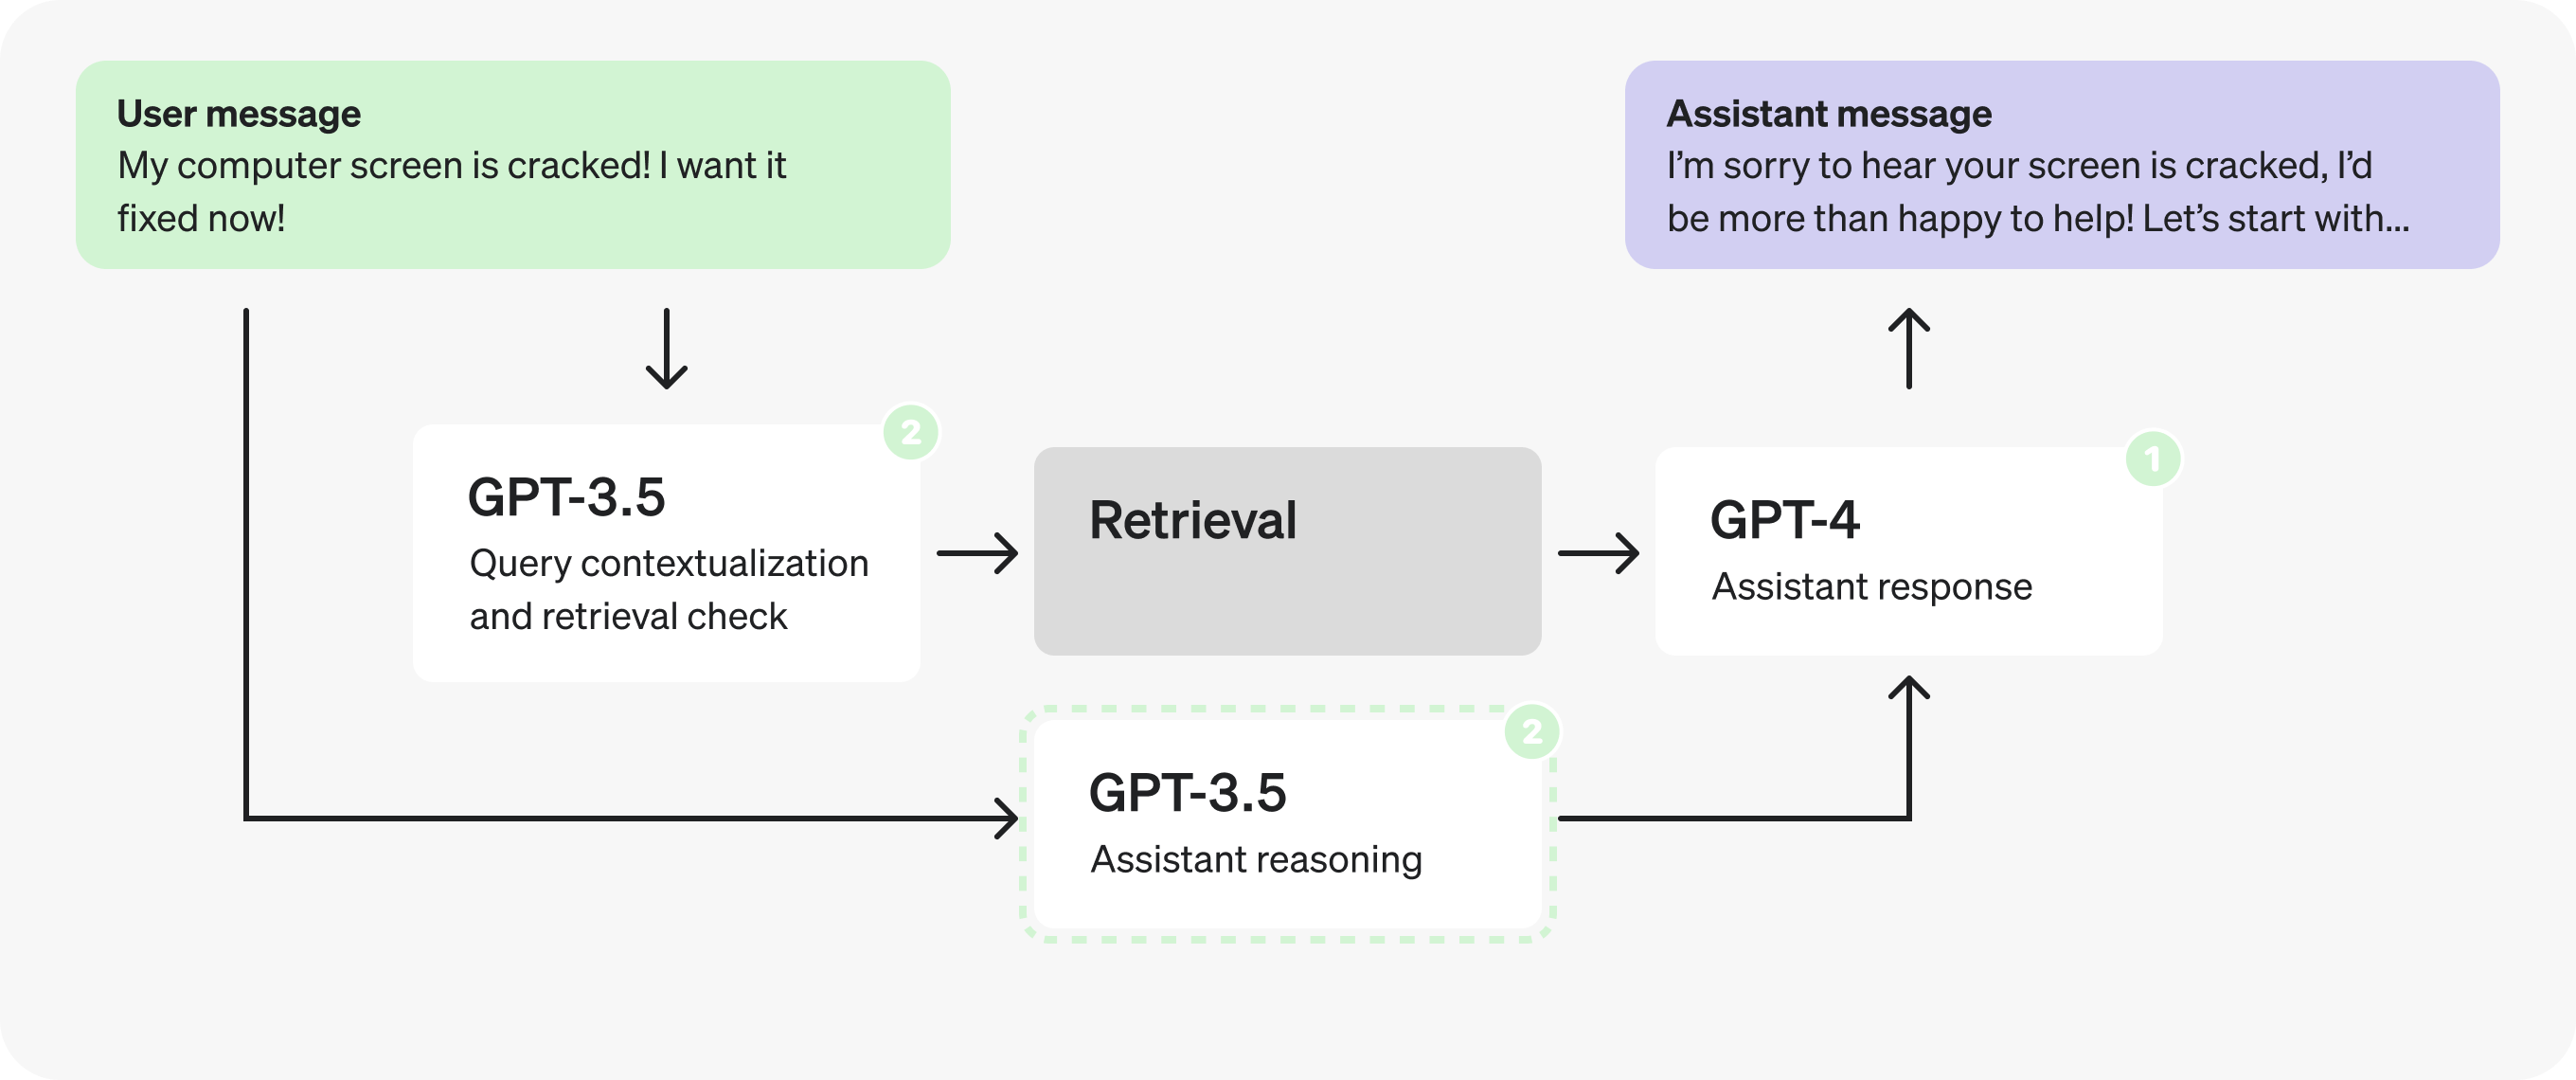
Die folgende Abbildung zeigt die ursprüngliche Architektur eines hypothetischen Kundenservice-Bots. An dieser Architektur werden wir Änderungen vornehmen.
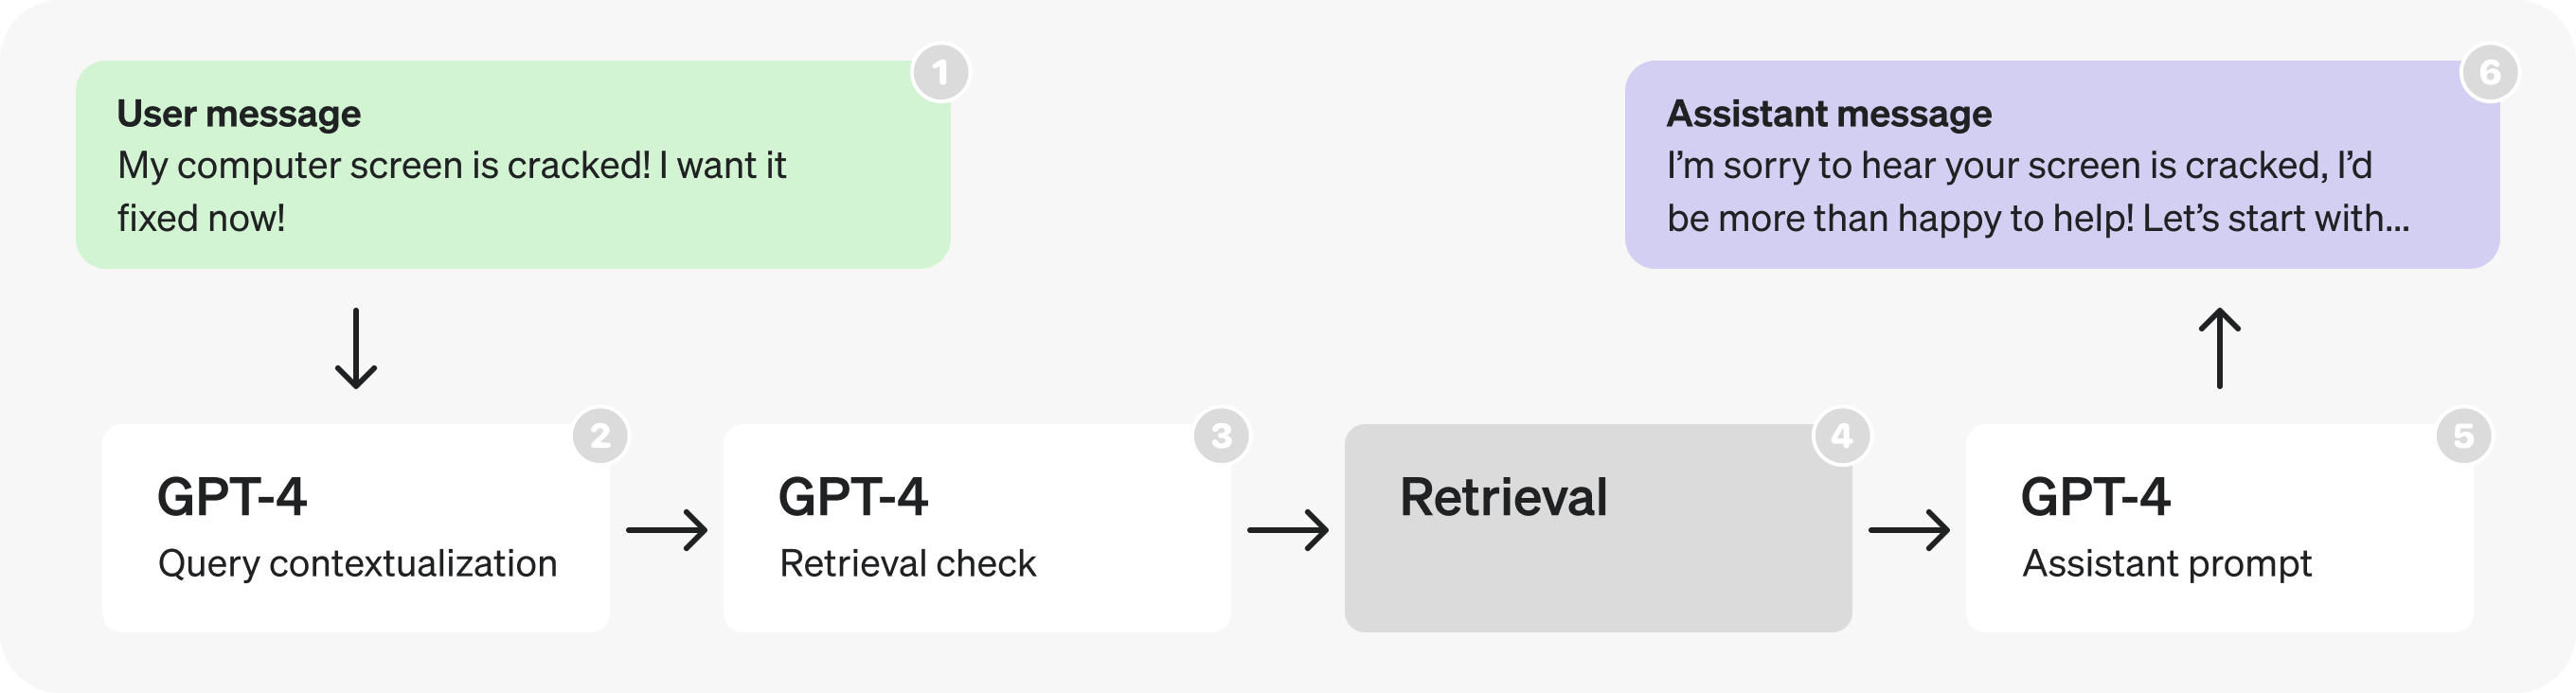
Das Diagramm zeigt im Wesentlichen folgenden Ablauf:
- Eine Person sendet im Rahmen einer laufenden Unterhaltung eine Nachricht.
- Die letzte Nachricht wird in eine eigenständig verständliche Anfrage umformuliert (siehe Beispiele im Prompt).
- Wir ermitteln, ob zur Beantwortung dieser Anfrage zusätzliche Informationen abgerufen werden müssen .
- Der Informationsabruf wird durchgeführt und liefert Suchergebnisse.
- Der Assistent analysiert die Anfrage der Person und die Suchergebnisse und erstellt eine Antwort.
- Die Antwort wird an die Person zurückgesendet.
Im Folgenden findest du die Prompts für die einzelnen Teile des Diagramms. Sie sind zwar hypothetisch und vereinfacht, entsprechen aber in Aufbau und Formulierung den Prompts einer Anwendung im Produktivbetrieb.
Platzhalter wie „[user input here]“ kennzeichnen dynamische Inhalte, die zur Laufzeit durch tatsächliche Daten ersetzt werden.
Analyse und Optimierungen
Teil 1: Prompts für den Informationsabruf untersuchen
Beim Blick auf die Architektur fallen zuerst die aufeinanderfolgenden GPT-4-Aufrufe auf. Sie deuten auf mögliche Ineffizienzen hin und lassen sich oft durch einen einzigen Aufruf oder parallele Aufrufe ersetzen.
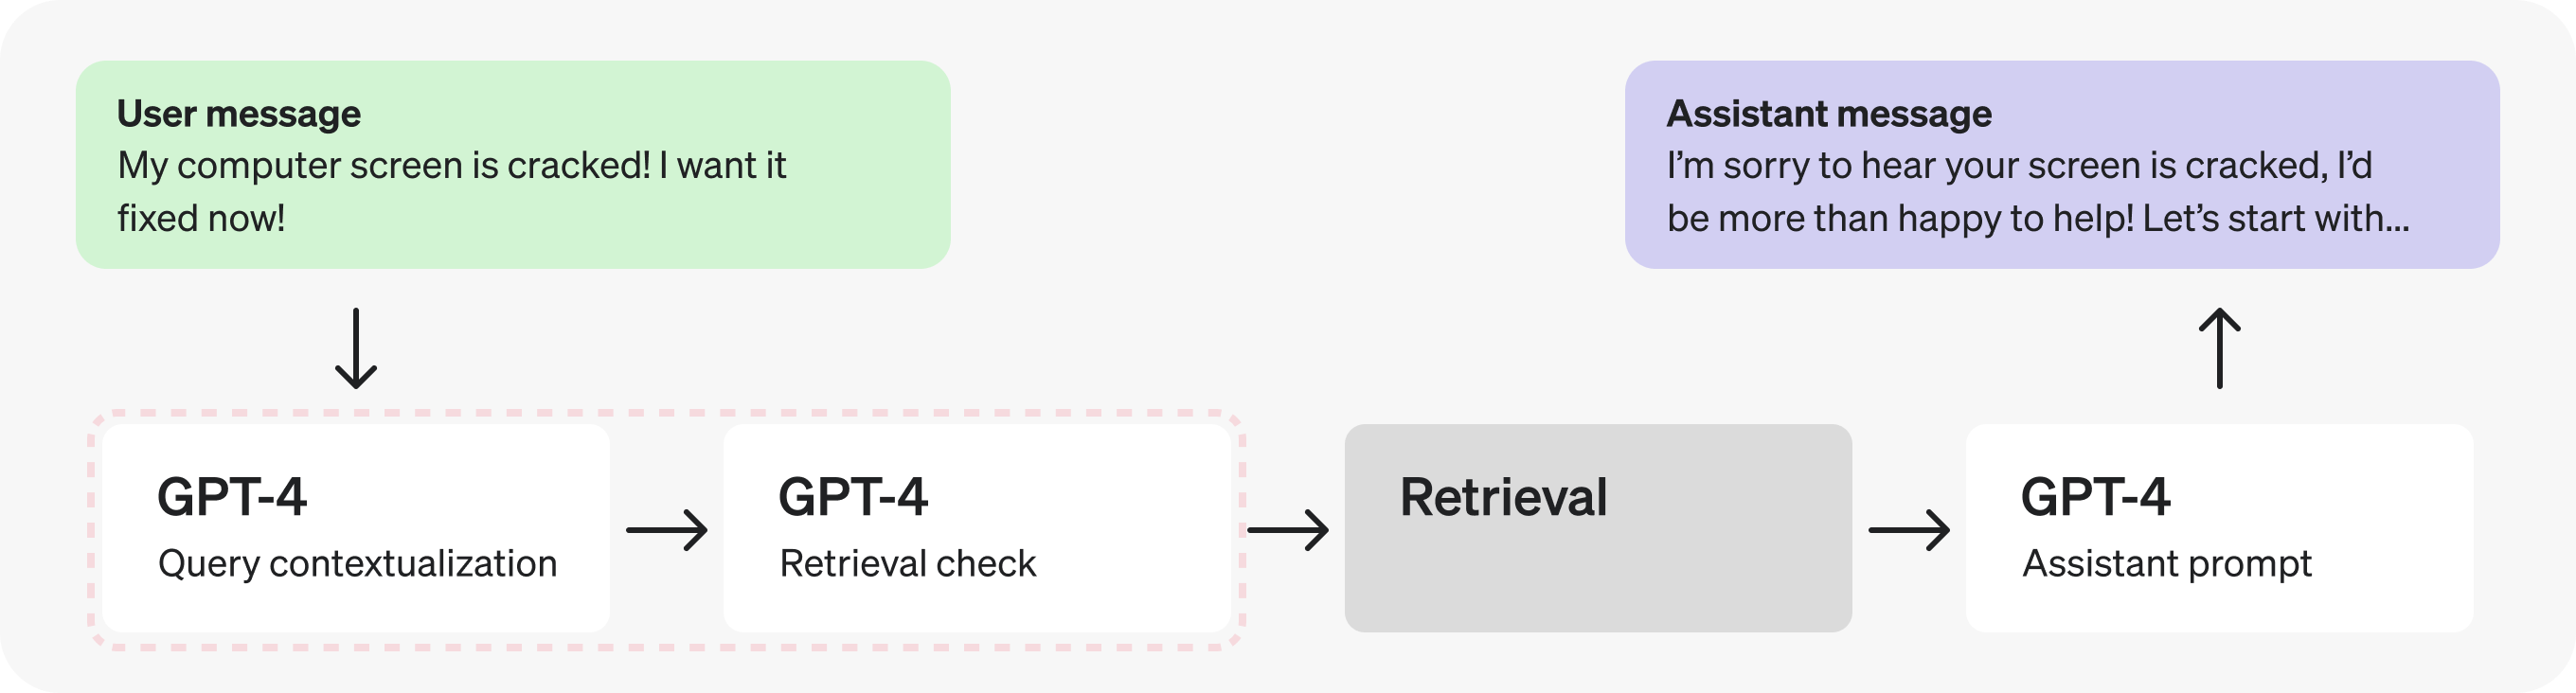
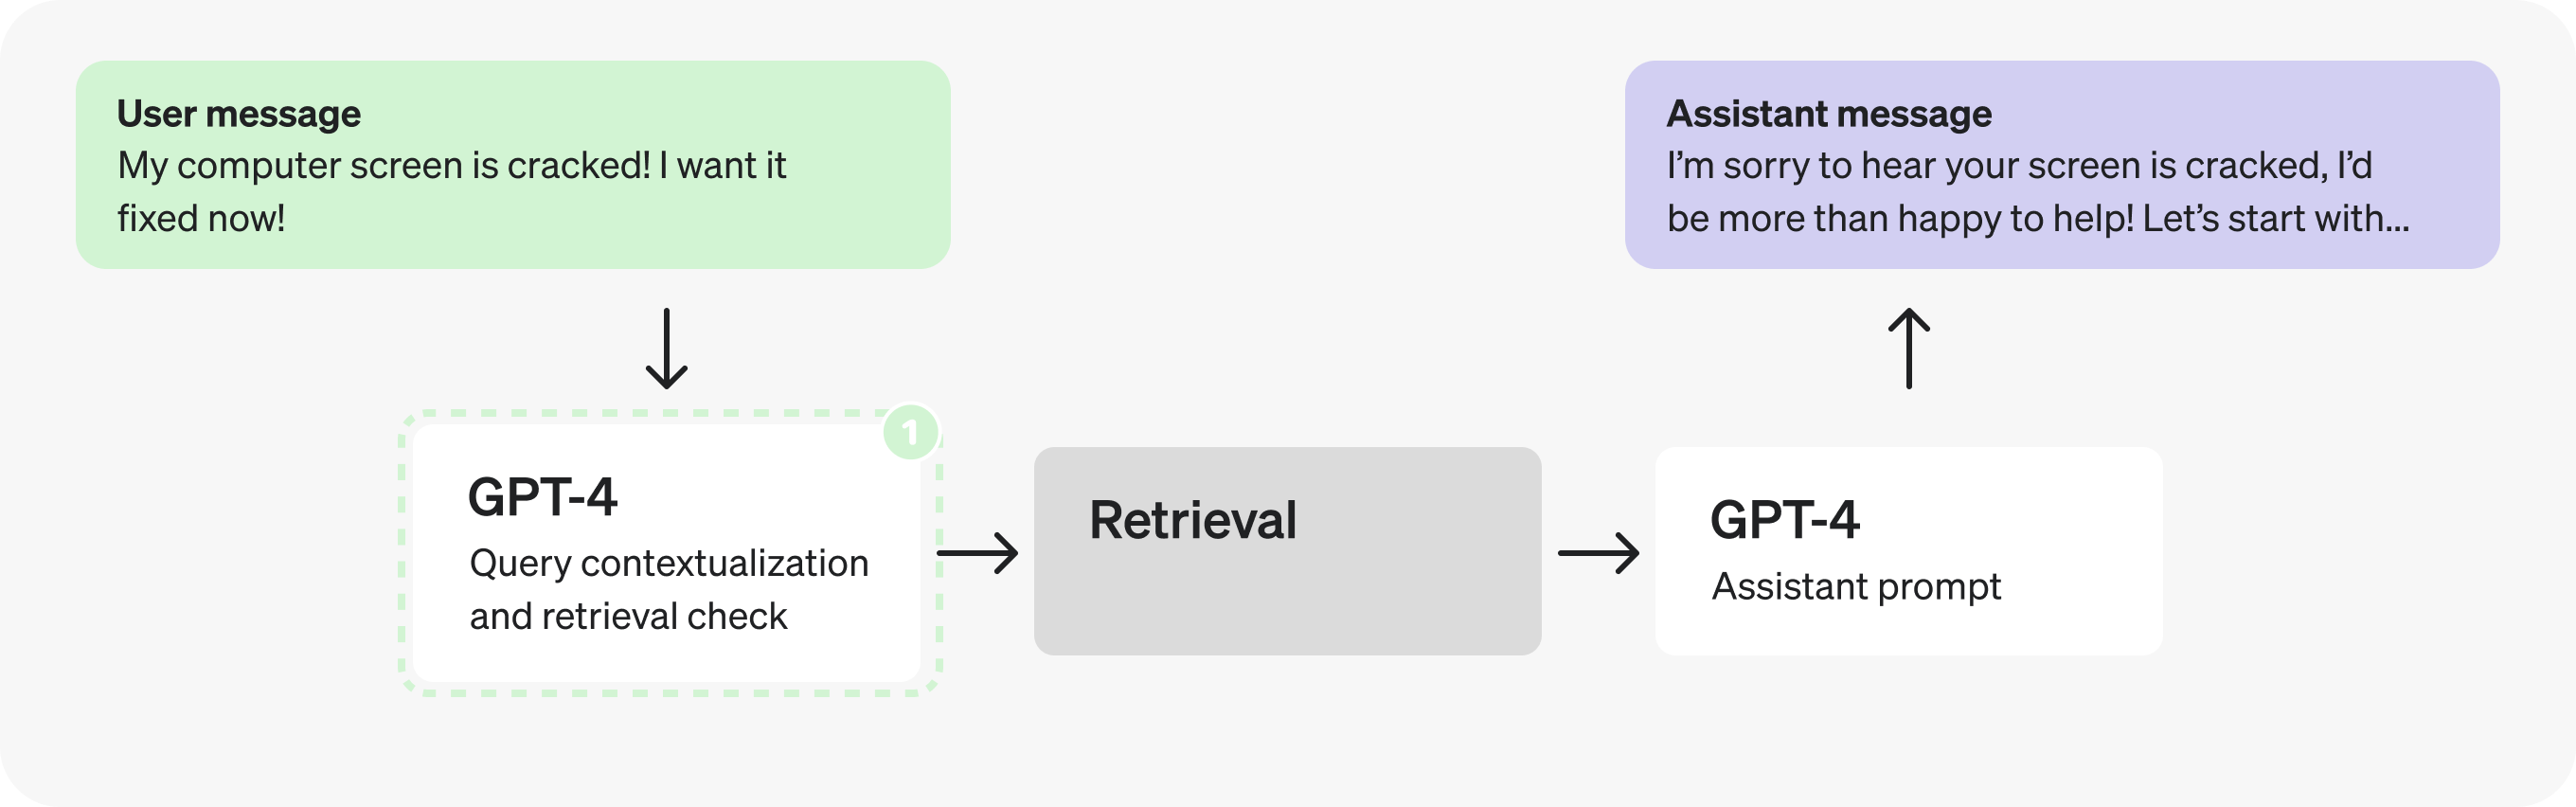
In diesem Fall benötigt die Prüfung, ob ein Informationsabruf nötig ist, die um Kontext ergänzte Anfrage. Deshalb kombinieren wir beide Schritte in einem einzigen Prompt , um weniger Anfragen zu stellen.
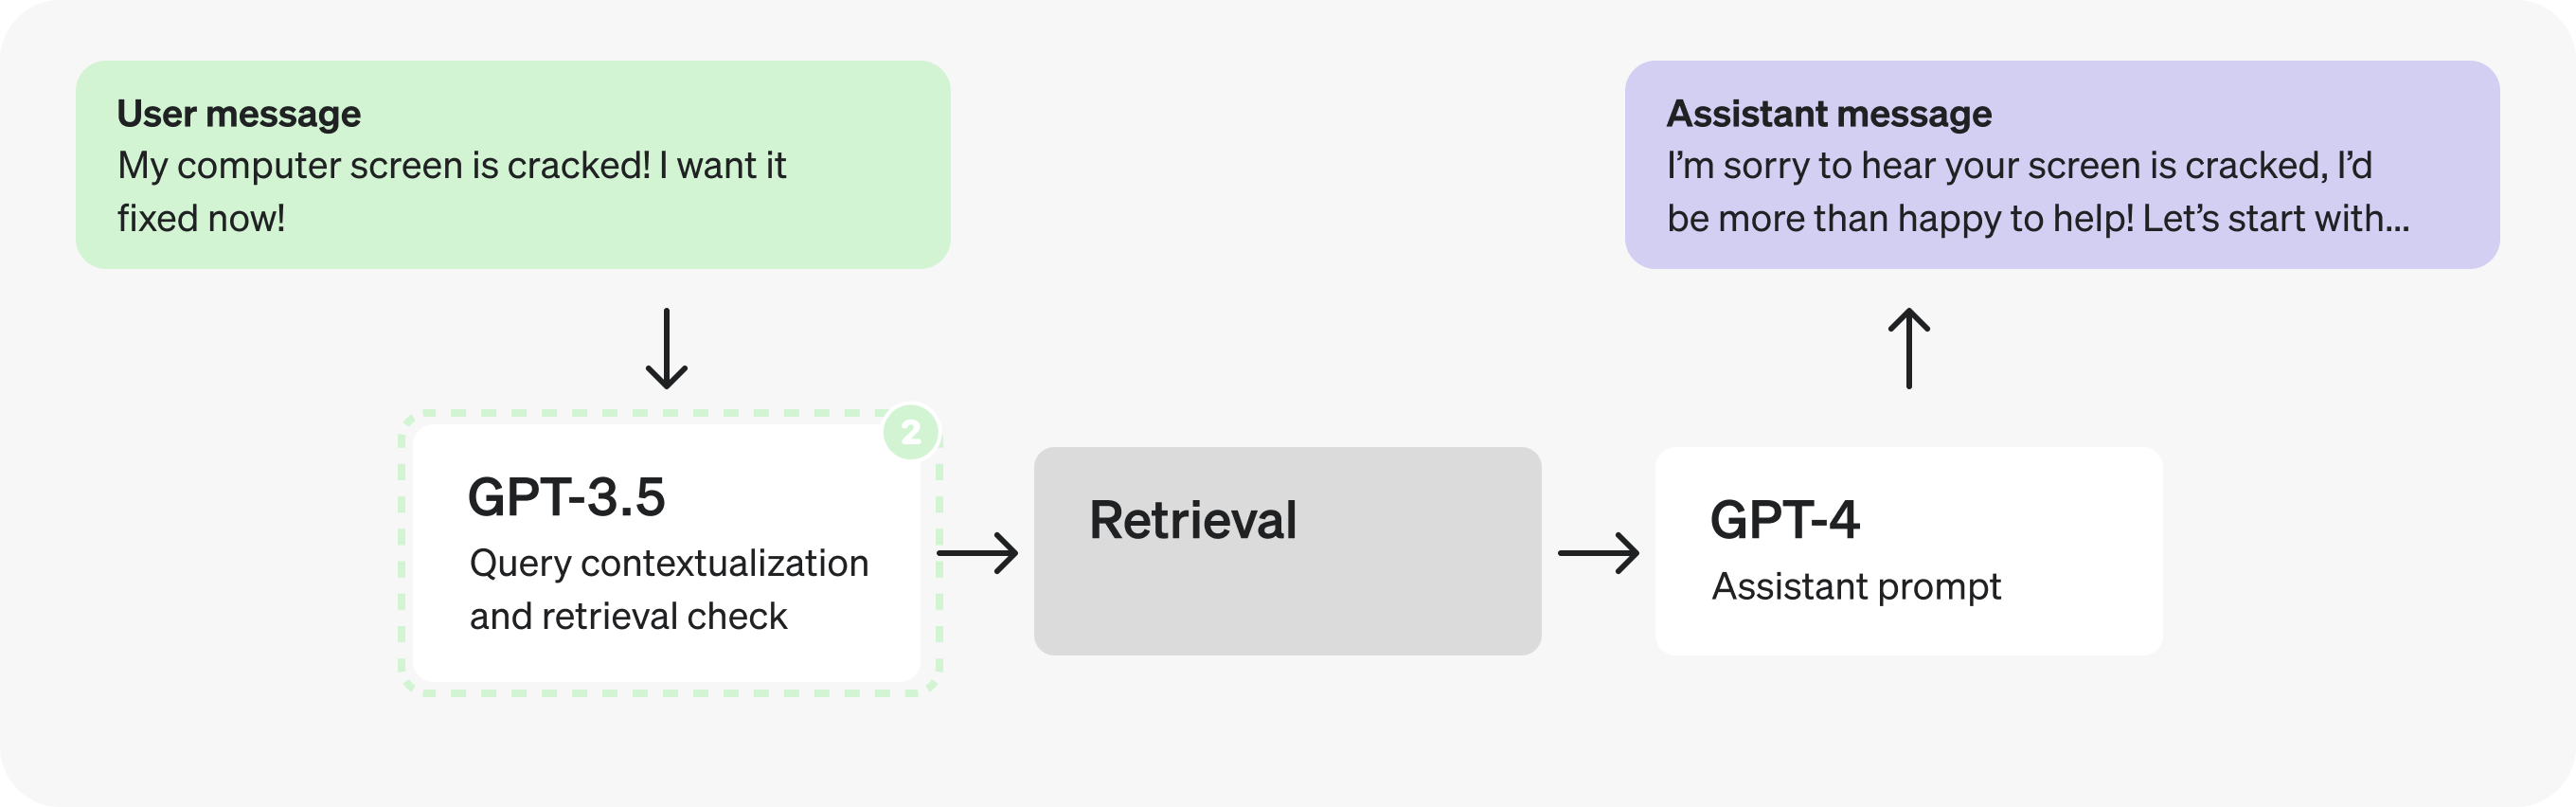
Kontext zu ergänzen und zu ermitteln, ob Informationen abgerufen werden müssen, sind einfache, klar definierte Aufgaben. Daher können wir wahrscheinlich ein kleineres, durch Fine-Tuning angepasstes Modell dafür einsetzen. Mit dem Wechsel zu GPT-3.5 können wir Token schneller verarbeiten.
Teil 2: Den Assistenten-Prompt analysieren
Wenden wir uns nun dem Assistenten-Prompt zu. Beim Ausfüllen der JSON-Felder scheinen viele einzelne Schritte abzulaufen. Das könnte eine Gelegenheit bieten, diese parallel auszuführen.
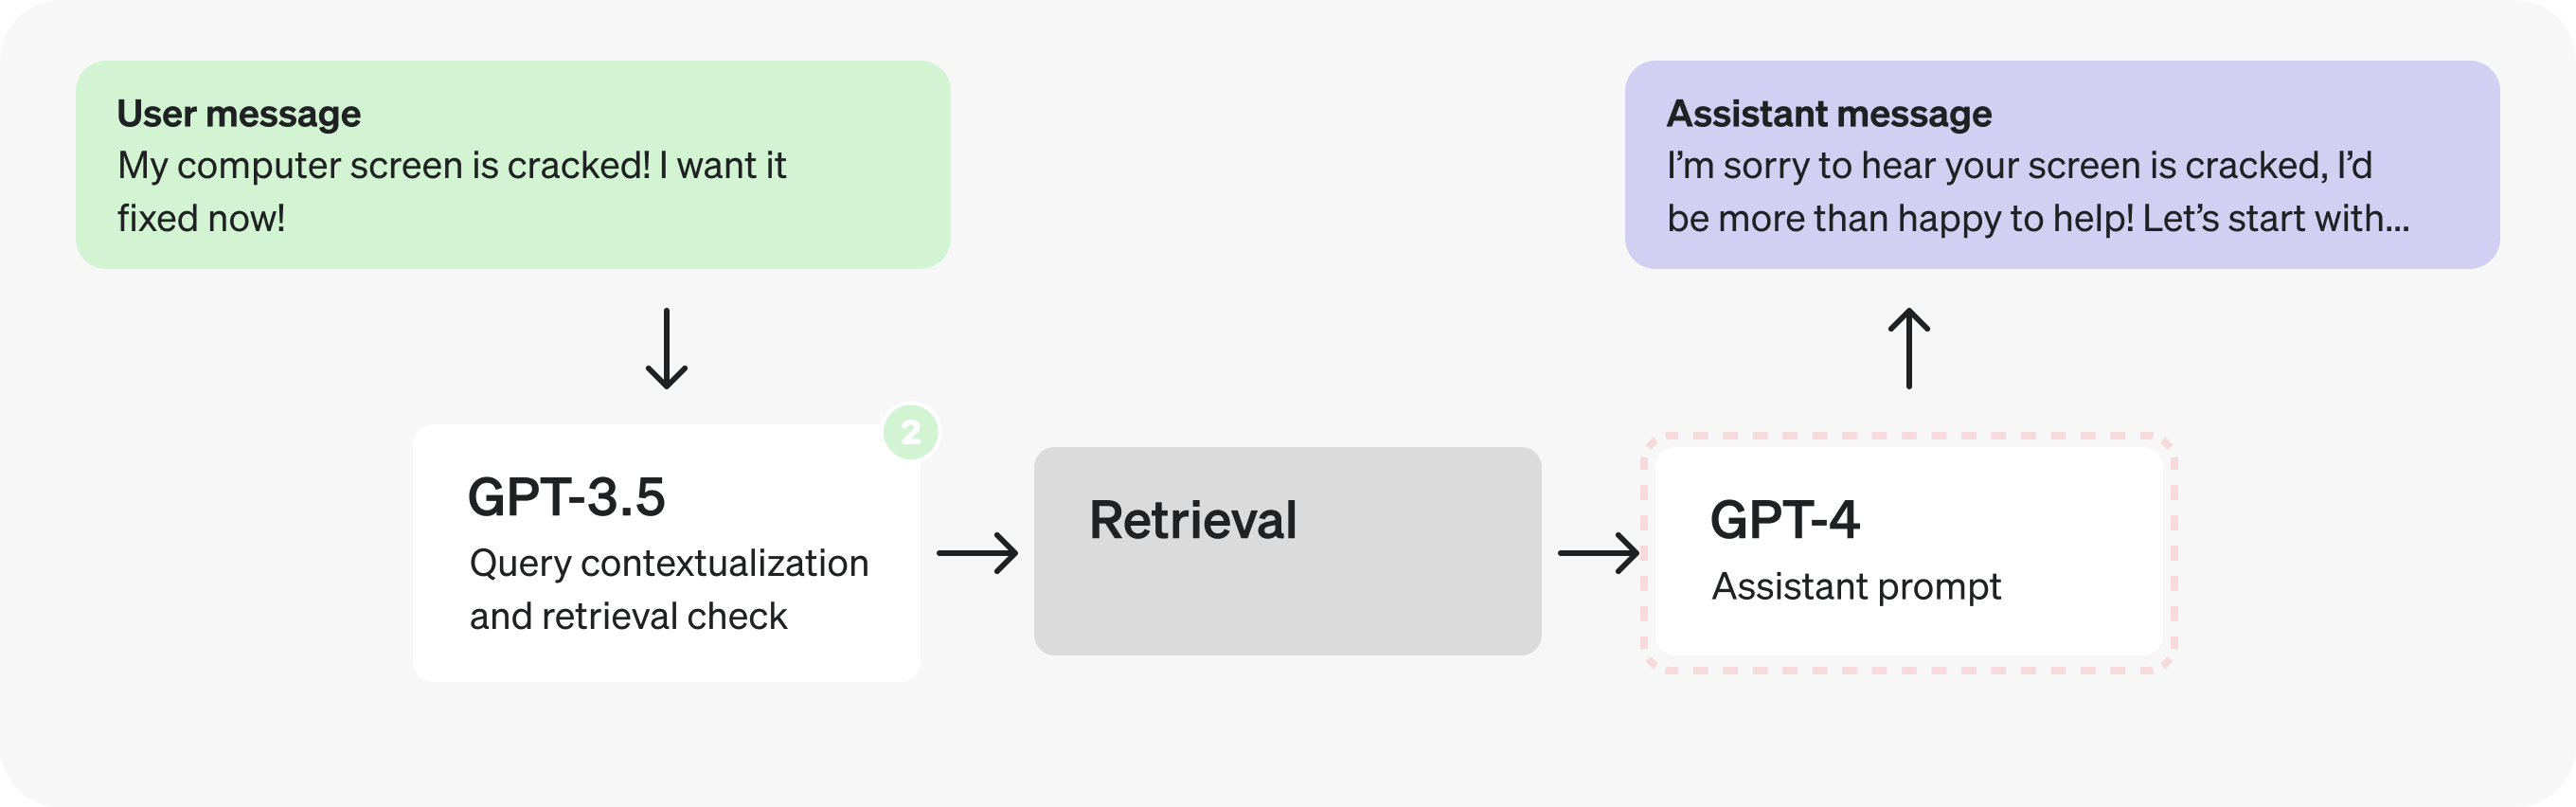
Nehmen wir jedoch an, wir hätten Tests durchgeführt und dabei festgestellt, dass die Aufteilung der Denkschritte im JSON zu schlechteren Antworten führt. Wir müssen also andere Lösungen untersuchen.
Könnten wir statt GPT-4 ein durch Fine-Tuning angepasstes GPT-3.5 verwenden? Vielleicht. Frei formulierte Antworten von Assistenten überlässt man jedoch im Allgemeinen am besten GPT-4, da es ein breiteres Spektrum an Fällen besser bewältigen kann. Betrachtet man die einzelnen Denkschritte, erfordern möglicherweise nicht alle Denkfähigkeiten auf dem Niveau von GPT-4. Da ihr Umfang klar definiert und begrenzt ist, kommen sie gut für Fine-Tuning infrage.
{
message_is_conversation_continuation: "True", // <-
number_of_messages_in_conversation_so_far: "1", // <-
user_sentiment: "Aggravated", // <-
query_type: "Hardware Issue", // <-
response_tone: "Validating and solution-oriented", // <-
response_requirements: "Propose options for repair or replacement.", // <-
user_requesting_to_talk_to_human: "False", // <-
enough_information_in_context: "True", // <-
response: "...", // X -- benefits from GPT-4
}Hier müssen wir abwägen: Bleiben wir bei einer einzigen Anfrage, deren Ausgabe vollständig von GPT-4 generiert wird, oder teilen wir sie in zwei aufeinanderfolgende Anfragen auf und verwenden GPT-3.5 für alles außer der endgültigen Antwort? Zwei Prinzipien stehen hier im Konflikt: Mit der ersten Option können wir weniger Anfragen stellen, mit der zweiten möglicherweise Token schneller verarbeiten.
Wie bei vielen Optimierungsentscheidungen kommt es auf die Details an. Zum Beispiel auf:
- Das Verhältnis der Token-Anzahl im Feld
responsezu der in den anderen Feldern. - Die durchschnittliche Latenzverringerung durch die schnellere Verarbeitung der meisten Felder.
- Die durchschnittliche Erhöhung der Latenz durch zwei Anfragen statt einer.
Das Ergebnis fällt je nach Fall unterschiedlich aus. Am besten triffst du die Entscheidung anhand von Tests mit Beispielen aus dem Produktivbetrieb. Nehmen wir hier an, die Tests hätten gezeigt, dass es vorteilhaft ist, den Prompt in zwei Teile aufzuteilen, um Token schneller zu verarbeiten.
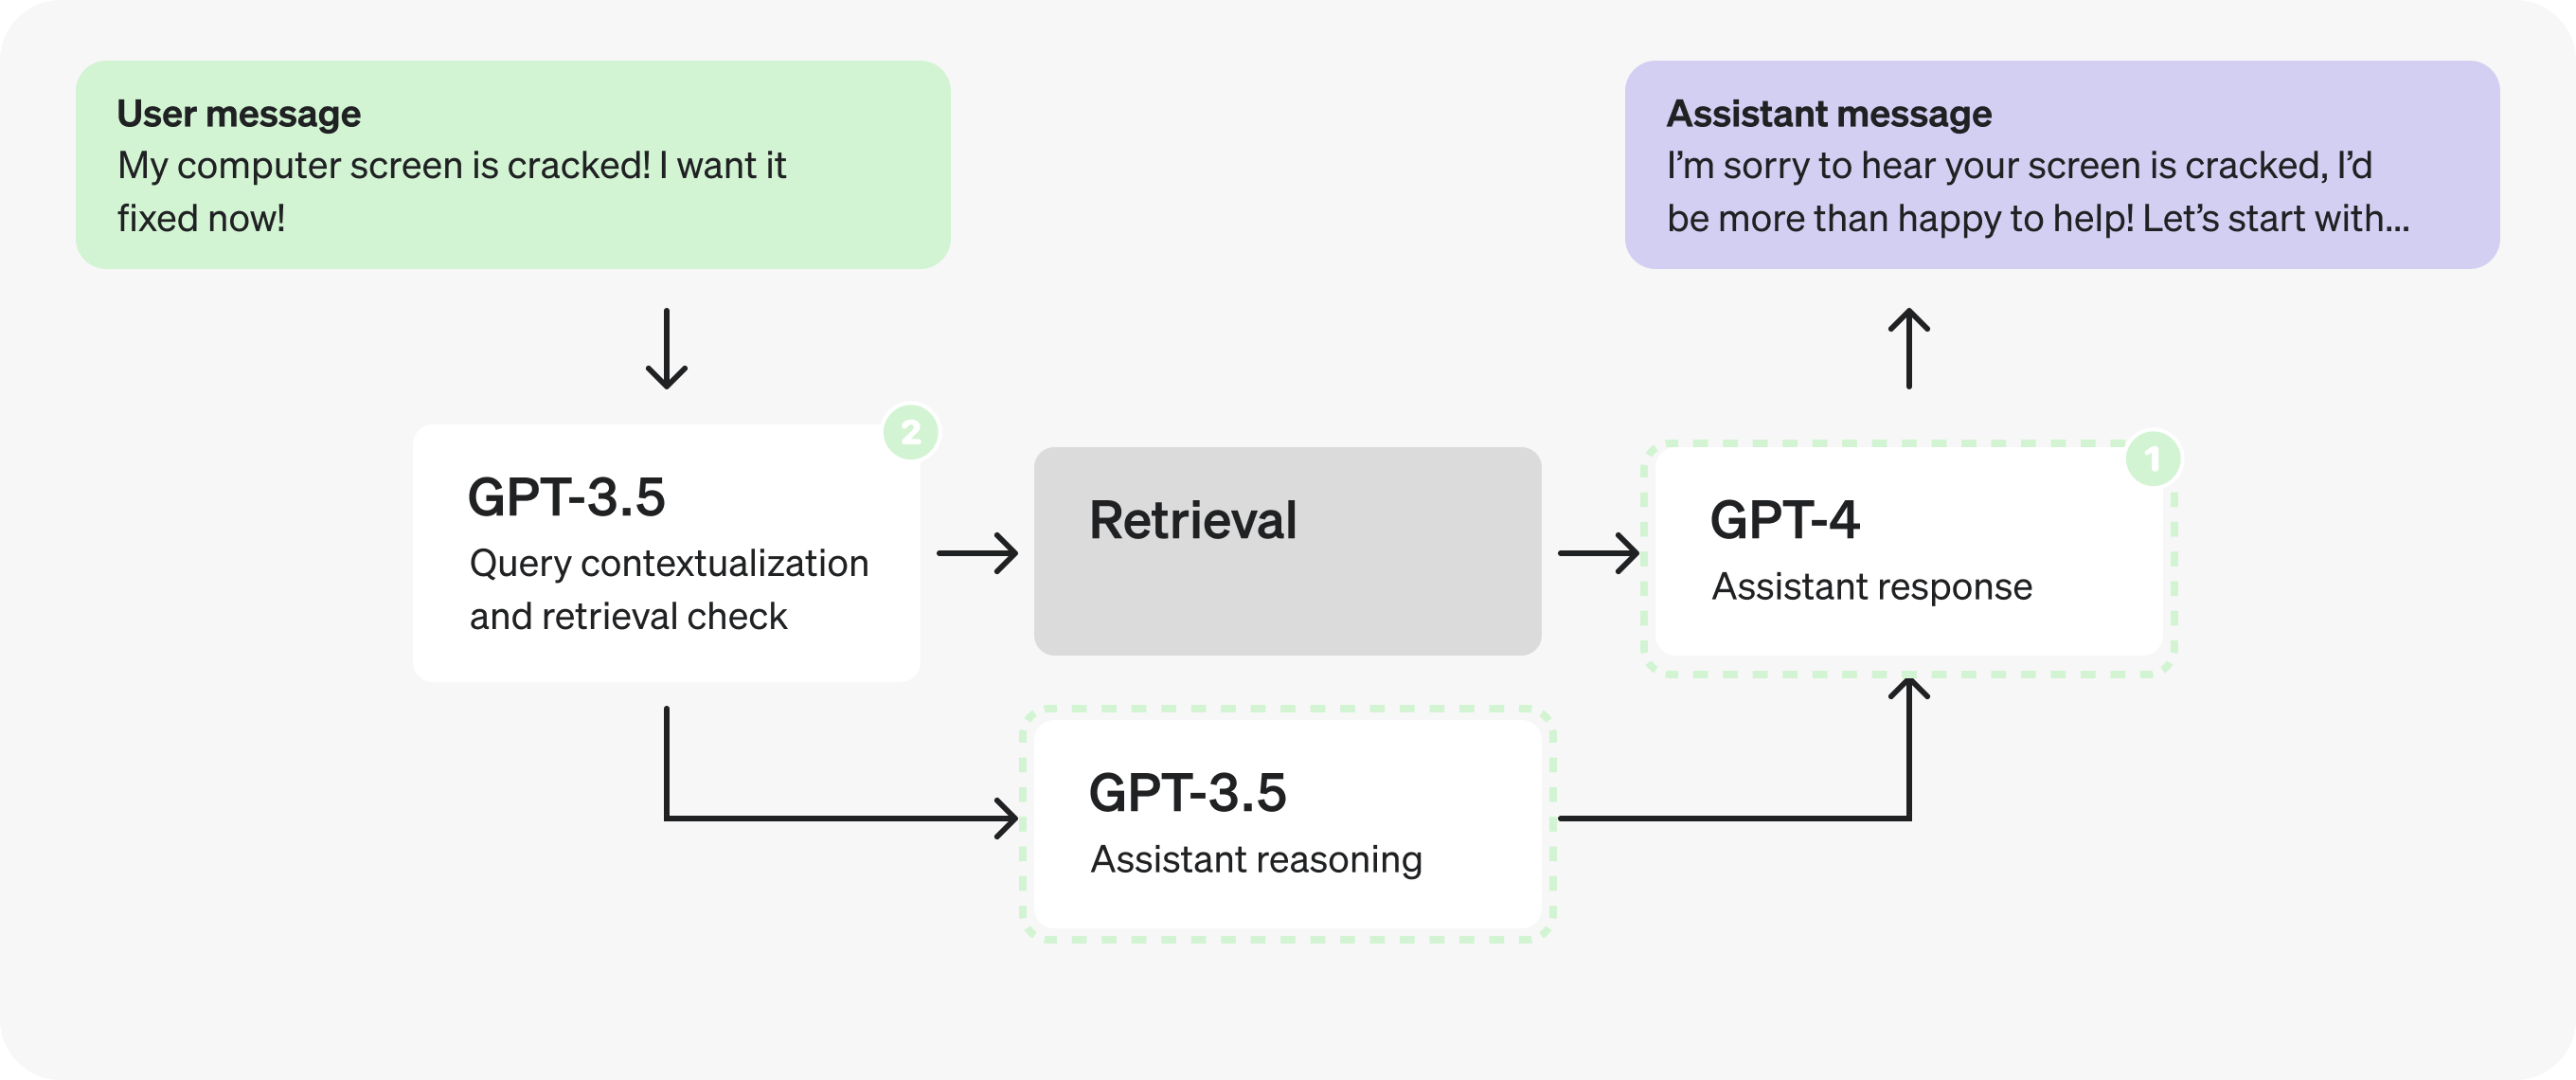
Hinweis: Wir fassen response und enough_information_in_context im zweiten Prompt zusammen, damit wir den abgerufenen Kontext nicht an beide neuen Prompts übergeben müssen.
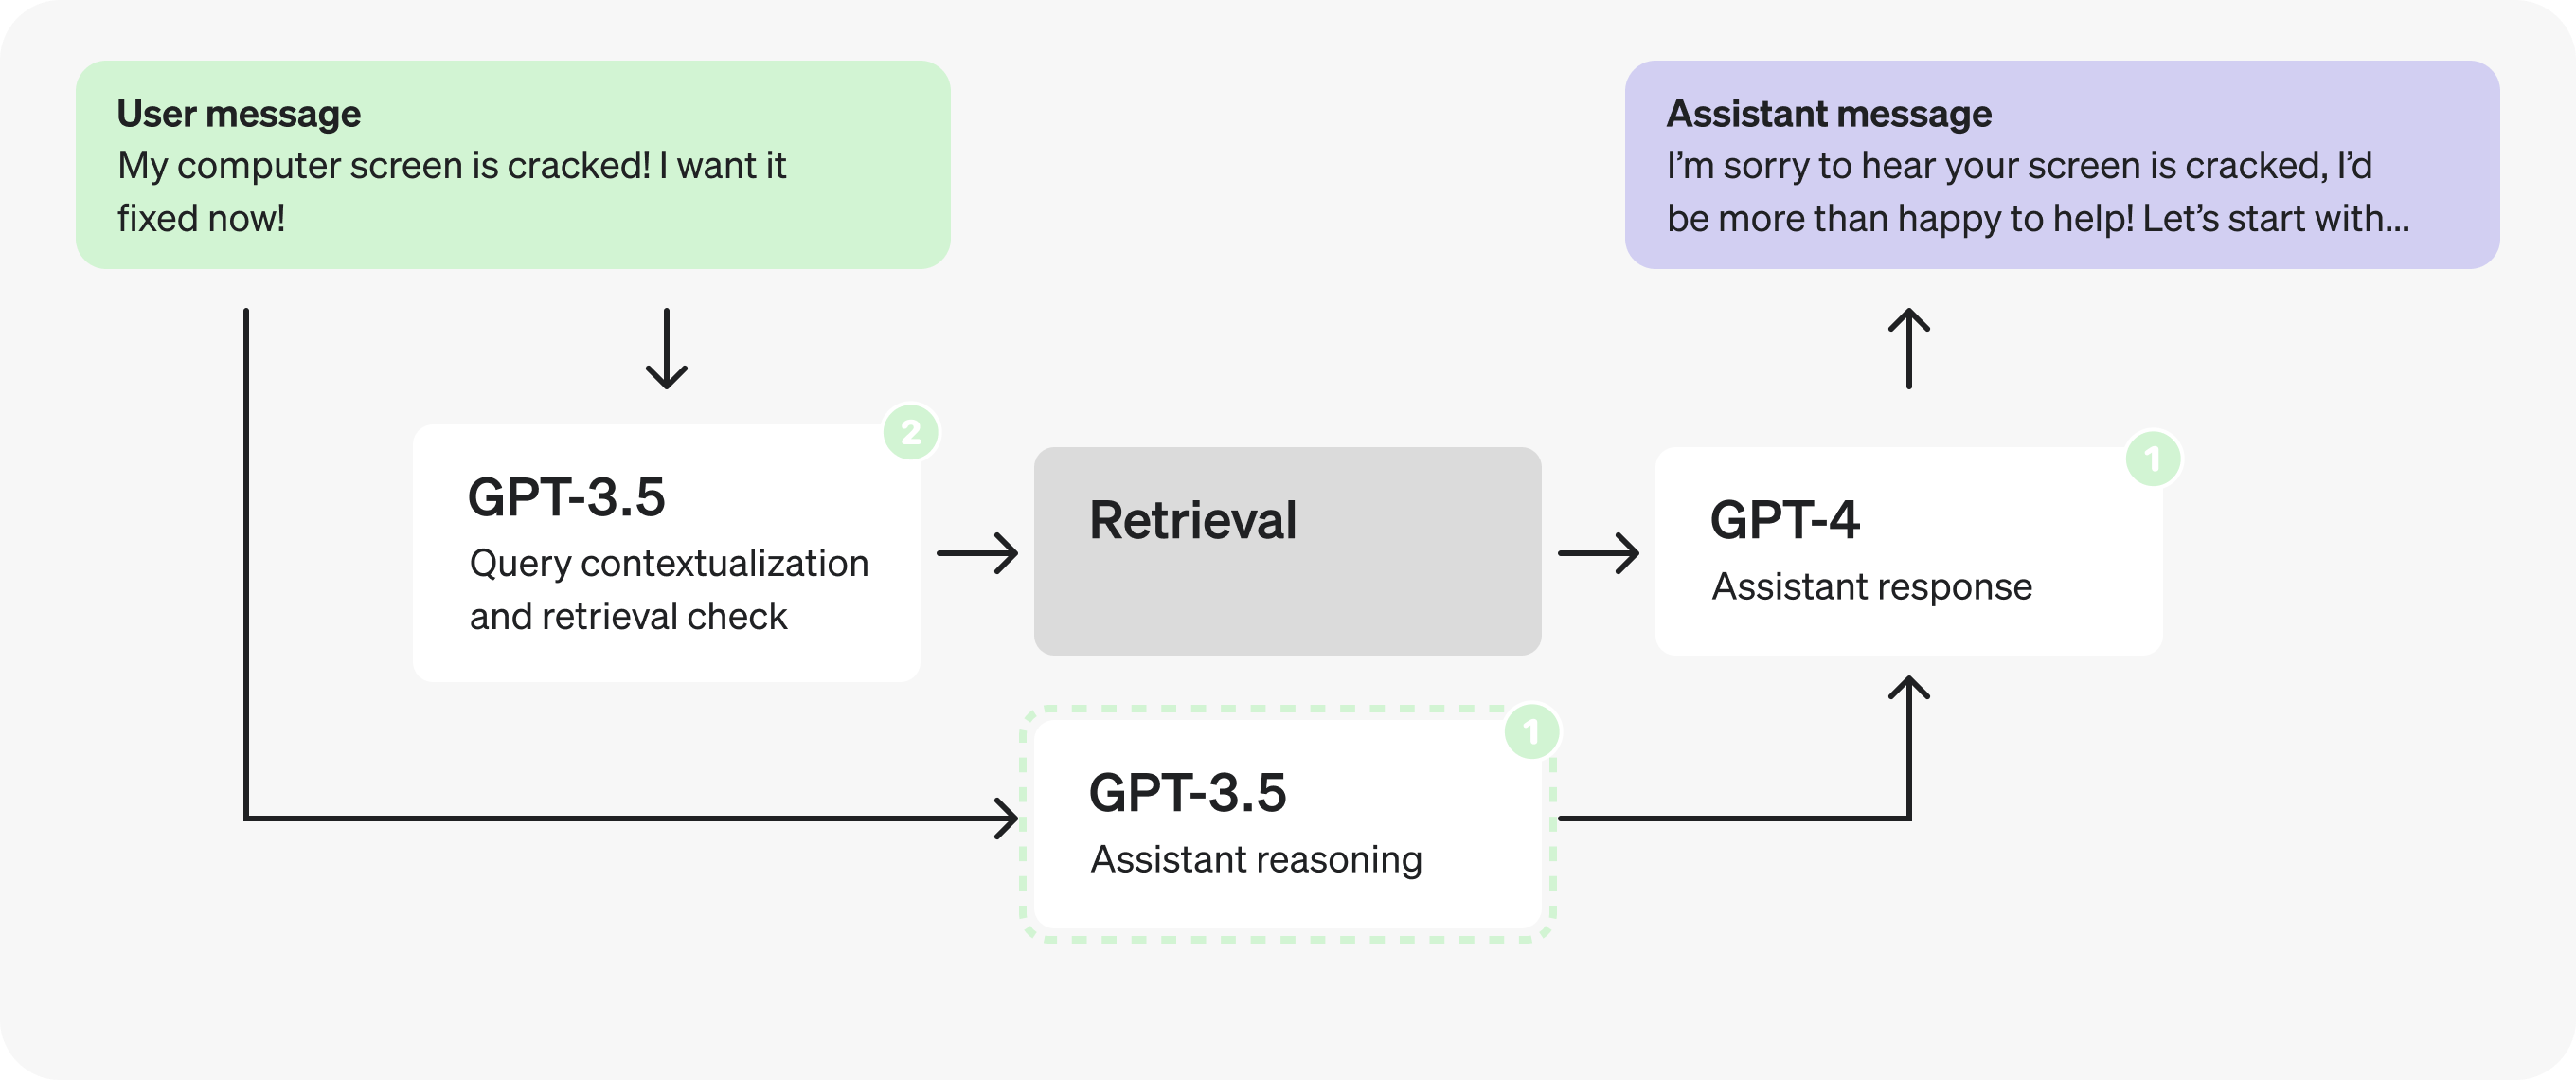
Da der Prompt für die Denkschritte nun nicht mehr vom abgerufenen Kontext abhängt, können wir die Verarbeitung parallelisieren und ihn gleichzeitig mit den Prompts für den Informationsabruf starten.
Teil 3: Die strukturierte Ausgabe optimieren
Sehen wir uns den Prompt für die Denkschritte noch einmal an.
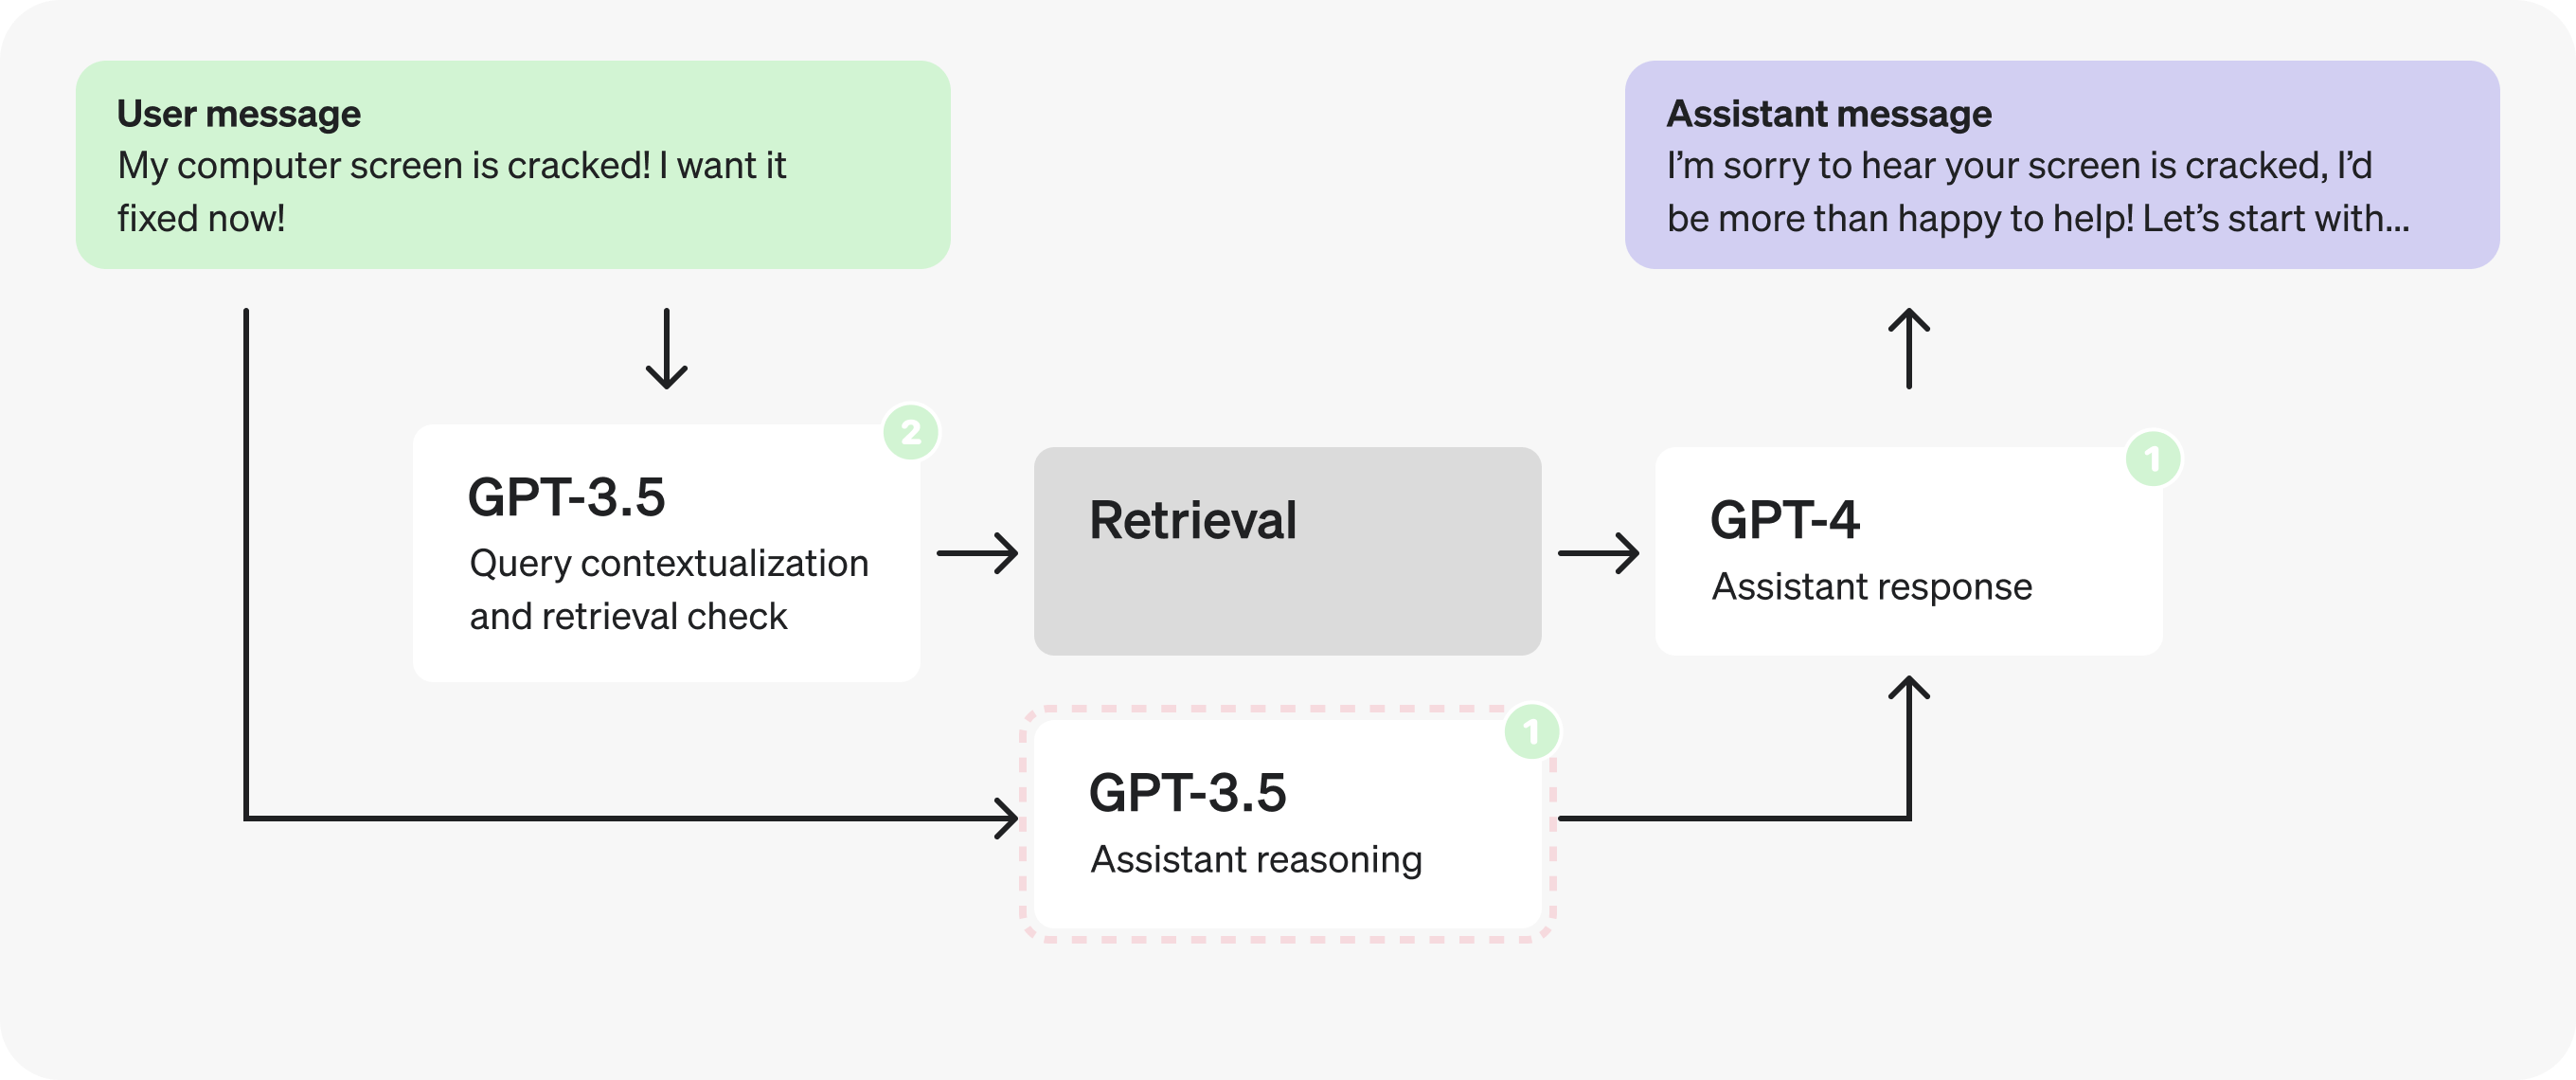
Wenn du dir das JSON-Objekt mit den Denkschritten genauer ansiehst, fällt dir vielleicht auf, dass die Feldnamen selbst recht lang sind.
{
message_is_conversation_continuation: "True", // <-
number_of_messages_in_conversation_so_far: "1", // <-
user_sentiment: "Aggravated", // <-
query_type: "Hardware Issue", // <-
response_tone: "Validating and solution-oriented", // <-
response_requirements: "Propose options for repair or replacement.", // <-
user_requesting_to_talk_to_human: "False", // <-
}Indem wir die Feldnamen kürzen und Erklärungen in die Kommentare verschieben, können wir weniger Token generieren.
{
cont: "True", // whether last message is a continuation
n_msg: "1", // number of messages in the continued conversation
tone_in: "Aggravated", // sentiment of user query
type: "Hardware Issue", // type of the user query
tone_out: "Validating and solution-oriented", // desired tone for response
reqs: "Propose options for repair or replacement.", // response requirements
human: "False", // whether user is expressing want to talk to human
}
Durch diese kleine Änderung wurden 19 Ausgabetoken eingespart. Bei GPT-3.5 bringt das möglicherweise nur wenige Millisekunden, bei GPT-4 könnte es dagegen bis zu einer Sekunde sparen.
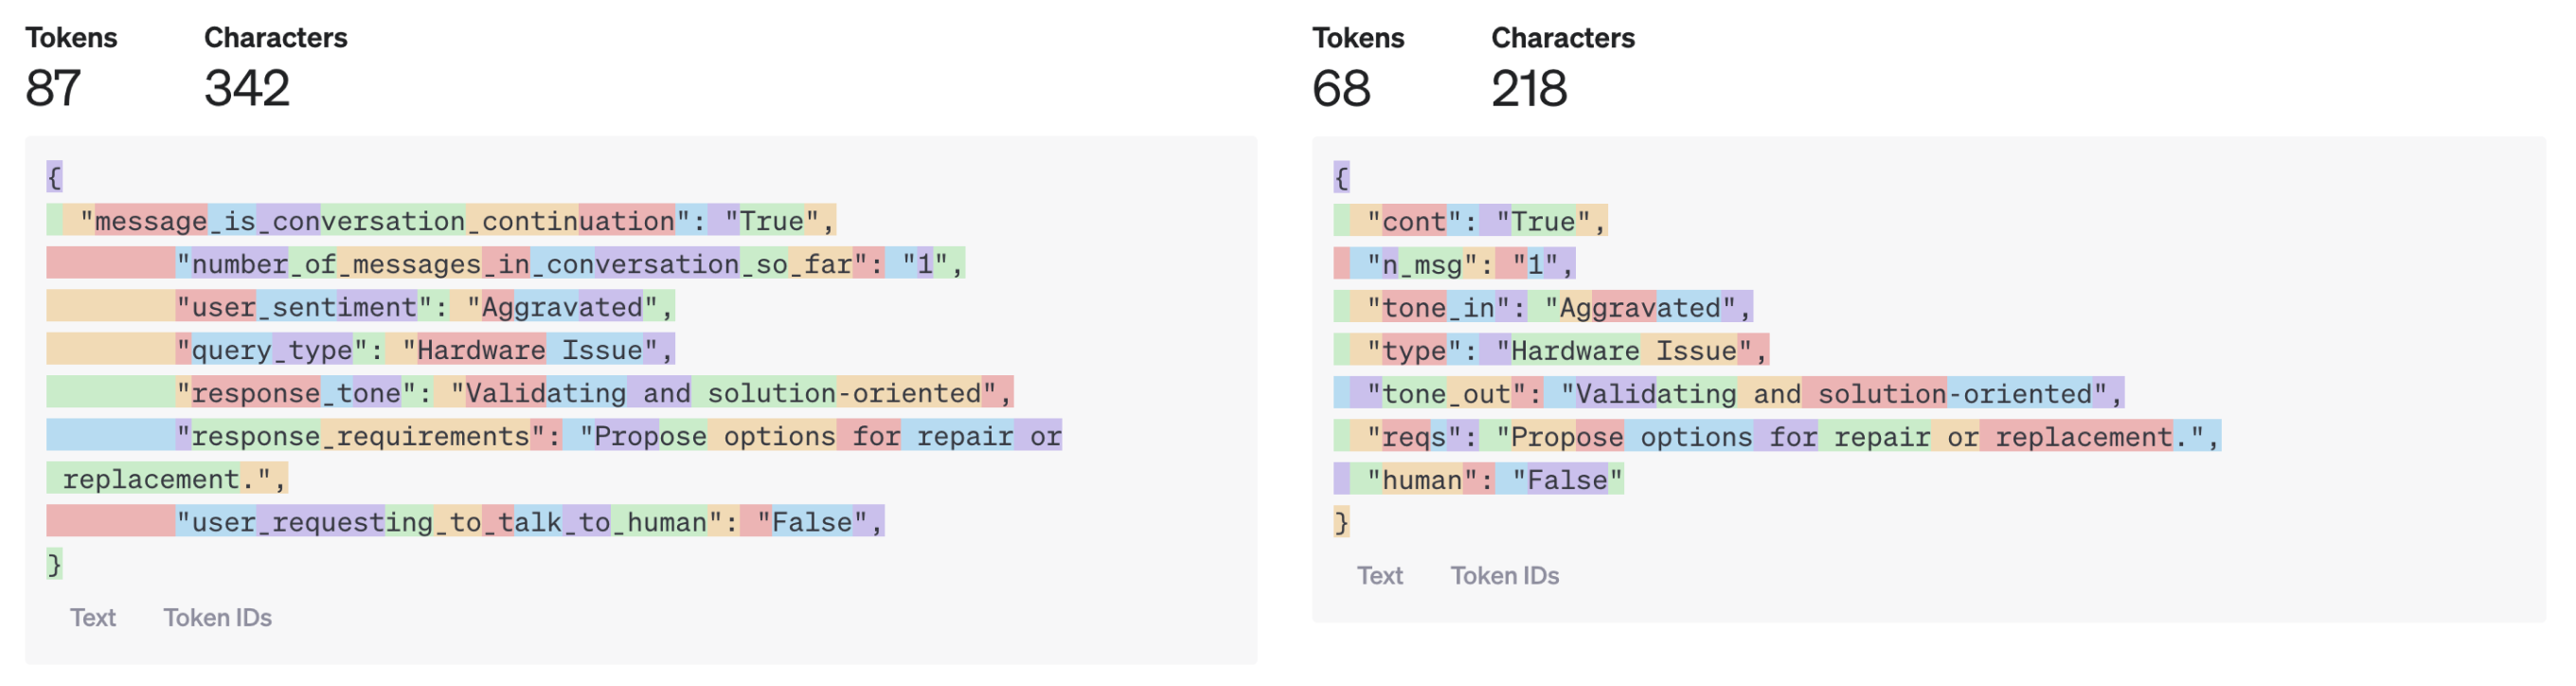
Du kannst dir aber vorstellen, dass dies bei umfangreicheren Modellausgaben deutlich mehr bewirken kann.
Wir könnten noch weiter gehen und einzelne Zeichen als JSON-Feldnamen verwenden oder alles in einem Array zusammenfassen. Das könnte allerdings die Antwortqualität beeinträchtigen. Auch hier lässt sich das am besten durch Tests herausfinden.
Zusammenfassung des Beispiels
Schauen wir uns noch einmal an, welche Optimierungen wir im Beispiel des Kundenservice-Bots umgesetzt haben:
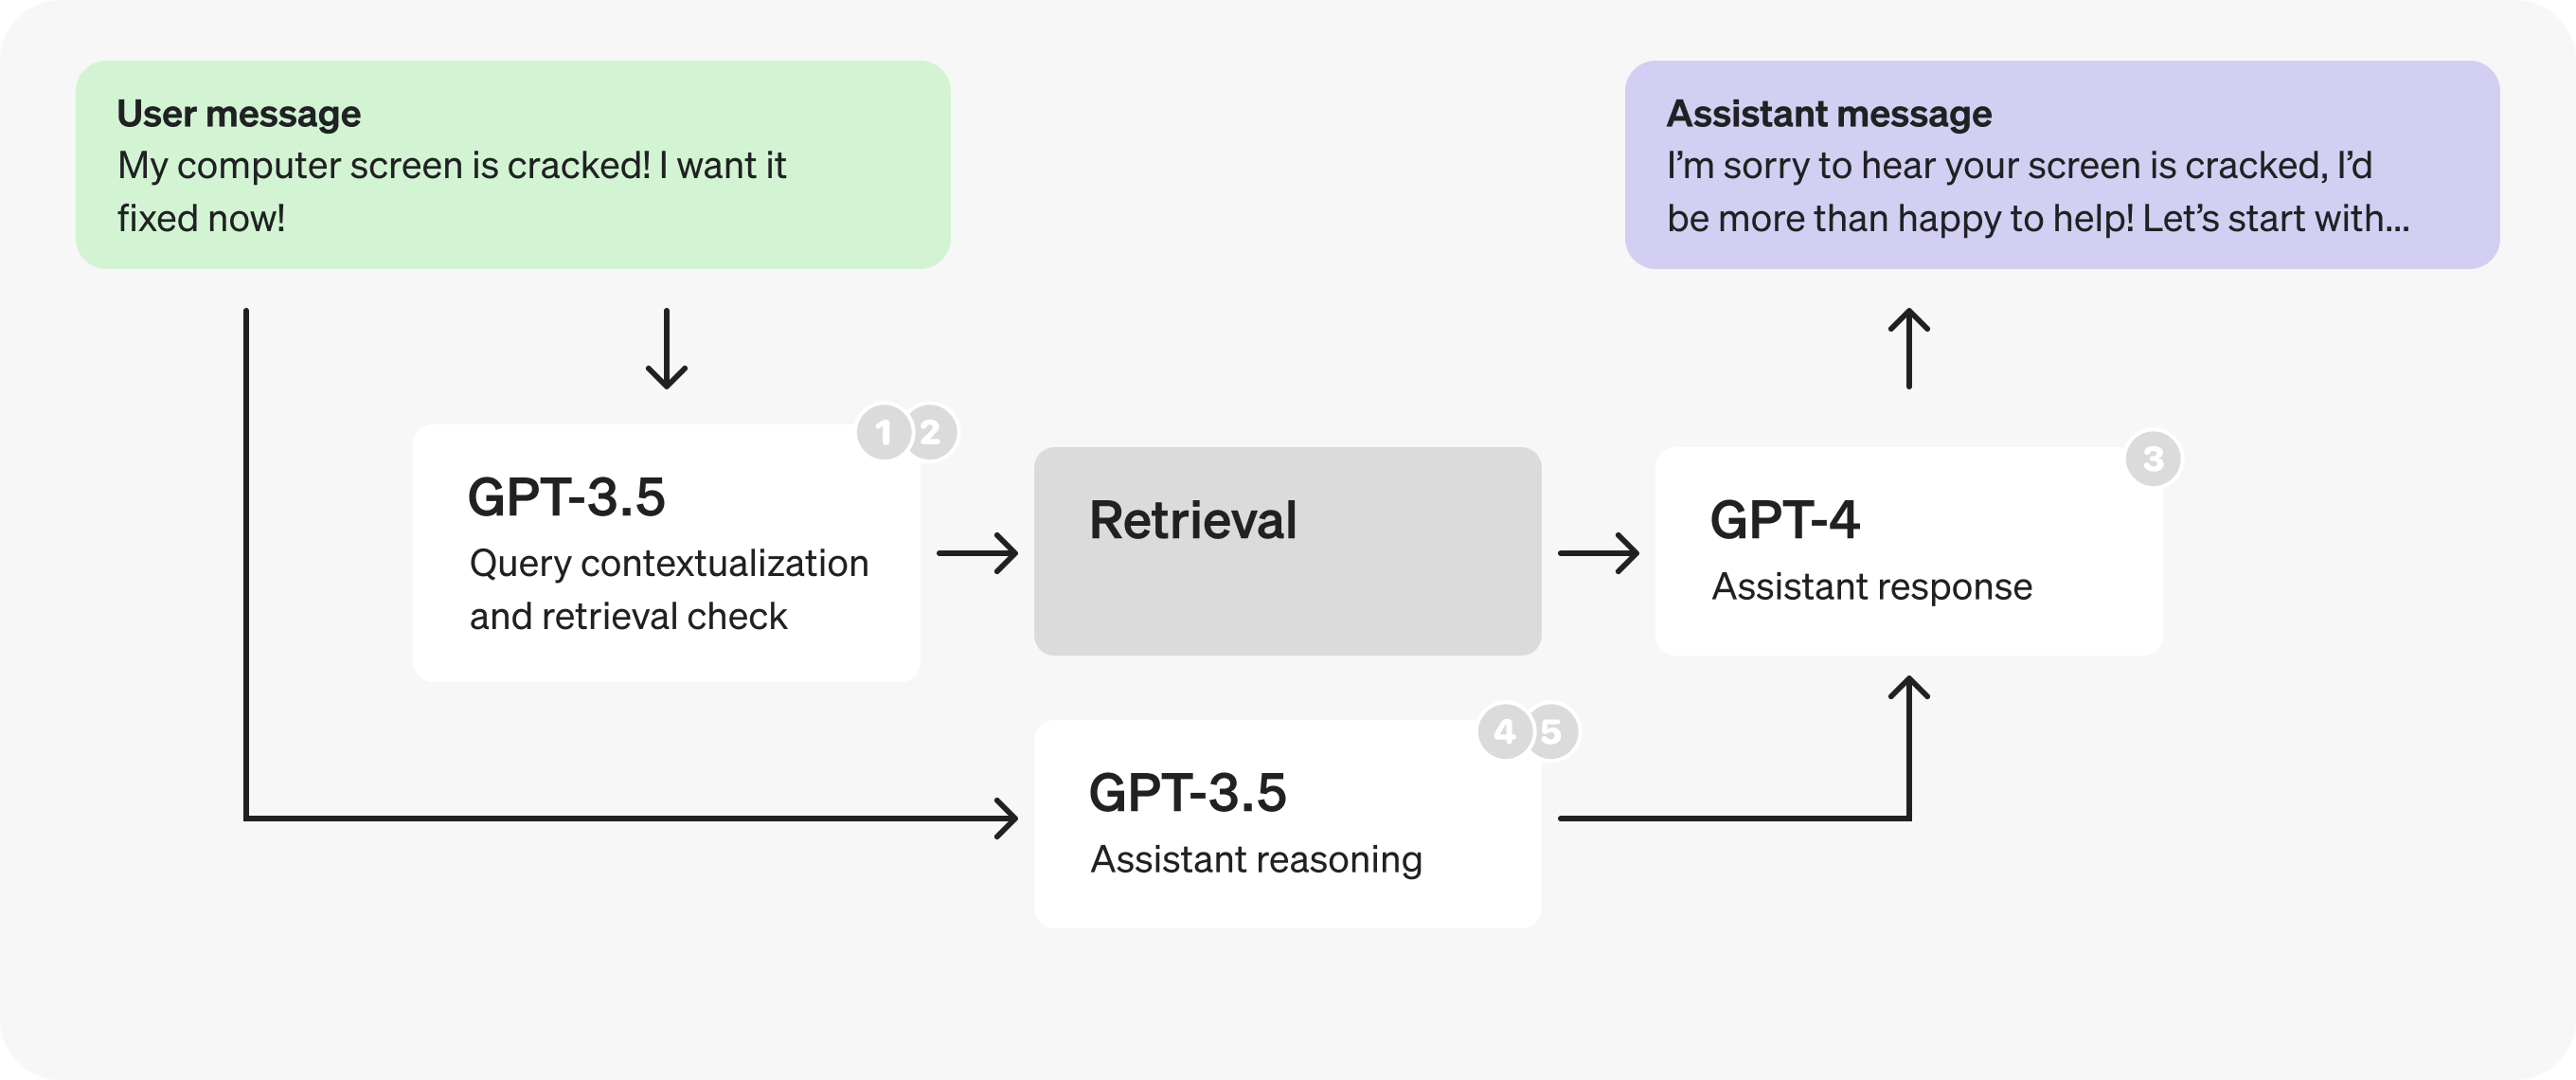
- Wir haben die Kontextualisierung der Anfrage und die Prüfung, ob ein Informationsabruf nötig ist, zusammengefasst , um weniger Anfragen zu stellen.
- Für den neuen Prompt sind wir auf ein kleineres, durch Fine-Tuning angepasstes GPT-3.5 umgestiegen , um Token schneller zu verarbeiten.
- Wir haben den Assistenten-Prompt in zwei Teile aufgeteilt und sind für die Denkschritte auf ein kleineres, durch Fine-Tuning angepasstes GPT-3.5 umgestiegen , ebenfalls um Token schneller zu verarbeiten.
- Wir haben die Prüfungen, ob ein Informationsabruf nötig ist, und die Denkschritte parallelisiert.
- Wir haben die Feldnamen für die Denkschritte gekürzt und Kommentare in den Prompt verschoben, um weniger Token zu generieren.