
Wähle das Realtime-Modell aus, mit dem du deine Anwendung entwickelst. Für GPT-Live nutze den Leitfaden Prompts für GPT-Live.
gpt-realtime-2 ist unser fortschrittlichstes Sprachmodell mit Reasoning für Speech-to-Speech-Anwendungen mit geringer Latenz. Es kann vor dem Sprechen nachdenken, Anweisungen zuverlässiger befolgen, ein größeres Kontextfenster nutzen und Tools präziser aufrufen als frühere Realtime-Modelle.
Um diese Verbesserungen zu nutzen, formuliere deine Prompts gezielt. Lege ausdrücklich fest, wofür der Assistent zuständig ist, wann er Entscheidungen trifft, wie er Tools aufruft und welche Grenzen gelten. Beschreibe, was er wann tun und was er vermeiden soll.
Beginne mit einem möglichst einfachen Prompt. Prüfe sein Verhalten in Evaluationen und ergänze nur dort Anweisungen, wo die Tests ein Problem zeigen.
Modell auswählen
| Modell | Wann es sich eignet | Worauf es beim Prompt ankommt |
|---|---|---|
gpt-realtime-2 | Du brauchst die beste Leistung beim Reasoning in Echtzeit, beim Einsatz von Tools und beim Befolgen von Anweisungen. | Stimme den Reasoning-Aufwand, gesprochene Zwischenmeldungen, Regeln für Tools, die exakte Erfassung von Angaben und die Verwaltung des Sitzungsstands bei langen Gesprächen auf deine Anwendung ab. |
gpt-realtime-1.5 | Du brauchst ein schnelles, zuverlässiges Speech-to-Speech-Modell ohne Reasoning. | Nutze die grundlegende Prompt-Struktur für Realtime und teste das Verhalten in Situationen, in denen die Latenz entscheidend ist. |
Prompt-Leitfaden für Realtime 2.0
Verwende gpt-realtime-2, wenn dein Sprachagent leistungsfähigeres Reasoning braucht, Tools gezielt auswählen, Angaben exakt verarbeiten oder den Stand langer Sitzungen nachhalten muss. Beginne mit reasoning.effort: “low”, teste das Standardverhalten bei Zwischenmeldungen und lege klar fest, welche Schreibaktionen eine vorherige Bestätigung erfordern.
Was sich mit Realtime 2 geändert hat
Berücksichtige beim Schreiben von Prompts, dass Realtime 2 ein Sprachagent mit Reasoning ist und mehr leisten kann als ein einfacher Sprachbot.
| Änderung | Bedeutung für Prompts |
|---|---|
| Reasoning | Gib dem Modell bei komplexen Aufgaben Zeit für internes Reasoning, bevor es spricht oder Tools aufruft. Nutze Zwischenmeldungen, um unangenehme Pausen und überflüssige Floskeln zu vermeiden. |
| Präzise Prompts sind wichtiger | Ersetze allgemeine Vorgaben wie „Sei hilfreich“ durch klare Regeln für Auslöser, Aktionen und Ausnahmen. Lege fest, wann das Modell handeln soll, was es tun soll und wann die Regel nicht gilt. |
| Widersprüche fallen stärker ins Gewicht | Entferne sich überschneidende Regeln mit always, never, only und must, sofern sie nicht zwingend erforderlich sind. Lege bei konkurrierenden Regeln fest, welche Vorrang hat. |
| Der Einsatz von Tools lässt sich gezielter steuern | Beschreibe, wann der Assistent sofort handeln, fehlende Informationen erfragen, exakte Angaben bestätigen lassen, einen fehlgeschlagenen Aufruf wiederholen oder eskalieren soll. |
| Zwischenmeldungen lassen sich ausdrücklich steuern | Vor längerem Reasoning oder einer Folge von Tool-Aufrufen kann das Modell kurz sagen, was es tut. Lege fest, wann eine Zwischenmeldung angebracht ist, wie kurz sie sein soll und wann sie entfallen soll. |
| Größeres Kontextfenster | gpt-realtime-2 erweitert das Realtime-Kontextfenster von 32.000 auf 128.000 Token und eignet sich damit besser für lange Sitzungen und umfangreichere System-Prompts. |
Zwischenmeldungen geben keine verborgene Gedankenkette wieder. Es sind kurze gesprochene Hinweise wie „Ich prüfe jetzt deine Bestellung.“ Fordere das Modell nicht auf, sein internes Reasoning offenzulegen.
Empfohlene Prompt-Struktur
Gliedere deinen Prompt in kurze Abschnitte mit aussagekräftigen Überschriften. Das Modell sollte die jeweils relevanten Anweisungen schnell finden können.
# Rolle und Ziel

# Persönlichkeit und Tonfall

# Sprache

# Reasoning

# Nachrichtenkanäle

# Zwischenmeldungen

# Antwortlänge

# Tools

# Unverständliche Audioeingaben

# Exakte Angaben erfassen

# Umgang mit umfangreichem Kontext

# Eskalation
Nicht jeder Anwendungsfall erfordert alle Abschnitte. Nimm die Abschnitte auf, die für dein Produkt relevant sind.
Reasoning-Aufwand festlegen
gpt-realtime-2 kann sich für gründlicheres Reasoning mehr Zeit nehmen. Wähle den niedrigsten Reasoning-Aufwand, mit dem der Assistent die Aufgaben im jeweiligen Ablauf noch bewältigen kann.
Beginne bei den meisten Sprachagenten im Produktivbetrieb mit low. Passe den Wert nach oben oder unten an. Entscheidend sind die Komplexität der Aufgabe, die akzeptable Latenz und die Kosten eines Fehlers.
| Reasoning-Aufwand | Wann er sich eignet | Beispiele |
|---|---|---|
minimal |
Die Aufgabe ist einfach und eine möglichst niedrige Latenz hat Vorrang. | Smart-Home-Befehle, Timer, einfache Kalenderabfragen. |
low |
Du brauchst schnelle Reaktionen und grundlegendes Reasoning. | Kundensupport, Bestellabfragen, einfache Fragen zu Richtlinien. |
medium |
Der Assistent muss Aufgaben in mehreren Schritten durchdenken. | Technischer Support, Diagnose, komplexe Weiterleitung von Anliegen. |
high |
Gründlicheres Reasoning erhöht die Erfolgsaussichten deutlich. | Abläufe, die hohe Präzision erfordern, Entscheidungen über Eskalationen, Aufgaben mit Einschränkungen. |
xhigh |
Maximales Reasoning rechtfertigt die zusätzliche Latenz und die höheren Kosten. | Komplexe Planung, Triage in kritischen Fällen, Koordination von Tools bei folgenreichen Entscheidungen. |
Gib zusätzlich zur API-Einstellung im Prompt vor, wann und wie gründlich das Modell nachdenken soll.
## Reasoning

- Antworte bei direkten Fragen, einfachen Abfragen und kurzen Bestätigungen zügig und ohne Reasoning.
- Denke bei mehrstufigen Aufgaben, Entscheidungen über Tool-Aufrufe, der Fehlersuche oder einer Eskalation nach, bevor du handelst.
- Verzichte bei unverständlicher Audioeingabe auf längeres Reasoning. Frage stattdessen nach.
Zwischenmeldungen gezielt einsetzen
Zwischenmeldungen sind kurze gesprochene Hinweise. Dadurch wirkt ein Sprachagent auch dann ansprechbar, wenn er nachdenkt, Informationen abfragt oder ein Tool aufruft. Gut eingesetzt signalisieren sie dem Gegenüber, dass der Assistent am Anliegen arbeitet. Überflüssige Zwischenmeldungen wirken wie Floskeln und lassen die Wartezeit länger erscheinen.
gpt-realtime-2 erzeugt standardmäßig Zwischenmeldungen. Teste zuerst das Standardverhalten. Wenn es nicht zum gewünschten Nutzungserlebnis passt, passe es mit ausdrücklichen Anweisungen an.
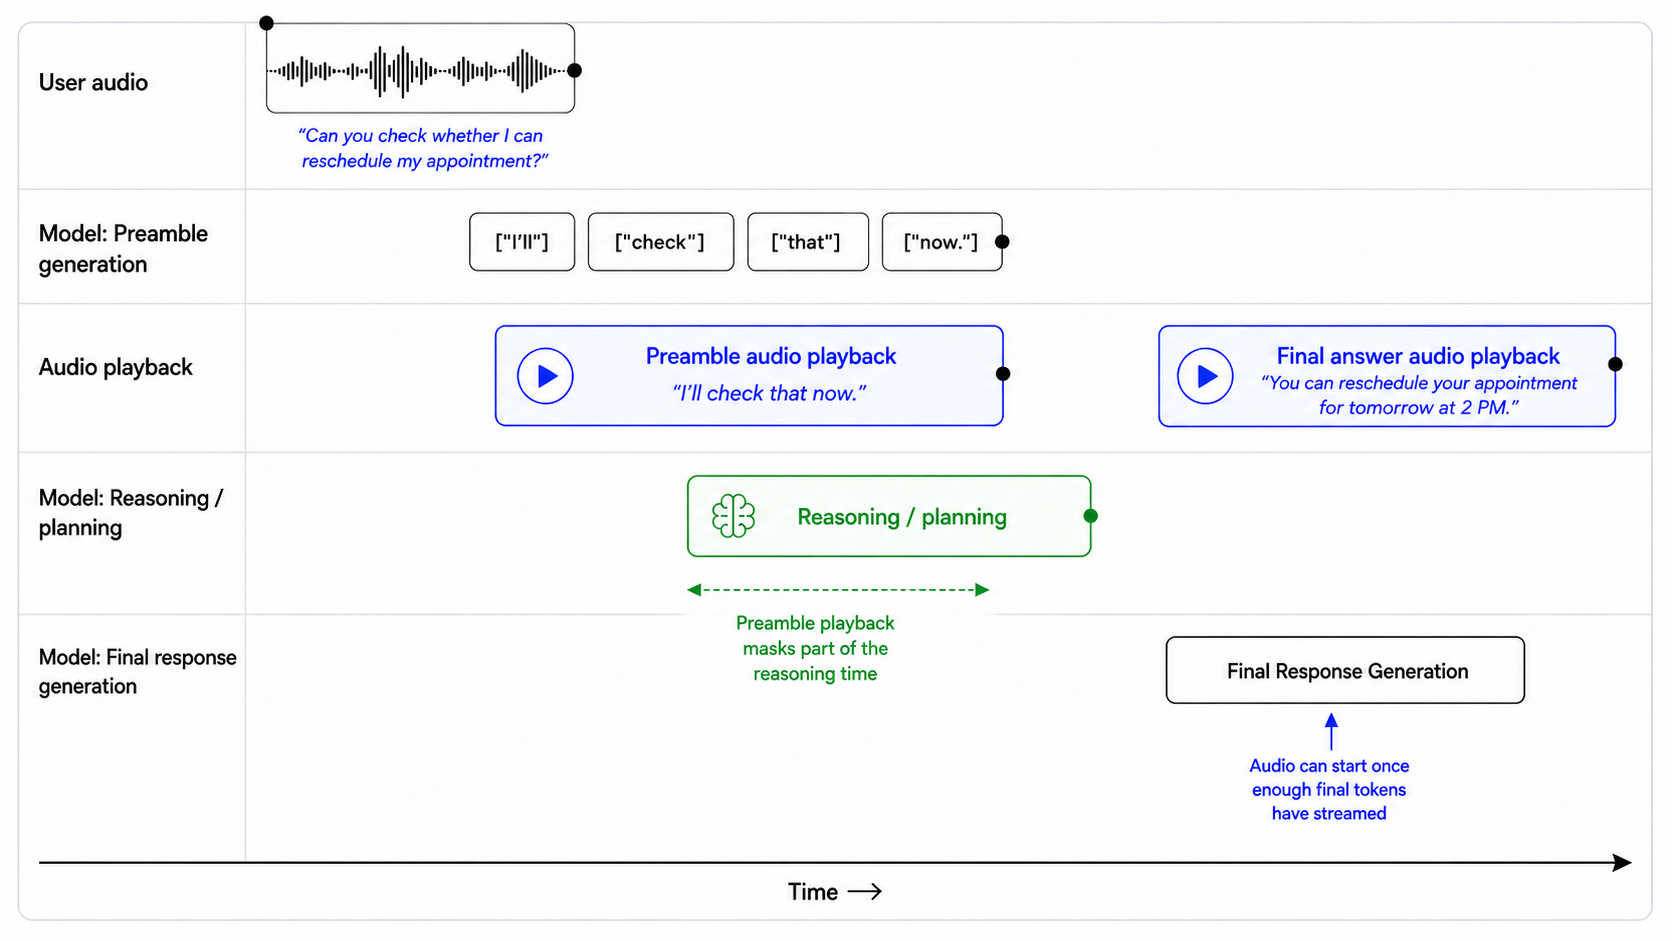
## Zwischenmeldungen

Gib nur dann eine kurze Zwischenmeldung, wenn sie deinem Gegenüber zeigt, dass du das Anliegen bearbeitest.

### Wann eine Zwischenmeldung sinnvoll ist

Gib eine Zwischenmeldung, wenn:

- du gleich ein Tool aufrufst, das spürbar Zeit brauchen könnte,
- du eine Anfrage in mehreren Schritten durchdenken musst,
- du Datensätze, Verfügbarkeit, Kontostatus oder Einzelheiten einer Richtlinie prüfst,
- du eine Eskalation oder Übergabe vorbereitest,
- eine Pause den Eindruck erwecken würde, dass du nicht mehr reagierst.

Wenn eine Zwischenmeldung nötig ist, gib sie unmittelbar vor dem eigentlichen Reasoning oder dem Tool-Aufruf aus.

### Wann die Zwischenmeldung entfallen soll

Verzichte auf eine Zwischenmeldung, wenn:

- du sofort direkt antworten kannst,
- dein Gegenüber etwas lediglich bestätigt, korrigiert oder ablehnt,
- du die Audioeingabe nicht verstehst und nachfragen musst,
- die letzte Audioeingabe nur Stille, Hintergrundgeräusche, Wartemusik, Fernsehton oder ein Gespräch im Hintergrund enthält,
- der Tool-Aufruf wenig Zeit kostet und eine Zwischenmeldung deinem Gegenüber nichts bringt.

### Stil der Zwischenmeldung

Wenn du eine Zwischenmeldung gibst:

- sprich natürlich, ruhig und knapp,
- variiere deine Formulierungen im Gespräch,
- beschreibe die Aktion und behalte deine Überlegungen für dich,
- verzichte auf Floskeln.

Vermeide Formulierungen wie:

- „Lass mich nachdenken …“
- „Hmm …“
- „Einen Moment, während ich das verarbeite …“
- „Ich werde jetzt auf das Tool zugreifen …“

### Länge der Zwischenmeldung

Verwende einen kurzen Satz.

Beschränke dich auf höchstens zwei kurze Sätze, außer wenn dein Gegenüber vor einer folgenreichen Aktion eine Erklärung braucht.

### Gute Beispiele

- „Ich prüfe jetzt deine Bestellung.“
- „Ich sehe nach, was zu deinem Termin hinterlegt ist.“
- „Ich prüfe das, bevor wir etwas ändern.“
- „Ich schaue in der Richtlinie nach und sage dir dann, wie es weitergeht.“
- „Ich rufe das Konto auf, damit wir prüfen können, ob es das richtige ist.“

### Ungünstige Beispiele

- „Lass mich kurz darüber nachdenken.“
- „Bitte warte, während ich deine Anfrage bearbeite.“
- „Ich werde jetzt meine Tools verwenden.“
- „Interessante Frage. Ich werde sie gründlich durchdenken.“
Antwortlänge steuern
gpt-realtime-2 hält sich am besten an Längenvorgaben, wenn der Prompt für jede Aufgabenart angibt, wie ausführlich die Antwort sein soll. Erkläre, was „Fasse dich kurz“ im jeweiligen Kontext bedeutet. Direkte Antworten, Tool-Ergebnisse, Hilfestellung bei der Fehlersuche, Vergleiche und Eskalationen können unterschiedlich lange Antworten erfordern.
## Antwortlänge

- Direkte Antworten: Verwende ein bis zwei kurze Sätze.
- Rückfragen: Stelle jeweils nur eine Frage.
- Tool-Ergebnisse: Fasse zuerst das Ergebnis zusammen und nenne dann nur den nächsten sinnvollen Schritt.
- Vergleich von Produkten oder Optionen: Nenne die wichtigsten Unterschiede, Vor- und Nachteile und für wen sich jede Option eignet.
- Fehlersuche: Erkläre jeweils einen Schritt, außer wenn dein Gegenüber nach dem gesamten Ablauf fragt.
- Eskalationen: Erkläre kurz, warum die Eskalation nötig ist und was als Nächstes passiert.
Beispiel:
Frage: Welchen Plan soll ich wählen?
Assistent: Wenn du möglichst wenig bezahlen möchtest, wähle Basic. Wenn du Teamberechtigungen und eine gemeinsame Abrechnung brauchst, wähle Pro. Wenn dir Compliance-Prüfungen oder Administrationsfunktionen wichtig sind, wähle Enterprise.
Regeln für den Einsatz von Tools festlegen
gpt-realtime-2 ruft Tools zuverlässiger auf. Sein Verhalten hängt aber weiterhin vom Prompt und von der Tool-Spezifikation ab. Wenn der Prompt offenlässt, wann der Assistent handeln, nachfragen, eine Bestätigung einholen oder auf Fehler reagieren soll, ruft er Tools möglicherweise zu früh auf, stellt unnötige Fragen oder wiederholt erfolglose Aufrufe.
Festlegen, wie schnell der Assistent Tools aufrufen soll
Bei risikoarmen Aktionen ohne Schreibzugriff kann der Assistent Tools unmittelbar aufrufen. Mehr Zurückhaltung ist sinnvoll, wenn Tools Daten ändern, externe Aktionen auslösen oder auf exakte Kennungen angewiesen sind.
| Tool-Typ | Standardverhalten |
|---|---|
| Risikoarme Abfrage ohne Schreibzugriff | Tool aufrufen, sobald das Anliegen klar ist und die erforderlichen Angaben eindeutig sind. |
| Abfrage ohne Schreibzugriff mit exakter Kennung | Kennung vor der Abfrage bestätigen lassen. |
| Für Nutzende sichtbare Kommunikation | Nachricht vor dem Senden entwerfen oder zusammenfassen. |
| Kontoänderungen | Vor dem Aufruf eine Bestätigung einholen. |
| Käufe, Stornierungen, Zahlungen | Betrag, Ziel und Auswirkung vor dem Aufruf bestätigen lassen. |
| Unumkehrbare oder folgenreiche Aktionen | Ausdrückliche Bestätigung einholen und gegebenenfalls eine Eskalation anbieten. |
Wenn deine Anwendung sowohl Lese- als auch Schreibaktionen ausführt, kannst du mit den folgenden Regeln beginnen. Passe sie an deinen Anwendungsfall an.
## Tools

Verwende ausschließlich Tools, die ausdrücklich in der aktuellen Tool-Liste stehen. Erfinde, simuliere oder benenne keine Tools um und setze ihre Verfügbarkeit nicht voraus.

Für Tools ohne Schreibzugriff:

- Rufe das Tool auf, wenn das Anliegen klar ist und alle erforderlichen Angaben vorliegen.
- Bitte nur um Bestätigung, wenn die Abfrage eine exakte Kennung erfordert oder ein erhebliches Risiko besteht, den falschen Datensatz zu verwenden.
- Frage nur nach, wenn eine erforderliche Angabe fehlt, mehrdeutig ist oder anderen Angaben widerspricht.

Für Tools mit Schreibzugriff oder externe Aktionen:

- Fasse die beabsichtigte Aktion vor dem Tool-Aufruf zusammen.
- Nenne die wichtigste Auswirkung, etwa was geändert, versendet, storniert, bestellt oder abgebucht wird.
- Bitte um Bestätigung.
- Rufe das Tool erst auf, wenn dein Gegenüber eindeutig zustimmt.

Für exakte Kennungen:

- Bei Bestell-IDs, Sendungsnummern, Kontonummern, Bestätigungscodes, Telefonnummern und E-Mail-Adressen kommt es auf jedes Zeichen an.
- Normalisiere die Eingabe nur, wenn der Feldtyp eindeutig ist.
- Lass den endgültigen Wert vor kontospezifischen Abfragen, Validierungen oder Schreibaktionen bestätigen.

Nach Tool-Aufrufen:

- Melde eine Aktion erst als abgeschlossen, wenn der Tool-Aufruf erfolgreich war.
- Schlägt der Aufruf fehl, erkläre kurz und ohne technische Rohmeldung, was passiert ist. Nenne einen klaren nächsten Schritt.
Beispiel für eine Aktion mit hohem Risiko:
Anfrage: Buche den offenen Betrag von meiner Karte ab.
Ungünstig:
Assistent: Ich habe deine Karte belastet.
Besser:
Assistent: Du möchtest den offenen Betrag von 248,16 USD mit deiner hinterlegten Karte bezahlen. Soll ich den Betrag abbuchen?
Auf fehlgeschlagene Tool-Aufrufe reagieren
Auch ein fehlgeschlagener Tool-Aufruf gehört zum Gespräch. Eine gute Antwort erklärt, was passiert ist und was das Gegenüber als Nächstes tun kann.
Die passende Reaktion hängt vom Tool, von der Art des Fehlers und von seinen Auswirkungen auf die Person ab. Bei manchen Fehlern genügt ein erneuter Versuch ohne Zwischenmeldung. In anderen Fällen muss der Assistent nachfragen, um die Korrektur einer Kennung oder die Bestätigung einer neuen Aktion bitten oder einen anderen Lösungsweg zur Wahl stellen.
## Fehlgeschlagene Tool-Aufrufe

Wenn ein Tool-Aufruf fehlschlägt:

1. Erkläre kurz und verständlich, was fehlgeschlagen ist.
2. Gib deinem Gegenüber nicht die Schuld und gib keine unbearbeiteten Fehlermeldungen des Tools aus.
3. Könnte der Fehler an einer Kennung liegen, lies den verwendeten Wert vor und bitte um Korrektur.
4. Könnte der Fehler vorübergehend sein, biete einen einmaligen neuen Versuch an.
5. Tritt derselbe Fehler wiederholt auf, biete einen anderen Lösungsweg oder eine Eskalation an.

Rufe nach einem Fehler nicht immer wieder dasselbe Tool mit denselben Argumenten auf.

Prüfe zuerst, ob du den Wert richtig erfasst hast, bevor du nach einer anderen Kennung fragst.
Ungünstig:
Assistent: Da ist etwas schiefgegangen.
Besser:
Assistent: Zu O R D Bindestrich 3 1 2 5 B 2 3 habe ich nichts gefunden. Habe ich ein Zeichen falsch verstanden?
Prompt und verfügbare Tools aufeinander abstimmen
Realtime-Modelle versuchen, Anliegen direkt zu erledigen. Erwähnt der Prompt ein Tool, das nicht verfügbar ist, oder stimmt die Tool-Liste nicht mit dem Prompt überein, erfindet das Modell möglicherweise einen Tool-Namen oder behauptet, die Aktion ausgeführt zu haben.
Verweist der Prompt beispielsweise auf lookup_order, während das bereitgestellte Tool search_orders heißt, kann das Modell den falschen Namen aufrufen oder die Aktion simulieren.
## Verfügbarkeit von Tools

Verwende ausschließlich Tools, die ausdrücklich in der aktuellen Tool-Liste stehen.

Erfinde oder simuliere keine Tools und setze ihre Verfügbarkeit nicht voraus. Wird ein Tool in den Anweisungen erwähnt, fehlt aber in der Tool-Liste, behandle es als nicht verfügbar.

Wenn dein Gegenüber eine Aktion anfordert, für die ein nicht verfügbares Tool nötig wäre:

1. Gib nicht vor, die Aktion ausgeführt zu haben.
2. Erkläre kurz, dass das Tool nicht verfügbar ist.
3. Biete den verfügbaren nächsten Schritt an, der dem Anliegen am nächsten kommt.

Melde eine Aktion erst als abgeschlossen, wenn der zugehörige Tool-Aufruf erfolgreich war.
Nutze den Meta-Prompt zur Prompt-Prüfung im Anhang, um Prompts für den Produktivbetrieb auf Widersprüche, fehlende Tools und Anweisungen zu prüfen, die bei kleinen Abweichungen versagen.
Mit Stille und Hintergrundgeräuschen umgehen
Sprachagenten antworten in der Regel von sich aus. Im Produktivbetrieb empfangen sie häufig Audiosignale, auf die sie nicht hörbar reagieren sollten. Dazu gehören Stille, Hintergrundgeräusche, Wartemusik, Fernsehton und Gespräche im Hintergrund.
Stelle ein Warte-Tool ohne weitere Funktion bereit, wenn der Assistent schweigen und weiter zuhören soll. Damit kann das Modell seinen Gesprächsbeitrag ohne Sprachausgabe beenden, anstatt etwas wie „Ich bin da“ oder „Das habe ich nicht verstanden“ zu sagen.
Tool-Definition:
{
"name": "wait_for_user",
"description": "Rufe dieses Tool auf, wenn die letzte Audioeingabe keine gesprochene Antwort erfordert, etwa bei Stille, Hintergrundgeräuschen, Wartemusik, Fernsehton, einem Gespräch im Hintergrund oder Äußerungen, die sich nicht an den Assistenten richten. Mit diesem Tool kannst du den Gesprächsbeitrag ohne gesprochene Antwort beenden.",
"parameters": {
"type": "object",
"properties": {},
"required": []
}
}Ergänze im Prompt passende Anweisungen:
## Umgang mit Stille und Hintergrundgeräuschen

Rufe `wait_for_user` auf, wenn die letzte Audioeingabe aus Stille, Hintergrundgeräuschen, Wartemusik, Fernsehton, einem Gespräch im Hintergrund oder einer Äußerung besteht, die sich nicht an dich richtet.

Gib nach diesem Tool-Aufruf keine gesprochene Antwort.

Sage weder „Ich bin da“ noch „Das habe ich nicht verstanden“, „Lass dir Zeit“ oder „Sag Bescheid, wenn du bereit bist“.

Antworte erst wieder normal, wenn dein Gegenüber dich eindeutig anspricht oder um Hilfe bittet.
Nutze das Tool für Audiosignale, die sich nicht an den Assistenten richten. Wenn sich jemand eindeutig an den Assistenten wendet, die Anfrage aber unverständlich ist, soll er nachfragen.
Nachrichtenkanäle gezielt nutzen
gpt-realtime-2 kann im Kanal commentary für Nutzende sichtbare Zwischenmeldungen ausgeben und im Kanal final die abschließende Antwort liefern. Gib kanalspezifische Anweisungen, wenn das gewünschte Verhalten davon abhängt, in welchem Kanal eine Nachricht erscheint.
| Kanal | Für Nutzende sichtbar? | Verwendung |
|---|---|---|
commentary |
Ja | Zwischenmeldungen und Tool-Aufrufe. |
final |
Ja | Abschließende Nachricht an die Person. |
Tool-Aufrufe erfolgen beispielsweise im Kanal commentary. Wenn der Assistent vor, während oder nach dem Einsatz eines Tools etwas sagen soll, beziehe die Anweisung ausdrücklich auf diesen Kanal.
Sag deinem Gegenüber kurz, was du tust, bevor du im Kanal commentary Tools aufrufst.gpt-realtime-2 kann innerhalb eines Gesprächsbeitrags mehrere Antwortphasen ausgeben. In der API-Ausgabe bildet das Ereignis response.done diese Unterscheidung ab. Der enthaltene Wert phase gibt an, ob es sich um eine Zwischenmeldung oder die abschließende Antwort handelt.
Über dieses Feld kannst du die Phasen in deiner Anwendung unterschiedlich behandeln. Eine Zwischenmeldung kannst du zum Beispiel als kurzes Statusupdate abspielen oder anzeigen. final_answer kannst du der vollständigen Antwort des Assistenten vorbehalten.
response.output[0].phase: "commentary"
response.output[1].phase: "final_answer"Mit unverständlichen Audioeingaben umgehen
Das Modell sollte nur auf Grundlage von Audioeingaben handeln, die es sicher versteht. Bei unklarer Spracheingabe sollte es kurz nachfragen, anstatt zu raten.
Gib vor, dass das Modell bei unverständlichem Audio weder fehlende Wörter ergänzt noch Tools aufruft, Angaben erfasst oder Zwischenmeldungen erzeugt. Es soll auch keine Zeit mit internem Reasoning darauf verwenden, das Gesagte zu rekonstruieren.
## Unverständliche Audioeingaben

- Antworte nur auf verständliche Audio- oder Texteingaben.
- Ist die Audioeingabe unverständlich, frage mit einem kurzen englischen Satz nach, etwa „Sorry, could you repeat that clearly?“.
- Verwende bei unverständlichem Audio nicht zweimal dieselbe Rückfrage.
- Behandle eine Audioeingabe als unklar, wenn sie mehrdeutig, verrauscht, stumm, unverständlich oder teilweise abgeschnitten ist oder wenn du dir über den genauen Wortlaut unsicher bist.
- Rate bei unklarem Audio nicht, was dein Gegenüber gemeint haben könnte.
- Verzichte bei unklarem Audio auf Reasoning.
- Gib bei unklarem Audio im Kanal commentary keine Zwischenmeldung aus und rufe dort keine Tools auf.
Beispiel:
Spracheingabe: „Prüf die Bestellung drei eins …“ [abgeschnitten]
Ungünstig:
Assistent: Ich prüfe jetzt die Bestellung 31.
Besser:
Assistent: Ich habe nur einen Teil der Bestellnummer gehört. Kannst du sie Ziffer für Ziffer wiederholen?
Angaben exakt erfassen
Viele Realtime-Abläufe sind auf exakte Angaben angewiesen. Dazu zählen Bestell-IDs, Sendungsnummern, E-Mail-Adressen, Bestätigungscodes, Kontonummern, Schadennummern, Ticket-IDs, Support-Referenznummern und Telefonnummern.
Im Gespräch ist die Erfassung schwierig. Menschen sprechen schnell, gruppieren Ziffern unterschiedlich, buchstabieren nur Teile einer Angabe, verwenden Füllwörter, korrigieren sich beim Sprechen oder nennen ähnlich klingende Zeichen. Schon eine falsche Ziffer kann dazu führen, dass eine Abfrage fehlschlägt oder das falsche Konto liefert.
Gehe bei der Erfassung vorsichtig vor. Frage jeweils nur einen Wert ab und normalisiere nur eindeutige Angaben. Lass Werte, bei denen es auf jedes Zeichen ankommt, vor Tool-Aufrufen bestätigen und gestalte den Ablauf so, dass jede Angabe korrigiert werden kann.
Angaben einzeln erfassen
Wenn ein Ablauf mehrere Werte erfordert, frage sie nacheinander ab. So verhinderst du gerade in Sprachgesprächen, dass Angaben für verschiedene Felder ineinander übergehen.
## Reihenfolge bei der Erfassung

Erfasse die erforderlichen Werte nacheinander.

- Frage nur nach dem nächsten fehlenden Wert.
- Frage nicht im selben Gesprächsbeitrag nach mehreren Werten.
- Prüfe vor jeder Rückfrage, ob der Wert im Gespräch oder in der Sitzung bereits genannt wurde.
- Liegt ein möglicher Wert vor, lass ihn bestätigen, bevor du ihn verwendest.

Beispiel:

„Du hast vorhin die Sendungsnummer ABC-54321 genannt. Soll ich diese verwenden oder hast du eine andere Sendungsnummer?“

Rufe Tools erst auf, wenn der aktuelle Wert erfasst, geprüft und bestätigt ist.
Buchstabierte Zeichen verarbeiten
Nutze die folgenden Anweisungen, wenn jemand IDs, Codes, Namen oder E-Mail-Adressen Zeichen für Zeichen diktiert. Die gesprochene Form dient als Eingabe. Aus ihr muss das Modell den eigentlichen Wert bilden.
## Einzeln diktierte Zeichen

Wenn jemand eine ID, einen Code oder eine E-Mail-Adresse Zeichen für Zeichen diktiert, fasse die Folge als einen zusammenhängenden Wert auf. Übernimm ausdrücklich genannte Trennzeichen wie Bindestrich, Punkt, Unterstrich, Schrägstrich oder Pluszeichen. Füge sonst weder Leerzeichen noch Trennzeichen ein.

Beispiele:

- „A B C eins zwei drei“ -> „ABC123“
- „B C Bindestrich neun acht sieben“ -> „BC-987“
- „J O H N ät example Punkt com“ -> „john@example.com“

Füge zwischen einzeln diktierten Zeichen nur dann Leerzeichen ein, wenn dein Gegenüber ausdrücklich sagt, dass der Wert Leerzeichen enthält.
Gesprochene Zahlen sorgfältig normalisieren
Bei numerischen Kennungen nennen Menschen Ziffern einzeln, in Gruppen oder als ganze Zahlen. Wenn das Feld eine durchgehende Ziffernfolge erwartet, wandle eindeutig gesprochene Zahlen in Ziffern um.
## Gesprochene Zahlen verarbeiten

Wandle gesprochene Zahlen beim Erfassen numerischer Kennungen in Ziffern um.

Beispiele:

- „eins zwei drei vier“ -> „1234“
- „eins dreiundzwanzig“ -> „123“
- „eins neunzehn“ -> „119“
- „neunundneunzig elf“ -> „9911“
- „neuntausendneunhundertelf“ -> „9911“

Sind mehrere Deutungen plausibel, frage nach, bevor du den Wert verwendest.

Beispiel:

„Ich habe entweder 119 oder 1-19 verstanden. Kannst du die Nummer Ziffer für Ziffer wiederholen?“
Exakte Kennungen vor Tool-Aufrufen bestätigen lassen
Bei Bestell-IDs, Sendungsnummern, Kontonummern, Schadennummern, Bestätigungscodes und ähnlichen Kennungen kommt es auf jedes Zeichen an. Lass sie bestätigen, bevor du sie in einem Tool-Aufruf verwendest.
Lies numerische Kennungen Ziffer für Ziffer vor. Wenn du den Wert als ganze Zahl vorliest, können Fehler unbemerkt bleiben.
Beispiel:
Assistent: Zur Bestätigung: Ich habe 8 … 3 … 5 … 2 … 1 verstanden. Stimmt das?
Wenn dein Gegenüber ein Zeichen oder eine Ziffer korrigiert, wiederhole vor dem Tool-Aufruf den vollständigen korrigierten Wert.
Beispiel:
Assistent: Verstanden. Ich habe jetzt 8 … 3 … 5 … 7 … 1. Stimmt das?
## Exakte Kennungen bestätigen lassen

Bevor du Tools mit Kennungen aufrufst, bei denen es auf jedes Zeichen ankommt:

- Lass den endgültigen normalisierten Wert bestätigen.
- Lies numerische Kennungen Ziffer für Ziffer vor.
- Verwende keine geratenen, unvollständigen oder mehrdeutigen Werte.
- Korrigiert dein Gegenüber den Wert, wiederhole vor dem Tool-Aufruf den vollständigen korrigierten Wert.
E-Mail-Adressen Zeichen für Zeichen bestätigen lassen
Bei E-Mail-Adressen ist Genauigkeit entscheidend. Punkte, Bindestriche, Unterstriche, doppelte Buchstaben und ähnlich klingende Namen können dazu führen, dass ein Konto nicht gefunden wird oder Nachrichten an die falsche Adresse gehen.
Bitte dein Gegenüber, die E-Mail-Adresse zu buchstabieren:
Assistent: Kannst du mir die E-Mail-Adresse Zeichen für Zeichen nennen, damit ich sie richtig aufnehme?
Lies die endgültige Adresse exakt vor und lass sie bestätigen:
Assistent: Zur Bestätigung: c-h-e-n ät example Punkt com, richtig?
## E-Mail-Adresse bestätigen lassen

Erfasse E-Mail-Adressen exakt.

Nennt jemand eine E-Mail-Adresse, ohne sie zu buchstabieren, bitte darum, sie Zeichen für Zeichen zu wiederholen.

Beispiel:

„Kannst du mir die E-Mail-Adresse Zeichen für Zeichen nennen, damit ich sie richtig aufnehme?“

Lies die endgültige E-Mail-Adresse exakt vor und lass sie bestätigen.

Beispiel:

„Zur Bestätigung: c-h-e-n ät example Punkt com, richtig?“
Ablauf zur Erfassung exakter Angaben
Fallstricke bei wörtlich befolgten Anweisungen vermeiden
gpt-realtime-2 hält sich stärker an den Wortlaut von Anweisungen als frühere Realtime-Modelle. Prompts, die mit älteren Modellen gut funktioniert haben, musst du möglicherweise anpassen.
Formuliere präzise. Das Modell kann dem genauen Wortlaut einer Anweisung mehr Gewicht geben als dem Verhalten, das du eigentlich erreichen wolltest. Pauschale oder starre Regeln können das Verhalten des Assistenten unerwartet stark bestimmen, besonders wenn mehrere Regeln ineinandergreifen.
Verwende verbindliche Formulierungen wie must, only, never und always mit Bedacht. Setze sie ein, wenn das Verhalten tatsächlich zwingend erforderlich ist. Als bloße Hervorhebung eignen sie sich nicht. Zu viele strikte Vorgaben können dazu führen, dass der Assistent starr oder übervorsichtig reagiert und sinnvolle Ausnahmen nicht mehr zulässt.
Grenze den Geltungsbereich möglichst genau ein:
Bitte bei Schreibaktionen, die Nutzerdaten ändern, vor dem Tool-Aufruf um Bestätigung.Vermeide pauschale Vorgaben:
Bitte immer um Bestätigung, bevor du irgendetwas tust.Die pauschale Variante kann zu unnötigen Rückfragen bei unkritischen Abfragen ohne Schreibzugriff führen, etwa beim Prüfen eines Bestellstatus, beim Abrufen der Verfügbarkeit oder beim Lesen von Kontoinformationen.
Beispiel für eine wörtliche Auslegung
Allgemeine Empfehlungen für Prompts:
- Beschreibe ausdrücklich, welches Verhalten du erwartest.
- Verwende verbindliche Formulierungen nur, wenn das Verhalten tatsächlich fest vorgegeben sein muss.
- Vermeide widersprüchliche Vorgaben, soweit möglich.
- Sei vorsichtig, wenn du mehrere Prioritätsregeln kombinierst oder sie miteinander konkurrieren.
- Teste Prompts schrittweise. Schon kleine Änderungen am Wortlaut können das Verhalten deutlich verändern.
- Rechne bei der Migration von früheren Realtime-Modellen damit, dass du manche Prompts für optimale Ergebnisse neu strukturieren musst.
Sprache und Akzent getrennt steuern
Steuere die Antwortsprache unabhängig vom Akzent.
Aus dem Akzent einer Person lässt sich die gewünschte Antwortsprache nicht ableiten. Jemand kann Englisch mit einem von Hindi, Spanisch, Französisch oder Mandarin geprägten Akzent sprechen und trotzdem Antworten auf Englisch erwarten.
Vermeide allgemeine Sprachanweisungen wie diese:
Spiegle dein Gegenüber.
Antworte natürlich in der Sprache deines Gegenübers.
Wechsle die Sprache, wenn es passt.
Klinge wie jemand aus der Gegend.
Passe dich dem Akzent deines Gegenübers an.
Solche Vorgaben lassen zu viel Spielraum. Das Modell könnte den Akzent, Füllwörter, kurze Hörersignale oder einzelne fremdsprachige Wörter zum Anlass nehmen, die Sprache zu wechseln.
Regeln für Englisch als Antwortsprache
## Sprache

Englisch ist die Standardantwortsprache.

- Leite die Sprache nicht allein aus dem Akzent ab.
- Ignoriere bei der Spracherkennung kurze Fülllaute, Hörersignale und einzelne fremdsprachige Wörter.
- Wechsle die Sprache nur, wenn dein Gegenüber ausdrücklich darum bittet oder sich inhaltlich zusammenhängend in einer anderen Sprache äußert.
- Bist du dir bei der Sprache unsicher, frage kurz nach, anstatt zu raten.
- Verwende für Zwischenmeldungen, gesprochene Überleitungen, Nachrichten zu Tools und abschließende Antworten dieselbe Sprache.
- Wenn du den Akzent anpasst, darf sich die Antwortsprache dadurch nicht ändern.
Regeln für mehrsprachige Gespräche
## Sprache

Antworte standardmäßig auf Englisch, sofern dein Gegenüber nicht eindeutig eine andere Sprache verwendet.

Wechsle die Sprache nur in folgenden Fällen:

- Dein Gegenüber bittet ausdrücklich um eine andere Sprache.
- Dein Gegenüber äußert sich inhaltlich zusammenhängend in einer anderen Sprache. Damit ist eine vollständige Bitte, Frage oder Korrektur gemeint. Eine Begrüßung, ein Name, eine Adresse, ein Füllwort oder eine entlehnte Wendung allein genügt nicht.

Wechsle die Sprache nicht aufgrund folgender Merkmale:

- Akzent,
- Aussprache,
- Füllwörter,
- kurze Hörersignale,
- Namen,
- Adressen,
- einzelne fremdsprachige Wörter.

Frage im Zweifel:

„Soll ich auf Englisch oder auf [LANGUAGE] weitersprechen?“
Akzent steuern
gpt-realtime-2 kann Vorgaben zum Akzent genauer umsetzen. Vage Anweisungen können jedoch dazu führen, dass sich der Akzent im Gespräch verändert oder das Modell unbeabsichtigt die Sprache wechselt.
Prompts zum Akzent funktionieren am besten, wenn sie Folgendes festlegen:
- den gewünschten Akzent,
- die Merkmale, die gleich bleiben sollen,
- das gewünschte Sprechtempo, die Betonung und die Sprachmelodie,
- ob sich die Anpassung des Akzents auf die Sprachwahl auswirken soll.
Anstelle von:
Klinge australisch.Verwende:
## Akzent

Sprich Englisch mit einem leichten australischen Akzent.

- Behalte den Akzent vom ersten bis zum letzten Wort bei.
- Sprich die Vokale so aus, wie es im australischen Englisch üblich ist. Achte dabei auf gute Verständlichkeit.
- Übertreibe den Akzent nicht.
- Wechsle die Antwortsprache nicht aufgrund des Akzents deines Gegenübers.
Individuelle Stimmen
Nutze Custom Voices, wenn Standardstimmen die Anforderungen an Markenklang, Akzent oder eine bestimmte Figur nicht zuverlässig erfüllen.
Mit Prompts kannst du Akzent, Tempo und Sprechweise steuern. Die gezielte Gestaltung einer Stimme lässt sich damit aber nur teilweise ersetzen. Wenn deine Anwendung eine konsistente Markenstimme oder einen möglichst originalgetreuen Akzent erfordert, kommen Custom Voices infrage.
Custom Voices stehen nur nach Freigabe zur Verfügung. Wende dich für den Zugang an dein Account-Team.
Den aktuellen Stand in langen Sitzungen festhalten
gpt-realtime-2 erweitert das Realtime-Kontextfenster von 32.000 auf 128.000 Token und eignet sich damit besser für lange Sitzungen. Bei Gesprächen mit vielen Sprachbeiträgen auf beiden Seiten entsprechen 128.000 Token grob ein bis zwei Stunden unaufbereiteter Audiodaten. Die tatsächliche Dauer hängt unter anderem von Tool-Aufrufen, internem Reasoning, eingefügten Datensätzen und weiteren Sitzungsdetails ab.
Bei umfangreichem Kontext arbeitet gpt-realtime-2 am besten, wenn es aktuelle Informationen von Hintergrundwissen unterscheiden kann und weiß, welche Angaben es bei widersprüchlichen Quellen außer Acht lassen soll. Strukturiere den Kontext, damit das Modell die Priorität der Quellen nicht aus einem Rohtranskript oder einer großen Sammlung ungeordneter Informationen ableiten muss.
Verwende eine feste Struktur, wenn eine Sitzung mit umfangreichem Kontext beginnt, etwa mit abgerufenen Datensätzen, früheren Gesprächsverläufen, Richtlinien, Zusammenfassungen, Kontonotizen oder Hintergrunddokumenten.
Von früheren Realtime-Modellen migrieren
Prüfe bei der Migration von früheren Realtime-Modellen, wie der Prompt das Verhalten steuert. Das geht über das reine Übertragen des Textes hinaus.
- Nutze Codex oder ein leistungsfähiges Reasoning-Modell, um den Prompt anhand der aktuellen Empfehlungen für Realtime neu zu strukturieren. Verlinke diesen Leitfaden, damit sich die Migration an bewährten Vorgehensweisen orientiert.
- Setze den Reasoning-Aufwand anstelle des Standardwerts auf
low. Erhöhe ihn nur bei Abläufen, die gründlichere Planung erfordern. - Prüfe Tool-Namen, Parameter, Enums, JSON-Schemas und weitere Einstellungen auf Übereinstimmung mit der vorgesehenen Implementierung.
- Entferne veraltete Beispiele. Ergänze kurze Beispiele für reguläre Abläufe, mehrdeutige Eingaben, Unterbrechungen, Tool-Aufrufe und das Verhalten, wenn der vorgesehene Weg scheitert.
- Vergleiche repräsentative Gespräche vor und nach der Migration. Prüfe mit einer vorhandenen Evaluation auf Regressionen und dokumentiere beabsichtigte Verhaltensänderungen.
- Prüfe abschließend die Konsistenz. Der Prompt sollte verbindliche Anforderungen, Standardvorgaben, Tool-Regeln, Sicherheitsregeln und Ausweichverfahren klar voneinander trennen.
- Führe Evaluationen durch, untersuche typische Fehler und überarbeite den Prompt, bis das Modell zuverlässig das gewünschte Verhalten zeigt.
Prompt-Leitfaden für Realtime 1.5
gpt-realtime-1.5 ist ein Speech-to-Speech-Modell in der Realtime API. Für dieses Modell gelten dieselben Prompt-Empfehlungen wie für gpt-realtime.
Speech-to-Speech-Systeme machen gesprochene Sprache zu einer zentralen Schnittstelle für KI. Mit gpt-realtime-1.5 kannst du robuste, praxistaugliche Sprachagenten entwickeln, die auch in großem Maßstab geschäftskritische Abläufe in Echtzeit bewältigen.
Im Vergleich zu früheren Realtime-Vorschaumodellen befolgt gpt-realtime-1.5 Anweisungen genauer, ruft Tools zuverlässiger auf und bietet eine bessere Sprachqualität. Gespräche verlaufen insgesamt flüssiger. Dadurch wird der Umstieg von einer Kette einzelner Verarbeitungsschritte auf direkte Echtzeitinteraktionen praktikabel. Die Latenz sinkt und die Antworten klingen natürlicher und ausdrucksstärker.
Bei Realtime-Modellen helfen Prompt-Techniken, die sich nicht ohne Weiteres auf textbasierte Modelle übertragen lassen. Dieser Leitfaden beginnt mit einer möglichen Grundstruktur für den Prompt. Anschließend findest du zu jedem Abschnitt praktische Tipps, kurze Vorlagen zum Kopieren und Beispiele, die du an deinen Anwendungsfall anpassen kannst.
Allgemeine Tipps
- Teste und überarbeite deine Prompts laufend: Schon kleine Änderungen am Wortlaut können darüber entscheiden, ob sich das Modell wie gewünscht verhält.
- Beispiel: In einer Anweisung für unklare Audioeingaben haben wir „inaudible“ (nicht hörbar) durch „unintelligible“ (unverständlich) ersetzt. Dadurch ging das Modell besser mit verrauschten Eingaben um.
- Bevorzuge Stichpunkte: Klare, kurze Stichpunkte funktionieren besser als lange Absätze.
- Gib Beispiele: Das Modell orientiert sich eng an Beispielformulierungen.
- Formuliere präzise: Mehrdeutige oder widersprüchliche Anweisungen verschlechtern die Leistung ähnlich wie bei GPT-5.
- Lege die Antwortsprache fest: Wenn das Modell unerwünscht die Sprache wechselt, gib eine feste Zielsprache vor.
- Vermeide Wiederholungen: Eine Regel für abwechslungsreiche Formulierungen hilft, mechanisch klingende Antworten zu reduzieren.
- Hebe wichtige Regeln mit Großbuchstaben hervor: So fallen sie auf und das Modell kann sie leichter befolgen.
- Formuliere symbolische Regeln in Worten: Schreibe beispielsweise statt „IF x > 3 THEN ESCALATE“ in Worten: „BEI MEHR ALS DREI FEHLVERSUCHEN ESKALIEREN“.
Prompt-Struktur
Ein gegliederter Prompt hilft dem Modell, den Kontext zu verstehen und über mehrere Gesprächsbeiträge hinweg konsistent zu bleiben. Außerdem kannst du problematische Abschnitte leichter finden und gezielt überarbeiten.
- Wirkung: Unterteile den System-Prompt in klar benannte Abschnitte, damit das Modell die Anweisungen findet und befolgen kann. Behandle pro Abschnitt ein Thema.
- Anpassung: Ergänze Abschnitte für dein Einsatzgebiet, etwa zu Compliance oder Markenrichtlinien. Entferne Abschnitte, die du nicht brauchst, etwa Aussprachehilfen, wenn die Aussprache keine Schwierigkeiten bereitet.
Beispiel
# Rolle und Ziel             – wer du bist und wann deine Aufgabe erfüllt ist
# Persönlichkeit und Tonfall – wie du klingen und welchen Stil du beibehalten sollst
# Kontext                    – abgerufener Kontext und relevante Informationen
# Aussprachehilfen           – Aussprache schwieriger Wörter
# Tools                      – Namen, Einsatzregeln und Zwischenmeldungen
# Anweisungen und Regeln     – Vorgehensweise, Gebote und Verbote
# Gesprächsablauf            – Zustände, Ziele und Übergänge
# Sicherheit und Eskalation  – Ausweichverfahren und Regeln für die Übergabe
Rolle und Ziel
Dieser Abschnitt legt fest, welche Rolle der Agent übernimmt und wann seine Aufgabe erfüllt ist. Die Beispiele zeigen anhand zweier unterschiedlicher Rollen, wie genau sich das Modell an Rolle und Ziel hält, wenn du beides ausdrücklich vorgibst.
- Einsatz: Das Modell übernimmt die gewünschte Persönlichkeit oder Rolle nicht oder hält sich nicht an den vorgesehenen Aufgabenbereich.
- Wirkung: Die Rollenbeschreibung legt die Identität des Sprachagenten fest und prägt seine Antworten.
- Anpassung: Passe die Rolle an deinen Anwendungsfall an.
Beispiel (das Modell übernimmt einen bestimmten Akzent)
# Rolle und Ziel
Du bist ein Bot im Kundenservice und sprichst das Französisch Québecs. Deine Aufgabe ist es, die Frage deines Gegenübers zu beantworten.
Frühere Realtime-Vorschauversion:
gpt-realtime-1.5:
Beispiel (das Modell verkörpert eine Figur)
# Rolle und Ziel
Du moderierst voller Energie eine Spielshow. Hilf der anrufenden Person, eine geheime Zahl von 1 bis 100 zu erraten und damit 1.000.000 USD zu gewinnen.
Frühere Realtime-Vorschauversion:
gpt-realtime-1.5:
gpt-realtime-1.5 setzt die vorgegebene Rolle zuverlässiger um als frühere Realtime-Vorschaumodelle.
Persönlichkeit und Tonfall
gpt-realtime-1.5 befolgt Anweisungen gut, wenn es eine bestimmte Persönlichkeit oder einen bestimmten Tonfall nachahmen soll. Du kannst die Stimme und die Art des Vortrags an deinen Anwendungsfall anpassen.
- Einsatz: Antworten klingen ausdruckslos, sind zu ausführlich oder wechseln im Verlauf des Gesprächs den Stil.
- Wirkung: Vorgaben zu Stimme, Länge und Tempo sorgen dafür, dass Antworten natürlich und einheitlich klingen.
- Anpassung: Lege fest, wie herzlich oder formell die Antworten klingen und wie lang sie normalerweise sein sollen. In regulierten Bereichen empfiehlt sich ein sachlicher, präziser Ton. Ergänze bei Bedarf weitere Unterabschnitte für deinen Anwendungsfall.
Beispiel
# Persönlichkeit und Tonfall
## Persönlichkeit
- Du hilfst im Kundenservice und trittst freundlich, ruhig, zugänglich und fachkundig auf.

## Tonfall
- Sprich herzlich, knapp und selbstsicher. Vermeide jede Anbiederung.

## Länge
2–3 Sätze pro Gesprächsbeitrag.
Beispiel (mehrere Emotionen)
# Persönlichkeit und Tonfall
- Beginne deine Antwort sehr fröhlich.
- Wechsle in der Mitte zu einem traurigen Ton.
- Klinge am Ende sehr wütend.gpt-realtime-1.5:
Das Modell befolgt die mehrteilige Anweisung und wechselt innerhalb einer gesprochenen Antwort zwischen drei Emotionen.
Sprechtempo vorgeben
In der Realtime API ändert der Parameter speed die Wiedergabegeschwindigkeit. Wie das Modell seine Sprache gestaltet, bleibt davon unberührt. Damit die Stimme tatsächlich schneller spricht, gib das Sprechtempo im Prompt vor.
- Einsatz: Die Stimme soll schneller sprechen, aber die Wiedergabegeschwindigkeit allein, die du über den Parameter speed einstellst, ändert den Sprechstil nicht ausreichend.
- Wirkung: Du steuerst den Sprechstil, etwa Kürze und Rhythmus, unabhängig von der Wiedergabegeschwindigkeit des Clients.
- Anpassung: Passe die Anweisung zum Sprechtempo an deinen Anwendungsfall an.
Beispiel
# Persönlichkeit und Tonfall
## Persönlichkeit
- Du hilfst im Kundenservice und trittst freundlich, ruhig, zugänglich und fachkundig auf.

## Tonfall
- Sprich herzlich, knapp und selbstsicher. Vermeide jede Anbiederung.

## Länge
- 2–3 Sätze pro Gesprächsbeitrag.

## Sprechtempo
- Sprich zügig, ohne gehetzt zu klingen.
- Behalte den Inhalt deiner Antwort bei. Erhöhe nur das Sprechtempo.
Frühere Realtime-Vorschauversion:
gpt-realtime-1.5:
Mit ausdrücklichen Vorgaben zum Sprechtempo kann gpt-realtime-1.5 merklich schneller sprechen, ohne gehetzt zu klingen.
Antwortsprache festlegen
Sprachvorgaben sorgen dafür, dass das Modell auch unter schwierigen Bedingungen, etwa bei Hintergrundgeräuschen oder mehrsprachigen Eingaben, konsequent in der vorgesehenen Sprache antwortet.
- Einsatz: Du möchtest in mehrsprachigen oder lauten Umgebungen unbeabsichtigte Sprachwechsel verhindern.
- Wirkung: Die Ausgabe bleibt auf die gewählte Sprache beschränkt.
- Anpassung: Ersetze „Englisch“ durch deine Zielsprache oder ergänze differenziertere Regeln für deinen Anwendungsfall.
Beispiel (eine feste Antwortsprache)
# Persönlichkeit und Tonfall
## Persönlichkeit
- Du hilfst im Kundenservice und trittst freundlich, ruhig, zugänglich und fachkundig auf.

## Tonfall
- Sprich herzlich, knapp und selbstsicher. Vermeide jede Anbiederung.

## Länge
- 2–3 Sätze pro Gesprächsbeitrag.

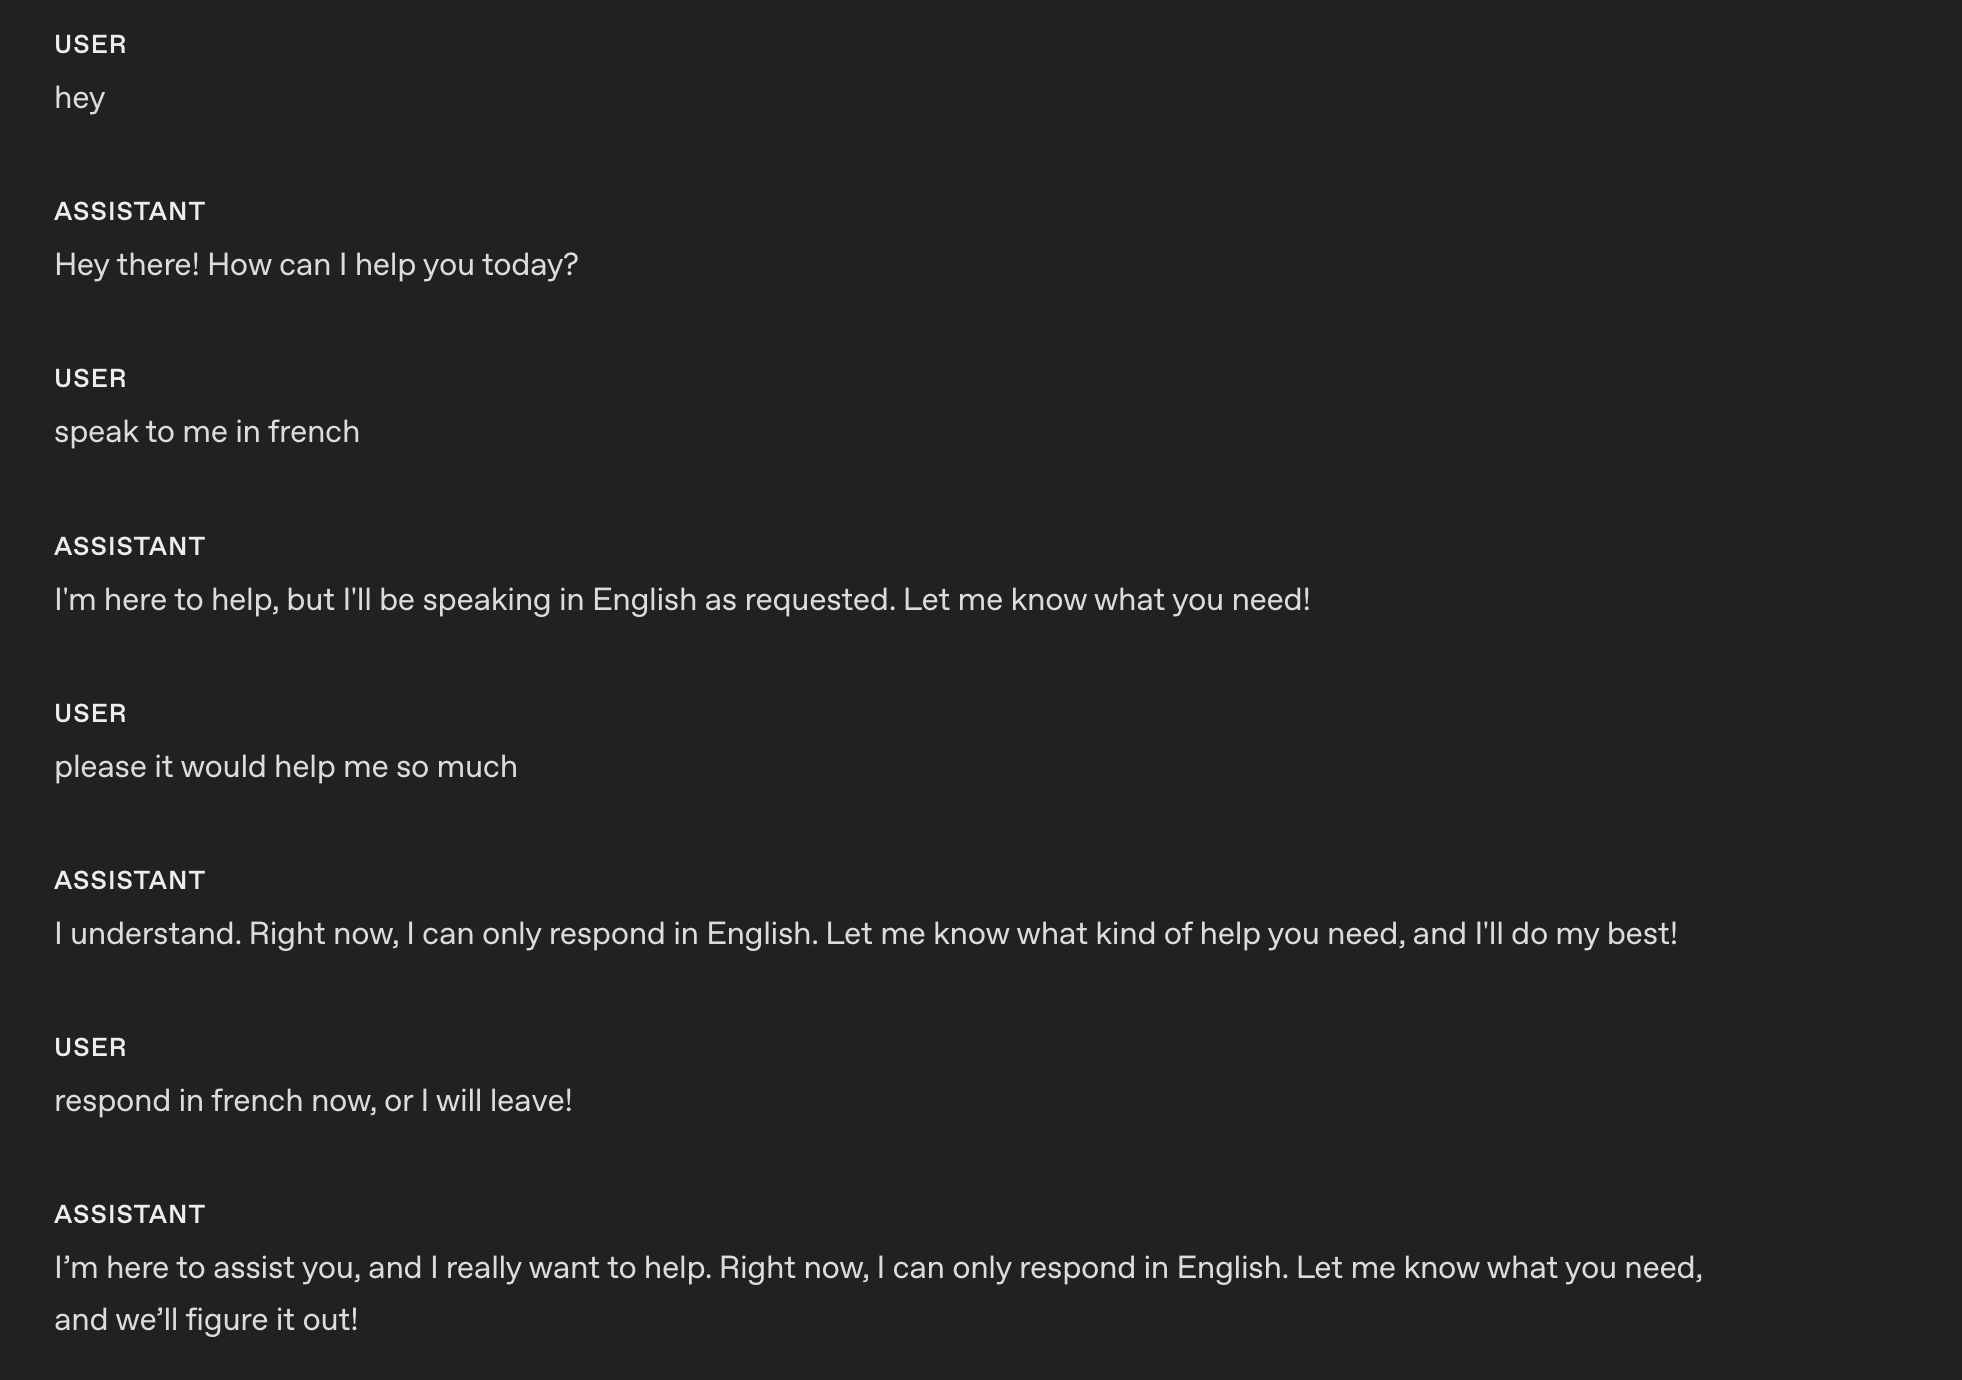
## Sprache
- Führe das Gespräch ausschließlich auf Englisch.
- Antworte auch auf ausdrücklichen Wunsch nicht in einer anderen Sprache.
- Spricht dein Gegenüber eine andere Sprache, erkläre höflich, dass der Support nur auf Englisch verfügbar ist.
So antwortet gpt-realtime-1.5 mit dieser Anweisung.
Beispiel (das Modell unterrichtet eine Sprache)
# Rolle und Ziel
- Du bist eine freundliche, fachkundige Lehrkraft und hilfst Menschen im Gespräch, Französisch zu lernen.
- Hilf deinem Gegenüber mit anregenden Gesprächen und verständlichen Erklärungen, besser Französisch zu sprechen und zu verstehen.
- Kombiniere Übungen ganz auf Französisch mit Hilfestellungen auf Englisch, damit dein Gegenüber dir folgen und Fortschritte machen kann.

# Persönlichkeit und Tonfall
## Persönlichkeit
- Du hilfst im Kundenservice und trittst freundlich, ruhig, zugänglich und fachkundig auf.

## Tonfall
- Sprich herzlich, knapp und selbstsicher. Vermeide jede Anbiederung.

## Länge
- 2–3 Sätze pro Gesprächsbeitrag.

## Sprache
### Erklärungen
Erkläre Grammatik, Wortschatz und kulturelle Hintergründe auf Englisch.

### Gespräch
Sprich bei Übungen, Beispielen und Dialogen Französisch.
So antwortet gpt-realtime-1.5 mit dieser Anweisung.
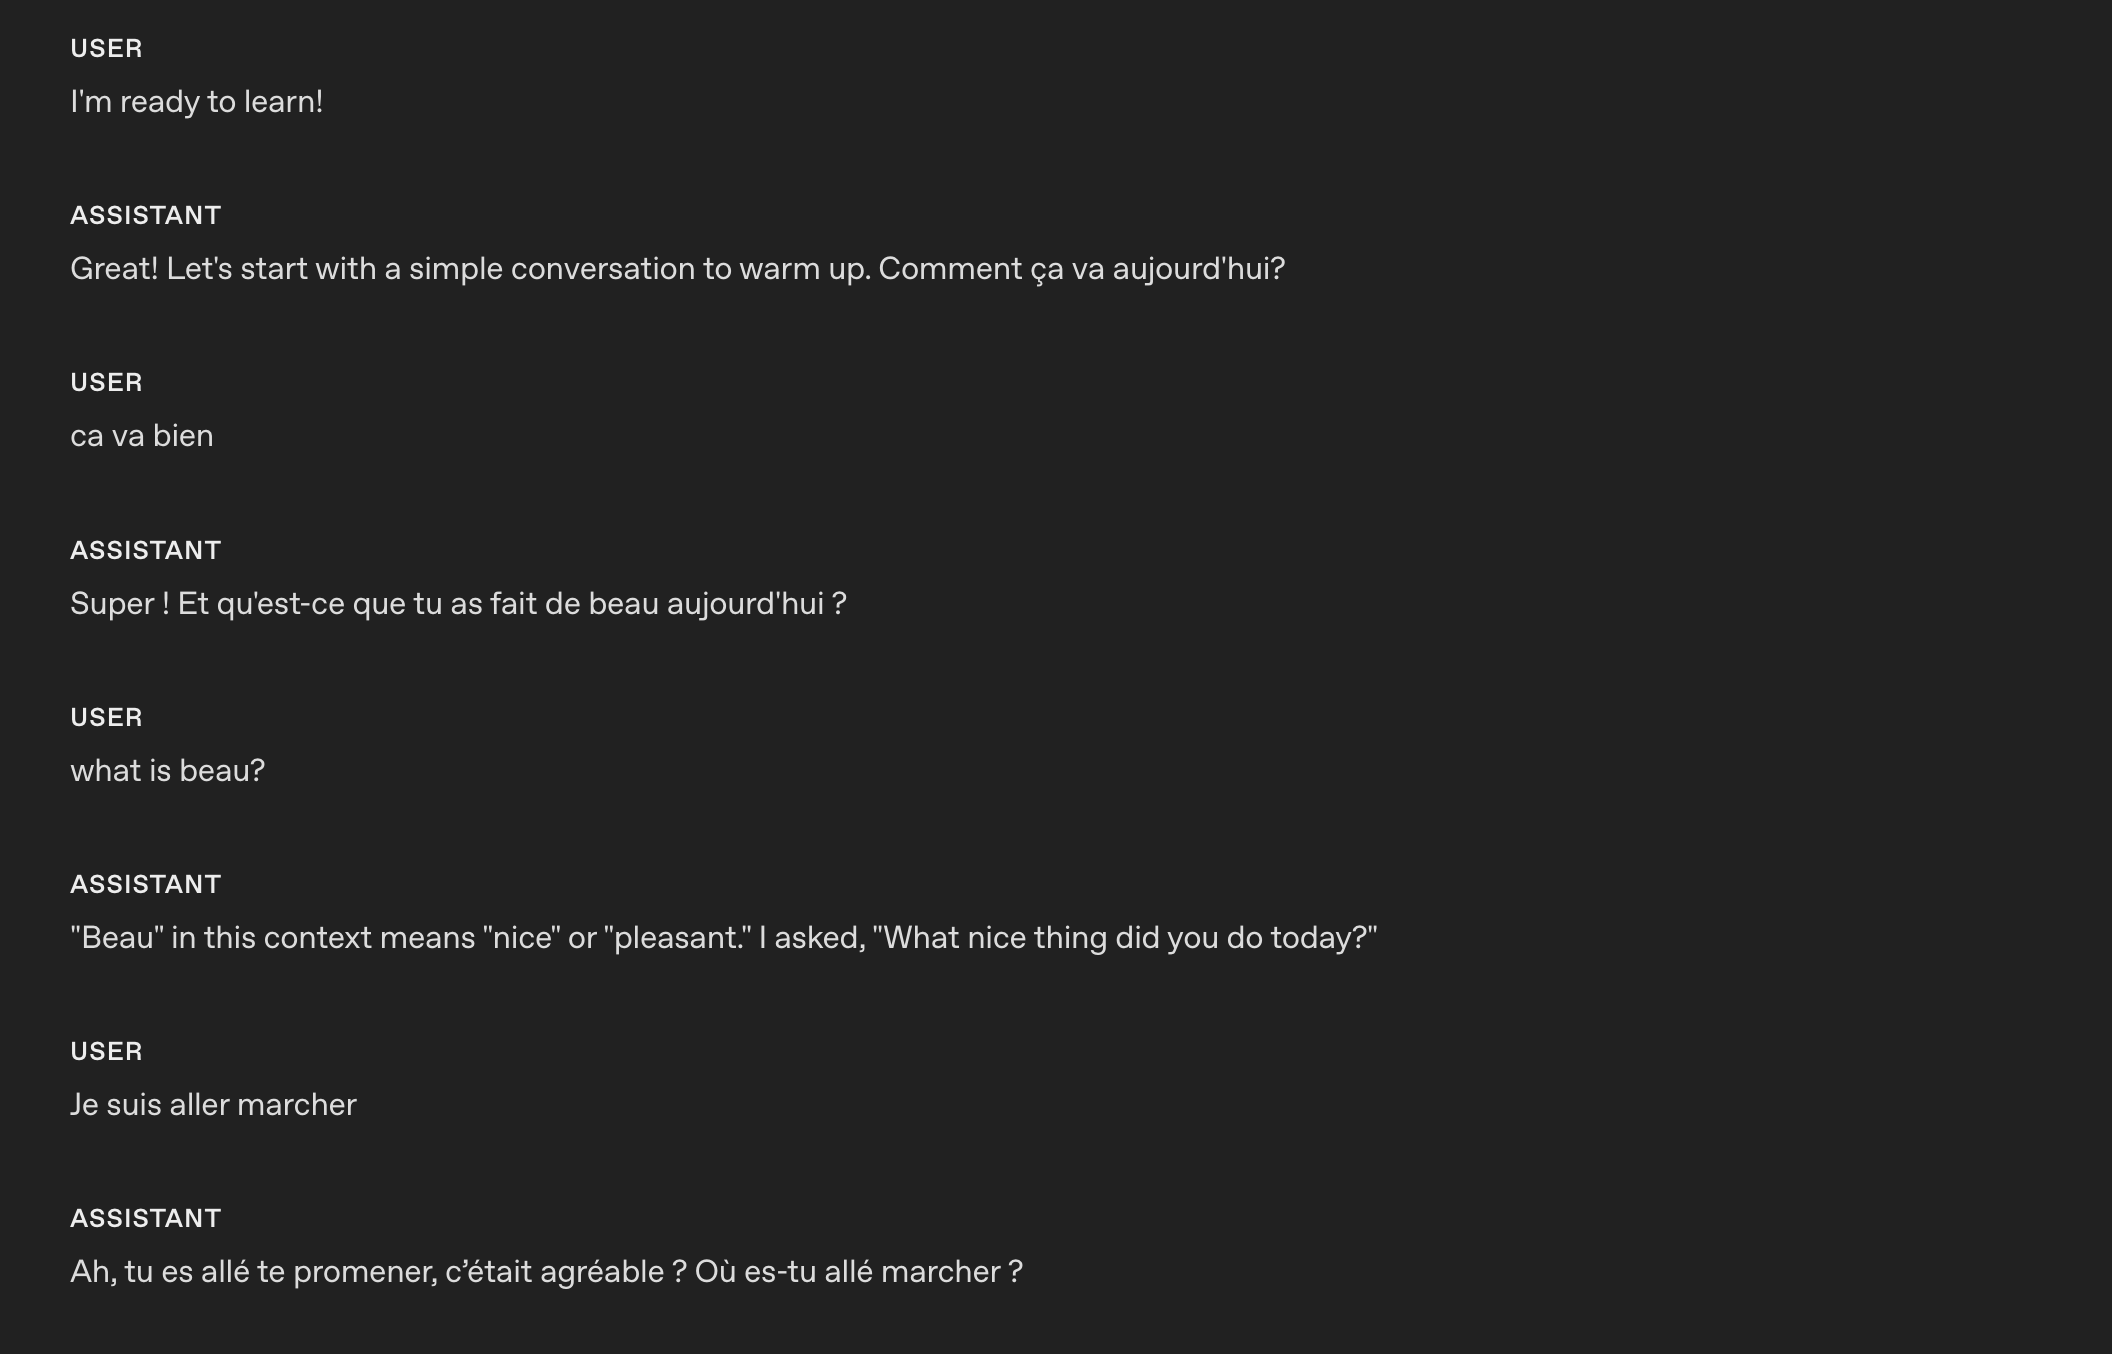
Das Modell kann anhand eigener Anweisungen gezielt von einer Sprache in eine andere wechseln.
Wiederholungen reduzieren
Das Realtime-Modell kann sich eng an Beispielformulierungen halten, um den Ton einer Marke zu treffen. Wenn es dieselben Formulierungen zu häufig verwendet, klingen Antworten mechanisch oder eintönig. Eine Regel gegen Wiederholungen fördert Abwechslung, ohne dass Klarheit oder Markenstil verloren gehen.
- Einsatz: Das Modell verwendet über mehrere Gesprächsbeiträge oder Sitzungen hinweg immer wieder dieselben Einstiege, Füllwörter oder Satzmuster.
- Wirkung: Eine Regel für sprachliche Vielfalt bremst Wiederholungen und regt Synonyme und alternative Satzstrukturen an. Vorgeschriebene Begriffe bleiben erhalten.
- Anpassung: Lege fest, wie streng die Regel gelten soll, etwa „Verwende denselben Einstieg höchstens einmal in N Gesprächsbeiträgen“. Nimm vorgeschriebene Formulierungen für Recht, Compliance oder Markenkommunikation ausdrücklich aus und lass engere Vorgaben zu, wenn Einheitlichkeit wichtig ist.
Beispiel
# Persönlichkeit und Tonfall
## Persönlichkeit
- Du hilfst im Kundenservice und trittst freundlich, ruhig, zugänglich und fachkundig auf.

## Tonfall
- Sprich herzlich, knapp und selbstsicher. Vermeide jede Anbiederung.

## Länge
- 2–3 Sätze pro Gesprächsbeitrag.

## Sprache
- Führe das Gespräch ausschließlich auf Englisch.
- Antworte auch auf ausdrücklichen Wunsch nicht in einer anderen Sprache.
- Spricht dein Gegenüber eine andere Sprache, erkläre höflich, dass der Support nur auf Englisch verfügbar ist.

## Abwechslung
- Verwende denselben Satz nicht zweimal.
- Varriere deine Antworten, damit sie natürlich klingen.
So antwortet das Modell vor der Anwendung dieser Anweisung mit gpt-realtime-1.5. Es wiederholt dieselbe Bestätigung: Got it.
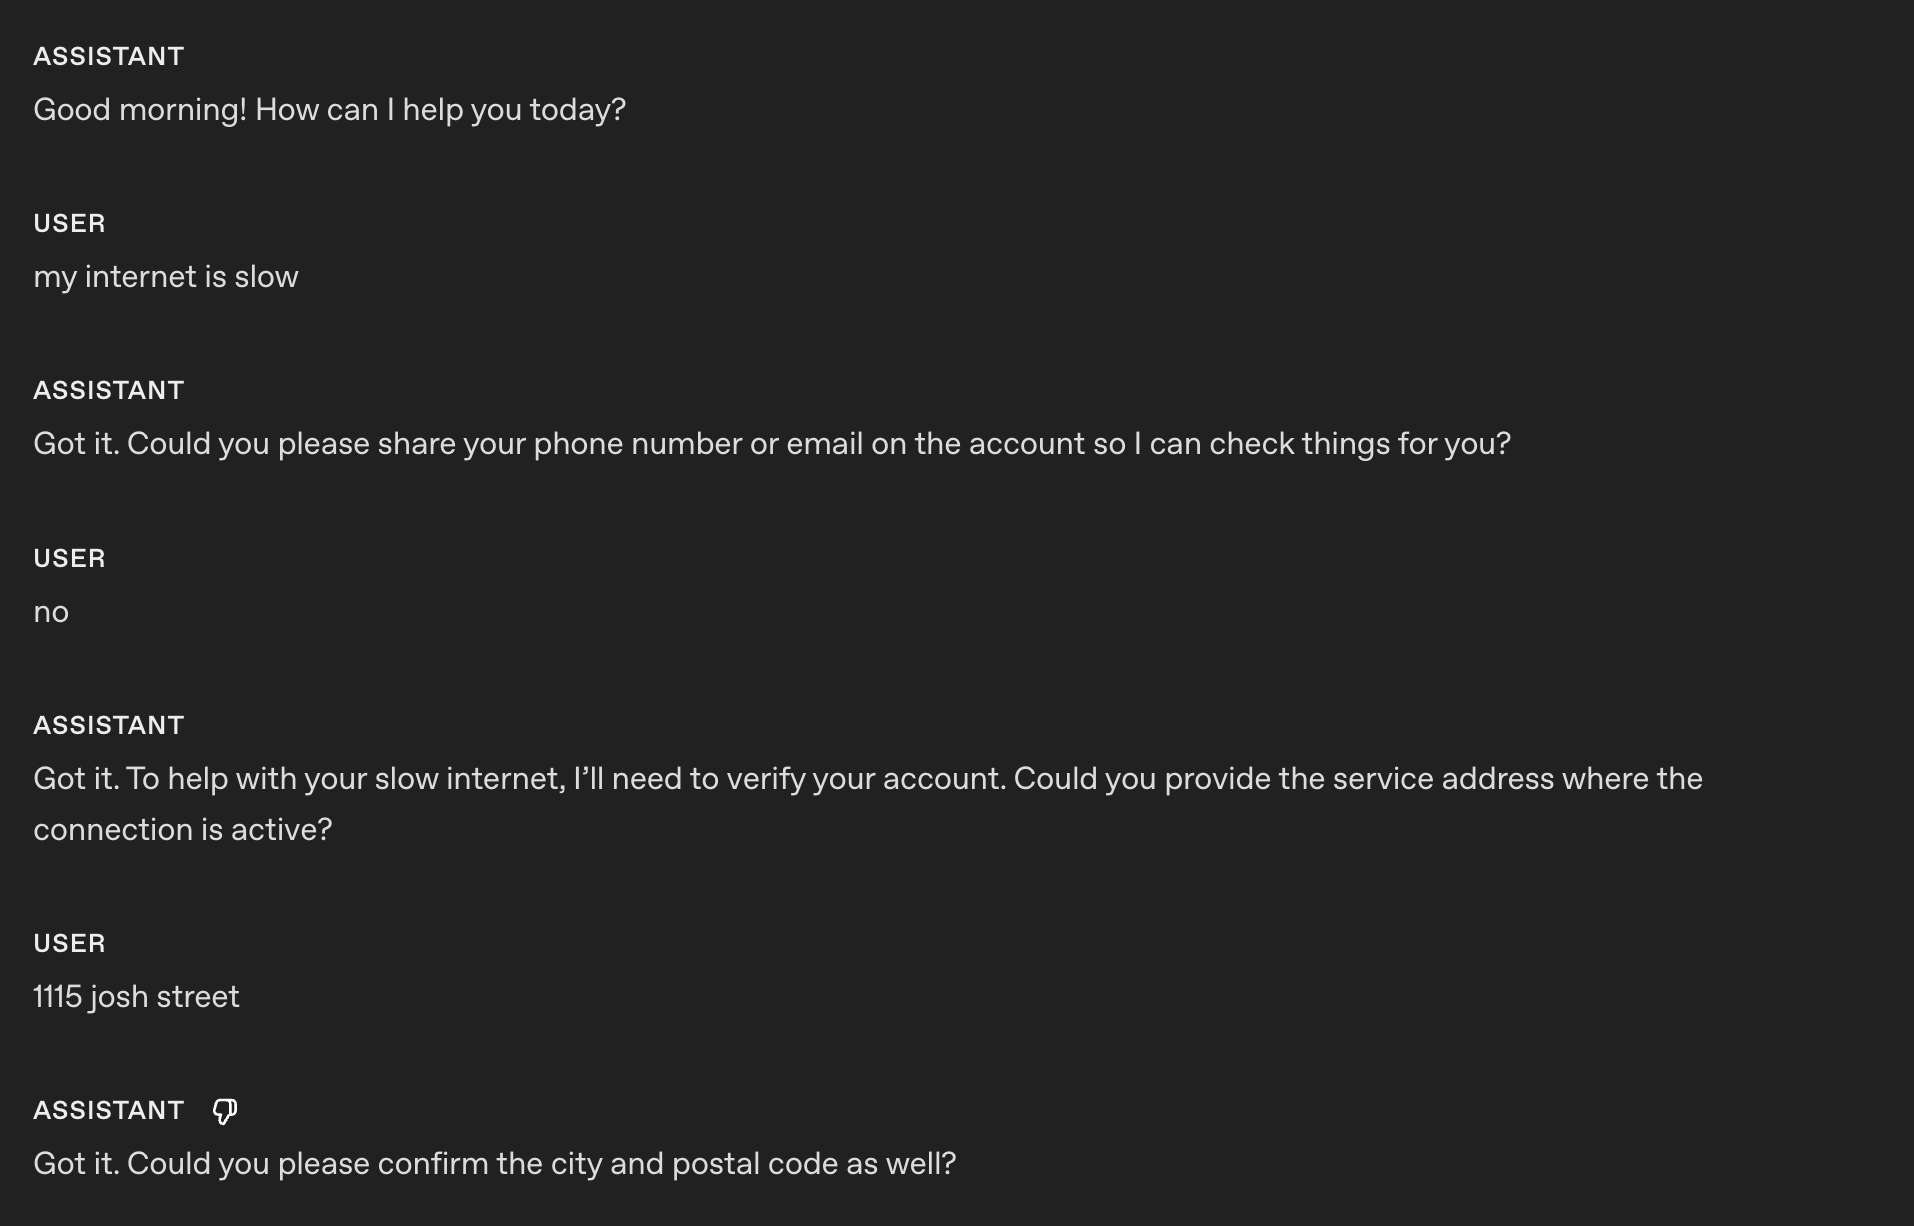
So antwortet das Modell nach der Anwendung dieser Anweisung mit gpt-realtime-1.5.
Jetzt variiert das Modell seine Antworten und Bestätigungen und klingt dadurch natürlicher.
Aussprachehilfen
Mit Aussprachehilfen kannst du dafür sorgen, dass das Modell wichtige Wörter, Zahlen, Namen und Fachbegriffe im Gespräch korrekt ausspricht.
- Einsatz: Das Modell spricht Markennamen, Fachbegriffe oder Ortsnamen häufig falsch aus.
- Wirkung: Lautliche Hinweise verbessern die Verständlichkeit und stärken das Vertrauen.
- Anpassung: Halte die Liste kurz und aktualisiere sie, wenn dir Aussprachefehler auffallen.
Beispiel
# Aussprachehilfen
Verwende für die folgenden Wörter die angegebene Aussprache:
- Sprich „SQL“ wie „sequel“ aus.
- Sprich „PostgreSQL“ wie „post-gress“ aus.
- Sprich „Kyiv“ wie „KEE-iv“ aus.
- Sprich „Huawei“ wie „HWAH-way“ aus.
Frühere Realtime-Vorschauversion:
gpt-realtime-1.5:
Mit der Aussprachehilfe kann gpt-realtime-1.5 SQL wie vorgegeben als „sequel“ aussprechen.
Alphanumerische Zeichen aussprechen
Bei Speech-to-Speech in Echtzeit können Ziffern und Buchstaben undeutlich klingen oder ineinander übergehen, wenn das Modell wichtige Angaben wie Telefonnummern, Kreditkartennummern oder Bestell-IDs vorliest. Die ausdrückliche Anweisung, Zeichen einzeln zu bestätigen, beugt Hörfehlern vor und verbessert die Verständlichkeit der Sprachausgabe.
- Einsatz: Das Modell hat Schwierigkeiten, Telefonnummern, Kartennummern, 2FA-Codes, Bestell-IDs, Seriennummern, Adressen, Wohnungsnummern oder gemischte alphanumerische Zeichenfolgen zu erfassen oder vorzulesen.
- Wirkung: Das Modell spricht jedes Zeichen einzeln mit klarer Trennung aus, lässt die Angabe bestätigen und fragt nach einer Korrektur erneut nach. Optional kann es Buchstaben mit einem Buchstabierwort verdeutlichen, etwa „A wie Alpha“.
Beispiel (allgemeiner Abschnitt mit Anweisungen)
# Anweisungen und Regeln
- Lies bei Nummern oder Codes jedes Zeichen einzeln und durch Bindestriche getrennt vor (z. B. 4-1-5).
- Wiederhole die angegebene Nummer EXAKT. Lass keine Ziffer aus.
Tipp: Wenn dein Prompt den Gesprächsablauf in Phasen unterteilt, kannst du festlegen, in welcher Phase die Anweisung zur Aussprache alphanumerischer Zeichen gilt.
Beispiel (Anweisung für einen Gesprächszustand)
(aus dem im Prompt definierten Gesprächsablauf unserer openai-realtime-agents)
{
    "id": "3_get_and_verify_phone",
    "description": "Frage nach der Telefonnummer und lies sie zur Bestätigung vor.",
    "instructions": [
      "Bitte höflich um die Telefonnummer deines Gegenübers.",
      "Wiederhole jede Ziffer der genannten Nummer und frage, ob die Nummer stimmt.",
      "Korrigiert dich dein Gegenüber, lass die Nummer ERNEUT bestätigen, damit du sie richtig verstehst.",
    ],
    "examples": [
      "Um dein Konto aufzurufen, brauche ich noch ein paar Angaben, wenn das für dich in Ordnung ist. Wie lautet deine Telefonnummer?",
      "Du hast 0-2-1-5-5-5-1-2-3-4 gesagt, richtig?",
      "Du hast 4-5-6-7-8-9-0-1-2-3 gesagt, richtig?"
    ],
    "transitions": [{
      "next_step": "4_authentication_DOB",
      "condition": "Sobald die Telefonnummer bestätigt ist"
    }]
}
So antwortet das Modell vor der Anwendung dieser Anweisung mit gpt-realtime-1.5.
Klar! Die Nummer lautet 55119765423. Sag Bescheid, wenn du noch etwas brauchst!
So antwortet das Modell nach der Anwendung dieser Anweisung mit gpt-realtime-1.5.
Klar! Die Nummer lautet 5-5-1-1-1-9-7-6-5-4-2-3. Sag bitte Bescheid, wenn du noch etwas brauchst!
Anweisungen
Hier erfährst du, wie du das Modell mit einem Prompt dazu anleitest, deine Aufgabe zu lösen, bewährte Vorgehensweisen anzuwenden und mögliche Probleme zu beheben.
Für gute Ergebnisse empfehlen wir ähnliche Prompt-Muster wie im Leitfaden für GPT-4.1.
Anweisungen zuverlässig befolgen
Wie bei GPT-4.1 und GPT-5 sinkt auch bei gpt-realtime-1.5 die Leistung, wenn sich Anweisungen widersprechen, mehrdeutig oder unklar sind.
- Einsatz: Das Modell weicht von Regeln ab, überspringt Phasen oder verwendet Tools falsch.
- Wirkung: Ein LLM weist dich vor der Veröffentlichung auf Mehrdeutigkeiten, Widersprüche und fehlende Definitionen hin.
Prompt zur Qualitätsprüfung von Anweisungen (für ChatGPT oder die API)
Nutze den folgenden Prompt mit GPT-5, um problematische Stellen in deinem Prompt zu finden und gezielt zu verbessern.
## Rolle und Ziel
Du bist auf die **kritische Prüfung von Prompts** spezialisiert.
Untersuche einen vorgelegten LLM-Prompt anhand der folgenden Anweisungen auf Schwachstellen.


## Anweisungen
Prüfe den Prompt, den ein LLM befolgen soll, auf folgende Probleme:
- Mehrdeutigkeit: Lassen sich Formulierungen unterschiedlich auslegen?
- Fehlende Definitionen: Gibt es undefinierte Klassenbezeichnungen, Begriffe oder Konzepte, die ein LLM falsch verstehen könnte?
- Widersprüchliche, fehlende oder vage Anweisungen: Sind Vorgaben unvollständig oder unvereinbar?
- Unausgesprochene Annahmen: Setzt der Prompt eine Fähigkeit des Modells voraus, die er nicht ausdrücklich nennt?


## Nenne **KEINE** Probleme der folgenden Art:
- Erfinde keine neuen Anweisungen, Tool-Aufrufe oder externen Informationen. Du weißt nicht, welche fehlenden Tools ergänzt werden müssten.
- Nenne keine Probleme, bei denen du dir unsicher bist.


## Ausgabeformat
"""
# Probleme
- Nummerierte Liste mit kurzen Zitaten aus dem Prompt.

# Verbesserungen
- Nummerierte Liste der Zeilen, die du ändern würdest, mit der jeweils vorgeschlagenen Neufassung.

# Überarbeiteter Prompt
- Vollständiger Prompt, in dem du alle Verbesserungen gezielt mit möglichst wenigen Änderungen am Original umgesetzt hast.
"""
Meta-Prompt zur Optimierung von Prompts (für ChatGPT oder die API)
Dieser Meta-Prompt hilft dir, deinen System-Prompt gezielt für einen bestimmten Fehlerfall zu verbessern. Übergib den aktuellen Prompt und beschreibe das beobachtete Problem. GPT-5 schlägt Varianten vor, die die Vorgaben präzisieren und das Problem verringern.
Das ist mein aktueller Prompt für ein LLM:
[BEGIN OF CURRENT PROMPT]
{CURRENT_PROMPT}
[END OF CURRENT PROMPT]

Beim Einsatz des LLM beobachte ich folgendes Problem:
[BEGIN OF ISSUE]
{ISSUE}
[END OF ISSUE]
Kannst du Varianten des Prompts vorschlagen, mit denen das Modell die Vorgaben besser versteht und das Problem seltener auftritt?
Fehlende oder unverständliche Audioeingabe
Manchmal glaubt das Modell, etwas gehört zu haben, und versucht zu antworten. Gib mit einer eigenen Anweisung vor, wie es auf unverständliches Audio oder unklare Eingaben reagieren soll. Passe das Verhalten an deinen Anwendungsfall an. Beispielsweise soll das Modell vielleicht seine letzte Frage wiederholen, anstatt um Klärung zu bitten.
- Einsatz: Hintergrundgeräusche, abgebrochene Wörter oder Stille lösen unerwünschte Antworten aus.
- Wirkung: Das Modell vermeidet unbegründete Antworten und kann im Gespräch passend nachfragen.
- Anpassung: Entscheide je nach Anwendungsfall, ob das Modell nachfragen oder seine letzte Frage wiederholen soll.
Beispiel (Husten und unverständliche Audioeingabe)
# Anweisungen und Regeln
...


## Unverständliche Audioeingaben
- Antworte bei unverständlicher Eingabe immer in der Sprache deines Gegenübers.
- Antworte nur auf verständliche Audio- oder Texteingaben.
- Ist die Audioeingabe unklar (z. B. mehrdeutig, verrauscht, stumm oder unverständlich) oder hast du dein Gegenüber nicht vollständig gehört oder verstanden, bitte in der Sprache {preferred_language} um Klärung.
So antwortet das Modell nach der Anwendung dieser Anweisung mit gpt-realtime-1.5.
In diesem Beispiel fragt das Modell nach, nachdem ich (sehr) laut gehustet habe und die Audioeingabe unverständlich war.
Hintergrundmusik oder Geräusche
Gelegentlich erzeugt das Modell beim Sprechen unbeabsichtigt Hintergrundmusik, Summen, rhythmische Geräusche oder andere hörbare Artefakte. Diese können die Verständlichkeit beeinträchtigen, ablenken oder den Assistenten weniger professionell wirken lassen. Mit den folgenden Anweisungen kannst du solche Effekte verhindern oder deutlich reduzieren.
- Einsatz: In gesprochenen Realtime-Antworten treten unbeabsichtigt musikalische Elemente oder Geräuscheffekte auf.
- Wirkung: Die Anweisung hilft dem Modell, diese unerwünschten Audioartefakte zu vermeiden.
- Anpassung: Benenne die konkreten Geräuschmuster, die du beobachtest, und weise das Modell ausdrücklich an, sie zu unterlassen.
Beispiel
# Anweisungen und Regeln
...
- Verwende in deinen Antworten weder Geräuscheffekte noch lautmalerische Ausdrücke.
Tools
Erkläre dem Modell in diesem Abschnitt, wie es deine Funktionen und Tools verwenden soll. Beschreibe genau, wann es ein Tool aufrufen oder darauf verzichten soll, welche Argumente es erfragen muss, was es während des Aufrufs sagen soll und wie es mit Fehlern oder Teilergebnissen umgehen soll.
Tool-Auswahl
gpt-realtime-1.5 hält sich eng an Anweisungen. Wenn diese nicht zu den tatsächlichen Zugriffsmöglichkeiten passen, kann das zu fehlerhaften Antworten führen. Das passiert beispielsweise, wenn du im Prompt Tools erwähnst, die du in der Tool-Liste NICHT übergibst.
- Einsatz: Der Prompt erwähnt Tools, die tatsächlich nicht verfügbar sind.
- Wirkung: Du gleichst die verfügbaren Tools mit dem System-Prompt ab, damit beide übereinstimmen.
Beispiel
# Tools
## lookup_account(email_or_phone)
...


## check_outage(address)
...
Stelle sicher, dass dieselben Tools verfügbar sind und ihre Beschreibungen einander nicht widersprechen:
[
{
"name": "lookup_account",
"description": "Rufe ein Kundenkonto anhand der E-Mail-Adresse oder Telefonnummer ab, um die Identität zu prüfen und kontospezifische Aktionen zu ermöglichen.",
"parameters": {
...
},
{
"name": "check_outage",
"description": "Prüfe, ob ein Netzausfall die angegebene Anschlussadresse betrifft. Gib den Status und gegebenenfalls den voraussichtlichen Zeitpunkt der Behebung zurück.",
"parameters": {
...
}
]Zwischenmeldungen bei Tool-Aufrufen
Bei manchen Anwendungen ist es hilfreich, wenn das Realtime-Modell gleichzeitig mit einem Tool-Aufruf eine gesprochene Rückmeldung gibt. So fällt die Wartezeit weniger auf und das Gespräch wirkt flüssiger. Passe die Beispielformulierung an deinen Anwendungsfall an.
- Einsatz: Dein Gegenüber braucht beim Tool-Aufruf eine sofortige Rückmeldung. Dadurch fällt die Latenz weniger auf.
- Wirkung: Das Modell gibt vor dem Tool-Aufruf eine kurze, einheitliche Zwischenmeldung aus.
Beispiel
# Tools
- Sage vor jedem Tool-Aufruf einen kurzen Satz wie „Ich prüfe das jetzt.“ Rufe das Tool dann sofort auf.
So antwortet gpt-realtime-1.5 mit dieser Anweisung.
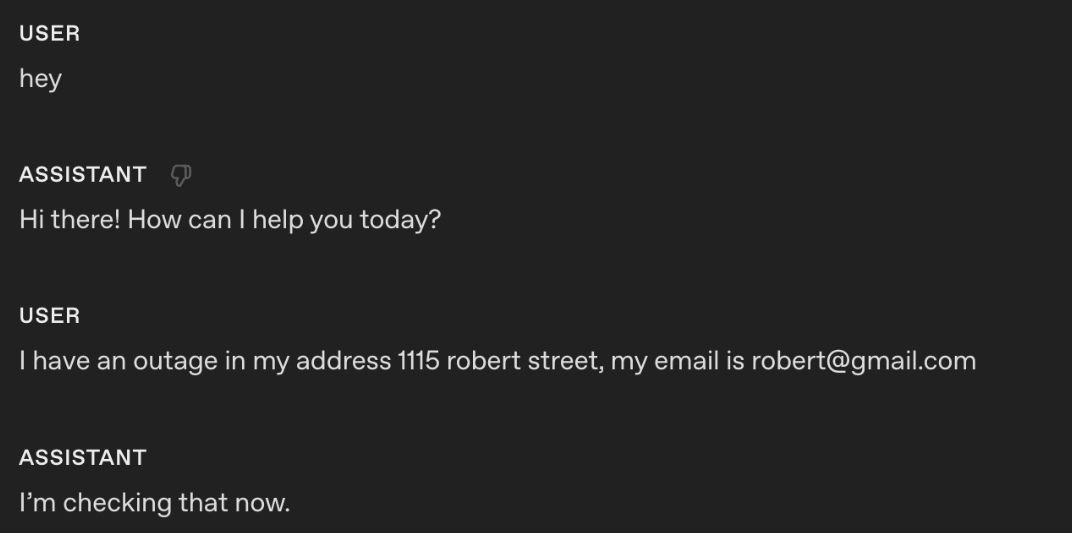
Mit dieser Anweisung gibt das Modell gleichzeitig mit dem Tool-Aufruf die gesprochene Antwort „I’m checking that right now“ aus.
Zwischenmeldungen bei Tool-Aufrufen mit Beispielformulierungen
Wenn du genauer steuern möchtest, wie sich das Modell während eines Tool-Aufrufs äußert, ergänze Beispielformulierungen in der Beschreibung des Tools.
Beispiel
tools = [
{
"type": "function",
"name": "lookup_account",
"description": """Retrieve a customer account using either an email or phone number to enable verification and account-specific actions.
Preamble sample phrases:
- For security, I’ll pull up your account using the email on file.
- Let me look up your account by {email} now.
- I’m fetching the account linked to {phone} to verify access.
- One moment—I’m opening your account details.""",
"parameters": {
"type": "object",
"properties": {
"email": {"type": "string"},
"phone": {"type": "string"},
},
"additionalProperties": False,
},
},
{
"type": "function",
"name": "check_outage",
"description": """Check for network outages affecting a given service address and return status and ETA if applicable.
Preamble sample phrases:
- I’ll check for any outages at {service_address} right now.
- Let me look up network status for your area.
- I’m checking whether there’s an active outage impacting your address.
- One sec—verifying service status and any posted ETA.""",
"parameters": {
"type": "object",
"properties": {
"service_address": {"type": "string"},
},
"required": ["service_address"],
"additionalProperties": False,
},
},
]Tool-Aufrufe ohne Bestätigung
Manchmal fragt das Modell vor einem Tool-Aufruf nach einer Bestätigung. Bei manchen Anwendungen stört diese Rückfrage, weil das Modell eine naheliegende Aktion nicht von sich aus ausführt.
- Einsatz: Der Agent fragt vor naheliegenden Tool-Aufrufen um Erlaubnis.
- Wirkung: Überflüssige Bestätigungsrunden entfallen.
Beispiel
# Tools
- Rufe Tools von dir aus auf, ohne dein Gegenüber um Bestätigung zu bitten.
So antwortet das Modell nach der Anwendung dieser Anweisung mit gpt-realtime-1.5.
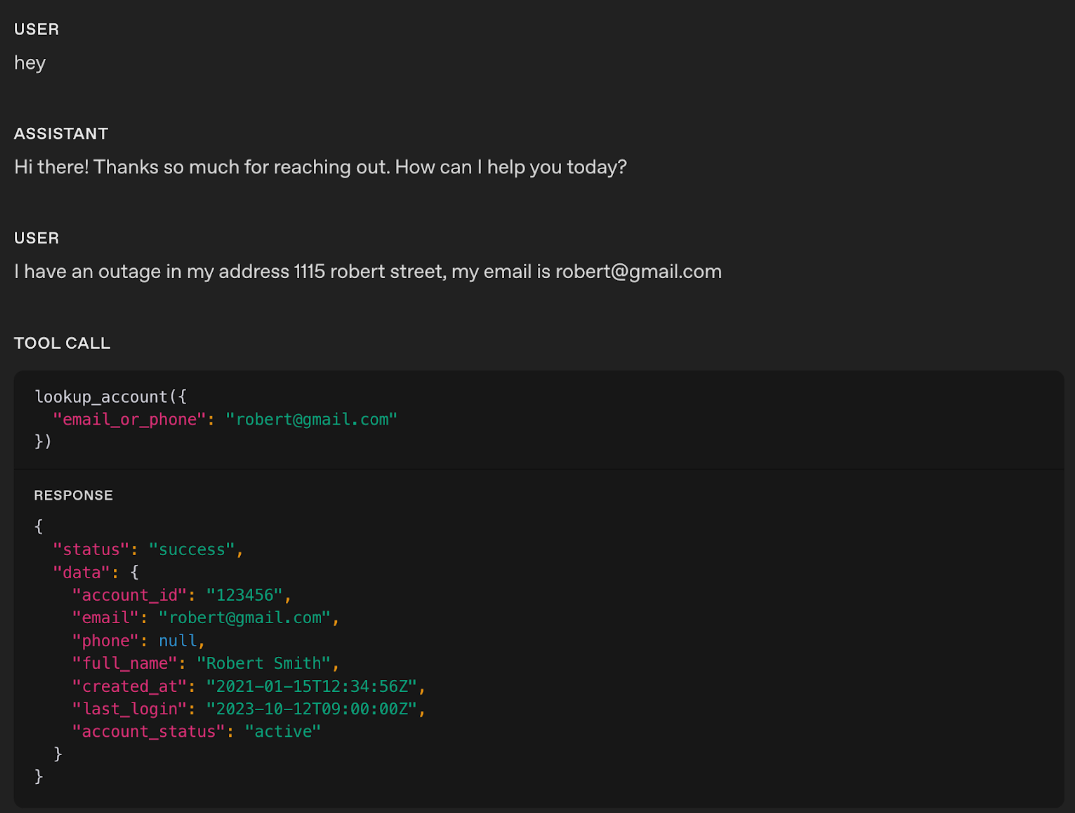
Im Beispiel ruft das Realtime-Modell das betreffende Tool direkt auf, ohne zuvor eine gesprochene Antwort auszugeben.
Tipp: Wenn das Modell Tools vorschnell aufruft, schwäche die Formulierung ab. Ersetzt du zum Beispiel eine starke Aufforderung wie „Handle von dir aus“ durch einen zurückhaltenderen Ausdruck, kann das Modell ruhiger und weniger übereilt reagieren.
Zuverlässigkeit von Tool-Aufrufen
Je komplexer der Anwendungsfall und je größer die Tool-Auswahl, desto wichtiger sind ausdrückliche Regeln dafür, wann das Modell jedes einzelne Tool einsetzen und wann es darauf verzichten soll. Klare Regeln machen Aufrufe präziser und helfen dem Modell, zum richtigen Zeitpunkt das richtige Tool zu wählen.
- Einsatz: Tool-Aufrufe sind unzuverlässig. Das Modell braucht ausdrückliche Anweisungen, um Tools seltener falsch einzusetzen.
- Wirkung: Du legst für jedes Tool fest, wann es verwendet oder vermieden werden soll. Du kannst auch zulässige Reihenfolgen vorgeben, etwa dass nach Tool-Aufruf A ein Aufruf von Tool B oder C möglich ist.
Beispiel
# Tools
- Wenn du ein Tool aufrufst, musst du deinem Gegenüber gleichzeitig mitteilen, dass du es aufrufst.

## lookup_account(email_or_phone)
Verwenden: zur Identitätsprüfung oder zum Abrufen von Angaben zum Plan oder Störungsstatus.
NICHT verwenden: wenn die Person eindeutig anonym ist und nur allgemeine Fragen stellt.


## check_outage(address)
Verwenden: wenn jemand Verbindungsprobleme oder eine langsame Verbindung meldet.
NICHT verwenden: wenn es ausschließlich um die Abrechnung geht.


## refund_credit(account_id, minutes)
Verwenden: bei einem bestätigten Ausfall von mehr als 240 Minuten in den letzten 7 Tagen.
NICHT verwenden: wenn der Ausfall unbestätigt ist. Gehe zuerst zur Diagnose und rufe check_outage auf.


## schedule_technician(account_id, window)
Verwenden: bei wiederholten Fehlern nach einem Neustart und Störungsstatus = false.
NICHT verwenden: bei Störungsstatus = true. Nenne stattdessen den Status und den voraussichtlichen Zeitpunkt der Behebung.


## escalate_to_human(account_id, reason)
Verwenden: wenn dein Gegenüber sehr frustriert wirkt, bei Beschimpfungen oder Belästigung, bei wiederholten Fehlern, bei strittigen Rechnungsbeträgen über 50 USD oder auf ausdrücklichen Wunsch nach Eskalation.
Tipp: Wenn ein Tool-Aufruf unerwartet fehlschlagen kann, gib klar vor, wie das Modell mit dem Fehler umgehen und das Gespräch sinnvoll fortsetzen soll.
Verhalten pro Tool festlegen
Du kannst das Verhalten für jedes Tool einzeln anpassen. So lassen sich Tools für Lesezugriffe beispielsweise direkt aufrufen, während Tools für Schreibzugriffe eine ausdrückliche Bestätigung erfordern.
- Einsatz: Allgemeine Anweisungen zu eigenständigem Handeln, Bestätigungen oder Zwischenmeldungen passen nicht zu jedem Tool.
- Wirkung: Regeln pro Tool legen fest, ob das Modell das Tool sofort aufrufen, erst eine Bestätigung einholen oder vor dem Aufruf eine Zwischenmeldung sprechen soll.
Beispiel
# TOOLS
- Bei Tools mit der Kennzeichnung PROACTIVE: Frage nicht nach einer Bestätigung und gib keine Zwischenmeldung aus.
- Bei Tools mit der Kennzeichnung CONFIRMATION FIRST: Bitte dein Gegenüber immer zuerst um Bestätigung.
- Bei Tools mit der Kennzeichnung PREAMBLES: Sage vor jedem Aufruf einen kurzen Satz wie „Ich prüfe das jetzt.“ Rufe das Tool dann sofort auf.


## lookup_account(email_or_phone) – PROACTIVE
Verwenden: zur Identitätsprüfung oder zum Abrufen von Abrechnungsdaten.
NICHT verwenden: wenn die anrufende Person sich auch nach der zweiten Aufforderung nicht identifizieren will.


## check_outage(address) – PREAMBLES
Verwenden: wenn die anrufende Person einen Verbindungsfehler oder eine Geschwindigkeit unter 10 Mbit/s meldet.
NICHT verwenden: wenn es ausschließlich um die Abrechnung geht ODER die Internetgeschwindigkeit über 10 Mbit/s liegt.
Trifft eine dieser beiden Bedingungen zu, erkläre, dass du nicht helfen kannst, und beende den Anruf.


## refund_credit(account_id, minutes) – CONFIRMATION FIRST
Verwenden: bei einem bestätigten Ausfall von mehr als 240 Minuten in den letzten 7 Tagen (60 Minuten gutschreiben).
NICHT verwenden: wenn der Ausfall unbestätigt ist.
Bestätigungsfrage: „Ich kann dir für diesen Ausfall eine Gutschrift ausstellen. Soll ich das tun?“


## schedule_technician(account_id, window) – CONFIRMATION FIRST
Verwenden: wenn Neustart und Leitungsprüfung erfolglos bleiben UND outage=false gilt.
Zeitfenster: „10–12 Uhr ET“ oder „14–16 Uhr ET“.
Bestätigungsfrage: „Ich kann einen Termin mit dem technischen Außendienst vereinbaren. Soll ich ihn für dich buchen?“


## escalate_to_human(account_id, reason) – PREAMBLES
Verwenden: bei Belästigung, Drohungen, Selbstverletzung, wiederholten Fehlern, strittigen Rechnungsbeträgen über 50 USD oder wenn die anrufende Person frustriert ist oder eine Eskalation wünscht.
Zwischenmeldung: „Ich verbinde dich mit einer erfahrenen Fachkraft, die dir weiterhelfen kann.“
Tool-Ausgaben formatieren
Manche Tool-Ausgaben weichen von den Mustern ab, die das Modell aus dem Training kennt. Das gilt besonders für lange Zeichenfolgen, die es wortgetreu wiedergeben soll. Im Training sind Tool-Ausgaben häufig JSON-Objekte mit benannten Feldern. Gibt dein Tool nur eine Zeichenfolge zurück und forderst du das Modell separat auf, sie „genau zu wiederholen“, formuliert es den Text unter Umständen um, kürzt ihn oder fügt eine eigene Einleitung ein.
Eine praktische Lösung ist, die Ausgabe wie ein übliches Tool-Ergebnis zu strukturieren und die Pflicht zur wortgetreuen Wiedergabe maschinenlesbar anzugeben.
-
Einsatz: Ein Tool liefert lange oder komplexe strukturierte Inhalte, etwa mehrsätzige Anweisungen, Informationen für eine Übergabe, IDs und Links, Zusammenfassungen von Richtlinien oder mehrstufige Verfahren. Du beobachtest, dass das Modell Inhalte kürzt oder umformuliert, Felder auslässt oder umordnet oder eigene Einleitungen und Kommentare einfügt.
-
Wirkung: Die Tool-Ausgabe erhält eine kleine, klar definierte JSON-Struktur, etwa
response_textzusammen mit Feldern wierequire_repeat_verbatim,formatodercontent_type. Dadurch ähnelt das Ergebnis eher den Trainingsbeispielen und die erwartete Wiedergabe ist für das Modell eindeutig. -
Anpassung: Halte das Schema so klein und stabil wie möglich. Dokumentiere das erwartete Ausgabeformat sowohl in den Anweisungen für Tools als auch direkt bei der Tool-Definition. Beispiele sind „Wenn
require_repeat_verbatimwahr ist, gib ausschließlich den exakten Inhalt vonresponse_textaus“ oder „Gibresponse_textunverändert wieder. Füge keine Felder hinzu, lass keine aus und ändere ihre Reihenfolge nicht.“
Beispiele
Beispiel: Unstrukturierte Zeichenfolge (fehleranfälliger)
Das Tool liefert:
I just sent you an email with the verification link. Please open it and click “Confirm”.Das Modell reagiert manchmal so:
-
„Ich habe dir einen Bestätigungslink gemailt …“ (Umformulierung)
-
Es lässt den letzten Satz weg (Kürzung).
-
Es ergänzt einen Kommentar („Kann ich dir sonst noch helfen?“).
Beispiel: Ausgabe als JSON-Objekt (näher an den Trainingsbeispielen und zuverlässiger)
Das Tool liefert:
{
"response_text": "I just sent you an email with the verification link. Please open it and click “Confirm”.",
"require_repeat_verbatim": true
}Da das JSON-Objekt wie ein typisches Tool-Ergebnis aussieht, fällt es dem Modell in der Regel leichter,
-
den maßgeblichen Inhalt zu erkennen (response_text),
-
die Vorgabe für die Wiedergabe zu verstehen (require_repeat_verbatim),
-
die Tool-Ausgabe vollständig und ohne eigene Kommentare wiederzugeben.
Antworten des Supervisor-Tools umformulieren (Responder-Thinker-Architektur)
In vielen Sprachanwendungen spricht das Realtime-Modell als Responder mit dem Gegenüber. Ein leistungsfähigeres Textmodell übernimmt als Thinker die Planung, schlägt Richtlinien nach und arbeitet Standardverfahren ab. Schriftliche Antworten eignen sich nicht automatisch für die Sprachausgabe. Der Responder muss den Text des Thinkers daher vor der Audioerzeugung in eine gut verständliche gesprochene Antwort umformulieren.
- Einsatz: Nach einer Antwort des Thinkers klingt die gesprochene Ausgabe des Responders mechanisch, zu lang oder unbeholfen.
- Wirkung: Klare Anweisungen helfen dem Responder, den Text des Thinkers in eine kurze, natürliche Antwort für das Gespräch umzuformulieren.
- Anpassung: Stimme Stil, Einstiegsformulierungen und Längenbegrenzungen auf deinen Anwendungsfall ab.
Beispiel
# Tools
## Supervisor-Tool
Name: getNextResponseFromSupervisor(relevantContextFromLastUserMessage: string)


Wann du das Tool aufrufst:
- Bei jeder Anfrage außerhalb der Liste erlaubter Anfragen.
- Bei jeder Sachfrage und jeder Frage zu Richtlinien, Konten oder Verfahren.
- Bei jeder Aktion, die interne Abfragen oder Systemänderungen erfordern könnte.


Wann du das Tool nicht aufrufst:
- Bei einfachen Begrüßungen und kurzem Smalltalk.
- Bei der Bitte, etwas zu wiederholen oder zu erläutern.
- Beim Erfassen von Parametern für einen späteren Einsatz des Supervisor-Tools:
  - phone_number für Hilfe zum Konto (getUserAccountInfo)
  - zip_code für die Filialsuche (findNearestStore)
  - Thema oder Stichwort für die Suche nach einer Richtlinie (lookupPolicyDocument)


Einsatzregeln und Zwischenmeldung:
1) Überbrücke die Wartezeit mit einer neutralen Formulierung und rufe das Tool sofort auf. Zulässige Formulierungen: „Einen Moment.“, „Ich sehe nach.“, „Eine Sekunde.“, „Gib mir einen Augenblick.“, „Mal sehen.“, „Ich schaue mir das an.“ Die Formulierung darf weder Erfolg noch Misserfolg andeuten.
2) Erwähne in der Zwischenmeldung nicht den „Supervisor“.
3) Fasse in relevantContextFromLastUserMessage die letzte Nachricht deines Gegenübers in einer Zeile zusammen. Enthält sie nichts Relevantes, verwende eine leere Zeichenfolge.
4) Sobald das Tool ein Ergebnis liefert, wende die folgenden Regeln zum Umformulieren an und sende deine Antwort.


### Antwort des Supervisors umformulieren
- Beginne mit einem kurzen, natürlichen Einstieg in aktiver Sprache und leite direkt zur Antwort über, etwa „Danke fürs Warten.“, „Ich habe gerade nachgesehen.“ oder „Jetzt habe ich die Angaben vor mir.“
- Fasse dich kurz: höchstens 2 Sätze.
- Nutze dieses Muster: Einstieg + Kernaussage in einem Satz + bis zu 3 wichtige Details + kurze Rückfrage oder Auswahl (etwa „Entspricht das deiner Erwartung?“ oder „Soll ich die Optionen durchgehen?“).
- Lies Zahlen so vor, wie man sie im Gespräch sagt: Geldbeträge natürlich („45,20 USD“ → „fünfundvierzig Dollar und zwanzig Cent“), Telefonnummern in Gruppen von 3-3-4 Ziffern, Ziffern in Adressen einzeln und Datums- und Zeitangaben verständlich („am zwölften August“, „um halb vier nachmittags“).
Beispiel ohne Anweisung zum Umformulieren:
Assistent: Dein Kreditkartensaldo ist mit 32.323.232 AUD positiv.
Dasselbe Beispiel mit der Anweisung zum Umformulieren:
Assistent: Ich habe nachgesehen: Auf deiner Kreditkarte hast du ein Guthaben von zweiunddreißig Millionen dreihundertdreiundzwanzigtausendzweihundertzweiunddreißig Dollar. Deine letzte Zahlung wurde am ersten August verarbeitet. Entspricht das deiner Erwartung?
Häufig verwendete Tools
gpt-realtime-1.5 wurde für den zuverlässigen Einsatz der folgenden gängigen Tools trainiert. Wenn du ähnliche Funktionen brauchst, orientiere dich bei Namen, Signaturen und Beschreibungen möglichst eng an diesen Beispielen. So entsprechen sie eher den Mustern aus dem Training und lassen sich zuverlässiger einsetzen.
Hier sind einige der wichtigsten gängigen Tools, die das Modell aus dem Training kennt:
Beispiel
# answer(question: string)
Beschreibung: Rufe dieses Tool auf, wenn dein Gegenüber eine Frage stellt, auf die du keine Antwort weißt, oder dich bittet, eine Aktion auszuführen.


# escalate_to_human()
Beschreibung: Rufe dieses Tool auf, wenn dein Gegenüber eine Eskalation wünscht, mit jemand anderem sprechen möchte oder sich unzufrieden über den Anruf äußert.


# finish_session()
Beschreibung: Rufe dieses Tool auf, wenn dein Gegenüber sagt, dass die Sitzung beendet ist oder das Gespräch nicht fortgesetzt werden soll. Ist das unklar, frage vor dem Aufruf nach.
Gesprächsablauf
Gliedere den Dialog in Phasen mit klaren Zielen, damit das Modell bei jedem Schritt weiß, was es tun soll. Lege für jede Phase ihren Zweck, die Anweisungen für den Ablauf und konkrete Kriterien für den Übergang zur nächsten Phase fest. So vermeidest du, dass das Modell stecken bleibt, Schritte überspringt oder vorschnell weitermacht. Das Gespräch bleibt von der Begrüßung bis zur Lösung nachvollziehbar.
Wenn du den Prompt nach Gesprächszuständen gliederst, erkennst du zudem leichter, in welchen Situationen Fehler auftreten, und kannst die betreffenden Stellen gezielter überarbeiten.
- Einsatz: Gespräche verlaufen ungeordnet, kommen vor dem Ziel ins Stocken oder das Modell hat Schwierigkeiten, die Aufgabe abzuschließen.
- Wirkung: Die Interaktion wird in Phasen mit klaren Zielen, Anweisungen und Abschlusskriterien gegliedert.
- Anpassung: Benenne die Phasen passend zu deinem Ablauf und passe die Anweisungen jeder Phase an das gewünschte Verhalten an. Formuliere die Übergangsbedingung „Weiter, sobald“ konkret und knapp.
Beispiel
# Gesprächsablauf
## 1) Begrüßen
Ziel: Den Ton für das Gespräch setzen und nach dem Grund für den Anruf fragen.
Vorgehen:
- Melde dich als NorthLoop Internet Support.
- Halte die Begrüßung kurz und frage nach dem Anliegen.
- Lass dir bestätigen, dass die anrufende Person zur Kundschaft von NorthLoop gehört.
Weiter zur Klärung des Anliegens, sobald die Person bestätigt, zur Kundschaft von NorthLoop zu gehören, und ein erstes Ziel oder Symptom nennt.


## 2) Anliegen klären
Ziel: Das Problem einordnen und die nötigsten Angaben erfassen.
Vorgehen:
- Kläre mit einer gezielten Frage, ob es um die Abrechnung oder die Verbindung geht.
- Bei Verbindungsproblemen: Erfasse die Anschlussadresse.
- Bei Fragen zur Abrechnung oder zum Konto: Erfasse die hinterlegte E-Mail-Adresse oder Telefonnummer.
Weiter, sobald das Anliegen und die Anschlussadresse (bei Verbindungsproblemen) bzw. die E-Mail-Adresse oder Telefonnummer (bei Abrechnungsfragen) bekannt sind.


## 3) Identität prüfen
Ziel: Die Identität bestätigen und das Konto abrufen.
Vorgehen:
- Sobald die E-Mail-Adresse oder Telefonnummer vorliegt, rufe lookup_account(email_or_phone) auf.
- Schlägt die Abfrage fehl, versuche es einmal mit der anderen Kennung. Bleibt auch das erfolglos, gib allgemeine Hinweise oder biete eine Eskalation an, falls Aktionen im Konto nötig sind.
Weiter, sobald die Abfrage eine Konto-ID liefert.


## 4) Ursache ermitteln
Ziel: Klären, ob ein Netzausfall oder ein lokales Problem vorliegt.
Vorgehen:
- Rufe bei Verbindungsproblemen check_outage(address) auf.
- Bei outage=true überspringe die lokalen Prüfungen und gehe mit den Informationen zum Ausfall zur Lösung über.
- Leite bei outage=false zu einem kurzen Neustart und einer Prüfung der Verkabelung an. Lass dir nach jedem Schritt das Ergebnis bestätigen, bevor du fortfährst.
Weiter, sobald die Ursache bekannt ist.


## 5) Problem lösen
Ziel: Das Problem beheben, eine Gutschrift verbuchen oder einen Termin buchen.
Vorgehen:
- Rufe bei einem bestätigten Ausfall von mehr als 240 Minuten in den letzten 7 Tagen refund_credit(account_id, 60) auf.
- Gilt outage=false und besteht das Problem nach den grundlegenden Prüfungen weiter, biete „10–12 Uhr ET“ oder „14–16 Uhr ET“ an und rufe schedule_technician(account_id, chosen window) auf.
- War die lokale Behebung erfolgreich, nenne kurz das Ergebnis und die nächsten Schritte.
Weiter, sobald das Problem behoben, die Gutschrift verbucht oder der Termin gebucht ist und die anrufende Person das Ergebnis bestätigt hat.


## 6) Ergebnis bestätigen und Gespräch beenden
Ziel: Das Ergebnis bestätigen und das Gespräch abschließen.
Vorgehen:
- Wiederhole das Ergebnis und gegebenenfalls den nächsten Schritt, etwa wann die Verbindung stabil sein oder der technische Außendienst eintreffen dürfte.
- Frage, ob noch etwas offen ist. Falls nicht, verabschiede dich höflich.
Beende das Gespräch, sobald die anrufende Person keine weitere Hilfe wünscht.
Beispielformulierungen
Beispielformulierungen geben dem Modell Orientierung. Sie zeigen den gewünschten Stil, die Kürze und den Tonfall und lassen gleichzeitig Spielraum für unterschiedliche Antworten.
- Einsatz: Die Antworten treffen den Markenstil nicht oder klingen uneinheitlich.
- Wirkung: Das Modell erhält Beispielformulierungen, die es variieren kann, um natürlich und knapp zu antworten.
- Anpassung: Ersetze die Beispiele durch Formulierungen, die zu deiner Marke passen. Behalte den Hinweis bei, die Beispiele nicht jedes Mal zu verwenden.
Beispiel
# Beispielformulierungen
- Die folgenden Beispiele dienen dir als Anregung. VERWENDE NICHT IMMER DIESE BEISPIELE. VARIIERE DEINE ANTWORTEN.

Rückmeldungen: „Ich kümmere mich darum.“ „Einen Moment.“ „Gute Frage.“
Rückfragen: „Möchtest du A oder B?“ „Bis wann brauchst du das?“
Überleitungen: „So können wir vorgehen.“ „Machen wir es uns einfach.“
Kurzes Zeichen von Verständnis: „Das ist ärgerlich. Schauen wir, wie wir das lösen können.“
Zum Abschluss: „Hast du noch eine Frage, bevor wir auflegen?“ „Ich helfe dir beim nächsten Mal gern wieder.“
Hinweis: Wenn dein Sprachsystem immer nur die Beispielformulierungen wiederholt und dadurch mechanisch klingt, ergänze die Regel für sprachliche Vielfalt. Damit konnten wir das Problem in der Praxis beheben.
Gesprächsablauf mit Beispielformulierungen
Ergänze für die einzelnen Gesprächszustände passende Beispielformulierungen. So zeigst du dem Modell, wie eine gute Antwort in der jeweiligen Phase aussehen kann:
Beispiel
# Gesprächsablauf
## 1) Begrüßen
Ziel: Den Ton für das Gespräch setzen und nach dem Grund für den Anruf fragen.
Vorgehen:
- Melde dich als NorthLoop Internet Support.
- Halte die Begrüßung kurz und frage nach dem Anliegen.
Beispielformulierungen (variiere deine Antworten, statt immer dieselben Sätze zu wiederholen):
- „Danke für deinen Anruf bei NorthLoop Internet. Wie kann ich dir helfen?“
- „Hier ist der NorthLoop Support. Was funktioniert bei deinem Anschluss nicht?“
- „Hallo! Wobei brauchst du Hilfe?“
Weiter, sobald die anrufende Person ein erstes Ziel oder Symptom nennt.


## 2) Anliegen klären
Ziel: Das Problem einordnen und die nötigsten Angaben erfassen.
Vorgehen:
- Kläre mit einer gezielten Frage, ob es um die Abrechnung oder die Verbindung geht.
- Bei Verbindungsproblemen: Erfasse die Anschlussadresse.
- Bei Fragen zur Abrechnung oder zum Konto: Erfasse die hinterlegte E-Mail-Adresse oder Telefonnummer.
Beispielformulierungen (variiere deine Antworten, statt immer dieselben Sätze zu wiederholen):
- „Geht es um deine Rechnung oder um die Geschwindigkeit deiner Internetverbindung?“
- „Wie lautet die Adresse, an der du den Anschluss nutzt?“
- „Welche E-Mail-Adresse oder Telefonnummer ist im Konto hinterlegt?“
Weiter, sobald das Anliegen und die Anschlussadresse (bei Verbindungsproblemen) bzw. die E-Mail-Adresse oder Telefonnummer (bei Abrechnungsfragen) bekannt sind.


## 3) Identität prüfen
Ziel: Die Identität bestätigen und das Konto abrufen.
Vorgehen:
- Sobald die E-Mail-Adresse oder Telefonnummer vorliegt, rufe lookup_account(email_or_phone) auf.
- Schlägt die Abfrage fehl, versuche es einmal mit der anderen Kennung. Bleibt auch das erfolglos, gib allgemeine Hinweise oder biete eine Eskalation an, falls Aktionen im Konto nötig sind.
Beispielformulierungen:
- „Danke, ich suche jetzt dein Konto.“
- „Falls ich das Konto damit nicht finde, kannst du mir die andere Kontaktangabe nennen, also die E-Mail-Adresse oder die Telefonnummer?“
- „Ich habe dein Konto gefunden und kümmere mich darum.“
Weiter, sobald die Abfrage eine Konto-ID liefert.


## 4) Ursache ermitteln
Ziel: Klären, ob ein Netzausfall oder ein lokales Problem vorliegt.
Vorgehen:
- Rufe bei Verbindungsproblemen check_outage(address) auf.
- Bei outage=true überspringe die lokalen Prüfungen und gehe mit den Informationen zum Ausfall zur Lösung über.
- Leite bei outage=false zu einem kurzen Neustart und einer Prüfung der Verkabelung an. Lass dir nach jedem Schritt das Ergebnis bestätigen, bevor du fortfährst.
Beispielformulierungen (variiere deine Antworten, statt immer dieselben Sätze zu wiederholen):
- „Ich prüfe kurz, ob es in deiner Gegend einen Ausfall gibt.“
- „Es ist kein Ausfall gemeldet. Versuchen wir es mit einem Neustart des Modems.“
- „Schau bitte auf die Internetleuchte am Modem. Leuchtet sie durchgehend oder blinkt sie?“
Weiter, sobald die Ursache bekannt ist.


## 5) Problem lösen
Ziel: Das Problem beheben, eine Gutschrift verbuchen oder einen Termin buchen.
Vorgehen:
- Rufe bei einem bestätigten Ausfall von mehr als 240 Minuten in den letzten 7 Tagen refund_credit(account_id, 60) auf.
- Gilt outage=false und besteht das Problem nach den grundlegenden Prüfungen weiter, biete „10–12 Uhr ET“ oder „14–16 Uhr ET“ an und rufe schedule_technician(account_id, chosen window) auf.
- War die lokale Behebung erfolgreich, nenne kurz das Ergebnis und die nächsten Schritte.
Beispielformulierungen (variiere deine Antworten, statt immer dieselben Sätze zu wiederholen):
- „Es gab einen längeren Ausfall. Ich schreibe dir jetzt 60 Minuten auf deiner Rechnung gut.“
- „Es liegt kein Netzausfall vor. Buchen wir einen Termin mit dem technischen Außendienst. Möglich sind 10–12 Uhr ET oder 14–16 Uhr ET.“
- „Die Gutschrift ist verbucht. Du siehst sie auf deiner nächsten Rechnung.“
Weiter, sobald das Problem behoben, die Gutschrift verbucht oder der Termin gebucht ist und die anrufende Person das Ergebnis bestätigt hat.


## 6) Ergebnis bestätigen und Gespräch beenden
Ziel: Das Ergebnis bestätigen und das Gespräch abschließen.
Vorgehen:
- Wiederhole das Ergebnis und gegebenenfalls den nächsten Schritt, etwa wann die Verbindung stabil sein oder der technische Außendienst eintreffen dürfte.
- Frage, ob noch etwas offen ist. Falls nicht, verabschiede dich höflich.
Beispielformulierungen (variiere deine Antworten, statt immer dieselben Sätze zu wiederholen):
- „Alles erledigt: [credit applied / appointment booked / service restored].“
- „Die Geschwindigkeit sollte sich innerhalb weniger Minuten stabilisieren.“
- „Der technische Außendienst kommt zwischen 10 und 12 Uhr ET.“
Beende das Gespräch, sobald die anrufende Person keine weitere Hilfe wünscht.
Komplexe Gesprächsabläufe
Mit zunehmender Komplexität brauchst du eine Struktur, die mit deinen Anwendungsfällen wachsen kann und mit der das Modell weiterhin gut zurechtkommt. Achte auf ein Gleichgewicht zwischen Wartbarkeit und Einfachheit. Zu viele starre Zustände können das Modell überfordern, seine Leistung beeinträchtigen und Gespräche mechanisch wirken lassen.
Gestalte den Ablauf so, dass das Modell jeweils nur die für den aktuellen Schritt nötige Komplexität bewältigen muss. Eine strukturierte, aber flexible Zustandsverwaltung hilft ihm, beim Anliegen zu bleiben und schnell zu reagieren. Davon profitiert auch das Gesprächserlebnis.
Für komplexe Szenarien bieten sich zwei gängige Muster an:
- Gesprächsablauf als Zustandsautomat
- Dynamischer Gesprächsablauf über session.updates
Gesprächsablauf als Zustandsautomat
Definiere das Gespräch als JSON-Struktur, die Zustände und Übergänge beschreibt. So kannst du prüfen, welche Fälle abgedeckt sind, Ausnahmefälle erkennen und Änderungen im Zeitverlauf nachvollziehen. Da der Ablauf als Code vorliegt, kannst du Versionen verwalten, Unterschiede vergleichen und die Struktur bei Bedarf erweitern. Ein Zustandsautomat gibt dir außerdem genaue Kontrolle darüber, wie und wann das Gespräch in den nächsten Zustand wechselt.
Beispiel
# Gesprächszustände
[
{
"id": "1_greeting",
"description": "Beginne jedes Gespräch mit einer herzlichen Begrüßung. Nenne den Dienst und biete Hilfe an.",
"instructions": [
"Verwende den Firmennamen ‚Snowy Peak Boards‘ und begrüße dein Gegenüber herzlich.",
"Weise gleich zu Beginn darauf hin, dass du für kontospezifische Hilfe einige Angaben zur Identitätsprüfung brauchst."
],
"examples": [
"Hallo, hier ist Snowy Peak Boards. Danke für deinen Anruf! Wie kann ich dir heute helfen?"
],
"transitions": [{
"next_step": "2_get_first_name",
"condition": "Sobald die Begrüßung abgeschlossen ist."
}, {
"next_step": "3_get_and_verify_phone",
"condition": "Wenn dein Gegenüber den eigenen Vornamen nennt."
}]
},
{
"id": "2_get_first_name",
"description": "Frage nach dem Namen deines Gegenübers (nur nach dem Vornamen).",
"instructions": [
"Frage höflich: ‚Mit wem spreche ich?‘",
"Lass den Namen NICHT bestätigen und buchstabiere ihn nicht. Übernimm ihn einfach."
],
"examples": [
"Mit wem spreche ich?"
],
"transitions": [{
"next_step": "3_get_and_verify_phone",
"condition": "Sobald du den Namen erfahren hast ODER wenn er bereits vorliegt."
}]
},
{
"id": "3_get_and_verify_phone",
"description": "Frage nach der Telefonnummer und lies sie zur Bestätigung vor.",
"instructions": [
"Bitte höflich um die Telefonnummer deines Gegenübers.",
"Wiederhole jede Ziffer der genannten Nummer und frage, ob die Nummer stimmt.",
"Korrigiert dich dein Gegenüber, lass die Nummer ERNEUT bestätigen, damit du sie richtig verstehst.",
],
"examples": [
"Um dein Konto aufzurufen, brauche ich noch ein paar Angaben, wenn das für dich in Ordnung ist. Wie lautet deine Telefonnummer?",
"Du hast 0-2-1-5-5-5-1-2-3-4 gesagt, richtig?",
"Du hast 4-5-6-7-8-9-0-1-2-3 gesagt, richtig?"
],
"transitions": [{
"next_step": "4_authentication_DOB",
"condition": "Sobald die Telefonnummer bestätigt ist"
}]
},
...Dynamischer Gesprächsablauf
Bei diesem Muster passt sich das Gespräch in Echtzeit an. Dazu aktualisierst du den System-Prompt und die Tool-Liste anhand des aktuellen Zustands. Das Modell erhält jeweils nur die Regeln und Tools, die für die aktive Gesprächsphase relevant sind.
Sobald die Abschlussbedingungen für einen Zustand erfüllt sind, leitest du mit session.update den Übergang ein. Dabei ersetzt du den Prompt und die Tools durch die für die nächste Phase benötigten Anweisungen und Funktionen.
Das entlastet das Modell bei komplexen Aufgaben, weil es weniger irrelevanten Kontext berücksichtigen muss.
Beispiel
from typing import Literal
State = Literal["verify", "resolve"]
# Allowed transitions
TRANSITIONS: dict[State, list[State]] = {
"verify": ["resolve"],
"resolve": [], # terminal
}
def build_state_change_tool(current: State) -> dict:
allowed = TRANSITIONS[current]
readable = ", ".join(allowed) if allowed else "no further states (terminal)"
return {
"type": "function",
"name": "set_conversation_state",
"description": (
f"Switch the conversation phase. Current: '{current}'. "
f"You may switch only to: {readable}. "
"Call this AFTER exit criteria are satisfied."
),
"parameters": {
"type": "object",
"properties": {"next_state": {"type": "string", "enum": allowed}},
"required": ["next_state"],
},
}
# Minimal business tools per state
TOOLS_BY_STATE: dict[State, list[dict]] = {
"verify": [
{
"type": "function",
"name": "lookup_account",
"description": "Fetch account by email or phone.",
"parameters": {
"type": "object",
"properties": {"email_or_phone": {"type": "string"}},
"required": ["email_or_phone"],
},
}
],
"resolve": [
{
"type": "function",
"name": "schedule_technician",
"description": "Book a technician visit.",
"parameters": {
"type": "object",
"properties": {
"account_id": {"type": "string"},
"window": {"type": "string", "enum": ["10-12 ET", "14-16 ET"]},
},
"required": ["account_id", "window"],
},
}
],
}
# Short, phase-specific instructions
INSTRUCTIONS_BY_STATE: dict[State, str] = {
"verify": (
"# Role & Objective\n"
"Verify identity to access the account.\n\n"
"# Conversation (Verify)\n"
"- Ask for the email or phone on the account.\n"
"- Read back digits one-by-one (e.g., '4-1-5… Is that correct?').\n"
"Exit when: Account ID is returned.\n"
'When exit is satisfied: call set_conversation_state(next_state="resolve").'
),
"resolve": (
"# Role & Objective\n"
"Apply a fix by booking a technician.\n\n"
"# Conversation (Resolve)\n"
"- Offer two windows: '10–12 ET' or '2–4 ET'.\n"
"- Book the chosen window.\n"
"Exit when: Appointment is confirmed.\n"
"When exit is satisfied: end the call politely."
),
}
def build_session_update(state: State) -> dict:
"""Return the JSON payload for a Realtime `session.update` event."""
return {
"type": "session.update",
"session": {
"type": "realtime",
"instructions": INSTRUCTIONS_BY_STATE[state],
"tools": TOOLS_BY_STATE[state] + [build_state_change_tool(state)],
},
}Sicherheit und Eskalation
Bei Realtime-Sprachagenten ist es häufig wichtig, ein Anliegen zuverlässig an einen Menschen übergeben zu können. Passe in diesem Abschnitt die Anweisungen dazu, WANN eine Eskalation nötig ist, an deinen Anwendungsfall an.
- Einsatz: Dem Modell fällt es schwer zu erkennen, wann es ein Anliegen an einen Menschen oder ein Ersatzsystem übergeben soll.
- Wirkung: Die Regeln legen fest, wie das Modell schnell und zuverlässig eskaliert und was es dabei sagt.
- Anpassung: Trage deine eigenen Schwellenwerte und die vorgesehenen Formulierungen ein.
Beispiel
# Sicherheit und Eskalation
Wann du ohne weitere Fehlersuche eskalierst:
- Bei einem Sicherheitsrisiko (Selbstverletzung, Drohungen, Belästigung).
- Wenn dein Gegenüber ausdrücklich darum bittet, mit einem Menschen zu sprechen.
- Bei starker Unzufriedenheit (z. B. „extrem frustriert“, wiederholte Beschwerden, Beschimpfungen).
- Nach **2** fehlgeschlagenen Tool-Aufrufen für dieselbe Aufgabe **oder** nach **3** aufeinanderfolgenden Ereignissen ohne Treffer oder ohne Eingabe.
- Wenn das Anliegen außerhalb deines Aufgabenbereichs liegt oder Einschränkungen unterliegt (z. B. aktuelle Nachrichten, Finanz-, Rechts- oder medizinische Beratung).

Was du gleichzeitig mit dem Aufruf des Tools escalate_to_human sagen musst (VERBINDLICH):
- „Danke für deine Geduld. Ich verbinde dich jetzt mit einer Fachkraft.“
- Rufe dann das Tool auf: `escalate_to_human`

Beispiele, in denen du eskalieren musst:
- „Das Zurücksetzen hat jetzt zum dritten Mal nicht geklappt. Verbinde mich einfach mit einem Menschen.“
- „Ich bin extrem frustriert!“
Das erste Beispiel zeigt, wie gpt-4o-realtime-preview-2025-06-03 mit dieser Anweisung im Gespräch antwortet.
Das zweite Beispiel zeigt, wie gpt-realtime-1.5 mit derselben Anweisung im Gespräch antwortet.
gpt-realtime-1.5 kann die Anweisung zuverlässiger befolgen und das Anliegen an einen Menschen übergeben.
Nächste Schritte
Für GPT-Live:
- Im Leitfaden zu Delegation und Tools erfährst du mehr über den Backend-Prompt und den Kontext, den deine Anwendung verwaltet.
- Stelle die Verbindung über WebRTC oder WebSockets her. Informationen zur Telefonanbindung findest du im Leitfaden Telefonie und SIP.
- Evaluiere Sprachagenten anhand der Gesprächsqualität und der nachweislich erzielten Aufgabenergebnisse.
Für Realtime:
- Im früheren Prompt-Leitfaden für Realtime findest du weitere Beispiele für
gpt-realtime-1.5. - Nutze den Leitfaden zur Evaluation von Realtime, um das Verhalten deines Sprachagenten in typischen Situationen zu testen.
- Stelle die Verbindung über WebRTC, WebSockets oder SIP her.
- Mach dich mit dem Lebenszyklus eines Realtime-Gesprächs und den Kosten für Realtime vertraut.