Wähle deine API aus, um zu erfahren, wie sie die Nutzung misst und wie du die Kosten deiner Sprachanwendung steuern kannst.
Nutzung und Kosten von GPT-Live
Bei GPT-Live läuft das Sprachgespräch getrennt vom Backend, das Aufgaben durchdenkt und Tools ausführt. Schätze die Kosten für beide Teile separat. Die Kosten der Sprachsitzung richten sich nach ihrer Dauer, die Backend-Kosten nach den verwendeten Modellen und Tools.
Kosten der Sprachsitzung
GPT-Live rechnet Sprachsitzungen sekundengenau zum aktuellen Preis des Modells ab. Die Sitzungsdauer wird nicht auf die nächste volle Minute aufgerundet.
Zur aktiven Sitzungszeit zählt die Zeit, in der die Person spricht, der Assistent spricht, beide schweigen oder das Backend arbeitet.
Rechne für deine Schätzung mit der gesamten aktiven Sitzungszeit vom Start bis zum Schließen. Verwende die von der API gemeldete Dauer. Wenn du nur die Wiedergabezeit misst, erfasst du lediglich einen Teil der Sitzung. Das Stummschalten des Mikrofons beendet die Sitzung nicht. Schließe die Sitzung, sobald das Gespräch beendet ist, und erfasse die abschließenden Nutzungsdaten.
Die Preise für Backend-Modelle und Tools findest du in der API-Preisübersicht.
Kosten für die WebRTC-Initialisierung
Bei einer Anfrage mit POST /v1/live/sessions zum Erstellen einer WebRTC-Sitzung werden während der Initialisierung 15 Sekunden Sprachsitzungszeit berechnet. Sobald die Sitzung läuft, wird dieser Betrag auf die zeitabhängigen Sitzungskosten angerechnet. Addiere bei der Kostenschätzung für die laufende Sitzung keine weiteren 15 Sekunden.
Die 90 Sekunden im folgenden Beispiel enthalten bereits die 15 Sekunden, die bei der Initialisierung berechnet wurden. Eine Abrechnung über 105 Sekunden würde diese Zeit doppelt zählen. Berücksichtige die Kosten für das Erstellen einer Sitzung, wenn du Verbindungswiederherstellungen bewertest oder wenn deine Anwendung Sitzungen erstellt, bevor jemand zum Sprechen bereit ist.
Backend-Kosten
Backend-Aufrufe werden getrennt von der Sprachsitzung abgerechnet, genauso wie bei Anwendungen ohne Sprachfunktion. Berücksichtige die Eingabe- und Ausgabetoken des Modells, gegebenenfalls Eingaben aus dem Cache sowie anfallende Kosten für Bilder oder Tools. Beziehe auch die Kosten anderer Dienste ein, die deine Anwendung aufruft.
Du kannst die Verarbeitung im Backend unabhängig vom Sprach-Frontend optimieren. Im allgemeinen Leitfaden zur Kostenoptimierung erfährst du, wie du die Anzahl der Anfragen und den Tokenverbrauch reduzierst. Nutze bei Backend-Modellen, die es unterstützen, Prompt-Caching. Platziere dazu wiederverwendbare Anweisungen, Tool-Definitionen und andere gleichbleibende Inhalte am Anfang des Prompts.
Deine Entscheidungen im Backend können auch die Gesprächsdauer beeinflussen. Vergleiche die Gesamtkosten, wenn eine Optimierung die Wartezeit verlängert oder sich darauf auswirkt, wie zuverlässig der Assistent die Aufgabe erledigt.
Gesprächskosten schätzen
Für ein Gespräch mit einer Sprachsitzung gilt:
Gesamtkosten = (abrechenbare Sitzungsdauer in Sekunden ÷ 60 × Preis pro Sprachminute) + Backend-Kosten
Bei einem beispielhaften Preis von 0,05 USD pro Minute kostet eine Sprachsitzung von 90 Sekunden 0,075 USD. Fallen im Backend insgesamt 0,02 USD für Modell und Tools an, kostet das Gespräch 0,095 USD.
| Komponente | Berechnung | Kosten |
|---|---|---|
| Sprachsitzung | 90 Sekunden ÷ 60 × 0,05 USD | 0,075 USD |
| Verarbeitung im Backend | Summe der Modell- und Tool-Kosten | 0,02 USD |
| Gesamtkosten des Gesprächs | 0,075 USD + 0,02 USD | 0,095 USD |
Die Preise und Backend-Kosten in dieser Rechnung dienen als Beispiel. Verwende für deine Schätzung den aktuellen Preis pro Sprachminute, die gemessene Backend-Nutzung und die geltenden Preise für Modelle und Tools. Erstreckt sich eine Aufgabe über mehrere Sprachsitzungen, addiere deren Dauer und berücksichtige auch die Verarbeitung im Backend zwischen den Sitzungen.
Strategien zur Optimierung
Hilf der Person, ihre Aufgabe mit weniger unnötigen Gesprächsschritten und kürzeren Wartezeiten zu erledigen. Behalte die für die Aufgabe erforderlichen Bestätigungen und Prüfungen bei.
Relevanten Kontext vor der Sitzung bereitstellen
Trage vor Beginn der Sprachsitzung die Informationen zusammen, die deine Anwendung bereits verwenden darf. Hilft ein Assistent beispielsweise bei einer Bestellung, kann er mit der Bestellnummer und dem aktuellen Bestellstatus starten. So muss die Person diese Angaben weder wiederholen noch eine weitere Abfrage abwarten.
Halte den Kontext aktuell und beschränke ihn auf die Aufgabe. Stelle dem Modell die Informationen bereit, die es für das Sprachgespräch braucht. Detaillierte Datensätze und Arbeitsabläufe gehören ins Backend. Mehr dazu erfährst du in den Abschnitten Sitzungskonfiguration und Delegation und Tools.
Wartezeit bei Tool-Aufrufen verkürzen
Kürzere Wartezeiten können die Bedienung angenehmer machen und die Kosten der Sprachsitzung senken. Angenommen, dein Backend verwendet gpt-5.6-luna im Schnellmodus und führt unabhängige Tool-Aufrufe parallel aus. Kann die Person ihre Aufgabe dadurch eine Minute früher abschließen und die Sprachsitzung beenden, sparst du 0,05 USD an Sitzungskosten. Die Gesamtkosten sinken, wenn die zusätzlichen Backend-Kosten geringer sind als diese Ersparnis.
Du kannst auch anhand von Transkriptfragmenten vorsorglich eine Abfrage starten, bevor ein Delegationsereignis eintrifft. Erfasse bei der Messung deiner Backend-Kosten auch vorsorglich ausgeführte Vorgänge, deren Ergebnisse ungenutzt bleiben.
Der Abschnitt Backend-Latenz reduzieren erläutert, wie du Modellnutzung, Verbindungen, Streaming und Tool-Aufrufe optimieren kannst. Prüfe mit Evaluationen für Sprachagenten, wie lange es bis zu einer hilfreichen gesprochenen Antwort dauert und ob die Aufgabe erfolgreich abgeschlossen wird.
Sitzung bei länger dauernden Aufgaben schließen
Das Sprach-Frontend und das von deiner Anwendung verwaltete Backend können unabhängig voneinander laufen. Bei der Delegation an den Client kann dein Backend-Worker weiterarbeiten, unabhängig davon, ob die Sprachsitzung geöffnet oder geschlossen ist. Speichere den Aufgabenstatus und den Gesprächskontext, bevor du die Sprachsitzung schließt.
Der Abschnitt Inaktive Sitzungen schließen und fortsetzen erläutert, wie du das Zeitlimit bei Inaktivität festlegst, den Neustart auslöst und den Kontext wiederherstellst.
Bei einem im Hintergrund verfügbaren Agenten schließt du die Sprachsitzung, während das Backend eine länger dauernde Aufgabe bearbeitet, etwa beim Programmieren im Zielmodus. Biete die Schaltfläche „Gespräch fortsetzen“ an, mit der die Person bei ihrer Rückkehr eine neue Sprachsitzung starten kann. Alternativ kannst du über ein Abschlussereignis im Backend eine neue Sitzung starten und der Person mitteilen, dass das Ergebnis vorliegt.
Um das Gespräch wieder aufzunehmen, starte eine neue Sitzung und übergib den gespeicherten Kontext und das geprüfte Aufgabenergebnis in input. Sende beispielsweise dieses Startereignis über eine neue WebSocket-Verbindung:
{
"type": "session.start",
"session": {
"model": "gpt-live-1",
"instructions": "Help the user review completed work and delegate follow-up tasks.",
"input": [
{
"type": "message",
"role": "developer",
"content": [
{
"type": "input_text",
"text": "Saved task: add CSV export. Result: code is ready for review."
}
]
}
],
"delegation": { "type": "client" }
}
}Warte auf session.started, bevor du Audio streamst. Der Abschnitt Sitzung mit einem früheren Gesprächsverlauf starten beschreibt das unterstützte Format für den Gesprächsverlauf.
Wenn die frühere Sitzung mit store: true gespeichert wurde, kannst du auch diese Sitzung forken. Speichere bei beiden Vorgehensweisen den geprüften Status der Backend-Aufgabe in deiner Anwendung.
Wenn du die Sprachsitzung schließt, sparst du pro Minute Leerlauf 0,05 USD. Wäge die Ersparnis gegen die Kosten für den erneuten Verbindungsaufbau und die Auswirkungen der Unterbrechung auf die Bedienung ab.
Das passende Backend-Modell wählen
Wähle zunächst Modelle aus, die für die Aufgabe ausreichend genau und zuverlässig sind. Vergleiche anschließend die Gesamtkosten des Gesprächs. Berücksichtige dabei die Dauer der Sprachsitzung, die Modellnutzung, Tool-Aufrufe und Wiederholungsversuche. Der Leitfaden zur Modellauswahl erläutert, wie du diese Faktoren abwägst.
Ein größeres Backend-Modell kann insgesamt günstiger sein, wenn es die Aufgabe schneller erledigt und die Ersparnis bei der Sprachsitzung die zusätzlichen Tokenkosten übersteigt. Ein günstigeres Modell kann insgesamt teurer sein, wenn es länger braucht, Tool-Aufrufe wiederholt oder die Aufgabe nicht erfolgreich abschließt.
Vergleiche neben den Kosten pro erfolgreich erledigter Aufgabe auch die Erfolgsquote und die Zeit bis zum Abschluss. Rechne fehlgeschlagene Versuche und Wiederholungen in die Gesamtkosten ein. So schneidet eine günstigere Konfiguration im Vergleich nicht allein deshalb besser ab, weil sie weniger Aufgaben erledigt. Nutze für die Planung deines Vergleichs das Cookbook zur Evaluation von Sprachagenten.
Tatsächliche Nutzung erfassen
Erfasse für jede Sitzung die Dauer der Sprachsitzung und die Backend-Nutzung getrennt. GPT-Live meldet die bisherige Gesamtdauer der Sprachsitzung in Sekunden:
{
"type": "session.usage.updated",
"event_id": "event_usage_1",
"usage": { "seconds": 12 },
"context_window": { "usage_ratio": 0.42 }
}Jede Aktualisierung ersetzt den zuvor gemeldeten Stand. Addiere die Zwischenstände nicht. Empfange nach dem Senden von session.close weiterhin Ereignisse, bis session.closed eintrifft, und erfasse den darin gemeldeten Endwert von usage.seconds genau einmal. Folge dem Ablauf zum geordneten Schließen der Sitzung, damit deine Anwendung die abschließenden Nutzungsdaten erfasst, bevor sie die Verbindung trennt.
Bei der Delegation an die Responses API liest du usage für die jeweilige Backend-Antwort aus den verschachtelten response.completed-Ereignissen aus, die über response.event eintreffen. Zähle jede Backend-Antwort anhand ihrer Antwort-ID genau einmal. Bewahre die Angaben zu Eingabetoken, Ausgabetoken und zwischengespeicherten Token auf, die du für die Berechnung zu den Preisen des jeweiligen Modells brauchst. Führt deine Anwendung Backend-Aufgaben unabhängig davon aus, erfasse auch die Nutzung dieser Anfragen.
Vergleiche die geschätzten mit den tatsächlichen Gesamtkosten anhand repräsentativer Gespräche. Erfasse Modellaufrufe, die ausschließlich der Evaluation dienen, getrennt von der Nutzung durch die Anwendung. Betrachte die Kosten gemeinsam mit dem Aufgabenerfolg.
Kosten der Realtime API
Hier erfährst du, wie die Realtime API die Nutzung abrechnet und wie du die Kosten optimieren kannst. In Sitzungen mit Sprachagenten fallen Eingabe- und Ausgabetoken für Text, Audio und Bilder an. Bei Sitzungen zur Streaming-Übersetzung oder Streaming-Transkription richtet sich die Abrechnung nach der Audiodauer. Die Preise unterscheiden sich je nach Modell. Du findest sie auf den jeweiligen Modellseiten, zum Beispiel für gpt-realtime-2, gpt-realtime-translate, gpt-realtime-whisper und gpt-realtime.
Gesprächssitzungen mit der Realtime API bestehen aus mehreren Gesprächsrunden. In jeder Runde löst die Eingabe der Person eine Response aus, mit der das Modell seine Ausgabe erzeugt. Der Server verwaltet eine Conversation. Sie enthält eine Liste von Items, die als Eingabe für die nächste Runde dienen. Sobald eine Response zurückgegeben wird, wird ihre Ausgabe automatisch zur Conversation hinzugefügt.
Übersetzungs- und Transkriptionssitzungen verwenden eine andere Streaming-Architektur. Der Client streamt kontinuierlich Audio. Während das Quellaudio eintrifft, erhält er übersetztes Audio, Transkript-Deltas oder Transkriptereignisse. Diese Sitzungen durchlaufen nicht den üblichen Lebenszyklus einer Response. Verwende für Kostenschätzung und Nutzungsüberwachung daher die zeitabhängigen Preise anstelle des Tokenverbrauchs pro Response.
Kosten pro Response
Bei der Realtime API fallen Kosten an, sobald eine Response erstellt wird. Die Abrechnung richtet sich nach der Anzahl der Eingabe- und Ausgabetoken. Eine Ausnahme sind die Kosten für die Eingabetranskription, die weiter unten beschrieben werden. Für Netzwerkbandbreite und Verbindungen fallen derzeit keine Kosten an. Du kannst eine Response manuell erstellen oder bei aktivierter Sprachaktivitätserkennung (VAD) automatisch erstellen lassen. Die VAD filtert Audio ohne Sprachaktivität heraus. Dieses Audio zählt nur dann als Eingabetoken, wenn der Client es manuell als Gesprächseingabe hinzufügt.
Für jede Response erhält das Modell das gesamte bisherige Gespräch als Eingabe. Die Ausgabe einer Runde wird der Conversation auf dem Server in Form von Items hinzugefügt und dient in späteren Runden als Eingabe. Spätere Runden derselben Sitzung sind daher teurer.
Die Kosten für Texttoken kannst du mit unseren Tools zur Tokenisierung schätzen. Bei Sprachnachrichten von Personen fällt pro 100 ms Audio ein Token an, bei Nachrichten des Assistenten pro 50 ms Audio ein Token. Neben dem Nachrichteninhalt werden auch spezielle Token gezählt. Dadurch können die Zahlen leicht abweichen. So kann eine Nachricht einer Person mit einem Inhalt von 10 Texttoken insgesamt als 12 Token zählen.
Beispiel
Das folgende Beispiel zeigt, wie sich die Tokenkosten über mehrere Gesprächsrunden einer Sitzung mit der Realtime API entwickeln.
In der ersten Runde übergeben wir Anweisungen im Umfang von 100 Token und eine Sprachnachricht der Person mit 20 Audiotoken. Diese Nachricht kann beispielsweise durch die VAD hinzugefügt werden, wenn die Person spricht. Insgesamt ergeben sich 120 Eingabetoken. Beim Erstellen der Response entsteht eine Nachricht des Assistenten mit 20 Audiotoken und 10 Texttoken.
Für die zweite Runde fügen wir eine weitere Sprachnachricht der Person hinzu. Welche Token fallen für Runde 2 an? Die Conversation enthält jetzt die ursprünglichen Anweisungen, die erste Nachricht der Person, die Antwort des Assistenten aus der ersten Runde und die zweite Nachricht der Person mit 25 Audiotoken. In dieser Runde entfallen 110 Texttoken und 64 Audiotoken auf die Eingabe. Hinzu kommen die Ausgabetoken für die nächste Nachricht des Assistenten.
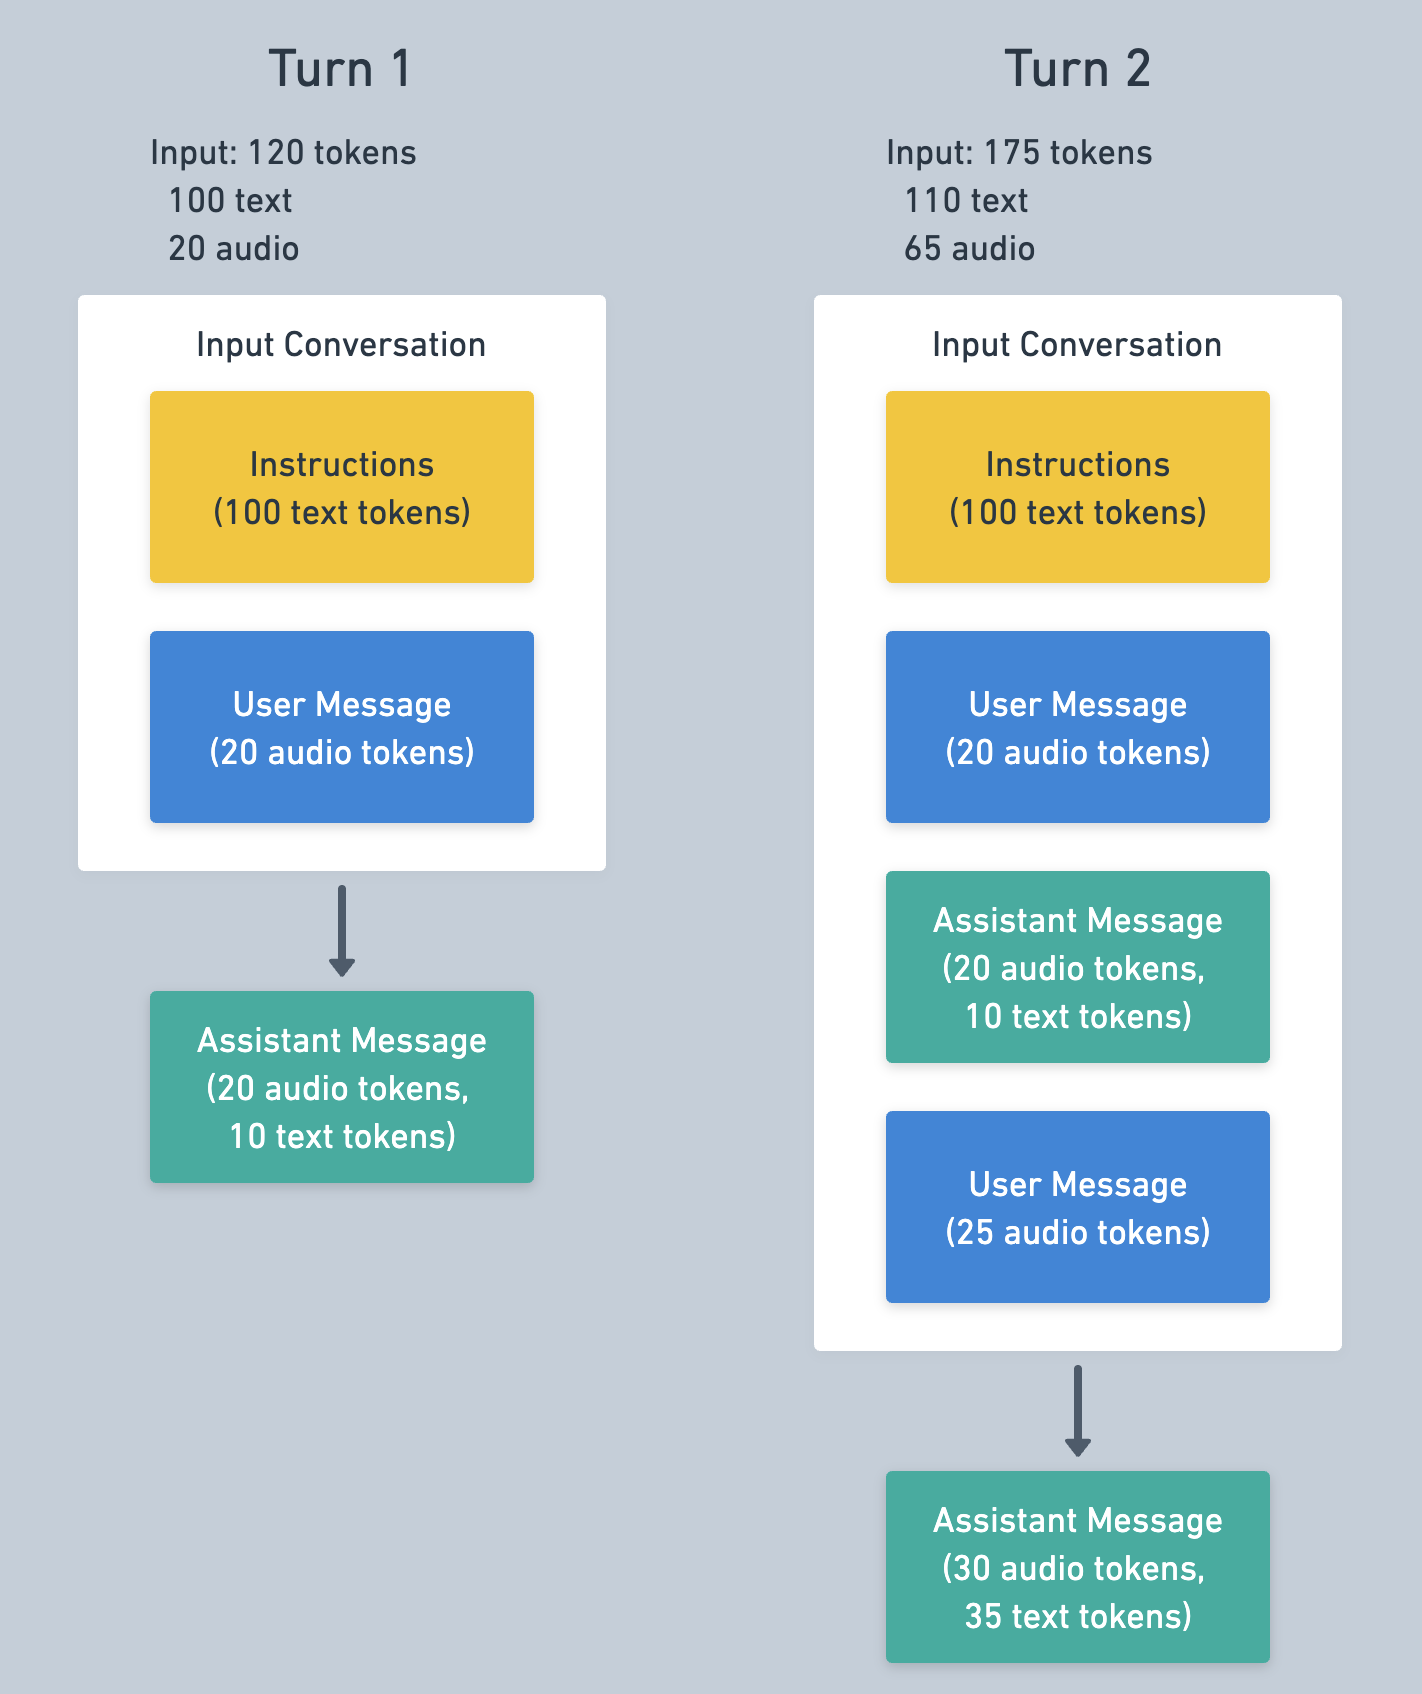
Für die zweite Runde stehen die Nachrichten aus der ersten Runde wahrscheinlich im Cache bereit. Dadurch sinken die Eingabekosten. Weitere Informationen zum Caching findest du weiter unten.
Die für eine Response verwendeten Token kannst du aus dem Ereignis response.done auslesen. Es hat folgende Struktur:
{
"type": "response.done",
"response": {
...
"usage": {
"total_tokens": 253,
"input_tokens": 132,
"output_tokens": 121,
"input_token_details": {
"text_tokens": 119,
"audio_tokens": 13,
"image_tokens": 0,
"cached_tokens": 64,
"cached_tokens_details": {
"text_tokens": 64,
"audio_tokens": 0,
"image_tokens": 0
}
},
"output_token_details": {
"text_tokens": 30,
"audio_tokens": 91
}
}
}
}Kosten für die Eingabetranskription
Wenn du die Eingabetranskription aktivierst, rechnet die Realtime API sie separat ab. Für die Eingabetranskription kommt ein anderes Modell mit anderen Preisen zum Einsatz als für Speech-to-Speech. Verwende gpt-transcribe für die Transkription einer bestätigten Gesprächsrunde. Die Transkription beginnt, nachdem die Audiodaten in den Eingabepuffer geschrieben wurden und der Pufferinhalt bestätigt wurde.
Lies die Nutzungsdaten für die Eingabetranskription aus dem Ereignis conversation.item.input_audio_transcription.completed aus. Welche Nutzungsfelder du erhältst, hängt vom Transkriptionsmodell ab. Bei gpt-transcribe richtet sich die Abrechnung nach der Audiodauer. Modelle mit tokenbasierter Abrechnung geben die Anzahl der Token zurück. Bei zeitabhängiger Abrechnung sehen die Nutzungsdaten beispielsweise so aus:
{
"type": "conversation.item.input_audio_transcription.completed",
"transcript": "Hi, can you hear me?",
"usage": {
"type": "duration",
"seconds": 3
}
}Caching
Die Realtime API nutzt automatisch Prompt-Caching. Das kann die Kosten für Eingabetoken in Sitzungen mit mehreren Gesprächsrunden erheblich senken. Stimmen die Eingabetoken einer Response mit Token einer früheren Response überein, kann die API sie aus dem Cache übernehmen. Ein Cache-Treffer ist jedoch nicht garantiert.
Die höchste Cache-Trefferquote erreichst du, wenn du den bisherigen Sitzungsverlauf unverändert lässt. Entfernst oder änderst du Inhalte im Gespräch, stimmt die Eingabe nur noch bis zur ersten Änderung mit der früheren Eingabe überein. Entsprechend lässt sich ein kleinerer Teil aus dem Cache wiederverwenden. Anweisungen und Tool-Definitionen stehen am Gesprächsanfang. Änderungen daran während einer Sitzung senken daher die Cache-Trefferquote in den folgenden Runden.
Gesprächsverlauf kürzen
Überschreitet die Anzahl der Token in einem Gespräch das Eingabelimit des Modells, wird der Gesprächsverlauf gekürzt. Dabei entfallen Nachrichten aus der Eingabe für die Response, beginnend mit der ältesten. Bei einem Modell mit einem Kontextfenster von 32k Token und maximal 4.096 Ausgabetoken kann der Kontext höchstens 28.224 Token enthalten, bevor er gekürzt wird.
Clients können ein kleineres Tokenfenster festlegen, als das Modell maximal unterstützt. So lassen sich Tokenverbrauch und Kosten steuern. Dazu dient die Einstellung token_limits.post_instructions, wenn du für die Kürzung wie im Beispiel unten den Typ retention_ratio konfigurierst. Die Einstellung gibt die maximale Anzahl der Eingabetoken pro Response ohne die Token für Anweisungen an. Setzt du post_instructions auf 1.000, erhält das Modell für die Response keine Items, die über das Limit von 1.000 Eingabetoken hinausgehen.
Durch das Kürzen ändert sich die Eingabe nahe am Gesprächsanfang. Wird der Verlauf in jeder Runde gekürzt, ist die Cache-Trefferquote deshalb sehr niedrig. Um das zu vermeiden, können Clients die Kürzung so konfigurieren, dass mehr Nachrichten als unmittelbar nötig entfallen. Damit bleibt mehr Platz, bevor eine weitere Kürzung nötig wird. Das steuerst du mit session.truncation.retention_ratio. Der Server verwendet standardmäßig den Wert 1.0 und entfernt damit nur so viele Items wie nötig. Beim Wert 0.8 bleiben nach der Kürzung 80 % der maximalen Tokenzahl erhalten. Weitere 20 % entfallen.
Um die Kosten der Realtime API pro Sitzung bei einem bestimmten Modell zu senken, empfehlen wir, die Anzahl der Token stärker zu begrenzen und für retention_ratio einen Wert unter 1 zu wählen, wie im folgenden Beispiel. Bedenke dabei, dass dem Modell in der jeweiligen Runde weniger Gesprächskontext zur Verfügung stehen kann, wenn du die Kosten auf diese Weise senkst.
{
"event": "session.update",
"session": {
"truncation": {
"type": "retention_ratio",
"retention_ratio": 0.8,
"token_limits": {
"post_instructions": 8000
}
}
}
}Du kannst die automatische Kürzung auch vollständig deaktivieren, wie im folgenden Beispiel. Ist sie deaktiviert, gibt die API einen Fehler zurück, sobald die Conversation zu lang ist, um eine Response zu erstellen. Das kann sinnvoll sein, wenn du die Größe der Conversation selbst steuern möchtest.
{
"event": "session.update",
"session": {
"truncation": "disabled"
}
}Weitere Strategien zur Optimierung
Ein Mini-Modell verwenden
Die Speech-to-Speech-Modelle für die Realtime API gibt es in einer Standardgröße und als deutlich günstigere Mini-Variante. Das Mini-Modell ist in der Regel weniger leistungsfähig, wenn es darum geht, Anweisungen zu befolgen oder Funktionsaufrufe auszuführen. Wir empfehlen, deine Anwendung zuerst mit dem größeren Modell zu testen und die Anwendung und den Prompt zu verbessern. Prüfe anschließend, ob du die Kosten mit dem Mini-Modell senken kannst.
Conversation bearbeiten
Der Server kürzt den Gesprächsverlauf automatisch. Du kannst die Kosten auch steuern, indem du die Conversation manuell bearbeitest. Die API gibt dem Client die volle Kontrolle über die Conversation auf dem Server. Der Client kann Items nach Bedarf hinzufügen und entfernen.
{
"type": "conversation.item.delete",
"item_id": "item_CCXLecNJVIVR2HUy3ABLj"
}Entfernst du alte Nachrichten, sinken die Anzahl der Eingabetoken und die Kosten. Dabei können wichtige Inhalte verloren gehen. Eine gängige Lösung besteht darin, die alten Nachrichten durch eine Zusammenfassung zu ersetzen. Mit einer Nachricht vom Typ conversation.item.delete entfernst du wie oben gezeigt Items aus der Conversation. Mit einer Nachricht vom Typ conversation.item.create fügst du Items hinzu.
Kosten schätzen
Da der Tokenverbrauch der Realtime API von mehreren Faktoren abhängt, lassen sich die Kosten im Voraus nur schwer schätzen. Teste die vorgesehenen Prompts und Funktionen im Realtime Playground und miss den Tokenverbrauch in einer Beispielsitzung. Den Tokenverbrauch der Sitzung findest du im Realtime Playground auf der Registerkarte „Logs“ neben der Sitzungs-ID.