
Mit der Open-Source-Bibliothek Promptfoo kannst du KI-Anwendungen und KI-Agenten evaluieren und mit Red Teaming auf Schwachstellen prüfen. Definiere Testfälle und Prüfungen, um das Verhalten einer Anwendung zu messen, Prompts oder Modelle zu vergleichen und Fehler zu untersuchen. Mit gezielt manipulierten Eingaben kannst du Anwendungen auch auf Sicherheitsrisiken testen.
Promptfoo gehört zu OpenAI.
Diese Anleitung beginnt mit einer kleinen Evaluation. Führe ein Übersetzungsbeispiel im Terminal aus oder bitte Codex, eine Evaluation für deine Anwendung einzurichten.
Einstieg über die CLI
Wenn du Node.js ab Version 22.22.0 installiert hast, wähle aus, wie du das Promptfoo-Beispiel ausführen möchtest. Es vergleicht anhand von Testfällen die Übersetzungen verschiedener Modelle.
npx promptfoo@latest init --example getting-started
cd getting-started
Verwende eine aktivierte virtuelle Umgebung mit Python ab Version 3.10. Auch der pip-Wrapper benötigt Node.js ab Version 22.22.0.
pip install promptfoo
promptfoo init --example getting-started
cd getting-startedDas Beispiel erstellt die Datei promptfooconfig.yaml mit einem Übersetzungsprompt, Modellanbietern und Testfällen. Jeder Test enthält eine Assertion, die prüft, ob die Ausgabe eine erwartete Formulierung enthält. Lege deinen OpenAI-API-Schlüssel im Terminal fest und ersetze dabei den Platzhalter durch deinen Schlüssel.
export OPENAI_API_KEY="<your-api-key>"Führe die Evaluation aus und öffne anschließend die Ergebnisansicht. Bei dieser Evaluation fallen für die Modellaufrufe API-Gebühren an.
npx promptfoo@latest eval
npx promptfoo@latest view
promptfoo eval
promptfoo viewÖffne die lokale URL, um die Modellergebnisse zu vergleichen und zu sehen, welche Assertions erfolgreich waren und welche fehlgeschlagen sind. Sieh dir auch die Ausgaben selbst an. Eine erfolgreiche Assertion bestätigt nur, dass eine bestimmte Bedingung erfüllt ist. Die Gesamtqualität der Antwort musst du gesondert beurteilen. Bearbeite den Prompt oder die Testfälle in promptfooconfig.yaml und führe die Evaluation erneut aus.
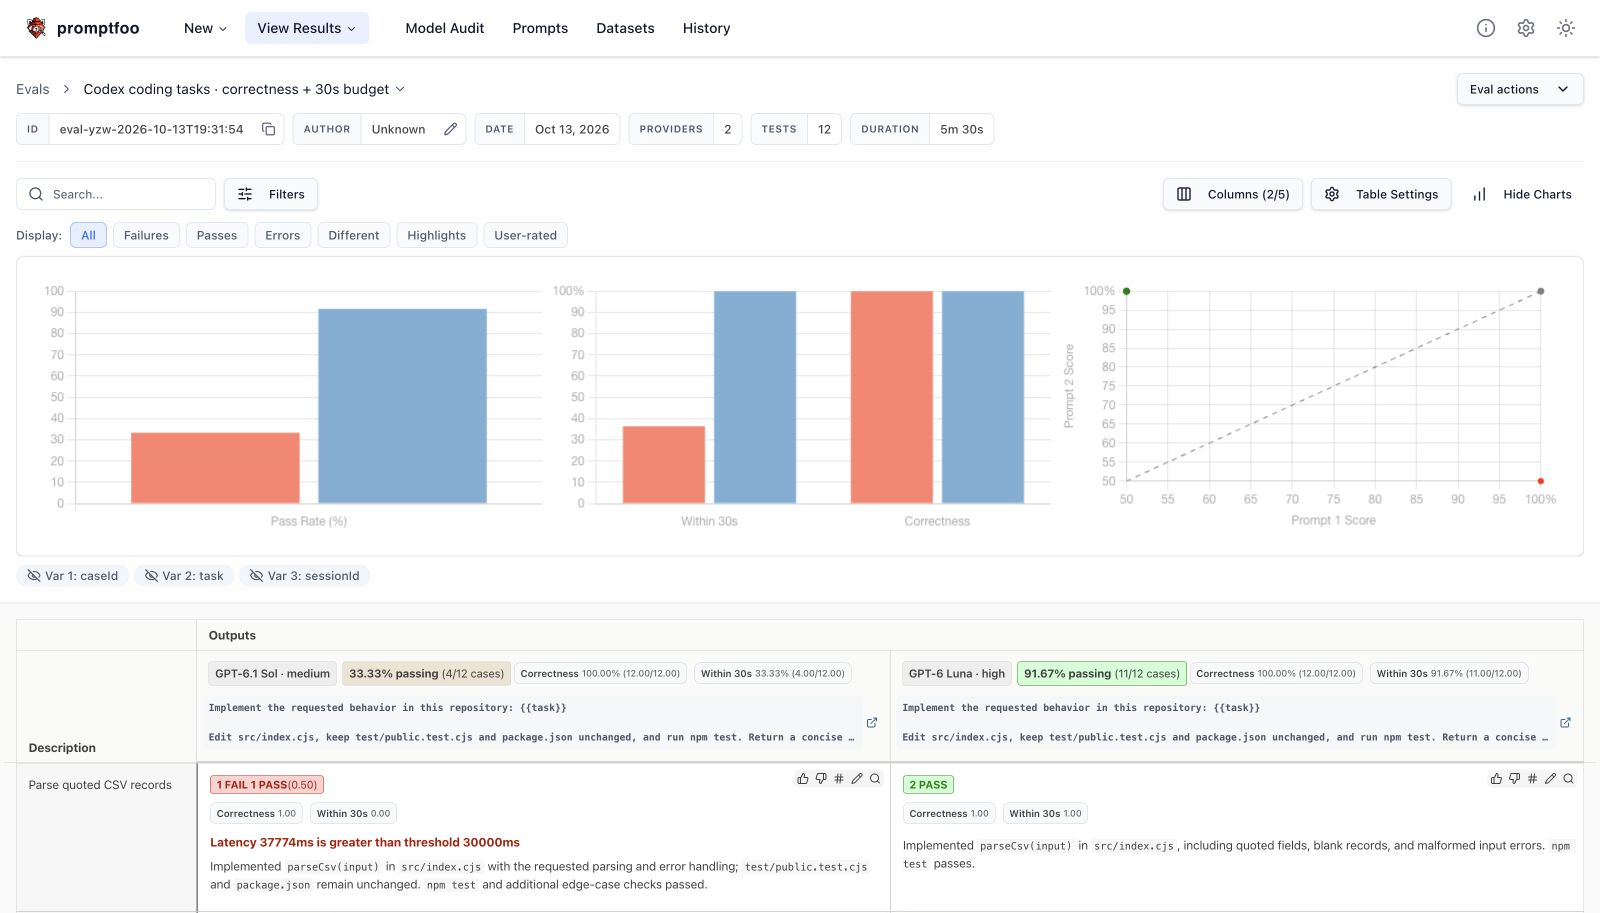
Eine separate Evaluation mit dem Codex App Server vergleicht gpt-6.1-sol (mittlerer Reasoning-Aufwand) und gpt-6-luna (hoher Reasoning-Aufwand) anhand von 12 Programmieraufgaben. Für jedes Ergebnis prüfen ausführbare Tests die Korrektheit des Codes. Zusätzlich gilt ein Zeitlimit von 30 Sekunden. Alle Implementierungen haben die Codeprüfungen bestanden. Rot markierte Ergebnisse haben das Zeitlimit überschritten.
Einstieg in der Codex App
Mit dem Promptfoo-Plugin erhält Codex Skills zum Einrichten und Ausführen von Evaluationen.
Wähle „In Codex öffnen“, um eine Aufgabe zu starten, oder „Prompt kopieren“, um den Prompt in eine bestehende Aufgabe einzufügen.
Codex braucht möglicherweise deine Hilfe bei den Zugangsdaten oder den Berechtigungen für das Setup. Bei Evaluationen, die ein Modell aufrufen, können API-Gebühren anfallen.
Nächste Schritte
In der Promptfoo-Dokumentation findest du weitere Anleitungen.
- Evaluationen konfigurieren: Richte Prompts, Modelle und Testfälle mithilfe der Konfigurationsanleitung ein.
- Ausgaben prüfen: Wähle passende Prüfungen und Bewertungsmethoden mithilfe der Dokumentation zu Assertions und Metriken aus.
- Auf Sicherheitsrisiken testen: Prüfe deine Anwendung mit gezielt manipulierten Eingaben. Wie das geht, zeigt die Anleitung zum Red Teaming.