
Mit GPT-Live kannst du einem Gespräch deinen eigenen Rhythmus geben. Du kannst einhaken, das Thema wechseln und eine Idee beim Sprechen weiterentwickeln. In kaskadierten Sprachsystemen durchläuft das Gesprochene nacheinander separate Modelle für Transkription, Sprachverarbeitung und Spracherzeugung. GPT-Live kann gleichzeitig zuhören und sprechen. So entstehen natürlichere Gespräche, in denen es ebenso auf den richtigen Moment und den Umgang mit Unterbrechungen ankommt wie auf die Worte selbst.
In diesem Blogbeitrag berichten Juno, Picsart, Treater und Weekend selbst, wie sie GPT-Live einsetzen und was sie dabei gelernt haben:
- Anrufe anhand aktueller Daten aus dem Produktivbetrieb verbessern
- Stimmen finden, die Vertrauen schaffen
- Gespräche mit der Arbeit von Hintergrundagenten abstimmen
- Das Zusammenspiel mehrerer Sprachagenten steuern
Wir schauen uns an, welche Prompts, Abläufe und Rückmeldungen diese Produkte prägen. Daraus ergeben sich Ideen, die du in deinen eigenen Anwendungen ausprobieren kannst.
Erfahrungsberichte der Start-ups
Juno: Wie sich Gespräche mit dem Gesundheitsassistenten dank GPT-Live natürlich anfühlen
Von Marshall Gould, Co-founder and CEO, und Isaac Tolley, Co-founder and CTO
Wir entwickeln Juno, einen persönlichen Gesundheitsassistenten für Menschen mit chronischen Erkrankungen wie Long COVID, POTS und EDS.
Was wir entwickeln wollten
Was eine chronische Erkrankung einem abverlangt, versteht man erst richtig, wenn man selbst damit lebt. Zu den starken Beschwerden, der Erschöpfung, den Terminen und der Angst, weil man nicht weiß, was einem fehlt, kommt die ganze Organisation. Man muss daran denken, Medikamente nachzubestellen, die neuesten Forschungsergebnisse lesen, Symptome festhalten und sie mit den Hunderten von Faktoren in Verbindung bringen, die sich jeden Tag ändern. Gleichzeitig versucht man, ein normales Leben zu führen.
Für Menschen mit chronischen Erkrankungen kann schon die Dokumentation zur Belastung werden. Das gilt besonders, wenn die Erkrankung die verfügbare Energie einschränkt. Alles von Hand einzutragen kostet Kraft. Viele geben die Apps deshalb wieder auf, obwohl sie ihnen helfen.
Die Spracheingabe hat daran grundlegend etwas geändert. Ein einziger gesprochener Satz genügt, damit Juno mehrere Dinge gleichzeitig für dich festhält.
Was bei Sprachinteraktionen noch schwierig ist
Schon ohne Anpassungen ist die Sprachfunktion beeindruckend. Sprechen ist für Menschen die natürlichste Art der Kommunikation. Wir lernen aber noch, wie wir diese Gespräche gut gestalten können. Einige Herausforderungen bleiben:
- Ein Symptom erfassen oder Kontext abrufen, ohne den Gesprächsfluss zu unterbrechen.
- Gespeicherte Informationen aus dem Textchat im Sprachmodus nutzen, ohne das Gespräch aufzuhalten.
- Lange Gespräche führen.
Sprachmodelle für Gespräche erinnern mich an Quallen. Sie reagieren schnell, geben aber von sich aus kaum eine Richtung vor. Sie lassen sich von der letzten Äußerung treiben und halten oft inne, um nach einer Bestätigung zu fragen. Textmodelle ergreifen eher die Initiative, weil ihnen viel mehr Kontext zur Verfügung steht und man ihnen die eigene Situation nicht jedes Mal erklären muss. Bei gesprochenen Gesprächen musst du die Richtung vorgeben.
Wie wir unsere Sprachagenten verbessern
Informationen erfassen und abrufen, ohne das Gespräch zu unterbrechen
Wenn du die meisten Sprachagenten um etwas bittest, geben sie die Aufgabe an ein Tool weiter und warten auf die Antwort. In dieser Zeit herrscht Stille. GPT-Live kann Arbeit an einen anderen Agenten delegieren. Bei der Übergabe stockt das Gespräch jedoch, bis die Antwort eintrifft. In unserer ersten Version gab es in vier von fünf Anrufen mindestens eine solche Pause: „Einen Moment“, gefolgt von etwa zehn Sekunden Stille.
Unsere Lösung ist einfach. Nach jedem Gesprächsschritt beantwortet ein kleines, schnelles Modell (Decisions API von OpenAI) im Hintergrund zwei Fragen:
- Gibt es etwas zu erfassen, und wenn ja, welcher Art ist der Eintrag?
- Was aus deiner Vorgeschichte ist gerade relevant?
Sag zum Beispiel „Trag Kopfschmerzen ein“. Juno bekommt sofort die Rückmeldung, dass der Eintrag erfasst ist, während das Speichern im Hintergrund läuft. Das geht so schnell, dass der Eintrag bereits gespeichert ist, wenn du gleich im nächsten Satz nach den Kopfschmerzen fragst.
Die zweite Antwort bestimmt, woran sich Juno erinnert. In den Kontext für den nächsten Gesprächsschritt kommt genau das aus deiner Vorgeschichte, was gerade relevant ist. Ein Modell für gesprochene Gespräche arbeitet mit deutlich weniger Kontext als ein Textmodell. Deshalb kommt es darauf an, die Informationen gezielt auszuwählen.
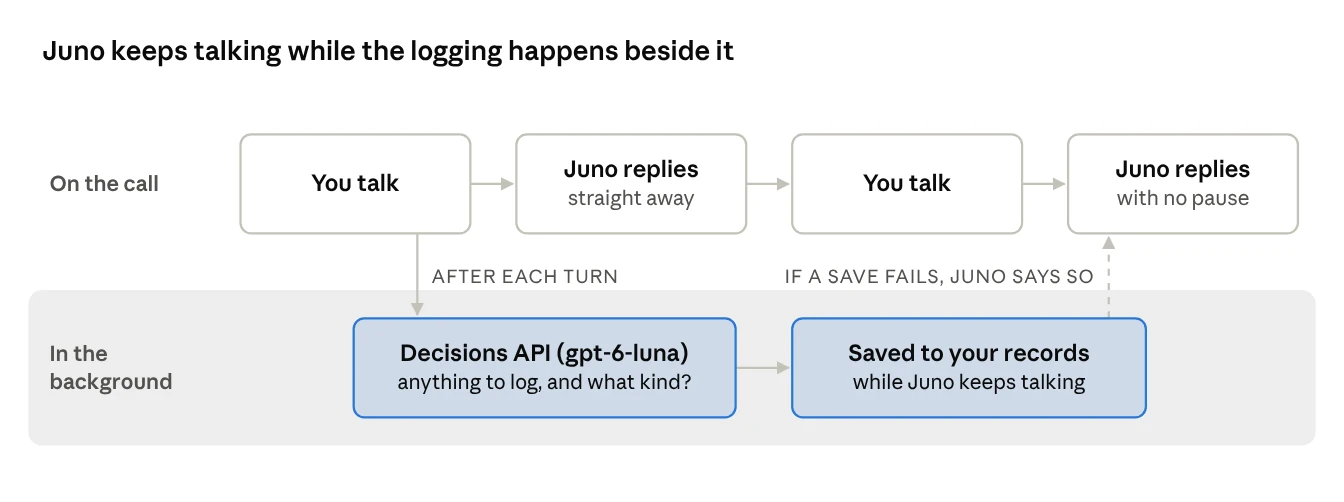
Dadurch gab es 40 % weniger Übergaben an den Textagenten. Die längste Stille in einem Testanruf sank von 9,3 auf 3,2 Sekunden. Das macht den Unterschied zwischen einer unangenehmen Wartezeit und einer natürlichen Gesprächspause.
Lange Gespräche
Lange Gespräche brauchen ebenso viel Aufmerksamkeit. Denk an die Qualle: Das Modell gibt kaum selbst eine Richtung vor, also musst du es steuern. Ein eigener Agent aktualisiert den Gesprächskontext. So weiß Juno auch beim hundertsten Gesprächsschritt noch, was ganz am Anfang gesagt wurde und welches Thema als Nächstes passt, wenn das Gespräch ins Stocken gerät. Wenn du lange Gespräche ermöglichen willst, musst du diese Steuerung selbst entwickeln. Der Aufwand lohnt sich, denn gerade in längeren Gesprächen zeigen sich Muster und Entwicklungen, die Menschen helfen, ihre Gesundheit besser zu verstehen.
Wie wir Junos Stimme im Hörtest finden
Auch eine Stimme zu gestalten, die genau richtig klingt, ist leichter gesagt als getan. Schon in der Grundversion klingt GPT-Live deutlich besser als die Vorgängermodelle. Trotzdem hören wir immer noch, eine Stimme klinge nach KI. Lässt sich eine Stimme gestalten, die für neun von zehn Menschen passt?
In einer Fokusgruppe mit chronisch erkrankten Menschen erfuhren wir, dass unsere Stimme etwas zu langsam spreche und leicht herablassend klinge. Diese Rückmeldung war uns wichtig. Deshalb haben wir eine Studie durchgeführt, um die Stimme zu verbessern.
Mit der Stimmerzeugung per Prompt von GPT-Live haben wir anhand kurzer schriftlicher Beschreibungen neue Stimmen entwickelt. 290 Erwachsene in den USA, die mit chronischen Erkrankungen leben, verglichen sie mit der aktuell eingesetzten Stimme. Alle hörten dieselben drei Sätze und bewerteten jede Stimme. Anschließend gaben sie an, welche Stimme ihnen am besten und welche am wenigsten gefiel und welche sie an einem Tag hören wollten, an dem sie erschöpft sind.
Über fünf kleine Testrunden hinweg behielten wir jeweils die besten Stimmen bei und überarbeiteten die Beschreibungen der übrigen. Anschließend verglichen 171 neue Testpersonen die bisherige Stimme mit den beiden besten neuen Varianten.
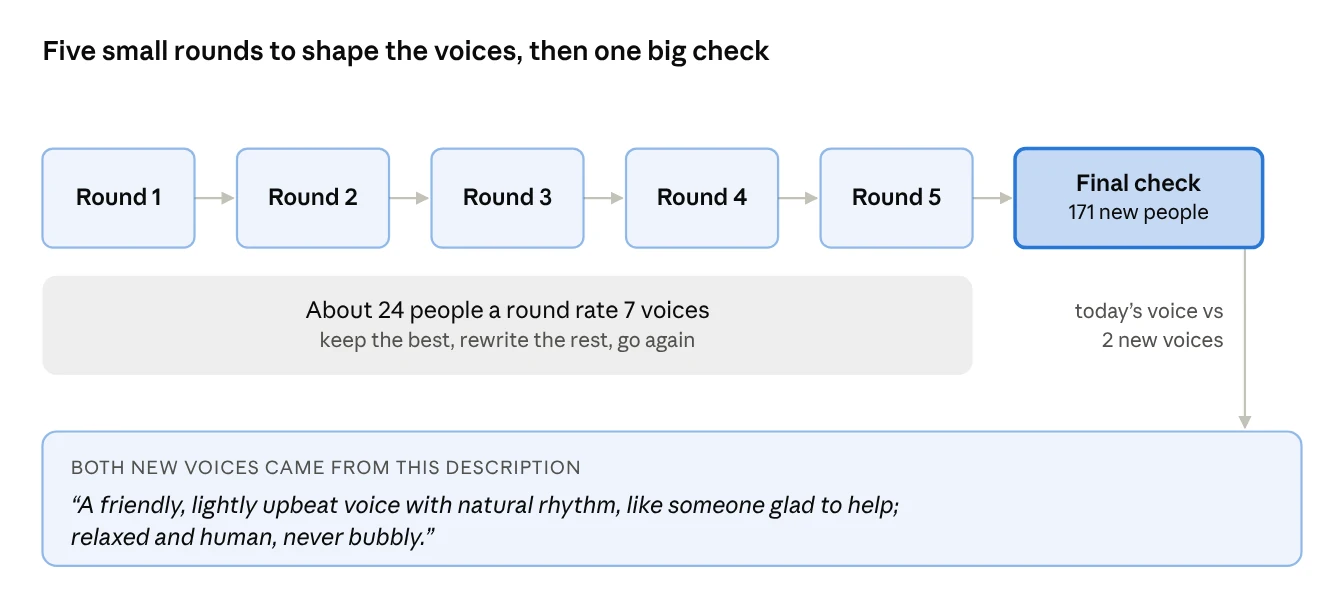
Am besten schnitt eine neue Stimme ab, die aus der Beschreibung in der Abbildung oben entstanden war. Im Abschlusstest wählten mehr Personen sie zu ihrer Lieblingsstimme als die bisherige Stimme. Weniger Personen setzten sie auf den letzten Platz, und deutlich weniger fanden, dass ihr Wärme fehlte.
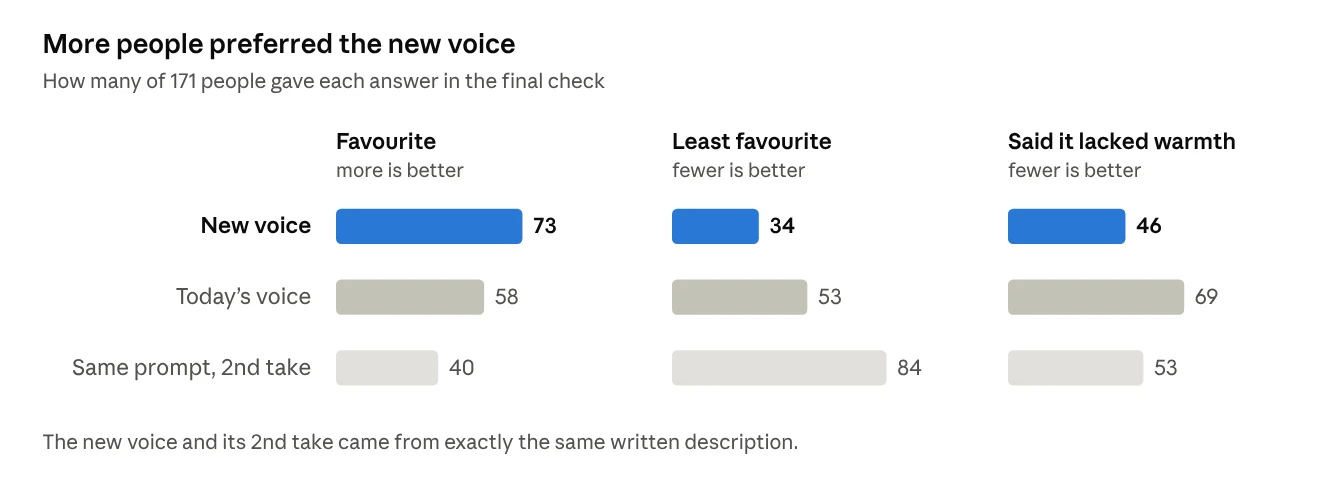
Die Aussagekraft der Studie ist begrenzt. Die Testpersonen hörten nur drei Sätze, die Bewertungen lagen eng beieinander und ein Hörtest unterscheidet sich von einem echten Anruf. Als Nächstes testen wir die neue Stimme in echten Gesprächen mit Menschen, die zum ersten Mal anrufen. Wir wollen sehen, ob mehr von ihnen am nächsten Tag wieder anrufen.
Welche Stimme passt an einem Tag, an dem man erschöpft ist?
Wir haben auch gefragt, welche Stimme die Menschen an einem Tag hören möchten, an dem sie erschöpft sind. Hier lag die bisherige Stimme knapp vor der neuen. Der Abstand ist gering, wirft aber eine grundsätzliche Frage auf: Warum suchen wir eigentlich so verbissen nach der einen perfekten Stimme?

Auch wir selbst sprechen nicht immer gleich. Wir passen Tonfall, Tempo und Lautstärke an die Situation an. Wie wäre es also, wenn Juno die Stimme darauf abstimmen könnte, wie du dich fühlst? Menschen vertrauen einer Stimme mehr, wenn Sprechtempo und Lautstärke ihren eigenen entsprechen (Levitan et al., 2016). Mit GPT-Live können wir Junos Sprechweise schon heute während eines Anrufs ändern. Das untersuchen wir in unserer Folgestudie. Alle Hörproben und die vollständigen Ergebnisse findest du auf junocompanion.com/voice-study.
Es ist beeindruckend zu sehen, was die Sprachfunktion Menschen mit chronischen Erkrankungen ermöglicht und wie viel leichter sie ihren Alltag macht. GPT-Live ist ein starkes Basismodell. Schon kleine Anpassungen machen für diese Menschen einen spürbaren Unterschied.
Über den Autor und das Unternehmen
Ich bin Marshall Gould, Gründer von Juno. Junos Stimme habe ich zusammen mit einem dreiköpfigen Forschungsteam entwickelt: Isaac Tolley, Sean Lees und Dawid Wraga. Als KI-Unternehmen haben wir bei Juno ein klares Ziel: Wir möchten Menschen dabei helfen, mit einer chronischen Erkrankung zu leben und ihren Alltag zu bewältigen. Wir sind stolz darauf, dass die meisten in unserem Team selbst mit einer chronischen Erkrankung leben. Inzwischen nutzen Hunderttausende Menschen Juno. Wir freuen uns, wenn du uns bei dieser Arbeit unterstützt. Mehr erfährst du auf junocompanion.com.
Picsart: Wie Gespräch und Aufgaben des Agenten synchron bleiben
Von Dmitry Ivanov, Senior Staff Engineer bei Picsart
Was wir entwickeln wollten
Kreative Arbeit kann länger dauern als ein Anruf. Wir wollten, dass du dich mit den KI-Agenten von Picsart ganz natürlich unterhalten kannst, während eine Aufgabe läuft. Du sollst das Gespräch auch verlassen und zurückkehren können, wenn die Ergebnisse vorliegen. Kreative Ideen sind selten von Anfang an ausgereift. Oft lässt sich eine Stimmung oder eine erste Richtung im Gespräch leichter vermitteln als in einem präzise formulierten Auftrag.
GPT-Live war die erste Technologie, mit der wir diese Idee umsetzen konnten. Das Live-Gespräch fühlte sich so natürlich an, dass man Ideen gemeinsam weiterentwickeln konnte, weit über das Diktieren von Befehlen hinaus. Damit hatten wir die Grundlage, um solche Gespräche auch mit den KI-Agenten von Picsart zu ermöglichen.
Wir haben Sprache deshalb als eigenständige Schnittstelle zum Agenten umgesetzt. Sie nutzt denselben Thread wie der Textchat. GPT-Live führt das Live-Gespräch. Unsere Verarbeitungsschicht übernimmt das Reasoning, verwaltet die Tools und Pläne und hält den gespeicherten Kontext bereit.
Unsere Lösung: Gespräch und Aufgabenbearbeitung trennen

Wie im Diagramm zu sehen, übergibt die App Aufgaben an die Verarbeitungsschicht und liefert Kontext und Antworten an GPT-Live zurück. Über eine gemeinsame WebSocket-Verbindung sendet sie Aufgaben und empfängt Fortschrittsmeldungen und Ergebnisse. Sprache und Text nutzen denselben Agenten. Auch die Abläufe für Aufgaben und die Genehmigungsregeln sind identisch.
Unser Sprach-Gateway richtet die Sitzung mit den Anweisungen des ausgewählten Agenten ein. Das Live-Audio fließt über WebRTC direkt zwischen dem Browser und OpenAI. Eine übermittelte Aufgabe kann nach dem Ende des Gesprächs weiterlaufen.
Eine Anfrage an den Agenten senden
Wenn GPT-Live den Hauptagenten mit etwas beauftragt, senden wir die gesprochene Anfrage, die letzten Nachrichten und die Anhänge an den aktuellen Agenten im aktuellen Thread. Dabei kennzeichnen wir die Anfrage als Anfrage aus dem Sprachmodus. Wir speichern den Kontext beim Absenden, damit spätere Äußerungen eine wartende Anfrage nicht überschreiben können.
Wir weisen den Hauptagenten an, seine Antworten für das Gespräch zu formulieren: kurz und natürlich antworten, immer nur eine Frage stellen und nichts wiederholen, was der Sprachagent bereits bestätigt hat. Der Hauptagent soll deutlich machen, welche Arbeit ansteht, was sie kostet und wofür eine Genehmigung nötig ist.
Was der Sprachagent weiß und was er ausspricht
Der Sprachagent erhält drei Arten von Informationen:
| Kanal | Was wir senden und wie der Sprachagent es verwendet |
|---|---|
| instructions | Identität des Agenten, Regeln für die Beauftragung des Agenten und für die Gesprächsführung |
| thinking | Letzte Nachrichten, Aufgabenstatus, ausgewählte Tool-Daten und Aktionen der nutzenden Person als unausgesprochener Kontext |
| commentary | Antworten, Fragen und wichtige Meldungen zu Aufgaben, die der Sprachagent aussprechen soll |
Über den Kanal thinking erhält der Sprachagent Kontext aus der App. Die internen Reasoning-Schritte des Hauptagenten bleiben privat. Bevor wir ausgewählte Tool-Ergebnisse weitergeben, entfernen wir gängige Felder für Zugangsdaten sowie Binärdaten, begrenzen die Größe der Ergebnisse und kennzeichnen unvollständige Ergebnisse.
Wenn eine Aktion auf dem Bildschirm eine Anfrage an den Agenten auslöst, informieren wir den Sprachagenten über den Kanal thinking. So kann er die Aktion bestätigen, ohne nachzufragen oder die Anfrage erneut zu stellen.
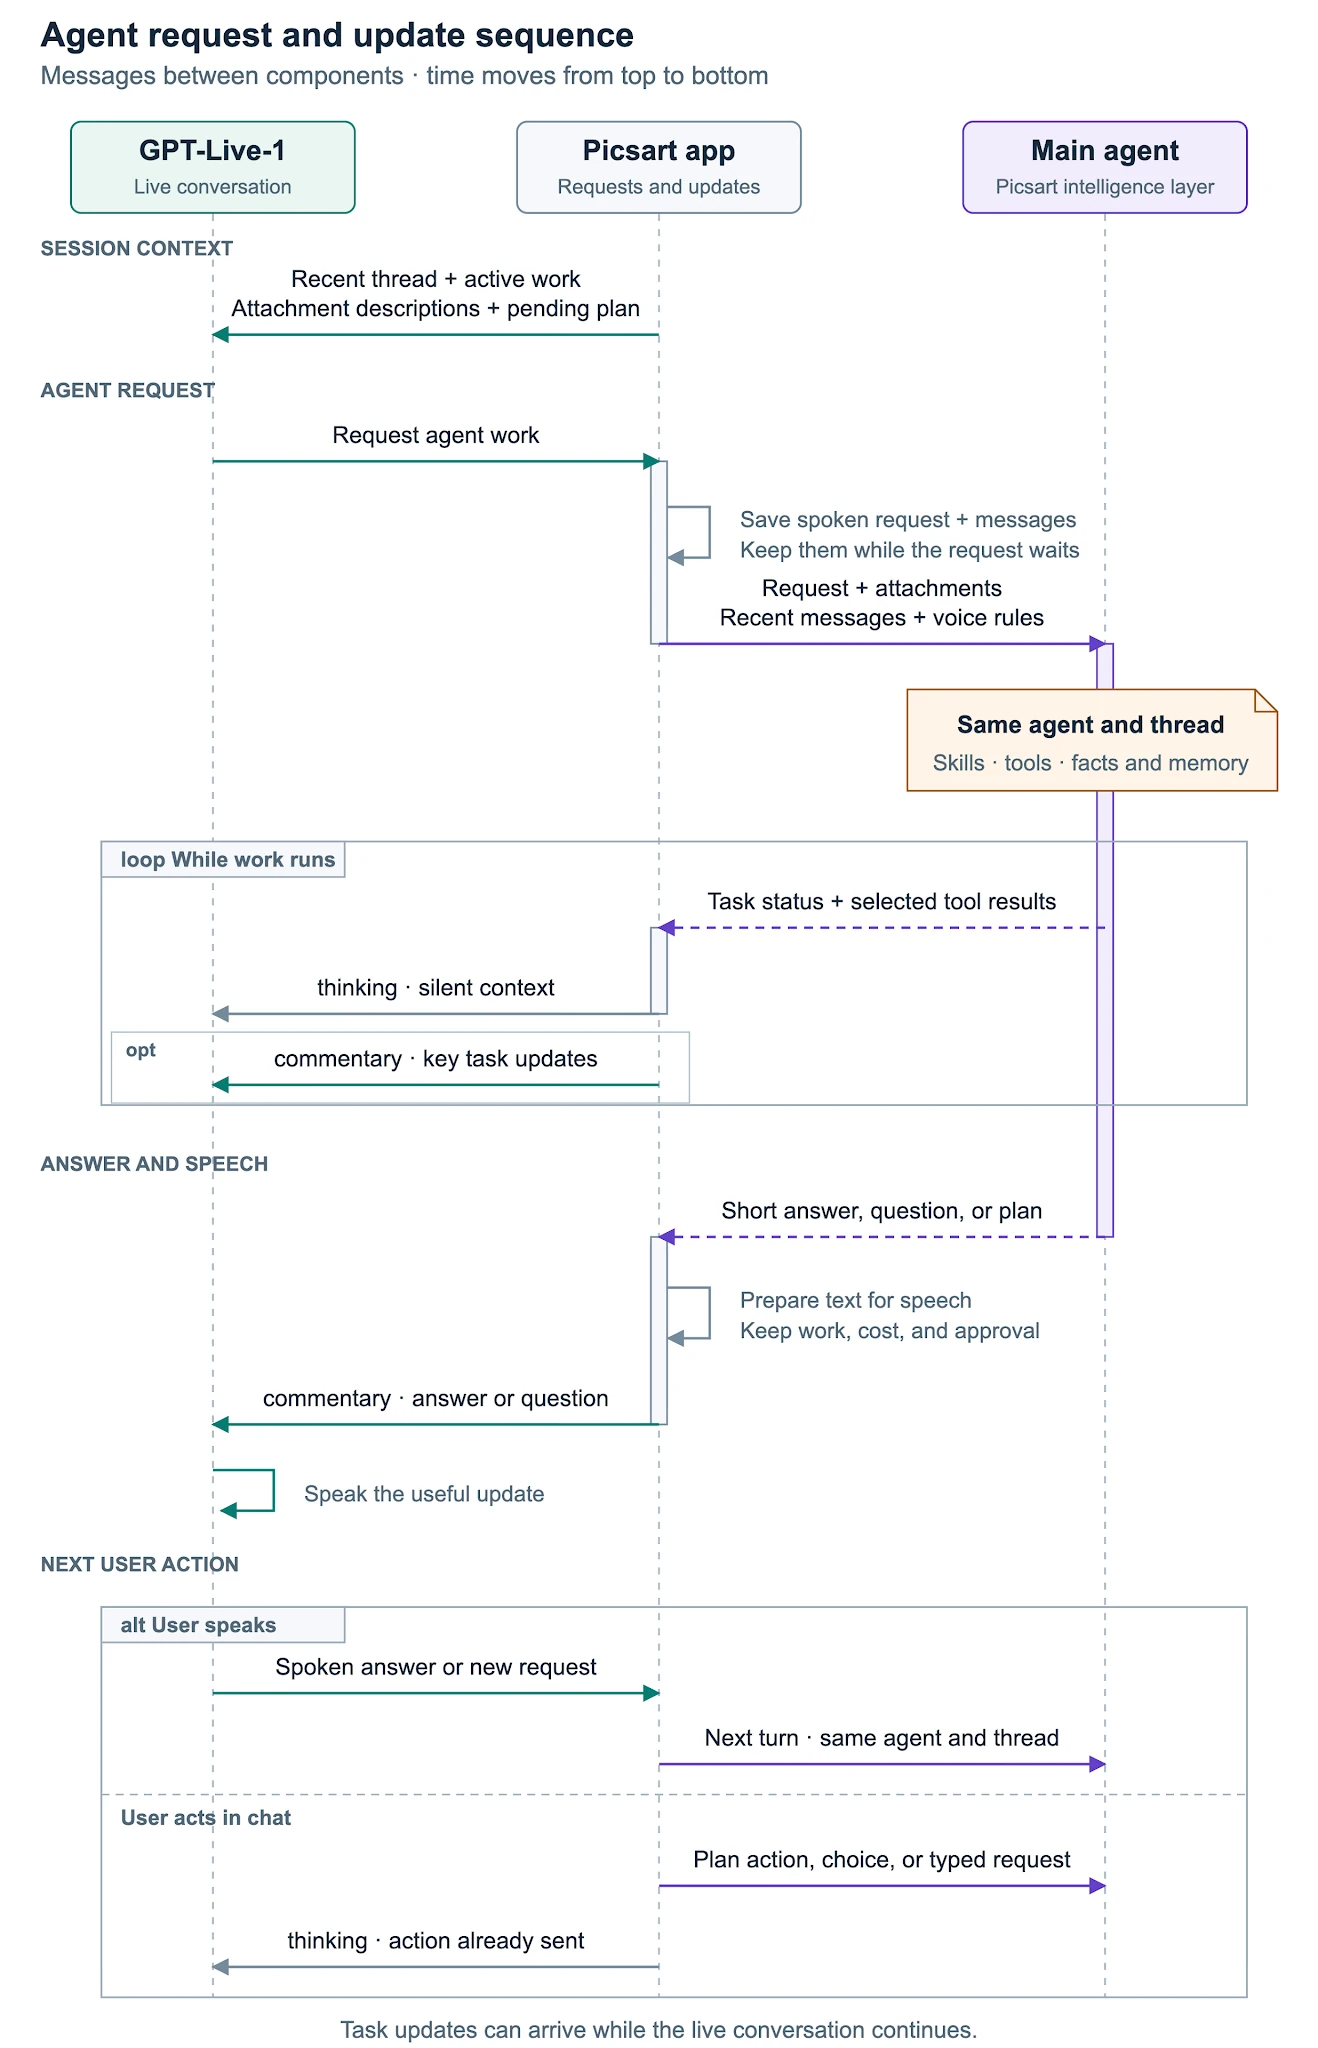
Routinemäßige Tool-Schritte laufen im Hintergrund ab. Wenn die Umsetzung eines Plans beginnt oder eine Aufgabe abgeschlossen ist, meldet sich der Sprachagent zu Wort. Wir fassen die nach und nach eintreffenden Antwortteile zu Sätzen zusammen und warten auf eine Gesprächspause, bevor wir sie an den Sprachagenten weitergeben. Trifft die endgültige Antwort ein, überspringen wir bereits übermittelten Text. Korrekturen und Fragen zur Genehmigung geben wir weiterhin weiter.
Welcher Kontext beim Anruf vorliegt und was gespeichert wird
Die Sitzungsanweisungen legen die Rolle des Agenten fest. Was er über die anrufende Person weiß, ergibt sich aus dem gespeicherten Kontext. Zu Beginn eines Anrufs laden wir die letzten Nachrichten, Beschreibungen von Anhängen, aktive Aufgaben und ausstehende Genehmigungen. So kann der Sprachagent dort anknüpfen, wo die Person aufgehört hat.
Das Langzeitgedächtnis bleibt beim Hauptagenten. Ist die Erinnerungsfunktion aktiviert, kann der Agent den Threadverlauf, Zusammenfassungen, gespeicherte Fakten sowie persönliche oder projektspezifische Präferenzen nutzen.
Wenn du sagst „Verwende den Stil, den wir gespeichert haben“, kann der Hauptagent ihn nachschlagen oder eine Rückfrage stellen und die Antwort an den Sprachagenten zurückgeben. Ist die Erinnerungsfunktion nicht verfügbar, kann das Gespräch mit weniger Kontext weiterlaufen.
Im Thread werden Anfragen an den Agenten und die zugehörigen Nachrichten gespeichert. Das umfasst nur einen Teil des gesprochenen Austauschs. Eine beiläufig erwähnte Präferenz bleibt nur dann erhalten, wenn der Hauptagent sie erhält und speichert.
Wann die Arbeit beginnt, weiterläuft oder endet
Wir geben einen Plan mündlich wieder, nachdem der Agent ihn erläutert hat. Dass die Arbeit läuft, melden wir erst, wenn der Agent den Start bestätigt hat. Den Arbeitsvorschlag, seine Kosten und die Frage nach der Genehmigung bringen wir gemeinsam zur Sprache. Zusätzlicher Kontext erteilt keine Erlaubnis, mehr zu tun oder mehr auszugeben.
Verpassen wir eine Meldung, rufen wir den aktuellen Stand der bestehenden Aufgabe ab. So müssen wir die Aufgabe weder neu starten noch Ergebnisse oder Genehmigungsfragen wiederholen.
Wenn du den Sprachagenten unterbrichst oder den Anruf beendest, läuft die Arbeit weiter. Um eine Aufgabe zu stoppen, musst du das gesondert anfordern. Bereits laufende Aktionen lassen sich dadurch unter Umständen nicht mehr anhalten. Neue Anfragen behalten ihren ursprünglichen Kontext und warten, bis der aktuelle Gesprächsschritt abgeschlossen ist. Bereits laufende Arbeiten werden dadurch nicht geändert.
Was wir gelernt haben: Der Sprachagent darf mehr wissen, als er sagt
Aus unserer Integration nehmen wir diese praktischen Hinweise mit:
- Lass den Hauptagenten die Antworten für die Sprachausgabe vorbereiten.
- Speichere den Kontext jeder Anfrage beim Absenden.
- Nutze für Sprache, Text und Aktionen auf dem Bildschirm denselben Thread und dieselben Regeln.
- Trenne das Gespräch von der Bearbeitung der Aufgabe.
Über Picsart
Picsart ist eine KI-Plattform für die Produktion und Verbreitung von Medien. Weltweit erstellen und vermarkten dort mehr als 100 Millionen Kreative und Unternehmen Inhalte und erzielen damit Einnahmen.
Seit mehr als 14 Jahren unterstützt Picsart eine neue Generation von Kreativen dabei, Geschichten auf Video zu erzählen, Inhalte in größerem Umfang zu produzieren und inzwischen auch zu monetarisieren. Mit intuitiven Designwerkzeugen, KI-gestützter Bild- und Videoerstellung sowie MCP- und CLI-Funktionen lässt sich Picsart dort einsetzen, wo Kreative arbeiten. Mit monatlich mehr als 100 Millionen aktiven Nutzenden und bislang über 2,5 Milliarden Downloads ermöglicht Picsart es Menschen, kreative Inhalte selbstbestimmt und in großem Umfang zu produzieren. Damit können sie ihre Identität ausdrücken, Einfluss gewinnen und Unternehmen aufbauen.
Treater: Sprachagenten so abstimmen, dass Anrufe mehr erreichen
Von Britt O’Daly, Co-founder and CEO, Ayaz Hafiz, Co-founder and CTO, und Sayd Agzamkhodjaev, Software Developer
Was ein Gespräch bewirken kann
Bei einem Anruf in einer Personalvermittlung sprach unser Sprachagent mit der Person, der das Unternehmen gehörte. Es ging um die Schwierigkeiten, die das Recruiting-Team mit der Software zur Terminplanung hatte.
Während sein Gegenüber erklärte, warum die bisherige Lösung nicht funktioniert hatte, fiel der Agent ihm immer wieder mit „Mhm“ und „Ja, genau“ ins Wort. Schließlich kürzte die Person das Gespräch ab:
Schick mir einfach eine E-Mail.
Der Agent hatte verstanden, was sein Gegenüber sagte. Seine Einwürfe machten das Gespräch trotzdem unangenehm. Eine Vertriebskraft würde aus dieser Erfahrung lernen und künftige Gespräche anders führen. Genau das wollten wir auch unseren Agenten ermöglichen.
Bei Treater entwickeln wir KI-Agenten, mit denen Unternehmen ihre Geschäftspartner per Telefon, E-Mail und SMS erreichen und mit ihnen zusammenarbeiten können. Unsere Agenten sollen durch besonders gute Gespräche die Ziele unserer Kundenunternehmen erreichen. Dafür haben wir ein Lernsystem entwickelt, das echte Gespräche auswertet, Verbesserungsmöglichkeiten erkennt und testet, mit welchen Agentenkonfigurationen die Unternehmen ihre Ziele besser erreichen.
In dieser Demo siehst du, wie unser Agent mit mehreren Beteiligten dafür sorgt, dass ein ausverkaufter Artikel in einem Lebensmittelgeschäft wieder aufgefüllt wird.
Agenten, die im Einsatz lernen
Vor GPT-Live verbrachten wir viel Zeit damit, unsere eigene technische Infrastruktur für Sprachanwendungen zu entwickeln und zu warten. Nach dem Umstieg konnten wir fast alles davon durch einfache Prompts ersetzen und erzielten bessere Ergebnisse. Längere Gespräche gehen bei unseren Kundenunternehmen mit besseren Ergebnissen einher. Seit dem Umstieg auf GPT-Live ist die Gesprächsdauer im Median um 26–30 % gestiegen, am 90. Perzentil um bis zu 40 %.
Die Quote, mit der unsere Agenten die für unsere Kundenunternehmen wichtigen Ziele erreichen, ist im Durchschnitt um 6 Prozentpunkte gestiegen.
So können wir mehr Zeit auf die Frage verwenden, „was unser Bier besser schmecken lässt“. Für uns heißt das: in einem Arbeitsumfeld, dessen Bedingungen sich laufend ändern, dazulernen und uns anpassen. Genau wie Menschen in ihre Aufgaben hineinwachsen, sollen unsere Agenten im Einsatz lernen, was hervorragende Arbeit ausmacht.
Wir erproben für jeden Agenten unterschiedliche Kombinationen aus Stimme, Prompt, Sprechrhythmus und verfügbaren Tools. Jedes Gespräch bewerten wir sowohl anhand unserer eigenen Kriterien (Gesprächsstimmung, ausgeführte Schritte) als auch anhand der Kriterien des Kundenunternehmens (berücksichtigte Präferenzen, Grad der Zielerreichung). Mit einem Multi-Armed-Bandit-Algorithmus leiten wir mehr Anrufe an Konfigurationen, die gut abschneiden. Schwache Varianten scheiden schnell aus.
Ein Prüfsystem wertet frühere Anrufe offline aus und schlägt neue Konfigurationen vor. Jeden Vorschlag spielen wir anhand vergangener Gespräche durch und schätzen den erwarteten Belohnungswert im Produktivbetrieb. Änderungen, die voraussichtlich keine nennenswerte Verbesserung bringen, verwerfen wir. Die übrigen legen wir unseren Kundenunternehmen zur Prüfung vor oder übernehmen sie auf Wunsch automatisch.
Vieles davon lässt sich mit GPT-Live sehr einfach konfigurieren. Tonfall, Sprechrhythmus, die Anpassung an die Energie des Gegenübers, der Grad der Förmlichkeit oder die Häufigkeit kurzer Zuhörsignale: Früher mussten wir dafür jeweils mehrere Komponenten unseres Sprachsystems aufeinander abstimmen. Heute genügt dafür meist eine Zeile in einem Prompt. So können wir Varianten gezielt vergleichen.
Was hat unser Agent aus dem Anruf bei der Personalvermittlung gelernt? Das zeigt die Demo.
Wie Treater-Agenten besser werden
Start with a goal
A software company wants demos with staffing agency owners. The catalog starts with one version of the agent.
Die Demo zeigt eine anonymisierte und vereinfachte Fassung der eingangs beschriebenen Kampagne. Ein Unternehmen möchte mit Personalvermittlungen Termine für Produktdemos vereinbaren und startet mit einem Agenten in der Grundkonfiguration.
- Unser System erkannte eine Verbesserungsmöglichkeit. Bei der Offline-Auswertung von Anrufen mit niedrigem Belohnungswert fielen Muster auf. Unter anderem unterbrach der Agent die Inhaberinnen und Inhaber in 20 % der Anrufe mit kurzen Zuhörsignalen. Das System schlug vier neue Konfigurationen vor.
- Das System schlug Verbesserungen vor. Wir simulierten jeden Vorschlag anhand früherer Anrufe und bewerteten ihn nach denselben Kriterien wie im Produktivbetrieb. Die Variante mit langsamerem Sprechtempo schnitt schlecht ab und schied sofort aus. Die übrigen wurden geprüft und genehmigt.
- Auswertung im Produktivbetrieb. Wie viele Anrufe die neuen Versionen erhalten, richtet sich nach dem erwarteten Belohnungswert. Innerhalb eines Tages führt Version B die meisten Gespräche. Version C holt nie auf und wird an Tag 3 abgeschaltet. Version D kommt an Tag 2 hinzu, übernimmt bis zum Beginn von Tag 3 die Führung und erhält am Ende etwa 90 % der Anrufe. A und B behalten einen kleinen Anteil, falls sich die Bedingungen ändern. Die Zahl der vereinbarten Demos pro 100 Anrufe steigt von 3,0 auf 4,3.
Wichtig ist der hierarchische Aufbau des Systems. Verbesserungen an unseren gemeinsam genutzten Harnesses kommen allen Anwendungsfällen zugute. Was wir in einem Ablauf lernen, dient als Ausgangspunkt für ähnliche Abläufe.
Was wir uns zu Herzen nehmen
- Alles ist eine Hypothese! Einer unserer deutlichsten Erfolge ergab sich, als ein Kundenunternehmen wollte, dass der Agent das Gespräch mit einer bevorstehenden Werbeaktion eröffnet. Anrufe liefen deutlich besser, wenn der Agent zuerst darauf einging, dass sich die Produkte zuletzt besser verkauft hatten.
- Richte die Belohnung an aussagekräftigen Ergebnissen aus, die für das Unternehmen etwas bewirken. Wenn sich ein Ergebnis erst spät bewerten lässt, etwa bei einem Vertragsabschluss, investiere in schneller messbare Zwischenziele wie die Vereinbarung eines Folgetermins. Prüfe aber, ob diese Zwischenziele tatsächlich mit dem gewünschten Ergebnis zusammenhängen.
- Sorge dafür, dass du das Umfeld, in dem deine Agenten arbeiten, beobachten und messen kannst. Simulationen und Benchmarks sind nur aussagekräftig, wenn sie die tatsächliche Verteilung der Fälle korrekt abbilden.
- Probiere mit GPT-Live aus, das gewünschte Verhalten zu beschreiben, statt jeden Schritt vorzugeben. Die Agenten können sich gut auf den Kontext einstellen und an allgemeinen Leitlinien orientieren, ohne ein vollständiges Skript zu brauchen.
Mit GPT-Live gelingt es uns immer wieder, die Gesprächsqualität sprunghaft zu verbessern. Wir sind gespannt, wohin uns die nächsten zehn Schritte führen!
Über Treater
Treater führt echte Gespräche, um deine Geschäftsziele zu erreichen, und behandelt jede Gelegenheit so, als wäre sie deine wichtigste. Auf unserer Plattform führen Tausende unterschiedliche Agenten Hunderttausende Anrufe. Im vergangenen Jahr ist das Anrufvolumen jeden Monat um 25 % gegenüber dem Vormonat gestiegen. Zu unseren Kunden zählen börsennotierte Unternehmen ebenso wie schnell wachsende Start-ups. Mehr erfährst du auf trytreater.com.
Weekend: Wie zwei Figuren mit GPT-Live in Wit’s End eine Szene spielen
Von Kevin Shen, Senior Software Engineer, und James Wilsterman, Co-founder and CTO bei Weekend
Was wir entwickeln wollten
Unser Spiel Wit’s End ist ein Fantasy-Tabletop-Rollenspiel, das man im Gespräch spielt. Sir Bart, unser KI-Spielleiter, erzählt die Geschichte und wendet die Regeln an. Die Spielenden müssen dafür nur sprechen. Mit dem Vollduplex-Audio von GPT-Live fühlt es sich an wie an einem echten Spieltisch: Die Spielenden fallen einander ins Wort, scherzen und streiten, und Sir Bart reagiert, während sie noch sprechen.
Der Schwachpunkt war die Besetzung. Eine GPT-Live-Sitzung spricht mit einer einzigen Stimme. Deshalb klangen der schroffe Hauptmann am Stadttor und die verängstigte alte Frau in der Taverne beide wie der Erzähler. Wir wollten, dass die Hauptfigur jeder Szene selbst zu Wort kommt, mit eigener Stimme und Persönlichkeit. Zugleich wollten wir erhalten, was das Spiel ausmacht: Die Spielenden können alles sagen, was ihnen einfällt, und die Geschichte findet trotzdem ihren Abschluss.
So läuft eine Szene heute ab. Die Gruppe erreicht das Tor von Timberfall. Sir Bart eröffnet die Szene und hält dann inne: „Eine Gruppe unerschütterlicher Wachen steht auf Posten. Ihr Hauptmann tritt vor, die Hand am Schwert, und mustert euch.“ Hauptmann Dmitri übernimmt mit tiefer, rauer Stimme. Er ist auf der Jagd nach einer Verräterin namens Jade, und die Gruppe passt auf die Beschreibung ihrer Komplizen. Jemand aus der Gruppe widerspricht ihm, und Dmitri hält dagegen. Eine andere Person steckt ihm eine Goldmünze zu. Sir Bart schaltet sich ein, kündigt den Würfelwurf an, erzählt, wie der Bestechungsversuch ausgeht, und überlässt Dmitri wieder das Wort. Der reagiert darauf.
Unsere Lösung: zwei Stimmen unter einer Regie
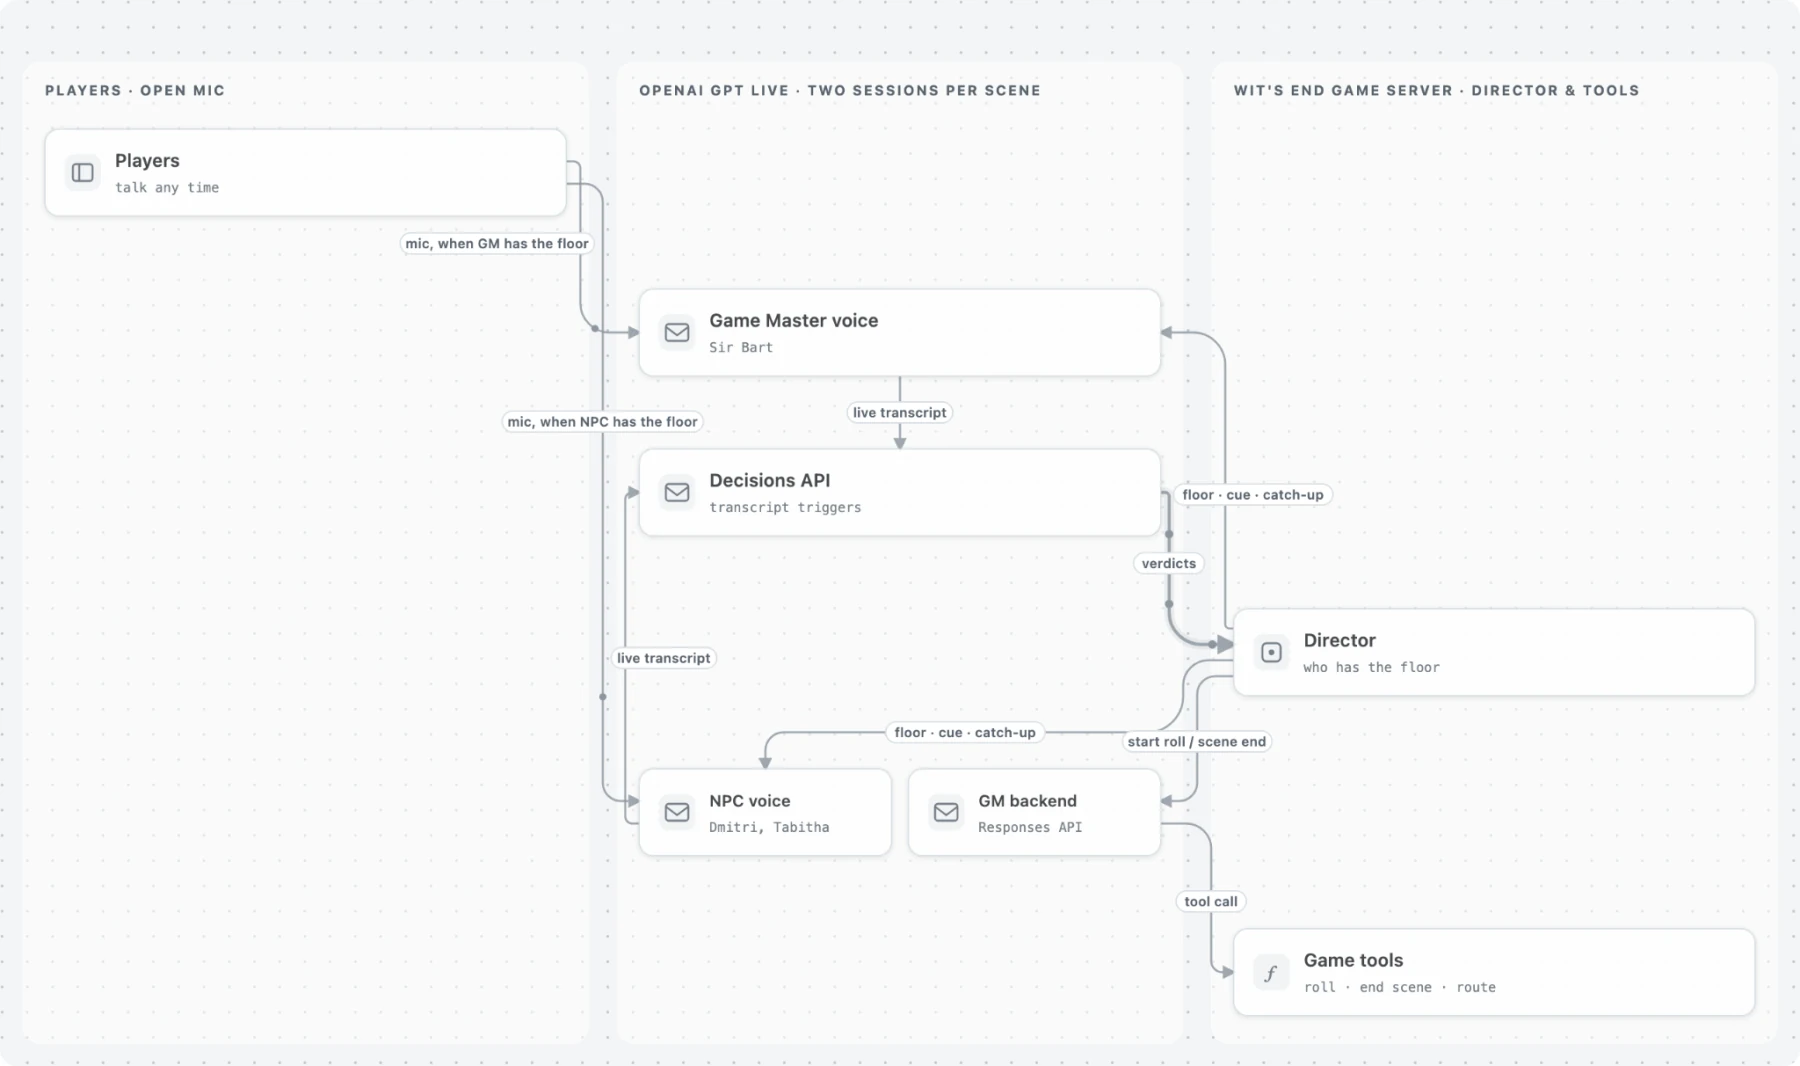
Wer hat das Wort? Anhand der Auswertungen der Decisions API zu den Transkripten beider Sitzungen erkennt die Regie, wer als Nächstes sprechen soll. Sie wechselt zwischen den beiden Stimmen und löst im Backend des Spielleiters Würfelwürfe und Szenenabschlüsse aus.
Für jede Szene laufen zwei GPT-Live-Sitzungen parallel: eine für Sir Bart und eine für die jeweilige Figur (Dmitri am Tor, Tabitha in der Taverne). Jede Sitzung hat einen eigenen Prompt und eine eigens gestaltete Stimme. Eine Regiekomponente auf unserem Spielserver bestimmt, wer das Wort hat. Nur diese Sitzung hört die Spielenden. Transkriptbasierte Trigger der Decisions API melden der Regie aus beiden Sitzungen, was im Gespräch passiert. Nur das Backend des Spielleiters, ein Responses-Modell, ruft die Spieltools für Würfelwürfe, Szenenabschlüsse und die Wahl des weiteren Wegs auf.
Zwei Persönlichkeiten, eine Geschichte
Für jede Figur trennen wir das Persönliche von dem, was alle über die Szene wissen müssen.
Die Persönlichkeit jeder Figur steht in ihrem eigenen Prompt.
Jeder Prompt beschreibt auch die Stimme der Figur. Dafür verwenden wir genau die Worte, mit denen wir die Stimme entworfen haben.
Beispiel für eine gemeinsame Szene
Die Szene ist beiden Sitzungen bekannt. Sir Bart und die Figur erhalten denselben Konflikt, dieselbe Auflösung und dieselben Handlungspunkte. Für jeden Punkt ist festgelegt, wer ihn zur Sprache bringt. Dmitri stellt sich vor und sagt, wen er jagt. Tabitha verrät der Gruppe, wo Jade sie treffen wird. Das Spiel beendet eine Szene erst, wenn die jeweils zuständige Stimme jeden ihrer Handlungspunkte ausgesprochen hat.
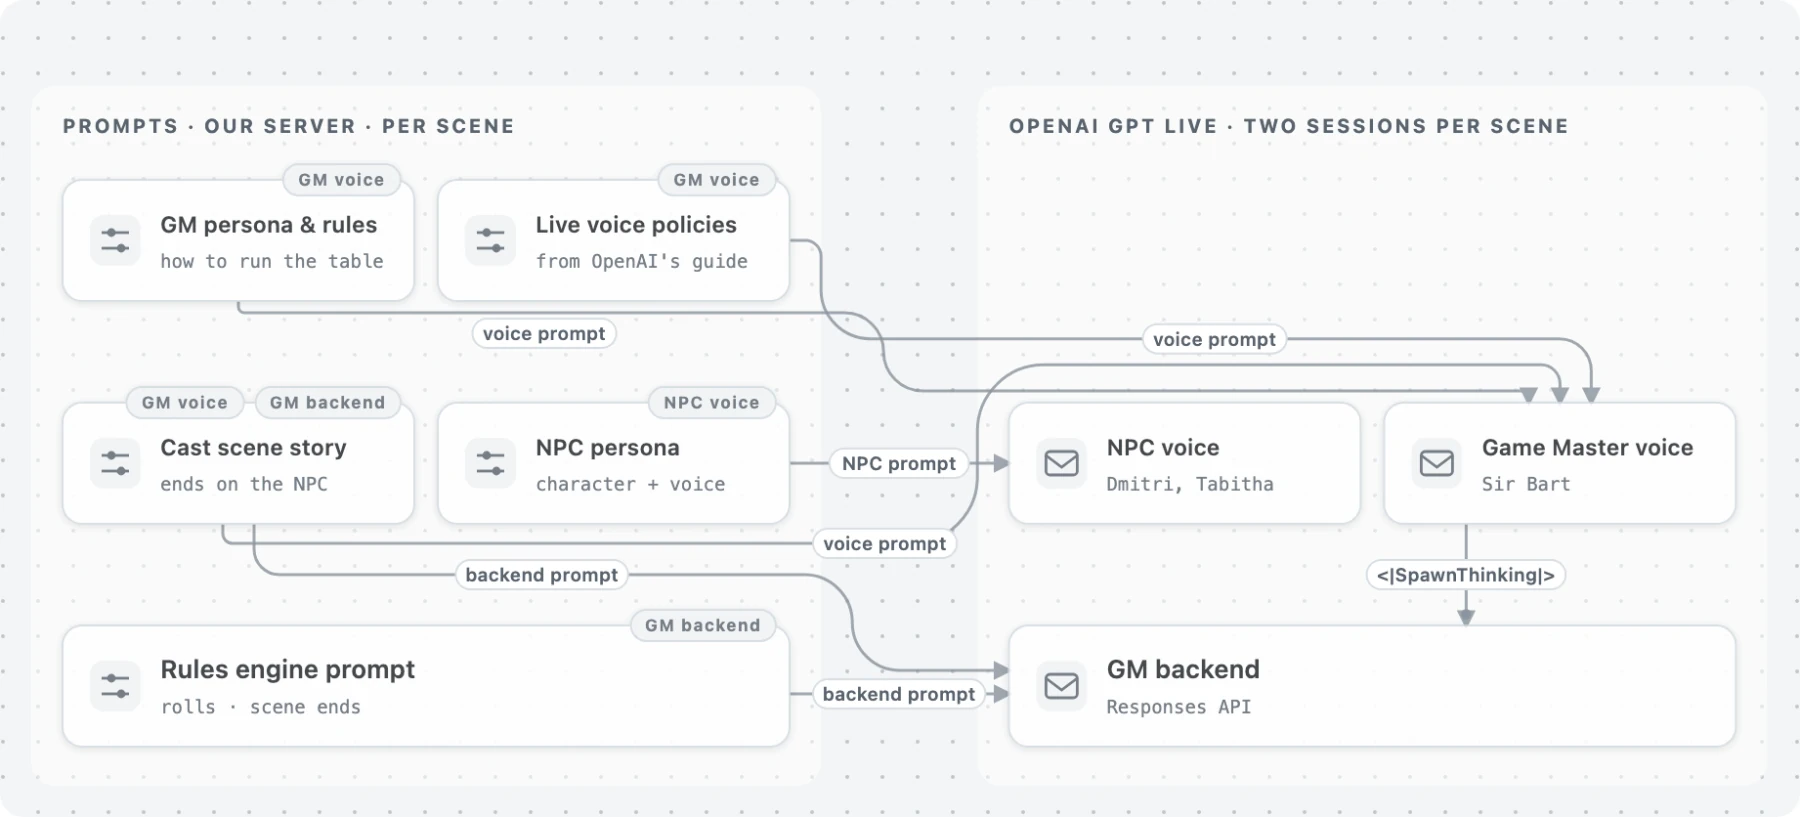
Aufbau der Prompts. Sir Barts Sprachsitzung und sein Backend kennen dieselbe Szenenhandlung. Die Figur erhält einen eigenen Prompt für ihre Rolle.
Aus dem Prompt der Figur
Du spielst eine Rolle in einer live gesprochenen Szene.
Ein Erzähler beschreibt die Welt. Du sprichst ausschließlich
als du selbst, laut und in der ersten Person.
- Übernimm nie die Erzählung, beschreibe weder deine eigenen
  Handlungen noch deine Stimme und sprich nie für die Reisenden
  oder den Erzähler.
- Entscheide nie, ob ein riskanter Versuch gelingt.
  Reagiere mit einem kurzen Satz und halte dann inne.
  Der Erzähler entscheidet, wie der Versuch ausgeht.
- Sprich nur, wenn dich jemand aus der Reisegruppe anspricht
  oder du das Wort erhältst.
Wie die Regie entscheidet, wer als Nächstes spricht
Die Regie erzeugt selbst keine Sprache. Sie nutzt die Auswertungen der Decisions API zu eingehenden Transkriptfragmenten, um zu erkennen, an wen sich jemand wendet, ob eine Aktion einen Würfelwurf erfordert und wann die Erzählung oder die letzte Äußerung einer Figur einen Sprecherwechsel ankündigt.

Die Einschätzung ändert sich, während jemand spricht. Um zu bestimmen, an wen sich die Äußerung richtet, wartet die Regie auf die abschließende Auswertung am Ende des Redebeitrags. Eine riskante Aktion übergibt sie dem Spielleiter, sobald sie diese erkennt.
Wer als Nächstes spricht
| Situation | Wer als Nächstes spricht |
|---|---|
| Sir Bart beendet seine Erzählung und die Bewertung für das Stichwort liegt bei mindestens 0,6, oder seine Äußerung endet mit einem Verb des Sprechens („Tabitha calls after you“) | Die Figur |
| Jemand spricht die Figur an, während Sir Bart das Wort hat | Die Figur. Sie erhält die Äußerung, auf die sie antworten soll |
| Jemand versucht etwas Riskantes, etwa jemanden zu bestechen, zu lügen, sich vorbeizuschleichen oder zu kämpfen | Sir Bart, sofort und bei Bedarf mitten im Satz. Die Regie löst den Wurf in seinem Backend aus. Er erzählt das Ergebnis und gibt das Wort zurück |
| Jemand fragt den Erzähler etwas oder beschreibt, was die eigene Spielfigur tut | Sir Bart |
| Die Spielenden unterhalten sich untereinander | Niemand. Die Sitzung, die das Wort hat, erhält einmalig den Hinweis, diese Äußerung unkommentiert zu lassen |
| Die Figur beendet ihren Part mit eigenen Worten („Na los, dann geht. Zieht die Köpfe ein.“) | Sir Bart, sobald die Figur ausgesprochen hat. Die Regie löst den Szenenabschluss in seinem Backend aus |
| Wer das Wort erhalten hat, schweigt 2,5 s lang | Dieselbe Stimme wird erneut zum Sprechen aufgefordert |
Wie die Übergabe abläuft
Bei jeder Übergabe führt die Regie vier Schritte aus:
- Sie schaltet die Sitzung stumm, die das Wort abgibt, weist sie an aufzuhören und verwirft alle Audiodaten in deren Warteschlange.
- Sie übermittelt der Sitzung, die das Wort erhält, mit
session.thinking.appendalles Verpasste als unausgesprochenen Kontext. Dieselben Äußerungen fließen in den Decisions-Kontext dieser Sitzung ein, damit ihre Trigger denselben Verlauf berücksichtigen. - Sie hebt die Stummschaltung der neuen Sitzung auf und gibt ihr das Stichwort.
- Sie hält die Mikrofone der Spielenden gesperrt, bis der erste Satz der neuen Stimme zu hören war, höchstens jedoch 8 s. So kann niemand die Übergabe übertönen.
Da die Sitzung der Figur bereits läuft, dauert es bei einer Übergabe im Durchschnitt 0,84 s bis zur ersten Audioausgabe. Bei einer neuen Sitzung sind es 1,54 s.
Wie das Spiel zu einem Ergebnis kommt
Die Stimmen improvisieren. Die App entscheidet, wann etwas passiert.
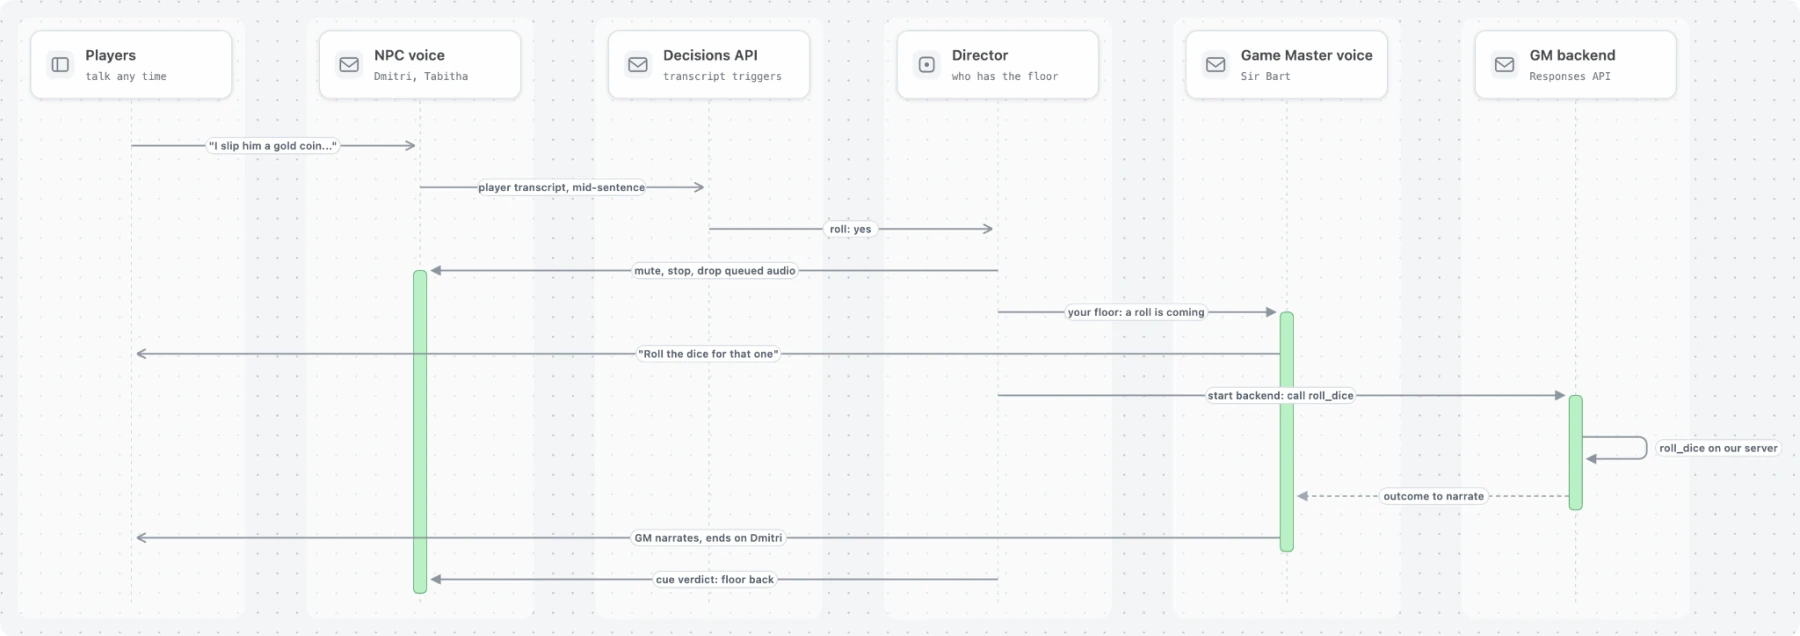
Ein Bestechungsversuch, während Dmitri das Wort hat. Mitten im Satz meldet die Auswertung, dass gewürfelt werden muss. Die Regie erteilt Sir Bart das Wort und löst den Wurf in seinem Backend aus. Sobald Sir Bart das Ergebnis erzählt hat, erkennt die Auswertung das Stichwort und Dmitri erhält das Wort zurück.
- Die Regie löst Würfelwürfe und Szenenabschlüsse selbst aus. Bei einem Spieltest sagte Sir Bart „You’re going to have to roll the dice for that one“, übergab aber nie an sein Backend. Also fiel kein Würfel und Sir Bart erfand das Ergebnis. Jetzt stößt die Regie direkt in seinem Backend eine Antwort an. Während der Verarbeitung spricht die Stimme einen kurzen Satz und erzählt dann das Ergebnis.
- Die Würfel entscheiden jede Szene. Szene 1 endet mit einem erfolgreichen Wurf. Gibt Dmitri nach, bevor überhaupt gewürfelt wurde, lässt die Regie über den Versuch der Gruppe würfeln. Die Szene bleibt bis dahin offen.
- Eine Figur kann ihren Part beenden. Der Spielleiter schließt die Szene ab. Sobald Tabitha der Gruppe sagt, dass Jade sie am Sprite Altar treffen wird, gibt die Regie Sir Bart das Wort. Sein Backend markiert die Szene als abgeschlossen, und er stellt die beiden Wege vor, auf denen es weitergeht.
Was wir gelernt haben
- Nur eine Sitzung sollte die Spielenden hören. Als beide Systeme zuhörten, antworteten beide auf jede Testäußerung und widersprachen sich dabei oft. Dmitri lehnte eine Bestechung ab, während der Spielleiter erzählte, wie er das Geld einsteckte.
- Auch eine stummgeschaltete Sitzung kann weiter Sprache erzeugen. Weise sie an aufzuhören und verwirf die Audiodaten in ihrer Warteschlange. Sobald sie das Wort zurückbekommt, hebe die Anweisung „Schweige“ ausdrücklich auf. Bei uns antwortete der Spielleiter eine ganze Szene lang niemandem, weil die Anweisung noch galt.
- Halte jede Stimme einsatzbereit. Die Stimme einer Sitzung wird beim Start festgelegt. Deshalb braucht jede Stimme ihre eigene Sitzung. Starten wir die Sitzung der Figur zu Beginn der Szene, sparen wir bei jeder Übergabe rund 0,7 s. Das macht den Unterschied zwischen einem fließenden Wechsel und einer unangenehmen Pause.
- Reagiere zum richtigen Zeitpunkt auf die jeweilige Auswertung. Die Einschätzungen treffen ein, während jemand noch spricht. Die letzte liegt im Median 0,19 s nach dem Ende der Äußerung vor. Übergib dem Spielleiter einen riskanten Zug, sobald er erkannt wird. Entscheide erst am Ende des Redebeitrags anhand der endgültigen Auswertung, an wen er gerichtet war.
- Formuliere Ja-Nein-Fragen als Prüfaussagen, bestimme Schwellenwerte anhand echter Äußerungen und halte eine einfache Regel als Rückfallebene bereit. Bei „Should Dmitri speak next?“ waren als Prüfaussage 11 von 12 Entscheidungen richtig, bei einer Auswahl zwischen zwei Möglichkeiten 8 von 12. Bei einem Schwellenwert von 0,4 galt „You’re going to have to roll the dice for that one“ als Stichwort. Dmitri bekam mitten im Würfelwurf das Wort. Echte Stichworte erreichten Werte ab 0,94, deshalb verwenden wir 0,6. „Tabitha calls after you“ erreichte nur 0,04. Eine zusätzliche Prüfung auf Verben des Sprechens erkennt deshalb Erzählpassagen, die genau dort aufhören, wo die Figur einsetzen soll.
- Lege für jedes Ergebnis genau eine Zuständigkeit fest. Nur das Backend des Spielleiters ruft Tools auf. Würfelwürfe und Szenenabschlüsse löst ausschließlich die App aus. So kann jede Figur frei improvisieren, ohne die Spielregeln zu verbiegen.
Über die Autoren und das Unternehmen
Das Team von Weekend entwickelt Wit’s End, ein sprachgesteuertes Fantasy-Tabletop-Rollenspiel für Browser und Fernseher. Ein KI-Spielleiter führt durch die Geschichte, und die Spielenden müssen nur sprechen. Du kannst es auf witsend.ai spielen.
Weekend, früher Volley, entwickelt sprachgesteuerte Spiele für den Fernseher. So können Familien vor dem Fernseher gemeinsam spielen und mitreden. Die mehr als 25 Spiele, darunter Jeopardy!, Wheel of Fortune, Song Quiz und Wit’s End, laufen auf Roku, Fire TV sowie Fernsehern von Samsung und LG. Sie wurden bereits in mehr als 30 Millionen Haushalten gespielt. Zu den Investoren von Weekend zählen Microsofts M12, Lightspeed Venture Partners und Y Combinator.
Wie es mit Sprachagenten weitergeht
Der nächste Schritt für Sprachanwendungen reicht über bessere Gespräche hinaus. Es geht um Software, die weiter zuhört, während sie Aufgaben erledigt, Kontext über verschiedene Schnittstellen hinweg erhält und mehrere Stimmen koordiniert, ohne den Gesprächsfaden zu verlieren. Weil GPT-Live gleichzeitig zuhören und sprechen kann, lassen sich Anwendungen entwickeln, die dem natürlichen Gesprächsrhythmus folgen. Niemand muss warten, bis die Software ausgesprochen hat.
Die vier Erfahrungsberichte zeigen, was das in der Praxis erfordert. Juno testet Stimmen mit den Menschen, die sie nutzen. Picsart stimmt Gespräch und Hintergrundarbeit aufeinander ab. Treater lernt aus echten Anrufen. Weekend gibt jeder Figur eine Stimme und behält dabei die Kontrolle über das Spiel.
Mit GPT-Live können Menschen Software auf intuitive Weise nutzen, und Agenten können neue Aufgaben übernehmen. Du kannst eine kreative Idee im Gespräch entwickeln, laufende Arbeit mitgestalten oder in eine Geschichte eintauchen und beeinflussen, wie es weitergeht. Diese Projekte zeigen erste Möglichkeiten, die sich eröffnen, wenn das Gespräch ein Teil der Funktionsweise von Software wird.
Wenn du eine eigene Anwendung entwickeln möchtest, findest du die ersten Schritte im Einstiegsleitfaden zu GPT-Live und in der Dokumentation zu Delegation und Tools.