
Wie du mit LLMs möglichst korrekte Antworten und konsistentes Verhalten erzielst
LLMs zu optimieren ist schwierig.
Wir haben mit vielen Entwicklungsteams in Start-ups und großen Unternehmen zusammengearbeitet. Dabei zeigte sich immer wieder, dass drei Fragen besonders schwierig zu beantworten sind:
- Wo fängst du an, wenn du die Genauigkeit verbessern willst?
- Wann eignet sich welche Optimierungsmethode?
- Welche Genauigkeit ist gut genug für den Produktivbetrieb?
Dieser Leitfaden gibt dir ein Denkmodell an die Hand, mit dem du die Genauigkeit und das Verhalten von LLMs optimieren kannst. Wir betrachten Methoden wie Prompt Engineering, Retrieval-Augmented Generation (RAG) und Fine-Tuning. Du erfährst, wann und wie du die einzelnen Techniken einsetzt und auf welche Fallstricke du achten solltest.
Überlege dir beim Lesen, was Genauigkeit in deinem konkreten Anwendungsfall bedeutet. Es macht einen Unterschied, ob jemand einen schlecht formulierten Text überarbeiten muss oder ob du versehentlich 1.000 USD statt 100 USD erstattest. Bevor du über die Genauigkeit eines LLM sprichst, solltest du grob einschätzen können, was dich ein Fehler des Modells kostet und wie viel du mit einem korrekten Ergebnis sparst oder verdienst. Darauf kommen wir am Ende zurück, wenn es darum geht, welche Genauigkeit für den Produktivbetrieb „gut genug“ ist.
Ansatzpunkte für die Optimierung von LLMs
Viele Anleitungen beschreiben die Optimierung als einfache Abfolge: Du beginnst mit Prompt Engineering, gehst dann zu Retrieval-Augmented Generation über und schließlich zum Fine-Tuning. In der Praxis läuft es oft anders. Die Methoden lösen unterschiedliche Probleme. Welche dich weiterbringt, hängt davon ab, was du verbessern willst.
Hilfreicher ist es, sich die Optimierung von LLMs als Matrix vorzustellen:

Bei einer typischen LLM-Aufgabe starten wir unten links mit Prompt Engineering. Wir testen Prompts, lernen aus den Ergebnissen und ermitteln durch Auswertung einen Ausgangswert. Anhand der Beispiele untersuchen wir, warum Antworten falsch sind. Danach können wir an einer von zwei Stellen ansetzen:
- Kontext optimieren: Optimiere den Kontext, wenn 1) dem Modell Wissen fehlt, weil es in den Trainingsdaten nicht vorkam, 2) sein Wissen veraltet ist oder 3) es unternehmensinterne Informationen braucht. Auf dieser Achse optimierst du die Genauigkeit der Antworten.
- LLM optimieren: Optimiere das LLM, wenn 1) die Ergebnisse uneinheitlich und falsch formatiert sind, 2) der Ton oder der Sprachstil nicht passt oder 3) das Modell beim Reasoning die vorgesehenen Schritte nicht zuverlässig einhält. Auf dieser Achse optimierst du die Konsistenz des Verhaltens.
In der Praxis optimieren wir schrittweise. Wir werten die Ergebnisse aus, stellen eine Hypothese auf, was helfen könnte, und probieren die Änderung aus. Anschließend bewerten wir die Ergebnisse erneut und entscheiden über den nächsten Schritt. Ein typischer Ablauf sieht so aus:
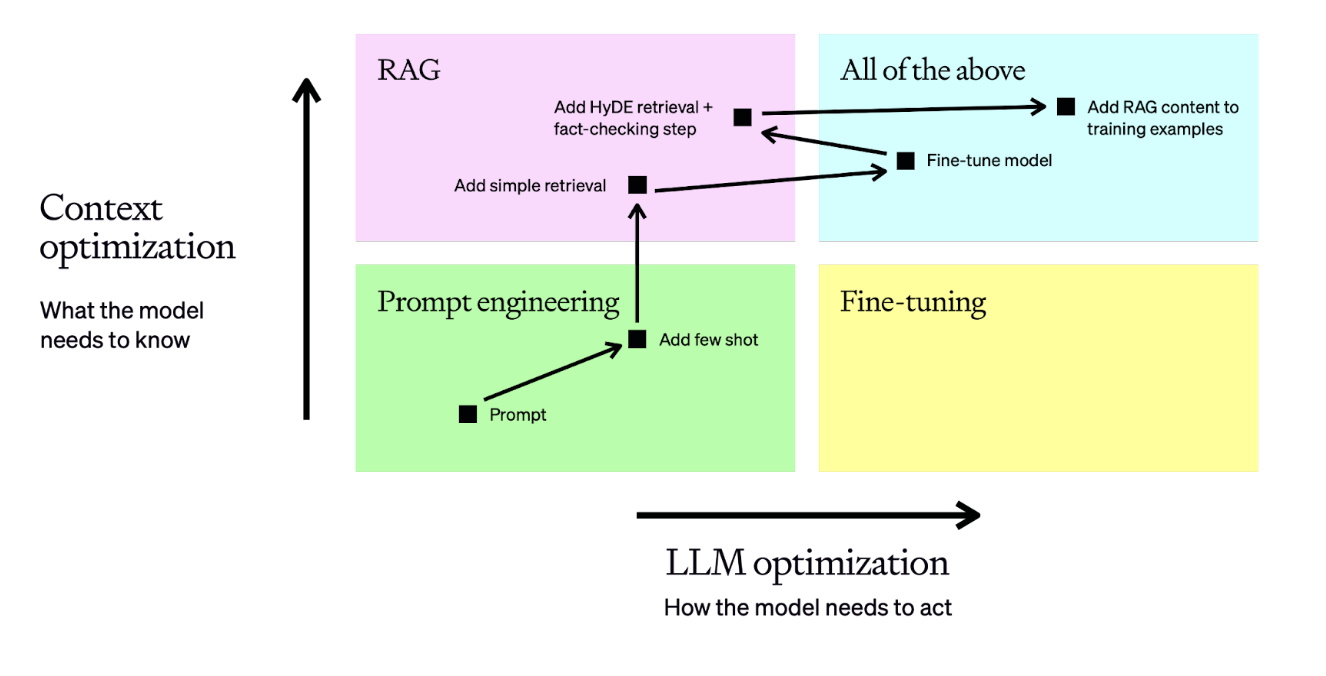
In diesem Beispiel gehen wir so vor:
- Wir beginnen mit einem Prompt und bewerten die Ergebnisse.
- Wir ergänzen feste Few-Shot-Beispiele, damit die Ergebnisse konsistenter ausfallen.
- Wir ergänzen einen Abrufschritt, der je nach Frage passende Few-Shot-Beispiele auswählt. So bekommt das Modell zu jeder Eingabe relevanten Kontext und liefert bessere Ergebnisse.
- Wir stellen einen Datensatz mit mindestens 50 Beispielen zusammen und führen ein Fine-Tuning des Modells durch, um die Konsistenz zu verbessern.
- Wir optimieren den Abruf und ergänzen einen Faktencheck, der Halluzinationen aufdeckt, um die Genauigkeit weiter zu erhöhen.
- Wir trainieren das bereits per Fine-Tuning angepasste Modell erneut mit den neuen Trainingsbeispielen, die unsere verbesserten RAG-Eingaben enthalten.
Dieser Ablauf ist typisch für die Optimierung bei anspruchsvollen Aufgaben im Unternehmen. Er hilft uns zu entscheiden, ob das Modell relevanteren Kontext braucht oder sich konsistenter verhalten muss. Damit wissen wir, wo wir mit der Optimierung ansetzen sollten.
Sehen wir uns jetzt an, wie du in den einzelnen Bereichen vorgehst. Wir beginnen unten links mit Prompt Engineering.
Prompt Engineering
Prompt Engineering ist in der Regel der beste Einstieg**. Für Aufgaben wie Zusammenfassen, Übersetzen und Codegenerierung reicht es oft schon aus. Hier kann ein Zero-Shot-Ansatz die für den Produktivbetrieb nötige Genauigkeit und Konsistenz erreichen.
Beim Prompt Engineering musst du festlegen, was Genauigkeit für deinen Anwendungsfall bedeutet. Schon beim einfachsten Test gibst du dem Modell eine Eingabe und musst beurteilen können, ob das Ergebnis deinen Erwartungen entspricht. Wenn es davon abweicht, zeigt dir die Frage nach dem Warum, wie du weiter optimieren kannst.
Beginne deshalb immer mit einem einfachen Prompt und einer klaren Vorstellung vom erwarteten Ergebnis. Ergänze dann Kontext, Anweisungen oder Beispiele, bis der Prompt das gewünschte Ergebnis liefert.
Optimierung
Für die Optimierung deiner Prompts orientiere ich mich vor allem an den Strategien aus dem Leitfaden zum Prompt Engineering in der API-Dokumentation von OpenAI. Je nach Strategie optimierst du den Kontext, das LLM oder beides:
| Strategie | Kontextoptimierung | LLM-Optimierung |
|---|---|---|
| Klare Anweisungen schreiben | X | |
| Komplexe Aufgaben in einfachere Teilaufgaben zerlegen | X | X |
| GPTs Zeit zum „Nachdenken“ geben | X | |
| Änderungen systematisch testen | X | X |
| Referenztexte bereitstellen | X | |
| Externe Tools nutzen | X |
An einem konkreten Beispiel lässt sich besser nachvollziehen, wie diese Strategien funktionieren. Wir testen sie, indem wir mit gpt-4-turbo isländische Sätze korrigieren.
Prompt Engineering eignet sich gut als Einstieg. Mit den passenden Anpassungen lassen sich die Ergebnisse schon deutlich verbessern.
Die größte Schwierigkeit beim Prompt Engineering liegt darin, dass es sich oft nur begrenzt skalieren lässt. Für ein breiteres Spektrum von Aufgaben müssen wir dem Modell unter Umständen dynamisch Kontext zuführen, weil feste Inhalte im Prompt nicht mehr ausreichen. Oder wir brauchen ein konsistenteres Verhalten, als wir mit Few-Shot-Beispielen erreichen können.
Modelle mit großen Kontextfenstern erweitern die Möglichkeiten des Prompt Engineering. Bei sehr langen Prompts mit komplexen Anweisungen fällt es Modellen aber mitunter schwer, alle Inhalte zu berücksichtigen. Teste solche Modelle deshalb immer mit unterschiedlich viel Kontext, um zu prüfen, ob Informationen in der Mitte verloren gehen. Der Ausdruck „Lost in the Middle“ beschreibt, dass ein LLM nicht allen Tokens einer Eingabe gleichzeitig dieselbe Aufmerksamkeit schenken kann. Dadurch übersieht es mitunter scheinbar willkürlich Informationen. Du kannst lange Kontexte einsetzen, solltest sie aber gründlich evaluieren. Greg Kamradt hat dazu im Rahmen seiner Open-Source-Arbeit den Test Needle in A Haystack (NITA) entwickelt. Er platzierte eine einzelne Information an unterschiedlichen Stellen in langen Dokumenten und prüfte, wie gut das Modell sie wiederfand. Das veranschaulicht den Nachteil langer Kontexte: Wenn du alles in den Kontext aufnimmst, wird der Abruf zwar wesentlich einfacher, die Genauigkeit kann aber darunter leiden.
Wie weit kommst du also mit Prompt Engineering? Das hängt von deiner Aufgabe ab. Evaluationen helfen dir bei der Entscheidung.
Evaluation
Das beste Ergebnis dieser Phase ist deshalb ein guter Prompt mit einem Evaluationsdatensatz aus Fragen und Referenzantworten. Wenn wir mindestens 20 Frage-Antwort-Paare haben, die Fehler im Detail untersucht und eine Hypothese zu ihrer Ursache aufgestellt haben, können wir auf dieser Grundlage anspruchsvollere Optimierungsmethoden testen.
Bevor du zu diesen Methoden übergehst, lohnt es sich zu überlegen, wie du die Evaluation automatisieren kannst. So kannst du Änderungen schneller testen. In der Praxis haben sich unter anderem folgende Ansätze bewährt:
- Metriken wie ROUGE oder BERTScore liefern eine grobe Einschätzung. Ihre Werte stimmen nur bedingt mit menschlichen Bewertungen überein. Sie zeigen dir aber schnell, wie stark sich die Modellergebnisse von einem Durchlauf zum nächsten verändert haben.
- Du kannst GPT-4 wie in der G-Eval-Studie beschrieben zur Bewertung einsetzen. Dazu gibst du dem LLM ein Bewertungsraster, anhand dessen es das Ergebnis möglichst objektiv beurteilen kann.
Wenn du die Methoden genauer kennenlernen möchtest, zeigt dir dieses Cookbook-Beispiel, wie du sie in der Praxis anwendest.
Das passende Werkzeug auswählen
Du hast deinen Prompt optimiert und einen Evaluationsdatensatz zusammengestellt. Trotzdem liefert das Modell noch nicht die Ergebnisse, die du brauchst. Jetzt kommt es darauf an, die Fehlerursache zu finden und zu entscheiden, mit welchem Werkzeug du sie am besten behebst.
Dabei hilft dir folgendes Schema:
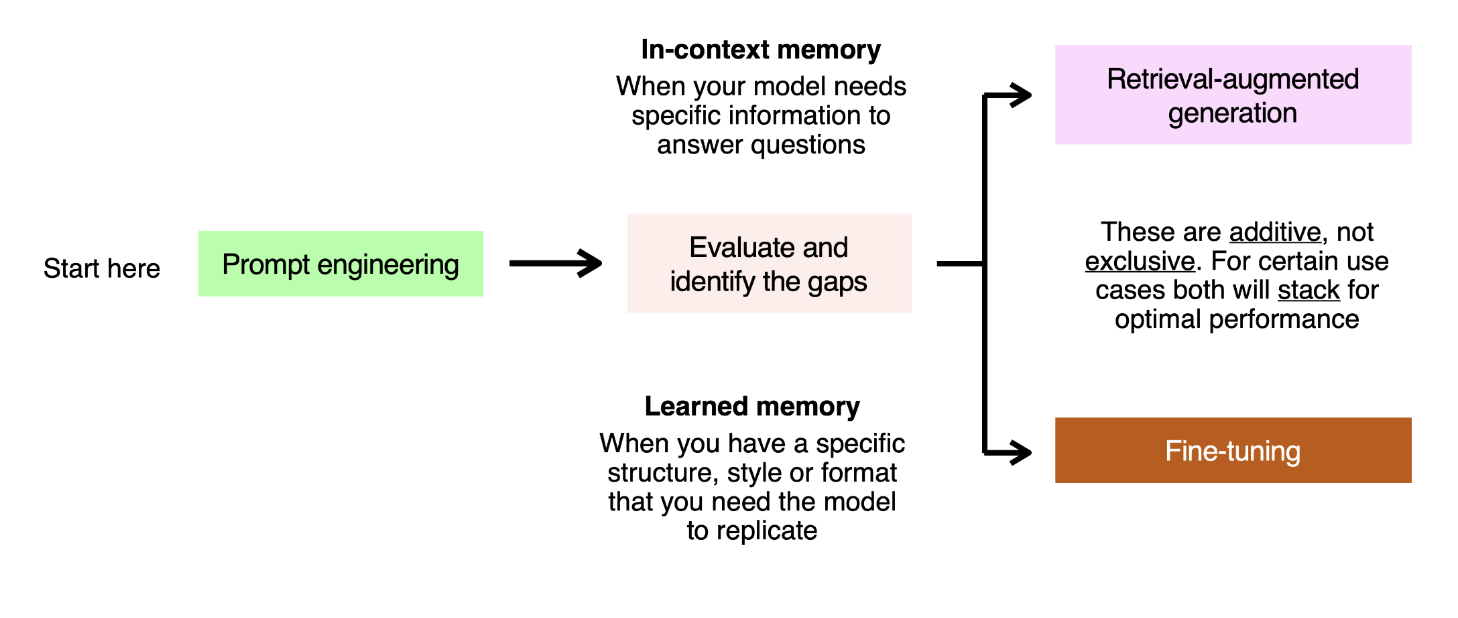
Bei jeder falsch beantworteten Frage kannst du prüfen, ob das Problem beim Wissen im Kontext oder beim erlernten Wissen liegt. Stell dir vor, du schreibst eine Prüfung. Es gibt zwei Wege, zur richtigen Antwort zu kommen:
- Du hast in den vergangenen sechs Monaten am Unterricht teilgenommen und immer wieder Beispiele dafür gesehen, wie ein bestimmtes Konzept funktioniert. Du greifst auf erlerntes Wissen zurück. Bei einem LLM erreichst du das, indem du dem Modell Beispiele für Prompts und die erwarteten Antworten zeigst, aus denen es lernen kann.
- Du hast das Lehrbuch dabei und kannst die Informationen nachschlagen, die du für die Antwort brauchst. Das entspricht dem Wissen im Kontext. Bei LLMs stellen wir die relevanten Informationen im Kontextfenster bereit. Das geht statisch mit Prompt Engineering oder in größerem Maßstab mit RAG.
Diese Optimierungsmethoden ergänzen einander und lassen sich kombinieren. Bei manchen Anwendungen brauchst du beide, um die besten Ergebnisse zu erzielen.
Nehmen wir an, das Problem liegt beim Kurzzeitgedächtnis. In diesem Fall setzen wir RAG ein.
Retrieval-Augmented Generation (RAG)
Bei RAG rufst du Inhalte ab (Retrieval), ergänzt damit den Prompt deines LLM (Augmented) und lässt es anschließend eine Antwort generieren (Generation). So erhält das Modell Zugriff auf fachspezifischen Kontext, den es zur Lösung einer Aufgabe braucht.
Mit RAG lassen sich die Genauigkeit und die Konsistenz eines LLM erheblich steigern. Bei vielen der größten Implementierungen für Kundenunternehmen von OpenAI kamen ausschließlich Prompt Engineering und RAG zum Einsatz.
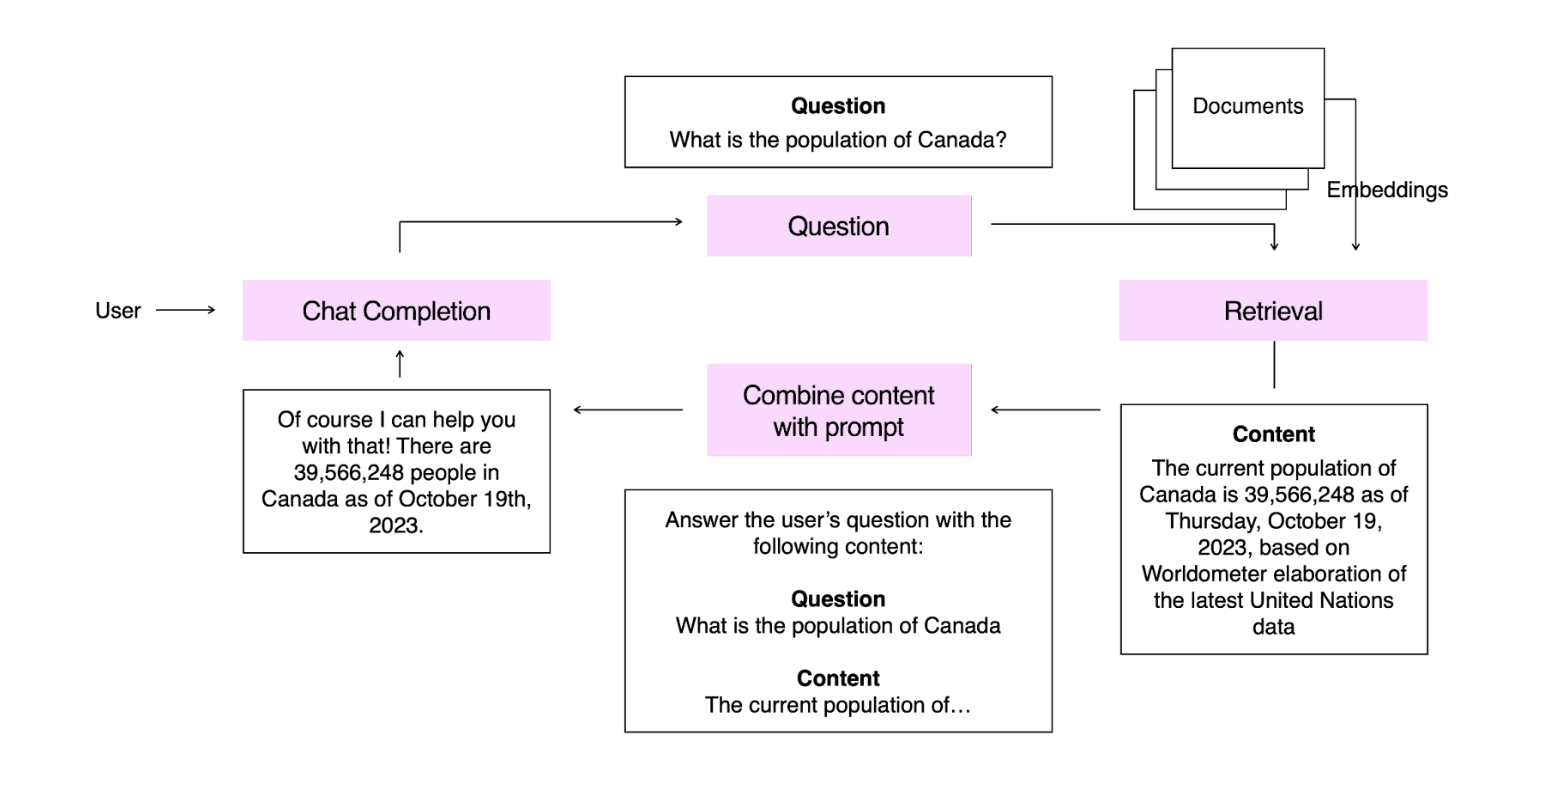
In diesem Beispiel haben wir für die Inhalte einer Wissensdatenbank mit Statistiken Embeddings erstellt. Wenn jemand eine Frage stellt, erstellen wir auch dafür ein Embedding und rufen die relevantesten Inhalte aus der Wissensdatenbank ab. Das Modell erhält diese Inhalte und beantwortet damit die Frage.
Bei RAG-Anwendungen kommt eine weitere Achse der Optimierung hinzu: der Abruf. Damit RAG funktioniert, müssen wir dem Modell den richtigen Kontext geben und anschließend prüfen, ob es die Frage korrekt beantwortet. Die folgende Matrix zeigt, wie sich diese beiden Aspekte bei der Evaluation unterscheiden lassen:
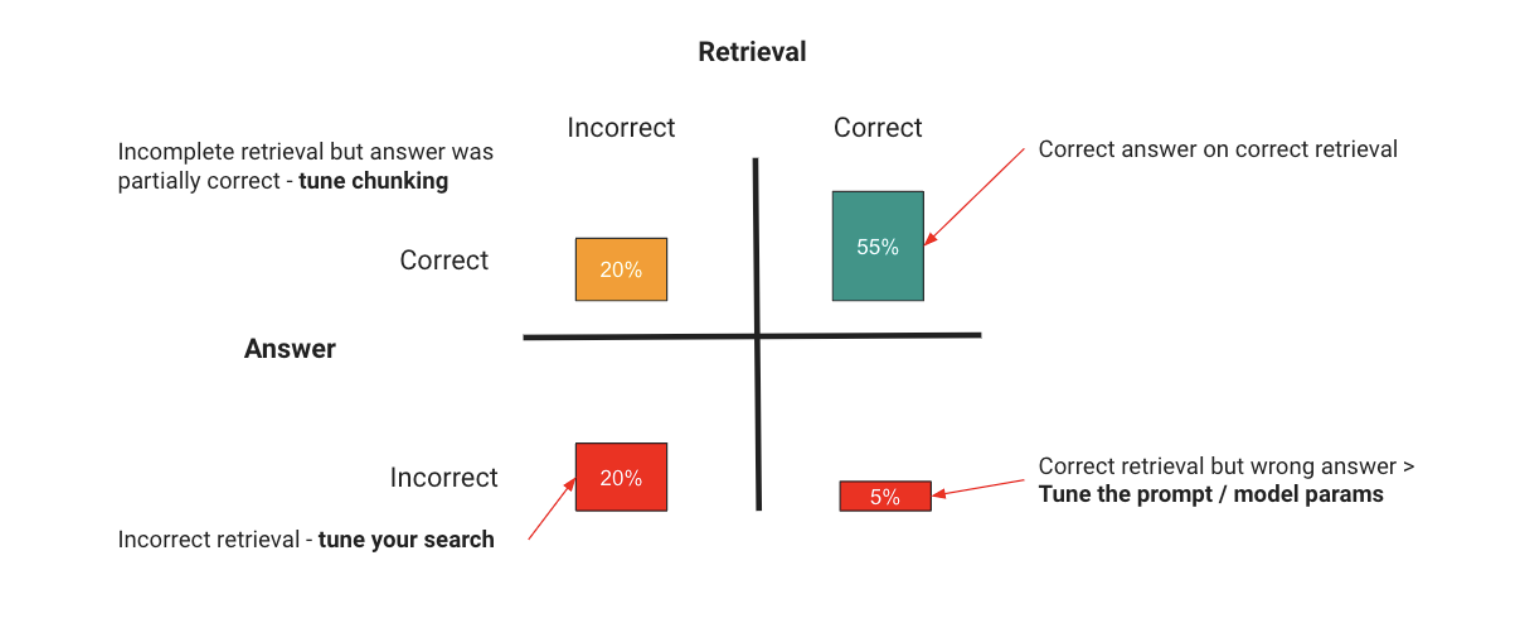
In einer RAG-Anwendung können an zwei Stellen Fehler auftreten:
| Bereich | Problem | Lösung |
|---|---|---|
| Abruf | Bekommt das Modell den falschen Kontext, kann es die Frage gar nicht beantworten. Zu viel irrelevanter Kontext kann die entscheidenden Informationen überlagern und Halluzinationen verursachen. | Optimiere den Abruf. Dafür gibt es mehrere Möglichkeiten: - Passe die Suche so an, dass sie die richtigen Treffer liefert. - Grenze die Suche so ein, dass sie weniger irrelevante Treffer liefert. - Stelle pro Treffer mehr Informationen bereit. Das sind nur einige Beispiele. Die Optimierung von RAG ist ein eigenes Fachgebiet. Bibliotheken wie LlamaIndex und LangChain bieten zahlreiche weitere Ansätze. |
| LLM | Das Modell kann den richtigen Kontext erhalten und ihn trotzdem falsch verwenden. | Verbessere mit Prompt Engineering die Anweisungen und die Vorgehensweise des Modells. Wenn Beispiele die Genauigkeit erhöhen, ergänze Fine-Tuning. |
Das Prinzip aus unserem anfänglichen Denkmodell bleibt dasselbe. Du ermittelst durch Evaluation, was schiefgegangen ist, und behebst den Fehler mit einer gezielten Änderung. Bei RAG musst du zusätzlich den Abruf berücksichtigen.
RAG hilft bei Problemen mit dem Lernen im Kontext. Bei vielen Anwendungen geht es aber darum, dass das LLM eine Aufgabe erlernt und sie anschließend konsistent und zuverlässig ausführt. Dafür setzen wir Fine-Tuning ein.
Fine-Tuning
Wenn das Modell eine Aufgabe noch nicht ausreichend gelernt hat, setzen viele Entwicklungsteams das Training des LLM mit einem kleineren, fachspezifischen Datensatz fort. So passen sie das Modell gezielt an diese Aufgabe an. Dieses Verfahren heißt Fine-Tuning.
Für Fine-Tuning gibt es in der Regel zwei Gründe:
- Die Genauigkeit des Modells bei einer bestimmten Aufgabe erhöhen: Du trainierst das Modell mit aufgabenspezifischen Daten. Anhand vieler korrekt gelöster Beispiele lernt es, die Aufgabe selbst zu lösen.
- Die Effizienz des Modells steigern: Du erreichst dieselbe Genauigkeit mit weniger Tokens oder mit einem kleineren Modell.
Für das Fine-Tuning stellst du zunächst einen Datensatz mit Trainingsbeispielen zusammen. Das ist der wichtigste Schritt, denn die Beispiele müssen genau dem entsprechen, was das Modell im realen Einsatz zu sehen bekommt.
Viele Unternehmen nutzen ein Verfahren namens Prompt Baking. Dabei protokollieren sie während einer Pilotphase die Prompt-Eingaben und die zugehörigen Modellergebnisse möglichst umfassend. Aus diesen Protokollen lassen sich realistische Beispiele für einen wirksamen Trainingsdatensatz auswählen.
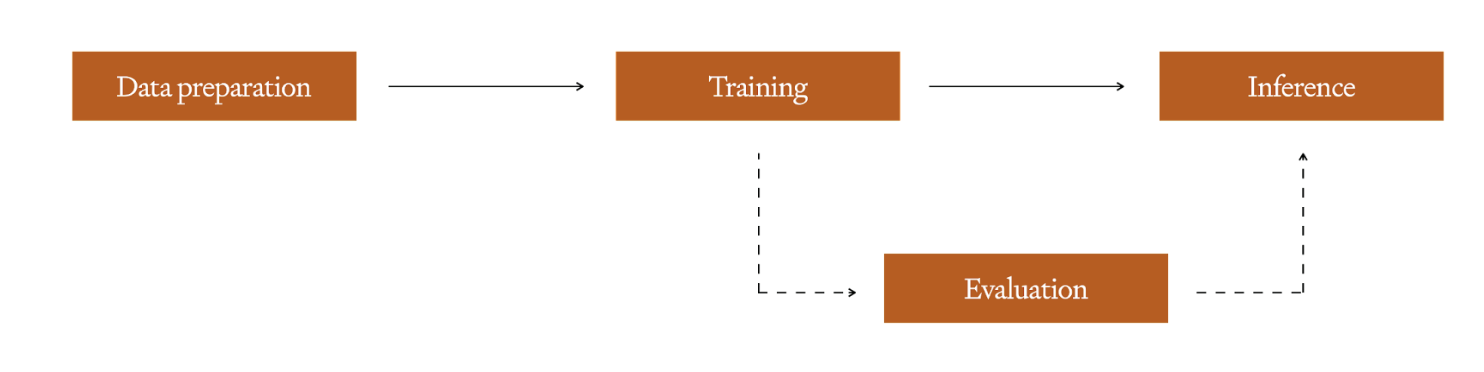
Mit diesem bereinigten Datensatz kannst du das Training für dein Fine-Tuning starten. Je nach Plattform oder Framework kannst du dabei wie bei anderen Modellen für maschinelles Lernen Hyperparameter anpassen. Wir empfehlen, immer einen separaten Datensatz für die Evaluation nach dem Training zurückzuhalten. Damit kannst du Überanpassung erkennen. Tipps für die Zusammenstellung eines guten Trainingsdatensatzes findest du in den Empfehlungen unserer Dokumentation zum Fine-Tuning. Nach dem Training steht das angepasste Modell für die Inferenz bereit.
Die folgenden Empfehlungen für das Fine-Tuning stammen aus unserer Erfahrung mit den Angeboten von OpenAI zur Modellanpassung. Die Grundsätze sollten sich auch auf andere Anbieter und Open-Source-Angebote übertragen lassen:
- Beginne mit Prompt Engineering: Stelle beim Prompt Engineering einen aussagekräftigen Evaluationsdatensatz zusammen, den du als Vergleichsgrundlage nutzen kannst. So bleibt der Aufwand gering, bis du von deinem Ausgangsprompt überzeugt bist.
- Beginne klein und achte auf Qualität: Beim Fine-Tuning eines Basismodells zählt die Qualität der Trainingsdaten mehr als ihre Menge. Beginne mit mindestens 50 Beispielen und werte die Ergebnisse aus. Vergrößere den Trainingsdatensatz, wenn du die erforderliche Genauigkeit noch nicht erreichst und die falschen Antworten auf inkonsistentes Verhalten zurückgehen, nicht auf fehlenden Kontext.
- Verwende repräsentative Beispiele: Zu den häufigsten Fehlern gehören Trainingsdaten, die sich in ihrer Form oder Formatierung leicht von den Eingaben im Produktivbetrieb unterscheiden. Bei einer RAG-Anwendung solltest du zum Beispiel auch für das Fine-Tuning Beispiele mit RAG-Kontext verwenden. Sonst muss das Modell im Produktivbetrieb im Zero-Shot-Verfahren herausfinden, wie es den Kontext nutzen soll.
Die Methoden kombinieren
Die Techniken lassen sich kombinieren. Wenn deine ersten Evaluationen sowohl beim Kontext als auch beim Verhalten Probleme zeigen, wirst du im Produktivbetrieb möglicherweise Fine-Tuning und RAG gemeinsam einsetzen. Das ist sinnvoll, denn die Methoden gleichen die jeweiligen Schwächen aus. Zu den wichtigsten Vorteilen gehören:
- Mit Fine-Tuning kannst du den Tokenverbrauch minimieren, der beim Prompt Engineering anfällt. An die Stelle von Anweisungen und Few-Shot-Beispielen treten viele Trainingsbeispiele, mit denen das Modell ein konsistentes Verhalten erlernt.
- Mit umfangreichem Fine-Tuning kannst du dem Modell komplexes Verhalten beibringen.
- Mit RAG kannst du Kontext bereitstellen, etwa aktuelle Inhalte oder spezielles Wissen, das deine Anwendung benötigt.
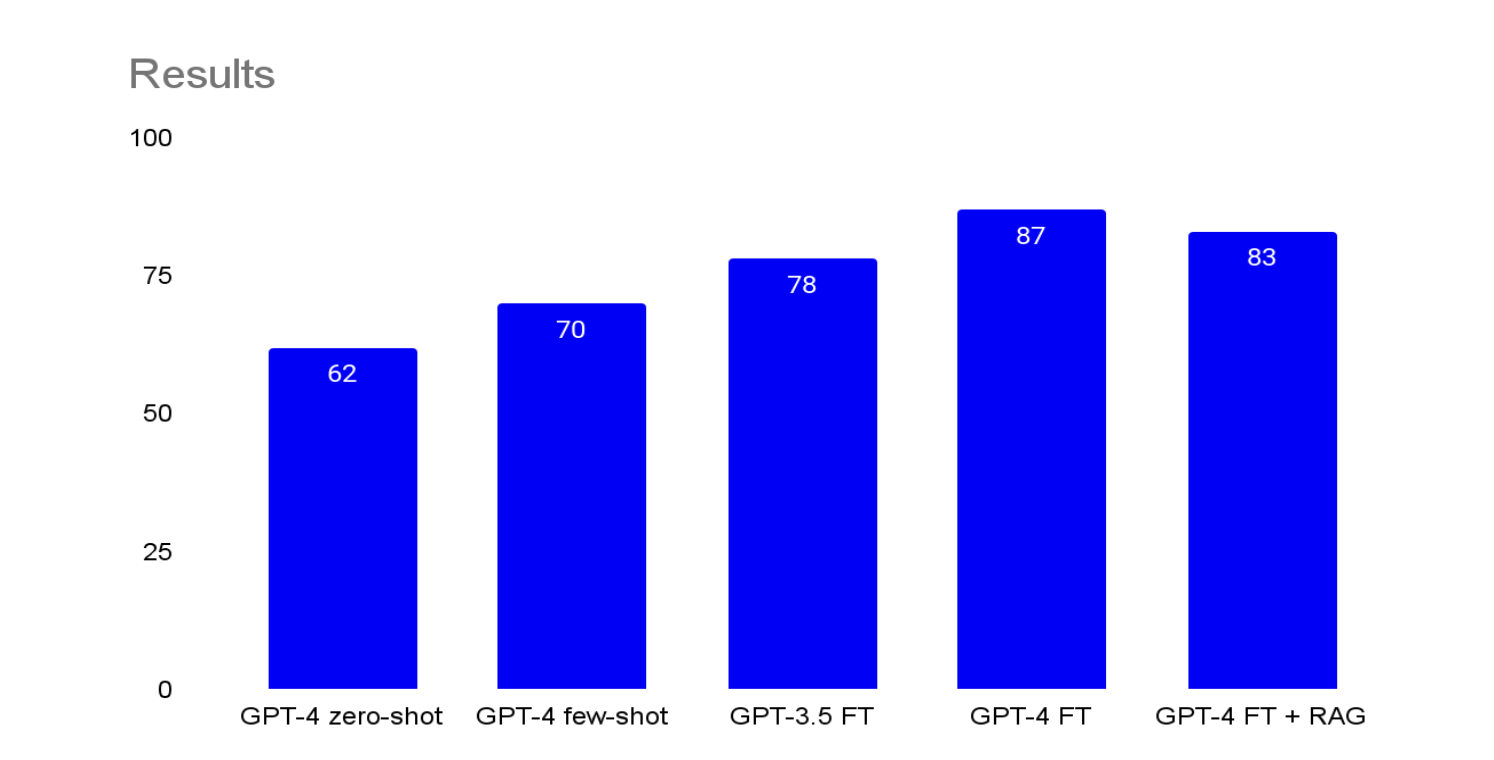 BLEU-Score nach Optimierungsmethode (von 100 möglichen Punkten)
Du kannst jetzt einschätzen, wann RAG und wann Fine-Tuning sinnvoll ist. Bedenke auch, wie sich der Einsatz dieser Werkzeuge darauf auswirkt, wie schnell du Änderungen testen kannst:
- Bei RAG musst du sowohl den Abruf als auch das Verhalten des LLM optimieren.
- Beim Fine-Tuning musst du für weitere Anpassungen das Training erneut durchführen und deine Trainings- und Validierungsdatensätze pflegen.
Beides kann aufwendig und zeitintensiv sein. Je komplexer deine LLM-Anwendung wird, desto eher können Änderungen bereits funktionierende Abläufe beeinträchtigen. Schöpfe deshalb die Genauigkeit aus, die du mit einfachen Methoden erreichen kannst, bevor du zu komplexeren Verfahren wie RAG oder Fine-Tuning greifst. Orientiere dich an deinem Genauigkeitsziel. Dass RAG und Fine-Tuning in Kombination als besonders fortschrittlich gelten, ist für sich genommen kein Grund, sie einzusetzen.
Welche Genauigkeit ist für den Produktivbetrieb „gut genug“?
Die Genauigkeit eines LLM lässt sich nahezu endlos optimieren. Mit Standardmethoden wirst du aber kaum eine Genauigkeit von 99,999 % erreichen. Wie entscheidest du also, wann sie ausreicht? Wann kannst du ein LLM mit gutem Gewissen im Produktivbetrieb einsetzen, und wie gehst du mit den Risiken deiner Lösung um?
Ich finde es hilfreich, diese Fragen aus wirtschaftlicher und technischer Sicht zu betrachten. Ich stelle die Grundzüge beider Ansätze vor und zeige am Beispiel eines Helpdesks im Kundenservice, wie wir in beiden Bereichen mit Risiken umgehen.
Wirtschaftliche Aspekte
Wer im Unternehmen bisher mit regelbasierten Systemen, klassischem maschinellem Lernen oder Menschen gearbeitet hat, ist an vergleichsweise gut einschätzbare Ergebnisse gewöhnt. Da kann es schwerfallen, einem LLM zu vertrauen. Bei einem solchen System lässt sich kaum vorhersagen, welche Fehler auftreten und wie sie sich auswirken.
Bei einer Anwendung im Kundenservice hat sich ein Ansatz bewährt, bei dem wir so vorgegangen sind:
Zunächst ermitteln wir die wichtigsten Erfolgs- und Fehlerfälle und schätzen, wie viel wir jeweils sparen oder verlieren. Anhand der Ergebnisse aus dem Pilotbetrieb können wir dann beziffern, welche Einsparungen oder Kosten bei der Lösung zu erwarten sind.
- Löst die KI einen Fall, den bisher ein Mensch gelöst hat, können wir beispielsweise 20 USD sparen.
- Wird ein Fall unnötig an das Serviceteam weitergeleitet, kann uns das 40 USD kosten.
- Im schlimmsten Fall ist jemand so unzufrieden mit der KI, dass die Person abwandert. Das kostet uns 1.000 USD. Wir nehmen an, dass dies in 5 % der Fälle passiert.
| Ereignis | Wert | Anzahl der Fälle | Gesamtwert |
|---|---|---|---|
| KI löst den Fall | +20 | 815 | 16.300 USD |
| KI scheitert (Weiterleitung) | -40 | 175,75 | 7.030 USD |
| KI scheitert (Abwanderung) | -1.000 | 9,25 | 9.250 USD |
| Ergebnis | +20 | ||
| Genauigkeit an der Gewinnschwelle | 81,5 % |
Außerdem haben wir Kennzahlen zum tatsächlichen Ablauf erhoben, um die Auswirkungen der Lösung insgesamt zu messen. Im Kundenservice kommen dafür zum Beispiel folgende Kennzahlen infrage:
- Die Kundenzufriedenheit (CSAT) bei Kontakten ausschließlich mit Menschen im Vergleich zu Kontakten mit der KI
- Der Anteil richtiger Entscheidungen bei nachträglich überprüften Fällen, jeweils für Menschen und KI
- Die Zeit bis zur Lösung eines Falls, jeweils für Menschen und KI
Nach einigen Pilotversuchen hatten wir im Kundenservice aussagekräftige Daten für zwei wichtige Entscheidungen:
- Unsere LLM-Lösung leitete zwar mehr Fälle an Menschen weiter als gewünscht, senkte aber die Betriebskosten gegenüber der bisherigen Lösung erheblich. Selbst eine Genauigkeit von 85 % konnte also ausreichen, wenn es sich bei den übrigen 15 % überwiegend um frühzeitige Weiterleitungen handelte.
- Wo Fehler sehr teuer werden konnten, etwa bei einer falschen Entscheidung in einem Betrugsfall, sollte ein Mensch entscheiden und die KI assistieren. Anhand des Anteils richtiger Entscheidungen kamen wir zu dem Schluss, dass wir der KI diese Fälle nicht vollständig überlassen wollten.
Technische Aspekte
Aus technischer Sicht ist die Aufgabe klarer. Sobald das Unternehmen den erwarteten Nutzen und die möglichen Fehlerkosten kennt, entwickelst du eine Lösung, die Fehler abfängt, ohne die Nutzung zu beeinträchtigen.
Nehmen wir noch einmal den Kundenservice als Beispiel. Angenommen, unser Modell erkennt in 85 % der Fälle korrekt, was die Person erreichen möchte. Als Entwicklungsteam können wir die Auswirkungen der verbleibenden 15 % auf verschiedene Weise begrenzen:
- Wir können das Modell per Prompt anweisen, bei Unsicherheit nach weiteren Informationen zu fragen. Die Trefferquote beim ersten Versuch sinkt dadurch möglicherweise, aber mit zwei Versuchen erkennt das Modell das Anliegen unter Umständen genauer.
- Wir können dem Assistenten auf der zweiten Supportebene ermöglichen, den Fall zur erneuten Klärung des Anliegens zurückzugeben. So kann der Ablauf eine Fehleinschätzung selbst korrigieren, auch wenn die Person dadurch etwas länger auf eine Antwort wartet.
- Wir können das Modell per Prompt anweisen, ein unklar gebliebenes Anliegen an einen Menschen weiterzuleiten. Kurzfristig sparen wir dadurch weniger Betriebskosten. Langfristig kann es aber das Risiko senken, dass Kundschaft abwandert.
Diese Entscheidungen beeinflussen das Nutzungserlebnis. Eine höhere Genauigkeit kann längere Wartezeiten bedeuten oder häufigeres Eingreifen des Serviceteams erfordern. Das fließt wiederum in das Kostenmodell aus dem Abschnitt zu den wirtschaftlichen Aspekten ein.
So kannst du die wirtschaftlichen und technischen Entscheidungen einzeln betrachten und ein Genauigkeitsziel festlegen, das zur tatsächlichen Situation deines Unternehmens passt.
Die Methoden in der Praxis einsetzen
Mit diesem Denkmodell kannst du einordnen, wie du die Genauigkeit von LLMs maximierst, welche Werkzeuge dir dabei helfen und wann die Genauigkeit für den Produktivbetrieb ausreicht. Damit hast du einen Rahmen und die Werkzeuge, um LLM-Anwendungen systematisch zur Einsatzreife zu bringen. Wenn du sehen möchtest, was andere mit diesen Methoden erreicht haben, findest du in unseren Kundenberichten Beispiele wie Morgan Stanley und Klarna.
Viel Erfolg! Wir sind gespannt, was du damit entwickelst.