
Überblick
Mit Multi-agent kann ein Modell Subagenten starten, ihre parallele Arbeit koordinieren und die Ergebnisse zu einer abschließenden Antwort zusammenführen. Das eignet sich besonders für Anwendungen mit komplexen Aufgaben, die sich parallel bearbeiten lassen, etwa wenn du eine Codebasis untersuchen, dokumentieren oder Funktionen implementieren möchtest.
Multi-agent ist als Beta-Funktion für GPT-6.1 Sol und alle Modelle der GPT-5.6-Reihe verfügbar. Prüfe die Angaben auf der Modellseite, bevor du Multi-agent in deiner Anwendung aktivierst.
Wann sich Multi-agent eignet
Viele Aufgaben lassen sich in unabhängige Teilaufgaben aufteilen. Ein einzelner Agent würde sie nacheinander bearbeiten, mehrere Agenten können sie parallel erledigen. Mit Multi-agent kann ein Hauptagent solche Aufgaben an mehrere Subagenten delegieren, die gleichzeitig daran arbeiten. Das kann mehrere Vorteile haben:
- Parallele Ausführung. Unabhängige Recherche-, Analyse- oder Implementierungsaufgaben können gleichzeitig laufen. Dadurch lässt sich die Bearbeitungszeit verkürzen.
- Eigener Kontext. Jeder Subagent erhält eine klar abgegrenzte Aufgabe und arbeitet mit seinem eigenen Kontext. So beeinflussen sich voneinander unabhängige Aufgaben weniger, was die Leistung verbessert.
- Koordination durch das Modell. Der Hauptagent kann Subagenten erstellen, ihnen zusätzliche Informationen senden, auf Ergebnisse warten und daraus eine abschließende Antwort formulieren. Deine Anwendung muss die Orchestrierung dafür nicht selbst implementieren.
Die Orchestrierung mit Multi-agent eignet sich besonders für Aufgaben, die sich in konkrete, voneinander unabhängige Teilaufgaben gliedern lassen. Beispiele dafür sind:
- Verschiedene Bereiche einer großen Codebasis untersuchen
- Mehrere Vorschläge, Dokumente oder Hypothesen vergleichen
- Parallel in mehreren Quellen recherchieren
- Voneinander unabhängige Komponenten implementieren oder separate Testsuiten schreiben
- Verschiedenen möglichen Fehlerursachen parallel nachgehen
- Mehrere Lösungsansätze gleichzeitig untersuchen
Zusätzliche Subagenten können den Tokenverbrauch erhöhen. Sie bringen unter Umständen weniger, wenn das Reasoning eine feste Abfolge aufeinander aufbauender Schritte erfordert, wenn die Agenten häufig in einen gemeinsamen veränderlichen Zustand schreiben müssen oder wenn bereits ein einzelner langsamer externer Vorgang die Laufzeit bestimmt.
| Nutze Multi-agent, wenn … | Nutze vorzugsweise einen einzelnen Agenten, wenn … |
|---|---|
| sich die Arbeit in unabhängige, klar abgegrenzte Aufgaben aufteilen lässt. | jeder Schritt unmittelbar vom vorherigen abhängt. |
| ein eigener Kontext pro Aufgabe hilft, sich auf das Wesentliche zu konzentrieren. | die Aufgabe klein genug für einen einzigen kurzen Durchlauf ist. |
| parallele Untersuchungen die Gesamtdauer verkürzen können. | mehrere Agenten um den Zugriff auf dieselbe veränderliche Ressource konkurrieren würden. |
| der Vergleich unabhängiger Ergebnisse mehr Aspekte der Aufgabe abdeckt. | du einen festen, deterministischen Ausführungsgraphen benötigst. |
Schnellstart
Die Python- und TypeScript-Beispiele verwenden die Beta-Version des Responses SDK. Verwende für HTTP-Anfragen client.beta.responses und übergib responses_multi_agent=v1 im Argument betas. Übergib bei direkten HTTP-Anfragen und WebSocket-Verbindungen OpenAI-Beta: responses_multi_agent=v1 in den Anfrage- bzw. Verbindungsheadern. Die Schemas der Elemente können sich während der Beta-Phase von Multi-agent ändern.
Aktiviere Multi-agent in deiner Anfrage an die Responses API mit multi_agent.enabled. Wenn multi_agent.enabled auf true gesetzt ist, kann der Hauptagent einen Baum von Subagenten erstellen. Die Subagenten verwenden das Modell und die verfügbaren Tools aus der Anfrage. Die Agenten stimmen sich über grundlegende Aktionen ab, mit denen sie Subagenten starten, Nachrichten senden und auf Ergebnisse warten können (siehe So funktioniert Multi-agent). Der Hauptagent führt die Antworten der Subagenten zusammen und gibt die abschließende Antwort aus.
from openai import OpenAI
client = OpenAI()
def review_pull_request(diff: str) -> str:
response = client.beta.responses.create(
model="gpt-6.1-sol",
input=(
"Review the pull-request diff below with three agents: one for "
"correctness, one for security, and one for missing tests. "
"Reconcile duplicate or conflicting findings, then return a "
"prioritized review with file and line references.\n\n"
f"<diff>\n{diff}\n</diff>"
),
multi_agent={
"enabled": True,
"max_concurrent_subagents": 3,
},
betas=["responses_multi_agent=v1"],
)
return "".join(
part.text
for item in response.output
if (
item.type == "message"
and item.agent is not None
and item.agent.agent_name == "/root"
and item.phase == "final_answer"
)
for part in item.content
if part.type == "output_text"
)max_concurrent_subagents legt fest, wie viele Subagenten im gesamten Agentenbaum gleichzeitig aktiv sein können. Dabei zählen alle nachgeordneten Agenten auf jeder Ebene, von direkten Subagenten über deren Subagenten bis hin zu tieferen Ebenen. Der Hauptagent zählt nicht mit.
Die API gibt für diese Einstellung keine feste Obergrenze vor. Der Standardwert 3 empfiehlt sich für die meisten Aufgaben. Auch für die Tiefe des Agentenbaums und die Gesamtzahl der während eines Multi-agent-Durchlaufs erstellten Subagenten gibt es keine feste Obergrenze.
Mit einer Developer-Nachricht kannst du genauer vorgeben, wann das Modell des Hauptagenten Subagenten starten soll. Diese Nachricht ergänzt die Anweisungen, die der Hauptagent und die Subagenten automatisch erhalten.
Beispiele für Developer-Nachrichten:
- „Starte Subagenten nur, wenn die Person, die die Anfrage stellt, ausdrücklich um Subagenten, die Delegation von Aufgaben oder die parallele Arbeit mehrerer Agenten bittet.“
- „Die proaktive Delegation mit Multi-agent ist aktiviert. Setze Subagenten ein, wenn sich die Bearbeitungszeit durch paralleles Arbeiten deutlich verkürzen oder die Qualität deutlich verbessern lässt.“
So funktioniert Multi-agent
Die Responses API stellt den Modellen des Hauptagenten und der Subagenten gehostete Aktionen zur Orchestrierung sowie Anweisungen für deren Verwendung bereit. Der Hauptagent heißt /root. Die Pfade der neu gestarteten Subagenten bilden die Hierarchie ab, zum Beispiel:
/root
├── /root/researcher
├── /root/reviewer
└── /root/reviewer/tester
Multi-agent begrenzt weder die Gesamtzahl der Subagenten noch die Tiefe des Agentenbaums auf einen festen Wert. Verwende für die meisten Aufgaben bei max_concurrent_subagents den Standardwert 3. Diese Einstellung begrenzt die Anzahl der gleichzeitig aktiven Bearbeitungsrunden von Subagenten im gesamten Baum. Sie gilt für direkte Subagenten ebenso wie für Subagenten auf tieferen Ebenen.
Wenn Multi-agent aktiviert ist, stellt die Responses API sechs gehostete Aktionen für die Zusammenarbeit bereit. Sie können als Elemente vom Typ multi_agent_call erscheinen. Deine Anwendung soll diese Aktionen weder ausführen noch Ergebnisse dafür übermitteln.
| Aktion | Zweck |
|---|---|
spawn_agent |
Erstellt einen Subagenten und weist ihm seine erste Aufgabe zu. |
send_message |
Stellt eine Nachricht für einen vorhandenen Agenten in die Warteschlange, ohne eine neue Bearbeitungsrunde zu starten. |
followup_task |
Weist einem vorhandenen Agenten außer dem Hauptagenten weitere Arbeit zu und startet seine Bearbeitungsrunde oder setzt sie fort. |
wait_agent |
Wartet auf eine neue Nachricht im Postfach des aufrufenden Agenten. |
interrupt_agent |
Unterbricht die aktive Bearbeitungsrunde eines anderen Agenten, ohne dessen Kontext zu löschen. |
list_agents |
Gibt den aktuellen Agentenbaum, den Status der einzelnen Agenten und für jeden Agenten den Wert von last_task_message zurück. |
Aufrufe von Tools, die du selbst definierst, verarbeitest du genauso wie ohne Multi-agent. Jeder Agent im Baum kann einen function_call ausgeben. Deine Anwendung muss den Aufruf ausführen und einen passenden function_call_output übermitteln.
Alle Agenten im Baum haben Zugriff auf die Tools, die für den Modellaufruf in der API-Anfrage konfiguriert sind.
Multi-agent in der Responses API verwenden
HTTP und WebSocket im Leistungsvergleich
HTTP und WebSocket unterstützen dieselben Multi-agent-Funktionen. Für Workflows mit vielen Toolaufrufen oder langer Laufzeit empfiehlt sich WebSocket. Über die dauerhafte Verbindung kann deine Anwendung Funktionsergebnisse zurückgeben, sobald sie vorliegen. Das senkt den Aufwand für die Fortsetzung und verkürzt die Wartezeit der Agenten.
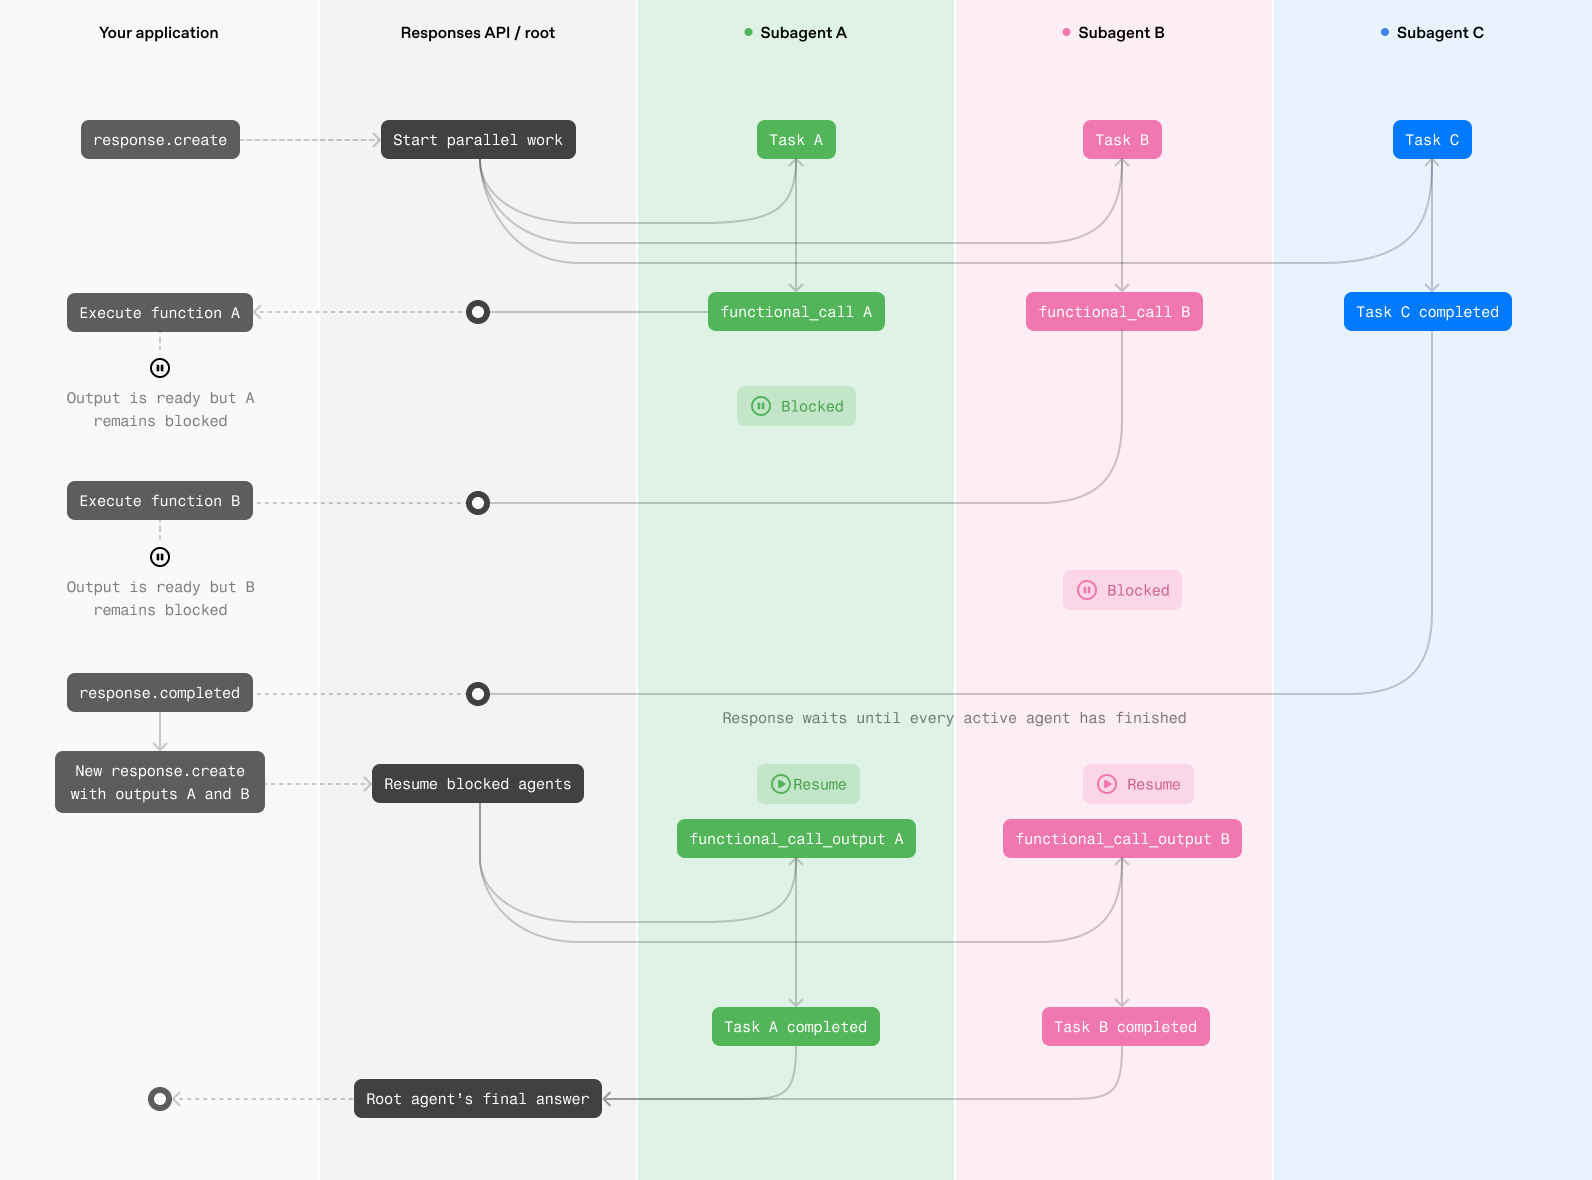
Bei HTTP endet die Antwort, sobald jeder aktive Agent entweder fertig ist oder auf das Ergebnis eines clientseitigen Funktionsaufrufs wartet. Deine Anwendung führt dann alle ausstehenden Funktionsaufrufe aus und übermittelt die Ergebnisse in einer neuen Anfrage an die Responses API. Die wartenden Agenten können anschließend weiterarbeiten.
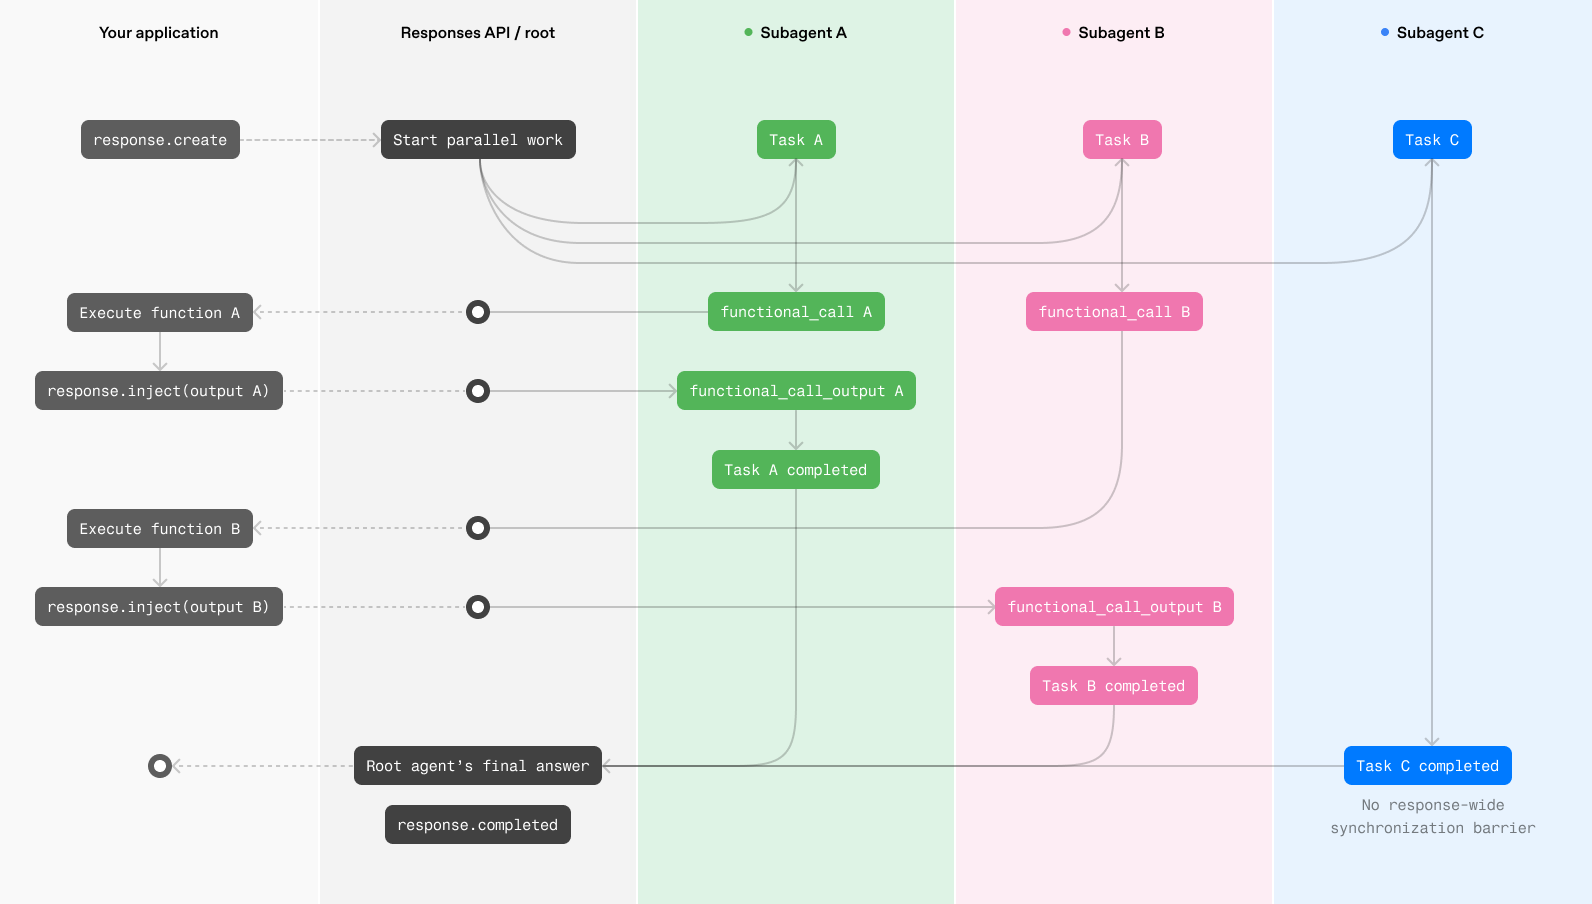
Bei WebSocket kann deine Anwendung jedes Funktionsergebnis in die laufende Antwort einfügen, sobald es vorliegt. Sie muss nicht warten, bis die Antwort abgeschlossen ist. Der wartende Agent kann seine Arbeit sofort fortsetzen, während andere Agenten weiterarbeiten. Das verkürzt die Wartezeiten bei der Koordination und vermeidet zusätzliche Anfragen und Antworten, wenn Agenten zu unterschiedlichen Zeitpunkten fertig werden oder Tools anfordern.
HTTP kann ausreichen, wenn ein Workflow mehrere gehostete Tools aufruft, etwa für parallele Websuchen, oder mit einer einzigen Anfrage und wenigen Funktionsaufrufen auskommt. Bei den meisten Multi-agent-Workflows dürfte WebSocket die Latenz senken und die Leistung über den gesamten Ablauf verbessern.
Funktionsaufrufe über HTTP ausführen
Funktionsaufrufe über WebSocket ausführen
HTTP
Für diese Beispiele brauchst du Beta-Versionen der SDKs, die Zugriff auf die Beta-Version der Responses API bieten. Rufe für HTTP-Streaming client.beta.responses.create auf und übergib responses_multi_agent=v1 im Argument betas. Dadurch stehen dir die Beta-Typen und die Autovervollständigung zur Verfügung. Wenn du in Python Typannotationen hinzufügst, importiere die Beta-Typen für Antwortelemente aus openai.types.beta.
Beispiel für clientseitigen Code:
from __future__ import annotations
import json
import sys
from openai import OpenAI
from openai.types.beta import BetaResponseOutputItem
client = OpenAI()
ROOT = "/root"
PROPOSALS = {
"alpha": {"estimated_weeks": 6, "risk": "medium"},
"beta": {"estimated_weeks": 8, "risk": "low"},
}
tools = [
{
"type": "function",
"name": "get_proposal",
"description": "Return details for a proposal that the agents should compare.",
"parameters": {
"type": "object",
"properties": {
"proposal": {
"type": "string",
"enum": ["alpha", "beta"],
}
},
"required": ["proposal"],
"additionalProperties": False,
},
"strict": True,
}
]
history = [
{
"role": "user",
"content": (
"Use two subagents, one for proposal alpha and one for proposal beta. "
"Have each call get_proposal, then compare their findings."
),
}
]
def agent_name(item: BetaResponseOutputItem) -> str:
return item.agent.agent_name if item.agent else ROOT
def render_to_user(delta: str) -> None:
print(delta, end="", flush=True)
def log_subagent_text(agent: str, delta: str) -> None:
print(f"[{agent}] {delta}", end="", file=sys.stderr, flush=True)
def process_tool_call(name: str, arguments: str) -> str:
if name != "get_proposal":
raise ValueError(f"Unknown tool: {name}")
parsed_arguments = json.loads(arguments)
return json.dumps(PROPOSALS[parsed_arguments["proposal"]])
while True:
output_items = []
pending_calls = []
item_agents: dict[int, str] = {}
stream = client.beta.responses.create(
model="gpt-6.1-sol",
input=history,
tools=tools,
store=False,
multi_agent={
"enabled": True,
"max_concurrent_subagents": 3,
},
stream=True,
betas=["responses_multi_agent=v1"],
)
for event in stream:
if event.type == "response.output_item.added":
item_agents[event.output_index] = agent_name(event.item)
elif event.type == "response.output_text.delta":
agent = item_agents.get(event.output_index, ROOT)
if agent == ROOT:
render_to_user(event.delta)
else:
log_subagent_text(agent, event.delta)
elif event.type == "response.output_item.done":
output_items.append(event.item)
if event.item.type == "function_call":
# Handle function calls from both the root agent and subagents.
pending_calls.append(event.item)
elif event.type == "response.completed":
print(f"\nUsage: {event.response.usage}", file=sys.stderr)
break
elif event.type in {
"error",
"response.failed",
"response.incomplete",
}:
raise RuntimeError(event)
history.extend(output_items)
for call in pending_calls:
history.append(
{
"type": "function_call_output",
"call_id": call.call_id,
"output": process_tool_call(call.name, call.arguments),
}
)
if not pending_calls:
breakWenn ein oder mehrere Agenten von dir definierte Funktionen aufrufen, führe alle ausstehenden Aufrufe aus und erstelle eine Anfrage, die ihre Ergebnisse enthält und die Verarbeitung fortsetzt.
WebSocket
Ruft ein Agent im WebSocket-Modus eine von dir definierte Funktion auf, führe sie in deiner Anwendung aus und sende ihr Ergebnis mit einem response.inject-Ereignis an die laufende Antwort. Der wartende Agent kann dann weiterarbeiten, ohne auf den Abschluss der gesamten Multi-agent-Antwort warten zu müssen.
{
"type": "response.inject",
"response_id": "resp_123",
"input": [
{
"type": "function_call_output",
"call_id": "call_123",
"output": "{\"temperature\":72}"
}
]
}Auf eine gültige response.inject-Anfrage antwortet der Server mit einem von zwei Ereignissen:
response.inject.created: Der Server hat die Eingabe geprüft und zum Einfügen angenommen.response.inject.failed: Der Server hat die Eingabe nicht eingefügt. Prüfeerror.code.
{
"type": "response.inject.created",
"sequence_number": 42,
"response_id": "resp_123"
}{
"type": "response.inject.failed",
"sequence_number": 43,
"response_id": "resp_123",
"input": [
{
"type": "function_call_output",
"call_id": "call_123",
"output": "{\"temperature\":72}"
}
],
"error": {
"code": "response_already_completed",
"message": "Response 'resp_123' has already completed."
}
}Entspricht eine Anfrage nicht dem Schema für response.inject, sendet der Server einen allgemeinen Fehler mit dem Statuscode 400 und schließt die WebSocket-Verbindung. Korrigiere die Anfrage und öffne eine neue WebSocket-Verbindung, bevor du ein weiteres Ereignis sendest.
Im Python-Beta-SDK ist der WebSocket-Modus über client.beta.responses.connect verfügbar, im TypeScript-Beta-SDK über ResponsesWS. Übergib OpenAI-Beta: responses_multi_agent=v1 in den Verbindungsheadern. Anders als beim HTTP-Streaming unterstützen die WebSocket-Konnektoren das Argument betas noch nicht.
Speichere die Antwort-ID aus dem response.created-Ereignis und gib sie in jedem response.inject-Ereignis an, das du für diese Antwort sendest. Nachdem du ein Element zum Einfügen gesendet hast, lies weiter Ereignisse aus der WebSocket-Verbindung, bis die Antwort abgeschlossen ist und du für jeden Einfügeversuch entweder ein response.inject.created- oder ein response.inject.failed-Ereignis erhalten hast.
from __future__ import annotations
import json
from openai import OpenAI
client = OpenAI()
PROPOSALS = {
"alpha": {"estimated_weeks": 6, "risk": "medium"},
"beta": {"estimated_weeks": 8, "risk": "low"},
}
tools = [
{
"type": "function",
"name": "get_proposal",
"description": "Return details for a proposal that the agents should compare.",
"parameters": {
"type": "object",
"properties": {
"proposal": {
"type": "string",
"enum": ["alpha", "beta"],
}
},
"required": ["proposal"],
"additionalProperties": False,
},
"strict": True,
}
]
def process_tool_call(name: str, arguments: str) -> str:
if name != "get_proposal":
raise ValueError(f"Unknown tool: {name}")
parsed_arguments = json.loads(arguments)
return json.dumps(PROPOSALS[parsed_arguments["proposal"]])
def run_multi_agent(connection):
previous_response_id: str | None = None
pending_input: list[dict[str, object]] = [{"role": "user", "content": input()}]
while pending_input:
request = {
"type": "response.create",
"model": "gpt-6.1-sol",
"store": True,
"multi_agent": {"enabled": True},
"tools": tools,
"input": pending_input,
}
if previous_response_id is not None:
request["previous_response_id"] = previous_response_id
connection.send(request)
next_input: list[dict[str, object]] = []
completed_response = None
response_id: str | None = None
pending_injections = 0
for event in connection:
event_type = event.type
if event_type == "response.created":
response_id = event.response.id
elif event_type == "response.output_item.done":
item = event.item
if item.type == "function_call":
if response_id is None:
raise RuntimeError(
"Received a function call before response.created"
)
output = {
"type": "function_call_output",
"call_id": item.call_id,
"output": process_tool_call(item.name, item.arguments),
}
pending_injections += 1
connection.send(
{
"type": "response.inject",
"response_id": response_id,
"input": [output],
}
)
elif event_type == "response.inject.created":
pending_injections -= 1
elif event_type == "response.inject.failed":
pending_injections -= 1
if event.error.code != "response_already_completed":
raise RuntimeError(event.error)
next_input.extend(item.model_dump(mode="json") for item in event.input)
elif event_type == "response.completed":
completed_response = event.response
elif event_type in {
"error",
"response.failed",
"response.incomplete",
}:
raise RuntimeError(event)
if completed_response is not None and pending_injections == 0:
break
if completed_response is None:
raise RuntimeError("Connection ended before response.completed")
if pending_injections:
raise RuntimeError("Connection ended with unacknowledged tool results")
if not next_input:
return completed_response
previous_response_id = completed_response.id
pending_input = next_input
with client.beta.responses.connect(
extra_headers={"OpenAI-Beta": "responses_multi_agent=v1"},
) as connection:
response = run_multi_agent(connection)
print(
"".join(
part.text
for item in response.output
if (
item.type == "message"
and item.agent is not None
and item.agent.agent_name == "/root"
and item.phase == "final_answer"
)
for part in item.content
if part.type == "output_text"
)
)Lies nach dem Senden eines response.inject-Ereignisses weiter aus der WebSocket-Verbindung und verarbeite die Rückmeldung:
response.inject.created: Der Server hat das Funktionsergebnis zur laufenden Antwort hinzugefügt. Lies weiter die Ereignisse für diese Antwort.response.inject.failedmitresponse_already_completed: Die Antwort war bereits abgeschlossen, bevor der Server das Funktionsergebnis hinzufügen konnte. Übernimm den Wert voninputaus dem Fehlerereignis und sende ihn in einer neuenresponse.create-Anfrage, die an die abgeschlossene Antwort anknüpft.response.inject.failedmitresponse_not_found: Der Server konnte die Antwort mit der angegebenenresponse_idnicht finden. Prüfe, ob du die ID ausresponse.createdverwendest.
Ein einzelner Multi-agent-Durchlauf kann sich über mehrere Anfragen an die Responses API erstrecken. Ruft ein Agent über HTTP eine von dir definierte Funktion auf, führt deine Anwendung sie aus und übermittelt ihr Ergebnis in einem neuen response.create-Aufruf. Bei WebSocket fügt deine Anwendung das Funktionsergebnis direkt in die laufende Antwort ein.
Neue Ausgabeelemente für Multi-agent
Multi-agent-Antworten können drei zusätzliche Typen von Ausgabeelementen enthalten:
multi_agent_call: Protokolliert eine gehostete Multi-agent-Aktion, zum Beispielspawn_agent.multi_agent_call_output: Enthält das Ergebnis einer ausgeführten gehosteten Aktion.agent_message: Übermittelt eine verschlüsselte Nachricht von einem Agenten an einen anderen.
Das Feld call_id verknüpft jeden multi_agent_call mit dem zugehörigen multi_agent_call_output.
Jedes Element enthält außerdem das Attribut agent. Bei einer agent_message gibt agent.agent_name den empfangenden Agenten an. Anhand von author und recipient kannst du nachvollziehen, wer die Nachricht an wen gesendet hat.
Wenn deine Anwendung einen multi_agent_call empfängt, führe ihn nicht als Funktionsaufruf aus und sende kein Ergebnis zurück. Die Responses API führt die gehostete Aktion aus und gibt den zugehörigen multi_agent_call_output zurück. Bewahre beide Elemente auf, wenn deine Anwendung sie benötigt, um den Ablauf erneut wiederzugeben oder nachzuverfolgen.
[
{
"type": "multi_agent_call",
"id": "mac_123",
"call_id": "call_spawn_a",
"action": "spawn_agent",
"arguments": "{\"task_name\":\"agent_a\",\"fork_turns\":\"all\",\"message\":\"enc_...\"}",
"agent": { "agent_name": "/root" }
},
{
"type": "multi_agent_call_output",
"id": "maco_123",
"call_id": "call_spawn_a",
"action": "spawn_agent",
"output": [
{
"type": "output_text",
"text": "{\"task_name\":\"/root/agent_a\"}",
"annotations": [],
"logprobs": []
}
],
"agent": { "agent_name": "/root" }
},
{
"type": "agent_message",
"id": "amsg_123",
"author": "/root/agent_a",
"recipient": "/root",
"content": [
{
"type": "encrypted_content",
"encrypted_content": "enc_..."
}
],
"agent": { "agent_name": "/root" }
}
]SSE-Ereignisse, die einem Agenten zugeordnet sind, enthalten auf oberster Ebene das Attribut agent. Bei einem agent_message-Ereignis gibt agent.agent_name den empfangenden Agenten an. Ereignisse im Lebenszyklus einer Antwort wie response.created und response.completed beziehen sich auf die gesamte Antwort. Daher enthalten sie kein agent-Attribut.
{
"type": "response.output_item.done",
"agent": { "agent_name": "/root" },
"item": {
"type": "agent_message",
"id": "amsg_123",
"author": "/root/agent_a",
"recipient": "/root",
"content": [
{
"type": "encrypted_content",
"encrypted_content": "enc_..."
}
],
"agent": { "agent_name": "/root" }
}
}Einschränkungen
- Kontextverdichtung:
- Der Endpunkt
/responses/compactwird bei aktiviertem Multi-agent nicht unterstützt. - Wenn
multi_agent.enabledauftruegesetzt ist, aktiviert die API automatisch die serverseitige Kontextverdichtung, auch wenn die Anfrage keine Einstellung fürcontext_managemententhält. Die API verdichtet den Kontext des Hauptagenten und jedes Subagenten separat. So behält jeder Agent seinen eigenen Kontext. Du kannstcompact_thresholdweiterhin überschreiben, indem du in der Anfragecontext_management.compact_thresholdexplizit setzt.
- Der Endpunkt
reasoning.summarywird bei aktiviertem Multi-agent nicht unterstützt.max_tool_callswird bei aktiviertem Multi-agent nicht unterstützt.max_concurrent_subagentshat den empfohlenen Standardwert3.
Hinweise zu Prompts
Wenn Multi-agent aktiviert ist, fügen unsere Systeme die folgenden Anweisungen für den Hauptagenten und die Subagenten automatisch als neue Developer-Nachricht hinzu. Du kannst diese Anweisungen weder bearbeiten noch entfernen. Formuliere deine eigenen Developer-Anweisungen so, dass sie die automatisch hinzugefügten Anweisungen ergänzen.
Hauptagent
You are `/root`, the primary agent in a team of agents collaborating to fulfill the user's goals.

At the start of your turn, you are the active agent.
You can spawn sub-agents to handle subtasks, and those sub-agents can spawn their own sub-agents.
All agents in the team, including the agents that you can assign tasks to, are equally intelligent and capable, and have access to the same set of tools.

You can use `spawn_agent` to create a new agent, `followup_task` to give an existing agent a new task and trigger a turn, and `send_message` to pass a message to a running agent without triggering a turn.
Child agents can also spawn their own sub-agents.
You can decide how much context you want to propagate to your sub-agents with the `fork_turns` parameter.

You will receive messages in the form:
```
Message Type: MESSAGE | FINAL_ANSWER
Task name: <recipient>
Sender: <author>
Payload:
<payload text>
```
They may be addressed as to=/root

There are {max_concurrent_subagents + 1} available concurrency slots, meaning that up to {max_concurrent_subagents + 1} agents can be active at once, including you.
Subagent
You are an agent in a team of agents collaborating to complete a task.

You can spawn sub-agents to handle subtasks, and those sub-agents can spawn their own sub-agents. All agents in the team, including the agents that you can assign tasks to, are equally intelligent and capable, and have access to the same set of tools.

You can use `spawn_agent` to create a new agent, `followup_task` to give an existing agent a new task and trigger a turn, and `send_message` to pass a message to a running agent.
Child agents can also spawn their own sub-agents.

When you provide a response in the final channel, that content is immediately delivered back to your parent agent.

You will receive messages in the form:
```
Message Type: NEW_TASK | MESSAGE | FINAL_ANSWER
Task name: <recipient>
Sender: <author>
Payload:
<payload text>
```
You may also see them addressed as to=/root/..., which indicates your identity is /root/...

There are {max_concurrent_subagents + 1} available concurrency slots, meaning that up to {max_concurrent_subagents + 1} agents can be active at once, including you.