
text-embedding-3-small und text-embedding-3-large, unsere neuesten und leistungsstärksten Embedding-Modelle, sind jetzt verfügbar. Sie kosten weniger und erzielen bei mehrsprachigen Aufgaben bessere Ergebnisse. Mit neuen Parametern kannst du die Gesamtgröße der Embeddings steuern.Was sind Embeddings?
Mit den Text-Embeddings von OpenAI lässt sich messen, wie eng Texte inhaltlich miteinander verwandt sind. Typische Anwendungen sind:
- Suche (Ergebnisse nach ihrer Relevanz für eine Suchanfrage sortieren)
- Clustering (Texte nach Ähnlichkeit gruppieren)
- Empfehlungen (Einträge mit inhaltlich verwandten Texten empfehlen)
- Anomalieerkennung (Ausreißer erkennen, die anderen Einträgen kaum ähneln)
- Messung der Vielfalt (die Verteilung von Ähnlichkeitswerten analysieren)
- Klassifikation (Texte der Klasse zuordnen, deren Bezeichnung ihnen am ähnlichsten ist)
Ein Embedding ist ein Vektor (eine Liste) aus Gleitkommazahlen. Der Abstand zwischen zwei Vektoren gibt an, wie ähnlich sich die zugehörigen Texte sind. Ein kleiner Abstand deutet auf eine hohe Ähnlichkeit hin, ein großer auf eine geringe.
Die Preise für Embeddings findest du in unserer Preisübersicht. Die Kosten einer Anfrage richten sich nach der Anzahl der Token in der Eingabe.
Embeddings abrufen
Um ein Embedding zu erhalten, sende deinen Text an den API-Endpunkt für Embeddings und gib den Namen des Embedding-Modells an (z. B. text-embedding-3-small).
1
2
3
4
5
6
7
8
9
10import OpenAI from "openai";
const openai = new OpenAI();

const embedding = await openai.embeddings.create({
  model: "text-embedding-3-small",
  input: "Your text string goes here",
  encoding_format: "float",
});

console.log(embedding);
1
2
3
4
5
6
7
8
9from openai import OpenAI
client = OpenAI()
response = client.embeddings.create(
input="Your text string goes here", model="text-embedding-3-small"
)
print(response.data[0].embedding)1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
embedding, err := client.Embeddings.New(context.Background(), openai.EmbeddingNewParams{
Model: openai.EmbeddingModelTextEmbedding3Small,
Input: openai.EmbeddingNewParamsInputUnion{
OfString: openai.String("Your text string goes here."),
},
})
if err != nil {
panic(err)
}
fmt.Println(len(embedding.Data[0].Embedding))
}1
2
3
4
5
6
7
8
9
10
11
12
13
14import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
var embedding =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.input("The food was delicious and the waiter...")
.build());
System.out.println(embedding.data().get(0).embedding());1
2
3
4
5
6
7
8
9
10
11using OpenAI.Embeddings;
string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "text-embedding-3-small";
EmbeddingClient client = new(model, key);
OpenAIEmbedding embedding = await client.GenerateEmbeddingAsync(
"The food was delicious and the waiter was friendly."
);
Console.WriteLine($"Dimensions: {embedding.ToFloats().Length}");1
2
3
4
5
6
7
8
9
10require "openai"
client = OpenAI::Client.new
response = client.embeddings.create(
model: "text-embedding-3-small",
input: "The food was delicious and the waiter..."
)
puts(response.data.fetch(0).embedding)1
2
3
4
5
6
7curl https://api.openai.com/v1/embeddings \
-H "Content-Type: application/json" \
-H "Authorization: Bearer $OPENAI_API_KEY" \
-d '{
"input": "Your text string goes here",
"model": "text-embedding-3-small"
}'Die Antwort enthält den Embedding-Vektor (eine Liste von Gleitkommazahlen) und zusätzliche Metadaten. Du kannst den Vektor aus der Antwort auslesen, in einer Vektordatenbank speichern und für verschiedene Anwendungen nutzen.
123456789101112131415161718{
  "object": "list",
  "data": [
    {
      "object": "embedding",
      "index": 0,
      "embedding": [
        -0.006929283495992422, -0.005336422007530928, -4.547132266452536e-5,
        -0.024047505110502243
      ]
    }
  ],
  "model": "text-embedding-3-small",
  "usage": {
    "prompt_tokens": 5,
    "total_tokens": 5
  }
}
Standardmäßig hat der Embedding-Vektor 1536 Dimensionen bei text-embedding-3-small oder 3072 bei text-embedding-3-large. Mit dem Parameter dimensions kannst du den Vektor verkürzen, ohne dass er seine Fähigkeit verliert, Konzepte abzubilden. Mehr zu den Dimensionen von Embeddings erfährst du im Abschnitt zu den Anwendungsfällen.
Embedding-Modelle
OpenAI bietet zwei leistungsfähige Embedding-Modelle der dritten Generation an. Du erkennst sie an -3 in der Modell-ID. Weitere Einzelheiten findest du im Blogbeitrag zur Einführung der Embedding-Modelle der dritten Generation.
Die Abrechnung erfolgt pro Eingabe-Token. Die Tabelle zeigt, wie viele Textseiten du für 1 USD verarbeiten kannst, wenn eine Seite etwa 800 Token enthält.
| Modell | Seiten pro 1 USD (ca.) | Ergebnis im MTEB-Benchmark | Maximale Eingabe (Token) |
|---|---|---|---|
| text-embedding-3-small | 62.500 | 62,3 % | 8.192 |
| text-embedding-3-large | 9.615 | 64,6 % | 8.192 |
| text-embedding-ada-002 | 12.500 | 61,0 % | 8.192 |
Anwendungsfälle
Anhand eines Datensatzes mit Amazon-Rezensionen zu Lebensmitteln zeigen wir einige typische Anwendungen.
Embeddings erstellen
Der Datensatz enthält insgesamt 568.454 Rezensionen zu Lebensmitteln, die bis Oktober 2012 auf Amazon veröffentlicht wurden. Für unser Beispiel verwenden wir die 1.000 neuesten Rezensionen. Die Rezensionen sind auf Englisch und fallen meist klar positiv oder negativ aus. Jede Rezension enthält die Felder ProductId, UserId und Score sowie einen Titel (Summary) und den eigentlichen Rezensionstext (Text). Zwei Beispiele:
| Produkt-ID | Nutzer-ID | Bewertung | Titel | Text |
|---|---|---|---|---|
| B001E4KFG0 | A3SGXH7AUHU8GW | 5 | Good Quality Dog Food | I have bought several of the Vitality canned… |
| B00813GRG4 | A1D87F6ZCVE5NK | 1 | Not as Advertised | Product arrived labeled as Jumbo Salted Peanut… |
Im folgenden Beispiel fassen wir Titel und Text jeder Rezension zu einem einzigen Text zusammen. Das Modell kodiert diesen Text und gibt dafür einen einzelnen Embedding-Vektor aus.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21import { mkdir, writeFile } from "node:fs/promises";
import OpenAI from "openai";

const client = new OpenAI();
const reviews = ["A rich cup of coffee.", "A bright herbal tea."];

const response = await client.embeddings.create({
  model: "text-embedding-3-small",
  input: reviews.map((review) => review.replaceAll("\n", " ")),
});

const csvField = (value: string) => `"${value.replaceAll('"', '""')}"`;
const rows = response.data.map(({ embedding }, index) =>
  [csvField(reviews[index]), csvField(JSON.stringify(embedding))].join(",")
);

await mkdir("output", { recursive: true });
await writeFile(
  "output/embedded_1k_reviews.csv",
  ["combined,ada_embedding", ...rows].join("\n") + "\n"
);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17from pathlib import Path
from openai import OpenAI
client = OpenAI()
def get_embedding(text, model="text-embedding-3-small"):
text = text.replace("\n", " ")
return client.embeddings.create(input=[text], model=model).data[0].embedding
df["ada_embedding"] = df.combined.apply(
lambda x: get_embedding(x, model="text-embedding-3-small")
)
Path("output").mkdir(exist_ok=True)
df.to_csv("output/embedded_1k_reviews.csv", index=False)1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68import (
"context"
"encoding/csv"
"encoding/json"
"fmt"
"log"
"os"
"strings"
"github.com/openai/openai-go/v3"
)
func main() {
if err := run(); err != nil {
log.Fatal(err)
}
}
func run() error {
client := openai.NewClient()
ctx := context.Background()
reviews := []string{"A rich cup of coffee.", "A bright herbal tea."}
if err := os.MkdirAll("output", 0755); err != nil {
return err
}
file, err := os.Create("output/embedded_1k_reviews.csv")
if err != nil {
return err
}
defer file.Close()
writer := csv.NewWriter(file)
if err := writer.Write([]string{"combined", "ada_embedding"}); err != nil {
return err
}
for _, review := range reviews {
vector, err := embedding(ctx, &client, strings.ReplaceAll(review, "\n", " "))
if err != nil {
return err
}
encoded, err := json.Marshal(vector)
if err != nil {
return err
}
if err := writer.Write([]string{review, string(encoded)}); err != nil {
return err
}
}
writer.Flush()
if err := writer.Error(); err != nil {
return err
}
if err := file.Close(); err != nil {
return err
}
fmt.Println("Saved output/embedded_1k_reviews.csv")
return nil
}
func embedding(ctx context.Context, client *openai.Client, text string) ([]float64, error) {
response, err := client.Embeddings.New(ctx, openai.EmbeddingNewParams{
Model: openai.EmbeddingModelTextEmbedding3Small,
Input: openai.EmbeddingNewParamsInputUnion{OfString: openai.String(text)},
})
if err != nil {
return nil, err
}
return response.Data[0].Embedding, nil
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
import java.io.IOException;
import java.nio.file.Files;
import java.nio.file.Path;
import java.util.List;
static String csvField(String value) {
return "\"" + value.replace("\"", "\"\"") + "\"";
}
List<String> reviews = List.of("A rich cup of coffee.", "A bright herbal tea.");
Path output = Path.of("output", "embedded_1k_reviews.csv");
Files.createDirectories(output.getParent());
try (var writer = Files.newBufferedWriter(output)) {
writer.write("combined,ada_embedding\n");
for (String review : reviews) {
var embedding =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.inputOfArrayOfStrings(List.of(review.replace("\n", " ")))
.build())
.data()
.get(0)
.embedding();
writer.write(csvField(review) + "," + csvField(embedding.toString()) + "\n");
}
}
System.out.println(output);1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26using System.Text.Json;
using OpenAI.Embeddings;
string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "text-embedding-3-small";
EmbeddingClient client = new(model, key);
string[] reviews = ["A rich cup of coffee.", "A bright herbal tea."];
Directory.CreateDirectory("output");
using StreamWriter writer = new("output/embedded_1k_reviews.csv");
await writer.WriteLineAsync("combined,ada_embedding");
foreach (string review in reviews)
{
float[] vector = await EmbedAsync(client, review.Replace("\n", " ", StringComparison.Ordinal));
string encoded = JsonSerializer.Serialize(vector);
await writer.WriteLineAsync($"{CsvField(review)},{CsvField(encoded)}");
}
Console.WriteLine("Saved output/embedded_1k_reviews.csv");
static async Task<float[]> EmbedAsync(EmbeddingClient client, string text)
{
OpenAIEmbedding result = await client.GenerateEmbeddingAsync(text);
return result.ToFloats().ToArray();
}
static string CsvField(string value) => "\"" + value.Replace("\"", "\"\"", StringComparison.Ordinal) + "\"";1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20require "csv"
require "fileutils"
require "json"
require "openai"
client = OpenAI::Client.new
reviews = ["A rich cup of coffee.", "A bright herbal tea."]
response = client.embeddings.create(
model: "text-embedding-3-small",
input: reviews.map { |review| review.tr("\n", " ") }
)
FileUtils.mkdir_p("output")
CSV.open("output/embedded_1k_reviews.csv", "w") do |csv|
csv << ["combined", "ada_embedding"]
response.data.each do |embedding|
csv << [reviews.fetch(embedding.index), JSON.generate(embedding.embedding)]
end
endMit dem folgenden Code lädst du die Daten aus einer zuvor gespeicherten Datei:
1
2
3
4
5from ast import literal_eval
import pandas as pd

df = pd.read_csv("output/embedded_1k_reviews.csv")
df["ada_embedding"] = df.ada_embedding.apply(literal_eval).apply(np.array)Größere Embeddings verursachen in der Regel höhere Kosten und benötigen mehr Rechenleistung, Arbeitsspeicher und Speicherplatz als kleinere Embeddings. Das gilt zum Beispiel, wenn du sie für spätere Suchanfragen in einem Vektorspeicher ablegst.
Für das Training unserer beiden neuen Embedding-Modelle haben wir ein Verfahren eingesetzt, mit dem du je nach Anwendung zwischen Leistung und Kosten abwägen kannst. Über den API-Parameter dimensions kannst du Embeddings verkürzen, also einige Zahlen am Ende der Folge weglassen. Dabei bleibt die Fähigkeit des Embeddings erhalten, Konzepte abzubilden. Im MTEB-Benchmark erzielt ein auf 256 Dimensionen verkürztes Embedding von text-embedding-3-large beispielsweise immer noch bessere Ergebnisse als ein ungekürztes Embedding von text-embedding-ada-002 mit 1.536 Dimensionen. Wie sich die Anzahl der Dimensionen auf die Leistung auswirkt, erfährst du in unserem Blogbeitrag zur Einführung der Embedding-Modelle der dritten Generation.
Wir empfehlen, die Anzahl der Dimensionen beim Erstellen des Embeddings mit dem Parameter dimensions festzulegen. In manchen Fällen musst du sie nachträglich ändern. Wenn du den Vektor manuell kürzt, musst du ihn anschließend wie im folgenden Beispiel normieren.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17import OpenAI from "openai";

const client = new OpenAI();

const response = await client.embeddings.create({
  model: "text-embedding-3-small",
  input: "Testing 123",
  encoding_format: "float",
});

const shortened = response.data[0].embedding.slice(0, 256);
const magnitude = Math.hypot(...shortened);
const normalized = shortened.map((value) =>
  magnitude === 0 ? 0 : value / magnitude
);

console.log(normalized);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26from openai import OpenAI
import numpy as np
client = OpenAI()
def normalize_l2(x):
x = np.array(x)
if x.ndim == 1:
norm = np.linalg.norm(x)
if norm == 0:
return x
return x / norm
else:
norm = np.linalg.norm(x, 2, axis=1, keepdims=True)
return np.where(norm == 0, x, x / norm)
response = client.embeddings.create(
model="text-embedding-3-small", input="Testing 123", encoding_format="float"
)
cut_dim = response.data[0].embedding[:256]
norm_dim = normalize_l2(cut_dim)
print(norm_dim)1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
import java.util.List;
private static List<Double> normalizeL2(List<Float> embedding) {
double norm =
Math.sqrt(embedding.stream().mapToDouble(value -> value.doubleValue() * value).sum());
return embedding.stream().map(value -> norm == 0 ? 0.0 : value / norm).toList();
}
var embedding =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.input("Testing 123")
.encodingFormat(EmbeddingCreateParams.EncodingFormat.FLOAT)
.build());
List<Float> shortened = embedding.data().get(0).embedding().subList(0, 256);
System.out.println(normalizeL2(shortened));1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16using OpenAI.Embeddings;
string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "text-embedding-3-small";
EmbeddingClient client = new(model, key);
OpenAIEmbedding embedding = await client.GenerateEmbeddingAsync("Testing 123");
float[] shortened = embedding.ToFloats().Span[..256].ToArray();
double magnitude = Math.Sqrt(shortened.Sum(value => (double)value * value));
double[] normalized =
magnitude == 0
? shortened.Select(value => (double)value).ToArray()
: shortened.Select(value => value / magnitude).ToArray();
Console.WriteLine(System.Text.Json.JsonSerializer.Serialize(normalized));1
2
3
4
5
6
7
8
9
10
11
12
13
14
15require "openai"
client = OpenAI::Client.new
response = client.embeddings.create(
model: "text-embedding-3-small",
input: "Testing 123",
encoding_format: :float
)
shortened = response.data.fetch(0).embedding.first(256)
magnitude = Math.sqrt(shortened.sum { |value| value**2 })
normalized = shortened.map { |value| magnitude.zero? ? 0 : value / magnitude }
puts(normalized)Wenn du die Anzahl der Dimensionen dynamisch anpasst, kannst du Embeddings flexibel einsetzen. Unterstützt dein Vektorspeicher beispielsweise höchstens 1.024 Dimensionen, kannst du trotzdem unser leistungsfähigstes Embedding-Modell text-embedding-3-large verwenden. Setze dafür den API-Parameter dimensions auf 1024. Damit verkürzt du den Vektor von 3.072 auf 1.024 Dimensionen und nimmst für die geringere Größe etwas weniger Genauigkeit in Kauf.
Häufig fehlen in den Trainingsdaten eines Modells wichtige Fakten, die es zur Beantwortung einer Anfrage braucht. Wie das folgende Beispiel zeigt, kannst du dem Modell zusätzliche Informationen in seinem Kontextfenster bereitstellen. Das funktioniert in vielen Anwendungsfällen gut, erhöht aber die Token-Kosten. Im Notebook vergleichen wir die Vor- und Nachteile dieses Ansatzes mit denen einer Embedding-basierten Suche.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import OpenAI from "openai";

const client = new OpenAI();
const article =
  "At the 2022 Winter Olympics, Great Britain won women's curling and Sweden won men's curling.";
const question = `Use the article below to answer the question. If the answer cannot be found, say "I don't know."

Article:
${article}

Question: Which athletes won the gold medal in curling at the 2022 Winter Olympics?`;

const response = await client.chat.completions.create({
  model: "gpt-4.1-mini",
  messages: [
    {
      role: "system",
      content: "You answer questions about the 2022 Winter Olympics.",
    },
    { role: "user", content: question },
  ],
  temperature: 0,
});

console.log(response.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22query = f"""Use the below article on the 2022 Winter Olympics to answer the subsequent question. If the answer cannot be found, write "I don't know."
Article:
\"\"\"
{wikipedia_article_on_curling}
\"\"\"
Question: Which athletes won the gold medal in curling at the 2022 Winter Olympics?"""
response = client.chat.completions.create(
messages=[
{
"role": "system",
"content": "You answer questions about the 2022 Winter Olympics.",
},
{"role": "user", "content": query},
],
model=GPT_MODEL,
temperature=0,
)
print(response.choices[0].message.content)1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27import (
"context"
"fmt"
"log"
"github.com/openai/openai-go/v3"
)
func main() {
if err := run(); err != nil {
log.Fatal(err)
}
}
func run() error {
client := openai.NewClient()
completion, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{
Model: "gpt-4.1-mini", Temperature: openai.Float(0), Messages: []openai.ChatCompletionMessageParamUnion{
openai.SystemMessage("You answer questions about the 2022 Winter Olympics."),
openai.UserMessage("Use the article to answer the question. If the answer cannot be found, write \"I don't know.\"\n\nArticle: At the 2022 Winter Olympics, Great Britain won women's curling and Sweden won men's curling.\n\nQuestion: Which athletes won the gold medal in curling at the 2022 Winter Olympics?")},
})
if err != nil {
return err
}
fmt.Println(completion.Choices[0].Message.Content)
return nil
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.chat.completions.ChatCompletionCreateParams;
String article =
"At the 2022 Winter Olympics, Great Britain won women's curling and Sweden won men's curling.";
String question =
"Use the below article on the 2022 Winter Olympics to answer the subsequent question. "
+ "If the answer cannot be found, write \"I don't know.\"\n\n"
+ "Article:\n"
+ article
+ "\n\nQuestion: Which athletes won the gold medal in curling at the 2022 Winter Olympics?";
ChatCompletionCreateParams params =
ChatCompletionCreateParams.builder()
.model("gpt-4.1-mini")
.addSystemMessage("You answer questions about the 2022 Winter Olympics.")
.addUserMessage(question)
.temperature(0)
.build();
client.chat().completions().create(params).choices().stream()
.flatMap(choice -> choice.message().content().stream())
.forEach(System.out::println);1
2
3
4
5
6
7
8
9
10
11
12using OpenAI.Chat;
string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "gpt-4.1-mini";
ChatClient client = new(model, key);
string article = "At the 2022 Winter Olympics, Great Britain won women's curling and Sweden won men's curling.";
string query = $"Use the article to answer the question. If the answer cannot be found, write I don't know.\nArticle: {article}\nQuestion: Which athletes won the gold medal in curling at the 2022 Winter Olympics?";
ChatCompletion result = await client.CompleteChatAsync(
[new SystemChatMessage("You answer questions about the 2022 Winter Olympics."), new UserChatMessage(query)],
new ChatCompletionOptions { Temperature = 0 });
Console.WriteLine(result.Content[0].Text);1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29require "openai"
client = OpenAI::Client.new
article = "At the 2022 Winter Olympics, Great Britain won women's curling and Sweden won men's curling."
question = <<~QUESTION
Use the article below to answer the question. If the answer cannot be found, say "I don't know."
Article:
#{article}
Question: Which athletes won the gold medal in curling at the 2022 Winter Olympics?
QUESTION
response = client.chat.completions.create(
model: "gpt-4.1-mini",
messages: [
{
role: :system,
content: "You answer questions about the 2022 Winter Olympics."
},
{
role: :user,
content: question
}
],
temperature: 0
)
puts(response.choices.fetch(0).message.content)Um die relevantesten Dokumente zu finden, berechnen wir für jedes Dokument die Kosinusähnlichkeit zwischen seinem Embedding-Vektor und dem der Anfrage. Wir geben die Dokumente mit den höchsten Werten zurück.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32import OpenAI from "openai";

const client = new OpenAI();
const reviews = [
  "A rich cup of coffee.",
  "Smooth beans in tomato sauce.",
  "Dark chocolate with orange.",
];

const { data } = await client.embeddings.create({
  model: "text-embedding-3-small",
  input: [...reviews, "delicious beans"],
});

const query = data[reviews.length].embedding;
const similarity = (embedding: number[]) => {
  const dotProduct = embedding.reduce(
    (total, value, index) => total + value * query[index],
    0
  );
  return dotProduct / (Math.hypot(...embedding) * Math.hypot(...query));
};

const results = reviews
  .map((review, index) => ({
    review,
    score: similarity(data[index].embedding),
  }))
  .sort((left, right) => right.score - left.score)
  .slice(0, 3);

console.log(results);
1
2
3
4
5
6
7
8
9
10def search_reviews(df, product_description, n=3, pprint=True):
embedding = get_embedding(product_description, model="text-embedding-3-small")
df["similarities"] = df.ada_embedding.apply(
lambda x: cosine_similarity(x, embedding)
)
res = df.sort_values("similarities", ascending=False).head(n)
return res
res = search_reviews(df, "delicious beans", n=3)1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73import (
"context"
"fmt"
"log"
"math"
"sort"
"github.com/openai/openai-go/v3"
)
func main() {
if err := run(); err != nil {
log.Fatal(err)
}
}
func run() error {
client := openai.NewClient()
ctx := context.Background()
texts := []string{"A rich cup of coffee.", "Crunchy crackers with sea salt.", "Dark chocolate with orange.", "A bright herbal tea.", "Smooth beans in tomato sauce.", "A mild cheese with herbs.", "Spicy roasted nuts.", "A crisp sparkling water."}
vectors := make([][]float64, len(texts))
for i, text := range texts {
vector, err := embedding(ctx, &client, text)
if err != nil {
return err
}
vectors[i] = vector
}
query, err := embedding(ctx, &client, "delicious beans")
if err != nil {
return err
}
matches := nearest(query, vectors)
for _, match := range matches[:min(3, len(matches))] {
fmt.Printf("%0.3f: %s\n", match.Similarity, texts[match.Index])
}
return nil
}
func embedding(ctx context.Context, client *openai.Client, text string) ([]float64, error) {
response, err := client.Embeddings.New(ctx, openai.EmbeddingNewParams{
Model: openai.EmbeddingModelTextEmbedding3Small,
Input: openai.EmbeddingNewParamsInputUnion{OfString: openai.String(text)},
})
if err != nil {
return nil, err
}
return response.Data[0].Embedding, nil
}
func cosineSimilarity(a, b []float64) float64 {
var dot, left, right float64
for i := range a {
dot += a[i] * b[i]
left += a[i] * a[i]
right += b[i] * b[i]
}
return dot / math.Sqrt(left*right)
}
type match struct {
Index int
Similarity float64
}
func nearest(query []float64, vectors [][]float64) []match {
matches := make([]match, len(vectors))
for i, vector := range vectors {
matches[i] = match{Index: i, Similarity: cosineSimilarity(query, vector)}
}
sort.SliceStable(matches, func(i, j int) bool { return matches[i].Similarity > matches[j].Similarity })
return matches
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
import java.util.Comparator;
import java.util.List;
import java.util.stream.IntStream;
List<String> reviews =
List.of(
"A rich cup of coffee.",
"Smooth beans in tomato sauce.",
"Dark chocolate with orange.");
var reviewEmbeddings =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.inputOfArrayOfStrings(reviews)
.build())
.data();
List<Float> query =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.inputOfArrayOfStrings(List.of("delicious beans"))
.build())
.data()
.get(0)
.embedding();
IntStream.range(0, reviews.size())
.boxed()
.sorted(
Comparator.comparingDouble(
(Integer index) ->
cosineSimilarity(query, reviewEmbeddings.get(index).embedding()))
.reversed())
.limit(3)
.map(reviews::get)
.forEach(System.out::println);1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33using OpenAI.Embeddings;
string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "text-embedding-3-small";
EmbeddingClient client = new(model, key);
string[] texts = ["A rich cup of coffee.", "Crunchy crackers with sea salt.", "Dark chocolate with orange.", "A bright herbal tea.", "Smooth beans in tomato sauce.", "A mild cheese with herbs.", "Spicy roasted nuts.", "A crisp sparkling water."];
OpenAIEmbeddingCollection batch = await client.GenerateEmbeddingsAsync(texts);
float[][] vectors = batch.Select(item => item.ToFloats().ToArray()).ToArray();
float[] query = await EmbedAsync(client, "delicious beans");
var ranked = vectors.Select((vector, index) => new { Index = index, Similarity = CosineSimilarity(query, vector) }).OrderByDescending(match => match.Similarity);
foreach (var match in ranked.Take(3))
{
Console.WriteLine($"{match.Similarity:F3}: {texts[match.Index]}");
}
static async Task<float[]> EmbedAsync(EmbeddingClient client, string text)
{
OpenAIEmbedding result = await client.GenerateEmbeddingAsync(text);
return result.ToFloats().ToArray();
}
static double CosineSimilarity(float[] left, float[] right)
{
double dot = 0, leftNorm = 0, rightNorm = 0;
for (int i = 0; i < left.Length; i++)
{
dot += (double)left[i] * right[i];
leftNorm += (double)left[i] * left[i];
rightNorm += (double)right[i] * right[i];
}
return dot / Math.Sqrt(leftNorm * rightNorm);
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30require "openai"
client = OpenAI::Client.new
reviews = [
"A rich cup of coffee.",
"Smooth beans in tomato sauce.",
"Dark chocolate with orange."
]
response = client.embeddings.create(
model: "text-embedding-3-small",
input: reviews + ["delicious beans"]
)
query = response.data.fetch(-1).embedding
similarity = lambda do |embedding|
dot_product = embedding.zip(query).sum { |value, query_value| value * query_value }
magnitude = Math.sqrt(embedding.sum { |value| value**2 })
query_magnitude = Math.sqrt(query.sum { |value| value**2 })
dot_product / (magnitude * query_magnitude)
end
results = reviews.map.with_index do |review, index|
{
review: review,
score: similarity.call(response.data.fetch(index).embedding)
}
end.sort_by { |result| -result.fetch(:score) }.first(3)
puts(results)Die Codesuche funktioniert ähnlich wie die Embedding-basierte Textsuche. Wir zeigen, wie du Python-Funktionen aus allen Python-Dateien eines Repositorys extrahierst. Anschließend wird jede Funktion mit dem Modell text-embedding-3-small indexiert.
Für die Codesuche erstellen wir mit demselben Modell ein Embedding der natürlichsprachlichen Suchanfrage. Dann berechnen wir die Kosinusähnlichkeit zwischen diesem Embedding und den Embeddings der einzelnen Funktionen. Die Treffer mit der höchsten Kosinusähnlichkeit sind am relevantesten.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30import OpenAI from "openai";

const client = new OpenAI();
const functions = [
  "function add(a, b) { return a + b; }",
  "function complete(prompt) { return prompt; }",
];

const { data } = await client.embeddings.create({
  model: "text-embedding-3-small",
  input: [...functions, "Completions API tests"],
});

const query = data[functions.length].embedding;
const similarity = (embedding: number[]) => {
  const dotProduct = embedding.reduce(
    (total, value, index) => total + value * query[index],
    0
  );
  return dotProduct / (Math.hypot(...embedding) * Math.hypot(...query));
};

const results = functions
  .map((source, index) => ({
    source,
    score: similarity(data[index].embedding),
  }))
  .sort((left, right) => right.score - left.score);

console.log(results);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16df["code_embedding"] = df["code"].apply(
lambda x: get_embedding(x, model="text-embedding-3-small")
)
def search_functions(df, code_query, n=3, pprint=True, n_lines=7):
embedding = get_embedding(code_query, model="text-embedding-3-small")
df["similarities"] = df.code_embedding.apply(
lambda x: cosine_similarity(x, embedding)
)
res = df.sort_values("similarities", ascending=False).head(n)
return res
res = search_functions(df, "Completions API tests", n=3)1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73import (
"context"
"fmt"
"log"
"math"
"sort"
"github.com/openai/openai-go/v3"
)
func main() {
if err := run(); err != nil {
log.Fatal(err)
}
}
func run() error {
client := openai.NewClient()
ctx := context.Background()
texts := []string{"def add(a, b): return a + b", "def complete(prompt): return prompt"}
vectors := make([][]float64, len(texts))
for i, text := range texts {
vector, err := embedding(ctx, &client, text)
if err != nil {
return err
}
vectors[i] = vector
}
query, err := embedding(ctx, &client, "Completions API tests")
if err != nil {
return err
}
matches := nearest(query, vectors)
for _, match := range matches[:min(3, len(matches))] {
fmt.Printf("%0.3f: %s\n", match.Similarity, texts[match.Index])
}
return nil
}
func embedding(ctx context.Context, client *openai.Client, text string) ([]float64, error) {
response, err := client.Embeddings.New(ctx, openai.EmbeddingNewParams{
Model: openai.EmbeddingModelTextEmbedding3Small,
Input: openai.EmbeddingNewParamsInputUnion{OfString: openai.String(text)},
})
if err != nil {
return nil, err
}
return response.Data[0].Embedding, nil
}
func cosineSimilarity(a, b []float64) float64 {
var dot, left, right float64
for i := range a {
dot += a[i] * b[i]
left += a[i] * a[i]
right += b[i] * b[i]
}
return dot / math.Sqrt(left*right)
}
type match struct {
Index int
Similarity float64
}
func nearest(query []float64, vectors [][]float64) []match {
matches := make([]match, len(vectors))
for i, vector := range vectors {
matches[i] = match{Index: i, Similarity: cosineSimilarity(query, vector)}
}
sort.SliceStable(matches, func(i, j int) bool { return matches[i].Similarity > matches[j].Similarity })
return matches
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
import java.util.Comparator;
import java.util.List;
import java.util.stream.IntStream;
List<String> functions =
List.of("def add(a, b): return a + b", "def complete(prompt): return prompt");
var functionEmbeddings =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.inputOfArrayOfStrings(functions)
.build())
.data();
List<Float> query =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.input("Completions API tests")
.build())
.data()
.get(0)
.embedding();
IntStream.range(0, functions.size())
.boxed()
.sorted(
Comparator.comparingDouble(
(Integer index) ->
cosineSimilarity(query, functionEmbeddings.get(index).embedding()))
.reversed())
.map(functions::get)
.forEach(System.out::println);1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36using OpenAI.Embeddings;
string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "text-embedding-3-small";
EmbeddingClient client = new(model, key);
string[] texts = ["def add(a, b): return a + b", "def complete(prompt): return prompt"];
List<float[]> vectors = [];
foreach (string text in texts)
{
vectors.Add(await EmbedAsync(client, text));
}
float[] query = await EmbedAsync(client, "Completions API tests");
var ranked = vectors.Select((vector, index) => new { Index = index, Similarity = CosineSimilarity(query, vector) }).OrderByDescending(match => match.Similarity);
foreach (var match in ranked.Take(3))
{
Console.WriteLine($"{match.Similarity:F3}: {texts[match.Index]}");
}
static async Task<float[]> EmbedAsync(EmbeddingClient client, string text)
{
OpenAIEmbedding result = await client.GenerateEmbeddingAsync(text);
return result.ToFloats().ToArray();
}
static double CosineSimilarity(float[] left, float[] right)
{
double dot = 0, leftNorm = 0, rightNorm = 0;
for (int i = 0; i < left.Length; i++)
{
dot += (double)left[i] * right[i];
leftNorm += (double)left[i] * left[i];
rightNorm += (double)right[i] * right[i];
}
return dot / Math.Sqrt(leftNorm * rightNorm);
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29require "openai"
client = OpenAI::Client.new
functions = [
"function add(a, b) { return a + b; }",
"function complete(prompt) { return prompt; }"
]
response = client.embeddings.create(
model: "text-embedding-3-small",
input: functions + ["Completions API tests"]
)
query = response.data.fetch(-1).embedding
similarity = lambda do |embedding|
dot_product = embedding.zip(query).sum { |value, query_value| value * query_value }
magnitude = Math.sqrt(embedding.sum { |value| value**2 })
query_magnitude = Math.sqrt(query.sum { |value| value**2 })
dot_product / (magnitude * query_magnitude)
end
results = functions.map.with_index do |source, index|
{
source: source,
score: similarity.call(response.data.fetch(index).embedding)
}
end.sort_by { |result| -result.fetch(:score) }
puts(results)Je geringer der Abstand zwischen zwei Embedding-Vektoren, desto ähnlicher sind sich die zugehörigen Texte. Dadurch eignen sich Embeddings für Empfehlungen.
Das folgende Beispiel zeigt ein einfaches Empfehlungssystem. Es erhält eine Liste von Texten und einen Referenztext, berechnet ihre Embeddings und gibt die Texte nach absteigender Ähnlichkeit zum Referenztext sortiert zurück. Das verlinkte Notebook wendet eine Variante dieser Funktion auf eine Stichprobe aus dem Nachrichtendatensatz AG News an. Aus 2.000 Artikelbeschreibungen ermittelt die Funktion zu einem beliebigen Ausgangsartikel die fünf ähnlichsten Artikel.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28import OpenAI from "openai";

const client = new OpenAI();
const strings = [
  "A cheetah is a fast land animal.",
  "A peregrine falcon is a fast bird.",
  "A tortoise moves slowly.",
];

const { data } = await client.embeddings.create({
  model: "text-embedding-3-small",
  input: strings,
});

const query = data[0].embedding;
const recommendations = data
  .map(({ embedding }, index) => {
    const dotProduct = embedding.reduce(
      (total, value, dimension) => total + value * query[dimension],
      0
    );
    const similarity =
      dotProduct / (Math.hypot(...embedding) * Math.hypot(...query));
    return { index, text: strings[index], similarity };
  })
  .sort((left, right) => right.similarity - left.similarity);

console.log(recommendations);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23def recommendations_from_strings(
strings: list[str],
index_of_source_string: int,
model="text-embedding-3-small",
) -> list[int]:
"""Return nearest neighbors of a given string."""
# get embeddings for all strings
embeddings = [embedding_from_string(string, model=model) for string in strings]
# get the embedding of the source string
query_embedding = embeddings[index_of_source_string]
# get distances between the source embedding and other embeddings (function from embeddings_utils.py)
distances = distances_from_embeddings(
query_embedding, embeddings, distance_metric="cosine"
)
# get indices of nearest neighbors (function from embeddings_utils.py)
indices_of_nearest_neighbors = indices_of_nearest_neighbors_from_distances(
distances
)
return indices_of_nearest_neighbors1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70import (
"context"
"fmt"
"log"
"math"
"sort"
"github.com/openai/openai-go/v3"
)
func main() {
if err := run(); err != nil {
log.Fatal(err)
}
}
func run() error {
client := openai.NewClient()
ctx := context.Background()
texts := []string{"A cheetah is a fast land animal.", "A peregrine falcon is a fast bird.", "A tortoise moves slowly."}
vectors := make([][]float64, len(texts))
for i, text := range texts {
vector, err := embedding(ctx, &client, text)
if err != nil {
return err
}
vectors[i] = vector
}
query := vectors[0]
matches := nearest(query, vectors)
for _, match := range matches {
fmt.Println(match.Index)
}
return nil
}
func embedding(ctx context.Context, client *openai.Client, text string) ([]float64, error) {
response, err := client.Embeddings.New(ctx, openai.EmbeddingNewParams{
Model: openai.EmbeddingModelTextEmbedding3Small,
Input: openai.EmbeddingNewParamsInputUnion{OfString: openai.String(text)},
})
if err != nil {
return nil, err
}
return response.Data[0].Embedding, nil
}
func cosineSimilarity(a, b []float64) float64 {
var dot, left, right float64
for i := range a {
dot += a[i] * b[i]
left += a[i] * a[i]
right += b[i] * b[i]
}
return dot / math.Sqrt(left*right)
}
type match struct {
Index int
Similarity float64
}
func nearest(query []float64, vectors [][]float64) []match {
matches := make([]match, len(vectors))
for i, vector := range vectors {
matches[i] = match{Index: i, Similarity: cosineSimilarity(query, vector)}
}
sort.SliceStable(matches, func(i, j int) bool { return matches[i].Similarity > matches[j].Similarity })
return matches
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
import java.util.Comparator;
import java.util.List;
import java.util.stream.IntStream;
List<String> strings =
List.of(
"A cheetah is a fast land animal.",
"A peregrine falcon is a fast bird.",
"A tortoise moves slowly.");
var embeddings =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.inputOfArrayOfStrings(strings)
.build())
.data();
List<Float> query = embeddings.get(0).embedding();
var nearestNeighbors =
IntStream.range(0, embeddings.size())
.boxed()
.sorted(
Comparator.comparingDouble(
(Integer index) -> {
List<Float> candidate = embeddings.get(index).embedding();
double dotProduct = 0;
double queryMagnitude = 0;
double candidateMagnitude = 0;
for (int dimension = 0; dimension < query.size(); dimension++) {
double queryValue = query.get(dimension);
double candidateValue = candidate.get(dimension);
dotProduct += queryValue * candidateValue;
queryMagnitude += queryValue * queryValue;
candidateMagnitude += candidateValue * candidateValue;
}
return 1 - dotProduct / Math.sqrt(queryMagnitude * candidateMagnitude);
}))
.toList();
System.out.println(nearestNeighbors);1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36using OpenAI.Embeddings;
string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "text-embedding-3-small";
EmbeddingClient client = new(model, key);
string[] texts = ["A cheetah is a fast land animal.", "A peregrine falcon is a fast bird.", "A tortoise moves slowly."];
List<float[]> vectors = [];
foreach (string text in texts)
{
vectors.Add(await EmbedAsync(client, text));
}
float[] query = vectors[0];
var ranked = vectors.Select((vector, index) => new { Index = index, Similarity = CosineSimilarity(query, vector) }).OrderByDescending(match => match.Similarity);
foreach (var match in ranked)
{
Console.WriteLine(match.Index);
}
static async Task<float[]> EmbedAsync(EmbeddingClient client, string text)
{
OpenAIEmbedding result = await client.GenerateEmbeddingAsync(text);
return result.ToFloats().ToArray();
}
static double CosineSimilarity(float[] left, float[] right)
{
double dot = 0, leftNorm = 0, rightNorm = 0;
for (int i = 0; i < left.Length; i++)
{
dot += (double)left[i] * right[i];
leftNorm += (double)left[i] * left[i];
rightNorm += (double)right[i] * right[i];
}
return dot / Math.Sqrt(leftNorm * rightNorm);
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31require "openai"
client = OpenAI::Client.new
strings = [
"A cheetah is a fast land animal.",
"A peregrine falcon is a fast bird.",
"A tortoise moves slowly."
]
response = client.embeddings.create(
model: "text-embedding-3-small",
input: strings
)
query = response.data.fetch(0).embedding
similarity = lambda do |embedding|
dot_product = embedding.zip(query).sum { |value, query_value| value * query_value }
magnitude = Math.sqrt(embedding.sum { |value| value**2 })
query_magnitude = Math.sqrt(query.sum { |value| value**2 })
dot_product / (magnitude * query_magnitude)
end
recommendations = response.data.map.with_index do |embedding, index|
{
index: index,
text: strings.fetch(index),
similarity: similarity.call(embedding.embedding)
}
end.sort_by { |recommendation| -recommendation.fetch(:similarity) }
puts(recommendations)Die Größe der Embeddings hängt von der Komplexität des zugrunde liegenden Modells ab. Um die hochdimensionalen Daten zu visualisieren, bilden wir sie mit dem t-SNE-Algorithmus auf zwei Dimensionen ab.
Die Farbe jeder Rezension gibt an, wie viele Sterne die Person vergeben hat, die sie geschrieben hat:
- 1 Stern: Rot
- 2 Sterne: Dunkelorange
- 3 Sterne: Gold
- 4 Sterne: Türkis
- 5 Sterne: Dunkelgrün
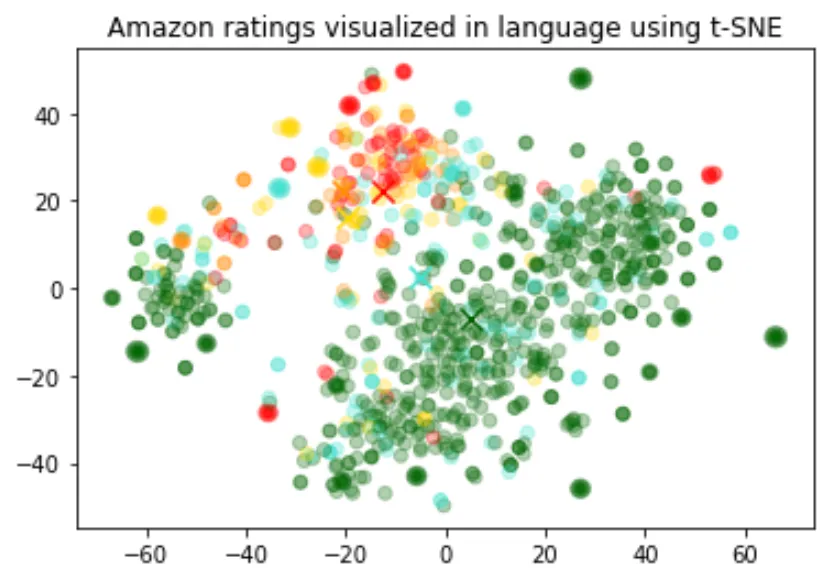
In der Darstellung lassen sich ungefähr drei Cluster erkennen. Eines davon enthält überwiegend negative Rezensionen.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24from ast import literal_eval
import numpy as np
import pandas as pd
from sklearn.manifold import TSNE
import matplotlib.pyplot as plt
import matplotlib

df = pd.read_csv("output/embedded_1k_reviews.csv")
matrix = np.array(df.ada_embedding.apply(literal_eval).to_list())

# Create a t-SNE model and transform the data
tsne = TSNE(
    n_components=2, perplexity=15, random_state=42, init="random", learning_rate=200
)
vis_dims = tsne.fit_transform(matrix)

colors = ["red", "darkorange", "gold", "turquoise", "darkgreen"]
x = [x for x, y in vis_dims]
y = [y for x, y in vis_dims]
color_indices = df.Score.values - 1

colormap = matplotlib.colors.ListedColormap(colors)
plt.scatter(x, y, c=color_indices, cmap=colormap, alpha=0.3)
plt.title("Amazon ratings visualized in language using t-SNE")Mit Embeddings lassen sich beliebige Freitexte als Merkmale für ein Modell des maschinellen Lernens (ML) kodieren. Wenn ein Teil der relevanten Eingaben aus Freitext besteht, verbessern Embeddings die Leistung eines solchen Modells. Du kannst mit Embeddings auch kategoriale Merkmale für ein ML-Modell kodieren. Das ist besonders hilfreich, wenn es viele Kategorien mit aussagekräftigen Bezeichnungen gibt, etwa Berufsbezeichnungen. Für diese Aufgabe liefern Embeddings für Ähnlichkeitsvergleiche in der Regel bessere Ergebnisse als Embeddings für die Suche.
Wir haben beobachtet, dass Embeddings meist sehr viele Informationen auf engem Raum enthalten. Reduziert man beispielsweise die Anzahl der Eingabedimensionen mithilfe von SVD oder PCA um nur 10 %, verschlechtern sich in der Regel die Ergebnisse bei den nachgelagerten Aufgaben.
Der folgende Code teilt die Daten in einen Trainings- und einen Testdatensatz auf. Beide verwenden wir für die nächsten zwei Anwendungsfälle, die Regression und die Klassifikation.
1
2
3
4
5from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(
    list(df.ada_embedding.values), df.Score, test_size=0.2, random_state=42
)
Regression mit Embedding-Merkmalen
Mit Embeddings lassen sich numerische Werte auf einfache Weise vorhersagen. In diesem Beispiel sagen wir anhand des Rezensionstextes voraus, wie viele Sterne die Person vergeben hat. Da Embeddings viele semantische Informationen enthalten, gelingen auch mit sehr wenigen Rezensionen brauchbare Vorhersagen.
Wir behandeln die Bewertung als kontinuierliche Variable zwischen 1 und 5. Der Algorithmus kann somit auch Gleitkommawerte vorhersagen. Der ML-Algorithmus minimiert den Abstand zwischen dem vorhergesagten Wert und der tatsächlichen Bewertung. Er erreicht einen mittleren absoluten Fehler von 0,39. Die Vorhersage weicht also im Durchschnitt um weniger als einen halben Stern ab.
1
2
3
4
5from sklearn.ensemble import RandomForestRegressor

rfr = RandomForestRegressor(n_estimators=100)
rfr.fit(X_train, y_train)
preds = rfr.predict(X_test)Diesmal soll der Algorithmus die genaue Anzahl der Sterne einer Rezension vorhersagen. Dafür ordnet er die Rezension einer von fünf Klassen zu, von einem Stern bis zu fünf Sternen. Zwischenwerte wie bei der Regression sind damit ausgeschlossen.
Nach dem Training erkennt das Modell Rezensionen mit einem oder fünf Sternen deutlich besser als die differenzierteren Bewertungen mit zwei bis vier Sternen. Vermutlich kommt die positive oder negative Haltung bei den Extremwerten deutlicher zum Ausdruck.
1
2
3
4
5
6from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report, accuracy_score

clf = RandomForestClassifier(n_estimators=100)
clf.fit(X_train, y_train)
preds = clf.predict(X_test)Mit Embeddings ist eine Zero-Shot-Klassifikation ohne gelabelte Trainingsdaten möglich. Für jede Klasse erstellen wir ein Embedding aus ihrem Namen oder einer kurzen Beschreibung. Um einen neuen Text zu klassifizieren, vergleichen wir sein Embedding mit allen Klassen-Embeddings. Als Vorhersage wählen wir die Klasse mit der höchsten Ähnlichkeit.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21import OpenAI from "openai";

const client = new OpenAI();
const labels = ["negative", "positive"];

const { data } = await client.embeddings.create({
  model: "text-embedding-3-small",
  input: [...labels, "The coffee arrived quickly and tastes great."],
});

const review = data[labels.length].embedding;
const similarity = (embedding: number[]) => {
  const dotProduct = embedding.reduce(
    (total, value, index) => total + value * review[index],
    0
  );
  return dotProduct / (Math.hypot(...embedding) * Math.hypot(...review));
};

const [negative, positive] = data.map(({ embedding }) => similarity(embedding));
console.log(positive > negative ? "positive" : "negative");
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18df = df[df.Score != 3]
df["sentiment"] = df.Score.replace(
{1: "negative", 2: "negative", 4: "positive", 5: "positive"}
)
labels = ["negative", "positive"]
label_embeddings = [get_embedding(label, model=model) for label in labels]
def label_score(review_embedding, label_embeddings):
return cosine_similarity(review_embedding, label_embeddings[1]) - cosine_similarity(
review_embedding, label_embeddings[0]
)
prediction = (
"positive" if label_score(get_embedding("Sample Review", model=model), label_embeddings) > 0 else "negative"
)1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59import (
"context"
"fmt"
"log"
"math"
"github.com/openai/openai-go/v3"
)
func main() {
if err := run(); err != nil {
log.Fatal(err)
}
}
func run() error {
client := openai.NewClient()
ctx := context.Background()
negative, err := embedding(ctx, &client, "negative")
if err != nil {
return err
}
positive, err := embedding(ctx, &client, "positive")
if err != nil {
return err
}
review, err := embedding(ctx, &client, "Sample Review")
if err != nil {
return err
}
score := cosineSimilarity(review, positive) - cosineSimilarity(review, negative)
prediction := "negative"
if score > 0 {
prediction = "positive"
}
fmt.Println(prediction)
return nil
}
func embedding(ctx context.Context, client *openai.Client, text string) ([]float64, error) {
response, err := client.Embeddings.New(ctx, openai.EmbeddingNewParams{
Model: openai.EmbeddingModelTextEmbedding3Small,
Input: openai.EmbeddingNewParamsInputUnion{OfString: openai.String(text)},
})
if err != nil {
return nil, err
}
return response.Data[0].Embedding, nil
}
func cosineSimilarity(a, b []float64) float64 {
var dot, left, right float64
for i := range a {
dot += a[i] * b[i]
left += a[i] * a[i]
right += b[i] * b[i]
}
return dot / math.Sqrt(left*right)
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
import java.util.List;
var embeddings =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.inputOfArrayOfStrings(List.of("negative", "positive", "Sample Review"))
.build())
.data();
List<Float> review = embeddings.get(2).embedding();
double negative = cosineSimilarity(review, embeddings.get(0).embedding());
double positive = cosineSimilarity(review, embeddings.get(1).embedding());
System.out.println(positive > negative ? "positive" : "negative");1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29using OpenAI.Embeddings;
string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "text-embedding-3-small";
EmbeddingClient client = new(model, key);
float[] negative = await EmbedAsync(client, "negative");
float[] positive = await EmbedAsync(client, "positive");
float[] review = await EmbedAsync(client, "Sample Review");
double score = CosineSimilarity(review, positive) - CosineSimilarity(review, negative);
Console.WriteLine(score > 0 ? "positive" : "negative");
static async Task<float[]> EmbedAsync(EmbeddingClient client, string text)
{
OpenAIEmbedding result = await client.GenerateEmbeddingAsync(text);
return result.ToFloats().ToArray();
}
static double CosineSimilarity(float[] left, float[] right)
{
double dot = 0, leftNorm = 0, rightNorm = 0;
for (int i = 0; i < left.Length; i++)
{
dot += (double)left[i] * right[i];
leftNorm += (double)left[i] * left[i];
rightNorm += (double)right[i] * right[i];
}
return dot / Math.Sqrt(leftNorm * rightNorm);
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22require "openai"
client = OpenAI::Client.new
labels = ["negative", "positive"]
response = client.embeddings.create(
model: "text-embedding-3-small",
input: labels + ["The coffee arrived quickly and tastes great."]
)
review = response.data.fetch(-1).embedding
similarity = lambda do |embedding|
dot_product = embedding.zip(review).sum { |value, review_value| value * review_value }
magnitude = Math.sqrt(embedding.sum { |value| value**2 })
review_magnitude = Math.sqrt(review.sum { |value| value**2 })
dot_product / (magnitude * review_magnitude)
end
negative, positive = response.data.first(2).map do |embedding|
similarity.call(embedding.embedding)
end
puts((positive > negative) ? "positive" : "negative")Für das Embedding einer Person bilden wir den Mittelwert der Embeddings aller Rezensionen, die sie geschrieben hat. Für das Embedding eines Produkts mitteln wir entsprechend die Embeddings aller Rezensionen zu diesem Produkt. Um zu zeigen, wie gut dieser Ansatz funktioniert, verwenden wir eine Teilmenge von 50.000 Rezensionen. Damit stehen uns pro Person und pro Produkt mehr Rezensionen zur Verfügung.
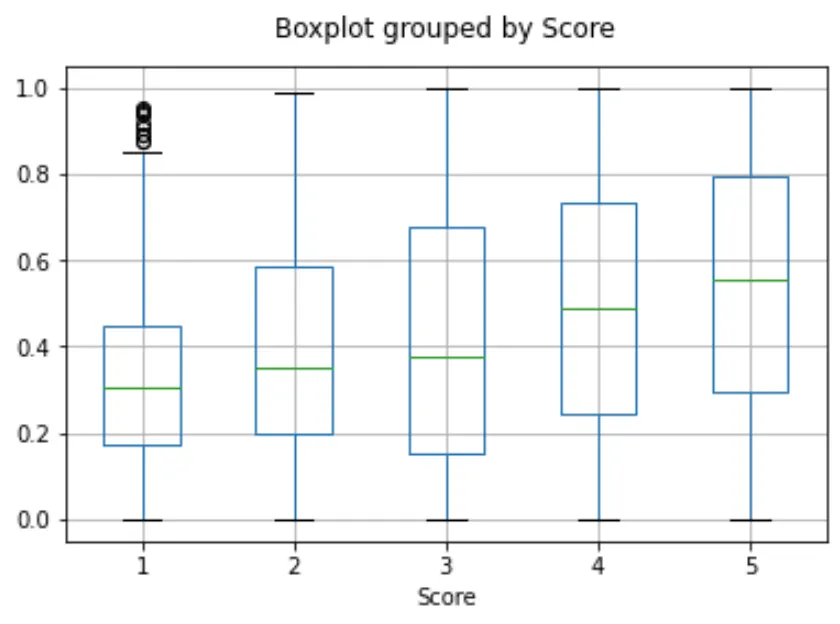
Wir prüfen die Aussagekraft dieser Embeddings anhand eines separaten Testdatensatzes. Dazu stellen wir die Ähnlichkeit zwischen Nutzer- und Produkt-Embedding in Abhängigkeit von der Bewertung dar. Noch bevor eine Person das Produkt erhält, können wir damit besser als durch bloßes Raten vorhersagen, ob es ihr gefallen wird.
user_embeddings = df.groupby("UserId").ada_embedding.apply(np.mean)
prod_embeddings = df.groupby("ProductId").ada_embedding.apply(np.mean)
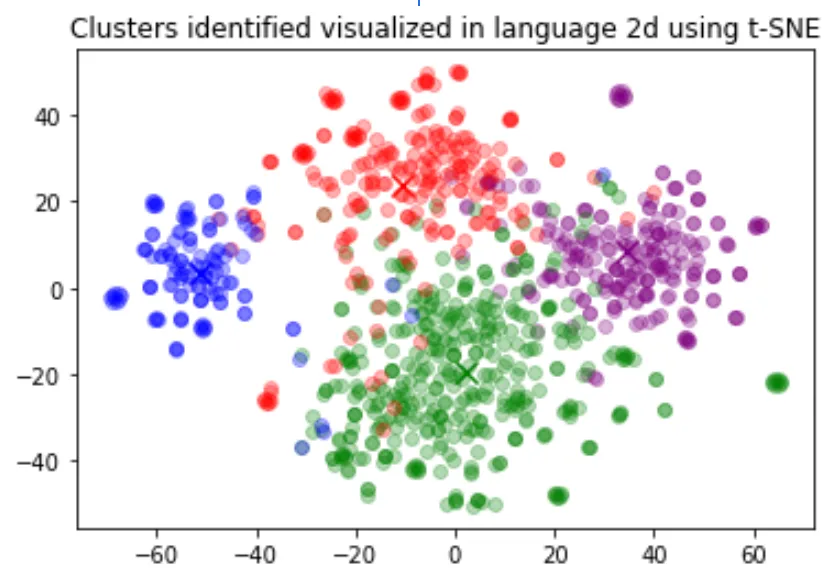
Clustering hilft dabei, große Mengen an Textdaten zu erschließen. Embeddings eignen sich dafür, weil ihre Vektoren die Bedeutung der einzelnen Texte abbilden. So lassen sich mit Clustering auch ohne vorgegebene Klassen verborgene Gruppen im Datensatz erkennen.
In diesem Beispiel finden wir vier klar unterscheidbare Cluster. Eines enthält vor allem Rezensionen zu Hundefutter, eines negative Rezensionen und zwei positive Rezensionen.
1
2
3
4
5
6
7
8
9import numpy as np
from sklearn.cluster import KMeans

matrix = np.vstack(df.ada_embedding.values)
n_clusters = 4

kmeans = KMeans(n_clusters=n_clusters, init="k-means++", random_state=42)
kmeans.fit(matrix)
df["Cluster"] = kmeans.labels_
Häufige Fragen
Wie ermittle ich die Anzahl der Token in einem Text, bevor ich sein Embedding erstelle?
In Python kannst du eine Zeichenkette mit dem Tokenizer tiktoken von OpenAI in Token zerlegen.
Beispielcode:
1
2
3
4
5
6
7
8
9
10
11import tiktoken


def num_tokens_from_string(string: str, encoding_name: str) -> int:
    """Returns the number of tokens in a text string."""
    encoding = tiktoken.get_encoding(encoding_name)
    num_tokens = len(encoding.encode(string))
    return num_tokens


num_tokens_from_string("tiktoken is great!", "cl100k_base")
Verwende für Embedding-Modelle der dritten Generation wie text-embedding-3-small die Kodierung cl100k_base.
Weitere Einzelheiten und Beispielcode findest du in der Anleitung zum Zählen von Token mit tiktoken im OpenAI Cookbook.
Wie finde ich schnell die K nächstgelegenen Embedding-Vektoren?
Für die schnelle Suche in großen Vektormengen empfehlen wir eine Vektordatenbank. Beispiele für den Einsatz von Vektordatenbanken mit der OpenAI API findest du in unserem Cookbook auf GitHub.
Welche Abstandsfunktion sollte ich verwenden?
Wir empfehlen die Kosinusähnlichkeit. Die Wahl der Abstandsfunktion macht in der Regel kaum einen Unterschied.
Die Embedding-Vektoren von OpenAI sind auf die Länge 1 normiert. Daraus folgt:
- Für die Berechnung der Kosinusähnlichkeit genügt das Skalarprodukt. Dadurch ist die Berechnung etwas schneller.
- Kosinusähnlichkeit und euklidischer Abstand ergeben dieselbe Rangfolge.
Kann ich meine Embeddings online teilen?
Ja. Dir gehören sowohl deine Eingaben als auch die Ausgaben, die du von unseren Modellen erhältst. Das gilt auch für Embeddings. Du bist dafür verantwortlich, dass die Inhalte, die du an unsere API sendest, weder gegen geltendes Recht noch gegen unsere Nutzungsbedingungen verstoßen.
Kennen Embedding-Modelle der dritten Generation aktuelle Ereignisse?
Nein. Die Modelle text-embedding-3-large und text-embedding-3-small haben keine Kenntnisse über Ereignisse nach September 2021. Bei Embedding-Modellen fällt diese Einschränkung in der Regel weniger ins Gewicht als bei Modellen zur Textgenerierung. In Ausnahmefällen kann sie jedoch die Leistung beeinträchtigen.