
OpenAI bietet zwei Arten von Modellen an: Reasoning-Modelle (zum Beispiel o3 und o4-mini) und GPT-Modelle (etwa GPT-4.1). Die beiden Modellfamilien verhalten sich unterschiedlich.
In diesem Leitfaden erfährst du:
- Wie sich unsere Reasoning-Modelle von GPT-Modellen ohne Reasoning unterscheiden
- Wann du unsere Reasoning-Modelle einsetzen solltest
- Wie du wirksame Prompts für Reasoning-Modelle formulierst
Erfahre mehr über Reasoning-Modelle und ihre Funktionsweise.
Reasoning-Modelle und GPT-Modelle im Vergleich
Die Modelle der o-Serie haben andere Stärken als GPT-Modelle und benötigen andere Prompts. Welche Modellfamilie sich besser eignet, hängt von der Aufgabe ab.
Wir haben unsere Modelle der o-Serie, die „Planer“, darauf trainiert, komplexe Aufgaben länger und gründlicher zu durchdenken. Dadurch können sie Strategien entwickeln, Lösungswege für schwierige Probleme planen und anhand großer Mengen mehrdeutiger Informationen Entscheidungen treffen. Sie können Aufgaben auch mit hoher Genauigkeit und Präzision ausführen. Damit eignen sie sich besonders für Bereiche, in denen sonst menschliches Fachwissen gefragt wäre, etwa Mathematik, Naturwissenschaften, Ingenieurwesen sowie Finanz- und Rechtsdienstleistungen.
Unsere GPT-Modelle sind dagegen die „Arbeitspferde“. Sie sind auf die direkte Ausführung von Aufgaben ausgelegt, haben eine geringere Latenz und arbeiten kosteneffizienter. Eine Anwendung kann mit Modellen der o-Serie eine Lösungsstrategie entwickeln und mit GPT-Modellen einzelne Aufgaben ausführen. Das bietet sich besonders dann an, wenn Geschwindigkeit und Kosten wichtiger sind als absolute Genauigkeit.
So wählst du ein Modell aus
Worauf kommt es bei deinem Anwendungsfall am meisten an?
- Geschwindigkeit und Kosten → GPT-Modelle sind schneller und in der Regel günstiger
- Ausführung klar definierter Aufgaben → GPT-Modelle können Aufgaben mit eindeutigen Vorgaben gut umsetzen
- Genauigkeit und Zuverlässigkeit → Modelle der o-Serie treffen zuverlässig Entscheidungen
- Lösung komplexer Probleme → Modelle der o-Serie kommen mit mehrdeutigen Informationen und komplexen Zusammenhängen zurecht
Wenn Geschwindigkeit und Kosten für dich ausschlaggebend sind und dein Anwendungsfall aus einfachen, klar definierten Aufgaben besteht, eignen sich unsere GPT-Modelle am besten. Wenn Genauigkeit und Zuverlässigkeit an erster Stelle stehen und du ein sehr komplexes Problem in mehreren Schritten lösen musst, ist ein Modell der o-Serie wahrscheinlich die richtige Wahl.
Die meisten KI-Workflows kombinieren beide Modellfamilien. Agenten nutzen die o-Serie für die Planung und für Entscheidungen und die GPT-Serie zur Ausführung der Aufgaben.
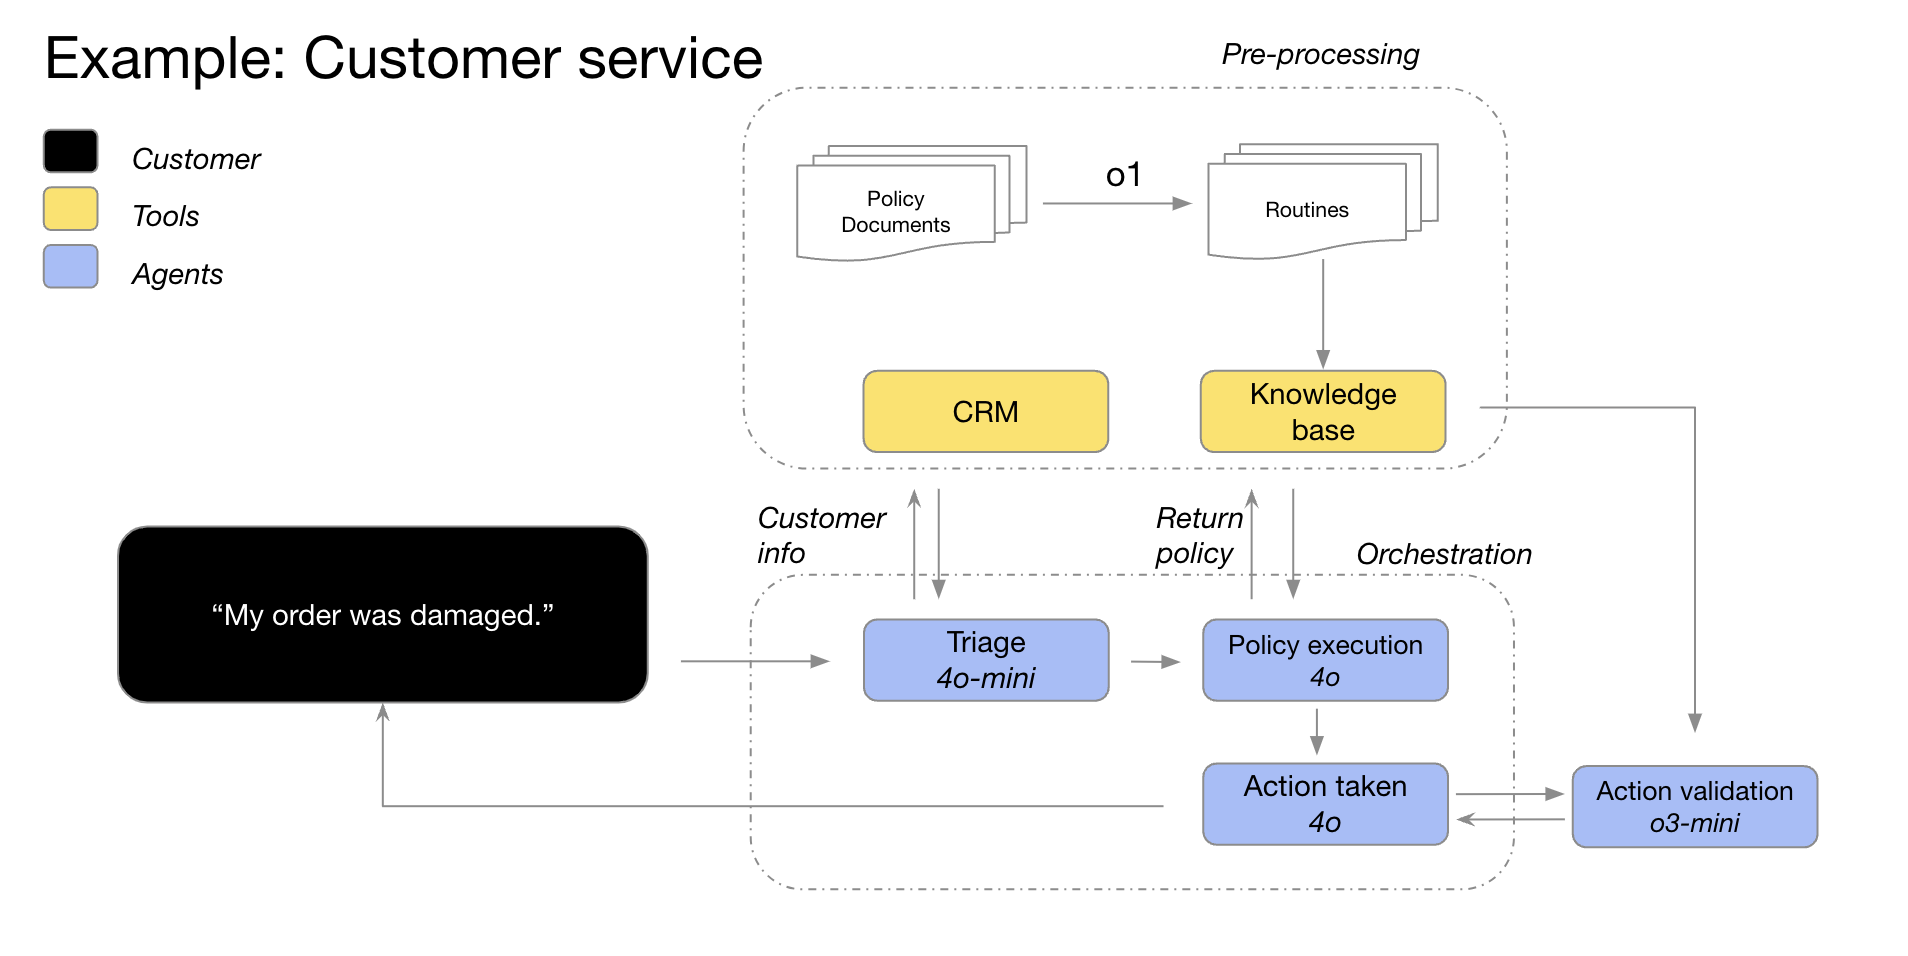
Unsere Modelle GPT-4o und GPT-4o mini prüfen die Bestelldaten zusammen mit den Kundeninformationen. Dabei ermitteln sie die Probleme mit der Bestellung und die geltende Rückgaberichtlinie. Sie übergeben alle Angaben an o3-mini. Das Modell entscheidet anhand der Richtlinie abschließend, ob eine Rückgabe möglich ist.
Wann du unsere Reasoning-Modelle einsetzen solltest
Die folgenden Beispiele zeigen, wie Unternehmen und unsere Teams bei OpenAI Reasoning-Modelle erfolgreich einsetzen. Sie decken einen Teil der möglichen Anwendungsfälle ab und geben dir praktische Anhaltspunkte, um unsere Modelle der o-Serie selbst zu testen.
Bereit für den Einsatz eines Reasoning-Modells? Direkt zum Schnellstart →
1. Mit unklaren Aufgaben umgehen
Reasoning-Modelle können schon mit einem einfachen Prompt gut erkennen, was jemand erreichen möchte, selbst wenn nur wenige oder verstreute Informationen vorliegen. Sie kommen auch mit lückenhaften Anweisungen zurecht. Oft stellen sie zuerst Rückfragen, bevor sie unbegründete Annahmen treffen oder versuchen, fehlende Informationen zu ergänzen.
„Dank der Reasoning-Fähigkeiten von o1 liefert unsere Multi-Agenten-Plattform Matrix bei der Verarbeitung komplexer Dokumente umfassende, übersichtlich formatierte und detaillierte Antworten. Mit einem einfachen Prompt konnte Matrix beispielsweise ohne Weiteres feststellen, welche Spielräume ein Kreditvertrag für ansonsten beschränkte Zahlungen vorsieht. Kein früheres Modell war so leistungsfähig. Bei 52 % der komplexen Prompts zu inhaltlich dichten Kreditverträgen lieferte o1 bessere Ergebnisse als andere Modelle.“
Hebbia, Anbieter einer KI-Wissensplattform für das Rechts- und Finanzwesen
2. Die Nadel im Heuhaufen finden
Wenn du große Mengen unstrukturierter Informationen übergibst, können Reasoning-Modelle diese gut einordnen und gezielt die Angaben herausfiltern, die für die Antwort auf eine Frage am wichtigsten sind.
„Bei der Analyse einer Unternehmensübernahme prüfte o1 Dutzende Unternehmensunterlagen, darunter Verträge und Mietvereinbarungen, auf heikle Bedingungen, die sich auf die Transaktion auswirken könnten. Das Modell sollte auf wichtige Vertragsbestimmungen hinweisen und entdeckte dabei in den Fußnoten eine entscheidende Klausel zum ‚Kontrollwechsel‘. Bei einem Verkauf müsste das Unternehmen ein Darlehen in Höhe von 75 Millionen USD sofort zurückzahlen. Weil o1 so genau auf Details achtet, können unsere KI-Agenten Finanzfachleute gezielt auf geschäftskritische Informationen hinweisen.“
Endex, KI-Plattform für Finanzanalysen
3. Zusammenhänge und feine Unterschiede in großen Datenbeständen erkennen
Nach unserer Erfahrung eignen sich Reasoning-Modelle besonders gut für die Analyse komplexer Dokumente, die auf Hunderten von Seiten dicht gepackte, unstrukturierte Informationen enthalten. Dazu gehören Verträge, Jahresabschlüsse und Unterlagen zu Versicherungsfällen. Die Modelle können besonders gut Parallelen zwischen Dokumenten erkennen und Entscheidungen auf Sachverhalte stützen, die aus den Daten hervorgehen, ohne ausdrücklich genannt zu werden.
„Bei der Recherche zu Steuerfragen müssen wir Informationen aus mehreren Dokumenten zusammenführen, um eine schlüssige Antwort zu geben. Wir haben GPT-4o durch o1 ersetzt. o1 konnte die Zusammenhänge zwischen den Dokumenten deutlich besser analysieren und daraus logische Schlüsse ziehen, die sich aus keinem einzelnen Dokument ergaben. Durch den Wechsel zu o1 hat sich die Leistung über den gesamten Prozess vervierfacht. Das hat uns beeindruckt.“
Blue J, KI-Plattform für die Recherche zu Steuerfragen
Reasoning-Modelle können auch differenzierte Richtlinien und Regelwerke analysieren und auf einen konkreten Fall anwenden, um zu einer nachvollziehbaren Schlussfolgerung zu gelangen.
„Bei Finanzanalysen geht es oft um komplexe Fragen zu Unternehmensbeteiligungen. Wer sie bearbeitet, muss die rechtlichen Feinheiten verstehen. Wir haben etwa zehn Modelle verschiedener Anbieter mit einer anspruchsvollen, aber häufigen Frage getestet: Wie wirkt sich eine Kapitalaufnahme auf diejenigen aus, die bereits Anteile halten, insbesondere wenn sie ihre Verwässerungsschutzrechte ausüben? Dafür muss man die Unternehmensbewertung vor und nach der Finanzierung nachvollziehen und zirkuläre Abhängigkeiten bei der Berechnung der Verwässerung auflösen. Selbst erfahrene Fachleute für Finanzanalysen brauchen dafür 20–30 Minuten. o1 und o3-mini haben das in unseren Tests fehlerfrei geschafft! Die Modelle erstellten sogar eine übersichtliche Berechnungstabelle, aus der die Auswirkungen auf eine Beteiligung im Wert von 100.000 USD hervorgingen.“
BlueFlame AI, KI-Plattform für das Investmentmanagement
4. Agenten mehrstufige Aufgaben planen lassen
Reasoning-Modelle spielen bei der Planung durch Agenten und bei der Strategieentwicklung eine zentrale Rolle. Bewährt hat sich eine Aufgabenteilung, bei der ein Reasoning-Modell die Planung übernimmt. Es arbeitet eine detaillierte Lösung in mehreren Schritten aus und weist jeden Schritt einem geeigneten GPT-Modell zur Ausführung zu. Dabei berücksichtigt es, ob für den jeweiligen Schritt hohe Intelligenz oder geringe Latenz wichtiger ist.
„In unserer Agenteninfrastruktur übernimmt o1 die Planung und koordiniert andere Modelle im Workflow, um mehrstufige Aufgaben zu erledigen. o1 ist unserer Erfahrung nach sehr gut darin, Datentypen auszuwählen und umfangreiche Fragen in kleinere Teilfragen zu zerlegen. So können sich die anderen Modelle auf die Ausführung konzentrieren.“
Argon AI, KI-Wissensplattform für die Pharmaindustrie
„Bei Lindy, unserem KI-Assistenten für die Arbeit, steuert o1 viele der Workflows unserer Agenten. Das Modell nutzt Funktionsaufrufe, um Informationen aus deinem Kalender oder deinen E-Mails abzurufen. Damit kann es dich automatisch dabei unterstützen, Besprechungen zu planen, E-Mails zu versenden und weitere Alltagsaufgaben zu organisieren. Wir haben alle Arbeitsschritte unserer Agenten, die früher Probleme bereiteten, auf o1 umgestellt. Praktisch über Nacht arbeiteten unsere Agenten fast fehlerfrei!“
Lindy.AI, KI-Assistent für die Arbeit
5. Visuelles Reasoning
Derzeit ist o1 das einzige Reasoning-Modell, das Bilder verarbeiten kann. Im Unterschied zu GPT-4o kann o1 auch besonders schwer verständliche Darstellungen erfassen, etwa Diagramme und Tabellen mit unklarer Struktur oder Fotos mit geringer Bildqualität.
„Wir automatisieren Risiko- und Compliance-Prüfungen für Millionen online angebotener Produkte. Dazu zählen Nachahmungen von Luxusschmuck, gefährdete Arten und regulierte Substanzen. Bei unseren schwierigsten Aufgaben zur Bildklassifizierung erzielte GPT-4o eine Genauigkeit von 50 %. o1 erreichte beachtliche 88 %, ohne dass wir unsere Pipeline anpassen mussten.“
SafetyKit, KI-gestützte Plattform für Risiko- und Compliance-Prüfungen
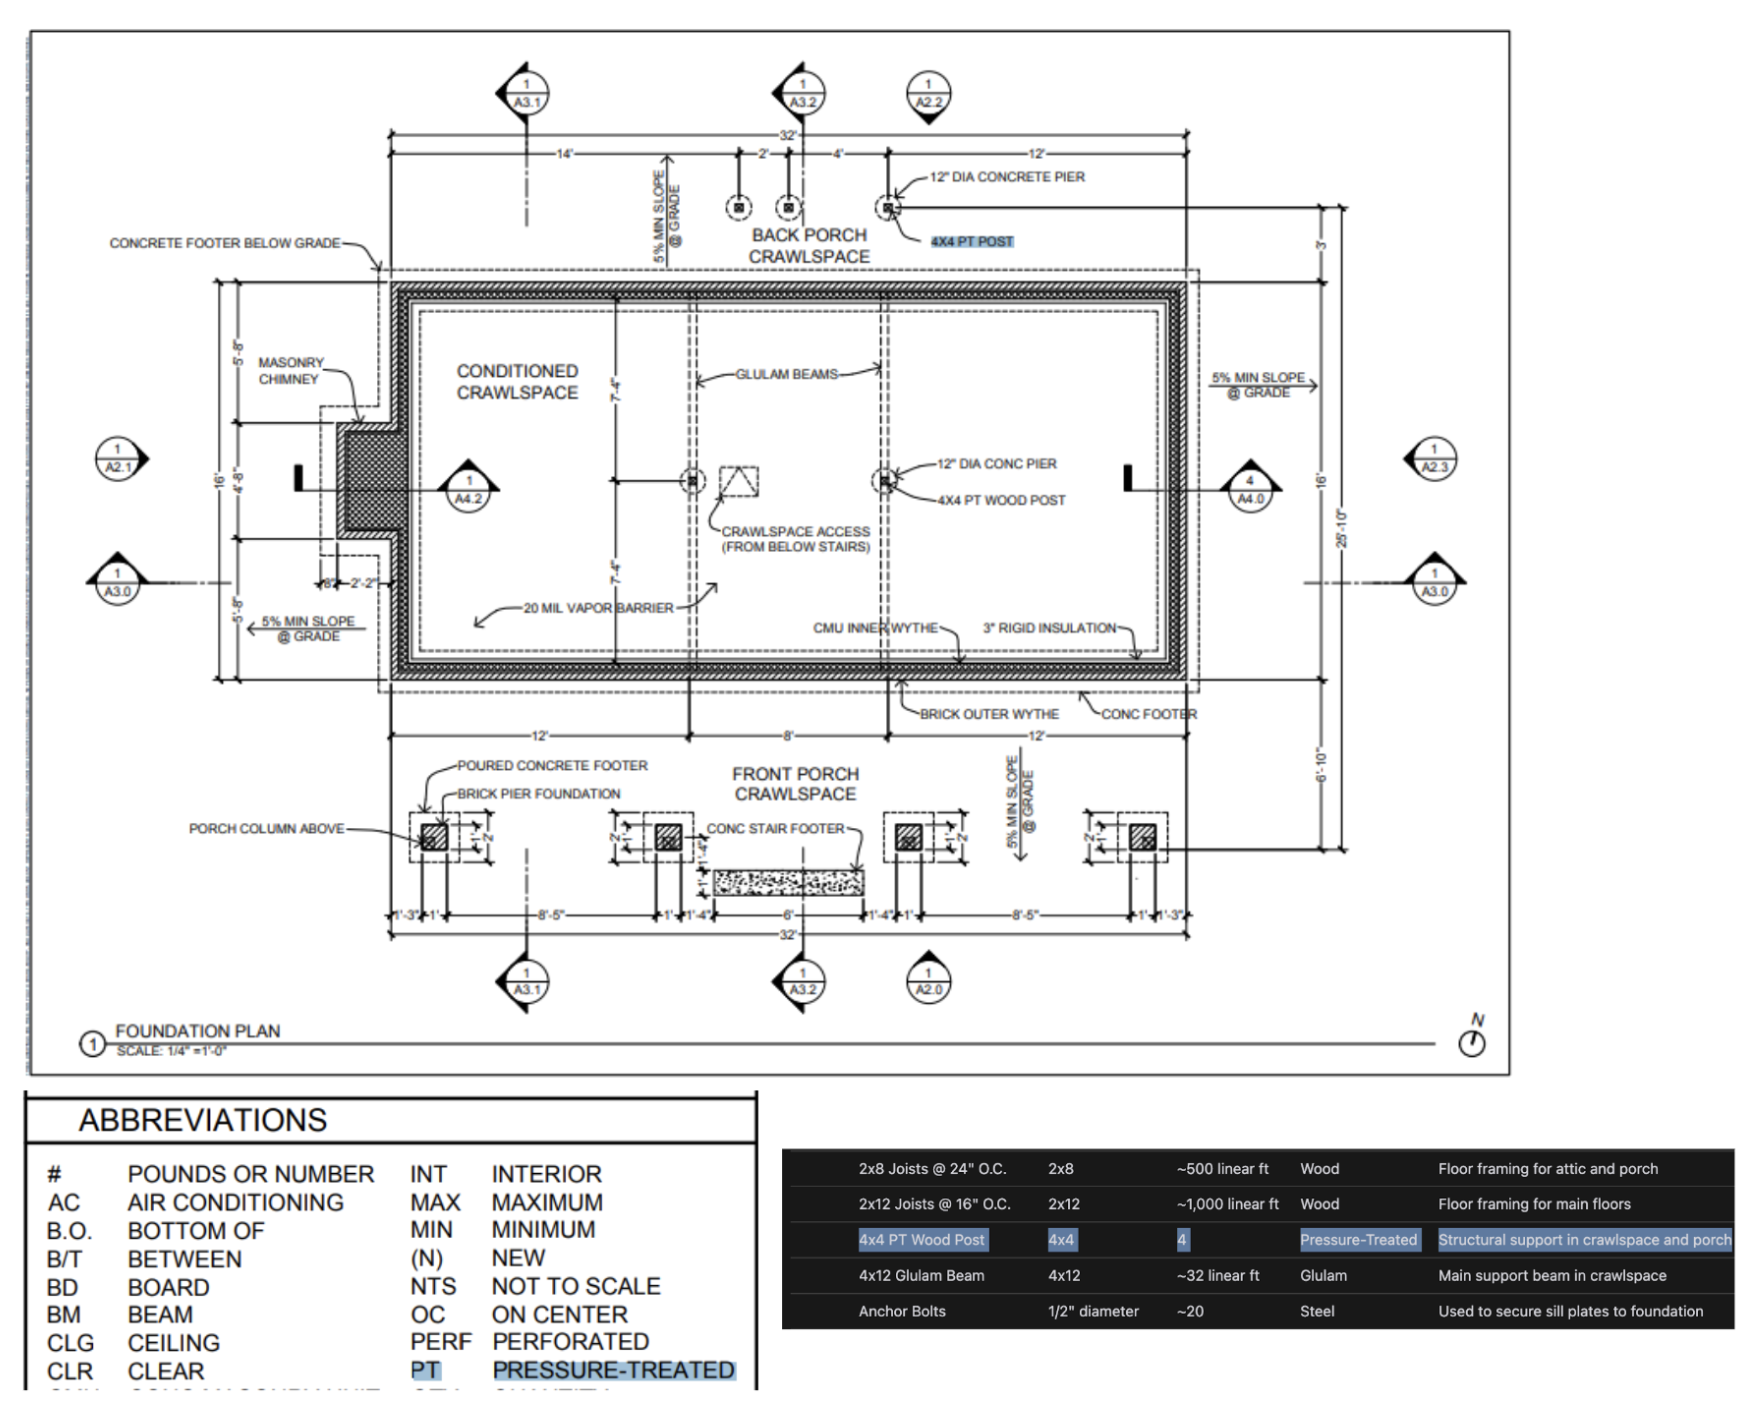
In unseren internen Tests konnte o1 Einbauten und Materialien in sehr detaillierten Bauzeichnungen erkennen und daraus eine umfassende Stückliste erstellen. Besonders überrascht hat uns, dass o1 Zusammenhänge zwischen verschiedenen Bildern erkennt. So konnte das Modell die Legende auf einem Blatt der Bauzeichnungen ohne ausdrückliche Anweisung auf einem anderen Blatt richtig anwenden. Im Beispiel unten erkannte o1 anhand der Legende, dass „PT“ bei den mit „4x4 PT“ bezeichneten Holzpfosten für „pressure treated“ (druckimprägniert) steht.
6. Code überprüfen, Fehler beheben und die Codequalität verbessern
Reasoning-Modelle eignen sich besonders gut dafür, große Mengen Code zu überprüfen und zu verbessern. Aufgrund der höheren Latenz laufen solche Prüfungen häufig im Hintergrund.
„Wir bieten auf Plattformen wie GitHub und GitLab automatisierte Code Reviews mit KI an. Bei der Codeprüfung kommt es in der Regel wenig auf die Latenz an. Entscheidend ist, die Codeänderungen über mehrere Dateien hinweg zu verstehen. Hier ist o1 besonders stark: Es erkennt zuverlässig kleine Änderungen an einer Codebasis, die bei einer manuellen Prüfung leicht übersehen werden können. Seit dem Wechsel zu Modellen der o-Serie konnten wir die Conversion-Raten unseres Produkts verdreifachen.“
CodeRabbit, Start-up für KI-gestützte Codeprüfung
Mit ihrer geringeren Latenz eignen sich GPT-4o und GPT-4o mini möglicherweise besser zum Schreiben von Code. Bei Anwendungsfällen, in denen die Latenz etwas weniger wichtig ist, haben wir aber auch mit o3-mini besonders gute Ergebnisse bei der Codegenerierung erzielt.
„o3-mini liefert durchweg hochwertigen Code, der das Problem schlüssig löst. Ist das Problem klar definiert, kommt o3-mini sehr häufig zur richtigen Lösung, selbst bei sehr anspruchsvollen Programmieraufgaben. Andere Modelle eignen sich mitunter nur für kleine, schnelle Überarbeitungsschritte. o3-mini ist besonders gut darin, komplexe Softwaresysteme zu entwerfen und umzusetzen.“
Windsurf, von Codeium entwickelte IDE für die Zusammenarbeit mit agentischer KI
7. Antworten anderer Modelle bewerten und vergleichen
Reasoning-Modelle haben sich bei uns auch für Benchmarks und die Bewertung von Antworten anderer Modelle bewährt. Daten zu validieren ist wichtig, um die Qualität und Zuverlässigkeit von Datensätzen sicherzustellen, insbesondere in sensiblen Bereichen wie dem Gesundheitswesen. Herkömmliche Validierungsverfahren arbeiten mit vordefinierten Regeln und Mustern. Fortschrittliche Modelle wie o1 und o3-mini können den Kontext erfassen und Schlussfolgerungen aus den Daten ziehen. So lässt sich die Validierung flexibler an den jeweiligen Fall anpassen.
„Viele Unternehmen setzen bei ihren Evaluierungen in Braintrust ein LLM zur Bewertung ein. Ein Unternehmen im Gesundheitswesen könnte zum Beispiel Fragen von Patientinnen und Patienten mit einem Modell wie gpt-4o zusammenfassen und die Qualität der Zusammenfassung anschließend mit o1 bewerten. Bei einem Unternehmen, das Braintrust nutzt, stieg der F1-Wert des Bewertungsmodells von 0,12 mit 4o auf 0,74 mit o1! Gerade bei den schwierigsten und komplexesten Bewertungen macht das Reasoning von o1 nach Erfahrung dieser Unternehmen einen entscheidenden Unterschied: Das Modell erkennt selbst feine Unterschiede zwischen Modellantworten.“
Braintrust, Plattform für KI-Evaluierungen
Wirksame Prompts für Reasoning-Modelle formulieren
Diese Modelle erzielen mit einfachen, direkten Prompts die besten Ergebnisse. Manche Techniken aus dem Prompt Engineering, etwa die Anweisung „Denke Schritt für Schritt“, bringen unter Umständen keinen Vorteil und können die Leistung sogar beeinträchtigen. Orientiere dich an den folgenden Empfehlungen oder steige mit Prompt-Beispielen ein.
- Entwicklernachrichten übernehmen die Rolle von Systemnachrichten: Ab
o1-2024-12-17unterstützen Reasoning-Modelle Entwicklernachrichten anstelle von Systemnachrichten. Damit folgen sie der in der Modellspezifikation beschriebenen Rangfolge von Anweisungen. - Formuliere Prompts einfach und direkt: Die Modelle verstehen kurze, klare Anweisungen besonders gut und können gezielt darauf antworten.
- Vermeide Prompts, die eine Gedankenkette verlangen: Diese Modelle führen das Reasoning intern durch. Anweisungen wie „Denke Schritt für Schritt“ oder „Erkläre deinen Gedankengang“ sind deshalb überflüssig.
- Grenze Abschnitte klar voneinander ab: Nutze Markdown, XML-Tags oder Abschnittsüberschriften, um die einzelnen Teile der Eingabe kenntlich zu machen. So kann das Modell jeden Abschnitt richtig einordnen.
- Beginne mit einem Zero-Shot-Prompt und nutze bei Bedarf einen Few-Shot-Prompt: Reasoning-Modelle liefern oft auch ohne Few-Shot-Beispiele gute Ergebnisse. Probiere deshalb zuerst einen Prompt ohne Beispiele aus. Hast du komplexere Anforderungen an das Ergebnis, können einige Beispiele für Eingaben und die jeweils gewünschte Ausgabe im Prompt helfen. Achte darauf, dass die Beispiele genau zu deinen Anweisungen passen. Abweichungen können zu schlechten Ergebnissen führen.
- Gib konkrete Vorgaben: Wenn die Antwort bestimmte Bedingungen erfüllen soll, nenne sie ausdrücklich im Prompt, etwa „Schlage eine Lösung mit einem Budget von weniger als 500 USD vor“.
- Beschreibe dein Ziel möglichst genau: Gib in deinen Anweisungen konkrete Kriterien für eine erfolgreiche Antwort an. Fordere das Modell auf, die Aufgabe weiter zu durchdenken und die Lösung zu überarbeiten, bis sie deine Kriterien erfüllt.
- Markdown-Formatierung: Ab
o1-2024-12-17vermeiden Reasoning-Modelle in der API standardmäßig Antworten mit Markdown-Formatierung. Wenn du Markdown in der Antwort wünschst, füge die ZeichenfolgeFormatting re-enabledin die erste Zeile deiner Entwicklernachricht ein.
Kosten niedrig und Genauigkeit hoch halten
Seit der Einführung von o3 und o4-mini behandelt die Responses API gespeicherte Reasoning-Elemente anders. Bisher (bei o1, o3-mini, o1-mini und o1-preview) blieben Reasoning-Elemente bei nachfolgenden API-Anfragen immer unberücksichtigt, selbst wenn sie in den Eingabeelementen der Anfrage enthalten waren. Bei o3 und o4-mini fließen einige Reasoning-Elemente, die unmittelbar vor oder nach Funktionsaufrufen stehen, in den Modellkontext ein. So kann das Modell mit möglichst wenigen Reasoning-Token bessere Ergebnisse erzielen.
Um diese Änderung optimal zu nutzen, empfehlen wir die Responses API. Setze den Parameter store auf true und übergib alle Reasoning-Elemente aus vorherigen Anfragen. Verwende dazu entweder previous_response_id oder übergib alle Ausgabeelemente einer früheren Anfrage als Eingabeelemente der neuen Anfrage. OpenAI nimmt relevante Reasoning-Elemente automatisch in den Modellkontext auf und lässt irrelevante Elemente weg. Wenn du bei anspruchsvolleren Anwendungsfällen genauer steuern möchtest, was in den Modellkontext gelangt, empfehlen wir, mindestens alle Reasoning-Elemente zwischen dem letzten Funktionsaufruf und der davor stehenden Nutzernachricht zu übergeben. So kann das Modell sein Reasoning fortsetzen, sobald du auf den Funktionsaufruf antwortest. Dadurch funktionieren Funktionsaufrufe besser und der Token-Verbrauch sinkt insgesamt.
Wenn du die Chat Completions API verwendest, gelangen Reasoning-Elemente nie in den Modellkontext, da diese API zustandslos ist. Bei komplexen Aufgaben, für die Agenten viele Funktionsaufrufe benötigen, fällt die Modellleistung deshalb etwas geringer aus und das Modell verbraucht mehr Reasoning-Token. Wenn keine komplexen Abfolgen von Funktionsaufrufen nötig sind, sollte die Leistung unabhängig von der verwendeten API gleich bleiben.
Weitere Ressourcen
Weitere Anregungen findest du im OpenAI Cookbook mit Beispielcode und Links zu Ressourcen von Drittanbietern. Mehr über unsere Modelle und ihre Reasoning-Fähigkeiten erfährst du hier: