
Die Decisions API ist jetzt allgemein verfügbar. Hier erfährst du, was seit der öffentlichen Beta neu ist.
Die Decisions API wertet Texte, Bilder und JSON-Daten aus und liefert typisierte Antworten etwa zehnmal so schnell wie die Responses API. Du erhältst die Wahrscheinlichkeit, mit der eine Bedingung zutrifft, eine Auswahl aus vorgegebenen Optionen oder einen Wert auf einer Bewertungsskala. Mit diesen Antworten kann deine Anwendung Inhalte klassifizieren, Anfragen weiterleiten und Aufgaben priorisieren.
Probiere die Decisions API im Playground aus, um Fragen und Eingaben zu testen, bevor du Code schreibst.
Sende Anfragen an POST /v1/decisions und verwende gpt-6-luna, das derzeit einzige unterstützte Modell.
Neuerungen
Seit dem Start der öffentlichen Beta bietet die Decisions API folgende zusätzliche Funktionen:
- Prompt-Caching. Verwende gemeinsame Eingaben für mehrere Anfragen und profitiere von günstigeren Preisen für das Lesen aus dem Cache.
- Bilder in Frageanweisungen. Gib für jede Frage eigene Bilder an, um sie mit denselben Referenzdaten zu vergleichen.
- JSON-Eingaben. Übergib strukturierte Daten direkt in einem Inhaltselement vom Typ
input_json. - Mehr Fragen pro Anfrage. Stelle bis zu 400 Fragen pro Anfrage. In der öffentlichen Beta lag die Grenze bei 200.
- Gehostete Bilder als Eingabe. Übergib neben eingebetteten Base64-Daten-URLs auch öffentlich zugängliche HTTP- oder HTTPS-URLs für Bilder.
- Gesprächsverlauf. Werte Nachrichten zusammen mit Funktionsaufrufen, Aufrufen benutzerdefinierter Tools und deren Ausgaben aus.
- Nutzungsberichte für Organisationen. Verfolge den Token-Verbrauch und die Anzahl der Anfragen.
- Native Integration mit GPT-Live. Lass Live die Decisions API direkt aufrufen oder löse Entscheidungen aus, sobald Transkripte der Ein- oder Ausgabe vorliegen.
- Private Link. Sende Anfragen an die Decisions API über eine private Verbindung.
So funktioniert die Decisions API
Eine Anfrage besteht aus drei Teilen:
| Feld | Zweck |
|---|---|
model |
Das Modell, das die Anfrage auswertet. Derzeit wird nur gpt-6-luna unterstützt. |
input |
Gemeinsame Datengrundlage für die Fragen: eine Zeichenfolge oder ein geordnetes Array aus Nachrichten, Tool-Aufrufen und Tool-Ausgaben. |
questions |
Legt fest, was ausgewertet wird. Enthält für jede Frage den Typ, die Anweisungen und gegebenenfalls die zulässigen Optionen oder Bewertungsstufen. |
Die Antwort enthält ein answers-Array. Gib jeder Frage mit name einen eindeutigen Namen, damit du ihr die Antwort zuordnen kannst. Die API gibt diesen Namen in der Antwort zurück.
Fragetyp auswählen
| Typ | Einsatzzweck | Hauptergebnis |
|---|---|---|
predicate |
Prüfen, ob eine Bedingung zutrifft, etwa ob ein Schaden sichtbar oder eine Textpassage relevant ist. | probability: geschätzte Wahrscheinlichkeit zwischen 0 und 1, mit der die Bedingung zutrifft. |
choice |
Eine Option auswählen, etwa eine Abteilung oder eine Inhaltskategorie. | choice: einer der vorgegebenen Werte. |
score |
Eine Eingabe anhand geordneter Stufen bewerten, etwa nach dem Schweregrad eines Problems. | score: der mit den Wahrscheinlichkeiten gewichtete Mittelwert der Stufenindizes. |
Sowohl choice als auch score liefern Wahrscheinlichkeiten für einzelne Optionen. Verwende choice für Kategorien ohne Rangfolge, etwa für Abteilungen. Verwende score für geordnete Stufen, etwa für Schweregrade. Die API gewichtet die numerischen Indizes der Stufen mit ihren Wahrscheinlichkeiten und bildet daraus einen Mittelwert, der zwischen zwei Stufen liegen kann.
Verwende die Decisions API, wenn deine Anwendung einen dieser Antworttypen benötigt. Nutze strukturierte Ausgaben mit der Responses API, um ein Objekt nach deinem eigenen JSON-Schema zu erzeugen, etwa mit extrahierten Feldern oder einer schriftlichen Erklärung. Nutze den Funktionsaufruf, wenn ein Modell einen Tool-Aufruf mit Argumenten anfordern soll.
Einen Gesprächsverlauf auswerten
Übergib den Gesprächsverlauf in input, um eine Anfrage im Kontext auszuwerten. Gib die Nachrichten sowie alle Funktionsaufrufe, Aufrufe benutzerdefinierter Tools und deren Ausgaben in der ursprünglichen Reihenfolge an. Ordne jede Tool-Ausgabe über call_id ihrem Aufruf zu.
Welche Inhalte unterstützt werden, hängt von der Nachrichtenrolle oder vom Elementtyp ab:
| Eingabeelement | Unterstützte Inhalte |
|---|---|
| Nutzernachricht | Text, Bilder und JSON |
| Entwickler- oder Systemnachricht | Nur Eingabetext. Die API behandelt Systemnachrichten wie Entwicklernachrichten. |
| Assistentennachricht | Ausgabetext oder Ablehnungen |
| Ausgabe einer Funktion oder eines benutzerdefinierten Tools | Text und Bilder, die dem zugehörigen Tool-Aufruf zugeordnet sind |
Tool-Aufrufe und ihre Ausgaben dienen als Datengrundlage für deine Fragen. Die Decisions API liefert typisierte Antworten. Deine Anwendung führt die damit ausgewählten Aktionen aus. Dateien, Audiodaten und Verweise auf einzelne Elemente werden nicht unterstützt. Die zulässigen Eingabefelder findest du in der API-Referenz zum Erstellen einer Entscheidung.
JSON-Daten auswerten
Mit einem Inhaltselement vom Typ input_json kannst du strukturierte Daten übergeben, ohne sie zuvor in eine Zeichenfolge umzuwandeln. Füge das JSON-Objekt oder -Array in data ein und übergib es zusammen mit etwaigen Text- oder Bildelementen in einer Nutzernachricht. Innerhalb einer Nachricht wird input_json nur für die Rolle user unterstützt.
Sende beispielsweise diesen JSON-Anfragekörper an POST /v1/decisions, um ein Supportticket anhand der Bestelldaten zu prüfen:
{
"model": "gpt-6-luna",
"input": [
{
"role": "user",
"content": [
{
"type": "input_text",
"text": "Evaluate the ticket using the order evidence."
},
{
"type": "input_json",
"data": {
"ticket": { "body": "Please refund the duplicate charge." },
"order": { "charges": [49, 49] }
}
}
]
}
],
"questions": [
{
"type": "predicate",
"name": "duplicate_charge",
"instructions": "Does the ticket describe a duplicate charge supported by the order?"
}
]
}JSON-Schlüssel wie role oder image_url sind innerhalb von data gewöhnliche Daten. Sie erzeugen keine Nachrichten und lösen keinen Bildabruf aus. Für die Antwort gilt weiterhin der gewählte Fragetyp. Eine JSON-Eingabe ändert das Antwortformat nicht.
Ein Bild auf sichtbare Schäden prüfen
Prüfe mit einer Frage vom Typ predicate, ob auf einem Produktfoto Schäden zu sehen sind. Diese Anfrage kombiniert das Bild mit der Anweisung, auf Sprünge, Risse oder Dellen zu achten.
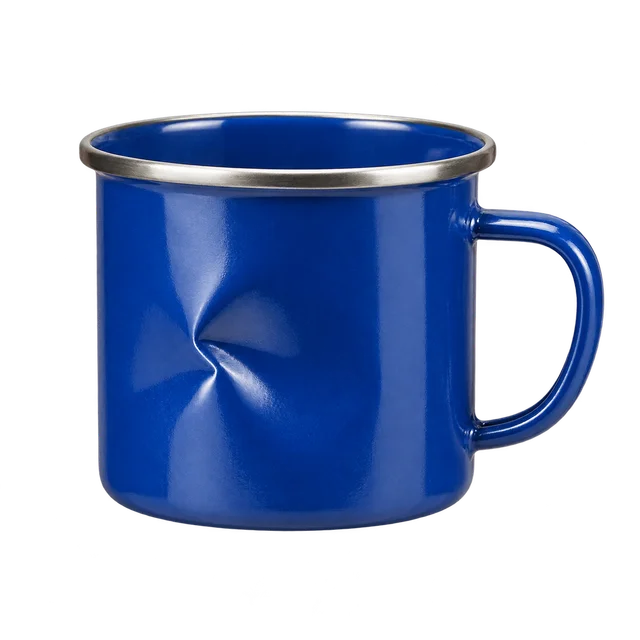
IMAGE_BASE64="$(base64 < product.png | tr -d '\r\n')"
curl https://api.openai.com/v1/decisions \
-H "Authorization: Bearer $OPENAI_API_KEY" \
-H "Content-Type: application/json" \
--data-binary @- <<JSON
{
"model": "gpt-6-luna",
"input": [{
"role": "user",
"content": [
{"type": "input_text", "text": "Inspect the product in this photo."},
{"type": "input_image", "image_url": "data:image/png;base64,$IMAGE_BASE64"}
]
}],
"questions": [{
"type": "predicate",
"name": "visible_damage",
"instructions": "Does the product have visible damage, such as a crack, tear, or dent? Ignore shadows and damage to the packaging."
}]
}
JSONAuszug aus einer Beispielantwort:
{
"answers": [
{
"type": "predicate",
"name": "visible_damage",
"probability": 0.92
}
]
}Der Wert probability gibt an, für wie wahrscheinlich das Modell es hält, dass die Bedingung zutrifft. Lege einen Schwellenwert fest, ab dem deine Anwendung Fotos zur Prüfung markiert.
Übergib Bilder als eingebettete Base64-Daten-URLs oder als öffentlich zugängliche HTTP- oder HTTPS-URLs. Dieser Endpunkt unterstützt keine Eingaben über file_id. Kombiniere input_text und input_image in einer Nutzernachricht, um Bilder zusammen mit Anweisungen oder weiteren Kontextinformationen auszuwerten.
Bilder in Frageanweisungen einbinden
Gib die gemeinsame Datengrundlage aller Fragen in input an. Soll jede Frage ein eigenes Bild erhalten, setze ihr Feld instructions auf ein nicht leeres Array aus Inhaltselementen vom Typ input_text und input_image. Das funktioniert bei Bedingungs-, Auswahl- und Bewertungsfragen. Reine Textanweisungen kannst du weiterhin als Zeichenfolge übergeben.
Sende beispielsweise diesen JSON-Anfragekörper an POST /v1/decisions, um ein Bild mit einem gemeinsamen Referenzbild zu vergleichen. Ersetze die beiden Beispiel-URLs durch URLs öffentlich zugänglicher Bilder oder verwende Base64-Daten-URLs für die Bilder:
{
"model": "gpt-6-luna",
"input": [
{
"role": "user",
"content": [
{
"type": "input_text",
"text": "The shared image is reference image A."
},
{
"type": "input_image",
"image_url": "https://example.com/reference.jpg"
}
]
}
],
"questions": [
{
"type": "predicate",
"name": "candidate_matches_reference",
"instructions": [
{
"type": "input_text",
"text": "Is candidate image B a derivative or variant of reference image A, including recompression or resizing?"
},
{
"type": "input_image",
"image_url": "https://example.com/candidate.jpg"
}
]
}
]
}Beachte beim Einbinden von Bildern in Frageanweisungen Folgendes:
- Füge für jedes weitere Vergleichsbild eine eigene Frage hinzu. Jede Frage vergleicht ihr Bild mit demselben Referenzbild.
- Gib die Inhaltselemente direkt in
instructionsan, ohne umschließendes Nachrichtenobjekt und ohnerole. - Für das Bildlimit einer Anfrage zählen die Bilder in den Frageanweisungen und in
inputzusammen.
Aus vorgegebenen Optionen auswählen
Eine Frage vom Typ choice wählt einen der von dir vorgegebenen Werte aus. Verwende unterschiedliche Werte und beschreibe für jede Option, wann sie zutrifft.
Das Modell erhält für jede Option den Wert aus value und, falls angegeben, die Beschreibung aus description. Beide Felder sind Teil des Prompts. Wenn du value änderst, kann sich das Ergebnis ändern, auch wenn die Beschreibung gleich bleibt.
Wenn du für value eine Zeichenfolge verwendest, wähle aussagekräftige Bezeichnungen wie "billing" und "technical" statt einer Kennung wie einer UUID, deren Bedeutung sich nicht aus der Kennung selbst erschließt.
Beschreibe die Optionen kurz und direkt, wie in den folgenden Beispielen.
Diese Anfrage ermittelt, an welche Abteilung eine Kundenbeschwerde gehen soll:
curl https://api.openai.com/v1/decisions \
-H "Authorization: Bearer $OPENAI_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"model": "gpt-6-luna",
"input": "I was charged twice for my order.",
"questions": [{
"type": "choice",
"name": "department",
"instructions": "Which department should handle this complaint?",
"choices": [
{"value": "billing", "description": "Payments, invoices, and refunds."},
{"value": "technical", "description": "Problems using the product."},
{"value": "shipping", "description": "Delivery and tracking."},
{"value": "other", "description": "Requests outside these categories."}
]
}]
}'Auszug aus einer Beispielantwort:
{
"answers": [
{
"type": "choice",
"name": "department",
"choice": "billing",
"probabilities": [
{ "value": "billing", "probability": 0.95 },
{ "value": "technical", "probability": 0.02 },
{ "value": "shipping", "probability": 0.01 },
{ "value": "other", "probability": 0.02 }
],
"confidence": 0.93
}
]
}Das Feld choice enthält einen der vorgegebenen Werte, hier "billing". Die Antwort enthält außerdem ein probabilities-Array für die Optionen und ein Feld namens confidence. Hinweise zum Festlegen von Schwellenwerten findest du im Abschnitt Antworten interpretieren.
Gib eine Auffangoption wie "other" an, wenn deine Kategorien nicht alle möglichen Eingaben abdecken. Deine Anwendung kann solche Fälle in eine allgemeine Warteschlange zur Prüfung einreihen.
Eingaben anhand eines Rasters bewerten
Eine Frage vom Typ score bewertet eine Eingabe anhand von zwei bis zehn geordneten Stufen (levels). Lege die Kriterien für jede Stufe fest und ordne die Stufen von der niedrigsten bis zur höchsten.
curl https://api.openai.com/v1/decisions \
-H "Authorization: Bearer $OPENAI_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"model": "gpt-6-luna",
"input": "Export fails in Safari but works in Chrome.",
"questions": [{
"type": "score",
"name": "severity",
"instructions": "How severe is this issue?",
"levels": [
{"label": "Cosmetic", "description": "Appearance only; no lost functionality."},
{"label": "Workaround available", "description": "A task fails, but another way works."},
{"label": "Fully blocked", "description": "A task fails with no workaround."}
]
}]
}'Auszug aus einer Beispielantwort:
{
"answers": [
{
"type": "score",
"name": "severity",
"score": 1.1,
"probabilities": [
{ "value": 0, "label": "Cosmetic", "probability": 0.1 },
{ "value": 1, "label": "Workaround available", "probability": 0.7 },
{ "value": 2, "label": "Fully blocked", "probability": 0.2 }
],
"confidence": 0.55
}
]
}Die Stufenindizes beginnen bei 0. Hier steht 0 für ein rein kosmetisches Problem. Bei 1 lässt sich das Problem umgehen, bei 2 ist kein Weiterarbeiten möglich. Der zurückgegebene score ist ein mit den Wahrscheinlichkeiten gewichteter Mittelwert und kann daher zwischen zwei Stufen liegen. In diesem Beispiel ergeben die Wahrscheinlichkeiten 0,1, 0,7 und 0,2 einen Wert von 1,1.
Die Antwort enthält außerdem confidence sowie unter probabilities die Wahrscheinlichkeiten der einzelnen Stufen. Der Bewertungswert fasst die Verteilung über alle Stufen zusammen. Verwende choice, um eine einzelne Kategorie auszuwählen.
Mehrere Fragen stellen
Eine Anfrage kann 1 bis 400 Fragen enthalten. Fasse voneinander unabhängige Fragen im selben questions-Array zusammen, um eine gemeinsame Eingabe auszuwerten. Bei einem Produktfoto kannst du mit einer Anfrage prüfen, ob das Produkt beschädigt ist, und seine Kategorie bestimmen. Die Fragen können unterschiedliche Typen haben.
Wenn eine Entscheidung von einer vorherigen Antwort abhängt, sende separate Anfragen. Prüfe beispielsweise zuerst, ob ein Schaden vorliegt. Entscheide dann anhand des Ergebnisses, ob du die Reparaturkategorie abfragen möchtest.
Formuliere Fragen anhand beobachtbarer Kriterien. Stelle für unterschiedliche Aspekte jeweils eine eigene Frage, grenze Auswahloptionen inhaltlich voneinander ab und definiere für benachbarte Bewertungsstufen klar unterscheidbare Kriterien.
Antworten interpretieren
Bei Bedingungsfragen erhältst du die geschätzte Wahrscheinlichkeit, mit der eine Bedingung zutrifft. Antworten auf Auswahl- und Bewertungsfragen enthalten eine Wahrscheinlichkeitsverteilung und ein separates Feld namens confidence.
Lege anhand bereits gekennzeichneter Beispiele aus deiner Anwendung Schwellenwerte für die Weiterleitung, Filterung oder Prüfung fest. Berücksichtige dabei die Kosten falsch positiver und falsch negativer Ergebnisse.
Gemeinsame Eingaben mit Prompt-Caching wiederverwenden
Mit Prompt-Caching können wiederholte Anfragen ein identisches Präfix der gemeinsamen Eingabe in input wiederverwenden. Für das Lesen aus dem Cache gilt ein reduzierter Preis. Du kannst beispielsweise ein Referenzdokument oder -bild in input beibehalten und die Fragen bei jeder Anfrage ändern. Der Inhalt von questions liegt außerhalb des wiederverwendbaren Präfixes. Das gilt auch für Bilder, die zu einer einzelnen Frage gehören.
Standardmäßig setzt die Decisions API am Ende der gemeinsamen Eingabe in input implizit eine Cache-Grenze. Bestehende Anfragen können den Cache nutzen, ohne dass du den Anfragekörper ändern musst. Das wiederverwendbare Präfix muss mindestens 1.024 Token enthalten. Der Inhalt der Fragen zählt dabei nicht mit. Damit sich das Präfix wiederverwenden lässt, muss es in allen betreffenden Anfragen identisch sein.
Mit prompt_cache_key kannst du die Wiederverwendung des Caches auf Anfragen mit demselben Schlüssel beschränken. Den Schlüssel gibst du beim Aufruf an. Um die Grenze selbst festzulegen, füge prompt_cache_breakpoint: {"mode": "explicit"} zu Text- oder Bildelementen in der gemeinsamen Eingabe input hinzu. Setze prompt_cache_options.mode auf "explicit", um nur ausdrücklich markierte Grenzen zu verwenden. Im expliziten Modus nutzt eine Anfrage ohne markierte Grenzen kein Prompt-Caching. In Frageanweisungen kannst du keine Cache-Grenzen setzen.
Die Anzahl der aus dem Cache gelesenen Token findest du in usage.input_tokens_details.cached_tokens, die Anzahl der in den Cache geschriebenen Token in usage.input_tokens_details.cache_write_tokens. Beide Werte sind bereits in usage.input_tokens enthalten. Addiere sie nicht noch einmal zum Gesamtwert. Der Leitfaden zum Prompt-Caching erklärt die Grundlagen. Die unterstützten Anfrageparameter findest du in der Referenz zur Decisions API.
Nutzung überwachen
Rufe mit GET /v1/organization/usage/decisions den Token-Verbrauch und die Anzahl der Anfragen deiner Organisation an die Decisions API ab. Authentifiziere dich mit einem Admin-API-Schlüssel und der Berechtigung api.usage.read.
Lege den Zeitraum und die Länge der einzelnen Zeitintervalle fest. Anschließend kannst du die Ergebnisse nach Projekt, API-Schlüssel oder Modell filtern oder gruppieren. Das Feld num_model_requests zählt Anfragen. Eine Anfrage mit mehreren Fragen zählt einmal. Informationen zu Filtern und zur Paginierung findest du in der Referenz zu den Nutzungsdaten der Decisions API.
Preise und Verfügbarkeit
Bei gpt-6-luna kosten Eingaben ohne Cache 0,10 USD pro Million Token. Bei Cache-Treffern gilt ein reduzierter Eingabepreis. Schreibzugriffe auf den Cache sind kostenpflichtig. Für Lese- und Schreibzugriffe gelten die Standardpreise für Prompt-Caching mit gpt-6-luna. Für Ausgabetoken fallen keine Kosten an.
Es gelten Zuschläge für die regionale Verarbeitung sowie Preismultiplikatoren für Eingaben mit langem Kontext. Diese Preise gelten für /v1/decisions. Für andere Anfragen mit gpt-6-luna gelten die jeweiligen Preise für das Modell und die Verarbeitungsstufe.
Wenn du die Voraussetzungen erfüllst, kannst du die Decisions API mit der Option „Keine Datenaufbewahrung“ (ZDR) sowie gemäß HIPAA nutzen. Datenresidenz ist in allen unterstützten API-Regionen verfügbar. Regionale Verarbeitung wird in den USA und in Europa (EWR und Schweiz) unterstützt. Informationen zu den Voraussetzungen, erforderlichen Vereinbarungen und Einschränkungen findest du in der Dokumentation zur Datenkontrolle.
Sprachsteuerung hinzufügen
Verbinde die Sprachverarbeitung mit der Decisions API, um anhand einer gesprochenen Anfrage eine Aktion auszuwählen oder schon während des Sprechens auf Äußerungen einer Person oder von GPT-Live zu reagieren.