
Eine Sandbox stellt einem Agenten eine isolierte, Unix-ähnliche Ausführungsumgebung bereit. Dazu gehören ein Dateisystem, eine Shell, installierte Pakete, eingebundene Daten, freigegebene Ports, Snapshots und kontrollierter Zugriff auf externe Systeme.
Agenten-Workflows werden fehleranfällig, wenn das Modell einen solchen Arbeitsbereich braucht, aber nur den Kontext aus dem Prompt erhält. Um umfangreiche Dokumentbestände zu bearbeiten, Artefakte zu erzeugen, Befehle auszuführen, Vorschauen bereitzustellen oder die Arbeit später fortzusetzen, braucht der Agent eine Umgebung, die er untersuchen und verändern kann.
Sandbox-Agenten sind in den Agents SDKs für TypeScript und Python verfügbar.
Dieser Leitfaden beschreibt Sandboxes im Agents SDK. Dabei führt deine Anwendung den Harness aus. Wenn OpenAI den Harness verwalten soll, folge der Anleitung Agents API: Eine Sandbox anbinden.
Verwende eine Sandbox, wenn der Agent Dateien bearbeiten, Befehle ausführen, einen Datenraum einbinden, Artefakte erstellen, einen Dienst zugänglich machen oder die Arbeit später mit dem bisherigen Zustand fortsetzen soll.
Entscheidend ist die Trennung zwischen Harness und Rechenumgebung. Der Harness bildet die Steuerungsebene um das Modell. Er verwaltet die Agentenschleife, Modellaufrufe, die Weiterleitung von Tool-Aufrufen, Übergaben, Genehmigungen, Tracing, Wiederherstellung und den Zustand des Laufs. Die Sandbox bildet die Ausführungsebene. Dort werden auf Anweisung des Modells Dateien gelesen und geschrieben, Befehle ausgeführt, Abhängigkeiten installiert, eingebundene Speicher genutzt, Ports freigegeben und Snapshots des Zustands erstellt.
Durch diese Trennung kann deine Anwendung sensible Steuerungsaufgaben in einer vertrauenswürdigen Infrastruktur ausführen. Die Sandbox übernimmt die anbieterspezifische Ausführung. Sie kann Dateien mit Code verarbeiten und dabei Zugangsdaten mit eng begrenzten Berechtigungen und gezielte Speichereinbindungen nutzen. Der Harness kann Authentifizierung, Abrechnung, Auditprotokolle, die Prüfung durch Menschen und den für die Wiederherstellung nötigen Zustand außerhalb einzelner Container verwalten.
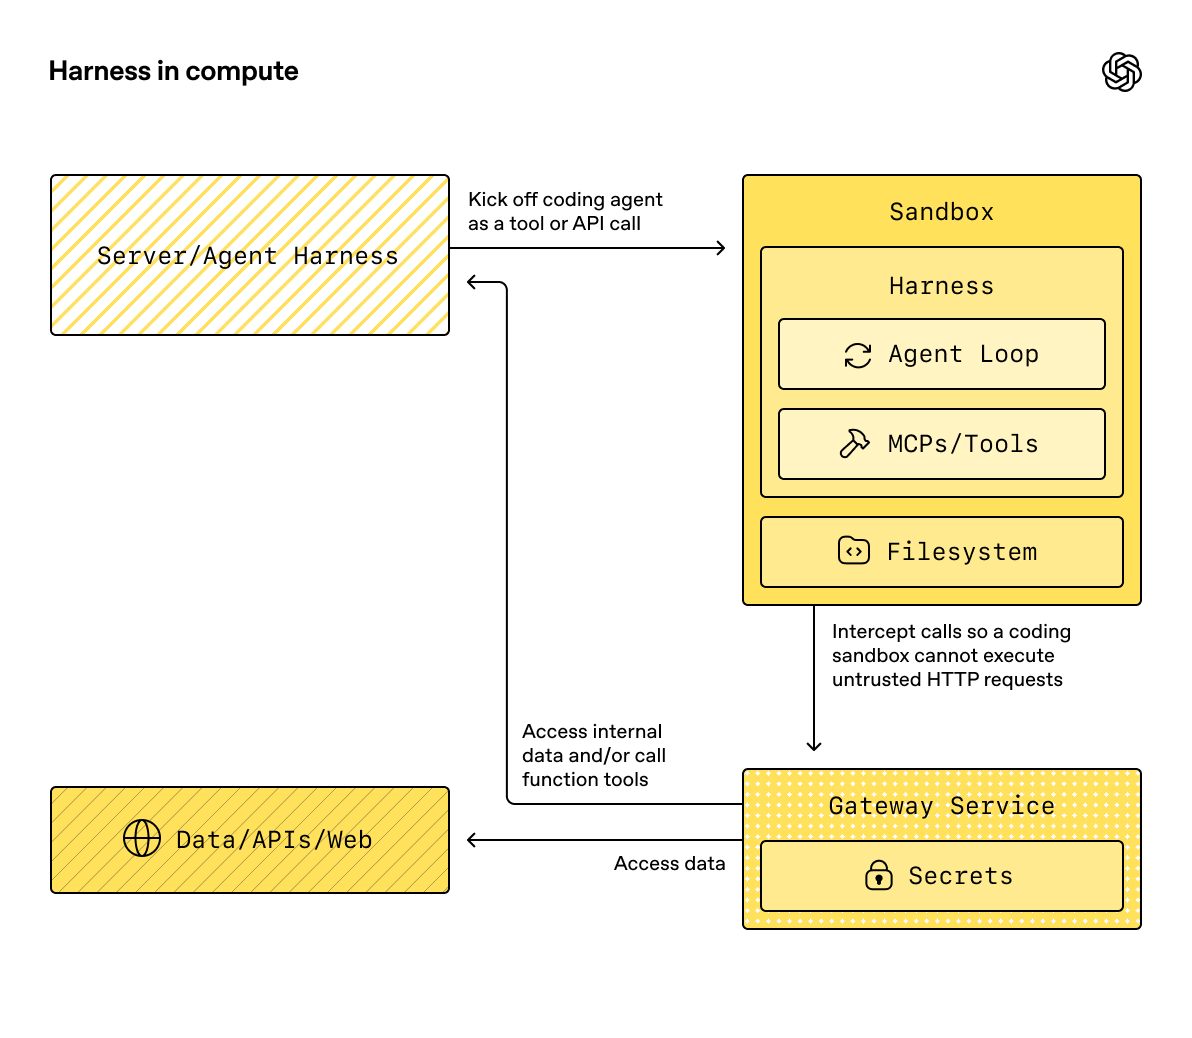
Für Prototypen kann es praktisch sein, den Harness in der Sandbox auszuführen. Orchestrierung und modellgesteuerte Ausführung teilen sich dann dieselbe Rechenumgebung.
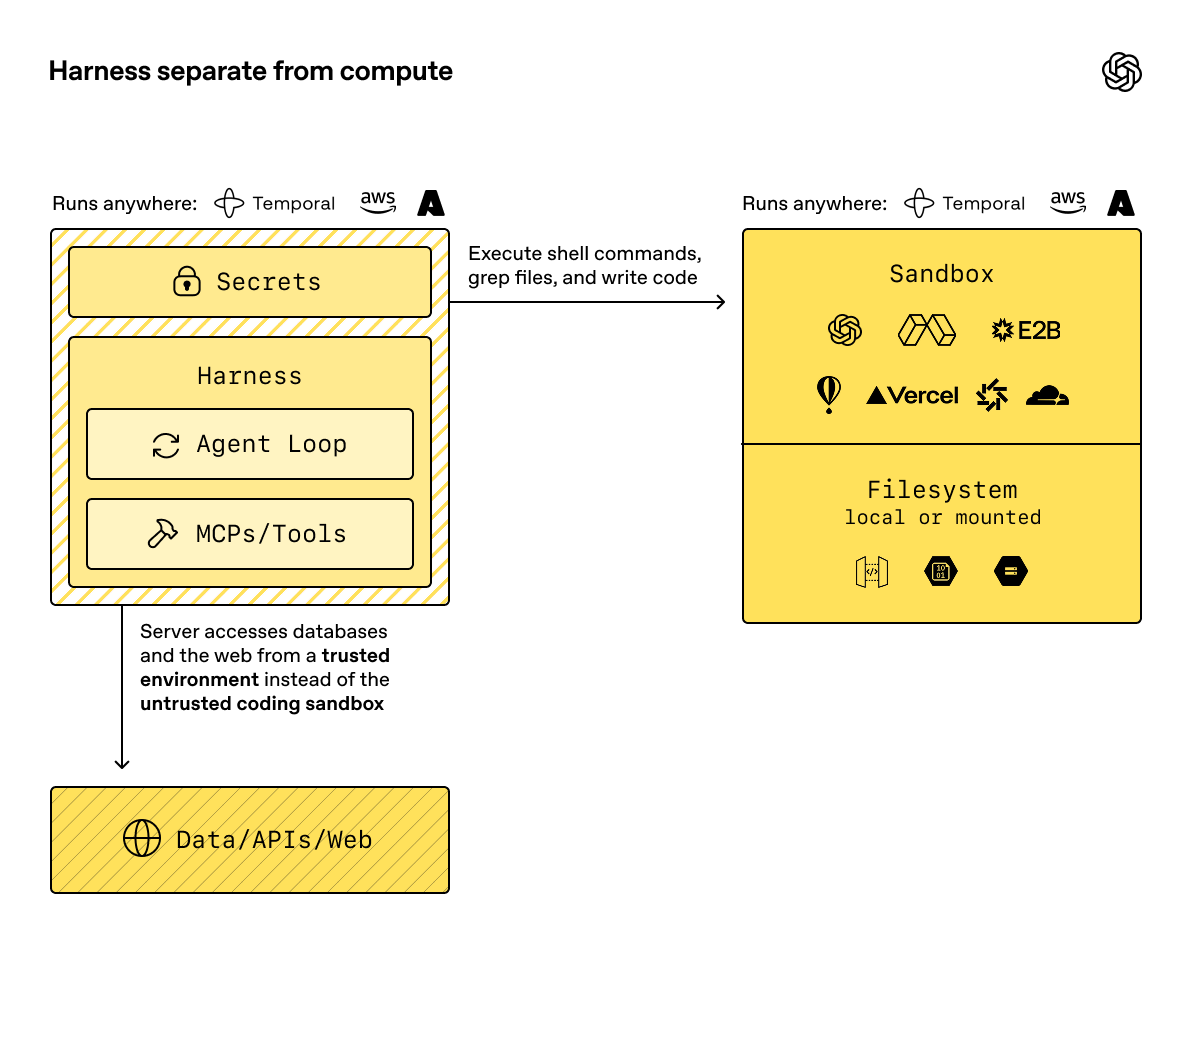
Der Harness kann in deiner Infrastruktur laufen, während die Sandbox die anbieterspezifische Ausführung übernimmt und den Zustand zwischen den Arbeitsschritten erhält.
Wann du eine Sandbox brauchst
Verwende eine Sandbox, wenn die Antwort des Agenten von Arbeitsschritten im Arbeitsbereich der Sandbox abhängt und Reasoning allein auf Grundlage des Prompt-Kontexts nicht ausreicht.
Typische Fälle sind:
- Für die Aufgabe wird ein ganzes Verzeichnis mit Dokumenten benötigt. Ein einzelner Prompt reicht nicht aus.
- Der Agent soll Dateien schreiben, die deine Anwendung später prüfen kann.
- Der Agent braucht Befehle, Pakete oder Skripte, um die Aufgabe abzuschließen.
- Der Workflow erzeugt Artefakte wie Markdown-, CSV- oder JSONL-Dateien, Screenshots oder Websites.
- Ein Dienst, ein Notebook oder eine Berichtsvorschau muss über einen freigegebenen Port erreichbar sein.
- Die Arbeit wird für eine Prüfung durch einen Menschen unterbrochen und anschließend im selben Arbeitsbereich fortgesetzt.
Wenn dein Workflow nur eine kurze Modellantwort braucht und ohne dauerhaften Arbeitsbereich auskommt, rufe die Responses API direkt auf oder verwende die Standardlaufzeit des Agents SDK ohne Sandbox.
Wenn der Agent nur gelegentlich Shell-Zugriff braucht, beginne mit dem Tool Hosted Shell aus dem Leitfaden Tools verwenden. Verwende Sandbox-Agenten, wenn dein Produkt einen isolierten Arbeitsbereich, die Wahl des Sandbox-Anbieters oder die Möglichkeit voraussetzt, die Arbeit mit dem bisherigen Dateisystemzustand fortzusetzen.
Was Sandboxes ergänzen
Ein SandboxAgent ist weiterhin ein Agent. Er bietet dieselbe Schnittstelle mit instructions, prompt, tools, handoffs, MCP-Servern, Modelleinstellungen, strukturierter Ausgabe, Schutzmechanismen und Hooks. Der Unterschied liegt in der Ausführungsumgebung. Der Runner bereitet den Agenten für eine laufende Sandbox-Sitzung vor. Diese stellt Dateien, Befehle und Ports bereit und sorgt für die anbieterspezifische Isolation.
| Bestandteil | Zuständigkeit | Frage für die Implementierung |
|---|---|---|
SandboxAgent |
Agentendefinition und Sandbox-Standardwerte | Was soll der Agent tun und welche Sandbox-Standardwerte bringt er mit? |
Manifest |
Vorgaben für den Arbeitsbereich einer neuen Sitzung | Welche Dateien, Verzeichnisse, Repositorys, Einbindungen, Umgebungseinstellungen, Konten und Gruppen sollen zu Beginn im Arbeitsbereich verfügbar sein? |
| Funktionen | Sandbox-spezifisches Verhalten des Agenten | Welche Sandbox-Tools, Anweisungen oder Laufzeitfunktionen braucht der Agent? |
| Sandbox-Client | Integration des Anbieters | Soll der Arbeitsbereich lokal mit Unix-local, in Docker oder bei einem Hosting-Anbieter laufen? |
| Sandbox-Sitzung | Aktive Ausführungsumgebung | Wo werden Befehle ausgeführt, Dateien geändert, Ports geöffnet und der anbieterspezifische Zustand verwaltet? |
| Sandbox-Konfiguration des Laufs | Quelle der Sandbox-Sitzung, Client-Optionen und Eingaben für eine neue Sitzung | Soll der Lauf eine übergebene Sandbox-Sitzung verwenden, eine Sitzung fortsetzen oder eine neue erstellen? |
| Gespeicherter Zustand | RunState, serialisierter Sitzungszustand und Snapshots |
Wie sollen spätere Läufe an die bisherige Arbeit anknüpfen oder einen neuen Arbeitsbereich mit gespeicherten Inhalten initialisieren? |
Sandbox-spezifische Standardwerte legst du am SandboxAgent fest. Welche Sandbox-Sitzung ein einzelner Lauf verwendet, bestimmst du in seiner Sandbox-Konfiguration.
Auch bei Sandbox-Agenten entspricht ein Turn einem Modellschritt. Einzelne Shell-Befehle oder Sandbox-Aktionen zählen nicht als eigene Turns. Manche Arbeitsschritte laufen vollständig auf der Ausführungsebene der Sandbox ab. Die Agentenlaufzeit verbraucht erst dann einen weiteren Turn, wenn sie nach der Arbeit in der Sandbox eine weitere Modellantwort benötigt.
Arbeitsbereich erstellen
Manifest beschreibt, welche Inhalte ein neuer Sandbox-Arbeitsbereich zu Beginn haben und wie er aufgebaut sein soll. Lege darin Dateien, Repositorys, Eingabeartefakte, Hilfsdateien, Einbindungen, Ausgabeverzeichnisse und Umgebungseinstellungen fest, die dem Agenten zur Verfügung stehen sollen.
Das Manifest legt den Ausgangszustand einer neuen Sitzung fest. Für einen konkreten Lauf kann sich der tatsächliche Arbeitsbereich auch aus einer wiederverwendeten laufenden Sandbox-Sitzung, einem serialisierten Sandbox-Sitzungszustand oder einem zur Laufzeit ausgewählten Snapshot ergeben.
Pfade in Manifest-Einträgen sind relativ zum Arbeitsbereich. Absolute Pfade sind unzulässig, ebenso Pfade, die mit .. aus dem Arbeitsbereich hinausführen. Dadurch gelten dieselben Vorgaben für lokale Clients, Docker-Clients und gehostete Clients.
| Eingabe im Manifest | Verwendungszweck |
|---|---|
File, Dir |
Kleine synthetische Eingaben, Hilfsdateien oder Ausgabeverzeichnisse. |
| Lokale Datei oder lokales Verzeichnis | Dateien oder Verzeichnisse vom Host, die in der Sandbox angelegt werden sollen. |
| Git-Repository | Ein Repository, das in den Arbeitsbereich geladen werden soll. |
S3Mount, GCSMount, R2Mount, AzureBlobMount, BoxMount, S3FilesMount |
Externer Speicher, der in der Sandbox verfügbar sein soll. |
environment |
Umgebungsvariablen, die die Sandbox beim Start braucht. |
users und groups |
Lokale Betriebssystemkonten und Gruppen in der Sandbox, sofern der Anbieter das Anlegen von Konten unterstützt. |
Beachte beim Erstellen des Manifests Folgendes:
- Trage Repositorys, Eingabeartefakte und Ausgabeverzeichnisse in das Manifest ein.
- Lege ausführliche Aufgabenbeschreibungen und Anweisungen für das jeweilige Repository in Dateien im Arbeitsbereich ab, etwa in
repo/task.mdoderAGENTS.md. - Verwende in Anweisungen Pfade relativ zum Arbeitsbereich, zum Beispiel
repo/task.mdoderoutput/report.md. - Beschränke den eingebundenen Speicher auf die Eingaben, die der Agent lesen oder schreiben soll.
- Behandle Speichereinbindungen als temporäre Einträge im Arbeitsbereich. Beim Erstellen von Snapshots und beim dauerhaften Speichern wird eingebundener Remote-Speicher übersprungen. Sein Inhalt wird nicht in den gespeicherten Arbeitsbereich kopiert.
Dateien und Speicher einbinden
Die benötigten Daten liegen oft bereits an anderer Stelle. Binde umfangreiche Dokumente in die Sandbox ein, damit der Agent direkt mit den Dateien arbeiten kann, statt ihren Inhalt in den Prompt-Kontext zu kopieren.
Beispiele:
- Binde einen Datenraum für eine Due-Diligence-Prüfung ein und lass den Agenten eine Zusammenfassung mit Quellenangaben erstellen.
- Binde einen Export von Supportfällen ein und lass den Agenten die Probleme gruppieren und in einem Bericht zusammenfassen.
- Binde erzeugte Artefakte ein, damit ein anderes System sie prüfen kann.
Jede Anbieterintegration bietet eigene Hilfsfunktionen für Speichereinbindungen. Auch der Umgang mit Zugangsdaten und die dauerhafte Speicherung hängen vom Anbieter ab. Binde bei jedem Anbieter nur die Eingaben ein, die der Agent verwenden soll. Teile ihm mit, wo er lesen und schreiben soll, und prüfe die erzeugten Artefakte, bevor du sie verwendest.
Geheimnisse und Zugangsdaten verwalten
Konfiguriere Sandbox-Zugangsdaten zur Laufzeit. Der Agent braucht gegebenenfalls Zugangsdaten für Paketmanager, Speichereinbindungen oder Anbieter-APIs. Diese Daten gehören weder in Prompts von Nutzenden noch in Agentenanweisungen, Aufgabendateien, eingecheckte Manifeste oder erzeugte Artefakte.
Beachte folgende Regeln:
- Nutze bei gehosteten Sandboxes vorzugsweise die Geheimnisverwaltung des Anbieters.
- Beschränke den Geltungsbereich von Zugangsdaten für Cloud-Speicher auf die Einbindung oder Anbieteroption, die sie benötigt.
- Verwende
Manifest.environmentfür Werte, die der Sandbox-Prozess beim Start braucht. Kennzeichne sensible oder generierte Einträge als temporär, wenn du sie neu erzeugen möchtest, statt sie dauerhaft zu speichern. - Vermeide es, Geheimnisse, generierte Konfigurationen für Speichereinbindungen, lokale Token oder Dateien zu speichern, die nach dem Lauf nicht erhalten bleiben sollen.
- Prüfe Artefakte, bevor du sie aus der Sandbox überträgst. Das gilt besonders, wenn der Agent private Dokumente oder eingebundene Speicher lesen kann.
Das SDK unterstützt Umgebungsvariablen im Manifest und anbieterspezifische Zugangsdaten für Speichereinbindungen. Wie sich ein Geheimnisspeicher anbinden lässt, hängt vom Anbieter ab. Die Laufzeitumgebung oder der Sandbox-Anbieter sollte die Zugangsdaten bereitstellen. Gib sie dem Modell nicht als Anweisungen mit.
Den Agenten mit Funktionen ausstatten
Mit Funktionen erweiterst du einen SandboxAgent um Sandbox-spezifisches Verhalten. Sie können den Arbeitsbereich vor dem Start eines Laufs vorbereiten, Sandbox-spezifische Anweisungen ergänzen, an die laufende Sandbox-Sitzung gebundene Tools bereitstellen und das Modellverhalten oder die Verarbeitung von Eingaben für diesen Agenten anpassen.
| Funktion | Wann du sie brauchst | Hinweise |
|---|---|---|
Shell |
Der Agent braucht Shell-Zugriff. | Ermöglicht die Ausführung von Befehlen und, sofern der Sandbox-Client dies unterstützt, interaktive Eingaben. |
Filesystem |
Der Agent soll Dateien bearbeiten oder lokale Bilder ansehen. | Stellt apply_patch und view_image bereit. Patch-Pfade sind relativ zum Stammverzeichnis des Arbeitsbereichs. |
Skills |
Der Agent soll Skills in der Sandbox finden und laden können. | Nutze diese Funktion vorzugsweise, statt .agents oder .agents/skills manuell einzubinden. |
Memory |
Spätere Läufe sollen Dateien mit Erinnerungen lesen oder erzeugen. | Erfordert Shell. Aktualisierungen von Erinnerungen während des Laufs erfordern zusätzlich Filesystem. |
Compaction |
Bei langen Workflows muss der Kontext gekürzt werden. | Passt Modellverhalten und Eingabeverarbeitung nach Einträgen zur Kontextverdichtung an. |
Standardmäßig verfügt ein SandboxAgent über Funktionen für Dateisystemzugriff, Shell-Zugriff und Kontextverdichtung. Wenn du eine Liste für capabilities übergibst, ersetzt sie die Standardliste. Nimm also alle Standardfunktionen auf, die der Agent weiterhin braucht.
Verwende nach Möglichkeit die integrierten Funktionen. Schreibe nur dann eine eigene Funktion, wenn du ein Sandbox-spezifisches Tool brauchst oder dem Agenten Anweisungen geben musst, die sich mit den integrierten Funktionen nicht abdecken lassen.
Skills laden
Für manche Aufgaben müssen wiederverwendbare Anweisungen, Skripte, Referenzen oder Ressourcen schon vor dem Start des Agenten bereitstehen. Mit der Funktion Skills kann der Agent diese Arbeitsgrundlagen während des Laufs finden.
import {
Capabilities,
SandboxAgent,
gitRepo,
skills,
} from "@openai/agents/sandbox";
const agent = new SandboxAgent({
name: "Tax prep assistant",
instructions: "Use the mounted skill before preparing the return.",
capabilities: [
...Capabilities.default(),
skills({
from: gitRepo({
repo: "owner/tax-prep-skills",
ref: "main",
}),
}),
],
});Wähle die Quelle danach aus, wie die Skills bereitgestellt werden sollen:
- Verwende für größere lokale Skill-Verzeichnisse eine lokale Verzeichnisquelle, die Inhalte bei Bedarf lädt. So kann das Modell zuerst den Index durchsuchen und anschließend nur die benötigten Inhalte laden.
- Verwende für ein kleines lokales Paket eine lokale Verzeichnisquelle, um es vorab vollständig bereitzustellen.
- Verwende ein Git-Repository als Quelle, wenn das Skill-Paket einen eigenen Veröffentlichungszyklus hat oder viele Sandboxes darauf zugreifen.
Vorschauen bereitstellen und Ports freigeben
Manchmal ist das Artefakt ein laufender Prozess. Gib einen Port frei, wenn der Agent eine lokale App, ein Notebook, einen Berichtsserver, eine Browservorschau oder einen anderen Dienst erstellt, auf den du von außerhalb der Sandbox zugreifen musst.
Wie du den Port konfigurierst, hängt vom Anbieter ab. Der Agent startet den Dienst in der Sandbox, der Sandbox-Client gibt den Port frei und deine Anwendung teilt die Vorschau-URL oder ruft sie zur Prüfung auf.
Einen Sandbox-Agenten ausführen
Für einen einfachen Sandbox-Lauf gehst du so vor:
- Erstelle ein
Manifest, das den Arbeitsbereich beschreibt. - Erstelle einen
SandboxAgentmit den Funktionen, die das Modell braucht. - Wähle einen Sandbox-Client für die Umgebung, in der die Arbeit ausgeführt werden soll.
- Führe den Agenten mit der Sandbox-Konfiguration für diesen Lauf aus.
- Prüfe oder kopiere die für deine Anwendung relevanten Artefakte, setze die Arbeit daran fort oder sichere sie in einem Snapshot.
Beginne bei der lokalen Entwicklung unter macOS oder Linux mit Unix-local. Der lokale Ablauf ist damit besonders einfach, weil der Runner aus dem Standardmanifest des Agenten einen temporären Arbeitsbereich erstellen und ihn nach dem Lauf aufräumen kann.
Wenn du das TypeScript-SDK verwendest, installiere auf dem Host einen vertrauenswürdigen Python-3-Interpreter, bevor du mit UnixLocalSandboxClient eine Sitzung erstellst. Das SDK verwendet Python für den geschützten Zugriff auf lokale Dateien und prüft die Pfade /usr/bin/python3, /usr/local/bin/python3 und /opt/homebrew/bin/python3. Ist Python an einem anderen Ort installiert, setze OPENAI_AGENTS_PYTHON in der Host-Umgebung auf den absoluten Pfad zur ausführbaren Datei des Interpreters, bevor du Node.js startest. Der Interpreter muss auf dem Host verfügbar sein. Eine Installation innerhalb der Sandbox erfüllt diese Voraussetzung nicht. Ohne geeigneten Python-Interpreter schlägt das Erstellen der Sitzung fehl.
import { run } from "@openai/agents";
import { Manifest, SandboxAgent, file, shell } from "@openai/agents/sandbox";
import { UnixLocalSandboxClient } from "@openai/agents/sandbox/local";
const manifest = new Manifest({
entries: {
"account_brief.md": file({
content:
"# Northwind Health\n\n" +
"- Segment: Mid-market healthcare analytics provider.\n" +
"- Renewal date: 2026-04-15.\n",
}),
"implementation_risks.md": file({
content:
"# Delivery risks\n\n" +
"- Security questionnaire is not complete.\n" +
"- Procurement requires final legal language by April 1.\n",
}),
},
});
const agent = new SandboxAgent({
name: "Renewal Packet Analyst",
model: "gpt-6-astra",
instructions:
"Review the workspace before answering. Keep the response concise, " +
"business-focused, and cite the file names that support each conclusion.",
defaultManifest: manifest,
capabilities: [shell()],
});
const result = await run(
agent,
"Summarize the renewal blockers and recommend the next two actions.",
{
sandbox: {
client: new UnixLocalSandboxClient(),
},
}
);
console.log(result.finalOutput);Vollständige Beispiele für die lokale Ausführung findest du im Schnelleinstieg für Sandbox-Agenten für TypeScript und in unix_local_runner.py für Python.
Anbieter wechseln
Den Anbieter legst du in der Konfiguration des Laufs fest. Die Agentendefinition ist davon unabhängig. Behalte den SandboxAgent, das Manifest und die Funktionen bei und tausche nur den Sandbox-Client und die Anbieteroptionen für die gewünschte Umgebung aus.
Dieses Beispiel verwendet Docker zur lokalen Isolation in einem Container. Bei Hosting-Anbietern gehst du genauso vor und verwendest deren Client-Klassen und Optionen.
import { run } from "@openai/agents";
import { SandboxAgent } from "@openai/agents/sandbox";
import { DockerSandboxClient } from "@openai/agents/sandbox/local";
const agent = new SandboxAgent({
name: "Workspace reviewer",
model: "gpt-6-astra",
instructions: "Inspect the sandbox workspace before answering.",
});
const result = await run(agent, "Inspect the workspace.", {
sandbox: {
client: new DockerSandboxClient({
image: "node:22-bookworm-slim",
}),
},
});
console.log(result.finalOutput);Ausführbare TypeScript-Beispiele findest du im Leitfaden zu Sandbox-Clients und im Einstiegsbeispiel. Das SDK-Repository enthält außerdem die Python-Beispiele basic.py zur Anbieterauswahl, docker_runner.py für Docker und main.py für einen Workflow mit Datenraum.
Fortgeschrittene Anwendungsmuster
Sobald der grundlegende Ablauf funktioniert, kannst du Sandboxes für Workflows einsetzen, bei denen der Agent einen eigenen Arbeitsbereich braucht und zusätzlicher Prompt-Kontext allein nicht ausreicht. Die Beispiele zeigen verschiedene Workflows mit derselben API. Derselbe Harness kann die Schritte weiterleiten, den Workflow anhalten, fortsetzen und per Tracing nachverfolgen. Jede Sandbox führt die Arbeit dort aus, wo die benötigten Dateien, Tools und Ports verfügbar sind.
| Beispiel | Beschreibung |
|---|---|
| Fragen zu einem Datenraum beantworten | Fragen anhand der Inhalte eines eingebundenen Datenraums beantworten. |
| Tabellen aus einem Datenraum extrahieren | Eine Tabelle aus einem eingebundenen Datenraum extrahieren. |
| Code in einem Repository überprüfen | Ein Repository klonen, den Code prüfen und die Ergebnisse der Prüfung als Artefakte ausgeben. |
| Eine Website mit der Vision API nachbilden | Eine Website mithilfe der Vision API und anhand von Rückmeldungen zu Screenshots nachbilden. |
| Arbeit in einer Sandbox fortsetzen | Die Arbeit in einer bereits vorhandenen Sandbox wieder aufnehmen. |
Arbeit fortsetzen oder einen neuen Lauf vorbereiten
Die Arbeit eines Agenten erstreckt sich oft über mehrere Anfragen. Vielleicht prüft jemand ein Artefakt, ein Schritt erfordert eine Genehmigung oder der nächste Schritt hängt von einem späteren Ereignis ab.
Unterscheide drei Arten von Zustand:
| Zustandsart | Was wird wiederhergestellt? | Wann ist das sinnvoll? |
|---|---|---|
RunState |
Zustand des Harness, etwa Modellelemente, Tool-Zustand, Genehmigungen und die aktuelle Position des aktiven Agenten im Ablauf. | Der Runner soll den Workflow nach Unterbrechungen fortführen. |
| Sitzungszustand | Eine serialisierte Sandbox-Sitzung, mit der sich ein Client erneut verbinden kann. | Deine App oder dein System zur Jobverwaltung speichert den Sitzungszustand des Anbieters direkt. |
snapshot |
Gespeicherte Inhalte des Arbeitsbereichs, mit denen eine neue Sandbox-Sitzung initialisiert wird. | Ein neuer Lauf soll mit gespeicherten Dateien und Artefakten beginnen, statt mit einem leeren Arbeitsbereich. |
Der Runner bestimmt die Sandbox-Sitzung in dieser Reihenfolge:
- Wenn du eine laufende Sandbox-Sitzung übergibst, verwendet der Runner sie direkt weiter.
- Andernfalls prüft der Runner, ob der Lauf aus
RunStatefortgesetzt wird. In diesem Fall verwendet er den dort gespeicherten Sandbox-Sitzungszustand. - Andernfalls verwendet der Runner einen explizit übergebenen serialisierten Sandbox-Zustand, um die Sitzung fortzusetzen.
- Trifft keiner dieser Fälle zu, erstellt der Runner eine neue Sandbox-Sitzung. Dazu verwendet er das Manifest für diesen Lauf, sofern du eines übergeben hast, andernfalls das Standardmanifest des Agenten.
Das Beispiel zur Wiederaufnahme einer Sandbox-Sitzung serialisiert den Zustand der angehaltenen Sitzung, setzt sie über denselben Client fort und übergibt die fortgesetzte Sitzung an den nächsten Lauf:
import { run } from "@openai/agents";
import { Manifest, SandboxAgent } from "@openai/agents/sandbox";
import { UnixLocalSandboxClient } from "@openai/agents/sandbox/local";
const manifest = new Manifest();
const client = new UnixLocalSandboxClient({
snapshot: { type: "local", baseDir: "/tmp/my-sandbox-snapshots" },
});
const agent = new SandboxAgent({
name: "Workspace builder",
model: "gpt-6-astra",
instructions: "Inspect the sandbox workspace before answering.",
});
const session = await client.create({ manifest });
let conversation = [];
let frozenSessionState;
try {
const firstResult = await run(agent, "Build the first version of the app.", {
maxTurns: 20,
sandbox: { session },
});
conversation = firstResult.history;
frozenSessionState = await client.serializeSessionState?.(session.state);
} finally {
await session.close?.();
}
if (!frozenSessionState || !client.deserializeSessionState || !client.resume) {
throw new Error("Sandbox client does not support session resume.");
}
const resumedSession = await client.resume(
await client.deserializeSessionState(frozenSessionState)
);
try {
conversation.push({
role: "user",
content: "Continue from the existing workspace and add tests.",
});
const secondResult = await run(agent, conversation, {
maxTurns: 20,
sandbox: { session: resumedSession },
});
console.log(secondResult.finalOutput);
} finally {
await resumedSession.close?.();
}Eingaben für neue Sitzungen wie manifest und snapshot gelten nur, wenn der Runner eine neue Sandbox-Sitzung erstellt. Wenn du eine laufende session übergibst, können bei der Verarbeitung der Funktionen kompatible Einträge hinzugefügt werden, sofern es sich nicht um Speichereinbindungen handelt. Das Stammverzeichnis, die Umgebung, die Konten und die Gruppen der laufenden Sandbox lassen sich auf diesem Weg nicht ändern. Ebenso wenig lassen sich vorhandene Einträge entfernen, Eintragstypen ersetzen oder Speichereinbindungen hinzufügen oder ändern.
So kann der Harness die Agentenschleife fortsetzen, während der Sandbox-Anbieter den Arbeitsbereich wiederherstellt oder neu erstellt. Aktuellen Beispielcode findest du für TypeScript im Beispiel zur Wiederaufnahme einer Sitzung aus dem gespeicherten Zustand und für Python in main.py und sandbox_agent_with_remote_snapshot.py.
Erinnerungen über mehrere Läufe hinweg speichern
Mit Sandbox-Erinnerungen können Agenten in späteren Läufen auf Erkenntnisse aus früheren Läufen zurückgreifen. Diese Funktion ist vom Gesprächsspeicher der SDK-verwalteten Session getrennt. Sitzungen bewahren den Nachrichtenverlauf auf. Sandbox-Erinnerungen halten dagegen nützliche Erkenntnisse aus früheren Läufen im Arbeitsbereich in Dateien fest, die der Agent später lesen kann.
Nutze Erinnerungen, wenn der Agent persönliche Präferenzen, Korrekturen, projektspezifische Erkenntnisse oder Aufgabenzusammenfassungen übernehmen soll, ohne jeden früheren Turn erneut durchzugehen. Beim Fortsetzen einer Sitzung und beim Erstellen von Snapshots bleibt der Zustand des Arbeitsbereichs erhalten. Erinnerungen halten fest, welche Hinweise aus der bisherigen Arbeit sich wiederverwenden lassen.
import {
Manifest,
SandboxAgent,
filesystem,
memory,
shell,
} from "@openai/agents/sandbox";
const manifest = new Manifest();
const agent = new SandboxAgent({
name: "Memory-enabled reviewer",
instructions:
"Inspect the workspace and retain useful lessons for follow-up runs.",
defaultManifest: manifest,
capabilities: [memory(), filesystem(), shell()],
});Standardmäßig kann der Agent Erinnerungen sowohl lesen als auch erzeugen. Zum Lesen braucht er Shell-Zugriff, damit er Erinnerungsdateien suchen und öffnen kann. Für Aktualisierungen während des Laufs ist standardmäßig auch Dateisystemzugriff erforderlich. Damit kann der Agent veraltete Erinnerungen korrigieren oder Erinnerungen auf Wunsch aktualisieren.
Der Agent liest Erinnerungen schrittweise. Das SDK fügt zu Beginn eines Laufs memory_summary.md in den Kontext ein. Wenn frühere Arbeit relevant erscheint, durchsucht der Agent MEMORY.md. Zusammenfassungen einzelner Ausführungen öffnet er erst, wenn er weitere Details braucht.
| Modus für Erinnerungen | Wann du ihn verwendest |
|---|---|
| Lesen und Schreiben (Standard) | Der Agent soll vorhandene Erinnerungen lesen und neue erzeugen. |
| Ohne Schreibzugriff | Der Agent soll Erinnerungen lesen, nach dem Lauf aber keine neuen erzeugen. |
| Nur erzeugen | Der Lauf soll Erinnerungen erzeugen, ohne vorhandene zu verwenden. |
| Lesekonfiguration | Du möchtest Aktualisierungen während des Laufs deaktivieren. |
| Konfiguration für die Erzeugung | Du möchtest anpassen, wie Erinnerungen erzeugt werden, etwa durch einen zusätzlichen Prompt. |
| Verzeichniskonfiguration | Die Agenten brauchen im selben Sandbox-Arbeitsbereich getrennte Verzeichnisstrukturen für ihre Erinnerungen. |
Standardmäßig liegen die Dateien für Erinnerungen im Arbeitsbereich der Sandbox:
workspace/
  sessions/
    <rollout-id>.jsonl
  memories/
    memory_summary.md
    MEMORY.md
    raw_memories.md
    phase_two_selection.json
    raw_memories/
      <rollout-id>.md
    rollout_summaries/
      <rollout-id>_<slug>.md
    skills/
Während der Sandbox-Sitzung hängt die Laufzeitumgebung Abschnitte der Läufe an. Beim Schließen der Sitzung extrahiert sie für die Erinnerungen zunächst Gesprächszusammenfassungen und vorläufige Erinnerungen. Anschließend führt sie diese Erinnerungen in MEMORY.md und memory_summary.md zusammen. Um die Erinnerungen in einem späteren Lauf wiederzuverwenden, musst du die konfigurierten Erinnerungsverzeichnisse erhalten. Dazu kannst du dieselbe laufende Sandbox-Sitzung beibehalten, eine Sitzung aus ihrem gespeicherten Zustand fortsetzen, mit einem Snapshot starten oder dauerhaften Speicher wie S3 einbinden.
Verwende für Sandbox-Chats über mehrere Turns hinweg eine stabile SDK-Sitzung zusammen mit derselben laufenden Sandbox-Sitzung. Beim Gruppieren von Läufen für die Erinnerungen hat die explizite Gesprächs-ID Vorrang. Danach folgen die SDK-Sitzungs-ID, die Laufgruppen-ID und schließlich eine für den einzelnen Lauf generierte ID. Die Sandbox-Sitzungs-ID identifiziert den aktiven Arbeitsbereich. Die Gesprächs-ID für Erinnerungen wird separat bestimmt.
Ausführbare Beispiele findest du im Leitfaden zu Erinnerungen für TypeScript. Für Python zeigt memory.py einen Ablauf mit lokalen Snapshots, memory_s3.py die Speicherung von Erinnerungen in S3 und memory_multi_agent_multiturn.py getrennte Erinnerungsverzeichnisse für mehrere Agenten.
Sandbox-Agenten kombinieren
Du kannst Sandbox-Agenten mit den übrigen Funktionen des SDK kombinieren.
Verwende eine Übergabe, wenn ein Agent außerhalb der Sandbox Anfragen entgegennimmt und nur den Teil eines Workflows an einen Sandbox-Agenten delegieren soll, der intensive Arbeit im Arbeitsbereich erfordert. Der übergeordnete Lauf wird fortgesetzt. Für den nächsten Turn übernimmt der Sandbox-Agent die Rolle des aktiven Agenten.
Verwende Agenten als Tools, wenn ein übergeordneter Orchestrator einen oder mehrere Sandbox-Agenten als verschachtelte Tools aufrufen soll. Jeder als Tool eingesetzte Sandbox-Agent kann eine eigene Sandbox-Konfiguration für den Lauf, einen eigenen Sandbox-Client, ein eigenes Manifest und eigene Anbieteroptionen verwenden.
Beispiele findest du in handoffs.py und sandbox_agents_as_tools.py.
Sandbox-Anbieter
Beginne mit Unix-local, wenn du Änderungen lokal schnell ausprobieren möchtest. Verwende Docker, wenn du lokale Isolation in einem Container brauchst. Wechsle zu einem Hosting-Anbieter, wenn die Aufgabe eine verwaltete Ausführungsumgebung, anbieterspezifische Isolation, Skalierung, Vorschauen, Speichereinbindungen, Snapshots oder Zugangsdaten erfordert, die außerhalb deines Anwendungsservers verwaltet werden sollen.
Details zum anbieterspezifischen Setup, zu Zugangsdaten, Isolation, Speicher, Vorschauen und dauerhafter Speicherung findest du in der Dokumentation des jeweiligen Anbieters.