
KI-Audiofunktionen eröffnen neue Möglichkeiten, mit Anwendungen zu interagieren. In diesem Jahr haben wir bereits mehrere neue Audiomodelle veröffentlicht, darunter gpt-realtime. Dazu kamen neue API-Funktionen, mit denen du solche Anwendungen entwickeln kannst.
Letzte Woche haben wir neue Versionen unserer Audiomodelle veröffentlicht. Sie verbessern die Zuverlässigkeit und Qualität von Sprachanwendungen im Produktivbetrieb und helfen damit bei typischen Herausforderungen in der Entwicklung zuverlässiger Sprachagenten. Die Verbesserungen reichen von der Transkription und Sprachsynthese bis hin zu Agenten, die natives Speech-to-Speech in Echtzeit unterstützen.
Die neuen Modellversionen im Überblick:
gpt-4o-mini-transcribe-2025-12-15zur Spracherkennung mit der Transkriptions-API oder der Realtime APIgpt-4o-mini-tts-2025-12-15zur Sprachsynthese mit der Speech APIgpt-realtime-mini-2025-12-15für natives Speech-to-Speech in Echtzeit mit der Realtime APIgpt-audio-mini-2025-12-15für natives Speech-to-Speech mit der Chat Completions API
Die neuen Versionen haben einige Verbesserungen gemeinsam:
Bei der Audioeingabe:
- Niedrigere Wortfehlerraten bei Aufnahmen aus dem Alltag und bei Aufnahmen mit Störgeräuschen
- Weniger Halluzinationen bei Stille oder Hintergrundgeräuschen
Bei der Audioausgabe:
- Natürlichere und stabilere Sprachausgabe, auch mit Custom Voices
Die Preise bleiben gegenüber den bisherigen Modellversionen gleich. Wir empfehlen dir daher, auf die neuen Versionen umzusteigen. So erhältst du zum gleichen Preis eine bessere Leistung.
Wenn du Sprachagenten, Systeme für den Kundensupport oder Sprachanwendungen mit eigener Markenstimme entwickelst, helfen dir diese Updates, deine Anwendungen im Produktivbetrieb zuverlässiger zu machen. Im Folgenden erfährst du, was neu ist und wie sich die Verbesserungen in der Praxis auswirken.
Speech-to-Speech
Wir stellen neue Modelle von Realtime mini und Audio mini bereit, die Tools zuverlässiger aufrufen und Anweisungen genauer befolgen. Damit verringert sich der Leistungsabstand zwischen den Mini-Modellen und den großen Modellen. Bei manchen Anwendungen kannst du deshalb auf das Mini-Modell umsteigen und Kosten senken.
gpt-realtime-mini-2025-12-15
Das Modell gpt-realtime-mini ist für die Realtime API ausgelegt. Sie ermöglicht native multimodale Interaktionen mit geringer Latenz. Das Modell unterstützt Audiostreaming für die Ein- und Ausgabe, reagiert auf Unterbrechungen (auf Wunsch mit Sprachaktivitätserkennung) und ermöglicht Funktionsaufrufe im Hintergrund, während es weiterspricht.
Die neue Version von Realtime mini eignet sich besser für Echtzeitagenten, weil sie Anweisungen genauer befolgt und Tools zuverlässiger aufruft. In unseren internen Speech-to-Speech-Tests stieg die Genauigkeit gegenüber der Vorgängerversion beim Befolgen von Anweisungen um 18,6 Prozentpunkte und bei Tool-Aufrufen um 12,9 Prozentpunkte. Auch beim Benchmark Big Bench Audio erzielte das Modell ein besseres Ergebnis.
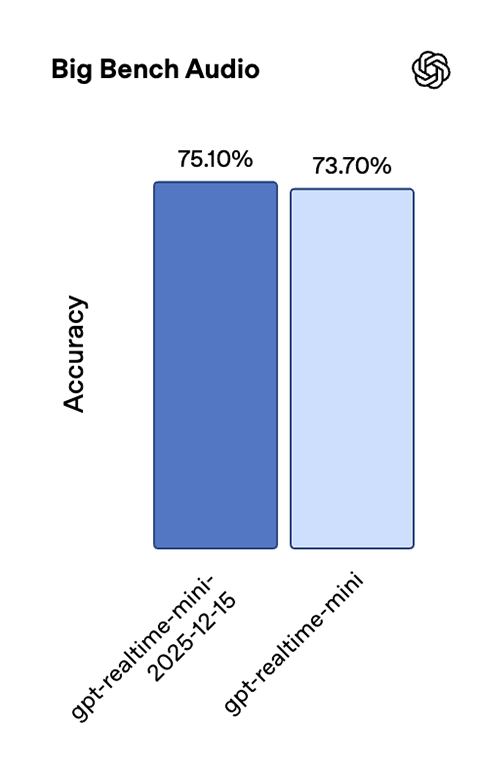
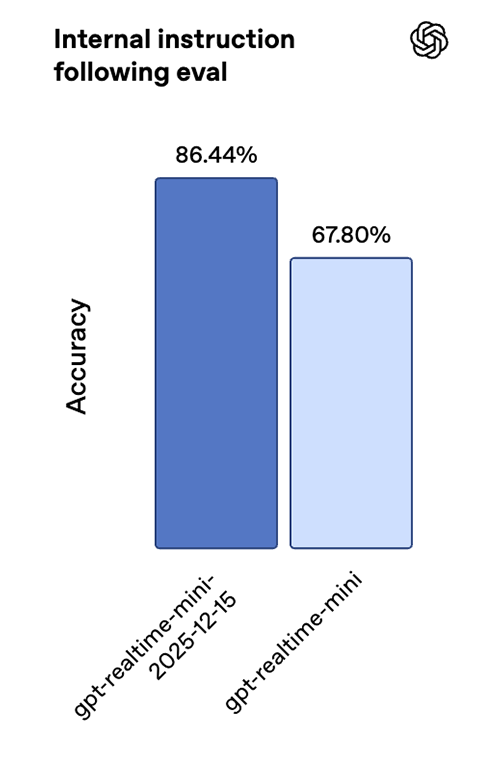
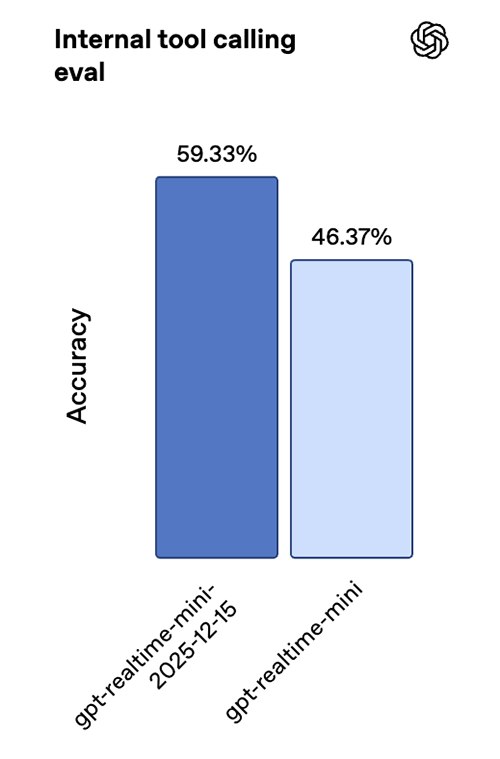
Dadurch laufen mehrstufige Interaktionen im Livebetrieb bei geringer Latenz zuverlässiger ab, und Funktionen werden konsistenter ausgeführt.
Wenn die Genauigkeit deines Agenten höhere Kosten rechtfertigt, bleibt gpt-realtime unser leistungsfähigstes Modell. Wenn es vor allem auf Kosten und Latenz ankommt, ist gpt-realtime-mini eine gute Wahl. Das Modell bewährt sich auch in der Praxis.
Genspark hat das Modell beispielsweise einem Belastungstest unterzogen. Dabei sollte es zwischen zwei Sprachen übersetzen und Anfragen je nach erkanntem Anliegen weiterleiten. Neben der besseren Sprachqualität stellte das Team fest, dass das Modell fast ohne Verzögerung reagierte. Auch bei schnellen Gesprächswechseln erkannte es die Anliegen durchweg richtig.
gpt-audio-mini-2025-12-15
Das Modell gpt-audio-mini kannst du mit der Chat Completions API für Speech-to-Speech-Anwendungen einsetzen, die keine Interaktion in Echtzeit erfordern.
Beide neuen Modellversionen nutzen außerdem einen verbesserten Decoder. Dadurch klingen die Stimmen natürlicher. Mit Custom Voices bleibt der Klang der gewählten Stimme zudem konsistenter.
Sprachsynthese
Unser neuestes Modell für die Sprachsynthese, gpt-4o-mini-tts-2025-12-15, arbeitet deutlich genauer als die Vorgängergeneration. In gängigen Sprachbenchmarks erzielt es wesentlich niedrigere Wortfehlerraten. Bei Common Voice und FLEURS liegt die Wortfehlerrate (WER) rund 35 % niedriger. Auch bei Multilingual LibriSpeech sehen wir durchweg Verbesserungen.
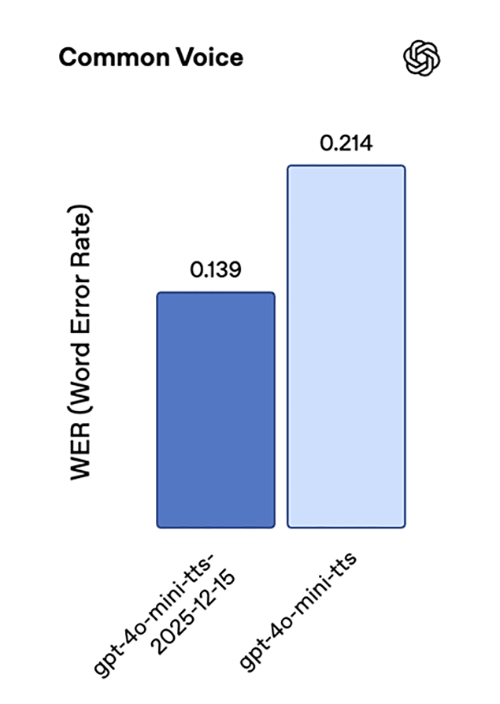
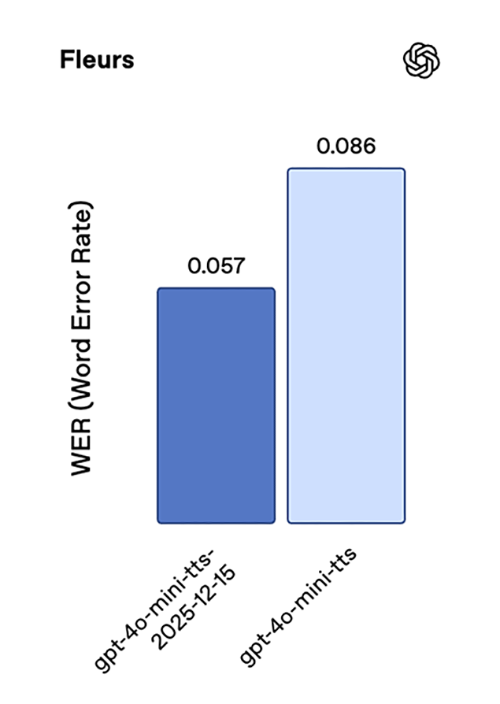
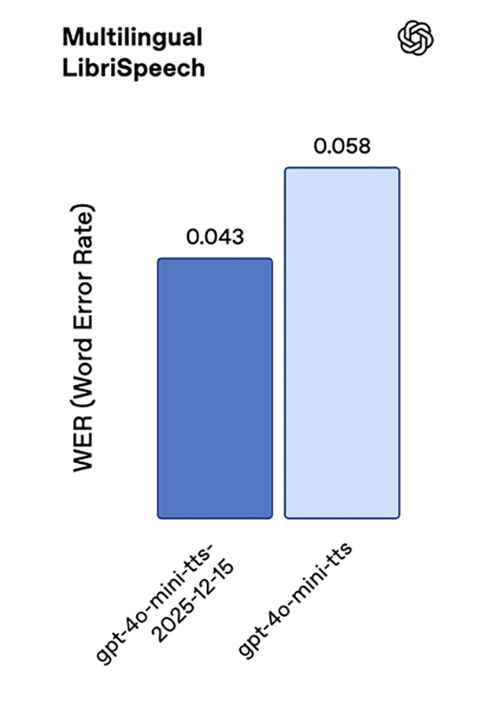
Die Ergebnisse zeigen, dass das Modell Wörter in vielen verschiedenen Sprachen genauer und zuverlässiger ausspricht.
Wie bei der neuen Version von gpt-realtime-mini klingt die Sprachausgabe deutlich natürlicher. Auch mit Custom Voices erzielt das Modell bessere Ergebnisse.
Spracherkennung
Unser neuestes Transkriptionsmodell, gpt-4o-mini-transcribe-2025-12-15, arbeitet deutlich genauer und zuverlässiger. Bei gängigen Benchmarks für die automatische Spracherkennung wie Common Voice und FLEURS erzielt es ohne Angabe der Sprache niedrigere Wortfehlerraten als frühere Modelle. Wir haben das Modell für typische Gesprächssituationen optimiert, etwa für kurze Äußerungen oder laute Umgebungen. In einem internen Test zu Halluzinationen bei Störgeräuschen haben wir Aufnahmen von Hintergrundgeräuschen aus dem Alltag sowie Audioclips mit unterschiedlich langen Sprechphasen und stillen Abschnitten abgespielt. Das Modell erzeugte rund 90 % weniger Halluzinationen als Whisper v2 und rund 70 % weniger als frühere GPT-4o-transcribe-Modelle.
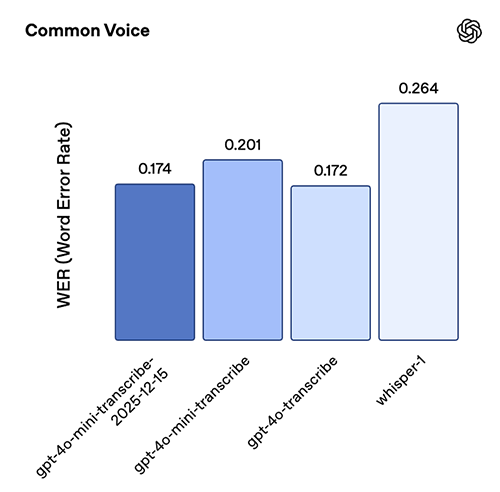
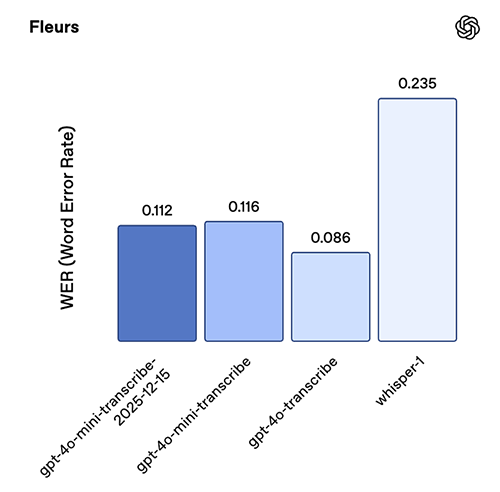
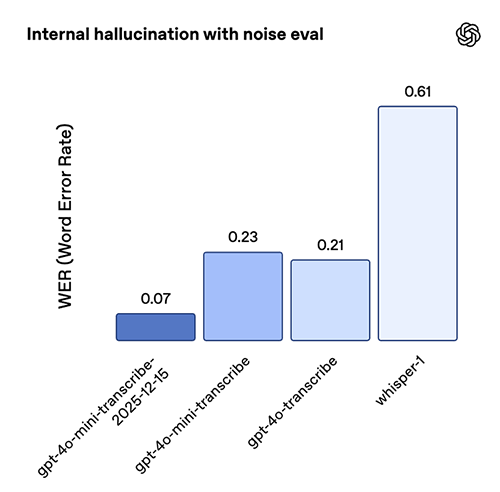
Besonders gute Ergebnisse erzielt diese Modellversion für Chinesisch (Mandarin), Hindi, Bengalisch, Japanisch, Indonesisch und Italienisch.
Custom Voices
Mit Custom Voices können Unternehmen ihre Kundschaft mit einer Stimme ansprechen, die zu ihrer Marke passt. Ob du einen Agenten für den Kundensupport oder einen Markenavatar entwickelst: Mit der Sprachtechnologie von OpenAI kannst du ganz einfach unverwechselbare, realistisch klingende Stimmen erstellen.
Mit den neuen Modellen für Speech-to-Speech und Sprachsynthese klingen individuelle Stimmen natürlicher und entsprechen der ursprünglichen Stimmprobe genauer. Auch Dialekte geben die Modelle präziser wieder.
Damit die Technologie sicher eingesetzt wird, stehen Custom Voices nur Unternehmen zur Verfügung, die die Voraussetzungen erfüllen. Mehr erfährst du bei deinem Account Director oder direkt bei unserem Vertriebsteam.
Vom Prototyp zum Produktivbetrieb
Sprachanwendungen stoßen häufig in denselben Situationen an ihre Grenzen: bei langen Gesprächen, in Ausnahmefällen wie Stille und bei Abläufen, in denen der Sprachagent Tools präzise einsetzen muss. Genau hier setzen die Updates an. Die Modelle machen weniger Fehler, halluzinieren seltener, setzen Tools zuverlässiger ein und befolgen Anweisungen genauer. Zusätzlich haben wir die Audioausgabe stabiler gemacht, damit deine Sprachanwendungen natürlicher klingen können.
Wenn du bereits Sprachanwendungen im Produktivbetrieb einsetzt, empfehlen wir dir, auf die neuen Modellversionen vom 2025-12-15 umzusteigen und die wichtigsten Testfälle für den Produktivbetrieb erneut auszuführen.
Wer die neuen Versionen frühzeitig getestet hat, konnte bestätigen, dass allein der Wechsel spürbare Verbesserungen brachte, auch mit denselben Anweisungen. Wir empfehlen dir, die Modelle mit deinen eigenen Anwendungsfällen auszuprobieren und deine Prompts bei Bedarf anzupassen.