
如何在使用 LLM 時,盡可能提高正確性與行為一致性
最佳化 LLM 並不容易。
我們曾與許多新創公司及企業的開發人員合作,發現最佳化之所以困難,總是歸結於以下幾個問題:
- 知道該 如何著手 提升準確度
- 何時該使用哪種 最佳化方法
- 準確度要達到什麼程度,才 足以 用於正式環境
本文提供一套思考架構,協助你最佳化 LLM 的準確度與行為。我們會探討提示工程、檢索增強生成(RAG)與微調等方法,說明各項技術的使用方式與時機,並分享幾個常見陷阱。
閱讀時,請結合你的具體使用案例,思考這些原則與準確度的關係。這看似理所當然,但產生需要人工修改的不佳文案,與原本應退款 $100 卻退給客戶 $1000,兩者的影響截然不同。在討論 LLM 準確度之前,你應該先大致瞭解:LLM 一次失敗會帶來多少成本,一次成功又能節省多少成本或創造多少收益。本文最後探討準確度要達到什麼程度才足以用於正式環境時,會再回到這個問題。
LLM 最佳化的背景
許多最佳化實作指南將整個過程描述成簡單的線性流程:先做提示工程,再做檢索增強生成,最後進行微調。然而,實際情況往往並非如此。這些方法各自解決不同的問題,必須選對方法,才能朝正確的方向最佳化。
將 LLM 最佳化視為一個矩陣,會更有助於理解:

一般的 LLM 任務會從左下角的提示工程開始,透過測試、學習與評估建立基準。檢視基準範例並分析出錯原因後,就可以選擇其中一種最佳化方法:
- 上下文最佳化: 當模型出現以下情況時,需要最佳化上下文:1) 訓練集未包含相關上下文知識,因此模型缺乏這些知識;2) 模型的知識已過時;或 3) 模型需要掌握專有資訊。這個軸向著重於盡可能提高 回應準確度。
- LLM 最佳化: 當模型出現以下情況時,需要最佳化 LLM:1) 產生的結果不一致且格式不正確;2) 語氣或表達風格不合適;或 3) 無法一致地遵循推理過程。這個軸向著重於盡可能提高 行為一致性。
實務上,這會形成一連串的最佳化步驟:先評估、提出最佳化假設、實作,再評估,然後重新判斷下一步。以下是相當典型的最佳化流程:
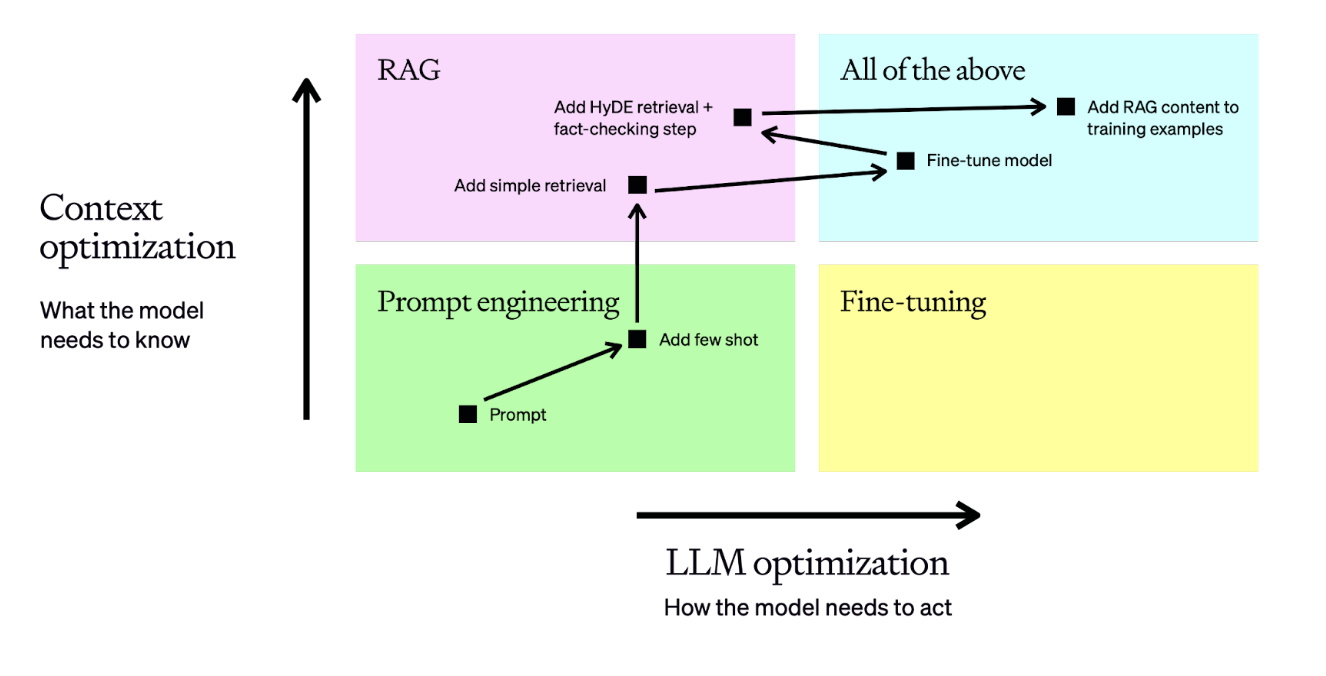
在這個範例中,我們會依序執行以下步驟:
- 先建立提示詞,再評估其表現
- 加入固定的少樣本範例,這應能提高結果的一致性
- 加入檢索步驟,根據問題動態帶入少樣本範例,確保每次輸入都有相關上下文,進而提升表現
- 準備包含 50 個以上範例的資料集,並微調模型以提高一致性
- 調整檢索機制,並加入事實查核步驟來找出幻覺,以達到更高的準確度
- 使用包含改良後 RAG 輸入的新訓練範例,重新訓練已微調的模型
這是解決棘手業務問題時相當典型的最佳化流程,有助於判斷我們需要的是更多相關上下文,還是模型更一致的行為。一旦做出判斷,就知道該選擇哪種方法作為最佳化的第一步。
有了這套思考架構後,接下來就深入瞭解各個面向的實作方法。我們會從左下角的提示工程開始。
提示工程
提示工程通常是最佳起點**。對於摘要、翻譯和程式碼生成等使用案例,零樣本方法就能達到正式環境所需的準確度與一致性,因此提示工程往往是唯一需要的方法。
這是因為提示工程會促使你明確定義使用案例中的準確度。你從最基本的提供輸入開始,因此必須能判斷輸出是否符合預期。如果結果不如預期,找出 原因 就能知道該用什麼方法進一步最佳化。
為此,你應始終從簡單的提示詞開始,並先想好預期的輸出,再加入 上下文、 指示或 範例 來最佳化提示詞,直到獲得所需的結果。
最佳化
在最佳化提示詞時,我會主要採用 OpenAI API 文件中提示工程指南的策略。每項策略都能協助你調整上下文、LLM,或同時調整兩者:
| 策略 | 上下文最佳化 | LLM 最佳化 |
|---|---|---|
| 撰寫清楚的指示 | X | |
| 將複雜任務拆解為較簡單的子任務 | X | X |
| 給 GPT 時間「思考」 | X | |
| 有系統地測試變更 | X | X |
| 提供參考文字 | X | |
| 使用外部工具 | X |
這些策略可能有些抽象,因此我們會透過實際範例逐一嘗試。讓我們使用 gpt-4-turbo 修正冰島語句子,看看這些策略如何發揮作用。
我們已經看到,提示工程是很好的起點,搭配適當的調整方法,就能大幅提升表現。
不過,提示工程最大的問題在於往往難以擴展。有時,光是在上下文中加入內容,仍不足以讓模型應付更廣泛的問題,必須動態提供上下文;有時,我們需要的行為一致性,也超出了少樣本範例所能達到的程度。
長上下文模型能進一步擴展提示工程的應用範圍。不過, 面對篇幅極長、指令複雜的提示詞, 模型可能難以全程維持注意力。因此,使用長上下文 模型時,應一併評估不同上下文長度的表現,確保不會出現 忽略中間資訊的問題。「忽略中間資訊」 指的是 LLM 無法在同一時間,對收到的所有 Token 給予同等的注意力。這可能導致模型遺漏 資訊,而且看似毫無規律。這並不表示你不該使用長 上下文,而是需要搭配充分的評估。一位開放原始碼 貢獻者 Greg Kamradt 設計了一項實用的評估,稱為 Needle in A Haystack (NITA), 將一項資訊隱藏在長上下文文件中的不同位置, 藉此評估檢索品質。這呈現了 長上下文的問題:它有望讓檢索流程大幅簡化,讓你把所有內容都放進 上下文,但代價是準確度下降。
那麼,提示工程究竟能做到什麼程度?答案取決於實際情況,而評估結果就是你做決定的依據。
評估
因此,這個階段最理想的成果是 一份良好的提示詞,以及一組包含問題和標準答案的評估集 。如果我們有 20 組以上的問答,已深入檢視失敗案例的細節,並對失敗原因提出假設,就具備了採用更進階最佳化方法所需的基準。
在採用更複雜的最佳化方法之前,也可以考慮如何將評估自動化,加快迭代速度。以下是我們觀察到幾種常見且有效的做法:
- 使用 ROUGE 或 BERTScore 等方法進行粗略判斷。這類評分與人工審查結果的相關性沒有那麼高,但能快速有效地衡量每次迭代對模型輸出造成的變化幅度。
- 依照 G-Eval 論文所述,使用 GPT-4 作為評估工具,向 LLM 提供評分表,讓它盡可能客觀地評估輸出。
若想進一步了解這些方法,可以參閱這篇 Cookbook,透過實作逐一了解各種方法。
了解工具
如果你已經做了提示工程,也準備了評估集,模型卻仍無法達到需求,接下來最重要的就是診斷模型在哪裡出錯,以及哪種工具最適合用來改善。
以下是一個基本的分析架構:
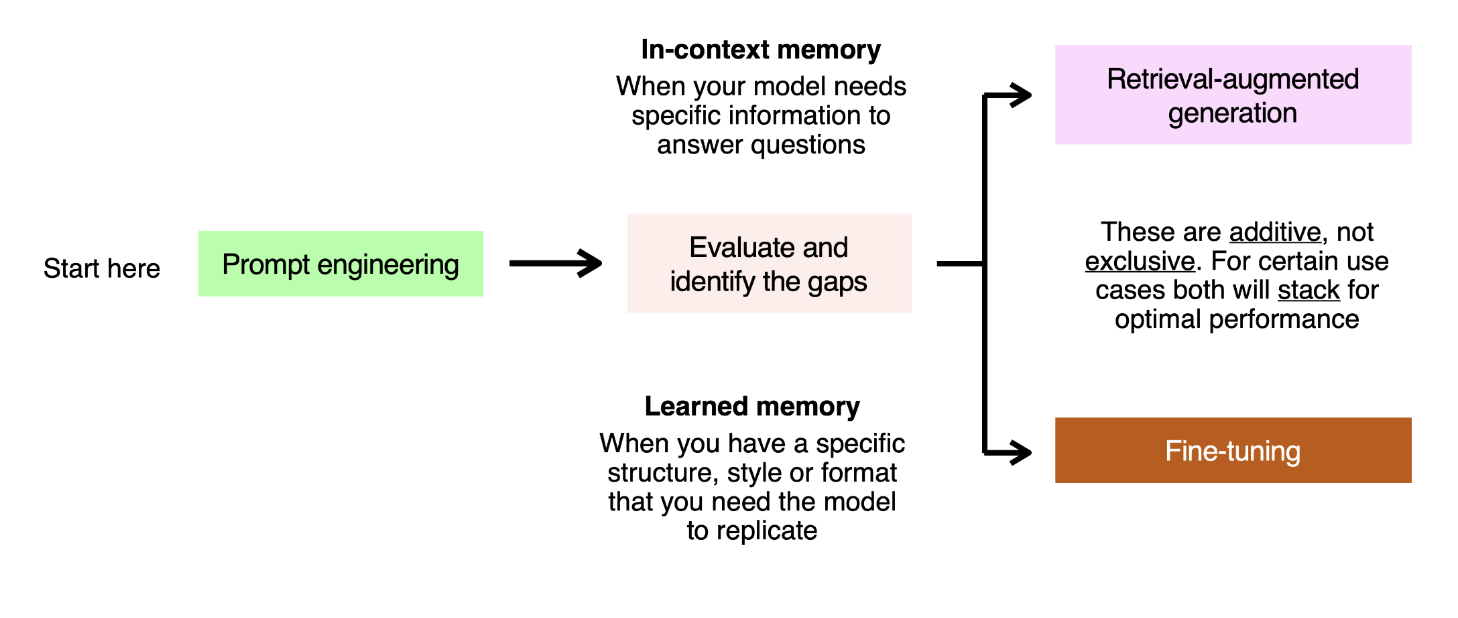
你可以將每一道模型答錯的評估題目,歸類為 上下文 記憶問題或 習得 記憶問題。以考試作為比喻,你有兩種方式可以確保答對:
- 過去 6 個月你持續上課,反覆看過許多範例,了解某個概念如何運作。這就是 習得 記憶。對 LLM 而言,可以提供提示詞與預期回應的範例,讓模型從中學習,藉此解決這類問題。
- 你帶著課本,可以查找正確的資訊來回答問題。這就是 上下文 記憶。對 LLM 而言,可以將相關資訊放入上下文視窗,藉此解決這類問題;既可以透過提示工程靜態加入,也可以使用 RAG 以規模化的方式處理。
這兩種最佳化方法 可以相互加成,並非互斥 。它們能搭配使用,有些使用案例也需要同時採用兩者,才能達到最佳表現。
假設我們面對的是短期記憶問題,接下來就用 RAG 來解決。
檢索增強生成(RAG)
RAG 是在生成答案( Generating)之前,先檢索內容( Retrieving)來增強 LLM 提示詞( Augment)的流程。它讓模型能夠 取得特定領域的上下文 ,以完成任務。
RAG 是提升 LLM 準確度與一致性的重要工具。在 OpenAI 規模最大的客戶部署案例中,許多都只使用了提示工程與 RAG。
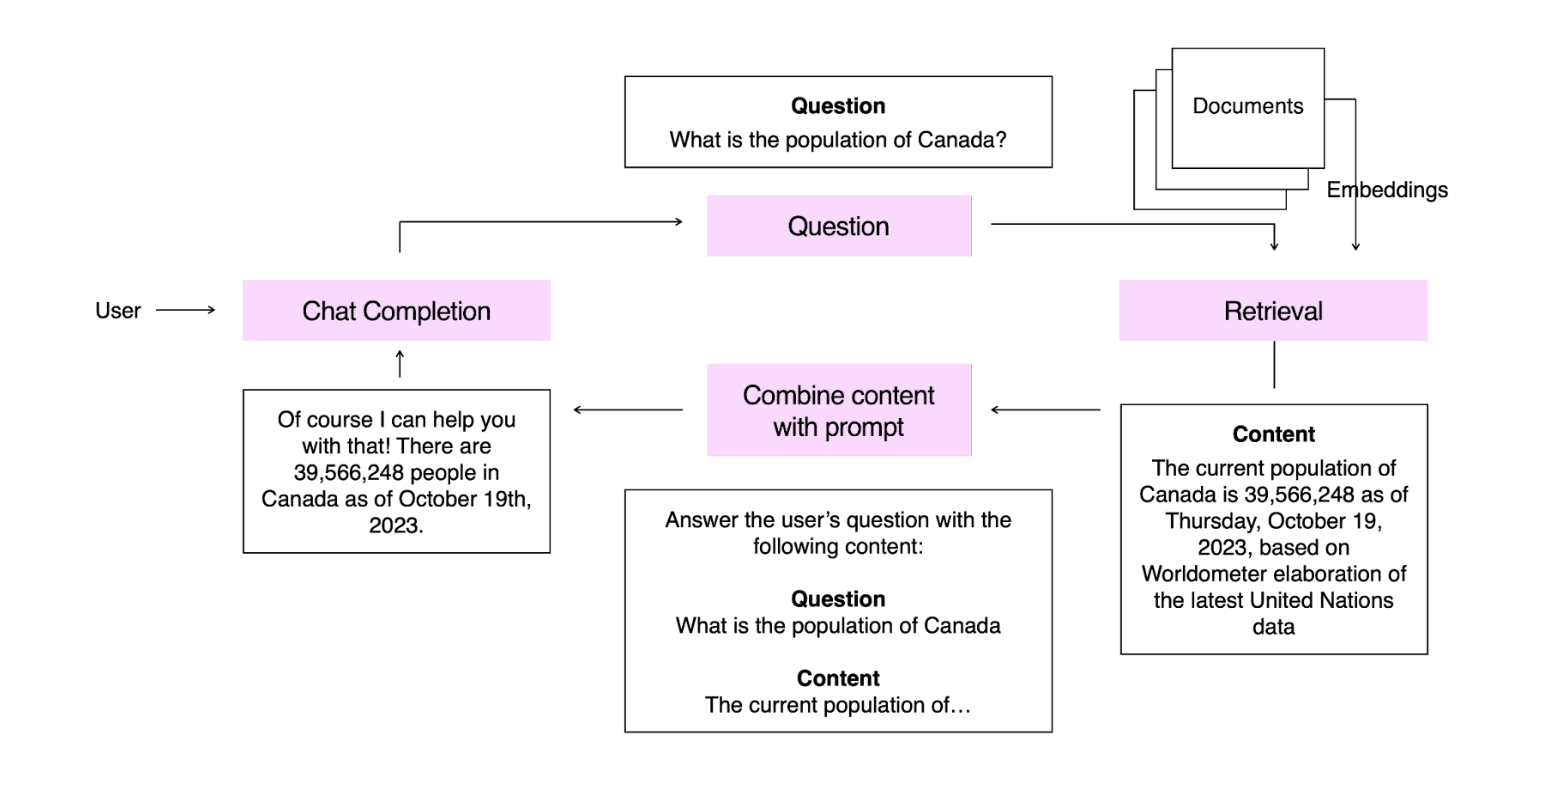
在這個範例中,我們已將統計資料知識庫轉換為嵌入向量。使用者提出問題時,我們也將問題轉換為嵌入向量,再從知識庫檢索最相關的內容,提供給模型來回答問題。
RAG 應用程式引入了一個新的最佳化面向:檢索。要讓 RAG 發揮作用,我們需要先提供正確的上下文給模型,再評估模型是否回答正確。我會用下方的矩陣呈現這些面向,提供一個思考 RAG 評估的簡單方式:
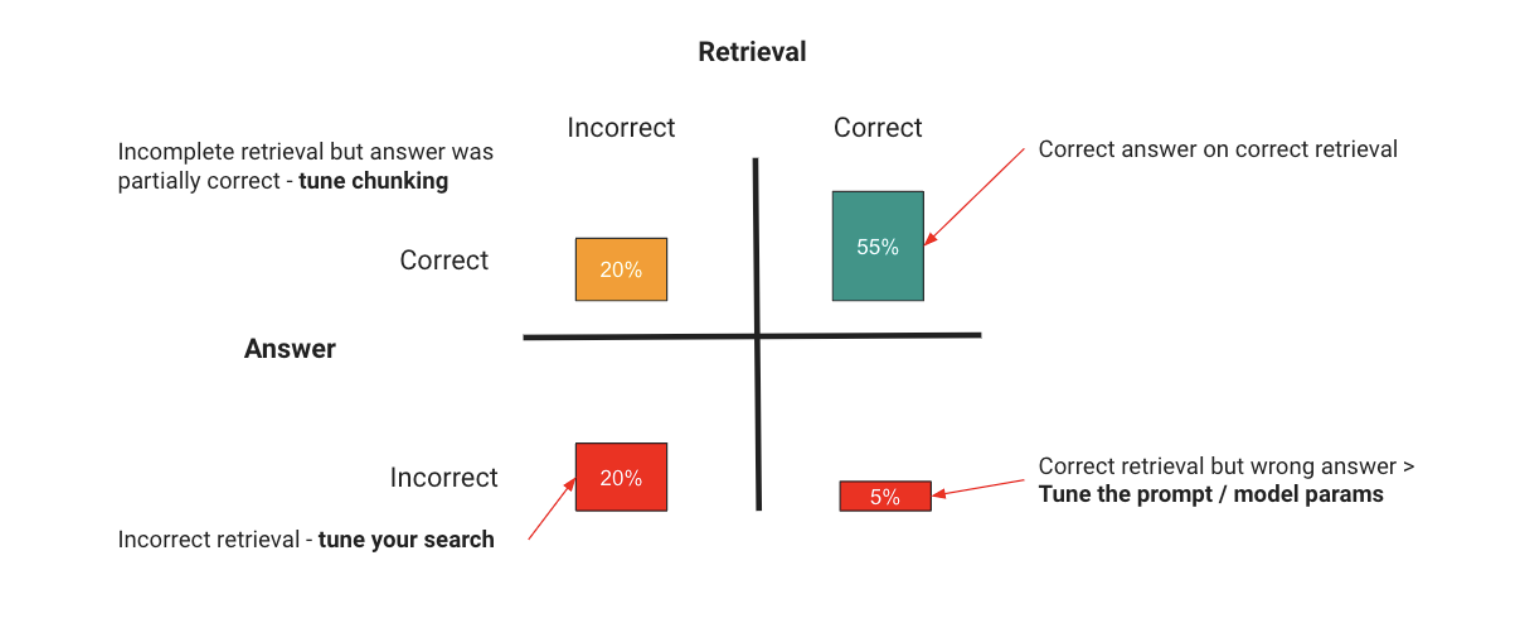
RAG 應用程式可能在兩個環節出問題:
| 環節 | 問題 | 解決方式 |
|---|---|---|
| 檢索 | 你可能提供了錯誤的上下文,讓模型根本無法回答;也可能提供了太多無關的上下文,淹沒真正有用的資訊,導致幻覺。 | 最佳化檢索,做法可以包括: - 調整搜尋,讓它傳回正確的結果。 - 調整搜尋,減少結果中的雜訊。 - 在每筆檢索結果中提供更多資訊。 這些只是部分範例。RAG 效能調整本身已形成一個產業,LlamaIndex 和 LangChain 等程式庫也提供了多種調整方法。 |
| LLM | 模型也可能取得正確的上下文,卻未能正確運用。 | 透過提示工程改善模型使用的指令與方法;如果提供範例能提高準確度,再加入微調。 |
這裡的重點是,原則仍與本文開頭的思考架構相同:透過評估找出問題,再採取最佳化步驟加以修正。使用 RAG 唯一的差別,是現在還需要考慮檢索這個面向。
RAG 雖然實用,卻只能解決上下文學習的問題。對許多使用案例來說,真正的挑戰是確保 LLM 學會一項任務,並能一致且可靠地執行。這類問題就需要透過微調來處理。
微調
為了解決習得記憶問題,許多開發人員會使用規模較小、針對特定領域的資料集,繼續訓練 LLM,讓它更適合執行特定任務。這個過程稱為 微調。
進行微調通常出於以下兩個原因之一:
- 提高模型執行特定任務的準確度: 使用特定任務的資料訓練模型,向它展示大量正確執行該任務的範例,以解決習得記憶問題。
- 提高模型效率: 使用更少的 Token,或改用更小的模型,達到相同的準確度。
微調流程從準備訓練範例資料集開始。這是最關鍵的一步,因為微調範例必須精確反映模型在實際使用時會遇到的情況。
許多客戶會採用稱為 提示詞烘焙的流程,在試行期間 大量記錄提示詞的輸入與輸出。篩選這些紀錄後, 就能建立包含真實情境範例的有效訓練集。
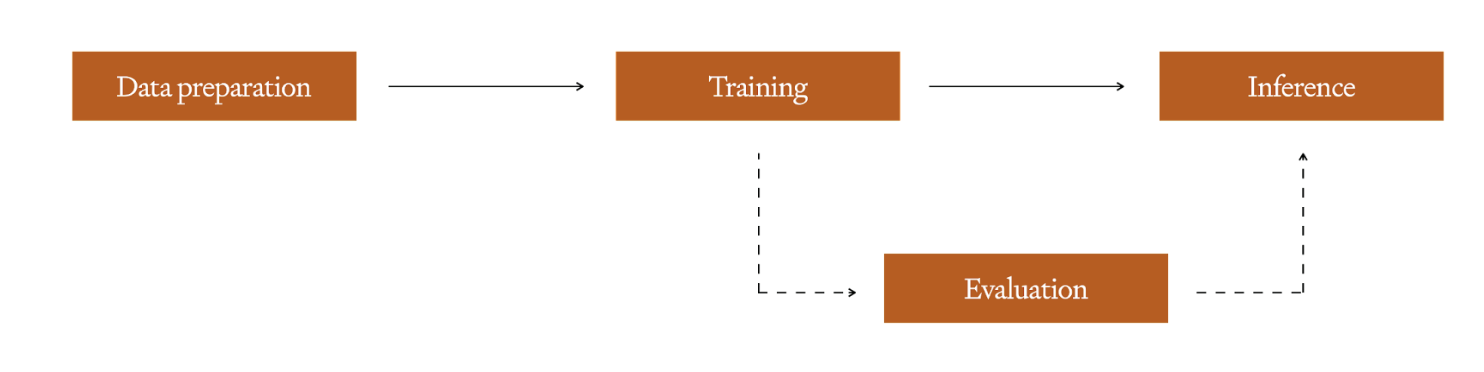
有了這份整理好的資料集,就可以執行一次 訓練 ,產生微調模型。如同其他機器學習模型,依據使用的訓練平台或框架,你可能也能調整超參數。我們一律建議保留一組不參與訓練的資料,在訓練後用於 評估 ,以偵測過度擬合。若想了解如何建立良好的訓練集,可以參閱微調文件中的指引。訓練完成後,新的微調模型即可用於推論。
在微調最佳化方面,我們會著重介紹使用 OpenAI 模型自訂服務時觀察到的最佳實務,不過這些原則應該也適用於其他供應商與開放原始碼方案。主要做法如下:
- 從提示工程開始: 在提示工程階段建立可靠的評估集,作為後續基準。這樣一來,在你對基礎提示詞有信心之前,就能維持較低的投入。
- 從小規模開始,重視品質: 在基礎模型上進行微調時,訓練資料的品質比數量更重要。先從 50 個以上的範例開始,再進行評估。如果準確度仍未達到需求,而且錯誤答案源自行為或一致性問題,而非上下文問題,再擴大訓練集。
- 確保範例具有代表性: 我們最常見的問題之一,就是訓練資料缺乏代表性:微調範例的格式或形式,與 LLM 在正式環境中遇到的內容有細微差異。例如,如果你開發的是 RAG 應用程式,就應使用包含 RAG 內容的範例來微調模型,讓它不必以零樣本方式學習如何運用上下文。
綜合運用以上方法
這些技術可以搭配使用。如果早期評估顯示上下文與行為都有問題,你最後的正式環境解決方案很可能會同時採用微調與 RAG。這是合理的做法,兩者搭配能彌補各自的弱點。主要優點包括:
- 透過微調,以大量訓練範例取代指令與少樣本範例,讓模型養成一致的行為,進而 盡量減少提示工程所需的 Token 。
- 透過充分的微調,教會模型複雜的行為
- 使用 RAG 加入上下文、較新的內容,或使用案例所需的其他特定上下文
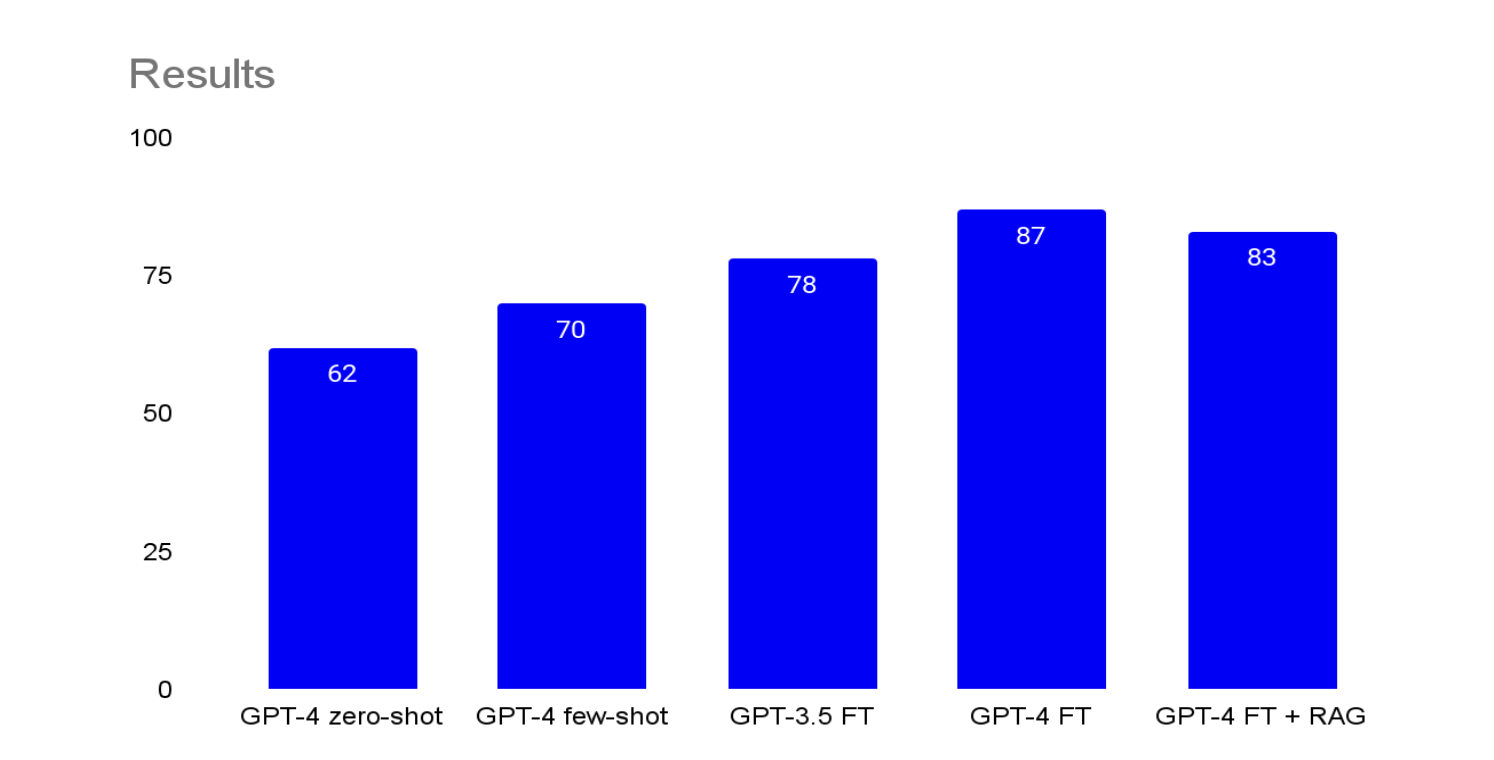 各調校方法的 Bleu 分數(滿分 100)
讀到這裡,你應該已了解 RAG 與微調,以及各自適用的情境。關於這些工具,最後還有一點需要了解:引入它們後,就必須在迭代速度上有所取捨:
- 使用 RAG 時,你需要同時調整檢索和 LLM 行為
- 使用微調時,每次進一步調校都需要重新執行微調流程,並管理訓練集與驗證集。
這兩種流程都可能耗時且複雜,隨著 LLM 應用程式越來越複雜,還可能導致原本正常的功能退步。如果本文只讓你記住一件事,那就是在採用更複雜的 RAG 或微調之前,先盡可能利用基本方法提高準確度。應以達到目標準確度為依歸,而不是因為 RAG + FT 被視為最先進的方法,就急著採用。
準確度要多高,才「足以」用於正式環境
調整 LLM 以提高準確度,可能是一場沒有終點的戰役;僅靠現成方法,不太可能達到 99.999% 的準確度。本節將探討如何判斷準確度何時已經足夠:如何放心地將 LLM 用於正式環境,以及如何管理所推出解決方案的風險。
我認為,同時從 商業 與 技術 角度思考這個問題很有幫助。接下來,我會概述這兩個面向的管理方法,並以客服支援台為例,說明如何管理兩方面的風險。
商業
對企業而言,習慣了以規則為基礎的系統、傳統機器學習系統,甚至人工處理所帶來的相對確定性之後,要信任 LLM 並不容易!面對一個可能以各種無法預料的方式出錯的系統,確實很難找到妥善的應對之道。
我曾看過一種方法在客服使用案例中奏效。我們當時採取了以下做法:
首先,我們找出主要的成功與失敗情境,並估算各自的成本。這樣就能根據試行結果,清楚說明這個解決方案可能節省多少費用,或產生多少成本。
- 例如,原本由人工解決的案件改由 AI 解決,可能節省 $20。
- 若將客戶不必要地轉交人工處理,可能產生 $40 的成本
- 最糟的情況是,客戶對 AI 極度不滿而流失,造成 $1000 的損失。我們假設有 5% 的案件會發生這種情況。
| 事件 | 價值 | 案件數 | 總價值 |
|---|---|---|---|
| AI 成功 | +20 | 815 | $16,300 |
| AI 失敗(轉交人工) | -40 | 175.75 | $7,030 |
| AI 失敗(客戶流失) | -1000 | 9.25 | $9,250 |
| 結果 | +20 | ||
| 損益兩平所需的準確度 | 81.5% |
我們也蒐集了流程中的實際統計數據,幫助衡量解決方案的整體影響。同樣以客服為例,這些數據可以包括:
- 純人工互動與 AI 互動的 CSAT 分數比較
- 透過事後審查案例,比較人工與 AI 的決策準確率
- 人工與 AI 解決問題所需的時間
在客服案例中,我們先進行了幾次試行以取得明確的資料,再根據這些資料做出兩項關鍵決策:
- 即使我們的 LLM 解決方案轉交人工處理的次數比預期多,與現有方案相比,仍大幅節省了營運成本。這表示,只要那 15% 的錯誤主要是提早轉交人工處理,即使準確率只有 85%,也可能可以接受。
- 對於出錯代價極高的情況,例如詐欺案件處理錯誤,我們決定由人工主導,AI 則擔任助手。在這種情況下,決策準確率的統計資料讓我們判斷,還無法放心讓 AI 完全自主處理。
技術面
技術面的方向就更明確了。既然業務團隊已清楚了解預期價值與出錯的代價,你的任務就是建構一套解決方案,能在不打斷使用者體驗的情況下,妥善處理失敗。
讓我們再次以客服案例說明,並假設模型判斷意圖的準確率為 85%。身為技術團隊,我們可以透過以下幾種方式,盡量降低那 15% 錯誤的影響:
- 我們可以透過提示工程,讓模型在信心不足時請客戶提供更多資訊。這樣一來,首次判斷的準確率可能會下降,但若有 2 次機會判斷意圖,整體準確率可能會更高。
- 我們可以讓第二線助手選擇將案件退回意圖判斷階段,讓使用流程有機會自行修正,代價是使用者需要多等一些時間。
- 我們可以透過提示工程,讓模型在意圖不明確時轉交人工處理。這會使短期內節省的營運成本減少,但長期而言,可能有助於降低客戶流失的風險。
這些決策也會影響使用者體驗:可能需要以更長的等待時間換取更高的準確率,或增加人工介入。這些影響都會反映在前述業務面章節的成本模型中。
現在,你已掌握一套方法,能拆解設定準確率目標時涉及的業務與技術決策,讓目標符合實際業務情況。
付諸實踐
以上概述了一套思考框架,協助你思考如何盡可能提高 LLM 的準確率、可以使用哪些工具,以及如何判斷準確率是否已足以投入正式環境。你已具備穩定推進至正式環境所需的框架與工具。如果想從他人運用這些方法的成果中獲得啟發,可以參考我們的客戶案例。Morgan Stanley 和 Klarna 等使用案例,展現了運用這些技術能達成的成果。
祝你一切順利,我們很期待看到你運用這些方法打造的成果!