透過 WebRTC 或 WebSocket 連上 Realtime API 後,即可呼叫 Realtime 模型(例如 gpt-realtime-2.1)進行語音到語音對話。你需要傳送用戶端事件來啟動操作,並監聽伺服器事件,以便在 Realtime API 執行操作時做出相應處理。
本指南說明使用模型功能時所需的事件流程,包括生成音訊與文字、圖片輸入及函式呼叫,也會介紹如何理解 Realtime 工作階段的狀態。
如果你不需要與模型對話,也就是不預期模型給予任何回應,可以使用 Realtime API 的轉錄模式。
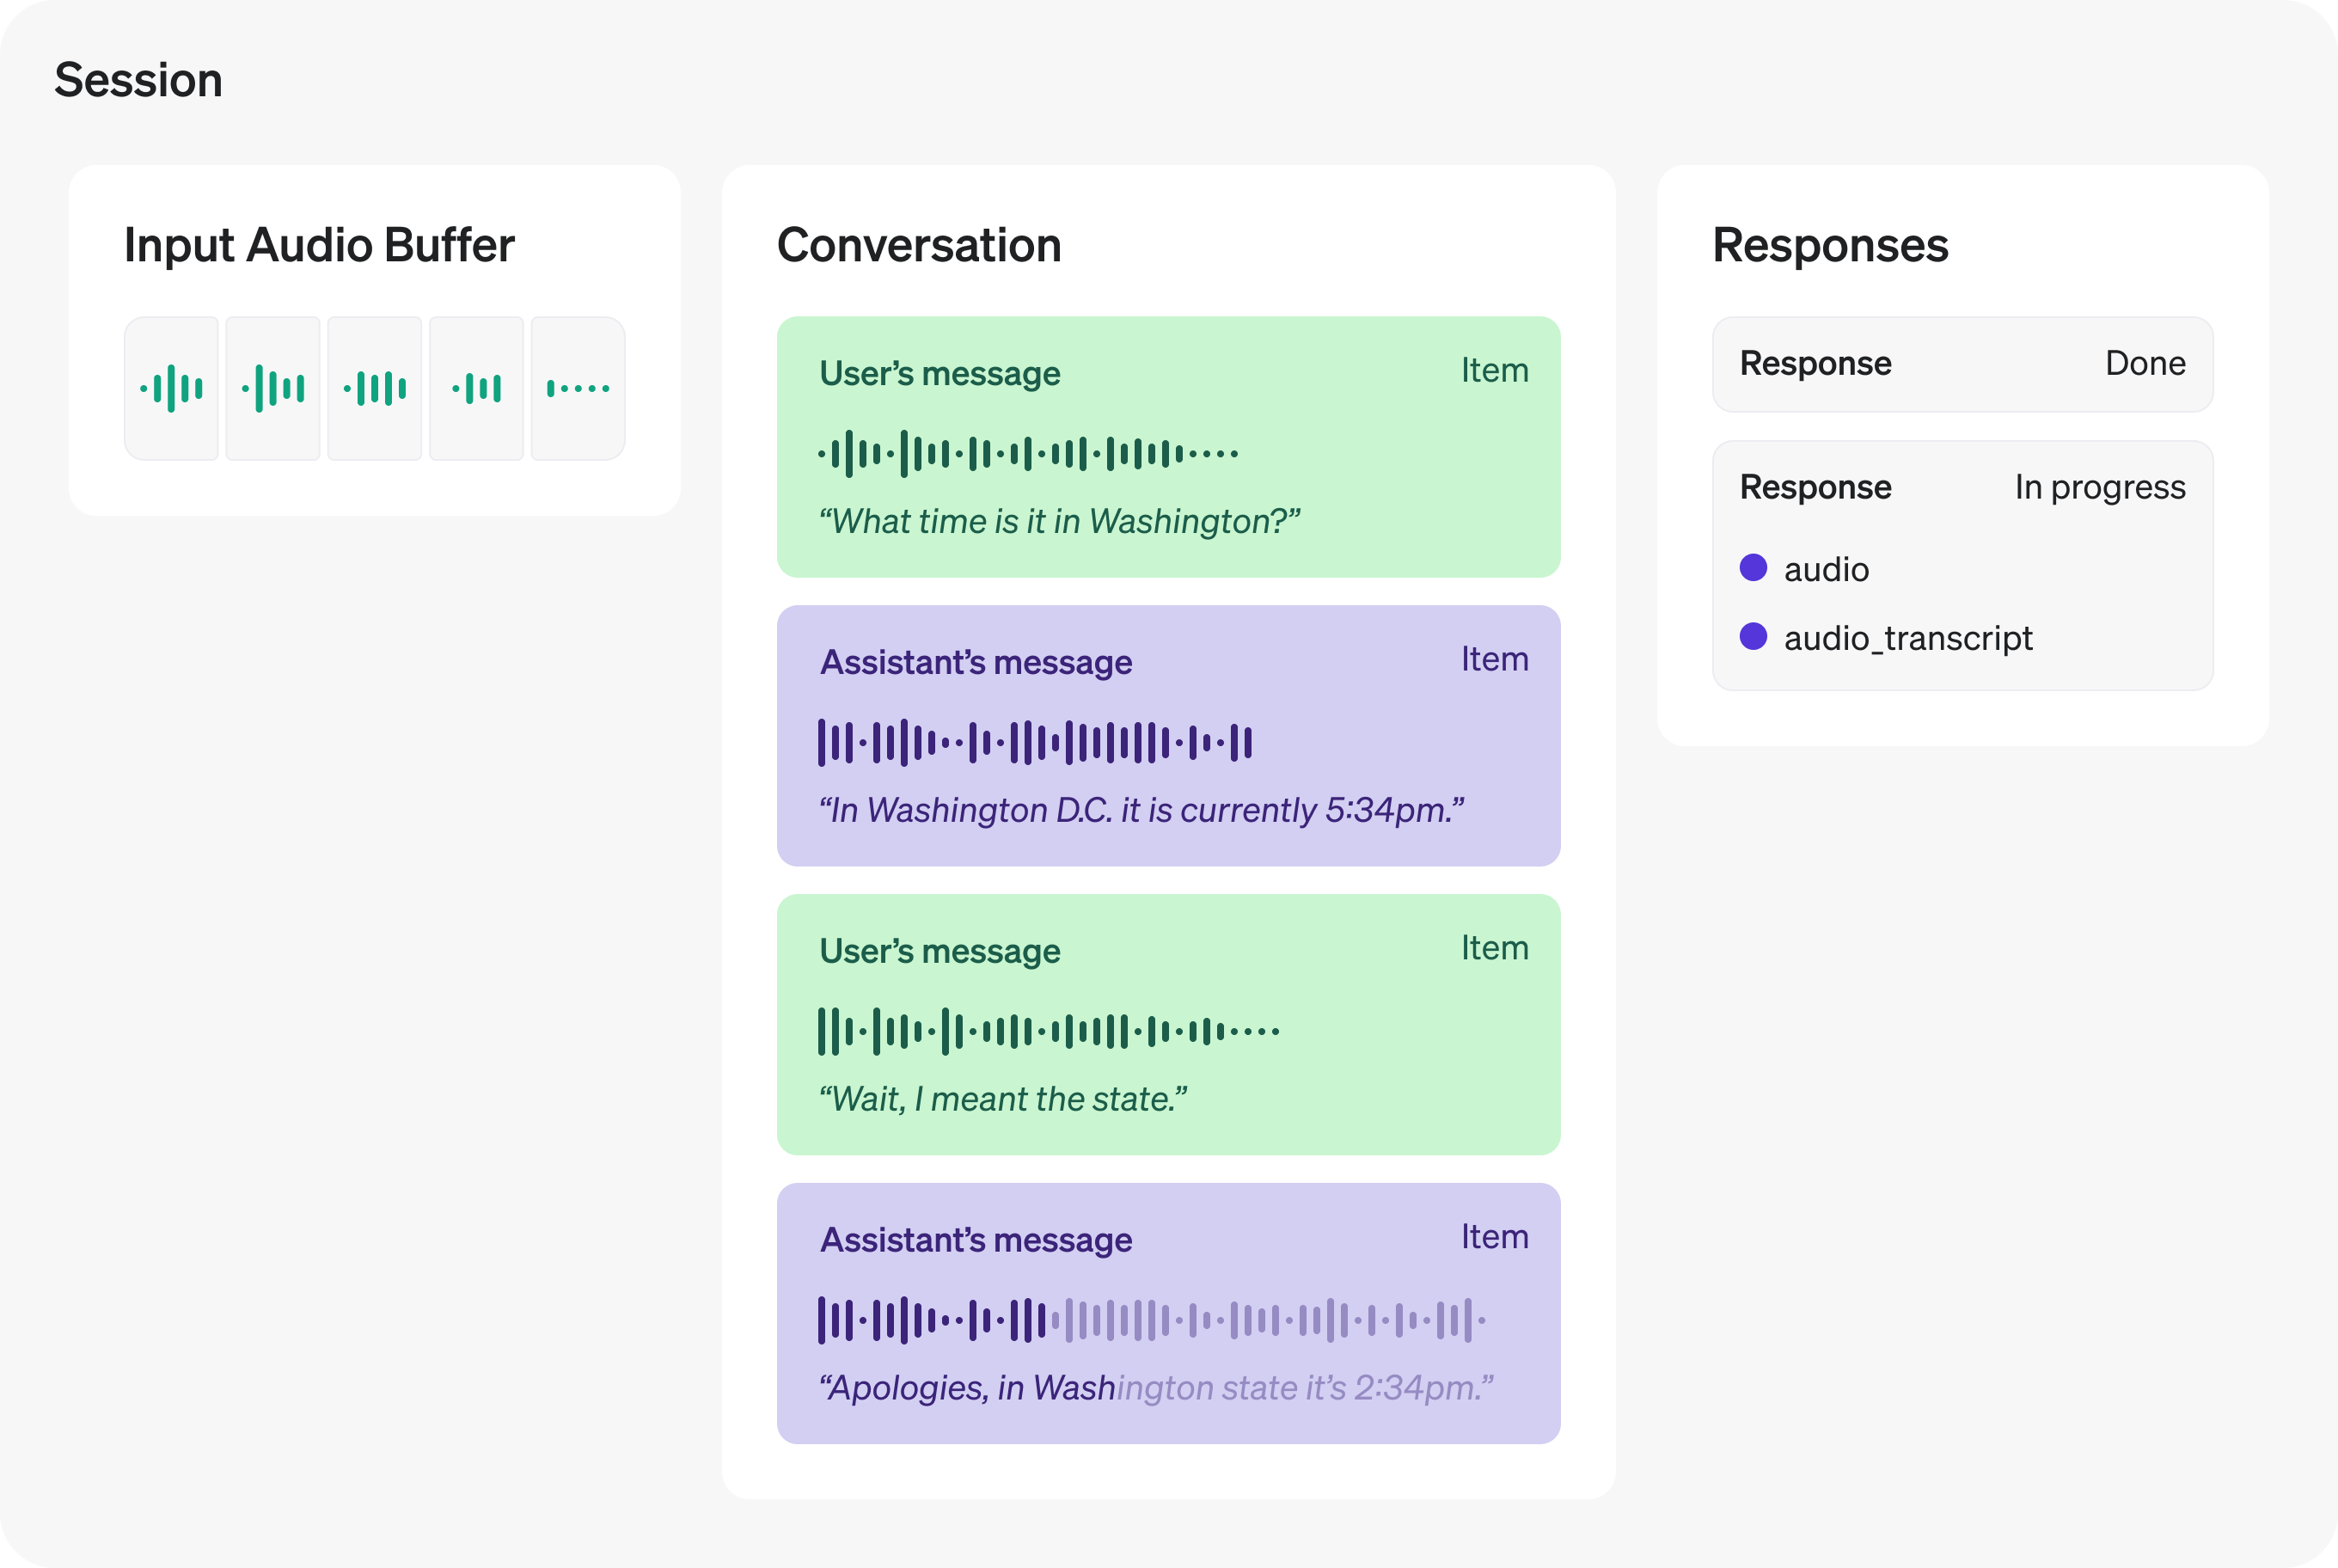
Realtime 工作階段是模型與已連線用戶端之間一段會保留狀態的互動。工作階段的主要組成部分如下:
- 工作階段物件控制互動參數,包括使用哪個模型、產生音訊輸出時使用的聲音,以及其他設定。
- 對話包含目前工作階段中的使用者輸入項目,以及模型產生的輸出項目。
- 回應是模型產生的音訊或文字項目,會加入對話中。
輸入音訊緩衝區與 WebSocket
如果使用 WebRTC,WebRTC API 可協助處理與模型收發音訊時所需的大部分媒體操作。
如果使用 WebSocket 傳輸音訊,則需要手動操作輸入音訊緩衝區:將音訊以 Base64 編碼,再透過 JSON 事件傳送至伺服器。
這些部分共同構成 Realtime 工作階段。你可以使用用戶端事件更新工作階段的狀態,並監聽伺服器事件,以便在狀態變更時做出相應處理。
透過 WebRTC 或 WebSocket 啟動工作階段後,伺服器會傳送 session.created 事件,表示工作階段已就緒。在用戶端,你可以使用 session.update 事件更新目前工作階段的設定。大部分工作階段屬性都可以隨時更新,唯有模型輸出音訊時使用的 voice,在模型首次以音訊回應後,就無法在該工作階段中變更。Realtime 工作階段最長可持續 60 分鐘。
以下範例示範如何使用 session.update 用戶端事件更新工作階段。如需瞭解如何透過這些通道傳送用戶端事件,請參閱 WebRTC 或 WebSocket 指南。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41const event = {
  type: "session.update",
  session: {
    type: "realtime",
    model: "gpt-realtime-2.1",
    // Lock the output to audio (set to ["text"] if you want text without audio)
    output_modalities: ["audio"],
    audio: {
      input: {
        format: {
          type: "audio/pcm",
          rate: 24000,
        },
        turn_detection: {
          type: "semantic_vad",
        },
      },
      output: {
        format: {
          type: "audio/pcm",
          rate: 24000,
        },
        voice: "marin",
      },
    },
    // Use a server-stored prompt by ID. Optionally pin a version and pass variables.
    prompt: {
      id: "pmpt_123", // your stored prompt ID
      version: "89", // optional: pin a specific version
      variables: {
        city: "Paris", // example variable used by your prompt
      },
    },
    // You can still set direct session fields; these override prompt fields if they overlap:
    instructions:
      "Speak clearly and briefly. Confirm understanding before taking actions.",
  },
};

// WebRTC data channel and WebSocket both have .send()
dataChannel.send(JSON.stringify(event));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35event = {
    "type": "session.update",
    "session": {
        "type": "realtime",
        "model": "gpt-realtime-2.1",
        # Choose ["audio"] or ["text"]; do not combine them.
        "output_modalities": ["audio"],
        "audio": {
            "input": {
                "format": {
                    "type": "audio/pcm",
                    "rate": 24000,
                },
                "turn_detection": {"type": "semantic_vad"},
            },
            "output": {
                "format": {
                    "type": "audio/pcmu",
                },
                "voice": "marin",
            },
        },
        # Use a server-stored prompt by ID. Optionally pin a version and pass variables.
        "prompt": {
            "id": "pmpt_123",  # Your stored prompt ID.
            "version": "89",  # Optional: pin a specific version.
            "variables": {
                "city": "Paris",  # Example variable used by your prompt.
            },
        },
        # Direct session fields override prompt fields if they overlap.
        "instructions": "Speak clearly and briefly. Confirm understanding before taking actions.",
    },
}
ws.send(json.dumps(event))
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40// Replace pmpt_123 and 89 with an existing saved prompt and version.
// The saved prompt must define the city variable.
if err := conn.Send(ctx, realtime.RealtimeClientEventParamOfSessionUpdate(realtime.RealtimeSessionCreateRequestParam{
	Model: "gpt-realtime-2.1",
	Prompt: responses.ResponsePromptParam{
		ID:      "pmpt_123",
		Version: openai.String("89"),
		Variables: map[string]responses.ResponsePromptVariableUnionParam{
			"city": {
				OfString: openai.String("Paris"),
			},
		},
	},
	OutputModalities: []string{"audio"},
	Instructions:     openai.String("Speak clearly and briefly. Confirm before taking action."),
	Audio: realtime.RealtimeAudioConfigParam{
		Input: realtime.RealtimeAudioConfigInputParam{
			Format: realtime.RealtimeAudioFormatsUnionParam{
				OfAudioPCM: &realtime.RealtimeAudioFormatsAudioPCMParam{
					Rate: 24000,
				},
			},
			TurnDetection: realtime.RealtimeAudioInputTurnDetectionUnionParam{
				OfSemanticVad: &realtime.RealtimeAudioInputTurnDetectionSemanticVadParam{},
			},
		},
		Output: realtime.RealtimeAudioConfigOutputParam{
			Format: realtime.RealtimeAudioFormatsUnionParam{
				OfAudioPCM: &realtime.RealtimeAudioFormatsAudioPCMParam{
					Rate: 24000,
				},
			},
			Voice: realtime.RealtimeAudioConfigOutputVoiceUnionParam{
				OfString: openai.String("marin"),
			},
		},
	},
})); err != nil {
	return err
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48import com.openai.client.okhttp.OkHttpClient;
import com.openai.core.ClientOptions;
import com.openai.core.JsonValue;
import com.openai.helpers.RealtimeConnection;
import com.openai.helpers.RealtimeWebSocketOptions;
import com.openai.models.realtime.*;

// Replace pmpt_123 with your stored prompt ID.
var pcm =
    RealtimeAudioFormats.AudioPcm.builder()
        .type(RealtimeAudioFormats.AudioPcm.Type.AUDIO_PCM)
        .rate(RealtimeAudioFormats.AudioPcm.Rate._24000)
        .build();
connection.send(
    RealtimeClientEvent.ofSessionUpdate(
        SessionUpdateEvent.builder()
            .session(
                RealtimeSessionCreateRequest.builder()
                    .model("gpt-realtime-2.1")
                    .addOutputModality(RealtimeSessionCreateRequest.OutputModality.AUDIO)
                    .audio(
                        RealtimeAudioConfig.builder()
                            .input(
                                RealtimeAudioConfigInput.builder()
                                    .format(pcm)
                                    .turnDetection(
                                        RealtimeAudioInputTurnDetection.SemanticVad.builder()
                                            .build())
                                    .build())
                            .output(
                                RealtimeAudioConfigOutput.builder()
                                    .format(pcm)
                                    .voice("marin")
                                    .build())
                            .build())
                    .prompt(
                        com.openai.models.responses.ResponsePrompt.builder()
                            .id("pmpt_123")
                            .version("89")
                            .variables(
                                com.openai.models.responses.ResponsePrompt.Variables.builder()
                                    .putAdditionalProperty("city", JsonValue.from("Paris"))
                                    .build())
                            .build())
                    .instructions(
                        "Speak clearly and briefly. Confirm understanding before taking actions.")
                    .build())
            .build()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28# Replace the illustrative IDs and URLs below with your own resource values.
connection.session.update(
  type: :realtime,
  model: "gpt-realtime-2.1",
  output_modalities: [:audio],
  audio: {
    input: {
      format: {
        type: :"audio/pcm",
        rate: 24_000
      },
      turn_detection: { type: :semantic_vad }
    },
    output: {
      format: {
        type: :"audio/pcm",
        rate: 24_000
      },
      voice: :marin
    }
  },
  prompt: {
    id: "pmpt_123",
    version: "89",
    variables: { city: "Paris" }
  },
  instructions: "Speak clearly and briefly. Confirm before taking action."
)
工作階段更新後,伺服器會發出 session.updated 事件,其中包含工作階段的新狀態。
若要使用 Realtime 模型生成文字,可以將文字輸入加入目前的對話,要求模型生成回應,並監聽伺服器傳送的事件以掌握回應進度。若要生成文字,工作階段必須設定為支援 text 模態(預設已啟用)。
使用 conversation.item.create 用戶端事件建立新的文字對話項目。這類似於透過 REST API 在 Chat Completions 中傳送使用者訊息(提示詞)。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16const event = {
  type: "conversation.item.create",
  item: {
    type: "message",
    role: "user",
    content: [
      {
        type: "input_text",
        text: "What Prince album sold the most copies?",
      },
    ],
  },
};

// WebRTC data channel and WebSocket both have .send()
ws.send(JSON.stringify(event));
1
2
3
4
5
6
7
8
9
10
11
12
13
14event = {
    "type": "conversation.item.create",
    "item": {
        "type": "message",
        "role": "user",
        "content": [
            {
                "type": "input_text",
                "text": "What Prince album sold the most copies?",
            }
        ],
    },
}
ws.send(json.dumps(event))
1
2
3
4
5
6
7
8
9
10if err := conn.Send(ctx, realtime.RealtimeClientEventParamOfConversationItemCreate(realtime.RealtimeConversationItemUserMessageParam{
	Content: []realtime.RealtimeConversationItemUserMessageContentParam{
		{
			Text: openai.String("What Prince album sold the most copies?"),
			Type: "input_text",
		},
	},
})); err != nil {
	return err
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20import com.openai.client.okhttp.OkHttpClient;
import com.openai.core.ClientOptions;
import com.openai.core.JsonMissing;
import com.openai.helpers.RealtimeConnection;
import com.openai.helpers.RealtimeWebSocketOptions;
import com.openai.models.realtime.*;

connection.send(
    RealtimeClientEvent.ofConversationItemCreate(
        ConversationItemCreateEvent.builder()
            .item(
                RealtimeConversationItemUserMessage.builder()
                    .object_(JsonMissing.of())
                    .addContent(
                        RealtimeConversationItemUserMessage.Content.builder()
                            .type(RealtimeConversationItemUserMessage.Content.Type.INPUT_TEXT)
                            .text("What Prince album sold the most copies?")
                            .build())
                    .build())
            .build()));
1
2
3
4
5
6
7using OpenAI.Realtime;

#pragma warning disable OPENAI002

RealtimeMessageItem item = RealtimeItem.CreateUserMessageItem("What Prince album sold the most copies?");
item.Id = Guid.NewGuid().ToString("N");
await session.SendCommandAsync(new RealtimeClientCommandConversationItemCreate(item), timeout.Token);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18connection.conversation.items.create(
  type: :message,
  role: :user,
  content: [
    {
      type: :input_text,
      text: "What is the weather like today?"
    }
  ]
)

receipt = connection.find do |event|
  raise event.error.message if event.is_a?(OpenAI::Realtime::RealtimeErrorEvent)
  next unless event.is_a?(OpenAI::Realtime::ConversationItemDone)

  event.item.is_a?(OpenAI::Realtime::RealtimeConversationItemUserMessage)
end
raise "Connection closed before the conversation item was acknowledged" unless receipt
將使用者訊息加入對話後,傳送 response.create 事件,讓模型開始生成回應。請選擇一種輸出模態:audio 會產生音訊及其轉錄文字,text 則只會產生文字。如果只需要文字,可以在傳送 response.create 用戶端事件時指定,如下所示。
1
2
3
4
5
6
7
8
9const event = {
  type: "response.create",
  response: {
    output_modalities: ["text"],
  },
};

// WebRTC data channel and WebSocket both have .send()
ws.send(JSON.stringify(event));
1
2event = {"type": "response.create", "response": {"output_modalities": ["text"]}}
ws.send(json.dumps(event))
1
2
3
4
5
6
7
8
9if err := conn.Send(ctx, realtime.RealtimeClientEventUnionParam{
	OfResponseCreate: &realtime.ResponseCreateEventParam{
		Response: realtime.RealtimeResponseCreateParams{
			OutputModalities: []string{"text"},
		},
	},
}); err != nil {
	return err
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14import com.openai.client.okhttp.OkHttpClient;
import com.openai.core.ClientOptions;
import com.openai.helpers.RealtimeConnection;
import com.openai.helpers.RealtimeWebSocketOptions;
import com.openai.models.realtime.*;

connection.send(
    RealtimeClientEvent.ofResponseCreate(
        ResponseCreateEvent.builder()
            .response(
                RealtimeResponseCreateParams.builder()
                    .addOutputModality(RealtimeResponseCreateParams.OutputModality.TEXT)
                    .build())
            .build()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14using OpenAI.Realtime;

#pragma warning disable OPENAI002

await session.SendCommandAsync(new RealtimeClientCommandResponseCreate
{
    ResponseOptions = new()
    {
        OutputModalities =
        {
            RealtimeOutputModality.Text
        }
    }
}, timeout.Token);
1
2
3
4
5
6
7
8
9
10
11
12
13
14connection.response.create(
  output_modalities: [:text],
  instructions: "Respond with a concise text message."
)

response_done = connection.find do |event|
  raise event.error.message if event.is_a?(OpenAI::Realtime::RealtimeErrorEvent)
  next unless event.is_a?(OpenAI::Realtime::ResponseDoneEvent)

  raise "Response failed: #{event.response.status}" unless event.response.status == :completed

  true
end
raise "Connection closed before the response completed" unless response_done
回應全部生成完畢後,伺服器會發出 response.done 事件。此事件包含模型生成的完整文字,如下所示。
1
2
3
4
5
6
7
8
9
10
11
12
13function handleEvent(message: import("ws").RawData | MessageEvent<string>) {
  const data = "data" in message ? message.data : message.toString();
  const serverEvent = JSON.parse(data);
  if (serverEvent.type === "response.done") {
    console.log(serverEvent.response.output[0]);
  }
}

// Listen for server messages (WebRTC)
// dataChannel.addEventListener("message", handleEvent);

// Listen for server messages (WebSocket)
ws.on("message", handleEvent);
1
2
3
4def on_message(ws, message):
    server_event = json.loads(message)
    if server_event["type"] == "response.done":
        print(server_event["response"]["output"][0])
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31func receiveUntil(ctx context.Context, conn *realtime.RealtimeConnection, terminal string) (realtime.RealtimeServerEventUnion, error) {
	for {
		event, err := conn.Recv(ctx)
		if err != nil {
			return event, fmt.Errorf("waiting for %s: %w", terminal, err)
		}
		if event.Type == "error" {
			return event, fmt.Errorf("Realtime API error: %s", event.OfRealtimeErrorEvent.Error.Message)
		}
		if event.Type == "response.done" && event.OfResponseDoneEvent.Response.Status != "completed" {
			return event, fmt.Errorf("response ended with status %s", event.OfResponseDoneEvent.Response.Status)
		}
		if event.Type == "response.done" {
			response := event.OfResponseDoneEvent.Response
			fmt.Println("Response status:", response.Status)
			for _, output := range response.Output {
				item := output.OfRealtimeConversationItemAssistantMessage
				if item.Type == "message" {
					for _, content := range item.Content {
						if content.Type == "output_text" {
							fmt.Print(content.Text)
						}
					}
				}
			}
		}
		if event.Type == terminal {
			return event, nil
		}
	}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23import com.openai.client.okhttp.OkHttpClient;
import com.openai.core.ClientOptions;
import com.openai.helpers.RealtimeConnection;
import com.openai.helpers.RealtimeWebSocketOptions;
import com.openai.models.realtime.*;

static void handleEvent(RealtimeServerEvent event) {
  event
      .responseDone()
      .ifPresent(
          done -> {
            if (!done.response()
                .status()
                .filter(RealtimeResponse.Status.COMPLETED::equals)
                .isPresent())
              throw new IllegalStateException(
                  "Response ended with status "
                      + done.response().status()
                      + ": "
                      + done.response().statusDetails());
            System.out.println(done.response().output());
          });
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14using OpenAI.Realtime;

#pragma warning disable OPENAI002

internal static void HandleEvent(RealtimeServerUpdate update)
{
    if (update is RealtimeServerUpdateResponseDone completion && completion.Response.Status != RealtimeResponseStatus.Completed)
        throw new InvalidOperationException($"Response ended with status {completion.Response.Status}: {System.ClientModel.Primitives.ModelReaderWriter.Write(completion.Response)}");
    if (update is RealtimeServerUpdateResponseDone done)
    {
        foreach (RealtimeItem item in done.Response.OutputItems)
            Console.WriteLine(System.ClientModel.Primitives.ModelReaderWriter.Write(item));
    }
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14response_done = connection.find do |event|
  next unless event.is_a?(OpenAI::Realtime::ResponseDoneEvent)

  puts("Response status: #{event.response.status}")
  Array(event.response.output).each do |item|
    next unless item.is_a?(OpenAI::Realtime::RealtimeConversationItemAssistantMessage)

    item.content.each do |content|
      puts(content.text) if content.type == :output_text
    end
  end
  true
end
raise "Connection closed before the response completed" unless response_done
模型生成回應的過程中,伺服器會發出一系列生命週期事件。你可以監聽 response.output_text.delta 等事件,在生成回應時即時向使用者顯示進度。下表的相關伺服器事件欄列出伺服器發出的所有事件,大致依發出順序排列。表中也列出生成文字時相關的用戶端事件。
Realtime API 的一項強大功能,是讓使用者直接以語音與模型互動,無須經過文字轉語音或語音轉文字的中間步驟。這能降低語音介面的延遲,也讓模型能運用語音輸入中的更多資訊,例如說話者的語氣與音調變化。
Realtime 工作階段提供多種內建聲音,可選擇其中一種產生音訊輸出。你可以設定 voice 來決定模型說話的聲音。這項設定可在建立工作階段時指定,也可在 response.create 事件中指定。目前可選用 alloy、ash、ballad、coral、echo、sage、shimmer、verse、marin 和 cedar。模型一旦在工作階段中輸出音訊,就無法再變更該工作階段的 voice。如需最佳音質,建議使用 marin 或 cedar。
使用 WebRTC 連上 Realtime API 時,Realtime API 會與用戶端建立對等連線。模型輸出的音訊會以遠端媒體串流傳送至用戶端。傳給模型的音訊則透過音訊裝置擷取(使用 getUserMedia),再將媒體串流以軌道的形式加入對等連線。
WebRTC 連線指南中的下列程式碼示範如何使用瀏覽器 API 設定本機與遠端音訊:
1
2
3
4
5
6
7
8
9
10
11
12
13// Create a peer connection
const pc = new RTCPeerConnection();

// Set up to play remote audio from the model
const audioEl = document.createElement("audio");
audioEl.autoplay = true;
pc.ontrack = (e) => (audioEl.srcObject = e.streams[0]);

// Add local audio track for microphone input in the browser
const ms = await navigator.mediaDevices.getUserMedia({
  audio: true,
});
pc.addTrack(ms.getTracks()[0]);
使用上述程式碼即可與 Realtime API 互動。若要進一步探索不同類型的使用者介面,可參閱 WebRTC 範例程式碼庫,也可以線上體驗這些範例。
使用瀏覽器的媒體擷取與串流 API,就能開啟或關閉麥克風、選擇擷取輸入的裝置,以及執行其他操作。
依預設,WebRTC 用戶端在傳送音訊輸入前,無須向 Realtime API 傳送任何用戶端事件。只要將本機音軌加入對等連線,使用者就可以開始說話。
不過,當用戶端與伺服器透過對等連線收發音訊時,WebRTC 用戶端仍會收到伺服器發出的一系列生命週期事件,例如:
使用 WebRTC API 操作媒體串流,可能就足以滿足你的控制需求。不過,有時仍需要透過較低階的介面處理音訊輸入與輸出。下方的 WebSocket 一節提供更多資訊,並列出精細控制音訊輸入所需的事件。
透過 WebSocket 收發音訊時,用戶端需要執行更多操作,才能將媒體傳給伺服器並接收伺服器傳回的媒體。下表列出在 WebSocket 工作階段中收發音訊所需的事件流程。
下列事件依生命週期順序排列,但有些事件(例如 delta 事件)可能同時發生。
若要將音訊輸入串流傳送至伺服器,可以使用 input_audio_buffer.append 用戶端事件。使用此事件時,需要透過 WebSocket 將以 Base64 編碼的音訊位元組分段傳送至 Realtime API。每段大小不得超過 15 MB。
請設定 session.audio.input.format,並透過 session.update 套用設定。若使用 PCM,請指定 {"type": "audio/pcm", "rate": 24000},並傳送 24 kHz 的單聲道音訊。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77import fs from "fs";
import decodeAudio from "audio-decode";

// Converts Float32Array of audio data to PCM16 ArrayBuffer
function floatTo16BitPCM(float32Array: Float32Array) {
  const buffer = new ArrayBuffer(float32Array.length * 2);
  const view = new DataView(buffer);
  let offset = 0;
  for (let i = 0; i < float32Array.length; i++, offset += 2) {
    const sample = Math.max(-1, Math.min(1, float32Array[i]));
    view.setInt16(
      offset,
      Math.round(sample * (sample < 0 ? 0x8000 : 0x7fff)),
      true
    );
  }
  return buffer;
}

// Converts a Float32Array to base64-encoded PCM16 data
function base64EncodeAudio(float32Array: Float32Array<ArrayBufferLike>) {
  const arrayBuffer = floatTo16BitPCM(float32Array);
  let binary = "";
  let bytes = new Uint8Array(arrayBuffer);
  const chunkSize = 0x8000; // 32KB chunk size
  for (let i = 0; i < bytes.length; i += chunkSize) {
    let chunk = bytes.subarray(i, i + chunkSize);
    binary += String.fromCharCode(...chunk);
  }
  return btoa(binary);
}

// Fills the audio buffer with the contents of three files,
// then asks the model to generate a response.
const files = [
  "fixtures/sample1.wav",
  "fixtures/sample2.wav",
  "fixtures/sample3.wav",
];

// Manual commit and response creation require automatic turn detection off.
ws.send(
  JSON.stringify({
    type: "session.update",
    session: {
      type: "realtime",
      audio: { input: { turn_detection: null } },
    },
  })
);

for (const filename of files) {
  const audioFile = fs.readFileSync(filename);
  const audioBuffer = await decodeAudio(audioFile);
  if (
    audioBuffer.sampleRate !== 24000 ||
    audioBuffer.channelData.length !== 1
  ) {
    throw new Error("Expected 24 kHz mono audio: " + filename);
  }
  const channelData = audioBuffer.channelData[0];
  const base64Chunk = base64EncodeAudio(channelData);
  ws.send(
    JSON.stringify({
      type: "input_audio_buffer.append",
      audio: base64Chunk,
    })
  );
}

ws.send(JSON.stringify({ type: "input_audio_buffer.commit" }));
ws.send(
  JSON.stringify({
    type: "response.create",
    response: { output_modalities: ["audio"] },
  })
);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32import base64
import json
import struct
import soundfile as sf
from websocket import create_connection

# ... create websocket-client named ws ...


def float_to_16bit_pcm(float32_array):
    clipped = [max(-1.0, min(1.0, x)) for x in float32_array]
    pcm16 = b"".join(struct.pack("<h", min(32767, int(x * 32768))) for x in clipped)
    return pcm16


def base64_encode_audio(float32_array):
    pcm_bytes = float_to_16bit_pcm(float32_array)
    encoded = base64.b64encode(pcm_bytes).decode("ascii")
    return encoded


files = ["./path/to/sample1.wav", "./path/to/sample2.wav", "./path/to/sample3.wav"]

for filename in files:
    data, samplerate = sf.read(filename, dtype="float32")
    if samplerate != 24000 or data.ndim != 1:
        raise ValueError(f"Expected 24 kHz mono audio: {filename}")
    base64_chunk = base64_encode_audio(data)

    # Send the client event
    event = {"type": "input_audio_buffer.append", "audio": base64_chunk}
    ws.send(json.dumps(event))
1
2
3
4
5
6
7// audio contains mono PCM16 samples at 24 kHz.
for start := 0; start < len(audio); start += 9600 {
	end := min(start+9600, len(audio))
	if err := conn.Send(ctx, realtime.RealtimeClientEventParamOfInputAudioBufferAppend(base64.StdEncoding.EncodeToString(audio[start:end]))); err != nil {
		return err
	}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30import com.openai.client.okhttp.OkHttpClient;
import com.openai.core.ClientOptions;
import com.openai.helpers.RealtimeConnection;
import com.openai.helpers.RealtimeWebSocketOptions;
import com.openai.models.realtime.*;
import java.util.Base64;

// Call for each PCM16, 24 kHz, mono chunk supplied by your audio source.
static void appendAudio(RealtimeConnection connection, byte[] pcmAudio) throws Exception {
  String base64Audio = Base64.getEncoder().encodeToString(pcmAudio);
  send(
      connection,
      RealtimeClientEvent.ofInputAudioBufferAppend(
          InputAudioBufferAppendEvent.builder().audio(base64Audio).build()));
}

// Retry only explicit admission rejections; these guarantee nothing was sent.
private static void send(RealtimeConnection connection, RealtimeClientEvent event)
    throws Exception {
  long deadline = System.nanoTime() + java.util.concurrent.TimeUnit.SECONDS.toNanos(5);
  while (true) {
    try {
      connection.send(event);
      return;
    } catch (com.openai.core.http.WebSocketWriteNotAttempted.Busy busy) {
      if (System.nanoTime() >= deadline) throw busy;
      Thread.sleep(10);
    }
  }
}
1
2
3
4
5
6
7
8
9using OpenAI.Realtime;

#pragma warning disable OPENAI002

// Call for each PCM16, 24 kHz, mono chunk supplied by your audio source.
internal static async Task AppendAudioAsync(RealtimeSessionClient session, BinaryData pcmAudio, CancellationToken cancellationToken)
{
    await session.SendCommandAsync(new RealtimeClientCommandInputAudioBufferAppend(pcmAudio), cancellationToken);
}
1
2
3
4
5File.open("speech.pcm", "rb") do |audio|
  while (chunk = audio.read(9_600))
    connection.input_audio_buffer.append_bytes(chunk)
  end
end
你也可以用整段錄音建立對話訊息。使用 conversation.item.create 用戶端事件,即可建立包含 input_audio 內容的訊息。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18const fullAudio = "<a base64-encoded string of audio bytes>";

const event = {
  type: "conversation.item.create",
  item: {
    type: "message",
    role: "user",
    content: [
      {
        type: "input_audio",
        audio: fullAudio,
      },
    ],
  },
};

// WebRTC data channel and WebSocket both have .send()
dataChannel.send(JSON.stringify(event));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17fullAudio = "<a base64-encoded string of audio bytes>"

event = {
    "type": "conversation.item.create",
    "item": {
        "type": "message",
        "role": "user",
        "content": [
            {
                "type": "input_audio",
                "audio": fullAudio,
            }
        ],
    },
}

ws.send(json.dumps(event))
1
2
3
4
5
6
7
8
9
10if err := conn.Send(ctx, realtime.RealtimeClientEventParamOfConversationItemCreate(realtime.RealtimeConversationItemUserMessageParam{
	Content: []realtime.RealtimeConversationItemUserMessageContentParam{
		{
			Audio: openai.String(base64.StdEncoding.EncodeToString(audio)),
			Type:  "input_audio",
		},
	},
})); err != nil {
	return err
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36import com.openai.client.okhttp.OkHttpClient;
import com.openai.core.ClientOptions;
import com.openai.core.JsonMissing;
import com.openai.helpers.RealtimeConnection;
import com.openai.helpers.RealtimeWebSocketOptions;
import com.openai.models.realtime.*;
import java.util.Base64;

// Pass the complete PCM16, 24 kHz, mono recording from your application.
static void sendAudioItem(RealtimeConnection connection, byte[] pcmAudio) throws Exception {
  String fullAudio = Base64.getEncoder().encodeToString(pcmAudio);
  var event =
      RealtimeClientEvent.ofConversationItemCreate(
          ConversationItemCreateEvent.builder()
              .item(
                  RealtimeConversationItemUserMessage.builder()
                      .object_(JsonMissing.of())
                      .addContent(
                          RealtimeConversationItemUserMessage.Content.builder()
                              .type(RealtimeConversationItemUserMessage.Content.Type.INPUT_AUDIO)
                              .audio(fullAudio)
                              .build())
                      .build())
              .build());
  // Retry only explicit admission rejections; these guarantee nothing was sent.
  long deadline = System.nanoTime() + java.util.concurrent.TimeUnit.SECONDS.toNanos(5);
  while (true) {
    try {
      connection.send(event);
      return;
    } catch (com.openai.core.http.WebSocketWriteNotAttempted.Busy busy) {
      if (System.nanoTime() >= deadline) throw busy;
      Thread.sleep(10);
    }
  }
}
1
2
3
4
5
6
7
8
9
10
11
12
13using OpenAI.Realtime;

#pragma warning disable OPENAI002

// Pass the complete PCM16, 24 kHz, mono recording from your application.
internal static async Task<string> SendAudioItemAsync(RealtimeSessionClient session, BinaryData pcmAudio, CancellationToken cancellationToken)
{
    RealtimeMessageItem item = RealtimeItem.CreateUserMessageItem([new RealtimeInputAudioMessageContentPart(pcmAudio)]);
    string itemId = Guid.NewGuid().ToString("N");
    item.Id = itemId;
    await session.SendCommandAsync(new RealtimeClientCommandConversationItemCreate(item), cancellationToken);
    return itemId;
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20audio = Base64.strict_encode64(File.binread("speech.pcm"))

connection.conversation.items.create(
  type: :message,
  role: :user,
  content: [
    {
      type: :input_audio,
      audio: audio
    }
  ]
)

receipt = connection.find do |event|
  raise event.error.message if event.is_a?(OpenAI::Realtime::RealtimeErrorEvent)

  event.is_a?(OpenAI::Realtime::ConversationItemDone) &&
    event.item.is_a?(OpenAI::Realtime::RealtimeConversationItemUserMessage)
end
raise "Connection closed before the audio item was acknowledged" unless receipt
若要在網頁瀏覽器等用戶端環境播放輸出音訊,建議優先使用 WebRTC,而非 WebSocket。在網路狀況不穩定時,WebRTC 能更可靠地將媒體傳送至用戶端裝置。
在伺服器對伺服器的應用程式中,若要使用 WebSocket 處理音訊輸出,需要監聽 response.output_audio.delta 事件。每個事件都包含模型輸出的一段音訊資料,並以 Base64 編碼。你可以先將這些資料存入緩衝區,再寫入檔案,也可以立即將資料串流傳送至其他目的地,例如 Twilio 電話通話。
請注意,response.output_audio.done 和 response.done 事件只包含音訊的轉錄文字,不含音訊資料。若要取得實際的音訊位元組,需要監聽 response.output_audio.delta 事件。
輸出音訊片段的格式可以針對整個工作階段設定,也可以逐一為回應設定。
1
2
3
4
5
6
7
8
9
10function handleEvent(message: { toString: () => string }) {
  const serverEvent = JSON.parse(message.toString());
  if (serverEvent.type === "response.output_audio.delta") {
    const audio = Buffer.from(serverEvent.delta, "base64");
    console.log(`Received ${audio.length} audio bytes`);
  }
}

// Listen for server messages (WebSocket)
ws.on("message", handleEvent);
1
2
3
4
5def on_message(ws, message):
    server_event = json.loads(message)
    if server_event["type"] == "response.output_audio.delta":
        # Access Base64-encoded audio chunks:
        print(server_event["delta"])
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24func receiveUntil(ctx context.Context, conn *realtime.RealtimeConnection, terminal string) (realtime.RealtimeServerEventUnion, error) {
	for {
		event, err := conn.Recv(ctx)
		if err != nil {
			return event, fmt.Errorf("waiting for %s: %w", terminal, err)
		}
		if event.Type == "response.output_audio.delta" {
			audio, err := base64.StdEncoding.DecodeString(event.OfResponseAudioDeltaEvent.Delta)
			if err != nil {
				return event, err
			}
			fmt.Printf("Received %d audio bytes\n", len(audio))
		}
		if event.Type == "error" {
			return event, fmt.Errorf("Realtime API error: %s", event.OfRealtimeErrorEvent.Error.Message)
		}
		if event.Type == "response.done" && event.OfResponseDoneEvent.Response.Status != "completed" {
			return event, fmt.Errorf("response ended with status %s", event.OfResponseDoneEvent.Response.Status)
		}
		if event.Type == terminal {
			return event, nil
		}
	}
}
1
2
3
4
5
6
7
8
9import com.openai.client.okhttp.OkHttpClient;
import com.openai.core.ClientOptions;
import com.openai.helpers.RealtimeConnection;
import com.openai.helpers.RealtimeWebSocketOptions;
import com.openai.models.realtime.*;

static void handleEvent(RealtimeServerEvent event) {
  event.responseOutputAudioDelta().ifPresent(delta -> System.out.println(delta.delta()));
}
1
2
3
4
5
6
7
8
9using OpenAI.Realtime;

#pragma warning disable OPENAI002

internal static void HandleEvent(RealtimeServerUpdate update)
{
    if (update is RealtimeServerUpdateResponseOutputAudioDelta delta)
        Console.WriteLine(Convert.ToBase64String(delta.Delta.ToArray()));
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14response_done = connection.find do |event|
  case event
  when OpenAI::Realtime::ResponseAudioDeltaEvent
    audio_bytes = Base64.strict_decode64(event.delta)
    puts("Received #{audio_bytes.bytesize} audio bytes")
  when OpenAI::Realtime::RealtimeErrorEvent
    raise event.error.message
  when OpenAI::Realtime::ResponseDoneEvent
    raise "Response failed: #{event.response.status}" unless event.response.status == :completed

    true
  end
end
raise "Connection closed before the response completed" unless response_done
gpt-realtime-2 和 gpt-realtime 也支援圖片輸入。你可以在使用者訊息中附上圖片,作為訊息內容的一部分,模型便能在回應時參考圖片內容。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18const base64Image = "<a base64-encoded string of image bytes>";

const event = {
  type: "conversation.item.create",
  item: {
    type: "message",
    role: "user",
    content: [
      {
        type: "input_image",
        image_url: `data:image/{format};base64,${base64Image}`,
      },
    ],
  },
};

// WebRTC data channel and WebSocket both have .send()
dataChannel.send(JSON.stringify(event));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24if err := conn.Send(ctx, realtime.RealtimeClientEventParamOfConversationItemCreate(realtime.RealtimeConversationItemUserMessageParam{
	Content: []realtime.RealtimeConversationItemUserMessageContentParam{
		{
			ImageURL: openai.String("data:image/png;base64," + base64.StdEncoding.EncodeToString(image)),
			Type:     "input_image",
		},
		{
			Text: openai.String("Describe this image."),
			Type: "input_text",
		},
	},
})); err != nil {
	return err
}

if err := conn.Send(ctx, realtime.RealtimeClientEventUnionParam{
	OfResponseCreate: &realtime.ResponseCreateEventParam{
		Response: realtime.RealtimeResponseCreateParams{
			OutputModalities: []string{"text"},
		},
	},
}); err != nil {
	return err
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26encoded_image = Base64.strict_encode64(File.binread("image.png"))

connection.conversation.items.create(
  type: :message,
  role: :user,
  content: [
    {
      type: :input_image,
      image_url: "data:image/png;base64,#{encoded_image}"
    },
    {
      type: :input_text,
      text: "Describe this image."
    }
  ]
)
connection.response.create(output_modalities: [:text])

completion = connection.find do |event|
  raise event.error.message if event.is_a?(OpenAI::Realtime::RealtimeErrorEvent)

  event.is_a?(OpenAI::Realtime::ResponseDoneEvent)
end
unless completion.is_a?(OpenAI::Realtime::ResponseDoneEvent) && completion.response.status == :completed
  raise "The Realtime response did not complete"
end
Realtime 工作階段預設啟用語音活動偵測(VAD)。API 會判斷使用者何時開始或停止說話,並自動回應。
如需瞭解如何設定 VAD,請參閱語音活動偵測指南。
將 turn_detection 設為 null,再透過 session.update 用戶端事件套用設定,即可停用 VAD。這適用於需要精細控制音訊輸入的介面,例如按住說話介面。
停用 VAD 後,用戶端必須手動發出以下額外事件,才能觸發音訊回應:
如果想繼續使用 VAD,但希望自行決定何時生成回應,可以將 turn_detection.interrupt_response 和 turn_detection.create_response 設為 false,再透過 session.update 用戶端事件套用設定。這會保留 VAD 的所有偵測行為,但不會自動建立新的回應。用戶端可以透過 response.create 事件手動觸發回應。
這適用於內容審核、輸入驗證或 RAG 等情境,讓你以稍長的互動延遲換取對輸入的控制。
依預設,在工作階段中生成的所有回應都會加入該工作階段的對話狀態(即「預設對話」)。不過,你可能希望模型在預設對話的上下文之外生成回應,或同時生成多個回應。你也可能希望更精確地控制模型在生成回應時參考哪些對話項目,例如只參考最近 N 輪對話。
將 response.conversation 欄位設為字串 none,再透過 response.create 用戶端事件建立回應,即可生成「帶外」回應。這類回應不會加入預設對話狀態。
建立帶外回應時,通常也需要辨識伺服器傳送的哪些事件與該回應有關。你可以為模型回應提供 metadata,以便辨識模型正在為這個用戶端事件生成哪個回應。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23const prompt = `
Analyze the conversation so far. If it is related to support, output
"support". If it is related to sales, output "sales".
`;

  const event = {
    type: "response.create",
    response: {
      // Setting to "none" indicates the response is out of band
      // and will not be added to the default conversation
      conversation: "none",

      // Set metadata to help identify responses sent back from the model
      metadata: { topic: "classification" },

      // Set any other available response fields
      output_modalities: ["text"],
      instructions: prompt,
    },
  };

  // WebRTC data channel and WebSocket both have .send()
  ws.send(JSON.stringify(event));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20prompt = """
Analyze the conversation so far. If it is related to support, output
"support". If it is related to sales, output "sales".
"""

event = {
    "type": "response.create",
    "response": {
        # Setting to "none" indicates the response is out of band,
        # and will not be added to the default conversation
        "conversation": "none",
        # Set metadata to help identify responses sent back from the model
        "metadata": {"topic": "classification"},
        # Set any other available response fields
        "output_modalities": ["text"],
        "instructions": prompt,
    },
}

ws.send(json.dumps(event))
1
2
3
4
5
6
7
8
9
10
11
12
13
14if err := conn.Send(ctx, realtime.RealtimeClientEventUnionParam{
	OfResponseCreate: &realtime.ResponseCreateEventParam{
		Response: realtime.RealtimeResponseCreateParams{
			Instructions: openai.String("\nAnalyze the conversation so far. If it is related to support, output\n\"support\". If it is related to sales, output \"sales\".\n"),
			Metadata: shared.Metadata{
				"topic": "classification",
			},
			Conversation:     "none",
			OutputModalities: []string{"text"},
		},
	},
}); err != nil {
	return err
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22import com.openai.client.okhttp.OkHttpClient;
import com.openai.core.ClientOptions;
import com.openai.core.JsonValue;
import com.openai.helpers.RealtimeConnection;
import com.openai.helpers.RealtimeWebSocketOptions;
import com.openai.models.realtime.*;

connection.send(
    RealtimeClientEvent.ofResponseCreate(
        ResponseCreateEvent.builder()
            .response(
                RealtimeResponseCreateParams.builder()
                    .conversation("none")
                    .metadata(
                        RealtimeResponseCreateParams.Metadata.builder()
                            .putAdditionalProperty("topic", JsonValue.from("classification"))
                            .build())
                    .addOutputModality(RealtimeResponseCreateParams.OutputModality.TEXT)
                    .instructions(
                        "Analyze the conversation so far. If it is related to support, output \"support\". If it is related to sales, output \"sales\".")
                    .build())
            .build()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20using OpenAI.Realtime;

#pragma warning disable OPENAI002

await session.SendCommandAsync(new RealtimeClientCommandResponseCreate
{
    ResponseOptions = new()
    {
        DefaultConversationConfiguration = RealtimeResponseDefaultConversationConfiguration.None,
        Metadata = new Dictionary<string, BinaryData>
        {
            ["topic"] = BinaryData.FromObjectAsJson("classification")
        },
        OutputModalities =
        {
            RealtimeOutputModality.Text
        },
        Instructions = "Analyze the conversation so far. If it is related to support, output \"support\". If it is related to sales, output \"sales\"."
    }
}, timeout.Token);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16connection.response.create(
  conversation: :none,
  metadata: { topic: "classification" },
  output_modalities: [:text],
  instructions: "Classify the conversation as support or sales."
)

response_done = connection.find do |event|
  raise event.error.message if event.is_a?(OpenAI::Realtime::RealtimeErrorEvent)
  next unless event.is_a?(OpenAI::Realtime::ResponseDoneEvent)

  raise "Response failed: #{event.response.status}" unless event.response.status == :completed

  true
end
raise "Connection closed before the response completed" unless response_done
這樣一來,監聽 response.done 伺服器事件時,就能辨識出帶外回應的結果。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22function handleEvent(message: import("ws").RawData | MessageEvent<string>) {
  const data = "data" in message ? message.data : message.toString();
  const serverEvent = JSON.parse(data);
  if (
    serverEvent.type === "response.done" &&
    serverEvent.response.metadata?.topic === "classification"
  ) {
    const { response } = serverEvent;
    if (response.status !== "completed" || response.output.length === 0) {
      throw new Error(
        "Classification response ended with status " + response.status
      );
    }
    console.log(response.output[0]);
  }
}

// Listen for server messages (WebRTC)
// dataChannel.addEventListener("message", handleEvent);

// Listen for server messages (WebSocket)
ws.on("message", handleEvent);
1
2
3
4
5
6
7
8
9
10
11
12def on_message(ws, message):
    server_event = json.loads(message)
    if server_event["type"] != "response.done":
        return
    response = server_event["response"]
    if (response.get("metadata") or {}).get("topic") != "classification":
        return
    if response["status"] != "completed" or not response["output"]:
        raise RuntimeError(
            f"Classification response ended with status {response['status']}"
        )
    print(response["output"][0])
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34func receiveUntil(ctx context.Context, conn *realtime.RealtimeConnection, terminal string) (realtime.RealtimeServerEventUnion, error) {
	for {
		event, err := conn.Recv(ctx)
		if err != nil {
			return event, fmt.Errorf("waiting for %s: %w", terminal, err)
		}
		if event.Type == "error" {
			return event, fmt.Errorf("Realtime API error: %s", event.OfRealtimeErrorEvent.Error.Message)
		}
		if event.Type == "response.done" && event.OfResponseDoneEvent.Response.Metadata["topic"] != "classification" {
			continue
		}
		if event.Type == "response.done" && event.OfResponseDoneEvent.Response.Status != "completed" {
			return event, fmt.Errorf("response ended with status %s", event.OfResponseDoneEvent.Response.Status)
		}
		if event.Type == "response.done" {
			response := event.OfResponseDoneEvent.Response
			fmt.Println("Response status:", response.Status)
			for _, output := range response.Output {
				item := output.OfRealtimeConversationItemAssistantMessage
				if item.Type == "message" {
					for _, content := range item.Content {
						if content.Type == "output_text" {
							fmt.Print(content.Text)
						}
					}
				}
			}
		}
		if event.Type == terminal {
			return event, nil
		}
	}
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22import com.openai.client.okhttp.OkHttpClient;
import com.openai.core.ClientOptions;
import com.openai.core.JsonValue;
import com.openai.helpers.RealtimeConnection;
import com.openai.helpers.RealtimeWebSocketOptions;
import com.openai.models.realtime.*;

static boolean handleEvent(RealtimeServerEvent event) {
  if (event.responseDone().isEmpty()) return false;
  var response = event.responseDone().orElseThrow().response();
  if (!response
      .metadata()
      .map(m -> m._additionalProperties().get("topic"))
      .flatMap(JsonValue::asString)
      .filter("classification"::equals)
      .isPresent()) return false;
  if (!response.status().filter(RealtimeResponse.Status.COMPLETED::equals).isPresent())
    throw new IllegalStateException(
        "Response ended with status " + response.status() + ": " + response.statusDetails());
  System.out.println(response.output());
  return true;
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16using OpenAI.Realtime;

#pragma warning disable OPENAI002

internal static bool HandleEvent(RealtimeServerUpdate update)
{
    if (update is not RealtimeServerUpdateResponseDone done ||
        !done.Response.Metadata.TryGetValue("topic", out BinaryData? topic) ||
        topic.ToObjectFromJson<string>() != "classification")
        return false;
    if (done.Response.Status != RealtimeResponseStatus.Completed)
        throw new InvalidOperationException($"Response ended with status {done.Response.Status}: {System.ClientModel.Primitives.ModelReaderWriter.Write(done.Response)}");
    foreach (RealtimeItem item in done.Response.OutputItems)
        Console.WriteLine(System.ClientModel.Primitives.ModelReaderWriter.Write(item));
    return true;
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15response_done = connection.find do |event|
  next unless event.is_a?(OpenAI::Realtime::ResponseDoneEvent)
  next unless event.response.metadata&.fetch(:topic, nil) == "classification"

  puts("Classification response completed: #{event.response.status}")
  Array(event.response.output).each do |item|
    next unless item.is_a?(OpenAI::Realtime::RealtimeConversationItemAssistantMessage)

    item.content.each do |content|
      puts("Classification: #{content.text}") if content.type == :output_text
    end
  end
  true
end
raise "Connection closed before the response completed" unless response_done
你也可以在目前的預設對話以外建立自訂上下文,讓模型據以生成回應。做法是使用 input 陣列,並在 response.create 用戶端事件中傳送。你可以提供新的輸入,也可以透過 ID 參照對話中既有的輸入項目。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45const existingItemId = "item_pizza";
ws.send(
  JSON.stringify({
    type: "conversation.item.create",
    item: {
      id: existingItemId,
      type: "message",
      role: "user",
      content: [
        { type: "input_text", text: "We are ordering pizza for dinner." },
      ],
    },
  })
);
const event = {
  type: "response.create",
  response: {
    conversation: "none",
    metadata: { topic: "pizza" },
    output_modalities: ["text"],

    // Create a custom input array for this request with whatever context
    // is appropriate
    input: [
      // potentially include existing conversation items:
      {
        type: "item_reference",
        id: existingItemId,
      },
      {
        type: "message",
        role: "user",
        content: [
          {
            type: "input_text",
            text: "Is it okay to put pineapple on pizza?",
          },
        ],
      },
    ],
  },
};

// WebRTC data channel and WebSocket both have .send()
ws.send(JSON.stringify(event));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46import json

existing_item_id = "item_pizza"
ws.send(
    json.dumps(
        {
            "type": "conversation.item.create",
            "item": {
                "id": existing_item_id,
                "type": "message",
                "role": "user",
                "content": [
                    {"type": "input_text", "text": "We are ordering pizza for dinner."}
                ],
            },
        }
    )
)

event = {
    "type": "response.create",
    "response": {
        "conversation": "none",
        "metadata": {"topic": "pizza"},
        "output_modalities": ["text"],
        # Create a custom input array for this request with whatever
        # context is appropriate
        "input": [
            # potentially include existing conversation items:
            {"type": "item_reference", "id": existing_item_id},
            # include new content as well
            {
                "type": "message",
                "role": "user",
                "content": [
                    {
                        "type": "input_text",
                        "text": "Is it okay to put pineapple on pizza?",
                    }
                ],
            },
        ],
    },
}

ws.send(json.dumps(event))
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34existing_item_id = "item_order"
connection.conversation.items.create(
  id: existing_item_id,
  type: :message,
  role: :user,
  content: [
    {
      type: :input_text,
      text: "Order ORD-123 has not arrived."
    }
  ]
)

connection.response.create(
  conversation: :none,
  metadata: { topic: "classification" },
  output_modalities: [:text],
  input: [
    {
      type: :item_reference,
      id: existing_item_id
    },
    {
      type: :message,
      role: :user,
      content: [
        {
          type: :input_text,
          text: "Classify this issue: my order is late."
        }
      ]
    }
  ]
)
你也可以讓模型忽略所有其他指示與上下文,再將回應插入預設對話。只要將 input 設為空陣列即可。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18const prompt = `
Say exactly the following:
I'm a little teapot, short and stout!
This is my handle, this is my spout!
`;

  const event = {
    type: "response.create",
    response: {
      // An empty input array removes existing context
      input: [],
      output_modalities: ["text"],
      instructions: prompt,
    },
  };

  // WebRTC data channel and WebSocket both have .send()
  ws.send(JSON.stringify(event));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17prompt = """
Say exactly the following:
I'm a little teapot, short and stout!
This is my handle, this is my spout!
"""

event = {
    "type": "response.create",
    "response": {
        "output_modalities": ["text"],
        # An empty input array removes all prior context
        "input": [],
        "instructions": prompt,
    },
}

ws.send(json.dumps(event))
1
2
3
4
5
6
7
8
9
10
11if err := conn.Send(ctx, realtime.RealtimeClientEventUnionParam{
	OfResponseCreate: &realtime.ResponseCreateEventParam{
		Response: realtime.RealtimeResponseCreateParams{
			Instructions:     openai.String("\nSay exactly the following:\nI'm a little teapot, short and stout!\nThis is my handle, this is my spout!\n"),
			Input:            []realtime.ConversationItemUnionParam{},
			OutputModalities: []string{"text"},
		},
	},
}); err != nil {
	return err
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18import com.openai.client.okhttp.OkHttpClient;
import com.openai.core.ClientOptions;
import com.openai.helpers.RealtimeConnection;
import com.openai.helpers.RealtimeWebSocketOptions;
import com.openai.models.realtime.*;
import java.util.List;

connection.send(
    RealtimeClientEvent.ofResponseCreate(
        ResponseCreateEvent.builder()
            .response(
                RealtimeResponseCreateParams.builder()
                    .addOutputModality(RealtimeResponseCreateParams.OutputModality.TEXT)
                    .input(List.of())
                    .instructions(
                        "Say exactly the following: I'm a little teapot, short and stout! This is my handle, this is my spout!")
                    .build())
            .build()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17using OpenAI.Realtime;

#pragma warning disable OPENAI002

RealtimeResponseOptions options = new()

{
    OutputModalities = { RealtimeOutputModality.Text },
    Instructions = "Say exactly the following: I'm a little teapot, short and stout! This is my handle, this is my spout!"

};
options.InputItems.Clear();
// An explicitly empty list excludes conversation context.
await session.SendCommandAsync(new RealtimeClientCommandResponseCreate
{
    ResponseOptions = options
}, timeout.Token);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15connection.response.create(
  input: [],
  output_modalities: [:text],
  instructions: "Generate a concise greeting without conversation context."
)

response_done = connection.find do |event|
  raise event.error.message if event.is_a?(OpenAI::Realtime::RealtimeErrorEvent)
  next unless event.is_a?(OpenAI::Realtime::ResponseDoneEvent)

  raise "Response failed: #{event.response.status}" unless event.response.status == :completed

  true
end
raise "Connection closed before the response completed" unless response_done
Realtime 模型也支援函式呼叫,讓你能執行自訂程式碼來擴充模型功能。基本流程如下:
- 更新工作階段或建立回應時,可以指定模型可呼叫的函式清單。
- 模型處理輸入時,如果判斷需要呼叫函式,就會在對話中新增項目,列出要傳給函式的引數。
- 用戶端偵測到含有函式呼叫引數的對話項目後,會使用這些引數執行自訂程式碼。
- 自訂程式碼執行完畢後,用戶端會建立包含函式呼叫結果的新對話項目,並要求模型回應。
以下範例會新增一個模型可呼叫的函式,為使用者提供今日星座運勢。範例會示範需要傳送的用戶端事件物件格式,以及伺服器接著會發出的事件。
首先,必須提供一組函式,讓模型根據使用者輸入選擇要呼叫的函式。可用函式可以針對整個工作階段設定,也可以針對個別回應設定。
以下是 session.update 用戶端事件的資料範例。它會設定一個生成星座運勢的函式,該函式只接受一個引數,即要查詢運勢的星座:
session.update
12345678910111213141516171819202122232425262728293031323334353637{
  "type": "session.update",
  "session": {
    "tools": [
      {
        "type": "function",
        "name": "generate_horoscope",
        "description": "Give today's horoscope for an astrological sign.",
        "parameters": {
          "type": "object",
          "properties": {
            "sign": {
              "type": "string",
              "description": "The sign for the horoscope.",
              "enum": [
                "Aries",
                "Taurus",
                "Gemini",
                "Cancer",
                "Leo",
                "Virgo",
                "Libra",
                "Scorpio",
                "Sagittarius",
                "Capricorn",
                "Aquarius",
                "Pisces"
              ]
            }
          },
          "required": ["sign"]
        }
      }
    ],
    "tool_choice": "auto"
  }
}
函式與參數各自的 description 欄位可協助模型判斷是否要呼叫該函式,以及每個參數應傳入哪些資料。如果模型收到的輸入表示使用者想查詢自己的星座運勢,就會使用 sign 參數呼叫此函式。
模型可能會根據收到的輸入,決定呼叫函式以生成最合適的回應。假設應用程式透過 conversation.item.create 事件新增以下對話項目,然後建立回應:
12345678910111213{
  "type": "conversation.item.create",
  "item": {
    "type": "message",
    "role": "user",
    "content": [
      {
        "type": "input_text",
        "text": "我是水瓶座,今天的運勢如何?"
      }
    ]
  }
}
接著傳送 response.create 用戶端事件,讓模型生成回應:
123{
  "type": "response.create"
}
此時,模型不會立即傳回文字或音訊,而會生成一個包含函式引數的回應,供開發者的應用程式將引數傳給指定函式。你可以監聽 response.function_call_arguments.delta 伺服器事件,即時取得函式呼叫引數的更新。response.done 也會包含呼叫函式所需的完整資料。
response.done
123456789101112131415161718192021{
  "type": "response.done",
  "event_id": "event_AeqLA8iR6FK20L4XZs2P6",
  "response": {
    "object": "realtime.response",
    "id": "resp_AeqL8XwMUOri9OhcQJIu9",
    "status": "completed",
    "status_details": null,
    "output": [
      {
        "object": "realtime.item",
        "id": "item_AeqL8gmRWDn9bIsUM2T35",
        "type": "function_call",
        "status": "completed",
        "name": "generate_horoscope",
        "call_id": "call_sHlR7iaFwQ2YQOqm",
        "arguments": "{\"sign\":\"Aquarius\"}"
      }
    ]
  }
}
從伺服器傳回的 JSON 可以判斷模型要呼叫自訂函式,並取得呼叫所需的資訊:
| 屬性 |
在函式呼叫中的用途 |
response.output[0].type |
值為 function_call 時,表示此回應包含呼叫指定函式所需的引數。 |
response.output[0].name |
要呼叫的已設定函式名稱,本例為 generate_horoscope。 |
response.output[0].arguments |
包含函式引數的 JSON 字串,本例為 "{\"sign\":\"Aquarius\"}"。 |
response.output[0].call_id |
系統為這次函式呼叫產生的 ID。將函式呼叫結果傳回模型時,需要使用這個 ID。 |
取得這些資訊後,就可以在應用程式中執行程式碼,產生星座運勢,再將結果傳回模型,讓模型據以生成回應。
應用程式收到含有函式呼叫引數的模型回應後,即可執行程式碼來完成該次呼叫。你可以依需求實作函式,例如呼叫外部 API 或存取資料庫。
準備好將自訂程式碼的執行結果傳給模型後,可以透過 conversation.item.create 用戶端事件,建立包含結果的新對話項目。
12345678{
  "type": "conversation.item.create",
  "item": {
    "type": "function_call_output",
    "call_id": "call_sHlR7iaFwQ2YQOqm",
    "output": "{\"horoscope\": \"You will soon meet a new friend.\"}"
  }
}
- 對話項目的類型為
function_call_output。
item.call_id 必須與先前從 response.done 事件取得的呼叫 ID 相同。item.output 是包含函式呼叫結果的 JSON 字串。
將含有函式呼叫結果的項目加入對話後,再從用戶端發出 response.create 事件。模型就會使用函式呼叫傳回的資料生成回應。
123{
  "type": "response.create"
}
工作階段進行期間,只要伺服器遇到錯誤,就會發出 error 事件。有些錯誤可以追溯到應用程式發出的用戶端事件。
在 HTTP 中,回應本身就對應到某個用戶端請求。使用 Realtime API 時,則需要在用戶端事件中加入 event_id 屬性,才能判斷是哪個事件在伺服器上觸發了錯誤。以下程式碼以用戶端嘗試發出不支援的事件類型為例,示範此做法。
1
2
3
4
5
6const event = {
  event_id: "my_awesome_event",
  type: "scooby.dooby.doo",
};

dataChannel.send(JSON.stringify(event));
伺服器無法處理用戶端傳來的事件,因此會發出類似以下的錯誤事件:
1234567891011{
  "type": "error",
  "event_id": "event_error_123",
  "error": {
    "type": "invalid_request_error",
    "code": "invalid_value",
    "message": "Invalid value: 'scooby.dooby.doo'.",
    "param": "type",
    "event_id": "my_awesome_event"
  }
}
許多語音應用程式都允許使用者在模型說話時打斷它。啟用 VAD 時,Realtime API 會在偵測到使用者開口後取消正在生成的回應,並開始新的回應。此時,模型需要知道使用者在哪裡打斷它,才能自然地接續對話,例如在使用者問「你剛剛最後說了什麼?」時接著回答。這個做法稱為截斷模型的上一則回應,也就是從對話中移除該則回應尚未播放的部分。
使用 WebRTC 或 SIP 連線時,伺服器會管理輸出音訊緩衝區,因此能掌握每個時間點已播放的音訊長度。使用者打斷模型時,伺服器會自動截去尚未播放的音訊。
使用 WebSocket 連線時,音訊播放由用戶端管理,因此用戶端必須負責停止播放並處理截斷。流程如下:
- 收到
input_audio_buffer.speech_started 時,立即停止播放模型的音訊,並捨棄該項目中所有排隊等候播放的音訊。以毫秒為單位記錄使用者實際聽到的該項目音訊長度。
- 傳送
conversation.item.truncate 事件,附上遭中斷項目的 ID、音訊內容的索引,並將已播放的時長填入 audio_end_ms。這會從對話中移除尚未播放的部分。
- VAD 中斷正在生成的回應時,伺服器會取消該回應,並傳送
response.done,其中 response.status 的值為 cancelled。此事件可用來確認回應已結束。停止播放或傳送截斷事件前,請勿等待此事件。
範例如下:
123456{
  "type": "conversation.item.truncate",
  "item_id": "item_1234",
  "content_index": 0,
  "audio_end_ms": 1500
}
在這個範例中,音訊會在播放 1.5 秒處截斷。
轉錄文字也能在同一處截斷嗎?Realtime 模型掌握的資訊不足以將轉錄文字與音訊精確對齊,因此 conversation.item.truncate 會在指定位置截斷音訊,並移除尚未播放部分的轉錄文字。這能移除尚未播放的音訊,但不會提供截斷後的轉錄文字。
Realtime API 預設使用語音活動偵測(VAD),根據音訊輸入觸發模型回應。你也可以停用 VAD,由應用程式控制何時將音訊輸入傳給模型,實作按住說話的互動方式。例如,按住空白鍵時擷取音訊,放開時觸發回應。這種方式在某些應用程式中特別有效:使用者能掌控互動時機,也能避免 VAD 偵測失敗,而且無須等待 VAD 逾時,操作起來更俐落。
使用 WebSocket 與 WebRTC 實作按住說話的方式略有不同。Realtime API 的 WebSocket 連線會透過同一個通道依序傳送所有事件,而 WebRTC 連線則使用不同通道傳送音訊與控制事件。
若要透過 WebSocket 連線實作按住說話,用戶端需要負責停止播放音訊、處理中斷及觸發新回應。詳細步驟如下:
- 指定
"turn_detection": null,並透過 session.update 事件套用設定,以停用 VAD。
- 按下按鍵時,在用戶端開始錄音。
- 如果模型正在生成回應,傳送
response.cancel 事件將其取消。
- 如果仍在播放模型輸出的音訊,立即停止播放,並傳送
conversation.item.truncate 事件,從對話中移除尚未播放的音訊。
- 放開按鍵時,傳送含有錄音的
input_audio_buffer.append 訊息,將新音訊加入輸入緩衝區。
- 傳送
input_audio_buffer.commit 事件,提交已寫入輸入緩衝區的音訊。如果已啟用輸入轉錄,也會開始轉錄。
- 接著傳送
response.create 事件來觸發回應。
使用 WebRTC 實作按住說話的方式類似,但必須明確清除輸入音訊緩衝區。步驟如下:
- 指定
"turn_detection": null,並透過 session.update 事件套用設定,以停用 VAD。
- 按下按鍵時,傳送
input_audio_buffer.clear 事件,清除先前的音訊輸入。
- 如果模型正在生成回應,傳送
response.cancel 事件將其取消。
- 如果仍在播放模型輸出的音訊,傳送
output_audio_buffer.clear 事件,清除尚未播放的音訊。這也會截斷對話中的相應內容。
- 放開按鍵時,傳送
input_audio_buffer.commit 事件,提交已寫入輸入緩衝區的音訊。如果已啟用輸入轉錄,也會開始轉錄。
- 接著傳送
response.create 事件來觸發回應。
