選擇你使用的 API,瞭解用量的計算方式,以及如何管理語音應用程式的成本。
GPT-Live 用量與成本
GPT-Live 將語音對話與負責推理及執行工具的後端分開。請分別估算這兩項成本:語音工作階段依持續時間計費,後端成本則取決於你使用的模型和工具。
語音工作階段成本
GPT-Live 語音工作階段依目前的模型費率按秒計費。工作階段的持續時間不會無條件進位到下一個整分鐘。
只要工作階段仍在進行,無論是使用者說話、助理說話、雙方都沒說話,或是後端正在處理任務,這些時間都會計入用量。
估算時,請計入工作階段從開始到關閉的全部時間。請使用 API 回報的持續時間,避免只計算播放音訊的時間。將麥克風輸入設為靜音不會關閉工作階段。對話結束後,請關閉工作階段並取得最終用量。
後端模型和工具的價格請參閱 API 定價。
WebRTC 初始化費用
透過 POST /v1/live/sessions 請求建立 WebRTC 工作階段時,系統會在初始化期間先收取 15 秒的語音費用。工作階段開始執行後,這筆費用會抵扣按時長計算的語音費用。估算成本時,請勿在工作階段的執行時間上再加 15 秒。
例如,下方範例中的 90 秒工作階段已包含初始化時收費的 15 秒,因此不會按 105 秒計費。評估重新連線的成本時,或是應用程式會在使用者準備好說話之前就建立工作階段時,都要將建立工作階段的費用納入考量。
後端成本
後端呼叫與語音工作階段分開計費,計費方式與不使用語音的應用程式相同。請計入模型的輸入與輸出 Token、模型支援快取時的快取輸入,以及適用的圖像或工具費用。如果應用程式會呼叫其他服務,也請將這些服務的成本納入估算。
你可以單獨針對後端進行最佳化。參考通用的成本最佳化指南,減少請求次數與 Token 用量。對於支援提示詞快取的後端模型,請將可重複使用的指示、工具定義及其他不常變動的內容放在提示詞開頭,以便使用快取。
後端的選擇也會影響對話時間。如果某項最佳化會讓使用者等得更久,或影響助理完成任務的可靠性,請比較調整前後的總成本。
估算對話成本
如果一次對話只使用一個語音工作階段:
總成本 =(計費語音秒數 ÷ 60 × 每分鐘語音費率)+ 後端成本
例如,假設語音費率為每分鐘 $0.05,90 秒的語音工作階段費用就是 $0.075。如果後端模型和工具費用合計為 $0.02,這次對話的成本就是 $0.095:
| 項目 | 計算方式 | 成本 |
|---|---|---|
| 語音工作階段 | 90 秒 ÷ 60 × $0.05 | $0.075 |
| 後端作業 | 模型和工具費用合計 | $0.02 |
| 對話總成本 | $0.075 + $0.02 | $0.095 |
上述費率和後端成本僅供示範。請使用目前的語音費率、實際測得的後端用量,以及適用的模型和工具費率。如果任務橫跨多個語音工作階段,請加總各工作階段的持續時間,並計入工作階段之間執行的後端作業。
最佳化策略
減少不必要的交談與等待,協助使用者完成任務。請保留任務所需的確認與檢查步驟。
在工作階段開始前提供相關上下文
開始語音工作階段之前,先收集應用程式已獲授權使用的資訊。例如,協助處理訂單的助理可以先取得訂單編號與目前狀態,使用者就不必重複提供這些資訊,也不必等待助理再次查詢。
請隨時更新上下文,並只保留與任務相關的資訊。提供語音模型進行對話所需的資訊,將詳細記錄和工作流程留在後端。請參閱工作階段設定與委派和工具。
縮短等待工具執行的時間
縮短等待時間可以改善使用者體驗,也能降低語音工作階段的成本。例如,假設後端使用 gpt-5.6-luna 的快速模式,並平行執行彼此獨立的工具呼叫。如果這些調整能讓使用者提早一分鐘完成任務並關閉語音工作階段,就能省下 $0.05 的語音費用。只要增加的後端成本低於省下的金額,總成本就會下降。
你也可以在收到委派事件之前,根據逐字稿片段預先發起推測性查詢。即使最後沒有用到查詢結果,衡量後端成本時仍要計入這些作業。
如需瞭解如何針對模型、連線、串流和工具進行最佳化,請參閱降低後端延遲。透過語音智慧體評估,驗證使用者多久能聽到有用的回應,以及任務是否成功完成。
在長時間執行的任務期間關閉工作階段
語音前端與應用程式管理的後端可以獨立執行。使用用戶端委派時,無論語音工作階段開啟或關閉,後端工作程序都能繼續執行。請先儲存任務狀態與對話上下文,再關閉語音工作階段。
如需瞭解閒置逾時設定、重新啟動的觸發條件及還原上下文的流程,請參閱關閉閒置工作階段並恢復對話。
對於持續在背景待命的智慧體,當後端處理耗時任務(例如在目標模式下撰寫程式碼)時,請關閉語音工作階段。提供標示為繼續對話的按鈕,讓使用者回來時能啟動新的語音工作階段。你也可以在後端發出任務完成事件時啟動新的工作階段,並通知使用者結果已就緒。
若要恢復對話,請啟動新的工作階段,並在 input 中提供已儲存的上下文和已驗證的任務結果。例如,透過新的 WebSocket 連線傳送以下啟動事件:
{
"type": "session.start",
"session": {
"model": "gpt-live-1",
"instructions": "Help the user review completed work and delegate follow-up tasks.",
"input": [
{
"type": "message",
"role": "developer",
"content": [
{
"type": "input_text",
"text": "Saved task: add CSV export. Result: code is ready for review."
}
]
}
],
"delegation": { "type": "client" }
}
}等收到 session.started 後,再開始串流音訊。如需瞭解支援的歷程記錄格式,請參閱使用先前的對話初始化工作階段。
如果先前的工作階段是使用 store: true 儲存的,也可以為該工作階段建立分支。無論採用哪種方式,都請在應用程式中保留已驗證的後端任務狀態。
關閉工作階段,每分鐘可省下 $0.05 的閒置語音費用。請一併衡量省下的費用、重新連線的成本,以及中斷對使用者體驗的影響。
選擇合適的後端模型
先選出符合任務準確度與可靠性要求的模型,再比較對話總成本。比較時請計入語音時長、模型用量、工具呼叫與重試。模型選擇指南說明如何權衡這些因素。
如果較大的後端模型能更快完成任務,且省下的語音工作階段費用超過增加的 Token 費用,整體成本反而可能更低。反之,較便宜的模型如果耗時較長、重複呼叫工具,或無法完成任務,整體成本反而可能更高。
請一併比較每次成功完成任務的成本、完成率與完成所需時間。計算總成本時,請納入失敗的嘗試與重試,以免較便宜的設定只是因為完成的任務較少,就顯得更划算。規劃比較方式時,可參考 Cookbook 的語音智慧體評估範例。
監控實際用量
請針對每個工作階段,分別記錄語音時長與後端用量。GPT-Live 會以秒為單位回報累計語音時長:
{
"type": "session.usage.updated",
"event_id": "event_usage_1",
"usage": { "seconds": 12 },
"context_window": { "usage_ratio": 0.42 }
}每次更新都會取代前一次的時長快照,請勿將快照中的數值加總。傳送 session.close 後,請持續接收事件,直到收到 session.closed,再記錄該事件中的最終 usage.seconds,只需記錄一次。請依照正常關閉工作階段的程序操作,讓應用程式能在中斷連線前取得最終用量。
使用 Responses 委派時,後端回應的 usage 位於巢狀的 response.completed 事件中,這些事件會透過 response.event 傳送。請依回應 ID 確保每個後端回應只計算一次,並保留輸入、輸出和快取 Token 的明細,以便按該模型的費率計算費用。如果應用程式會獨立執行其他後端作業,也請收集這些請求的用量。
選取具代表性的對話,比較估算與實際的總成本。請將僅用於評估的模型呼叫與應用程式用量分開計算,並一併檢視成本與任務完成情況。
Realtime API 成本
本指南說明 Realtime API 的計費方式與成本最佳化策略。語音智慧體工作階段會累計文字、音訊和圖像等不同模態的輸入與輸出 Token。串流翻譯與串流轉錄工作階段則依音訊時長計費。各模型的價格不同,請參閱各模型頁面,例如 gpt-realtime-2、gpt-realtime-translate、gpt-realtime-whisper 和 gpt-realtime。
Realtime API 的對話式工作階段由一連串 回合 組成。使用者加入輸入後,會觸發一個 回應 來產生模型輸出。伺服器會維護一個 對話,其中的 項目 清單構成下一回合的輸入。系統傳回回應時,會自動將輸出加入對話。
翻譯和轉錄工作階段採用不同的串流架構。用戶端會持續串流音訊,並隨著來源音訊傳入,陸續收到翻譯後的音訊、逐字稿的增量更新或轉錄事件。這些工作階段不使用一般的回應生命週期,因此請依音訊時長與對應費率估算及監控成本,無須按每個回應的 Token 用量計算。
每個回應的成本
Realtime API 在建立回應時會依輸入與輸出 Token 數量計費(輸入轉錄費用除外,詳見下文)。目前網路頻寬與連線均不收費。你可以手動建立回應,也可以啟用語音活動偵測(VAD),讓系統自動建立回應。VAD 會濾除沒有語音的輸入音訊,因此除非用戶端手動將這些音訊加入對話輸入,否則不會計入輸入 Token。
每次產生回應時,系統都會將整段對話傳給模型。每一回合的輸出都會以項目的形式加入伺服器上的對話,成為後續回合的輸入。因此,工作階段中越後面的回合,成本就越高。
你可以使用我們的 Token 化處理工具估算文字 Token 的成本。使用者訊息每 100 毫秒音訊計為 1 個音訊 Token,助理訊息則每 50 毫秒音訊計為 1 個音訊 Token。除了訊息內容,計數也包含特殊 Token,因此實際數量可能略有差異。例如,內容有 10 個文字 Token 的使用者訊息,實際可能計為 12 個 Token。
範例
以下用一個簡單的例子說明 Realtime API 工作階段進行多回合對話時的 Token 成本。
在對話的第一回合,我們加入了 100 個 Token 的指示,以及包含 20 個音訊 Token 的使用者訊息(例如由 VAD 在偵測到使用者說話時加入),合計為 120 個輸入 Token。建立回應後,模型會產生一則助理輸出訊息,包含 20 個音訊 Token 與 10 個文字 Token。
接著,我們加入另一則使用者音訊訊息,開始第二回合。這個回合會用到多少 Token?此時,對話包含最初的指示、第一則使用者訊息、第一回合的助理輸出訊息,以及第二則使用者訊息(25 個音訊 Token)。這個回合的輸入共有 110 個文字 Token 與 64 個音訊 Token,此外還要計入新一則助理訊息的輸出 Token。
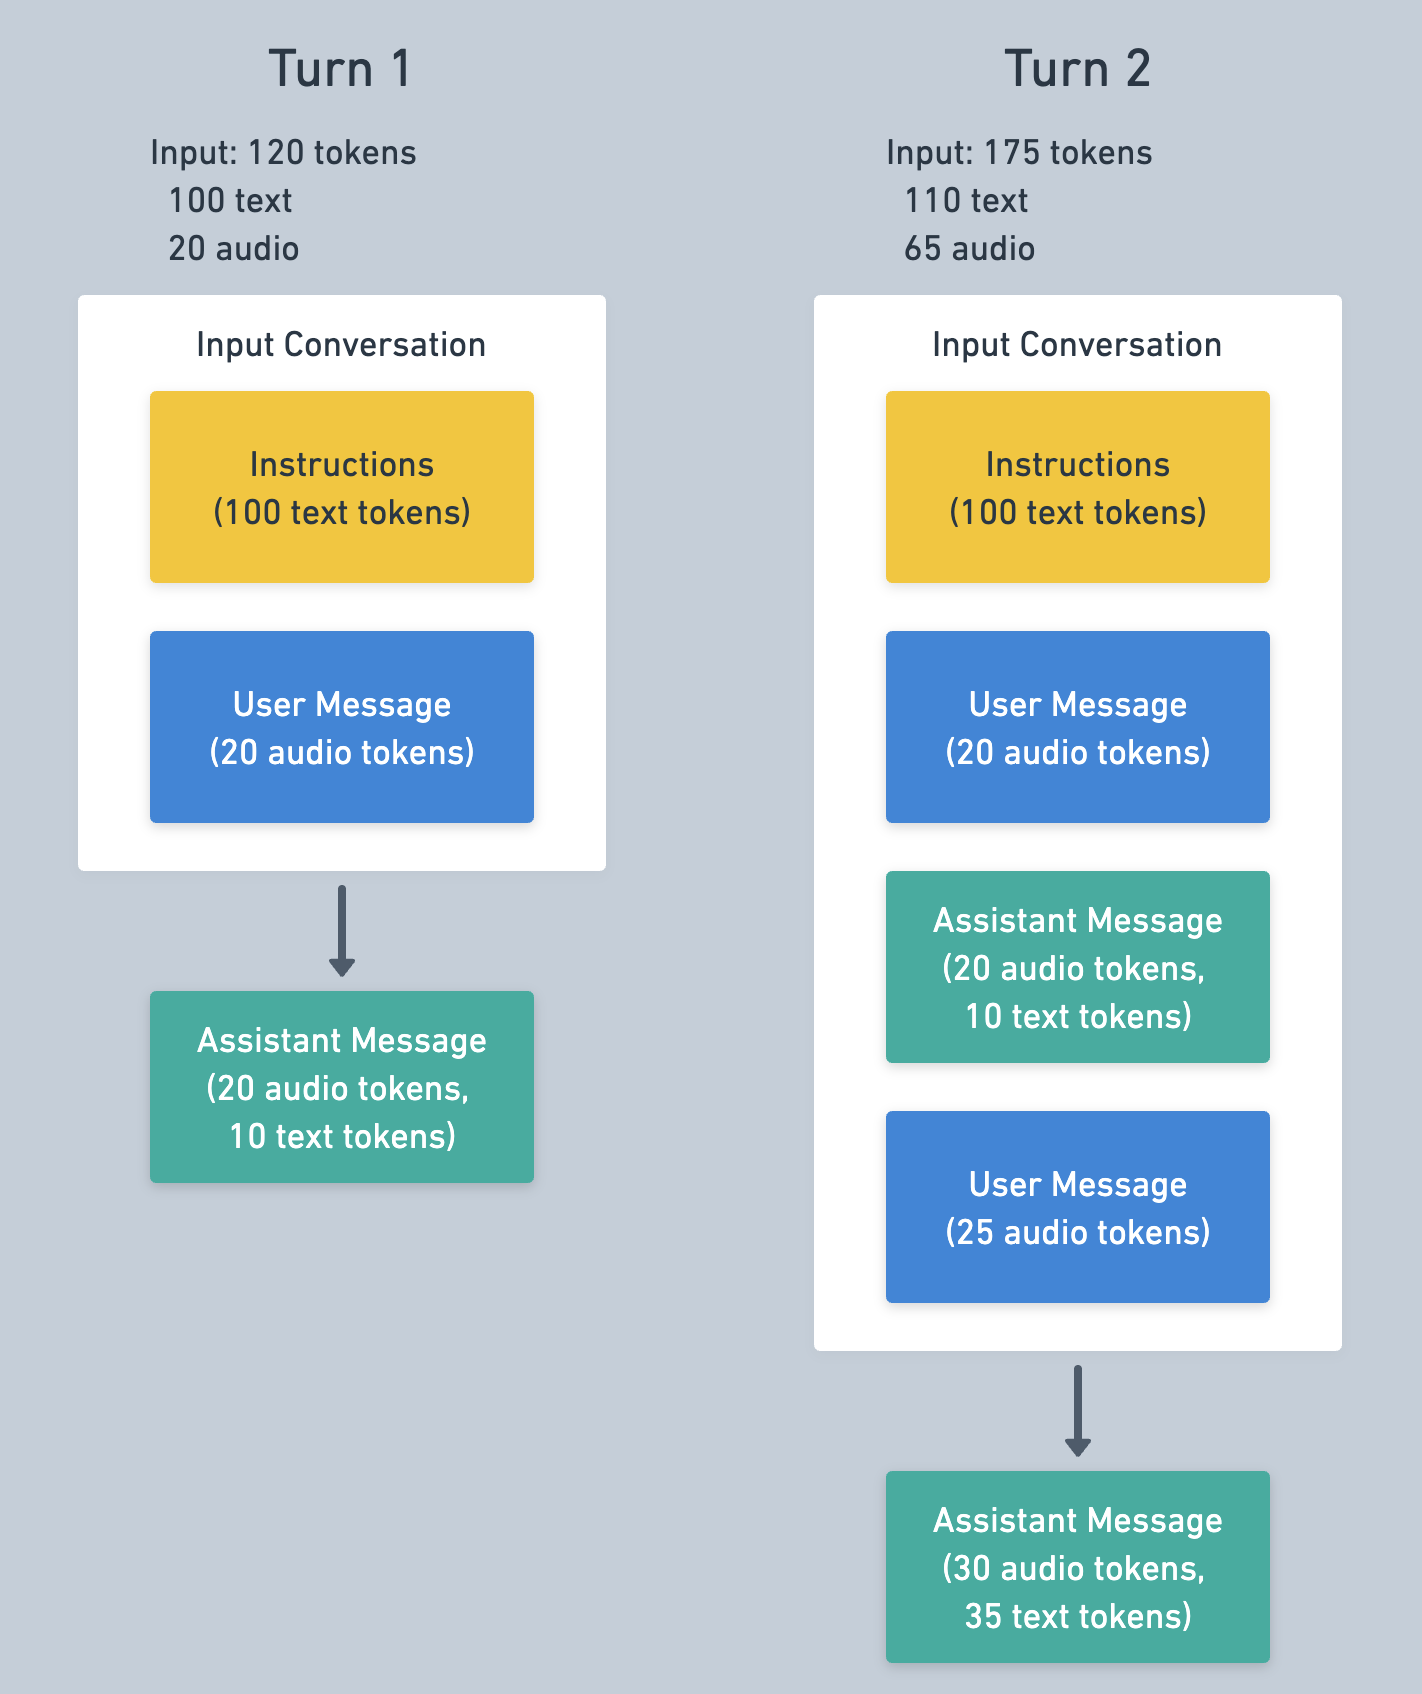
第一回合的訊息到了第二回合很可能會命中快取,因而降低輸入成本。如需瞭解快取機制,請參閱下文。
你可以從 response.done 事件讀取該回應的 Token 用量,事件格式如下:
{
"type": "response.done",
"response": {
...
"usage": {
"total_tokens": 253,
"input_tokens": 132,
"output_tokens": 121,
"input_token_details": {
"text_tokens": 119,
"audio_tokens": 13,
"image_tokens": 0,
"cached_tokens": 64,
"cached_tokens_details": {
"text_tokens": 64,
"audio_tokens": 0,
"image_tokens": 0
}
},
"output_token_details": {
"text_tokens": 30,
"audio_tokens": 91
}
}
}
}輸入轉錄成本
啟用輸入轉錄後,Realtime API 會另外收取轉錄費用。輸入轉錄使用的模型和費率都與語音到語音模型不同。請使用 gpt-transcribe 轉錄已提交的回合。音訊寫入輸入音訊緩衝區並提交緩衝區後,就會開始轉錄。
請從 conversation.item.input_audio_transcription.completed 事件讀取輸入轉錄用量。用量欄位依轉錄模型而異:gpt-transcribe 依音訊時長計費,依 Token 用量計費的模型則會傳回 Token 數量。例如,依時長計算的用量格式如下:
{
"type": "conversation.item.input_audio_transcription.completed",
"transcript": "Hi, can you hear me?",
"usage": {
"type": "duration",
"seconds": 3
}
}快取
Realtime API 會自動套用提示詞快取,在多回合工作階段中可大幅降低輸入 Token 成本。當回應的輸入 Token 與先前回應的 Token 相符時,系統會盡可能使用快取,但不保證每次都會命中。
要提高快取命中率,最有效的做法是讓工作階段中已有的歷程記錄維持不變。刪除或修改對話內容會縮短與快取相符的輸入前綴,快取只能沿用到變更處之前。指示與工具定義都位於對話開頭,因此在工作階段中途變更這些內容,會降低後續回合的快取命中率。
截斷
當對話中的 Token 數量超過模型的輸入 Token 上限時,系統會截斷對話,從最舊的訊息開始,依序將訊息移出回應的輸入內容。以支援 32k 上下文、最多可輸出 4,096 個 Token 的模型為例,上下文最多只能包含 28,224 個 Token,超過就會截斷。
用戶端可以將 Token 視窗設得比模型上限更小,以控制 Token 用量與成本。你可以透過 token_limits.post_instructions 設定視窗大小,前提是依照下方範例將截斷類型設為 retention_ratio。這項設定限制每個回應的輸入 Token 數量,指示本身的 Token 不計入上限。例如,將 post_instructions 設為 1,000 後,系統在產生回應時就不會將超出 1,000 個輸入 Token 上限的項目傳給模型。
截斷會讓對話開頭附近的快取失效。如果每個回合都發生截斷,快取命中率就會很低。為減輕影響,用戶端可以設定每次截斷時多移除一些訊息,預留更多空間,延後下次截斷。你可以透過 session.truncation.retention_ratio 調整保留比例。伺服器的預設值為 1.0,表示只移除必要的項目。設為 0.8 時,每次截斷會保留上限的 80%,額外移除相當於上限 20% 的內容。
如果想在使用同一模型的前提下降低 Realtime API 每個工作階段的成本,建議調低 Token 數量上限,並將 retention_ratio 設為小於 1 的值,如下方範例所示。請留意其中的取捨:成本可能下降,但模型在該回合能參考的對話歷程也可能變少。
{
"event": "session.update",
"session": {
"truncation": {
"type": "retention_ratio",
"retention_ratio": 0.8,
"token_limits": {
"post_instructions": 8000
}
}
}
}你也可以完全停用截斷,如下方範例所示。停用後,如果對話過長而無法建立回應,系統會傳回錯誤。如果你打算自行管理對話長度,可以使用這項設定。
{
"event": "session.update",
"session": {
"truncation": "disabled"
}
}其他最佳化策略
使用 mini 模型
Realtime 語音到語音模型提供標準版與 mini 版,mini 版的價格低得多。主要取捨在於模型能力:mini 模型在遵循指示與函式呼叫方面的表現通常較弱。建議先使用較大的模型測試應用程式,調整應用程式與提示詞,再嘗試使用 mini 模型降低成本。
編輯對話
除了讓伺服器自動截斷對話,你也可以手動編輯對話來管理成本。這個 API 的設計原則之一,是讓用戶端完整控制伺服器上的對話,依需要新增或移除項目。
{
"type": "conversation.item.delete",
"item_id": "item_CCXLecNJVIVR2HUy3ABLj"
}清除舊訊息可以減少輸入 Token 數量並降低成本,但也可能移除重要內容。常見做法是用摘要取代舊訊息。你可以傳送上例中的 conversation.item.delete 訊息,從對話中刪除項目,也可以傳送 conversation.item.create 訊息來新增項目。
估算成本
Realtime API 的 Token 用量涉及多項因素,因此很難事先準確估算成本。你可以在 Realtime Playground 中使用預計採用的提示詞和函式,測量一個範例工作階段的 Token 用量。在 Realtime Playground 的「記錄」分頁中,工作階段 ID 旁會顯示該工作階段的 Token 用量。