
GPT-Live 能配合對話的節奏,讓互動更順暢:使用者可以隨時接話、轉換話題,也可以一邊說,一邊把想法想清楚。串接式語音系統會將語音依序交給獨立的轉錄模型、語言模型和語音生成模型處理。GPT-Live 則能同時聽和說,讓交流更自然。畢竟在對話中,何時開口、何時讓對方插話,和說了什麼一樣重要。
在本文中,Juno、Picsart、Treater 和 Weekend 將親自分享運用 GPT-Live 開發產品的經驗,以及他們在這些方面的心得:
- 運用正式環境的即時資料改善通話體驗
- 找出讓人信任的聲音
- 協調語音互動與背景智慧體的工作
- 編排多個語音智慧體,讓它們彼此配合
我們將看看這些團隊如何運用提示詞、工作流程和使用者回饋來打造產品。其他開發者也可以在自己的應用程式中試試這些做法。
新創團隊的故事
Juno:用 GPT-Live 打造能和病患自然交談的語音夥伴
作者:共同創辦人暨執行長 Marshall Gould、共同創辦人暨技術長 Isaac Tolley
我們正在開發 Juno,一款為長新冠、姿勢性心搏過速症候群(POTS)、埃勒斯-當洛斯症候群(EDS)等慢性病患者設計的個人健康助理。
我們想打造什麼
只有親身經歷慢性病,才能真正體會它帶來的負擔。除了嚴重的症狀、疲憊、一次次就診,以及不知道身體到底出了什麼問題的焦慮,還有一大堆事情要打理:記得補藥、閱讀最新研究、追蹤症狀,還得從每天變動的數百個因素中找出哪些與症狀有關。與此同時,日子還是要照過。
對慢性病患者來說,尤其是體力因病受限的人,追蹤工具本身也是負擔。手動記錄太耗精力,許多人即使覺得追蹤應用程式有幫助,最後還是停用了。
語音改變的正是這件事。你只要說一句簡單的話,Juno 就能同時幫你記下好幾件事。
語音互動還有哪些難題
光是語音模型本身的能力就已經很驚人。說話是人與人之間最自然的溝通方式,但我們還在摸索怎麼讓產品也做到這一點。目前還有幾個難題:
- 如何記錄症狀或取得相關上下文,又不打斷對話。
- 如何把文字對話的記憶帶入語音互動,又不讓對話卡住。
- 如何維持長時間的對話。
我常把語音模型想成水母。它們反應很快,卻不太有自己的方向。使用者剛說了什麼,它們就跟著往那個方向漂,還常常停下來請使用者確認。文字模型能參考的上下文多得多,不需要使用者每次都重新解釋自己的狀況,因此也更主動。換成語音,你就得幫模型掌握方向。
我們如何改進語音智慧體
在不中斷對話的情況下記錄和運用記憶
請大多數語音智慧體辦件事,它們會將工作交給工具,然後等待答案。這段時間,通話兩端一片寂靜。GPT-Live 可以把工作委派給另一個智慧體,但交接後,對話就得等結果回來才能繼續。在我們的第一版中,每五通電話就有四通至少出現過一次這樣的停頓:先說「請稍等」,接著沉默約 10 秒。
我們的做法很簡單。每一輪對話結束後,一個小巧、快速的模型(OpenAI 的 Decisions API)會在背景回答兩個問題:
- 有什麼需要記錄?屬於哪一類?
- 你的過往紀錄中,哪些內容跟現在有關?
只要說「幫我記一下頭痛」,系統就會立刻告知 Juno 已記下這件事,同時在背景儲存紀錄。儲存速度夠快,即使你下一輪馬上問起這次頭痛,紀錄也已經存好了。
第二個答案用來處理記憶。下一輪的上下文只會納入過往紀錄中與當下有關的內容。這個篩選很重要,因為語音模型能處理的上下文遠少於文字模型,必須慎選要放進去的資訊。
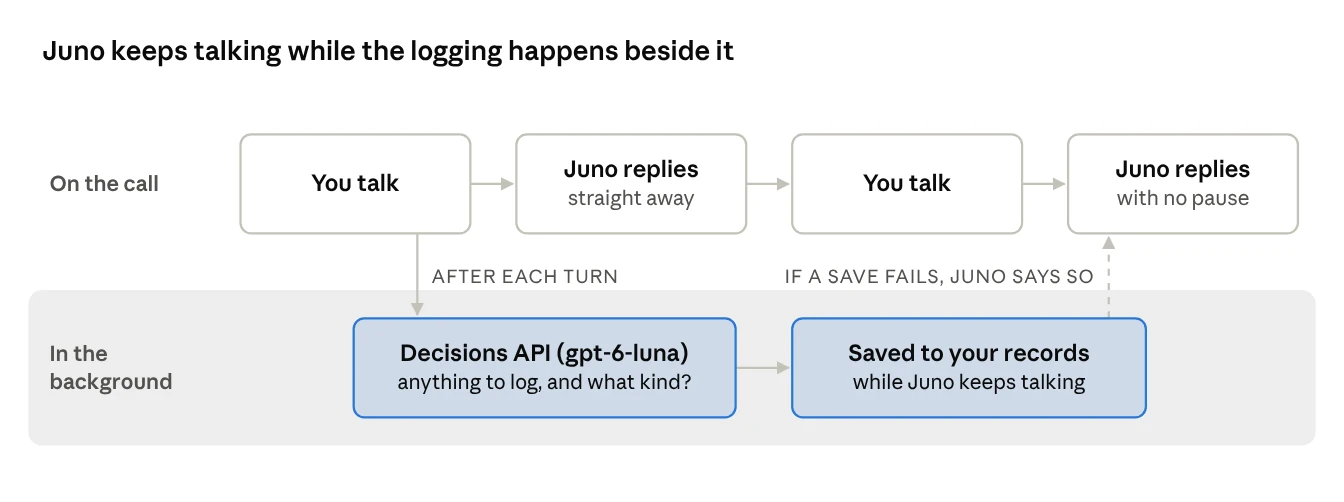
結果,移交給文字智慧體的次數減少了 40%,一通測試電話中最長的沉默也從 9.3 秒縮短為 3.2 秒。原本讓人尷尬的等待,現在聽起來就像自然的停頓。
長時間對話
長時間對話也需要同樣細心的設計。還記得水母的比喻嗎?模型自己不太有方向感,所以需要引導。我們用一個負責引導的智慧體更新通話的上下文。這樣到了第 100 輪,Juno 還記得第一輪說過的話;如果聊不下去了,它也知道接下來可以提什麼。想支援長時間對話,就得自己建立這套機制。這很值得,因為聊得夠久,才有機會發現有助於人們了解自身健康狀況的規律與趨勢。
透過實際試聽,找出適合 Juno 的聲音
另一個難題是設計出聽起來恰到好處的聲音。這說起來容易,做起來難。GPT-Live 內建的語音比前幾代進步許多,但還是有人覺得聽起來像 AI。我們能不能設計出每十人就有九人覺得合適的聲音?
一群參與焦點座談的慢性病患者告訴我們,Juno 說話有點慢,語氣也有點像在教訓人。這項回饋很重要,於是我們展開研究,看看能怎麼改進。
我們使用 GPT-Live 的提示詞轉語音功能,以簡短的文字描述設計出幾種新聲音,並請 290 位患有慢性病的美國成年人試聽,比較新聲音與現用聲音。每個人聽的都是相同的三句話。他們為每種聲音評分,選出最喜歡、最不喜歡,以及在筋疲力盡時最想聽到的聲音。
我們進行了五輪小規模測試,每輪都保留表現最好的聲音,其餘則重寫描述。接著,我們請另外 171 人比較現用聲音和表現最好的兩種新聲音。
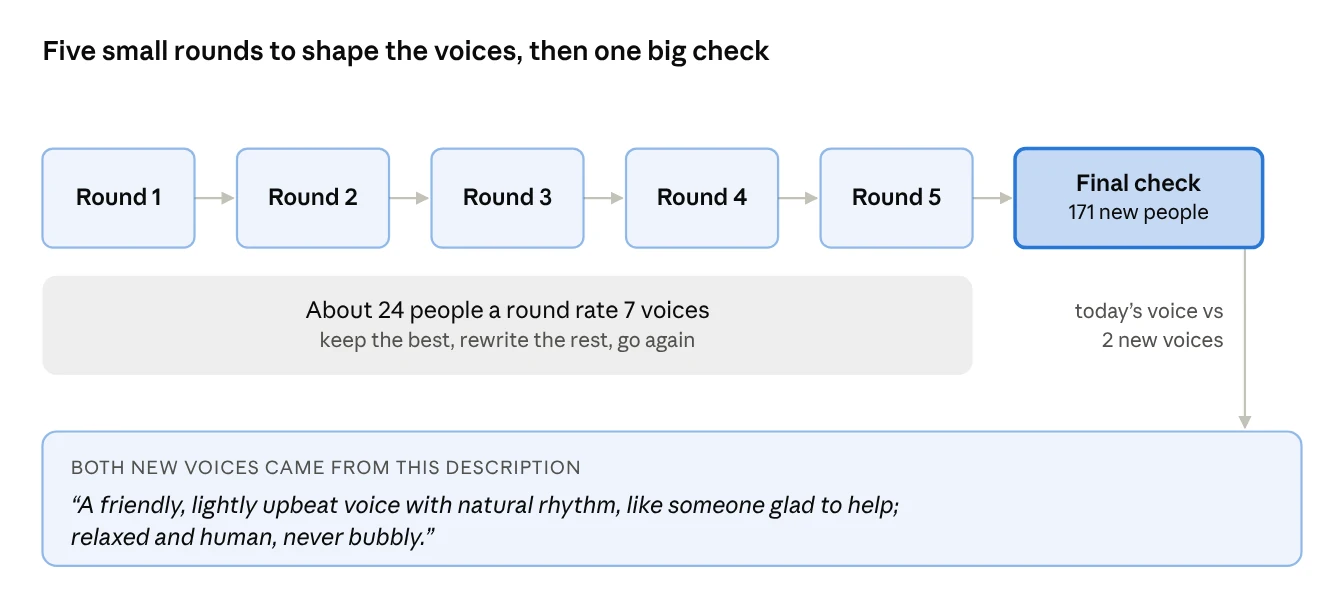
勝出的是用上圖那段描述產生的新聲音。在最後一輪試聽中,與現用聲音相比,更多人把它選為最喜歡的聲音,更少人把它列為最不喜歡的聲音,而覺得它缺乏溫暖的人也少了許多。
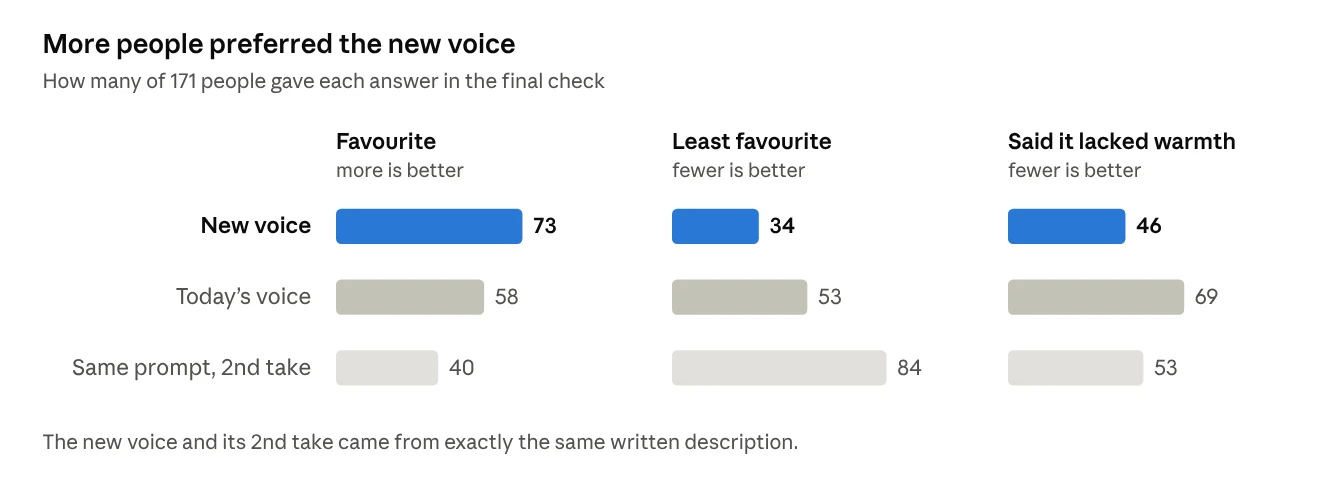
這項研究有其限制:參與者只聽了三句話,各聲音的評分很接近,而且試聽和實際通話畢竟有差別。接下來,我們會讓首次來電的使用者在真實通話中體驗新聲音,看看隔天回來使用的人會不會增加。
累了一天,想聽哪種聲音?
我們也問了參與者,筋疲力盡的那天,他們會想聽到哪種聲音。這次,現用聲音略勝一籌。差距雖小,卻讓我們想到一個更大的問題:為什麼我們這麼執著於找出一種完美的聲音?

我們自己的聲音也不是一成不變的。我們會因情境改變語氣、語速和音量。如果 Juno 的聲音也能隨你的感受調整呢?當一個聲音的語速和音量接近自己的說話方式時,人們會更信任它(Levitan 等人,2016)。GPT-Live 已經能讓我們在通話途中調整 Juno 的說話方式。這正是我們接下來要測試的方向。你可以在 junocompanion.com/voice-study 試聽每種聲音,查看完整結果。
看到語音互動讓慢性病患者能做到以前很費力的事,日常生活也輕鬆許多,我們深受鼓舞。GPT-Live 是很好的基礎模型,在這個基礎上稍作調整,就能帶來切身可感的改變。
關於作者與公司
我是 Juno 創辦人 Marshall Gould。我和三位研究人員 Isaac Tolley、Sean Lees、Dawid Wraga 一起打造了 Juno 的聲音。Juno 是一家把使命放在首位的 AI 公司,致力於幫助人們管理慢性病,與疾病共處。我們引以為傲的是,團隊多數成員本身就有與慢性病共處的經驗。目前已有數十萬人使用 Juno,我們也希望有你加入,一起延續這項使命。詳見 junocompanion.com。
Picsart:讓語音對話與智慧體任務保持同步
作者:Picsart 資深主任工程師 Dmitry Ivanov
我們想打造什麼
一件創作可能比一通電話花得更久。我們希望使用者能在任務執行期間自然地與 Picsart AI 智慧體交談,也可以先離開通話,等結果準備好再回來。創意不見得一開始就很完整。有時,聊聊想營造的氛圍或大致方向,比寫出精確的要求容易得多。
GPT-Live 是第一個讓我們能實現這個構想的技術。自然的即時對話讓使用者能透過交談一起發展點子,語音的用途也從口述指令延伸到共同創作。有了這個基礎,我們就能將這樣的對話體驗帶進 Picsart AI 智慧體。
因此,我們把語音設計成與智慧體互動的獨立介面,同時讓它和文字聊天共用同一個對話串。我們選擇 GPT-Live 處理即時對話,由我們的智慧層負責推理、工具、計畫和已儲存的上下文。
解決方式:讓對話與工作分開進行

如圖所示,應用程式會將工作送到智慧層,再把上下文和答案傳回 GPT-Live。它透過共用的 WebSocket 連線傳送工作,並接收進度和結果。語音和文字使用相同的智慧體、任務流程和核准規則。
語音閘道會依所選智慧體的指示建立工作階段。瀏覽器與 OpenAI 之間透過 WebRTC 直接傳輸即時音訊。通話結束後,已送出的任務仍可繼續執行。
將請求送給智慧體
當 GPT-Live 請主要智慧體執行工作時,我們會將口頭請求、近期訊息和附件一併送往目前的智慧體與對話串,並標記為語音模式。我們會在送出時儲存這份上下文,以免後來說的話覆寫已排入佇列的請求。
我們要求主要智慧體撰寫適合說出口的回覆:回答要簡短、口語化,一次問一個問題,語音端已經確認過的事就不用重複。要把準備做的事、費用及需要核准的事項交代清楚。
語音端接收哪些資訊,又會說出哪些內容
我們會提供三類資訊給語音端:
| 通道 | 傳送的資訊及語音端的用法 |
|---|---|
| instructions | 智慧體的身分、何時請智慧體執行工作的規則,以及對話規則 |
| thinking | 近期訊息、任務狀態、選定的工具資料及使用者操作,供語音端作為無須說出口的上下文 |
| commentary | 要說給使用者聽的答案、問題和重要任務進度 |
thinking 通道傳遞的是來自應用程式的上下文,不包含主要智慧體的內部推理。從選定的工具結果轉送資料前,我們會先移除常見的憑證欄位和二進位資料、限制資料大小,並標記不完整的結果。
當使用者在畫面上的操作向智慧體送出請求時,我們會透過 thinking 通道通知語音端。這樣,語音端就能告知使用者已收到操作,不必再問一次,也不會重複送出請求。
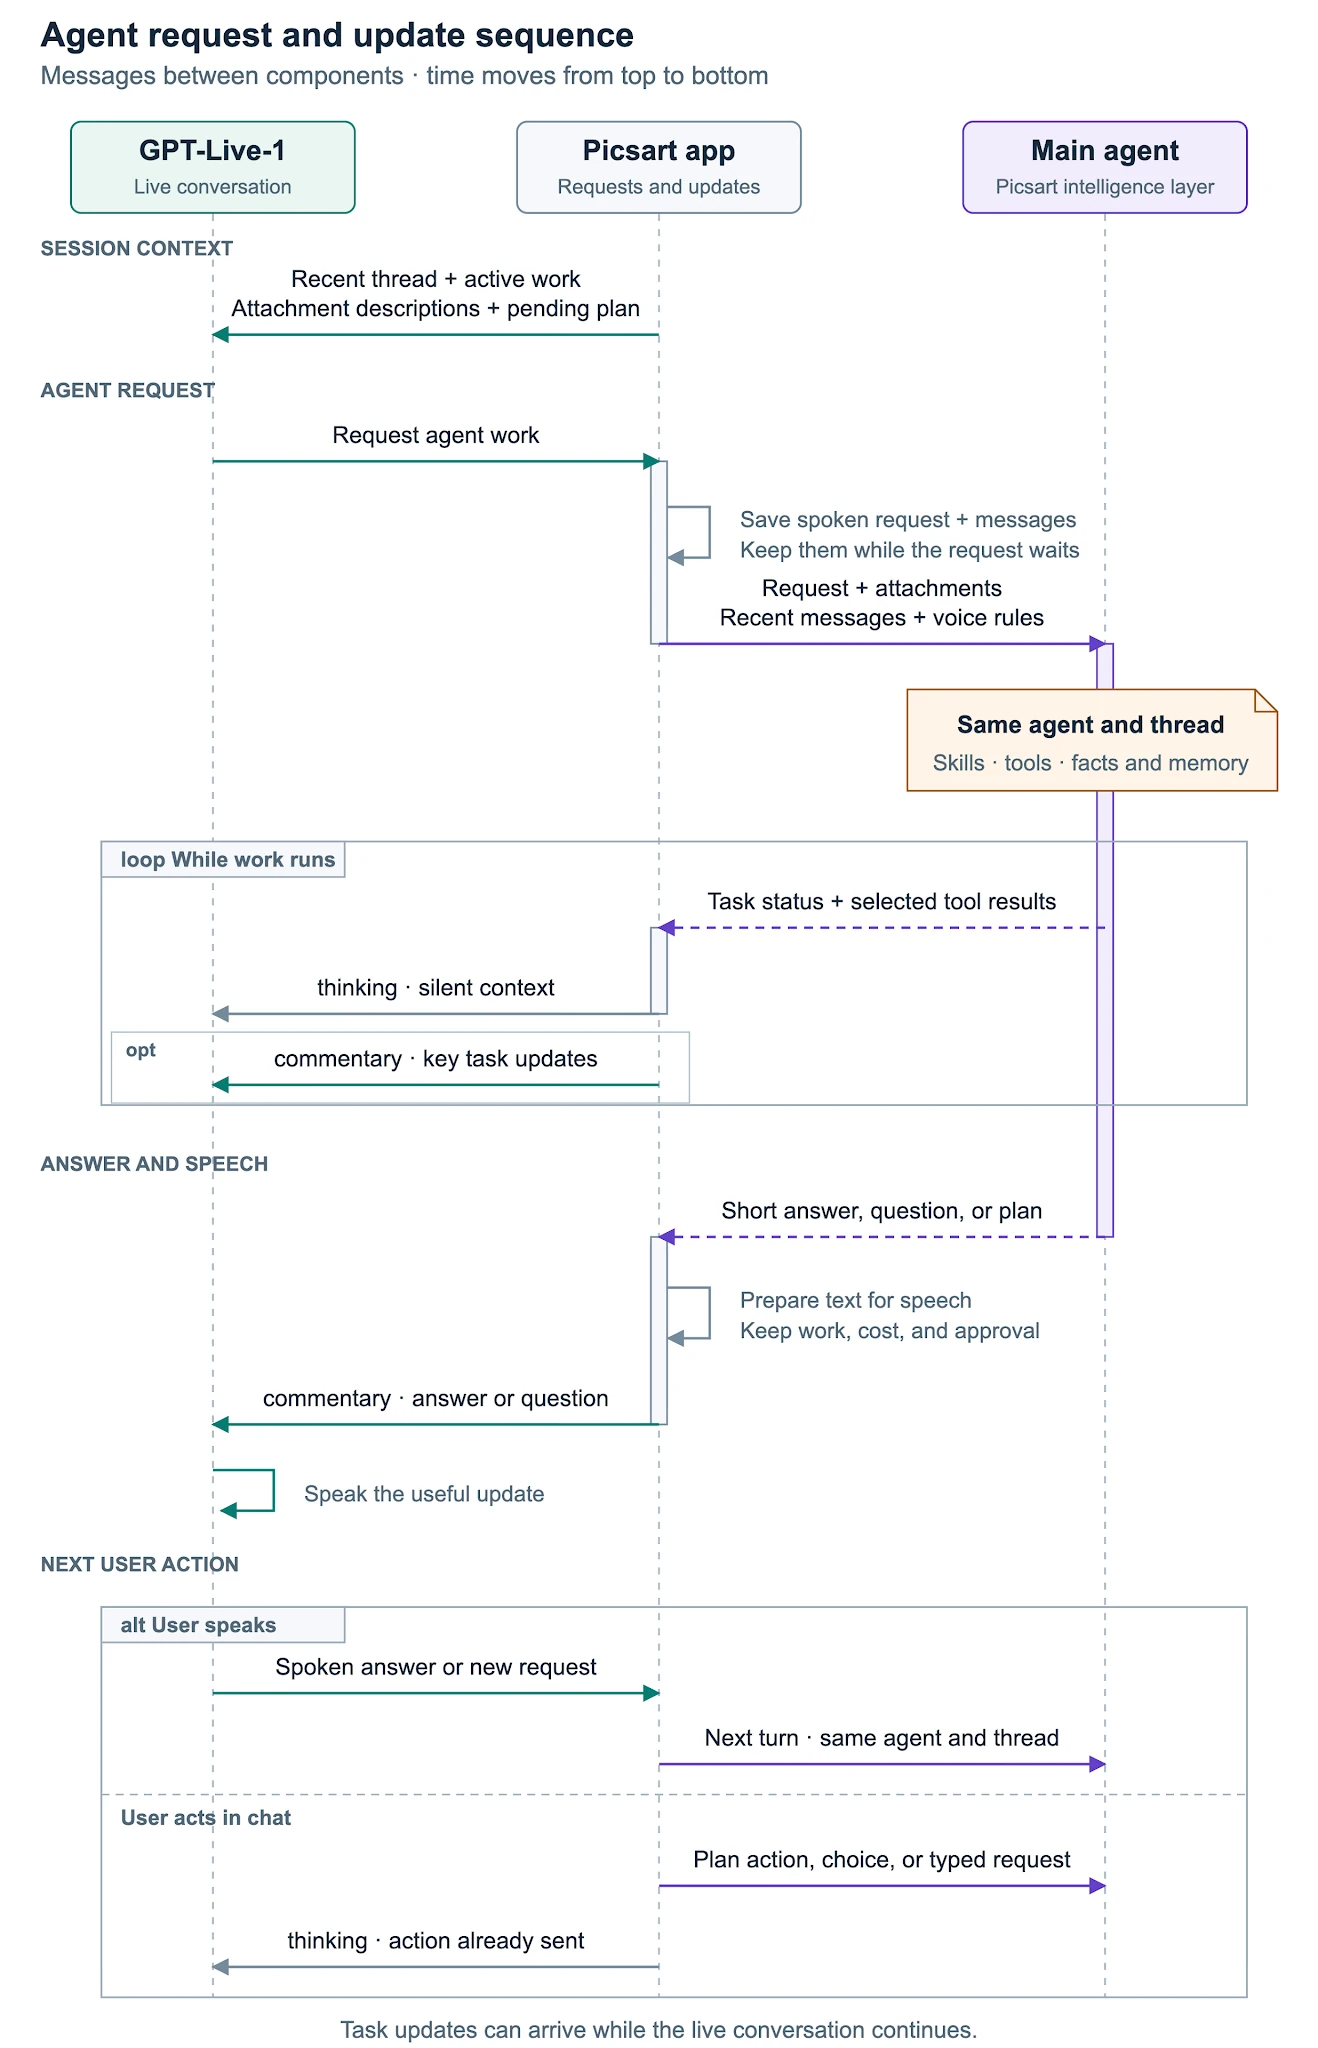
例行的工具操作無須播報。計畫開始執行或任務完成時,語音端才會告知使用者。我們會把串流傳來的答案整理成完整句子,等對話出現空檔再送到語音端。最終答案送達時,已傳送過的文字不會重複,但更正內容和需要使用者核准的問題仍會轉達。
通話會帶入什麼,又會儲存什麼
工作階段的指示用來定義智慧體的角色。至於智慧體記得哪些關於使用者的事,則另有機制。通話開始時,我們會載入近期訊息、附件描述、進行中的任務和待核准事項,讓語音端能接續使用者先前的進度。
長期記憶由主要智慧體管理。啟用記憶後,智慧體可以使用對話串紀錄、摘要、已儲存的事實,以及使用者或專案的偏好設定。
如果使用者說「用我們之前存下來的風格」,主要智慧體可以查詢記憶或提問釐清,再把答案傳回語音端。如果無法使用記憶,通話仍可繼續,只是可參考的上下文較少。
對話串會儲存送給智慧體的請求及隨附訊息,但不會逐句儲存通話內容。閒聊中提到的偏好,只有在主要智慧體收到並儲存後才會留下紀錄。
工作何時開始、繼續或停止
智慧體說明計畫後,我們才會用語音轉達。只有在智慧體確認已開始執行後,我們才會說工作正在進行。我們會一併說明預計執行的工作及費用,並詢問使用者是否核准。使用者補充上下文,並不代表已授權執行更多工作或增加支出。
如果漏接一次更新,我們會重新取得現有任務的狀態,避免重啟任務、再次播報結果或重提核准問題。
使用者打斷語音或離開通話,工作都會繼續。若要停止任務,必須另外提出請求,而且已在進行中的動作可能無法中止。新的請求會保留送出時的上下文,等目前這一輪結束後再處理,不會改動正在執行的工作。
經驗談:讓語音端知道得多,說得精簡
這次整合讓我們學到幾個實作要點:
- 由主要智慧體準備適合說出口的答案。
- 每次送出請求時,就儲存該次請求的上下文。
- 讓語音、文字和畫面操作共用對話串與規則。
- 讓對話與任務分開進行。
關於 Picsart
Picsart 是一個 AI 媒體製作與發行平台。全球有超過 1 億名創作者與企業用戶在這裡製作、行銷內容,並透過內容獲利。
14 年多來,Picsart 一直幫助新一代創作者用影片說故事,從創作、擴大製作規模,到如今透過影片獲利。Picsart 結合直覺的設計工具、AI 圖像與影片創作功能,以及 MCP 和 CLI 功能,讓創作者可以在自己慣用的工作環境中使用。如今,Picsart 每月有超過 1 億名活躍使用者,累計下載次數超過 25 億次。創作者可以在平台上自主創作並擴大規模,透過內容建立個人形象、發揮影響力,也能開創自己的事業。
Treater:調整語音智慧體,提升通話成效
作者:共同創辦人暨執行長 Britt O’Daly、共同創辦人暨技術長 Ayaz Hafiz、軟體開發者 Sayd Agzamkhodjaev
讓對話帶來實際成果
有一次,我們的語音智慧體打電話給一家人力仲介公司,和負責人聊起招募人員使用排程軟體時遇到的困難。
負責人正在解釋之前的方案為什麼不管用,智慧體卻不斷插話,回應「嗯哼」、「對,對」。最後,對方直接結束了對話:
這樣吧,你寄封電子郵件給我就好。
智慧體聽懂了對方的意思,但頻頻插話讓通話體驗很差。業務人員會從這次互動中學到教訓,下次換個方式交談。我們希望智慧體也能做到這一點。
在 Treater,我們開發 AI 智慧體,幫助企業透過電話、電子郵件和簡訊聯繫合作夥伴、協同工作。我們希望智慧體能透過出色的對話體驗,幫客戶達成目標。為此,我們建立了一套學習系統,評估真實對話、找出改進空間,再以客戶的實際成果檢驗新的智慧體設定。
下面這段示範呈現了我們的智慧體如何與多方協調,解決一家食品雜貨店的缺貨問題。
在實際工作中學習的智慧體
在使用 GPT-Live 之前,我們花了很多時間建構和維護一整套客製化語音系統。採用 GPT-Live 後,我們移除了幾乎所有自建元件,改用簡單的提示詞,表現還更好。就我們的客戶而言,較長的對話往往伴隨較好的成果。自從採用 GPT-Live,對話長度的中位數增加了 26–30%,第 90 百分位數的增幅則高達 40%。
客戶重視的目標,達成率平均提高了 6 個百分點。
這讓我們能把更多時間花在真正決定產品好壞的問題上,用釀酒來比喻就是「怎麼讓我們的啤酒更好喝」:讓智慧體在不斷變動的工作環境中學習與調適。就像人在工作中逐漸成長,我們也希望智慧體在實際工作中學會什麼才算「做得好」。
為了改進智慧體,我們針對每個智慧體的多個設定維度取樣,包括聲音、提示詞、說話節奏和可用工具,再為每次對話評分。評分標準有些由我們訂定,例如對話中的情緒、實際採取的步驟;有些由客戶訂定,例如是否遵循偏好、目標達成了多少。我們使用多臂吃角子老虎機演算法,逐步把流量分配給得分較高的設定,並迅速淘汰表現不佳的設定。
離線審查系統會讀取過去的通話紀錄,提出新設定。我們用過去的對話逐一重播測試每項提案,預測它在正式環境中的獎勵,先篩掉預期無法改善成效的變更。其餘變更會交給客戶審查;客戶也可以選擇自動上線。
使用 GPT-Live 後,許多設定都很容易調整。從前,要改變語氣、節奏、是否配合對方的情緒、用語有多正式,或是多久出聲附和一次,每一項都需要協調語音系統中的多個元件。現在,多數設定只要在提示詞中寫一行就能調整,也讓不同版本更容易直接比較。
示範:我們的智慧體從與人力仲介公司負責人的那通電話中學到了什麼?
Treater 智慧體如何持續改進
Start with a goal
A software company wants demos with staffing agency owners. The catalog starts with one version of the agent.
這段示範將開頭提到的業務活動匿名化並加以簡化:一家公司從基本版智慧體開始,打電話邀請人力仲介公司預約產品示範。
- 系統找出改進機會: 離線審查系統讀取獎勵較低的通話紀錄,找出反覆出現的情形。其中一項發現是,有 20% 的通話出現智慧體出聲附和、打斷負責人說話的情況。系統據此提出四種新設定。
- 系統提出改進方案: 每項提案都以過去的通話進行模擬,並依正式環境的評估方式給予獎勵。放慢語速的版本得分很低,立刻遭到淘汰,其餘版本經過審查後獲得核准。
- 在正式環境中評估: 系統依預期獎勵分配流量給新版本。不到一天,B 版就接下了大部分通話。C 版始終追不上,在第 3 天停用。第 2 天加入的 D 版到第 3 天一開始就取得領先,最後接下約 90% 的通話。A 版和 B 版各自保留少量流量,以因應環境變化。每 100 通電話預約到的產品示範從 3.0 場增加到 4.3 場。
這套系統採用分層設計,這點很重要。改進共用的任務執行框架,每個使用情境都會受益;一個工作流程學到的經驗,也能成為其他類似流程的起點。
我們牢記的經驗
- 任何想法都是有待驗證的假設!有一次,客戶想讓智慧體以即將推出的促銷活動開場,但實測發現,先聊起最近產品銷售率提升的通話,成效好得多。這是我們看過差異最明顯的例子之一。
- 用能提供明確訊號、又能實質推進目標的成果來設定獎勵。如果評估這類獎勵需要很長的時間(例如談成一筆新交易),就投入資源衡量能快速觀察的成果(例如約到下一次會議),但務必驗證兩者確實相關。
- 投入資源,讓智慧體實際工作的環境可以觀測和衡量。模擬與基準測試必須準確反映真實情況的分布,結果才有意義。
- 使用 GPT-Live 時,可以試著描述想達到的效果,少一些逐步規定。只要有上下文和大致方針,GPT-Live 智慧體就很能因應情況調整,不需要完整逐字稿。
有了 GPT-Live,我們不斷看到對話品質出現躍升,也很期待再往上走十階,會看到什麼樣的進展!
關於 Treater
Treater 透過與真實世界中的人交談,幫你達成業務目標,並像對待你最重要的商機一樣,把握每一次機會。我們的平台透過數千個不同的智慧體處理數十萬通電話,過去一年,通話量每月成長 25%。我們的客戶涵蓋上市企業和快速成長的新創公司。詳見 trytreater.com。
Weekend:兩個 GPT-Live 角色如何在 Wit’s End 中同場演出
作者:Weekend 資深軟體工程師 Kevin Shen、共同創辦人暨技術長 James Wilsterman
我們想打造什麼
我們的遊戲 Wit’s End 是一款以語音為主要互動方式的奇幻桌上遊戲。AI 遊戲主持人 Sir Bart 負責講故事、執行規則,玩家開口說話就能玩。GPT-Live 的全雙工音訊讓人感覺就像真的圍坐在桌邊:玩家可以插話、開玩笑、爭辯,而 Sir Bart 不用等他們說完就能回應。
角色配音是當時的弱點。一個 GPT-Live 工作階段只能用一種聲音說話,所以城門口那位語氣粗獷的隊長和酒館裡受驚的老婦人,聽起來都像旁白。我們希望每一幕的主要角色都能用自己的聲音和個性開口說話,同時保留遊戲最重要的特色:玩家什麼都可以說,故事還是能走到結局。
現在,一幕戲是這樣進行的。冒險小隊抵達 Timberfall 城門,Sir Bart 先描述眼前的場景,然後停下來:「一隊不苟言笑的衛兵守在城門口。隊長上前一步,一手按著劍,打量著你們。」接著,隊長 Dmitri 用低沉沙啞的聲音開口。他正在追捕一名叫 Jade 的叛徒,而這支小隊的模樣正好符合她同夥的描述。一名玩家和他爭辯,Dmitri 也回嘴。另一名玩家偷偷塞給他一枚金幣。Sir Bart 插話宣布擲骰,說明這次行賄的結果,再讓 Dmitri 接話,做出反應。
解決方式:兩個聲音,一位導演
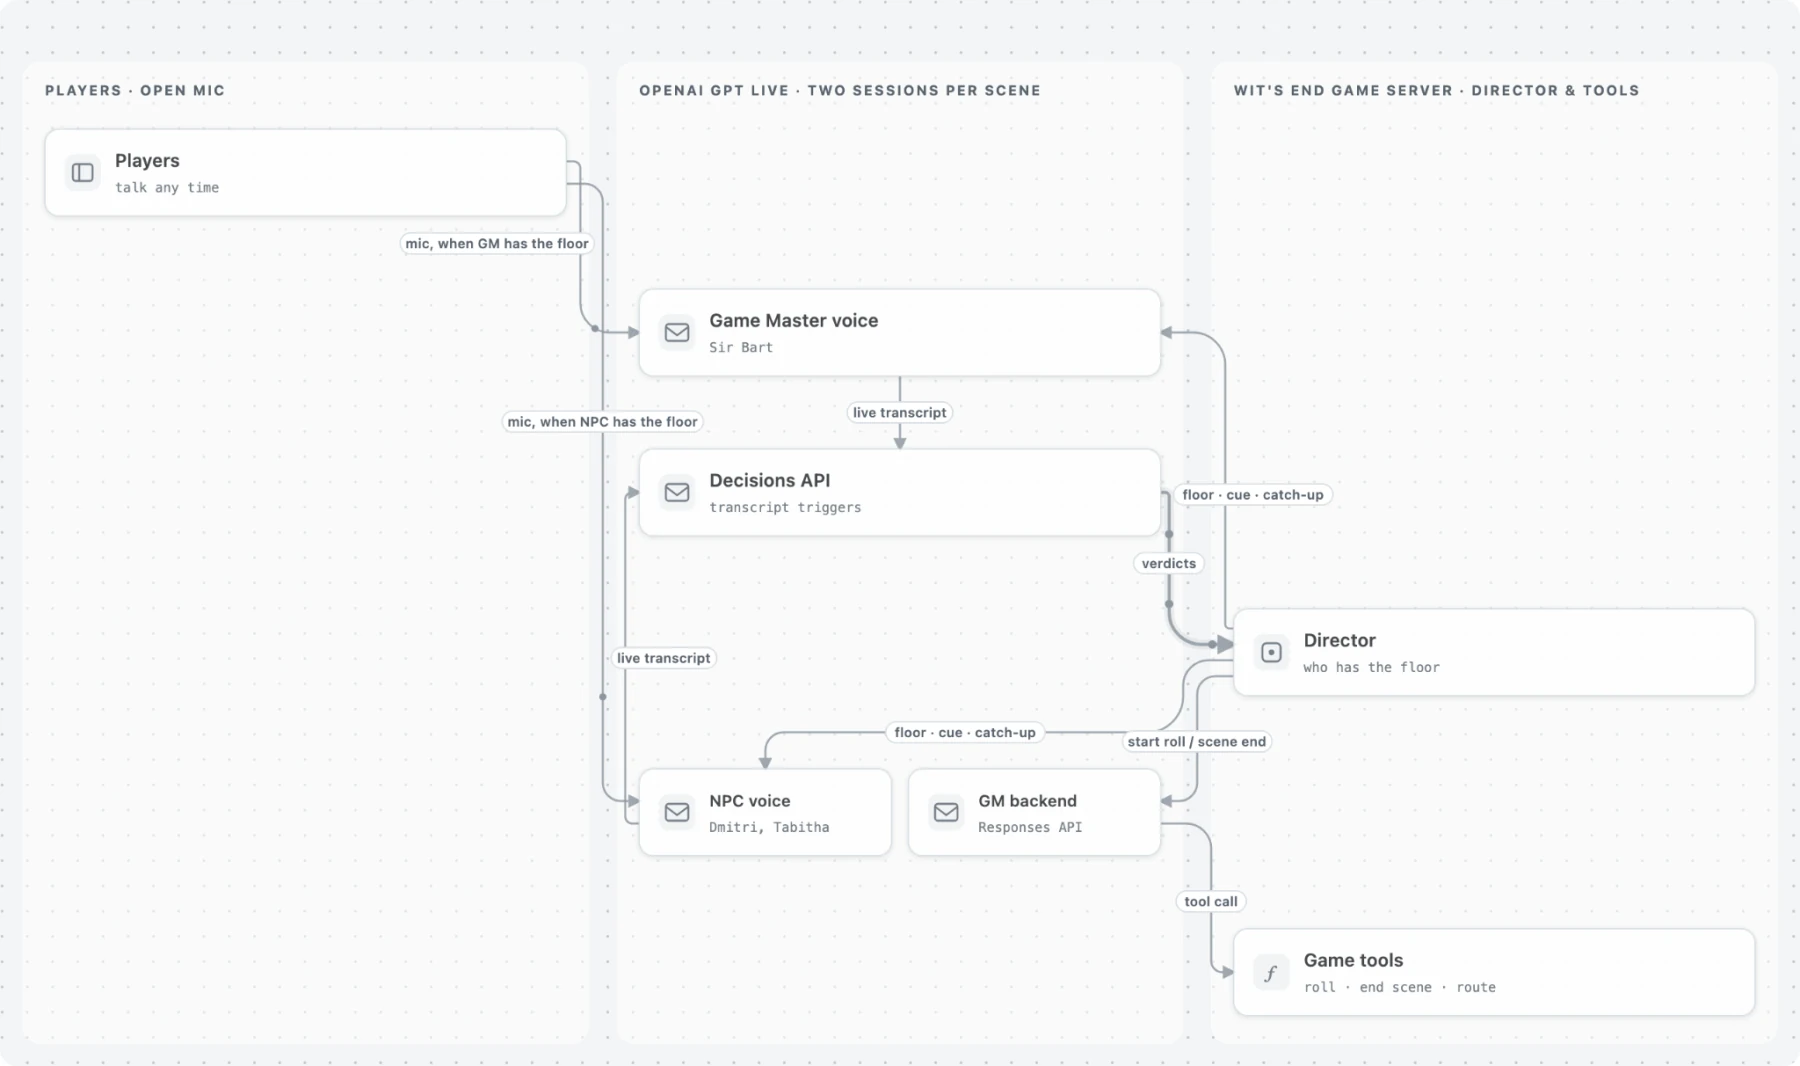
現在輪到誰說話?Decisions API 會分析兩個工作階段的逐字稿,判定接下來該由誰開口。導演依此在兩個聲音之間切換發言權,並在遊戲主持人的後端啟動擲骰和場景結束流程。
每一幕都會同時執行兩個 GPT-Live 工作階段:一個屬於 Sir Bart,另一個屬於當前場景的角色(城門口的 Dmitri 或酒館裡的 Tabitha)。兩者各有自己的提示詞與自訂聲音。遊戲伺服器上的導演程式決定由誰發言,只有持有發言權的一方聽得到玩家說話。我們在兩個工作階段中都設定了 Decisions API 逐字稿觸發條件,讓導演得知對話中發生了什麼事。遊戲主持人的後端使用 Responses 模型,也是唯一能呼叫遊戲工具的元件,負責擲骰、結束場景和處理路線選擇。
兩種個性,同一個故事
我們把每個角色的設定分成角色專屬和場景共用兩部分。
角色的個性寫在各自的提示詞裡。
每份提示詞也會描述角色的聲音,沿用當初設計該聲音時使用的措辭。
共用場景範例
場景由雙方共用。Sir Bart 和場景角色收到的是同一個衝突、同一種解決方式,以及同一組劇情要點。每個要點都會註明該由誰說。Dmitri 會自我介紹,說明自己在追捕誰;Tabitha 則會告訴小隊,Jade 會在哪裡與他們會合。每個要點都必須由指定的聲音說出來,遊戲才會結束這一幕。
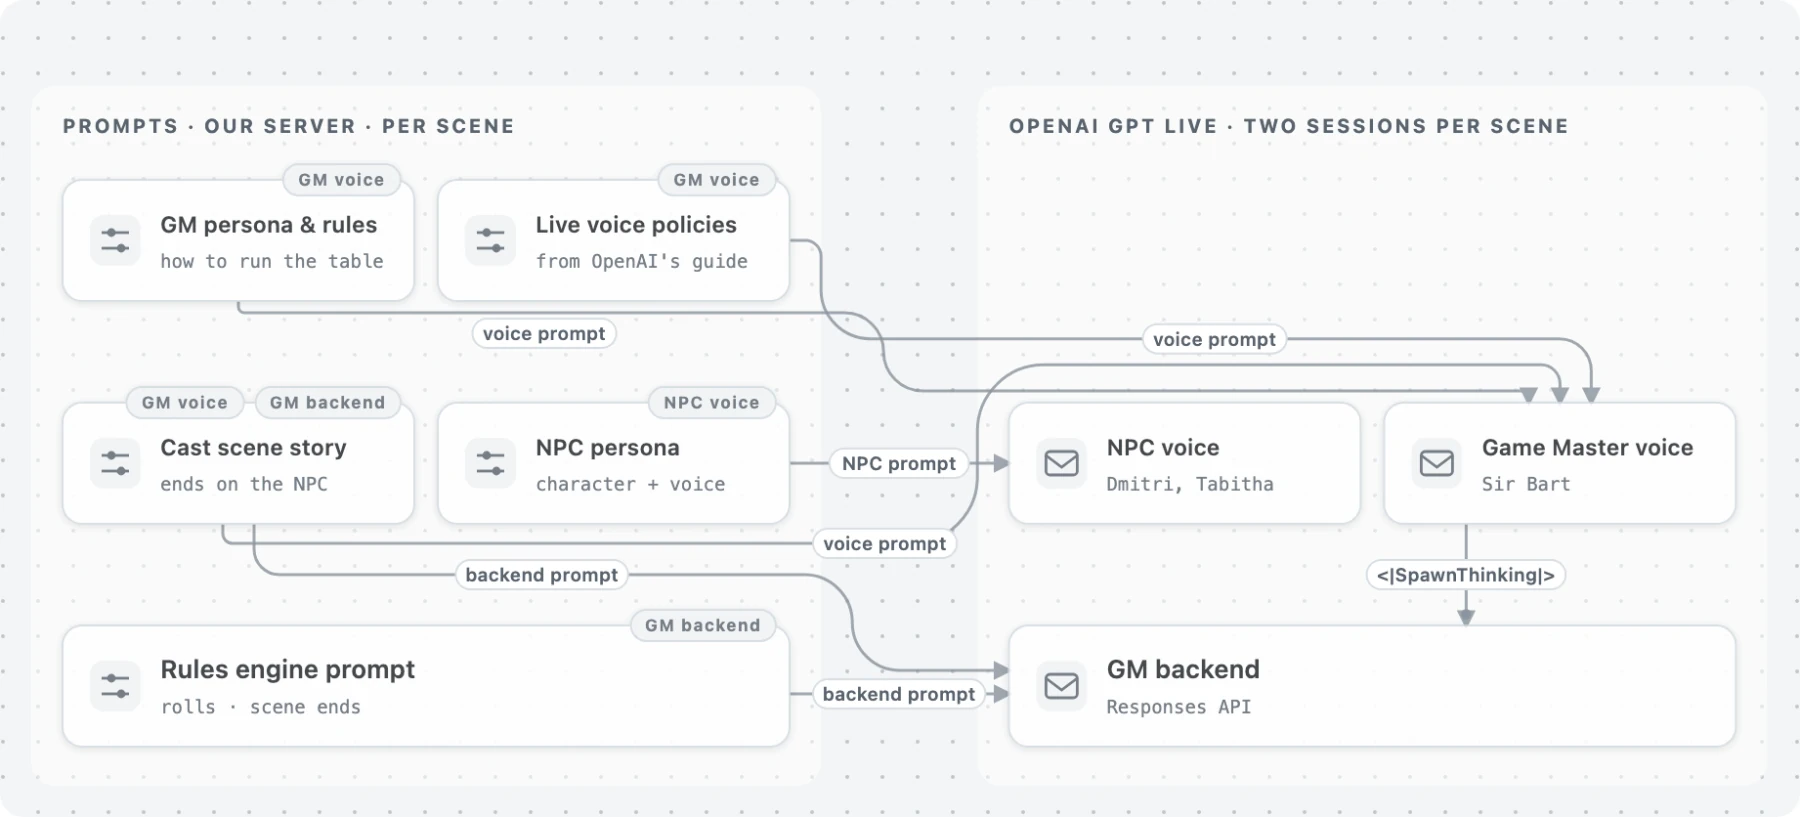
提示詞結構。Sir Bart 的語音工作階段和後端共用場景劇情,場景角色則有自己的人物設定提示詞。
角色提示詞節錄
你是這場即時語音演出中的一名演員。
旁白負責描述這個世界。你開口時,一律以自己的角色身分,
用第一人稱說話。
- 不要擔任旁白,不要描述自己的動作或聲音,
  也不要替旅人或旁白說話。
- 有人嘗試冒險行動時,不要自行決定是否成功。
  只用一句簡短的話回應,說完就停下來,讓旁白裁定結果。
- 只有在旅人對你說話,或你取得發言權時,才開口說話。
導演如何決定下一個開口的人
導演本身不生成語音。它使用 Decisions API 對陸續傳入的逐字稿片段做出判定,辨識玩家正在跟誰說話、某個動作是否需要擲骰,以及何時該在一段旁白或角色的最後一句台詞之後交接發言權。

判定會隨玩家說出的內容而改變。導演會等這一輪發言結束、判定穩定後,才確認玩家在跟誰說話。但只要辨識出冒險行動,就會立即交給遊戲主持人。
接下來由誰發言
| 情況 | 接下來由誰發言 |
|---|---|
| Sir Bart 說完旁白,接話提示的判定分數達 0.6 以上,或他的台詞以表示說話的動詞作結(例如「Tabitha 在你身後喊道」) | 場景角色 |
| Sir Bart 持有發言權時,玩家對場景角色說話 | 場景角色,同時會收到需要回應的那句話 |
| 玩家嘗試冒險行動,例如行賄、說謊、偷偷溜過或打鬥 | Sir Bart 立即接手,必要時在玩家說到一半就介入。導演在他的後端啟動擲骰,Sir Bart 敘述結果後再交回發言權 |
| 玩家向旁白提問,或描述自己所扮演角色的動作 | Sir Bart |
| 玩家彼此交談 | 雙方都不開口。持有發言權的一方會收到一次性指示,讓玩家繼續聊 |
| 角色的台詞已經為自己的戲份收尾(例如「那就走吧。低調點。」) | 角色說完後,由 Sir Bart 接手。導演會在他的後端啟動場景結束流程 |
| 取得發言權的一方已沉默 2.5 秒 | 維持同一位發言者,再提示一次 |
如何交接發言權
每次交接都會執行四個步驟:
- 將交出發言權的工作階段靜音,指示它停止說話,並捨棄它排入佇列的所有音訊。
- 透過
session.thinking.append,將新發言者錯過的內容作為無須說出口的上下文補給它。同樣的對話內容也會加入該工作階段的 Decisions 上下文,讓觸發條件依據相同的歷史紀錄做判斷。 - 解除新發言者的靜音狀態,並提示它開口。
- 暫時關閉玩家的麥克風,直到新發言者說完第一句話,最長 8 秒,避免玩家在交接時蓋過新發言者的聲音。
由於場景角色的工作階段已在執行,從交接到聽見第一個聲音平均只需 0.84 秒;如果新開工作階段,則需要 1.54 秒。
讓遊戲持續朝結局推進
兩個聲音都可以即興演出。何時觸發遊戲事件,則由應用程式決定。
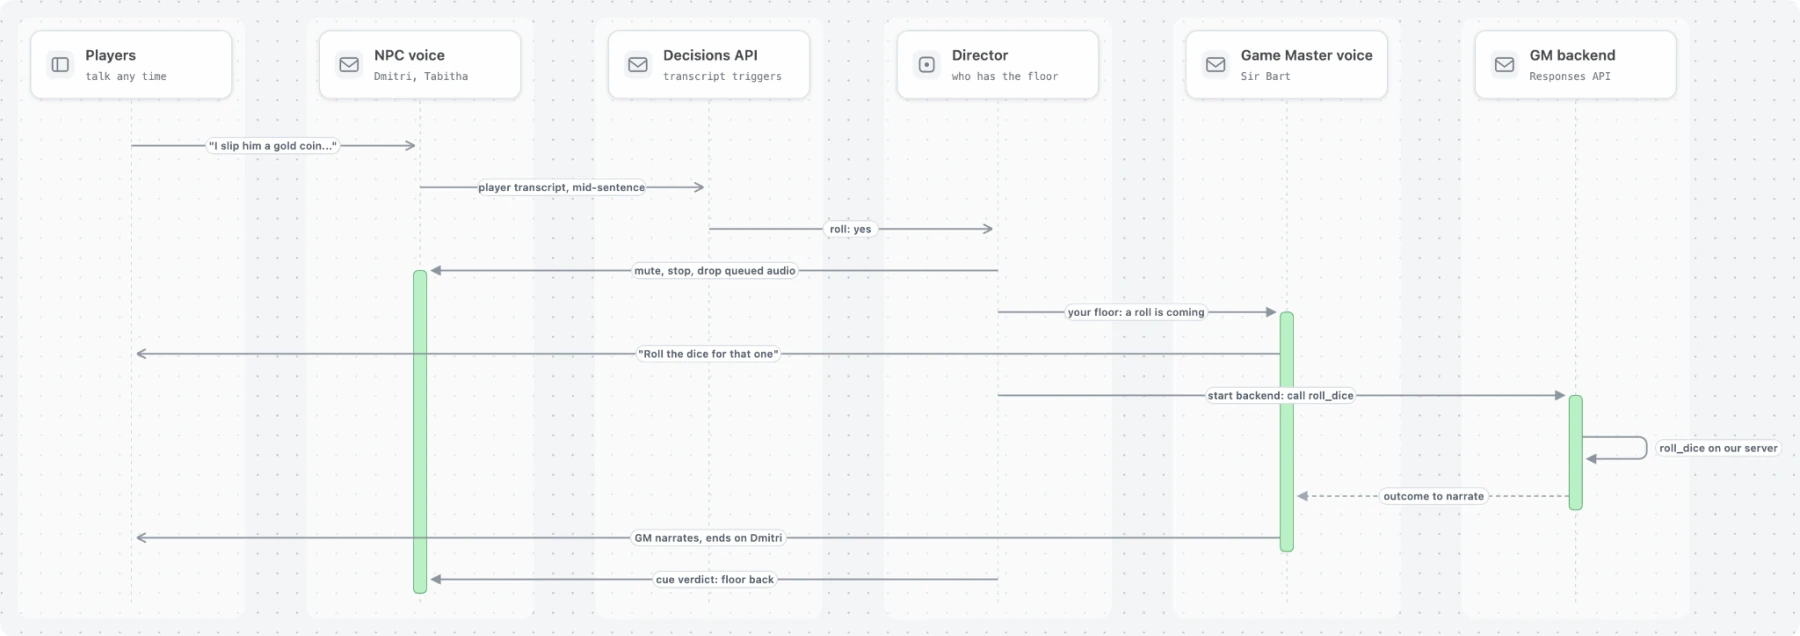
Dmitri 持有發言權時,玩家試圖行賄。玩家話還沒說完,系統就判定需要擲骰。導演將發言權交給 Sir Bart,並在他的後端啟動擲骰。等 Sir Bart 敘述完結果,系統會依接話提示的判定將發言權交回 Dmitri。
- 導演會自行啟動擲骰和場景結束流程。 有一次試玩,Sir Bart 說「這次你得擲骰才行」,卻沒有把工作交給後端。結果骰子根本沒擲,他自己編了一個結果。現在,導演會直接在 Sir Bart 的後端啟動回應。執行期間,語音端會先說一句簡短的台詞,等結果出來後再加以敘述。
- 每一幕的結果由骰子決定。 第 1 幕要等擲骰成功才會結束。如果還沒擲骰,Dmitri 就先讓了步,導演仍會要求擲骰來判定玩家的行動結果,不會直接結束這一幕。
- 角色可以結束自己的戲份,再由遊戲主持人為場景收尾。 當 Tabitha 告訴小隊 Jade 會在精靈祭壇與他們會合時,導演會將發言權交給 Sir Bart。他的後端會將場景標記為完成,再由他介紹接下來可走的兩條路。
開發心得
- 一次只讓一個工作階段聽見玩家。 當兩套系統都在聽時,每句測試台詞都會得到兩個回應,而且兩者往往互相矛盾。例如,Dmitri 拒絕收賄,遊戲主持人卻說他把錢放進了口袋。
- 即使工作階段已靜音,也要指示它停止說話。 明確要求它停止,並捨棄已排入佇列的音訊。當它重新取得發言權時,也要明確解除「保持安靜」的指示。有一次,遊戲主持人因為仍受這條規則限制,整整一幕都沒回應任何人。
- 讓每個聲音的工作階段都保持就緒。 工作階段的聲音在啟動時就已決定,因此每種聲音都需要自己的工作階段。在場景開始時就啟動角色的工作階段,每次交接就能省下約 0.7 秒。這點時間,足以讓尷尬的停頓變成自然的接話。
- 針對不同判定,在適當的時機採取行動。 玩家還在說話時,判定就會陸續送達。從玩家停止說話到最後一個判定送達,時間中位數為 0.19 秒。辨識出冒險行動就立刻交給遊戲主持人;至於一句話是對誰說的,則等這一輪發言結束、判定穩定後再決定。
- 將是非題設為判斷式,根據真實台詞設定門檻,並保留簡單的備援規則。 對「Should Dmitri speak next?」這個問題,使用判斷式時,12 次中答對 11 次;改成二選一時,12 次中答對 8 次。門檻設為 0.4 時,「You’re going to have to roll the dice for that one」被誤判為接話提示,擲骰還沒結束,發言權就交給了 Dmitri。真正的接話提示得分都在 0.94 以上,因此我們採用 0.6 作為門檻。另外,「Tabitha calls after you」只得到 0.04 分,所以我們也會檢查旁白是否以表示說話的動詞作結,藉此辨識旁白停下、該讓角色開口的時機。
- 每個結果都要有唯一的負責方。 只有遊戲主持人的後端能呼叫工具,擲骰和場景結束流程則由應用程式啟動,語音端無權啟動。這樣一來,每個角色都能自由即興演出,又不會破壞遊戲規則。
關於作者與公司
Weekend 團隊打造的 Wit’s End,是一款以語音為主要互動方式的奇幻桌上遊戲。AI 遊戲主持人負責帶動劇情,玩家在瀏覽器或電視上開口說話就能玩。你可以前往 witsend.ai 體驗遊戲。
Weekend 的前身是 Volley,專為電視開發語音遊戲,讓全家人看電視的時間,也能成為一起開口玩遊戲的時光。旗下有超過 25 款遊戲,包括 Jeopardy!、Wheel of Fortune、Song Quiz 和 Wit’s End,可在 Roku、Fire TV、Samsung 和 LG 電視上遊玩,已有超過 3,000 萬個家庭玩過。Weekend 的投資者包括 Microsoft 旗下的 M12、Lightspeed Venture Partners 和 Y Combinator。
語音智慧體的下一步
語音的下一步,除了讓對話更自然,也要讓軟體在執行工作時繼續聆聽、在不同介面之間沿用上下文,並協調多個聲音,讓對話前後連貫。GPT-Live 能同時聽和說,讓開發者可以依循人們交談的節奏設計互動,不必讓使用者等輪到自己才能開口。
這四個故事呈現了實作的不同面向:Juno 邀請實際使用者試聽各種聲音,Picsart 讓對話和背景工作保持同步,Treater 從真實通話中學習,Weekend 則讓每個角色都擁有自己的聲音,同時掌握遊戲進程。
GPT-Live 讓人們多了一種與軟體互動的直覺方式,也拓展了智慧體能做到的事。人們可以邊聊邊發展創意、引導正在進行的工作,或走進故事裡,影響接下來的情節。當對話成為軟體運作的一部分,這些應用只是開發者能創造的眾多可能的開端。
想打造自己的語音體驗,可以從 GPT-Live 入門指南和工作委派與工具文件開始。