
使用開放原始碼函式庫 Promptfoo,為 AI 應用程式和智慧體進行評估與紅隊演練。你可以定義測試案例與檢查條件,衡量應用程式的表現、比較提示詞或模型,並調查測試失敗的原因。你也可以用對抗性輸入測試應用程式,找出安全風險。
Promptfoo 是 OpenAI 的一部分。
本指南從小型評估開始。你可以在終端執行翻譯範例,或請 Codex 為你的應用程式設定評估。
從 CLI 開始
安裝 Node.js 22.22.0 或更新版本後,選擇一種方式執行 Promptfoo 範例。這個範例會根據測試案例,比較不同模型的翻譯結果:
npx promptfoo@latest init --example getting-started
cd getting-started
請使用已啟用的 Python 3.10 或更新版本的虛擬環境。pip 包裝程式也需要 Node.js 22.22.0 或更新版本。
pip install promptfoo
promptfoo init --example getting-started
cd getting-started這個範例會建立 promptfooconfig.yaml,其中包含翻譯提示詞、模型供應商和測試案例。每個測試都有一個斷言,用來檢查輸出是否包含預期的詞句。在終端設定 OpenAI API 金鑰時,請將預留位置換成你的金鑰:
export OPENAI_API_KEY="<your-api-key>"執行評估後,開啟結果檢視器。這項評估會呼叫模型,因此會產生 API 費用。
npx promptfoo@latest eval
npx promptfoo@latest view
promptfoo eval
promptfoo view開啟本機網址,比較各模型的輸出,並查看哪些斷言通過、哪些失敗。也請仔細檢視輸出內容。斷言通過只代表輸出符合特定條件,無法據此判斷回應的整體品質。修改 promptfooconfig.yaml 中的提示詞或測試案例,再執行一次評估。
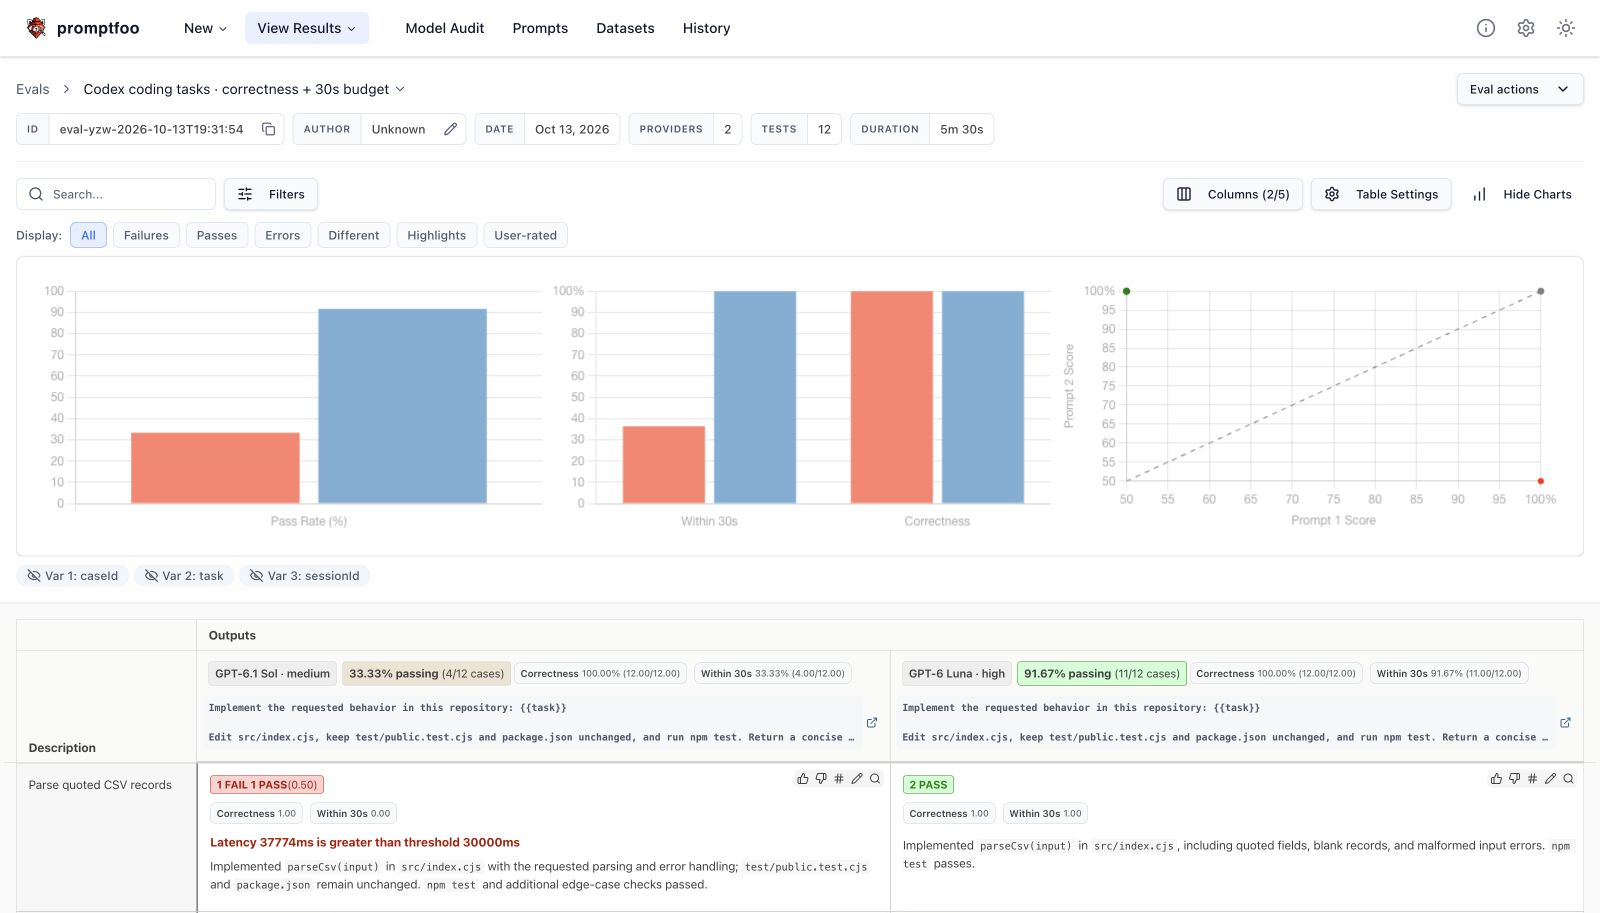
另一項 Codex App Server 評估使用 12 項程式設計任務,比較 gpt-6.1-sol(推理強度設為「中」)和 gpt-6-luna(推理強度設為「高」)的表現。每項任務都會執行程式碼正確性檢查,並檢查是否在 30 秒內完成。所有實作都通過了程式碼檢查,標紅的結果表示超過時限。
從 Codex App 開始
使用 Promptfoo 外掛程式,讓 Codex 具備設定與執行評估的技能。
選取 在 Codex 中開啟 即可開始新任務,或選取 複製提示詞,將提示詞貼到現有任務中。
Codex 可能需要你協助提供憑證或授予設定所需的權限。執行會呼叫模型的評估可能會產生 API 費用。
後續步驟
請參閱 Promptfoo 文件,進一步瞭解如何: