选择您使用的 API,了解其用量计量方式,以及管理语音应用成本的方法。
GPT-Live 用量与成本
GPT-Live 将语音对话与负责推理和运行工具的后端分开。请分别估算这两部分成本:语音会话费用取决于会话时长,后端费用取决于您使用的模型和工具。
语音会话费用
GPT-Live 语音会话按活跃费率和待机费率逐秒计费。
活跃时长包括用户或助手说话的时间、达到空闲超时前的静默时间,以及推理仍在运行时等待后端处理的时间。如果 WebRTC 会话已配置待机模式,则在推理暂停期间按待机费率计费。将麦克风输入静音后,会话仍处于活跃状态。对话结束后,请关闭会话并收集最终用量。
后端模型和工具的价格请参阅 API 定价。
WebRTC 初始化费用
采用默认启动方式时,通过 POST /v1/live/sessions 创建 WebRTC 会话会在初始化期间先收取 15 秒的语音费用。会话开始运行后,这笔费用会抵扣会话的时长费用。估算成本时,请勿在会话运行时长上再加 15 秒。
例如,活跃时长为 90 秒的会话已经包含初始化时计费的 15 秒。如果应用需要重新连接,或在用户准备好说话之前就创建会话,请在估算成本时计入创建会话的费用。
后端费用
与不提供语音功能的应用一样,后端调用单独计费,与语音会话费用分开计算。请计入模型的输入和输出 Token、模型支持的缓存输入,以及适用的图像或工具费用。如果您的应用还调用其他服务,也请计入这些服务的费用。
您可以单独优化后端处理。参照通用的成本优化指南,减少请求次数和 Token 用量。对于支持提示词缓存的后端模型,请将可复用的指令、工具定义及其他稳定内容放在提示词开头,以便利用缓存。
后端方案也可能影响对话时长。如果某项优化延长了用户的等待时间,或影响了助手完成任务的可靠性,请比较优化前后的总成本。
估算对话成本
将活跃分钟数乘以活跃费率,待机分钟数乘以待机费率,两项相加即可估算语音费用。例如,如果一次通话有 60 秒处于活跃状态、30 秒处于待机状态,则按活跃费率计算 1 分钟的费用,按待机费率计算半分钟的费用。将这两项费用与后端模型和工具费用相加,即可得到总成本。如果任务跨越多个会话,还要计入会话之间的后端处理费用。
优化策略
帮助用户减少不必要的交谈和等待,更快地完成任务,同时保留任务所需的确认和检查步骤。
在会话开始前提供相关上下文
启动语音会话前,先收集应用已获准使用的信息。例如,处理订单问题的助手可以预先获取订单号和当前状态,让用户无需重复提供这些信息或等待再次查询。
确保上下文及时更新,并且与当前任务相关。向语音模型提供对话所需的信息,将详细记录和工作流保留在后端。请参阅会话配置和委派与工具。
缩短等待工具返回结果的时间
缩短等待时间既能改善用户体验,也能降低语音会话费用。例如,假设您的后端使用 gpt-5.6-luna 的快速模式,并行执行彼此独立的工具调用。如果这些优化让用户提前一分钟完成任务并关闭语音会话,就能节省一分钟的语音费用。只要新增的后端费用低于节省的语音费用,总成本就会下降。
您还可以在收到委派事件之前,根据转写片段提前发起推测性查询。统计后端费用时,即使某次推测性查询的结果最终没有用到,也要计入其费用。
有关模型、连接、流式传输和工具的优化方法,请参阅降低后端延迟。通过语音智能体评估验证用户需要等待多久才能听到有用的答复,以及任务能否成功完成。
在执行耗时任务期间关闭会话
语音前端和由应用管理的后端可以独立运行。使用客户端委派时,无论语音会话处于打开还是关闭状态,后端工作进程都可以继续运行。请先保存任务状态和对话上下文,再关闭语音会话。
如果 WebRTC 通话需要在静默期间保持连接,请使用待机模式。如果需要在空闲时断开连接,请按关闭空闲会话并启动新会话中的步骤操作。
对于常驻智能体,当后端处理耗时任务(例如在目标模式下编写代码)时,请关闭语音会话。您可以提供恢复对话按钮,让用户返回时启动新的语音会话,也可以在后端发出任务完成事件时启动新会话,并通知用户结果已就绪。
要恢复对话,请启动新会话,并在 input 中提供已保存的上下文和经过验证的任务结果。例如,通过新的 WebSocket 连接发送以下启动事件:
{
"type": "session.start",
"session": {
"model": "gpt-live-1",
"instructions": "Help the user review completed work and delegate follow-up tasks.",
"input": [
{
"type": "message",
"role": "developer",
"content": [
{
"type": "input_text",
"text": "Saved task: add CSV export. Result: code is ready for review."
}
]
}
],
"delegation": { "type": "client" }
}
}请等到收到 session.started 事件后,再开始流式传输音频。有关支持的历史记录格式,请参阅使用已有对话初始化会话。
如果之前的会话已通过 store: true 保存,您也可以从该会话派生新会话。无论采用哪种方式,都请在应用中保留经过验证的后端任务状态。
关闭会话后,语音计费即停止。请权衡节省的费用、重新连接的成本,以及中断对用户对话的影响。
选择合适的后端模型
先筛选满足任务准确性和可靠性要求的模型,再比较对话总成本,包括语音时长、模型用量、工具调用和重试产生的费用。模型选择指南介绍了如何权衡这些因素。
如果较大的后端模型能更快地完成任务,节省的语音会话费用又超过了额外的 Token 费用,那么总成本反而可能更低。如果价格较低的模型耗时更长、重复调用工具或无法完成任务,总成本反而可能更高。
比较方案时,请同时考察每成功完成一项任务的成本、任务完成率和完成所需的时间。将失败的尝试和重试计入总成本,以免某个低价配置仅仅因为完成的任务较少,就显得更划算。设计对比评估时,请参阅 Cookbook 中的语音智能体评估示例。
监控实际用量
对于每个会话,请分别记录语音时长和后端用量。GPT-Live 以秒为单位报告累计语音用量:
{
"type": "session.usage.updated",
"event_id": "event_usage_1",
"usage": { "seconds": 12 },
"context_window": { "usage_ratio": 0.42 }
}每次更新都会替换上一次报告的累计用量。请勿将各次快照的用量相加。发送 session.close 后,请继续接收事件,直到收到 session.closed,并将其中的最终 usage.seconds 记录一次。请按正常关闭会话的流程操作,以便应用在断开连接前收集最终用量。
使用 Responses 委派时,后端响应的 usage 字段位于嵌套的 response.completed 事件中。请通过 response.event 接收这些事件并读取该字段。请按响应 ID 去重,每个后端响应只统计一次,并保留输入、输出和缓存 Token 的用量明细,以便按该模型的费率计算费用。对于应用独立执行的后端任务,也请收集相应请求的用量。
选取有代表性的对话,比较估算总成本与实际总成本。将仅用于评估的模型调用与应用用量分开统计,并结合任务成功情况评估成本。
Realtime API 费用
本节介绍 Realtime API 的计费方式和成本优化策略。语音智能体会话会累计文本、音频和图像的输入与输出 Token。流式翻译和流式转写会话按音频时长计费。各模型的价格不同,具体价格见相应的模型页面,例如 gpt-realtime-2、gpt-realtime-translate、gpt-realtime-whisper 和 gpt-realtime。
Realtime API 的对话式会话由多个轮次组成。每一轮中,用户添加输入,触发一次响应以生成模型输出。服务器维护一个对话,其中的条目组成下一轮的输入。响应返回后,输出会自动添加到对话中。
翻译和转写会话采用不同的流式架构。客户端持续发送音频,并随着源音频的传入接收翻译后的音频、增量转写文本或转写事件。这些会话不采用常规的响应生命周期。估算和监控其费用时,请使用按时长计费的费率,无需按每次响应的 Token 用量计算。
每次响应的费用
Realtime API 在创建响应时产生费用,按输入和输出 Token 数量计费(输入转写费用除外,详见下文)。目前,网络带宽和连接均免费。您可以手动创建响应,也可以开启语音活动检测(VAD),让系统自动创建响应。VAD 能有效过滤没有语音的输入音频,因此,除非客户端手动将这类音频添加到对话输入中,否则不会将其计入输入 Token。
每次生成响应时,系统都会将整个对话发送给模型。每一轮的输出都会作为条目添加到服务器维护的对话中,成为后续轮次的输入。因此,会话中越靠后的轮次费用越高。
您可以使用我们的 Token 化处理工具估算文本 Token 的费用。用户消息中每 100 毫秒音频计为 1 个音频 Token,助手消息中每 50 毫秒音频计为 1 个音频 Token。除了消息内容,用量统计还包含特殊 Token,因此实际计数可能略有差异。例如,一条内容包含 10 个文本 Token 的用户消息,实际可能计为 12 个 Token。
示例
下面通过一个简单的例子说明 Realtime API 多轮会话的 Token 费用是如何产生的。
在第一轮对话中,我们添加了 100 个 Token 的指令,以及一条包含 20 个音频 Token 的用户消息(例如由 VAD 检测到用户说话后添加),共计 120 个输入 Token。创建响应后,模型生成一条助手消息,其中包含 20 个音频 Token 和 10 个文本 Token。
接着,我们添加另一条用户音频消息,开始第二轮对话。第二轮的 Token 如何计算?此时,对话包含初始指令、第一条用户消息、助手在第一轮输出的消息,以及第二条用户消息(25 个音频 Token)。本轮的输入包含 110 个文本 Token 和 64 个音频 Token,此外还要计入助手在本轮生成的消息所用的输出 Token。
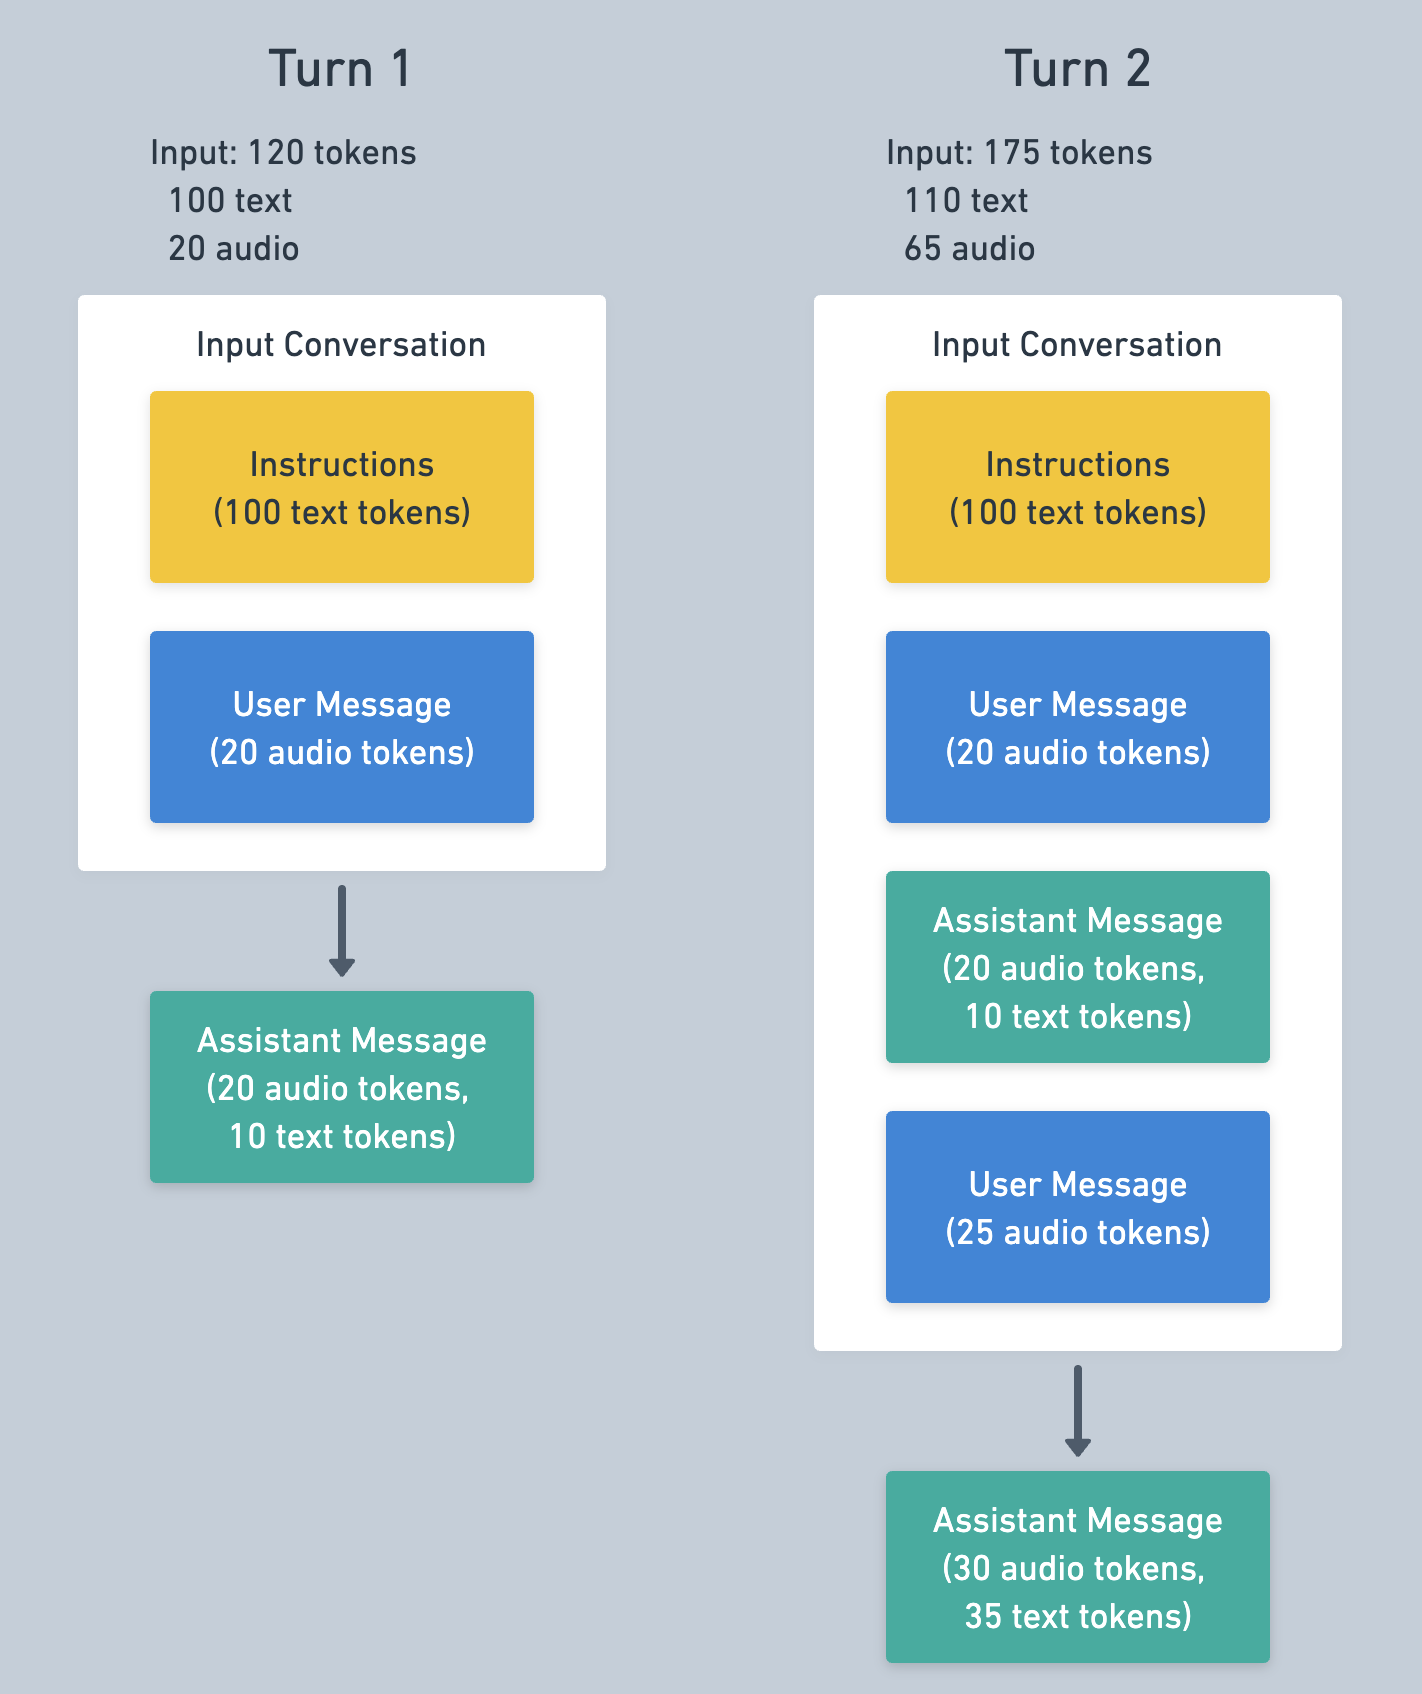
第一轮的消息在第二轮很可能命中缓存,从而降低输入费用。有关缓存的更多信息,请参阅下文。
您可以从 response.done 事件中读取一次响应的 Token 用量,如下所示。
{
"type": "response.done",
"response": {
...
"usage": {
"total_tokens": 253,
"input_tokens": 132,
"output_tokens": 121,
"input_token_details": {
"text_tokens": 119,
"audio_tokens": 13,
"image_tokens": 0,
"cached_tokens": 64,
"cached_tokens_details": {
"text_tokens": 64,
"audio_tokens": 0,
"image_tokens": 0
}
},
"output_token_details": {
"text_tokens": 30,
"audio_tokens": 91
}
}
}
}输入转写费用
如果启用了输入转写,Realtime API 会对其单独计费。输入转写所用的模型和费率均与语音到语音模型不同。请使用 gpt-transcribe 转写已提交的轮次。音频写入输入音频缓冲区并提交该缓冲区后,转写即会开始。
请从 conversation.item.input_audio_transcription.completed 事件中读取输入转写用量。用量字段取决于转写模型:gpt-transcribe 按音频时长计费,而按 Token 用量计费的模型会返回 Token 数量。例如,按时长计量的用量数据格式如下:
{
"type": "conversation.item.input_audio_transcription.completed",
"transcript": "Hi, can you hear me?",
"usage": {
"type": "duration",
"seconds": 3
}
}缓存
Realtime API 支持提示词缓存。系统会自动应用缓存,可显著降低多轮会话的输入 Token 费用。当某次响应的输入 Token 与之前某次响应的 Token 匹配时,系统会尽可能复用缓存,但不保证命中。
要最大限度地提高缓存命中率,最好保持已有的会话历史记录不变。删除或修改对话内容后,能够匹配缓存的输入前缀会缩短,只有改动位置之前的部分仍可能命中缓存。指令和工具定义位于对话开头,因此,在会话中途更改它们会降低后续轮次的缓存命中率。
截断
当对话中的 Token 数量超过模型的输入 Token 上限时,系统会截断对话,从最早的消息开始依次从响应输入中移除消息。对于上下文窗口为 32k、最多可输出 4,096 个 Token 的模型,上下文中最多可包含 28,224 个 Token,再多就会触发截断。
客户端可以将 Token 窗口设为小于模型上限的值,以控制 Token 用量和成本。您可以通过 token_limits.post_instructions 配置这一窗口,前提是按下方示例将截断类型设为 retention_ratio。该设置限制的是每次响应的输入 Token 数量,不包括指令 Token。将 post_instructions 设为 1,000 后,生成响应时,超出 1,000 个输入 Token 上限的条目不会发送给模型。
截断会导致对话开头附近的缓存失效。如果每一轮都发生截断,缓存命中率就会很低。为缓解这一问题,客户端可以配置截断策略,一次多移除一些消息,为后续轮次留出更多空间,推迟下一次截断。您可以通过 session.truncation.retention_ratio 控制这一行为。服务器默认使用 1.0,表示截断时只移除必要的条目。设为 0.8 表示截断后保留的 Token 数量为上限的 80%,即额外移除相当于上限 20% 的 Token。
如果您希望降低某个模型的 Realtime API 单次会话费用,建议调低 Token 数量上限,并将 retention_ratio 设为小于 1 的值,如下例所示。这样做可以降低成本,但模型在某一轮中可参考的历史内容也可能减少。
{
"event": "session.update",
"session": {
"truncation": {
"type": "retention_ratio",
"retention_ratio": 0.8,
"token_limits": {
"post_instructions": 8000
}
}
}
}您也可以完全禁用截断,如下所示。禁用后,如果对话过长而无法创建响应,系统会返回错误。如果您打算手动管理对话长度,可以使用此设置。
{
"event": "session.update",
"session": {
"truncation": "disabled"
}
}其他优化策略
使用 mini 模型
Realtime 语音到语音模型提供常规版和 mini 版,mini 版的价格低得多。两者主要在遵循指令和函数调用的能力上有所差异,mini 模型在这两方面的表现通常较弱。建议先用较大的模型测试应用,完善应用和提示词,再尝试使用 mini 模型优化成本。
编辑对话
服务器会自动截断对话,您也可以通过手动编辑对话来管理成本。该 API 的设计原则之一是让客户端完全掌控服务器端的对话,可以按需添加和移除条目。
{
"type": "conversation.item.delete",
"item_id": "item_CCXLecNJVIVR2HUy3ABLj"
}清理旧消息可以减少输入 Token 数量并降低成本,但也可能丢失重要内容。常见的做法是用摘要替换这些旧消息。您可以像上例一样使用 conversation.item.delete 消息从对话中删除条目,也可以使用 conversation.item.create 消息添加条目。
估算费用
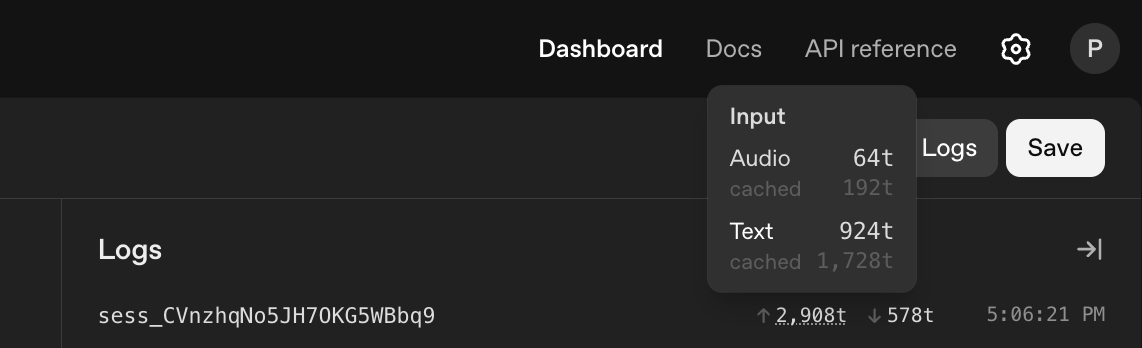
Realtime API 的 Token 用量计算较为复杂,可能很难提前估算费用。一种实用的做法是在 Realtime Playground 中使用您计划采用的提示词和函数运行一次示例会话,并测量 Token 用量。在 Realtime Playground 的“日志”选项卡中,您可以在会话 ID 旁边看到该会话的 Token 用量。