
在 Alpic,我们相信,下一代产品和服务将围绕以 AI 为先的交互体验来构建。在这样的界面中,用户可以与模型协作,无需按传统界面预设的流程逐步操作。
OpenAI 一发布 Apps SDK,我们就开始用它开发应用。在三个月里,我们为内部团队和客户开发了 24 个 ChatGPT 应用,既有面向企业的,也有面向消费者的,覆盖旅游、零售和 SaaS 等领域。
我们很快发现,开发 ChatGPT 应用与开发传统网页或移动应用有着根本区别。在网页上行之有效的做法,例如在需要时才获取数据、由界面驱动状态、让用户手动配置,在智能体环境中往往行不通,有时甚至会损害使用体验。
本文总结了我们在实际开发 ChatGPT 应用时学到的 15 条最重要的经验,并介绍我们如何把这些经验融入面向社区的开源框架 Skybridge 和一项 Codex 技能,帮助开发者更快地构思、开发、测试和发布应用。
三体问题
在传统网页应用中,情况很简单,只需考虑用户和界面。到了 ChatGPT 应用中,还要考虑第三个参与者:模型。
为 ChatGPT 开发应用时,最难的问题之一就是管理这三者之间的信息流。例如,用户点击小组件中的“选择”按钮后,界面会随之更新。但除非您明确把这次选择告诉模型,否则负责对话的模型便无从知晓。如果用户接着问:“能详细介绍一下这款产品吗?” 模型根本不知道用户正在看哪款产品。
我们把这种情况称为上下文不对称:三方各自只了解系统的一部分,谁也看不到全貌。要做好 ChatGPT 应用,无需让所有信息时刻保持同步,而要决定 哪些信息 需要共享、什么时候 共享,以及 谁 需要看到这些信息。处理好这个问题,用户与智能体的交互才会自然流畅。
1. 上下文应按需共享
起初,我们的直觉是“把所有信息都共享给所有参与方”。这成了我们最早踩的坑之一。
在实际开发中,我们往往需要让 ChatGPT 应用的不同部分看到同一状态的不同侧面。这种差异是 有意设计的。为什么?
- 出于性能考虑,界面小组件需要的数据往往远多于模型所需。例如,旅游预订应用的小组件可能需要图片、不同方案的价格以及预加载的选项。把这些数据全都发给模型,会增加 Token 用量、延长响应时间,还会让无关信息干扰模型判断。
- 出于逻辑需要,有些信息必须只对特定参与方可见。我们最早开发的应用中有一款名为 Murder in the Valleys 的推理游戏。模型必须知道凶手是谁才能演好角色,而界面和用户都不能知道。在 Time’s Up 这类猜词游戏中,情况正好相反:界面要把谜底展示给用户,但不能让模型知道。
我们从中学到的是,要明确决定谁需要知道什么,无需一律同步所有信息。为此,我们用不同的 工具输出 字段来区分信息的接收方:
| 字段 | 用途 | 对谁可见 |
|---|---|---|
| structuredContent | 供小组件和模型使用的带类型数据 | 小组件和模型均可见(通过 toolOutput 和 callTool 函数) |
| _meta | 响应元数据 | 仅小组件可见,对模型隐藏 |
例如,在 Time’s Up 游戏中,我们通过 _meta 字段仅将谜底传给小组件,让模型根据用户的提示猜词。
2. 延迟加载在 AI 应用中往往效果不佳
我们做惯了网页开发,自然就采用了延迟加载:等用户点击后再获取数据,按需加载详情,尽量减少首次传输的数据量。
在 ChatGPT 中,情况恰好相反。受安全沙盒和模型推理耗时的影响,每次工具调用都会带来延迟,往往要等上几秒。
实践中,我们学会了尽量提前加载数据:在首次工具响应中返回尽可能多的数据,再通过 window.openai.toolOutput 用这些数据初始化小组件。这样做几乎总能加快响应,让交互更流畅。
当然,如果小组件能够安全地从公共 API 端点获取数据,而且无需与模型共享信息,您就可以直接在小组件中使用传统的 XHR 调用。不过,大多数时候,为了让用户能继续通过对话操作应用,您会希望模型能够自主调用工具。
3. 模型需要知道用户在界面上看到了什么
当用户先与小组件交互(例如从列表中选中一款产品),再到聊天中提问时,就会出现一个不易察觉却很关键的问题。如果模型不知道用户指的是界面上的哪一项,就无法正确作答。
为此,我们使用了 window.openai.setWidgetState(state)。您可以用它保存特定的状态数据,等到用户下次与模型交互时,这些数据就会加入模型的上下文。
随着应用日益复杂,为了让模型知道用户浏览到了哪里,我们不得不在许多地方调用 setWidgetState。于是,我们改用声明式的方式描述界面上下文。开发者可以直接给组件添加 data-llm 属性,省去为每次交互单独编写更新逻辑的麻烦:
<div
data-llm={
selectedTab === "details"
? "User is viewing product details"
: "User is viewing reviews"
}
>
Product details
</div>为此,我们开发了一个 Vite 插件,在后台读取这些属性并自动更新 widgetState。这样,模型就能在需要时收到相关的界面上下文,开发者也无需手动同步每一次交互。
我们把这个 Vite 插件和本文介绍的许多其他做法都放进了为社区开发的开源框架中。
4. 不同交互需要不同的 API
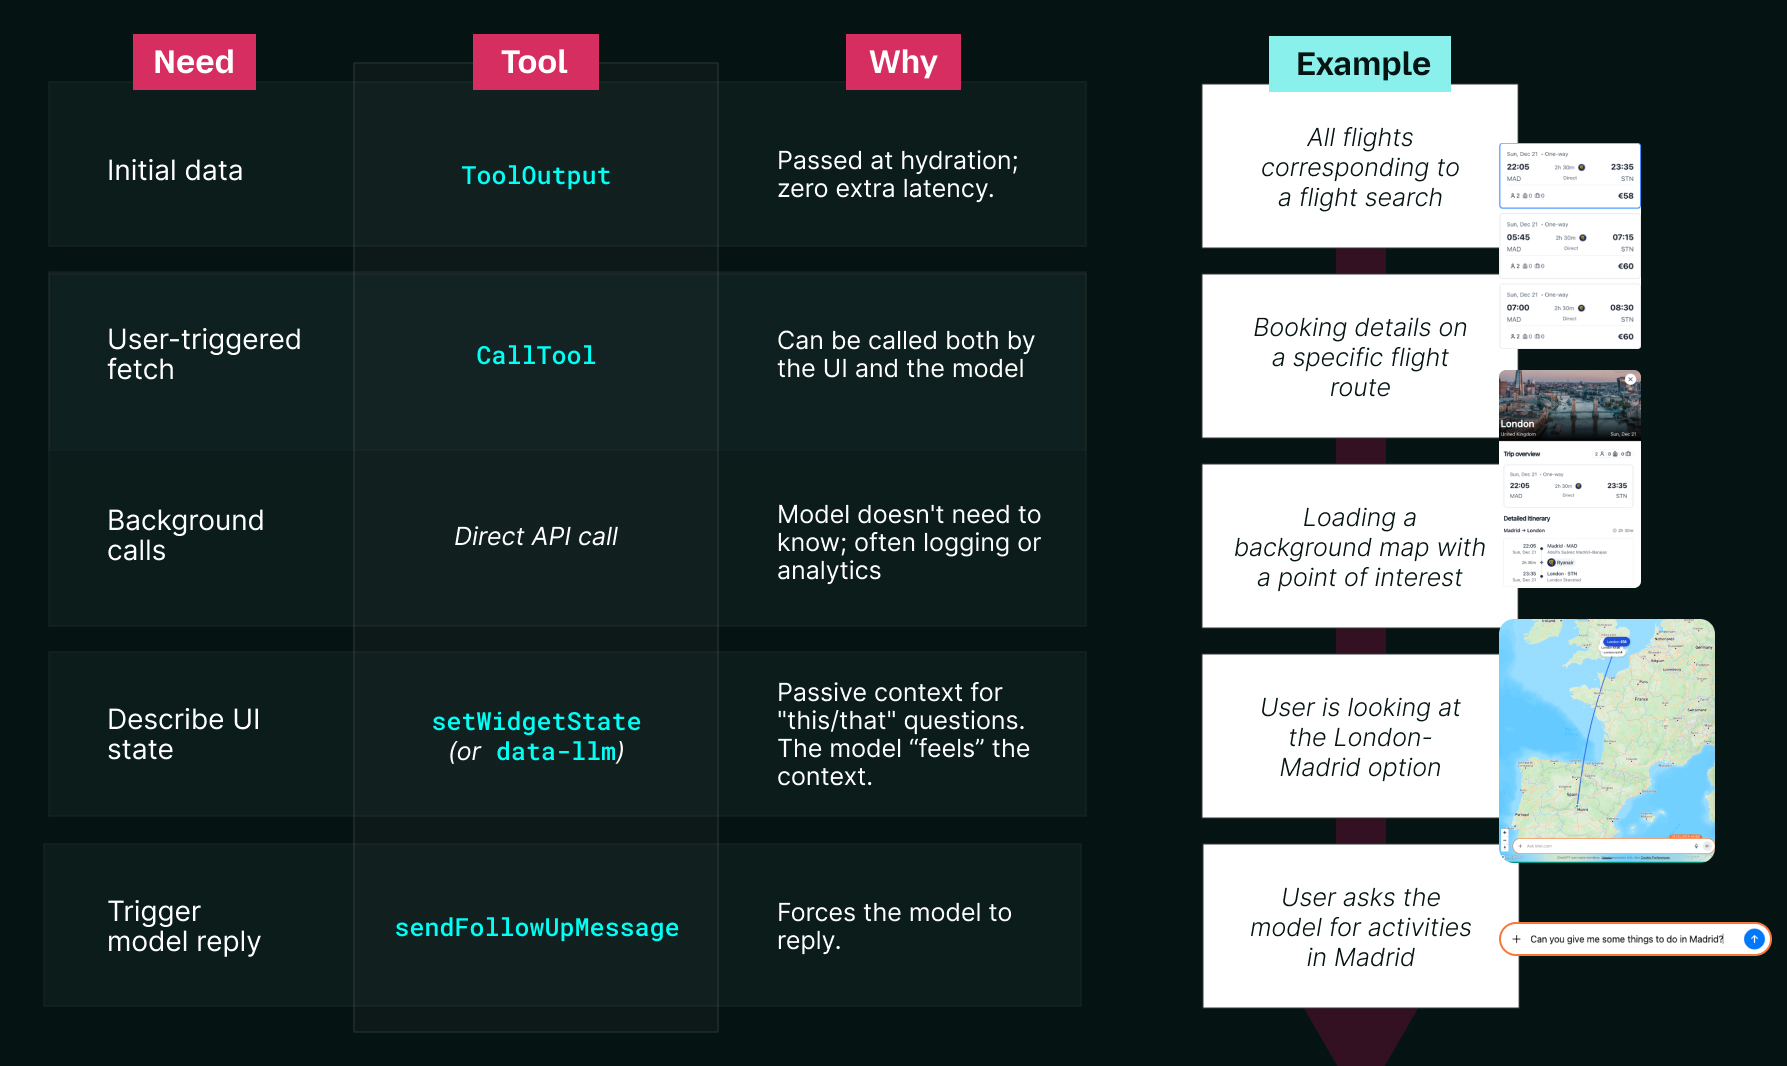
在 ChatGPT 应用中,小组件、服务器和模型之间有多条交互路径。每条路径支持的交互都不同,不能互换。
开发 ChatGPT 应用的一条重要经验,就是把这些通信路径梳理清楚,明确每个交互环节应采用哪种机制。
这些路径大致如下图所示:
以上几条经验奠定了 ChatGPT 应用的基础,涵盖如何共享上下文、如何让模型了解界面状态,以及不同交互如何在系统中传递。接下来看看这些特点会怎样影响界面设计。
为 AI 重新设计界面
ChatGPT 应用是一个全新的环境。我们很快就学会了放下对界面的固有看法,充分利用这个环境提供的新能力。要设计出好用的应用,有些界面设计思路需要掌握,有些则需要放下。
5. 界面必须适应多种显示模式及其限制
ChatGPT 应用没有固定的布局。同一个小组件可以用三种不同的模式呈现,具体取决于调用的方式和时机。
应用可以内嵌在对话中,也可以通过 画中画(PiP) 悬浮在对话上方,还可以在需要更多空间时全屏显示。画中画和全屏模式支持更丰富的界面,但宿主界面也会在小组件上方叠加一些控件,小组件无法控制它们。设计时必须考虑各类设备的安全区域,例如为移动设备上始终显示的关闭按钮留出空间,以免内容被裁切,也方便用户操作。
经过一段时间的实践,我们总结出了各种显示模式的特点和适用场景:
| 显示效果 | 适用场景 | |
|---|---|---|
| 内嵌 | 默认显示模式。小组件保留在对话历史中。 | 适合快速完成的交互。 |
| 全屏 | 小组件占满整个屏幕,底部显示聊天栏。 | 小组件较复杂、需要较大空间时,例如显示地图。 |
| 画中画 | 尺寸与内嵌模式相同,但小组件会一直悬浮在对话上方。 | 回复生成后,用户在后续对话中仍然需要参考或操作小组件时。 |
6. 嵌入式界面需要保持视觉一致
刚开始时,我们拿不准 ChatGPT 应用在视觉设计上可以有多大的自由度。用户第一次接触这种界面时,应该仍有熟悉感。为此,我们的各个应用之间要保持一致,也要与周围的 ChatGPT 界面协调。小组件嵌在现有界面中,任何视觉上的不协调都会比在独立产品中更显眼。
好在 OpenAI Apps SDK UI Kit 为我们提供了清晰的设计基准。
这套工具基于 Tailwind CSS 构建,提供了与 ChatGPT 设计系统一致的现成组件、图标和设计变量。借助它,我们既能加快开发,又能让小组件看起来就像周围界面的原生组成部分。即使为集成 Mapbox 等场景开发自定义组件,也能保持这种一致性。
7. 优先让用户用自然语言筛选
传统仪表板的侧边栏里往往排满了复选框和范围滑块。在智能体界面中,照搬这种设计反而会让操作更繁琐。用户本可以直接用自然语言表达意图,例如“帮我找找欧洲有哪些阳光充足、花费不到 200 美元的目的地”。既然一句话就能说清楚,就应该允许用户直接说,无需再逐一操作多个控件。
因此,在大多数应用中,我们都选择了“不设筛选控件”。我们省去了列有筛选和排序选项的侧边栏,转而向模型提供工具参数的 取值列表(LOV)。
这样,模型就能直接以用户的消息为输入,无需“猜测”有哪些可用选项。换句话说,它可以把自然语言直接映射为后端 API 要求的参数。如果用户说“阳光充足”,模型就知道应该用 weather=“sunny” 调用工具。
8. 文件让交互有了更多可能
在开发更复杂的应用时,我们发现,文件也可以是主要输入。在 ChatGPT 应用中,文件可以带来新的交互方式。用户可以从手头已有的东西开始,不必先填表或设置筛选条件。
例如,在电商应用中,用户可以先在聊天中上传一张商品照片,让模型识别商品,然后直接在小组件中查找匹配的商品或发现其他商品。
这种交互要求模型和界面两端都能处理文件。在模型端,工具可以通过 openai/fileParams 直接使用聊天中上传的文件,让模型根据图片或用户提供的其他素材进行推理。在界面端,小组件也可以使用 window.openai.uploadFile 和 window.openai.getFileDownloadUrl 直接处理文件。这样,小组件既可以在用户操作过程中请求上传文件,也可以生成文件供用户下载和复用。
上线部署
当应用从本地开发走向生产环境,就要考虑安全、配置和工具方面的新问题。第三组经验就来自这个阶段。
9. 继 CORS 之后,还要过 CSP 这一关
出于安全考虑,OpenAI 在两层嵌套的 iframe 中渲染应用。内容安全策略(CSP)是 iframe 隔离所用的一种原生机制。在这种架构下,系统会严格执行 CSP,因此经常出现“本地运行正常,一上线就出问题”的情况。
在传统网页开发中,策略设得宽松一些可能也能运行,但使用 Apps SDK 时,策略必须配置得很精确。
具体来说,您需要在应用清单中为每种交互分别声明允许使用的域名:
| 字段 | 用途 | 示例 | 常见错误 |
|---|---|---|---|
| connectDomains | API 和 XHR 请求 | https://api.weather.com | 忽略预发布环境与生产环境的 API 域名差异,漏配其中之一。 |
| resourceDomains | 图片、字体、脚本 | https://cdn.jsdelivr.net | 使用 delivr.net 等公共 CDN,却没有将其域名加入允许列表。 |
| frameDomains | 嵌入 iframe | https://www.youtube.com | 嵌入 YouTube 视频或 Mapbox 实例时,未将相应域名加入允许列表。 |
| redirectDomains | 打开时不显示警告的外部链接 | https://app.alpic.ai | 漏掉结账页面或 OAuth 回调的域名。 |
我们从一开始就认真对待 CSP 配置,后来因此省下了大量排查生产环境问题的时间。
10. 小组件的几个标志位影响很大
除了 CSP,小组件还有几项设置,决定了小组件、模型和宿主环境各自能控制什么。这些标志位很容易被忽视,却决定了导航行为、工具访问权限,以及应用能否发布。
宿主与导航的边界
widgetDomain是提交应用时必须设置的字段。它定义全屏模式下“在 <App> 中打开”按钮的默认目标地址,也用于确定要加入允许列表的源,因为小组件是在<widgetDomain>.web-sandbox.oaiusercontent.com下渲染的。我们使用setOpenInAppUrl根据上下文将用户引导到相应路径。
模型与工具的边界
- 工具注解必须符合发布指南。
readOnly、destructiveHint和openWorldHint等标志位是必填项,提交时系统会校验这些标志位。 - 工具的可见性决定了模型能否调用它。对于不应由模型调用的工具,您必须明确将其标记为私有。
小组件的执行边界
widgetAccessible控制小组件能否通过callTool自行调用工具。
这些设置单看都很小,却共同决定了应用发布后能否正常运行。
加快开发迭代
Apps SDK 一直在快速演进,我们也很高兴能一路用它开发应用。为了让开发流程更顺畅、更高效,我们决定开发自己的开源框架,并与社区分享。下面这些经验可以帮助您避开我们在开发初期遇到的问题。
11. 快速迭代需要热重载
我们最早着手解决的问题之一就是迭代速度。ChatGPT 应用的资源缓存有效期(TTL)很长,资源又要通过 JSON-RPC 转发。这两个因素叠加,使 Vite 或 Next.js 等工具提供的标准模块热重载机制无法直接用于 ChatGPT 应用。
我们花了不少时间研究 Vite 的内部机制,最后开发出一个 Vite 插件,让小组件可以直接在 ChatGPT 中实时重载。插件会拦截发往 MCP 服务器的资源请求,并将实时更新注入 ChatGPT 的 iframe。在 IDE 中改动代码后,我们马上就能在 ChatGPT 中看到效果,大大缩短了等待反馈的时间。
12. 有些测试可以在 ChatGPT 之外完成
在 ChatGPT 中测试是最可靠的方式,但在最初几轮迭代中,本地模拟器可以让开发更快。尤其是在调整工具定义时,如果修改后需要在 ChatGPT 中刷新自定义 MCP 服务器连接,本地模拟器就更有帮助。
为了加快早期迭代,我们开发了一个轻量级本地模拟器,用来模拟 ChatGPT 宿主环境,并配备了调试工具和应用专用日志。这样,我们能以毫秒级的速度反复调整 React 状态和布局,再到真正的 ChatGPT 环境中验证模型交互和边界情况。
13. 移动端测试需要专门支持
移动端测试还带来了另一个挑战。在 ChatGPT 中测试本地服务器需要通过隧道连接,但 Vite 默认使用 localhost,导致其他设备无法访问同一个 URL。
我们扩展了 Vite 插件,让它支持在通过隧道开放的端口上转发域名。这样一来,我们就可以在 iOS 和 Android 设备上测试,也把移动端验证纳入了日常开发流程。
14. 熟悉的抽象(如 React 钩子)可以加快前端开发
Apps SDK 功能强大,但主要通过底层 JavaScript API 提供这些能力。我们长期使用 React,希望能用自己已经熟悉的方式来开发。
于是,我们引入了一些适合 React 的抽象,包括 useCallTool、useWidgetState 和 useLocale 等钩子。对于复杂的数据流,我们还提供了基于 Zustand 构建的 createStore 等更高级的状态管理机制。重新用上熟悉的前端模式后,样板代码少了,小组件的开发流程也更接近常见的现代网页开发流程。
把经验融入 Codex 技能
15. 把经验做成可复用的工具
随着同样的模式在多个应用中陆续出现,我们意识到,在每个项目里重新摸索一遍会拖慢开发。为了让 ChatGPT 应用的开发更快、过程更可预测,我们决定把这些经验直接做进工具里,供团队和社区共同使用。
由此诞生了两项相辅相成的成果:
- Skybridge 框架: 这个开源 React 框架将本文介绍的许多做法封装成可复用的构件,包括我们开发的钩子(
useCallTool、useToolInfo)、开发者工具(模块热替换(HMR)和本地模拟器),以及 data-llm 属性。 - chatgpt-apps-builder Codex 技能: 我们在框架之上构建了一项专用的 Codex 技能,覆盖应用的整个生命周期:
- 构思: 一起探索如何让应用具备智能体交互能力,避免简单照搬网页版。
- 代码生成: 同时编写 React 前端和 MCP 服务器后端,并预先配置合适的用户体验和界面设计模式。
- 本地测试: 启动开发服务器,将本地应用连接到 ChatGPT,通过热重载实时迭代。
- 质量保证与发布: 对照 OpenAI 的提交指南逐项检查,包括验证 CSP、检查界面是否留足安全区域,以及在生产环境中测试。
- 应用部署: 协助完成应用上线及后续迭代所需的最后几个步骤。
要安装并使用这项技能,请运行以下命令:
npx skills add alpic-ai/skybridge结语
开发 ChatGPT 应用,需要重新思考上下文如何流动、界面如何响应,以及用户如何与模型协作。本文的许多经验都源于我们在实践中发现的一点:熟悉的网页开发模式并不总能适应智能体系统的实际需要。
我们把这些经验分享出来,并融入开源框架和 Codex 技能,希望各个团队能少花些时间反复摸索相同的问题,多花些时间探索这种新交互方式带来的可能。最吸引人的 ChatGPT 应用会跳出简单移植现有产品的思路,从设计之初就围绕这种以 AI 为先的体验展开。