
AI 的音频能力为用户体验带来了令人期待的新可能。今年早些时候,我们发布了包括 gpt-realtime 在内的多款音频模型,并推出了新的 API 功能,帮助开发者打造这些体验。
上周,我们发布了新的音频模型快照,旨在解决开发可靠语音智能体时遇到的一些常见问题。这些快照提升了生产环境中语音工作流的可靠性和质量,涵盖语音转写、文本转语音,以及原生支持实时语音到语音交互的智能体。
本次更新包括以下快照:
gpt-4o-mini-transcribe-2025-12-15可通过转写 API 或 Realtime API 将语音转为文本。gpt-4o-mini-tts-2025-12-15可通过语音 API 将文本转为语音。gpt-realtime-mini-2025-12-15可通过 Realtime API 实现原生的实时语音到语音交互。gpt-audio-mini-2025-12-15可通过 Chat Completions API 实现原生的语音到语音交互。
这些新快照有几项共同的改进:
音频输入方面:
- 处理真实场景中的音频和带有噪声的音频时,词错误率更低。
- 遇到静音片段或背景噪声时,产生的幻觉更少。
音频输出方面:
- 输出的语音更自然、更稳定,使用自定义声音时也是如此。
价格与之前的模型快照相同。我们建议您切换到新快照,以相同的价格获得更好的性能。
如果您正在开发语音智能体、客服系统或具有品牌特色的语音体验,这些更新将帮助您的应用在生产环境中更可靠地运行。下面介绍具体改进,以及它们在实际语音工作流中的表现。
语音到语音
我们正在部署新版 Realtime mini 和 Audio mini 模型,并针对工具调用和指令遵循进行了优化。这些改进缩小了 mini 模型与完整版模型之间的能力差距,让部分应用可以通过改用 mini 模型来降低成本。
gpt-realtime-mini-2025-12-15
gpt-realtime-mini 模型专为配合 Realtime API 使用而设计。该 API 支持低延迟的原生多模态交互。模型支持流式音频输入和输出,可以处理用户打断(可选择启用语音活动检测),还可以在继续说话的同时在后台调用函数。
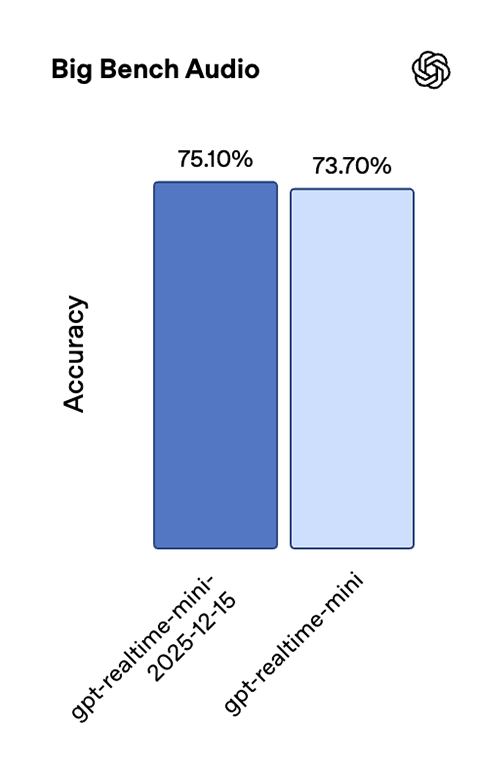
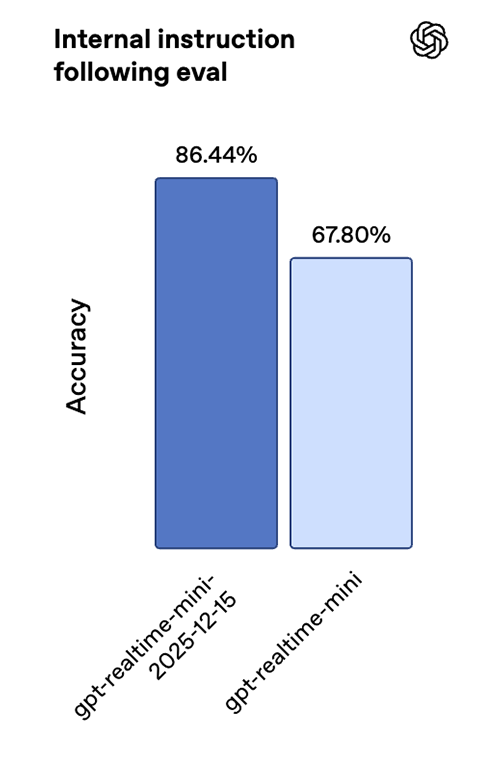
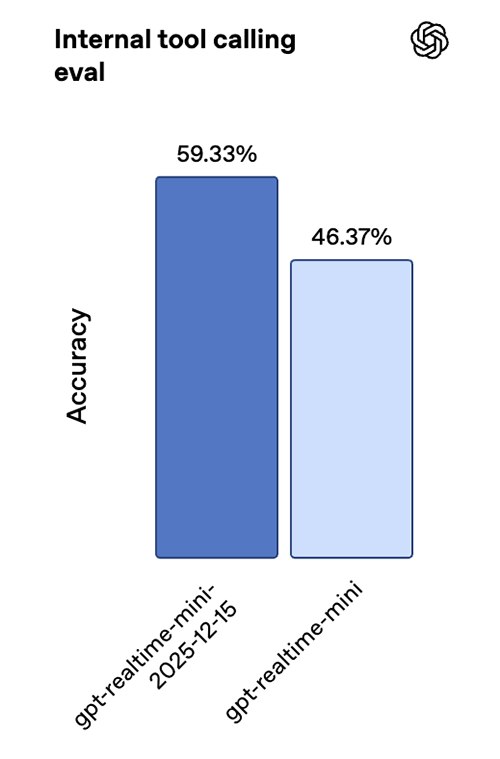
新的 Realtime mini 快照在遵循指令和调用工具方面均有明显进步,更适合实时智能体。在我们的内部语音到语音评测中,与上一个快照相比,新快照的指令遵循准确率提高了 18.6 个百分点,工具调用准确率提高了 12.9 个百分点。它在 Big Bench Audio 基准测试中的表现也有所提升。
在需要低延迟的实时场景中,这些改进让多步交互更加可靠,也让函数执行的表现更加一致。
如果您的应用值得为更高的智能体准确性投入更多成本,gpt-realtime 仍是我们表现最好的模型。如果您最看重成本和延迟,gpt-realtime-mini 则是一个很好的选择,在实际场景中也表现出色。
例如,Genspark 在双语翻译和智能意图路由场景中对该模型进行了压力测试。测试团队发现,除了语音质量有所提升,模型几乎能即时响应,即使对话节奏很快,也始终能准确识别意图。
gpt-audio-mini-2025-12-15
如果您的语音到语音应用无需实时交互,可以使用 gpt-audio-mini 模型,通过 Chat Completions API 调用它。
两个新快照都升级了解码器,生成的声音听起来更自然,使用自定义声音时也能更好地保持声音的一致性。
文本转语音
我们最新的文本转语音模型 gpt-4o-mini-tts-2025-12-15 在准确性上有了显著提升。与上一代相比,它在多项标准语音基准测试中的词错误率均大幅下降。在 Common Voice 和 FLEURS 上,词错误率(WER)降低了约 35%,在 Multilingual LibriSpeech 上也取得了稳定的提升。
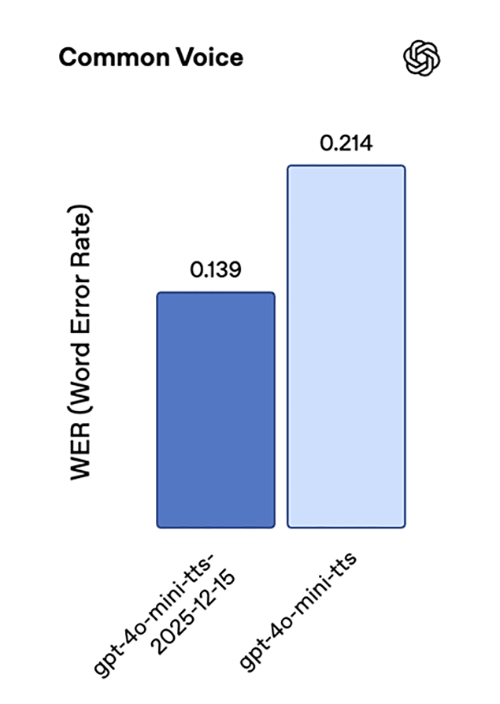
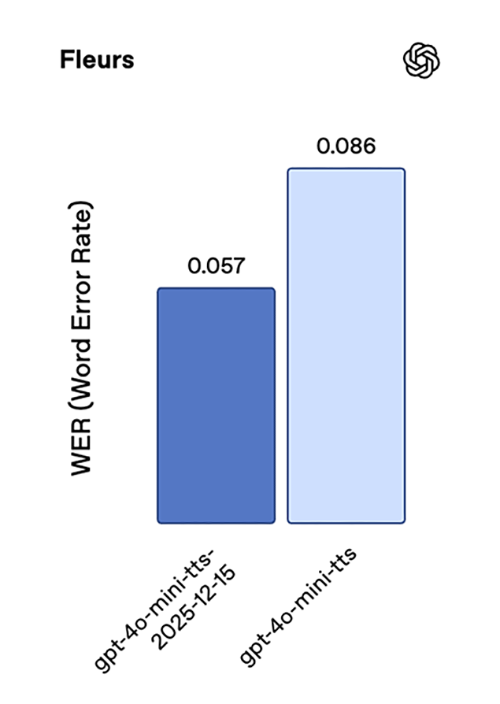
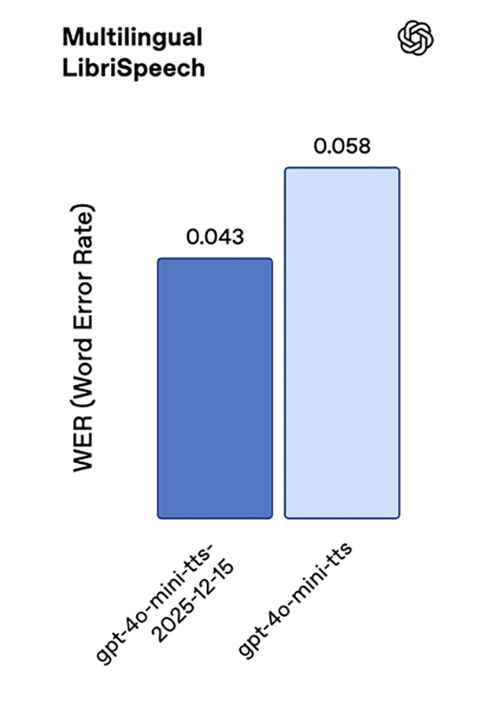
综合来看,这些结果表明,模型在多种语言中的发音更准确,表现也更稳定。
与新的 gpt-realtime-mini 快照类似,该模型生成的语音听起来更加自然,使用自定义声音时的效果也更好。
语音转文本
最新的转写模型 gpt-4o-mini-transcribe-2025-12-15 在准确性和可靠性上均有显著提升。在 Common Voice 和 FLEURS 等标准自动语音识别(ASR)基准测试中,在不提供语种提示的情况下,它的词错误率低于此前的模型。我们针对实际对话场景优化了模型,尤其是用户发言简短或背景嘈杂的情况。在内部的“噪声环境下的幻觉”评测中,我们播放了真实环境中的背景噪声片段,以及说话间隔长短不一的音频(其中包含静音片段)。与 Whisper v2 相比,该模型产生的幻觉减少了约 90%,与此前的 GPT-4o-transcribe 模型相比,减少了约 70%。
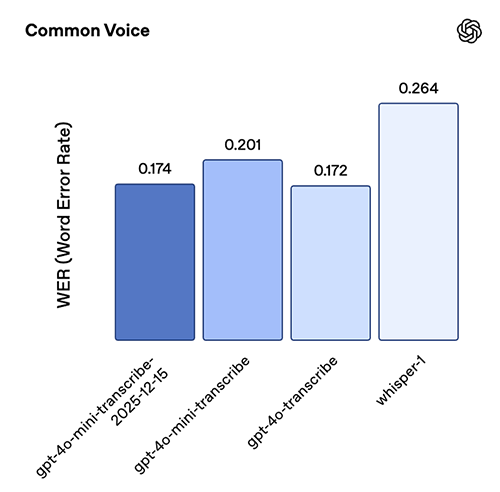
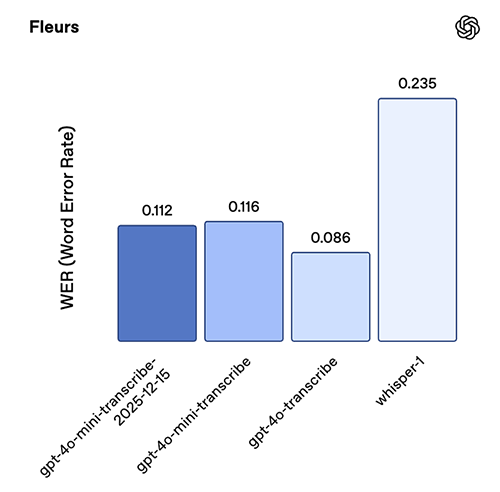
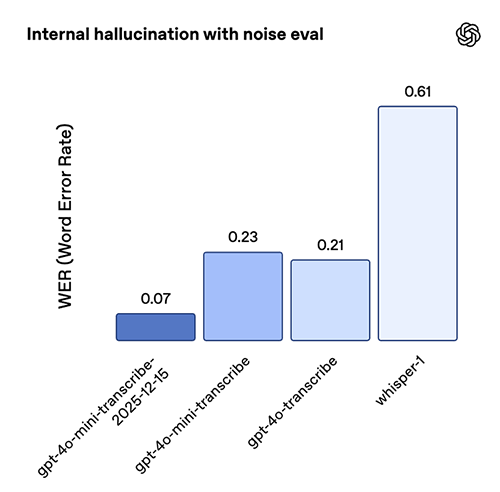
这个模型快照在中文(普通话)、印地语、孟加拉语、日语、印度尼西亚语和意大利语上的表现尤为出色。
自定义声音
自定义声音让企业能够用具有自身品牌特色的声音与客户交流。无论您是在开发客服智能体还是打造品牌虚拟形象,OpenAI 的自定义声音技术都能让您轻松创建独特而逼真的声音。
使用这些新的语音到语音和文本转语音模型时,自定义声音的语调更自然,更接近原始声音样本,在不同方言中的发音也更准确。
为确保这项技术得到安全使用,自定义声音仅向符合条件的客户开放。如需了解更多信息,请联系您的客户总监或咨询我们的销售团队。
从原型到生产环境
语音应用容易在一些相似的场景中出错,尤其是在长时间对话中、遇到静音等边缘情况时,或是在需要语音智能体精准调用工具的流程中。本次更新针对这些问题降低了错误率,减少了幻觉,让模型调用工具时表现更一致,也能更好地遵循指令。此外,我们还提高了音频输出的稳定性,让应用中的语音听起来更自然。
如果您正在推出语音应用,我们建议您切换到新的 2025-12-15 快照,并重新运行生产环境中的关键测试用例。
早期测试者已经确认,沿用原有指令,仅切换到新快照,就能看到明显改进。我们仍建议您根据自己的用例进行测试,并按需调整提示。