OpenAI 提供多種方式來管理對話狀態,讓你能在對話的多則訊息或多個回合之間保留資訊。
如果 GPT-5.5 將中途的進度更新當成最終答案,排查問題時,請確認你的整合程式是否正確保留了助理訊息的 phase 欄位。詳見階段參數。
每個文字生成請求都是獨立且無狀態的,但你仍可在請求參數中傳入額外的訊息,實作多回合對話。以下以一問一答的敲門笑話為例:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23import OpenAI from "openai";

const openai = new OpenAI();

const response = await openai.chat.completions.create({
  model: "gpt-6-astra",
  messages: [
    {
      role: "user",
      content: "knock knock.",
    },
    {
      role: "assistant",
      content: "Who's there?",
    },
    {
      role: "user",
      content: "Orange.",
    },
  ],
});

console.log(response.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14from openai import OpenAI

client = OpenAI()

response = client.chat.completions.create(
    model="gpt-6-astra",
    messages=[
        {"role": "user", "content": "knock knock."},
        {"role": "assistant", "content": "Who's there?"},
        {"role": "user", "content": "Orange."},
    ],
)

print(response.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26package main

import (
	"context"
	"fmt"

	"github.com/openai/openai-go/v3"
)

func main() {
	client := openai.NewClient()

	completion, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{
		Model: "gpt-6-astra",
		Messages: []openai.ChatCompletionMessageParamUnion{
			openai.UserMessage("Knock knock."),
			openai.AssistantMessage("Who's there?"),
			openai.UserMessage("Orange."),
		},
	})
	if err != nil {
		panic(err)
	}

	fmt.Println(completion.Choices[0].Message.Content)
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.chat.completions.ChatCompletionCreateParams;

ChatCompletionCreateParams params =
    ChatCompletionCreateParams.builder()
        .model("gpt-6-astra")
        .addUserMessage("Knock knock.")
        .addAssistantMessage("Who's there?")
        .addUserMessage("Orange.")
        .build();

client.chat().completions().create(params).choices().stream()
    .flatMap(choice -> choice.message().content().stream())
    .forEach(System.out::println);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15using OpenAI.Chat;

string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "gpt-6-astra";
ChatClient client = new(model, key);

ChatCompletion completion = await client.CompleteChatAsync(
    [
        new UserChatMessage("Knock knock."),
        new AssistantChatMessage("Who's there?"),
        new UserChatMessage("Orange."),
    ]
);

Console.WriteLine(completion.Content[0].Text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23require "openai"

client = OpenAI::Client.new

completion = client.chat.completions.create(
  model: "gpt-6-astra",
  messages: [
    {
      role: :user,
      content: "Knock knock."
    },
    {
      role: :assistant,
      content: "Who's there?"
    },
    {
      role: :user,
      content: "Orange."
    }
  ]
)

puts(completion.choices.fetch(0).message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14import OpenAI from "openai";

const openai = new OpenAI();

const response = await openai.responses.create({
  model: "gpt-6-astra",
  input: [
    { role: "user", content: "knock knock." },
    { role: "assistant", content: "Who's there?" },
    { role: "user", content: "Orange." },
  ],
});

console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6-astra",
    input=[
        {"role": "user", "content": "knock knock."},
        {"role": "assistant", "content": "Who's there?"},
        {"role": "user", "content": "Orange."},
    ],
)

print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29package main

import (
	"context"
	"fmt"

	"github.com/openai/openai-go/v3"
	"github.com/openai/openai-go/v3/responses"
)

func main() {
	client := openai.NewClient()

	response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{
		Model: "gpt-6-astra",
		Input: responses.ResponseNewParamsInputUnion{
			OfInputItemList: responses.ResponseInputParam{
				responses.ResponseInputItemParamOfMessage("Knock knock.", responses.EasyInputMessageRoleUser),
				responses.ResponseInputItemParamOfMessage("Who's there?", responses.EasyInputMessageRoleAssistant),
				responses.ResponseInputItemParamOfMessage("Orange.", responses.EasyInputMessageRoleUser),
			},
		},
	})
	if err != nil {
		panic(err)
	}

	fmt.Println(response.OutputText())
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.responses.EasyInputMessage;
import com.openai.models.responses.ResponseCreateParams;
import com.openai.models.responses.ResponseInputItem;
import java.util.List;

ResponseCreateParams params =
    ResponseCreateParams.builder()
        .model("gpt-6-astra")
        .inputOfResponse(
            List.of(
                ResponseInputItem.ofEasyInputMessage(
                    EasyInputMessage.builder()
                        .role(EasyInputMessage.Role.USER)
                        .content("Knock knock.")
                        .build()),
                ResponseInputItem.ofEasyInputMessage(
                    EasyInputMessage.builder()
                        .role(EasyInputMessage.Role.ASSISTANT)
                        .content("Who's there?")
                        .build()),
                ResponseInputItem.ofEasyInputMessage(
                    EasyInputMessage.builder()
                        .role(EasyInputMessage.Role.USER)
                        .content("Orange.")
                        .build())))
        .build();

client.responses().create(params).output().stream()
    .flatMap(item -> item.message().stream())
    .flatMap(message -> message.content().stream())
    .flatMap(content -> content.outputText().stream())
    .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16using OpenAI.Responses;
#pragma warning disable OPENAI001

string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
ResponsesClient client = new(key);

ResponseResult response = await client.CreateResponseAsync(
    "gpt-6-astra",
    [
        ResponseItem.CreateUserMessageItem("Knock knock."),
        ResponseItem.CreateAssistantMessageItem("Who's there?"),
        ResponseItem.CreateUserMessageItem("Orange."),
    ]
);

Console.WriteLine(response.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23require "openai"

client = OpenAI::Client.new

response = client.responses.create(
  model: "gpt-6-astra",
  input: [
    {
      role: :user,
      content: "Knock knock."
    },
    {
      role: :assistant,
      content: "Who's there?"
    },
    {
      role: :user,
      content: "Orange."
    }
  ]
)

puts(response.output_text)
交替排列 user 和 assistant 訊息,就能在一次請求中將先前的對話狀態傳給模型。
若要手動在各次回應之間共用上下文,請將模型上一次回應的輸出作為輸入,附加到下一個請求中。
向推理模型傳送無狀態請求時,請保留回應中 output 陣列的每個項目。Responses API 預設會傳回加密的推理項目。將完整輸出傳回模型,即可完整保留推理項目和助理訊息的 phase 值。對於支援持久保存推理內容的模型,可使用 reasoning.context: "all_turns",在下一次取樣時納入先前回合中可用的推理內容。詳見在多次呼叫之間保留推理內容。
將推理項目傳回模型時,請保留模型產生這些項目時所依據的對話紀錄。如需瞭解修改對話紀錄會如何影響推理,請參閱保持前綴不變。
在以下範例中,我們先請模型說一個笑話,再請它說另一個。將先前的回應附加到新請求中,有助於保留先前互動的上下文,讓對話自然延續。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30import OpenAI from "openai";

const openai = new OpenAI();

let history: OpenAI.Chat.Completions.ChatCompletionMessageParam[] = [
  {
    role: "user",
    content: "tell me a joke",
  },
];

const completion = await openai.chat.completions.create({
  model: "gpt-6-astra",
  messages: history,
});

console.log(completion.choices[0].message.content);

history.push(completion.choices[0].message);
history.push({
  role: "user",
  content: "tell me another",
});

const secondCompletion = await openai.chat.completions.create({
  model: "gpt-6-astra",
  messages: history,
});

console.log(secondCompletion.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22from openai import OpenAI

client = OpenAI()

history = [{"role": "user", "content": "tell me a joke"}]

response = client.chat.completions.create(
    model="gpt-6-astra",
    messages=history,
)

print(response.choices[0].message.content)

history.append(response.choices[0].message)
history.append({"role": "user", "content": "tell me another"})

second_response = client.chat.completions.create(
    model="gpt-6-astra",
    messages=history,
)

print(second_response.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37package main

import (
	"context"
	"fmt"

	"github.com/openai/openai-go/v3"
)

func main() {
	client := openai.NewClient()
	history := []openai.ChatCompletionMessageParamUnion{
		openai.UserMessage("Tell me a joke."),
	}

	first, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{
		Model:    "gpt-6-astra",
		Messages: history,
	})
	if err != nil {
		panic(err)
	}
	fmt.Println(first.Choices[0].Message.Content)

	history = append(history,
		openai.AssistantMessage(first.Choices[0].Message.Content),
		openai.UserMessage("Tell me another."),
	)
	second, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{
		Model:    "gpt-6-astra",
		Messages: history,
	})
	if err != nil {
		panic(err)
	}
	fmt.Println(second.Choices[0].Message.Content)
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.chat.completions.ChatCompletionCreateParams;

var params =
    ChatCompletionCreateParams.builder()
        .model("gpt-6-astra")
        .addUserMessage("Tell me a joke.")
        .build();
var first = client.chat().completions().create(params);
first.choices().stream()
    .flatMap(choice -> choice.message().content().stream())
    .forEach(System.out::println);

var second =
    client
        .chat()
        .completions()
        .create(
            params.toBuilder()
                .addAssistantMessage(first.choices().get(0).message().content().orElseThrow())
                .addUserMessage("Tell me another.")
                .build());
second.choices().stream()
    .flatMap(choice -> choice.message().content().stream())
    .forEach(System.out::println);
1
2
3
4
5
6
7
8
9
10
11
12
13
14using OpenAI.Chat;

string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "gpt-6-astra";
ChatClient client = new(model, key);

List<ChatMessage> messages = [new UserChatMessage("Tell me a joke.")];
ChatCompletion first = await client.CompleteChatAsync(messages);
Console.WriteLine(first.Content[0].Text);

messages.Add(new AssistantChatMessage(first));
messages.Add(new UserChatMessage("Tell me another."));
ChatCompletion second = await client.CompleteChatAsync(messages);
Console.WriteLine(second.Content[0].Text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30require "openai"

client = OpenAI::Client.new
history = [
  {
    role: :user,
    content: "Tell me a joke."
  }
]

first = client.chat.completions.create(
  model: "gpt-6-astra",
  messages: history
)
puts(first.choices.fetch(0).message.content)

history << {
  role: :assistant,
  content: first.choices.fetch(0).message.content
}
history << {
  role: :user,
  content: "Tell me another."
}

second = client.chat.completions.create(
  model: "gpt-6-astra",
  messages: history
)
puts(second.choices.fetch(0).message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35import OpenAI from "openai";
import { toResponseInputItems } from "openai/lib/responses/ResponseInputItems";

const openai = new OpenAI();

let history: OpenAI.Responses.ResponseInput = [
  {
    role: "user",
    content: "tell me a joke",
  },
];

const response = await openai.responses.create({
  model: "gpt-6-astra",
  input: history,
  store: false,
});

console.log(response.output_text);

// Add replayable output items, including reasoning items, to the history
history.push(...toResponseInputItems(response.output));

history.push({
  role: "user",
  content: "tell me another",
});

const secondResponse = await openai.responses.create({
  model: "gpt-6-astra",
  input: history,
  store: false,
});

console.log(secondResponse.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26from openai import OpenAI

client = OpenAI()

history = [{"role": "user", "content": "tell me a joke"}]

response = client.responses.create(
    model="gpt-6-astra",
    input=history,
    store=False,
)

print(response.output_text)

# Add all response output items, including encrypted reasoning items, to the conversation
history += response.output

history.append({"role": "user", "content": "tell me another"})

second_response = client.responses.create(
    model="gpt-6-astra",
    input=history,
    store=False,
)

print(second_response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50package main

import (
	"context"
	"encoding/json"
	"fmt"

	"github.com/openai/openai-go/v3"
	"github.com/openai/openai-go/v3/responses"
)

func main() {
	client := openai.NewClient()
	history := responses.ResponseInputParam{
		responses.ResponseInputItemParamOfMessage("tell me a joke", responses.EasyInputMessageRoleUser),
	}
	first, err := client.Responses.New(context.Background(), responses.ResponseNewParams{
		Model: "gpt-6-astra",
		Input: responses.ResponseNewParamsInputUnion{OfInputItemList: history},
		Store: openai.Bool(false),
	})
	if err != nil {
		panic(err)
	}
	fmt.Println(first.OutputText())

	history = append(history, outputAsInput(first.Output)...)
	history = append(history, responses.ResponseInputItemParamOfMessage("tell me another", responses.EasyInputMessageRoleUser))
	second, err := client.Responses.New(context.Background(), responses.ResponseNewParams{
		Model: "gpt-6-astra",
		Input: responses.ResponseNewParamsInputUnion{OfInputItemList: history},
		Store: openai.Bool(false),
	})
	if err != nil {
		panic(err)
	}
	fmt.Println(second.OutputText())
}

func outputAsInput(output []responses.ResponseOutputItemUnion) []responses.ResponseInputItemUnionParam {
	input := make([]responses.ResponseInputItemUnionParam, 0, len(output))
	for _, item := range output {
		var converted responses.ResponseInputItemUnion
		if err := json.Unmarshal([]byte(item.RawJSON()), &converted); err != nil {
			panic(err)
		}
		input = append(input, converted.ToParam())
	}
	return input
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.core.JsonValue;
import com.openai.models.responses.EasyInputMessage;
import com.openai.models.responses.ResponseCreateParams;
import com.openai.models.responses.ResponseInputItem;
import java.util.ArrayList;

var history = new ArrayList<ResponseInputItem>();
history.add(
    ResponseInputItem.ofEasyInputMessage(
        EasyInputMessage.builder()
            .role(EasyInputMessage.Role.USER)
            .content("Tell me a joke.")
            .build()));

var first =
    client
        .responses()
        .create(
            ResponseCreateParams.builder()
                .model("gpt-6-astra")
                .inputOfResponse(history)
                .store(false)
                .build());
first.output().stream()
    .flatMap(item -> item.message().stream())
    .flatMap(message -> message.content().stream())
    .flatMap(content -> content.outputText().stream())
    .forEach(text -> System.out.println(text.text()));
first.output().stream()
    .map(item -> JsonValue.from(item).convert(ResponseInputItem.class))
    .forEach(history::add);
history.add(
    ResponseInputItem.ofEasyInputMessage(
        EasyInputMessage.builder()
            .role(EasyInputMessage.Role.USER)
            .content("Tell me another.")
            .build()));

client
    .responses()
    .create(
        ResponseCreateParams.builder()
            .model("gpt-6-astra")
            .inputOfResponse(history)
            .store(false)
            .build())
    .output()
    .stream()
    .flatMap(item -> item.message().stream())
    .flatMap(message -> message.content().stream())
    .flatMap(content -> content.outputText().stream())
    .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35using OpenAI.Responses;
#pragma warning disable OPENAI001

string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
ResponsesClient client = new(key);

List<ResponseItem> history =
[
    ResponseItem.CreateUserMessageItem("Tell me a joke."),
];

CreateResponseOptions options = new("gpt-6-astra", history)
{
    StoredOutputEnabled = false,
    IncludedProperties =
    {
        IncludedResponseProperty.ReasoningEncryptedContent,
    },
};
ResponseResult first = await client.CreateResponseAsync(options);
Console.WriteLine(first.GetOutputText());

history.AddRange(first.OutputItems);
history.Add(ResponseItem.CreateUserMessageItem("Tell me another."));

options = new("gpt-6-astra", history)
{
    StoredOutputEnabled = false,
    IncludedProperties =
    {
        IncludedResponseProperty.ReasoningEncryptedContent,
    },
};
ResponseResult second = await client.CreateResponseAsync(options);
Console.WriteLine(second.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29require "openai"

client = OpenAI::Client.new
history = [
  {
    role: :user,
    content: "Tell me a joke."
  }
]

first = client.responses.create(
  model: "gpt-6-astra",
  input: history,
  store: false
)
puts(first.output_text)

history.concat(first.output)
history << {
  role: :user,
  content: "Tell me another."
}

second = client.responses.create(
  model: "gpt-6-astra",
  input: history,
  store: false
)
puts(second.output_text)
透過 OpenAI API,你可以輕鬆地自動管理對話狀態,無須在每個對話回合手動傳入先前的輸入。
建議改用 Responses API。它會保留狀態,因此只要指定一個參數,就能管理跨對話的上下文。
如果使用 Chat Completions 端點,則需依照上文說明手動管理狀態。
Conversations API 可搭配 Responses API,將對話狀態儲存為長期存在的物件,每個物件都有自己的固定識別碼。建立對話物件後,即可在不同工作階段、裝置或作業中繼續使用它。
對話中儲存的項目可以是訊息、工具呼叫、工具輸出或其他資料。
const conversation = await client.conversations.create();
conversation = openai.conversations.create()
conversation, err := client.Conversations.New(context.Background(), conversations.ConversationNewParams{})
if err != nil {
	panic(err)
}
import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;

var conversation = client.conversations().create();

System.out.println(conversation.id());
conversation = client.conversations.create
在多回合互動中,產生後續回應時可傳入 conversation,讓這些回應保留狀態並共用上下文,無須逐一串接多個回應項目。
1
2
3
4
5
6
7const response = await client.responses.create({
  model: "gpt-6-astra",
  input: [{ role: "user", content: "What are the five Ds of dodgeball?" }],
  conversation: conversation.id,
});

console.log(response.output_text);
1
2
3
4
5response = openai.responses.create(
    model="gpt-6-astra",
    input=[{"role": "user", "content": "What are the 5 Ds of dodgeball?"}],
    conversation=conversation.id,
)
1
2
3
4
5
6
7
8
9
10
11
12
13response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{
	Model: "gpt-6-astra",
	Conversation: responses.ResponseNewParamsConversationUnion{
		OfString: openai.String(conversation.ID),
	},
	Input: responses.ResponseNewParamsInputUnion{
		OfString: openai.String("What are the five Ds of dodgeball?"),
	},
})
if err != nil {
	panic(err)
}
fmt.Println(response.OutputText())
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.responses.ResponseCreateParams;

var conversation = client.conversations().create();

var response =
    client
        .responses()
        .create(
            ResponseCreateParams.builder()
                .model("gpt-6-astra")
                .conversation(conversation.id())
                .input("What are the five Ds of dodgeball?")
                .build());

response.output().stream()
    .flatMap(item -> item.message().stream())
    .flatMap(message -> message.content().stream())
    .flatMap(content -> content.outputText().stream())
    .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7response = client.responses.create(
  model: "gpt-6-astra",
  conversation: conversation.id,
  input: "What are the five Ds of dodgeball?"
)

puts(response.output_text)
另一種管理對話狀態的方式,是使用 previous_response_id 參數在各次回應之間共用上下文。這個參數可將回應串接起來,形成連貫的對話串。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20import OpenAI from "openai";

const openai = new OpenAI();

const response = await openai.responses.create({
  model: "gpt-6-astra",
  input: "tell me a joke",
  store: true,
});

console.log(response.output_text);

const secondResponse = await openai.responses.create({
  model: "gpt-6-astra",
  previous_response_id: response.id,
  input: [{ role: "user", content: "explain why this is funny." }],
  store: true,
});

console.log(secondResponse.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16from openai import OpenAI

client = OpenAI()

response = client.responses.create(
    model="gpt-6-astra",
    input="tell me a joke",
)
print(response.output_text)

second_response = client.responses.create(
    model="gpt-6-astra",
    previous_response_id=response.id,
    input=[{"role": "user", "content": "explain why this is funny."}],
)
print(second_response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36package main

import (
	"context"
	"fmt"

	"github.com/openai/openai-go/v3"
	"github.com/openai/openai-go/v3/responses"
)

func main() {
	client := openai.NewClient()

	first, err := client.Responses.New(context.Background(), responses.ResponseNewParams{
		Model: "gpt-6-astra",
		Input: responses.ResponseNewParamsInputUnion{
			OfString: openai.String("Tell me a joke."),
		},
	})
	if err != nil {
		panic(err)
	}
	fmt.Println(first.OutputText())

	second, err := client.Responses.New(context.Background(), responses.ResponseNewParams{
		Model:              "gpt-6-astra",
		PreviousResponseID: openai.String(first.ID),
		Input: responses.ResponseNewParamsInputUnion{
			OfString: openai.String("Explain why this is funny."),
		},
	})
	if err != nil {
		panic(err)
	}
	fmt.Println(second.OutputText())
}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.responses.ResponseCreateParams;

var first =
    client
        .responses()
        .create(
            ResponseCreateParams.builder().model("gpt-6-astra").input("Tell me a joke.").build());

first.output().stream()
    .flatMap(item -> item.message().stream())
    .flatMap(message -> message.content().stream())
    .flatMap(content -> content.outputText().stream())
    .forEach(text -> System.out.println(text.text()));

var second =
    client
        .responses()
        .create(
            ResponseCreateParams.builder()
                .model("gpt-6-astra")
                .input("Explain why this is funny.")
                .previousResponseId(first.id())
                .build());
second.output().stream()
    .flatMap(item -> item.message().stream())
    .flatMap(message -> message.content().stream())
    .flatMap(content -> content.outputText().stream())
    .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18using OpenAI.Responses;
#pragma warning disable OPENAI001

string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
ResponsesClient client = new(key);

ResponseResult first = await client.CreateResponseAsync(
    "gpt-6-astra",
    "Tell me a joke."
);
Console.WriteLine(first.GetOutputText());

ResponseResult second = await client.CreateResponseAsync(
    "gpt-6-astra",
    "Explain why this is funny.",
    previousResponseId: first.Id
);
Console.WriteLine(second.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16require "openai"

client = OpenAI::Client.new

first = client.responses.create(
  model: "gpt-6-astra",
  input: "Tell me a joke."
)
puts(first.output_text)

second = client.responses.create(
  model: "gpt-6-astra",
  previous_response_id: first.id,
  input: "Explain why this is funny."
)
puts(second.output_text)
使用 Responses API 的 WebSocket 模式 時,previous_response_id 延續對話的方式與 HTTP 模式相同,但會透過持續開啟的通訊端,多次傳送 response.create 事件。
每個連線都有專屬快取,會將最近的回應保留在記憶體中,以降低延續對話時的延遲。使用 stream_id 時,每個通道都能保留自己的最新回應。回應的承接關係仍由 previous_response_id 決定,因此只要另一個通道上的某個回應仍可用,新通道就能從該回應建立分支。如果某個 ID 不在快取中,也無法找到對應的回應,請將 previous_response_id 設為 null,並傳入完整的輸入上下文,開始新的回合。
回應物件預設會儲存 30 天。你可以在控制台的記錄頁面查看這些物件,或透過 API 擷取這些物件。若要停用儲存功能,請在建立回應時將 store 設為 false。
對話物件及其內含項目不受 30 天存留時間(TTL)的限制。只要回應已加入對話,其中的項目就會持久保存,不受 30 天 TTL 的限制。
未經你明確同意,OpenAI 不會使用透過 API 傳送的資料來訓練模型。瞭解詳情。
即使使用 previous_response_id,API 仍會將回應鏈中先前各次回應的所有輸入 Token 都按輸入 Token 計費。
瞭解上下文視窗有助於建立對話串,並在多次模型互動之間管理狀態。
上下文視窗是單一請求可使用的 Token 數量上限。輸入、輸出和推理 Token 都計入這個上限。若要查詢模型的上下文視窗大小,請參閱模型詳細資料。
當輸入變得更複雜,或對話包含更多回合時,就需要同時考量輸出 Token 和上下文視窗的上限。模型的輸入和輸出都以 Token 為計量單位。模型會將輸入拆解為 Token,分析其內容和意圖,再組合 Token 以產生連貫的輸出。每個模型對單次文字生成請求從開始到結束可使用的 Token 數量都設有上限。
- 輸出 Token 是模型根據提示詞產生的 Token。各模型的輸出 Token 上限不同。例如,
gpt-4o-2024-08-06 最多可產生 16,384 個輸出 Token。
- 上下文視窗決定輸入和輸出合計可使用多少 Token(部分模型也會計入推理 Token)。你可以比較各模型的上下文視窗上限。例如,
gpt-4o-2024-08-06 的上下文視窗總容量為 128k 個 Token。
如果提示詞很長,例如為模型加入了額外的上下文、資料或範例,就可能超出模型的上下文視窗上限,導致輸出遭到截斷。
你可以使用 Token 計數工具查看一段文字包含多少個 Token。這項工具使用 tiktoken 程式庫建置。
例如,向 Chat Completions 傳送 API 請求並使用 o1 模型時,下列 Token 都會計入上下文視窗的總用量:
- 輸入 Token(你在
messages 陣列中傳給 Chat Completions 的輸入)
- 輸出 Token(模型根據提示詞產生的 Token)
- 推理 Token(模型用來規劃回應的 Token)
例如,向 Responses API 傳送 API 請求並使用已啟用推理功能的模型(如 o1 模型)時,下列 Token 都會計入上下文視窗的總用量:
- 輸入 Token(你在
input 陣列中傳給 Responses API 的輸入)
- 輸出 Token(模型根據提示詞產生的 Token)
- 推理 Token(模型用來規劃回應的 Token)
API 回應可能會截斷超出上下文視窗上限的生成 Token。
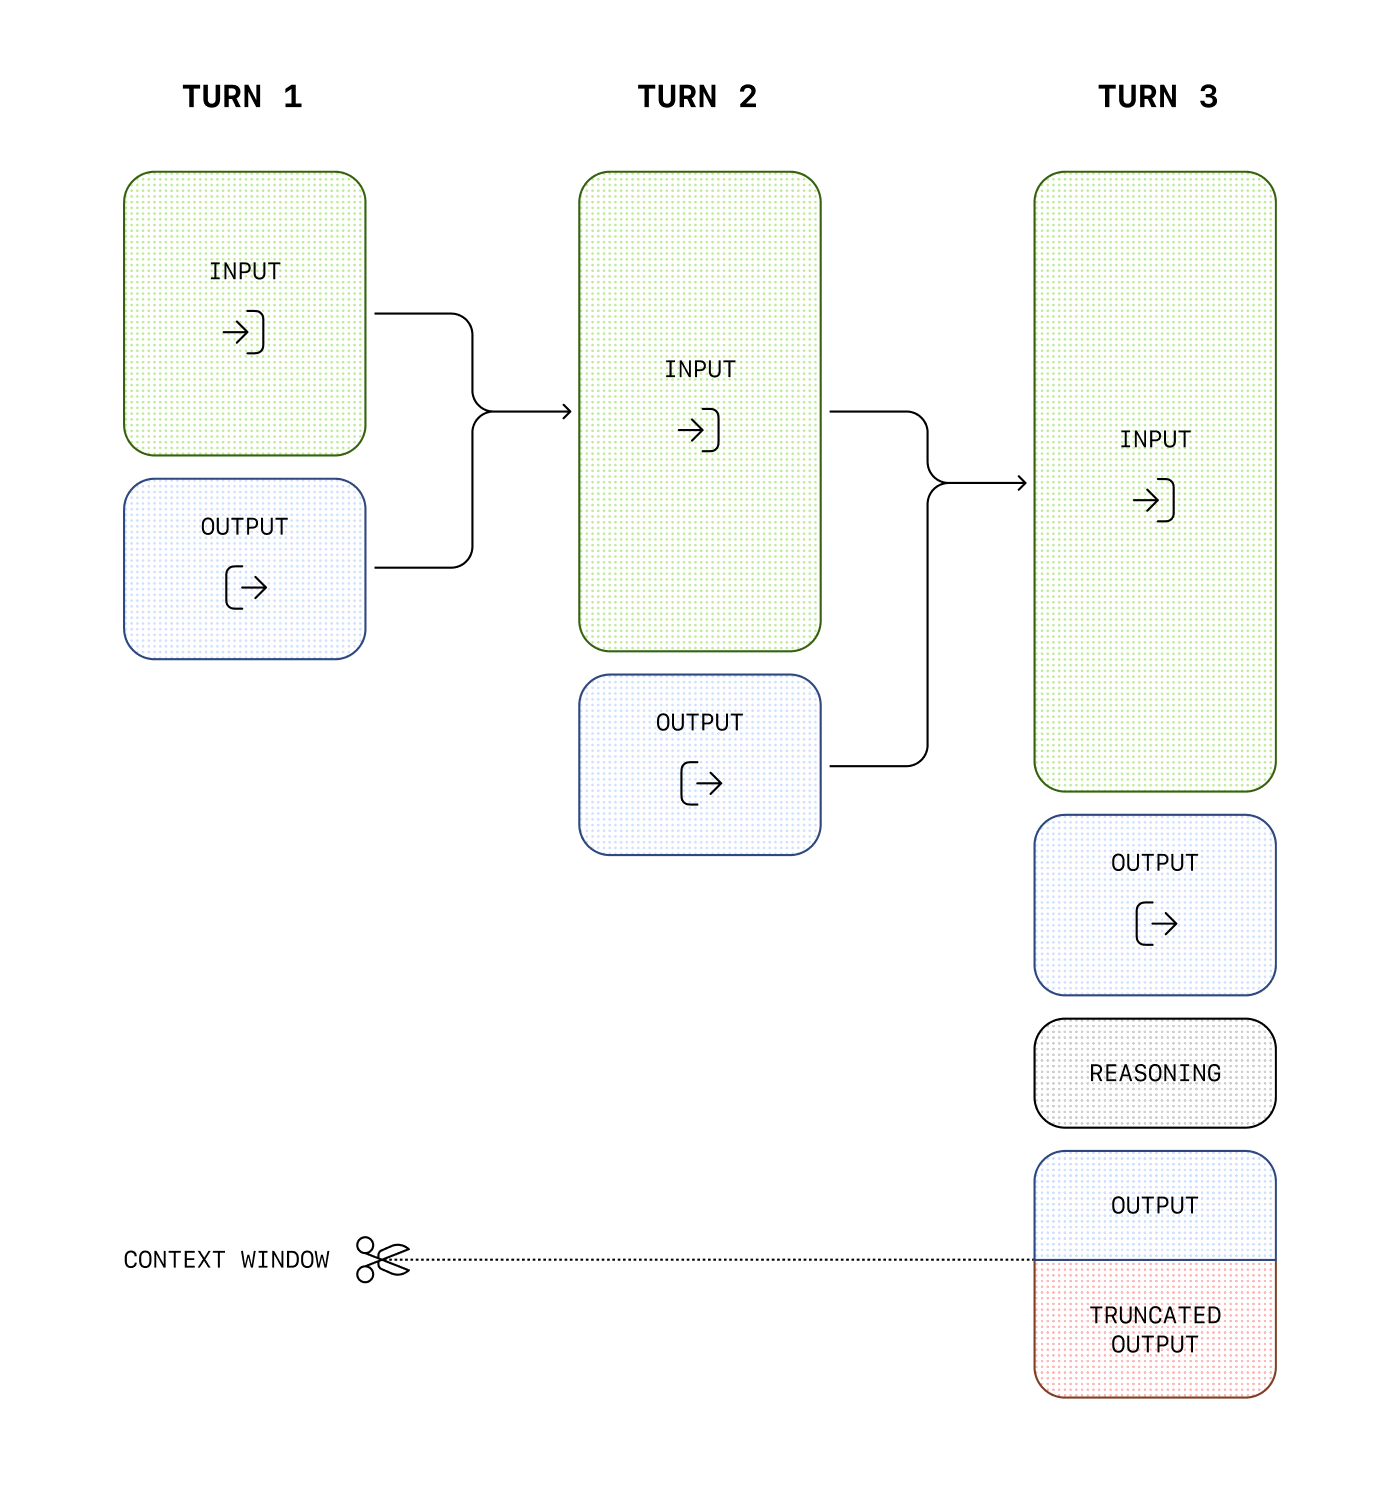
你可以使用 Token 計數工具估算訊息會使用多少個 Token。
如需詳細的壓縮指引,請參閱壓縮。
如需更多具體範例和使用案例,請參閱 OpenAI Cookbook,或透過以下指南瞭解如何使用 API 擴充模型功能:
