
AI 的音訊能力為使用者體驗開創了令人期待的新可能。今年稍早,我們推出了多款新的音訊模型,包括 gpt-realtime,也推出了新的 API 功能,讓開發者能打造這些體驗。
上週,我們推出了新的音訊模型快照,希望解決開發可靠的語音智慧體時常見的難題。這些快照提升了正式環境中各種語音工作流程的可靠性與品質,涵蓋語音轉錄、文字轉語音,以及原生支援即時語音到語音互動的智慧體。
本次更新包括:
gpt-4o-mini-transcribe-2025-12-15:搭配轉錄 API 或 Realtime API,將語音轉為文字。gpt-4o-mini-tts-2025-12-15:搭配 Speech API,將文字轉為語音。gpt-realtime-mini-2025-12-15:搭配 Realtime API,支援原生的即時語音到語音互動。gpt-audio-mini-2025-12-15:搭配 Chat Completions API,支援原生的語音到語音互動。
這些新快照有幾項共同的改進:
音訊輸入:
- 詞錯誤率更低,無論是處理真實環境中的音訊,還是含有雜訊的音訊。
- 較少出現幻覺,尤其是在無人說話或有背景雜訊時。
音訊輸出:
- 輸出的語音更自然、更穩定,使用自訂語音時也是如此。
新快照的價格與先前的模型快照相同,因此我們建議切換至新快照,以相同的價格獲得更好的效能。
如果你正在開發語音智慧體、客服系統或品牌語音體驗,這些更新能讓你的應用程式在正式環境中運作得更可靠。以下將逐項介紹更新內容,以及這些改進在實際語音工作流程中的表現。
語音到語音
我們正在部署新版 Realtime mini 和 Audio mini 模型,兩者都經過最佳化,能更準確地呼叫工具及遵循指示。新版模型縮小了 mini 模型與完整規模模型之間的能力差距,讓部分應用程式可以改用 mini 模型來降低成本。
gpt-realtime-mini-2025-12-15
gpt-realtime-mini 模型專為搭配 Realtime API 而設計。這個 API 支援低延遲的原生多模態互動。模型可透過串流接收及輸出音訊,也能處理使用者打斷對話的情況(可選擇啟用語音活動偵測),並在持續說話的同時於背景執行函式呼叫。
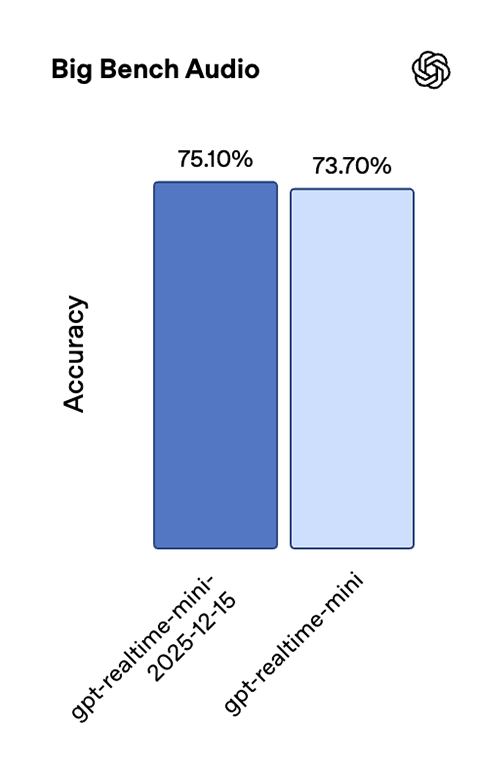
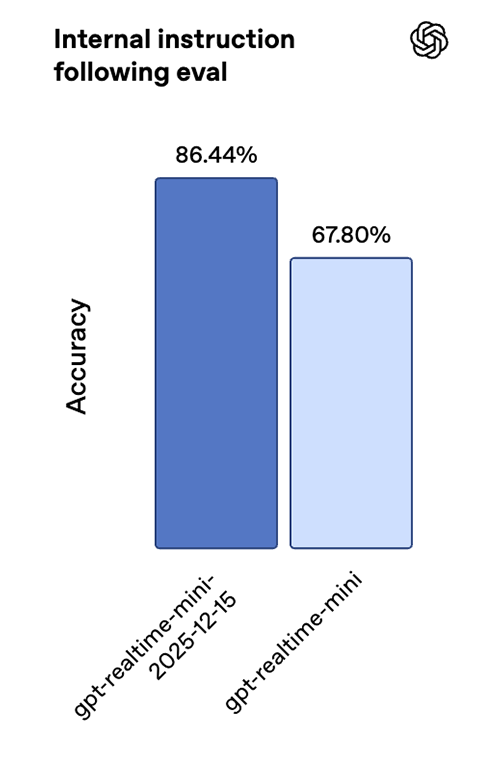
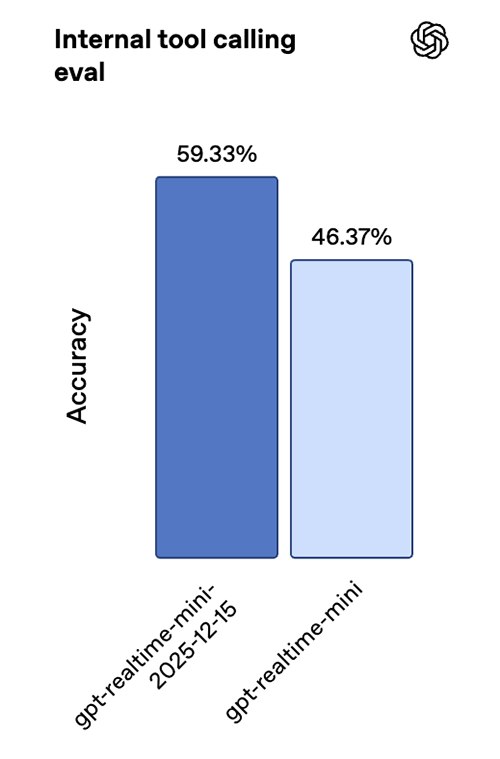
新的 Realtime mini 快照在遵循指示與呼叫工具方面都有明顯進步,更適合用於即時智慧體。在內部的語音到語音評測中,與上一版快照相比,遵循指示的準確率提高了 18.6 個百分點,工具呼叫的準確率提高了 12.9 個百分點。新版在 Big Bench Audio 基準測試中的表現也有所提升。
有了這些改進,在要求低延遲的即時互動中,智慧體能更可靠地完成多個步驟,執行函式時的表現也更一致。
如果你的應用需要更高的智慧體準確率,也值得為此投入更多成本,gpt-realtime 仍是我們表現最好的模型。如果最重要的考量是成本與延遲,gpt-realtime-mini 則是很好的選擇,在實際使用情境中也有良好表現。
例如,Genspark 以雙語翻譯和依使用者意圖自動分流這兩種情境,對模型進行了壓力測試。他們發現,除了語音品質有所提升,模型幾乎能立即回應,即使雙方快速交談,也能始終準確辨識使用者的意圖。
gpt-audio-mini-2025-12-15
如果你的語音到語音應用無須即時互動,可以搭配使用 gpt-audio-mini 模型與 Chat Completions API。
這兩款新快照也都採用了升級版解碼器,讓聲音聽起來更自然,使用自訂語音時也更能維持聲音的一致性。
文字轉語音
我們最新的文字轉語音模型 gpt-4o-mini-tts-2025-12-15 大幅提升了準確度,在各項標準語音基準測試中的詞錯誤率都明顯低於上一代模型。在 Common Voice 和 FLEURS 測試中,詞錯誤率(WER)降低了約 35%,在 Multilingual LibriSpeech 測試中也有穩定的改善。
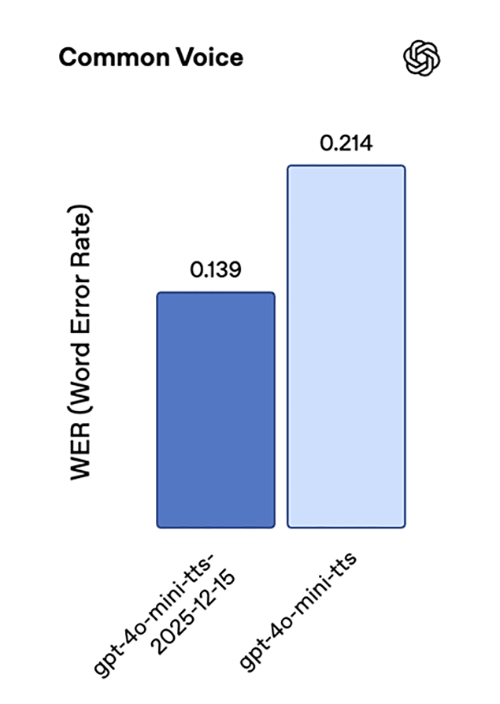
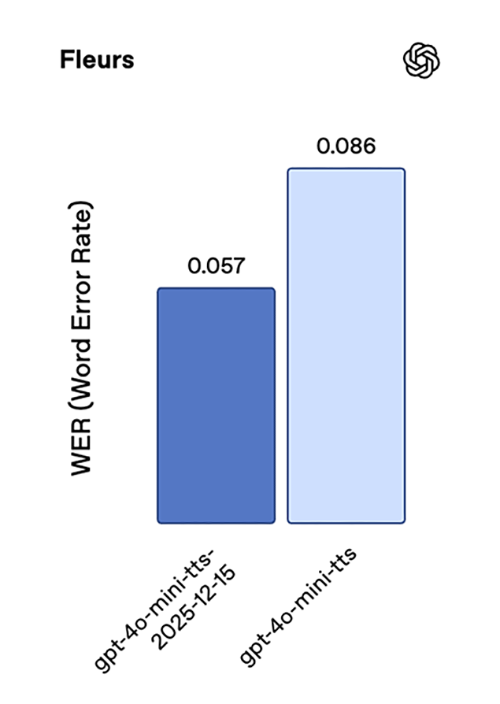
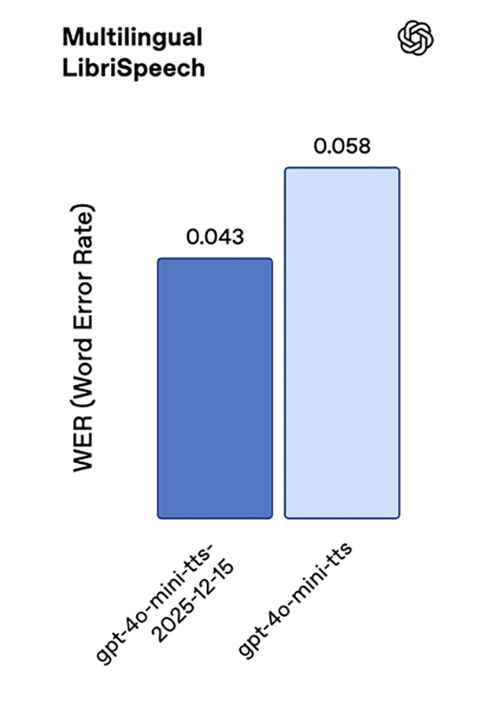
整體而言,這些結果顯示,模型在多種語言中的發音更準確,表現也更穩健。
和新的 gpt-realtime-mini 快照一樣,這款模型的語音聽起來自然許多,使用自訂語音時的表現也更好。
語音轉文字
最新的轉錄模型 gpt-4o-mini-transcribe-2025-12-15 在準確度與可靠性上都有明顯進步。我們在 Common Voice 和 FLEURS 等標準自動語音辨識(ASR)基準測試中未提供語言提示,測得的詞錯誤率低於先前的模型。我們針對實際對話情境進行了最佳化,例如使用者只說了短短幾個字,或周遭環境嘈雜。在內部評測中,我們測試了模型在有雜訊時產生幻覺的情況。我們播放了真實環境的背景雜訊片段,以及說話間隔長短不一的音訊(包含靜默片段)。這款模型產生的幻覺比 Whisper v2 少約 90%,比先前的 GPT-4o-transcribe 模型少約 70%。
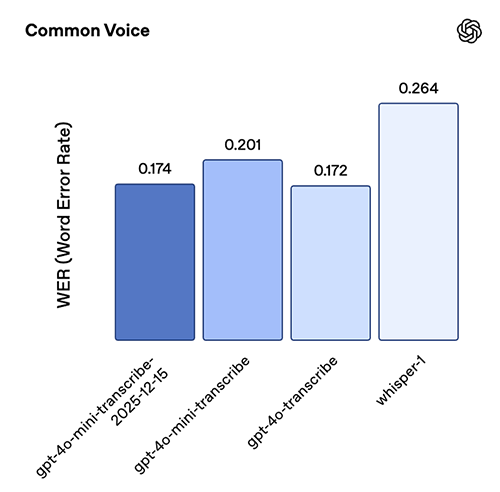
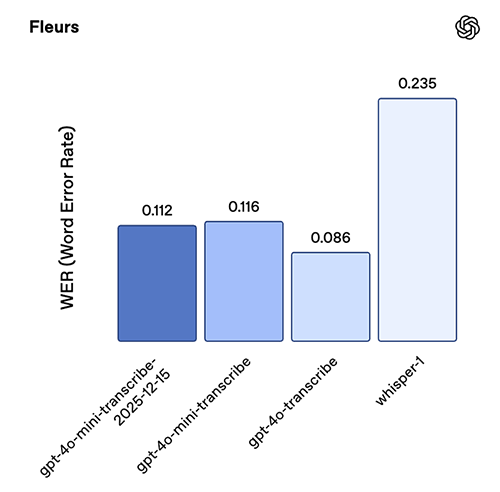
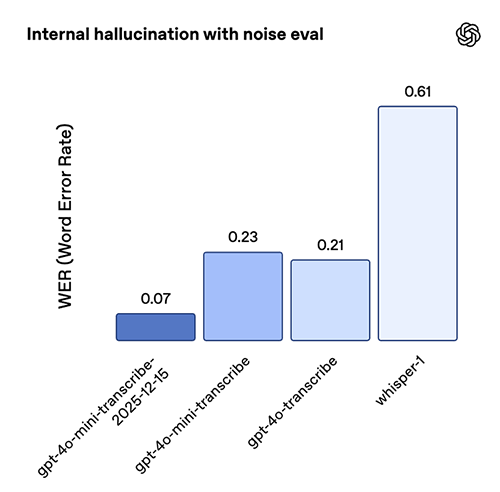
這款模型快照在中文(華語)、印地語、孟加拉語、日語、印尼語及義大利語上的表現尤其出色。
自訂語音
自訂語音讓組織能以品牌獨有的聲音與客戶互動。無論你要打造客服智慧體還是品牌虛擬角色,OpenAI 的自訂語音技術都能讓你輕鬆建立獨特而逼真的聲音。
這些新的語音到語音與文字轉語音模型改善了自訂語音的效果:語調更自然,聲音更忠於原始樣本,說不同方言時也更準確。
為確保這項技術能安全使用,自訂語音僅開放給符合資格的客戶。如需進一步瞭解,請聯絡你的客戶總監,或洽詢我們的業務團隊。
從原型到正式上線
語音應用程式容易在幾種情境中出錯,主要是對話持續較久、遇到無人說話等邊界情況,或語音智慧體必須準確呼叫工具才能完成流程時。本次更新針對這些問題降低了錯誤率、減少了幻覺,也讓工具使用更一致,模型更能遵循指示。此外,我們也提升了音訊輸出的穩定性,讓你的語音應用聽起來更自然。
如果你目前正在推出語音應用,我們建議切換至新的 2025-12-15 快照,並重新執行正式環境中的關鍵測試案例。
早期測試者確認,只要切換至新快照,即使沿用原本的指示,也能看到明顯改善。我們仍建議你在自己的使用情境中實際測試,並視需要調整提示詞。