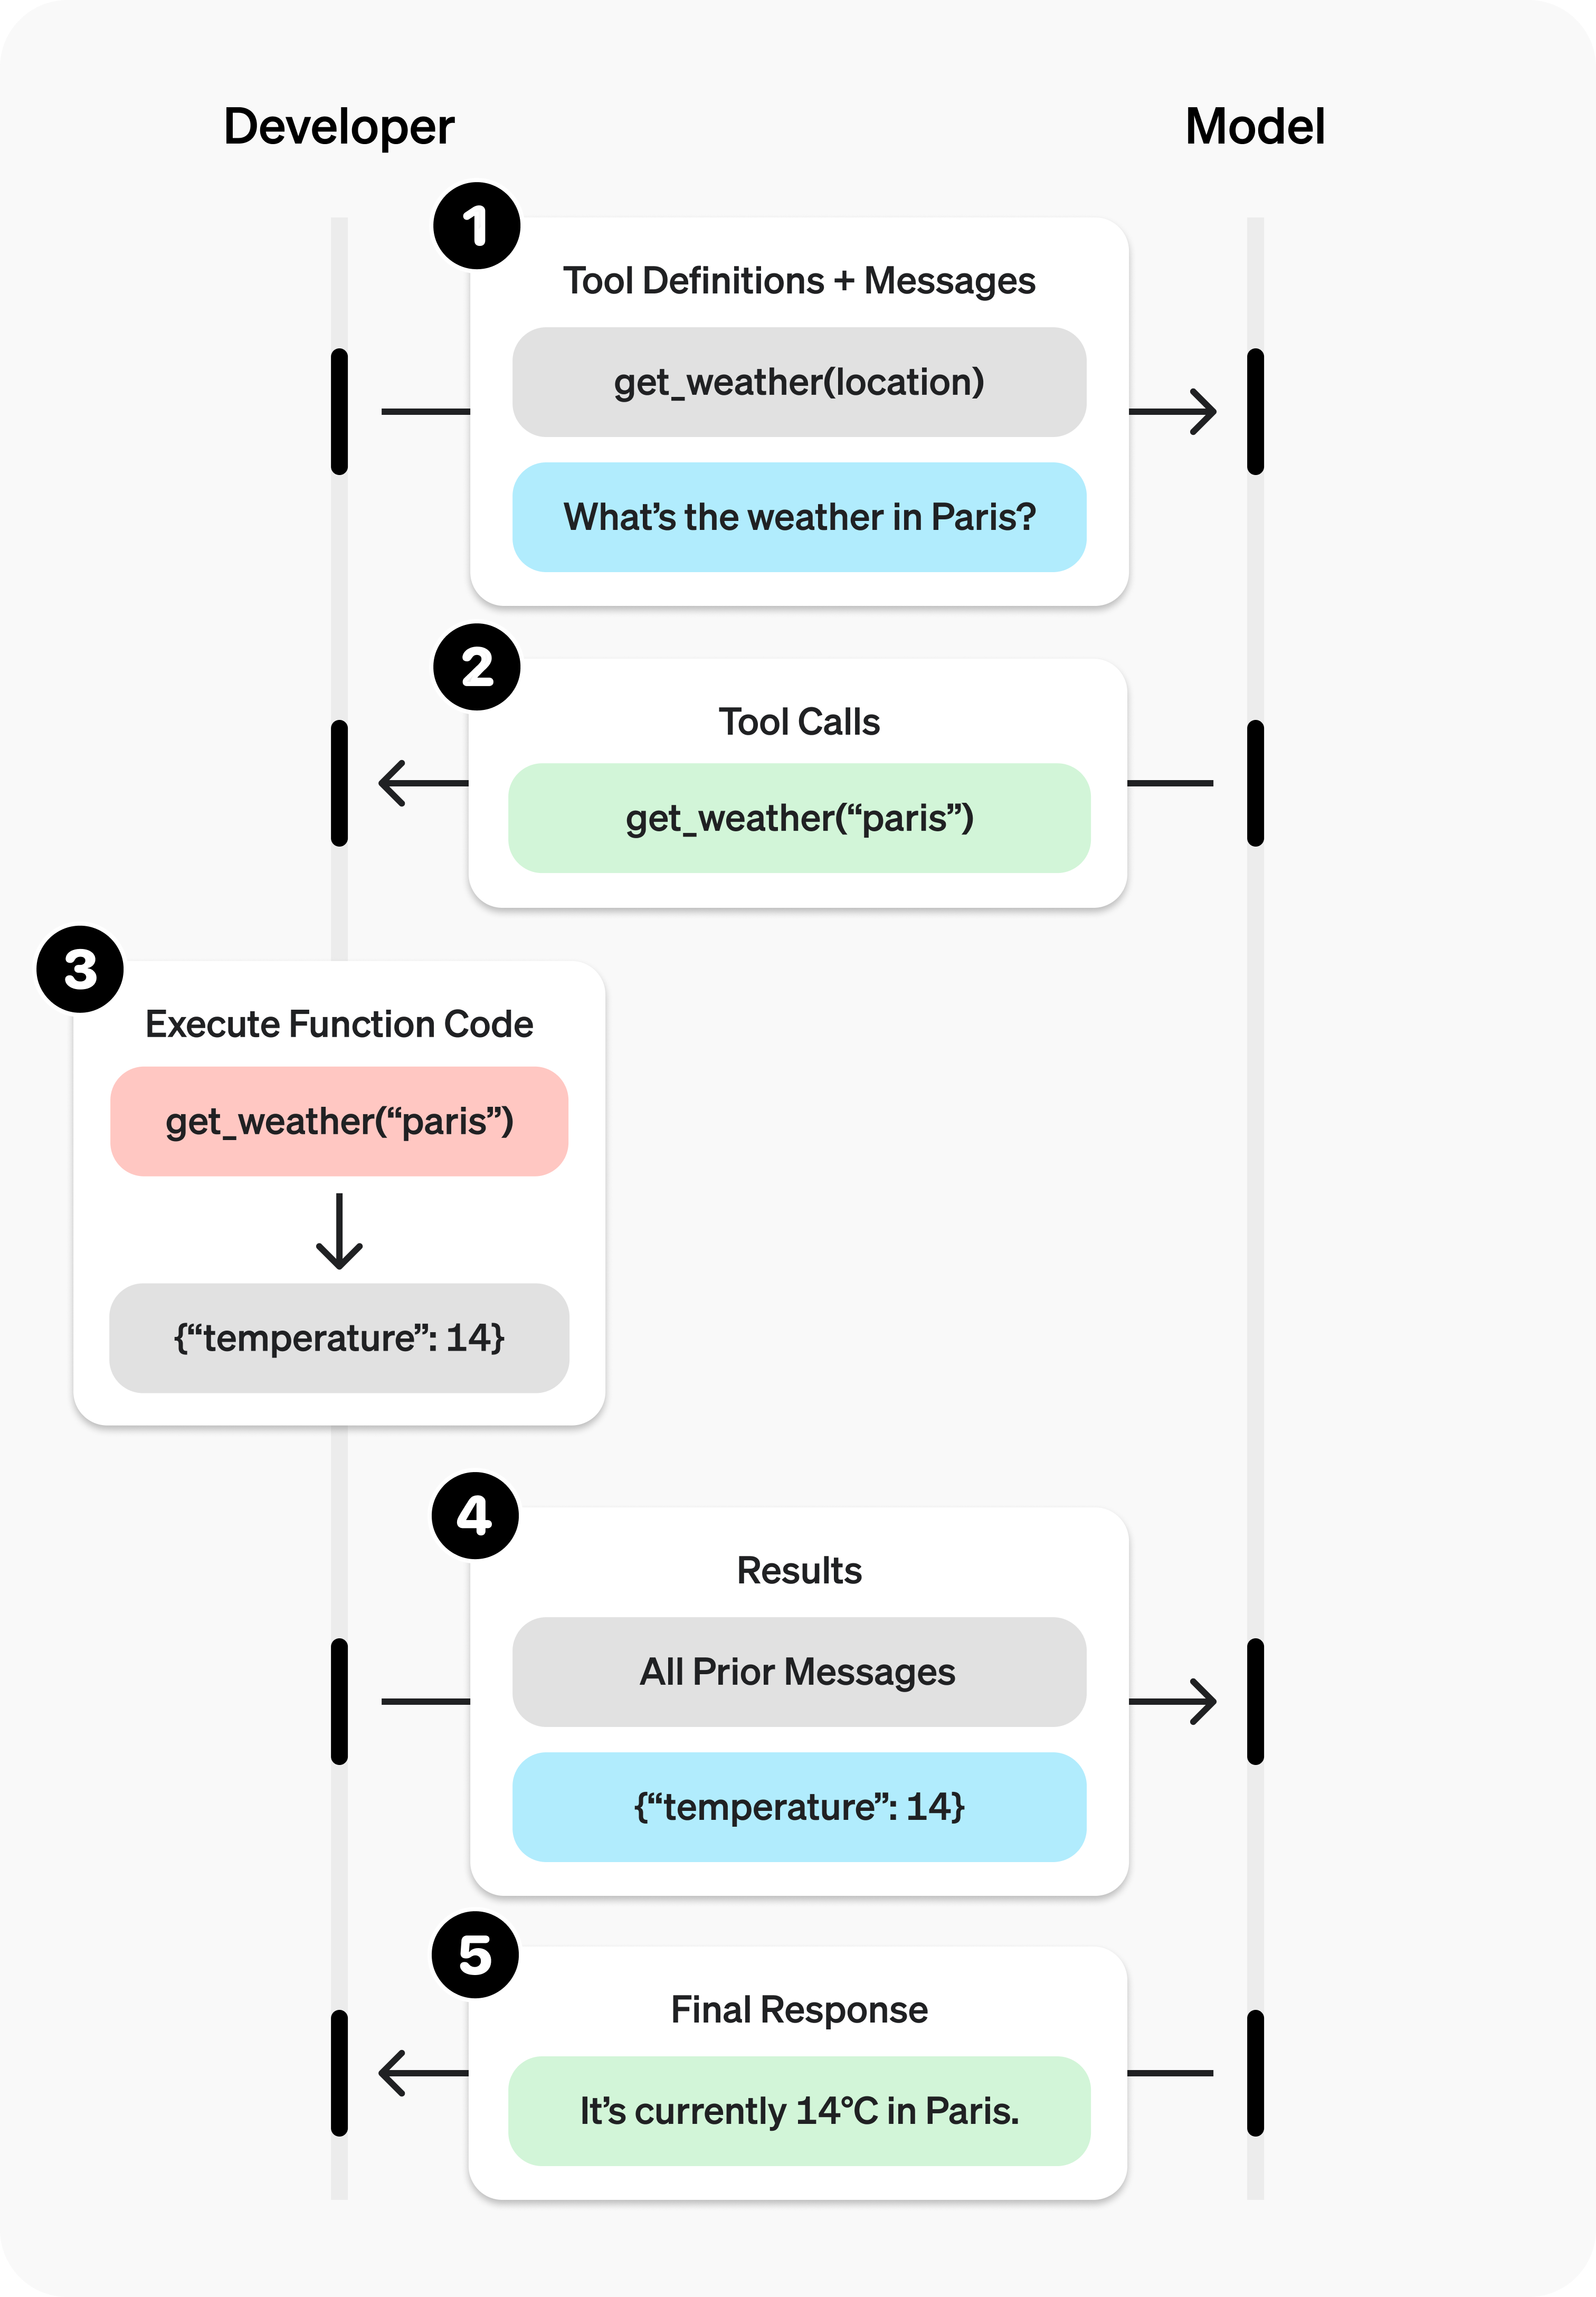
Da a los modelos acceso a nuevas funciones y datos que puedan usar para seguir instrucciones y responder a prompts.
Responses
La llamada a funciones (también conocida como llamada a herramientas) ofrece una forma potente y flexible para que los modelos de OpenAI interactúen con sistemas externos y accedan a datos que no forman parte de sus datos de entrenamiento. Esta guía muestra cómo conectar un modelo con los datos y las acciones que ofrece tu aplicación. Mostraremos cómo usar herramientas de función (definidas mediante un esquema JSON) y herramientas personalizadas que trabajan con entradas y salidas de texto libre.
Para las sesiones de la API de agentes, usa Funciones para registrar funciones y gestionar las solicitudes de acciones de la sesión. Los ejemplos de esta guía muestran las integraciones con la API Responses y Chat Completions.
Si tu aplicación tiene muchas funciones o esquemas grandes, puedes combinar la llamada a funciones con la búsqueda de herramientas para diferir la carga de las herramientas que se usan con poca frecuencia y cargarlas solo cuando el modelo las necesite. Solo gpt-5.4 y los modelos posteriores admiten tool_search.
GPT-6 Astra requiere la API Responses para la llamada a herramientas. Los ejemplos de Chat Completions
usan GPT-5.6 por compatibilidad. Consulta la guía de
migración para actualizar una integración
existente.
Cómo funciona
Comencemos por entender algunos términos clave sobre la llamada a herramientas. Una vez que tengamos un vocabulario común, te mostraremos cómo se hace con algunos ejemplos prácticos.
Una función o herramienta se refiere, en términos generales, a una capacidad que le indicamos al modelo que tiene a su disposición. Al generar una respuesta a un prompt, el modelo puede decidir que necesita datos o capacidades de una herramienta para seguir las instrucciones del prompt.
Podrías darle al modelo acceso a herramientas que permitan:
Consultar el clima de hoy en un lugar
Acceder a los detalles de una cuenta a partir de un ID de usuario
Emitir reembolsos por un pedido extraviado
O cualquier otra cosa que quieras que el modelo pueda saber o hacer al responder a un prompt.
Cuando hacemos una solicitud al modelo a través de la API con un prompt, podemos incluir una lista de herramientas que el modelo podría considerar usar. Por ejemplo, si quisiéramos que el modelo pudiera responder preguntas sobre el clima actual en algún lugar del mundo, podríamos darle acceso a una herramienta get_weather que recibe location como argumento.
Una llamada a una función o llamada a una herramienta se refiere a un tipo especial de respuesta que podemos recibir del modelo cuando analiza un prompt y determina que, para seguir sus instrucciones, necesita llamar a una de las herramientas que pusimos a su disposición.
Si el modelo recibe un prompt como “¿Cómo está el clima en París?” en una solicitud a la API, podría responder con una llamada a la herramienta get_weather, con Paris como valor del argumento location.
El resultado de una llamada a una función o resultado de una llamada a una herramienta se refiere a la respuesta que genera una herramienta con los datos de entrada de una llamada del modelo. Este resultado puede ser JSON estructurado o texto sin formato, y debe contener una referencia a una llamada específica del modelo a una herramienta (identificada mediante call_id en los ejemplos que siguen).
Para completar nuestro ejemplo del clima:
El modelo tiene acceso a una herramientaget_weather que recibe location como argumento.
En respuesta a un prompt como “¿Cómo está el clima en París?”, el modelo devuelve una llamada a una herramienta que contiene un argumento location con el valor Paris
El resultado de la llamada a la herramienta podría devolver un objeto JSON (por ejemplo, {"temperature": "25", "unit": "C"}, que indica una temperatura actual de 25 grados), contenido de imágenes o contenido de archivos.
Luego, enviamos de vuelta al modelo la definición completa de la herramienta, el prompt original, la llamada del modelo a la herramienta y su resultado para recibir finalmente una respuesta de texto como esta:
The weather in Paris today is 25C.
Una función es un tipo específico de herramienta, definida mediante un esquema JSON. La definición de una función permite que el modelo pase datos a tu aplicación, donde tu código puede acceder a datos o realizar las acciones que sugiere el modelo.
Además de las herramientas de función, existen herramientas personalizadas (descritas en esta guía) que trabajan con entradas y salidas de texto libre.
La llamada a herramientas es una conversación de varios pasos entre tu aplicación y un modelo a través de la API de OpenAI. Este flujo consta de cinco pasos generales:
Envía una solicitud al modelo con las herramientas a las que podría llamar
Recibe una llamada a una herramienta del modelo
Ejecuta código en la aplicación con los datos de entrada de la llamada a la herramienta
Envía una segunda solicitud al modelo con el resultado de la herramienta
Recibe una respuesta final del modelo (o más llamadas a herramientas)
Con Responses, tu aplicación puede continuar este flujo durante tantas llamadas a herramientas como requiera la tarea. Si quieres un framework que encapsule la orquestación recurrente de ese ciclo, consulta la comparación entre la API Responses y el Agents SDK.
Ejemplo de una herramienta de función
Veamos un flujo completo de llamada a herramientas para una función get_horoscope que obtiene el horóscopo diario de un signo del zodiaco.
Ejemplo completo de llamada a herramientas
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70import OpenAI from "openai";const openai = new OpenAI();// 1. Define a list of callable tools for the modelconst tools = [ { type: "function", function: { name: "get_horoscope", description: "Get today's horoscope for an astrological sign.", parameters: { type: "object", properties: { sign: { type: "string", description: "An astrological sign like Taurus or Aquarius", }, }, required: ["sign"], additionalProperties: false, }, strict: true, }, },];function getHoroscope(sign) { return `${sign}: Next Tuesday you will befriend a baby otter.`;}const messages = [ { role: "user", content: "What is my horoscope? I am an Aquarius." },];// 2. Prompt the model with tools definedlet response = await openai.chat.completions.create({ model: "gpt-5.6", messages, tools,});messages.push(response.choices[0].message);for (const toolCall of response.choices[0].message.tool_calls ?? []) { if (toolCall.type !== "function") continue; if (toolCall.function.name === "get_horoscope") { // 3. Execute the function logic for get_horoscope const args = JSON.parse(toolCall.function.arguments); const horoscope = getHoroscope(args.sign); // 4. Provide function call results to the model messages.push({ role: "tool", tool_call_id: toolCall.id, content: JSON.stringify({ horoscope }), }); }}response = await openai.chat.completions.create({ model: "gpt-5.6", messages, tools,});// 5. The model should be able to give a response!console.log(response.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67from openai import OpenAIimport jsonclient = OpenAI()# 1. Define a list of callable tools for the modeltools = [ {"type": "function","function": {"name": "get_horoscope","description": "Get today's horoscope for an astrological sign.","parameters": {"type": "object","properties": {"sign": {"type": "string","description": "An astrological sign like Taurus or Aquarius", }, },"required": ["sign"],"additionalProperties": False, },"strict": True, }, },]defget_horoscope(sign):returnf"{sign}: Next Tuesday you will befriend a baby otter."messages = [{"role": "user", "content": "What is my horoscope? I am an Aquarius."}]# 2. Prompt the model with tools definedresponse = client.chat.completions.create(model="gpt-5.6",messages=messages,tools=tools,)messages.append(response.choices[0].message)for tool_call in response.choices[0].message.tool_calls or []:if tool_call.function.name =="get_horoscope":# 3. Execute the function logic for get_horoscope args = json.loads(tool_call.function.arguments) horoscope = get_horoscope(args["sign"])# 4. Provide function call results to the model messages.append( {"role": "tool","tool_call_id": tool_call.id,"content": json.dumps({"horoscope": horoscope}), } )response = client.chat.completions.create(model="gpt-5.6",messages=messages,tools=tools,)# 5. The model should be able to give a response!print(response.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77import OpenAI from "openai";import { toResponseInputItems } from "openai/lib/responses/ResponseInputItems";const openai = new OpenAI();// 1. Define a list of callable tools for the modelconst tools = [ { type: "function", name: "get_horoscope", description: "Get today's horoscope for an astrological sign.", parameters: { type: "object", properties: { sign: { type: "string", description: "An astrological sign like Taurus or Aquarius", }, }, required: ["sign"], additionalProperties: false, }, strict: true, },];function getHoroscope(sign) { return `${sign}: Next Tuesday you will befriend a baby otter.`;}// Create a running input list we will add to over timelet input = [ { role: "user", content: "What is my horoscope? I am an Aquarius." },];// 2. Prompt the model with tools definedlet response = await openai.responses.create({ model: "gpt-6-astra", tools, input,});// Preserve model output for the next turninput.push(...toResponseInputItems(response.output));for (const item of response.output) { if (item.type !== "function_call") continue; if (item.name === "get_horoscope") { // 3. Execute the function logic for get_horoscope const { sign } = JSON.parse(item.arguments); const horoscope = getHoroscope(sign); // 4. Provide function call results to the model input.push({ type: "function_call_output", call_id: item.call_id, output: horoscope, }); }}console.log("Final input:");console.log(JSON.stringify(input, null, 2));response = await openai.responses.create({ model: "gpt-6-astra", instructions: "Respond only with a horoscope generated by a tool.", tools, input,});// 5. The model should be able to give a response!console.log("Final output:");console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72from openai import OpenAIimport jsonclient = OpenAI()# 1. Define a list of callable tools for the modeltools = [ {"type": "function","name": "get_horoscope","description": "Get today's horoscope for an astrological sign.","parameters": {"type": "object","properties": {"sign": {"type": "string","description": "An astrological sign like Taurus or Aquarius", }, },"required": ["sign"], }, },]defget_horoscope(sign):returnf"{sign}: Next Tuesday you will befriend a baby otter."# Create a running input list we will add to over timeinput_list = [{"role": "user", "content": "What is my horoscope? I am an Aquarius."}]# 2. Prompt the model with tools definedresponse = client.responses.create(model="gpt-6-astra",tools=tools,input=input_list,)# Save function call outputs for subsequent requestsinput_list += response.outputfor item in response.output:if item.type =="function_call":if item.name =="get_horoscope":# 3. Execute the function logic for get_horoscope sign = json.loads(item.arguments)["sign"] horoscope = get_horoscope(sign)# 4. Provide function call results to the model input_list.append( {"type": "function_call_output","call_id": item.call_id,"output": horoscope, } )print("Final input:")print(input_list)response = client.responses.create(model="gpt-6-astra",instructions="Respond only with a horoscope generated by a tool.",tools=tools,input=input_list,)# 5. The model should be able to give a response!print("Final output:")print(response.model_dump_json(indent=2))print("\n"+ response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75package mainimport ( "context" "encoding/json" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() tool := horoscopeResponseTool() response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Input: responses.ResponseNewParamsInputUnion{OfString: openai.String("What is my horoscope? I am an Aquarius.")}, Tools: []responses.ToolUnionParam{tool}, }) if err != nil { panic(err) } var functionOutput responses.ResponseInputItemUnionParam for _, output := range response.Output { if output.Type != "function_call" { continue } call := output.AsFunctionCall() if call.Name != "get_horoscope" { continue } var arguments struct { Sign string `json:"sign"` } if err := json.Unmarshal([]byte(call.Arguments), &arguments); err != nil { panic(err) } functionOutput = responses.ResponseInputItemParamOfFunctionCallOutput(getHoroscope(arguments.Sign)) functionOutput.OfFunctionCallOutput.CallID = openai.String(call.CallID) } if functionOutput.OfFunctionCallOutput == nil { panic("the model did not call get_horoscope") } response, err = client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", PreviousResponseID: openai.String(response.ID), Instructions: openai.String("Respond only with a horoscope generated by a tool."), Input: responses.ResponseNewParamsInputUnion{OfInputItemList: responses.ResponseInputParam{functionOutput}}, Tools: []responses.ToolUnionParam{tool}, }) if err != nil { panic(err) } fmt.Println(response.OutputText())}func horoscopeResponseTool() responses.ToolUnionParam { parameters := map[string]any{ "type": "object", "properties": map[string]any{ "sign": map[string]any{"type": "string", "description": "An astrological sign like Taurus or Aquarius"}, }, "required": []string{"sign"}, "additionalProperties": false, } tool := responses.ToolParamOfFunction("get_horoscope", parameters, true) tool.OfFunction.Description = openai.String("Get today's horoscope for an astrological sign.") return tool}func getHoroscope(sign string) string { return fmt.Sprintf("%s: Next Tuesday you will befriend a baby otter.", sign)}
Ten en cuenta que, en los modelos de razonamiento como GPT-5 u o4-mini, todos los elementos de razonamiento
que se devuelvan en las respuestas del modelo con llamadas a herramientas también deben enviarse de vuelta junto con los resultados
de esas llamadas.
Definir funciones
Las funciones suelen declararse en el parámetro tools de cada solicitud a la API. Con la búsqueda de herramientas, tu aplicación también puede cargar funciones diferidas más adelante en la interacción. En ambos casos, cada función a la que se puede llamar usa la misma estructura de esquema. La definición de una función tiene las siguientes propiedades:
Campo
Descripción
type
Siempre debe ser function
name
El nombre de la función (por ejemplo, get_weather)
description
Detalles sobre cuándo y cómo usar la función
parameters
Esquema JSON que define los argumentos de entrada de la función
strict
Indica si se debe aplicar el modo estricto a la llamada a la función
Aquí tienes un ejemplo de definición de una función get_weather
12345678910111213141516171819202122{ "type": "function", "name": "get_weather", "description": "Retrieves current weather for the given location.", "parameters": { "type": "object", "properties": { "location": { "type": "string", "description": "City and country e.g. Bogotá, Colombia" }, "units": { "type": "string", "enum": ["celsius", "fahrenheit"], "description": "Units the temperature will be returned in." } }, "required": ["location", "units"], "additionalProperties": false }, "strict": true}
Al definir parameters mediante un esquema JSON, puedes aprovechar muchas de sus funciones avanzadas, como tipos de propiedades, enumeraciones, descripciones, objetos anidados y objetos recursivos.
Definir espacios de nombres
Usa espacios de nombres para agrupar herramientas relacionadas por dominio, como crm, billing o shipping. Los espacios de nombres ayudan a organizar herramientas similares y son especialmente útiles cuando el modelo debe elegir entre herramientas que sirven a distintos sistemas o propósitos, como una herramienta de búsqueda para tu CRM y otra para tu sistema de tickets de soporte.
Si necesitas darle al modelo acceso a un amplio ecosistema de herramientas, puedes diferir la carga de algunas o de todas ellas con tool_search. La herramienta tool_search permite que el modelo busque herramientas relevantes, las agregue a su contexto y luego las use. Solo gpt-5.4 y los modelos posteriores la admiten. Lee la guía de búsqueda de herramientas para obtener más información.
Aunque recomendamos que definas directamente los esquemas de tus funciones, nuestros SDK incluyen funciones auxiliares para convertir objetos de pydantic y zod en esquemas. No se admiten todas las características de pydantic y zod.
Define objetos para representar el esquema de la función
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26import OpenAI from "openai";import { z } from "zod";import { zodFunction } from "openai/helpers/zod";const openai = new OpenAI();const GetWeatherParameters = z.object({ location: z.string().describe("City and country e.g. Bogotá, Colombia"),});const tools = [ zodFunction({ name: "getWeather", parameters: GetWeatherParameters }),];const messages = [ { role: "user", content: "What's the weather like in Paris today?" },];const response = await openai.chat.completions.create({ model: "gpt-5.6", messages, tools, store: true,});console.log(response.choices[0].message.tool_calls);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19from openai import OpenAI, pydantic_function_toolfrom pydantic import BaseModel, Fieldclient = OpenAI()classGetWeather(BaseModel): location: str= Field(..., description="City and country e.g. Bogotá, Colombia")tools = [pydantic_function_tool(GetWeather)]completion = client.chat.completions.create(model="gpt-5.6",messages=[{"role": "user", "content": "What's the weather like in Paris today?"}],tools=tools,)print(completion.choices[0].message.tool_calls)
Prácticas recomendadas para definir funciones
Escribe nombres de funciones, descripciones de parámetros e instrucciones que sean claros y detallados.
Describe explícitamente el propósito de la función y de cada parámetro (y su formato), así como lo que representa la salida.
Usa el prompt del sistema para describir cuándo usar cada función y cuándo no. En general, dile al modelo exactamente qué hacer.
Incluye ejemplos y casos límite, especialmente para corregir fallas recurrentes. (Nota: agregar ejemplos puede perjudicar el desempeño de los modelos de razonamiento.)
Para las herramientas de carga diferida, incluye instrucciones detalladas en la descripción de la función y mantén concisa la descripción del espacio de nombres. El espacio de nombres ayuda al modelo a elegir qué cargar; la descripción de la función lo ayuda a usar correctamente la herramienta cargada.
Aplica las prácticas recomendadas de ingeniería de software.
Usa enumeraciones y la estructura de los objetos para evitar estados no válidos. Por ejemplo, toggle_light(on: bool, off: bool) permite llamadas no válidas.
Supera la prueba del pasante. ¿Puede un pasante u otra persona usar correctamente la función con solo la información que le diste al modelo? (Si no, ¿qué preguntas te hace? Agrega las respuestas al prompt.)
Reduce la carga del modelo y usa código cuando sea posible.
No hagas que el modelo complete argumentos cuyos valores ya conoces. Por ejemplo, si ya tienes un order_id a partir de un menú anterior, no incluyas un parámetro order_id. En su lugar, define submit_refund() sin parámetros y pasa el order_id en tu código.
Combina las funciones que siempre se llaman en secuencia. Por ejemplo, si siempre llamas a mark_location() después de query_location(), simplemente mueve la lógica de marcado a la llamada a la función de consulta.
Mantén un número reducido de funciones disponibles al inicio para lograr mayor precisión.
Evalúa el desempeño con distintas cantidades de funciones.
Procura que haya menos de 20 funciones disponibles al inicio de cada turno , aunque esto es solo una recomendación orientativa.
Usa la búsqueda de herramientas para diferir la carga de grupos grandes de herramientas o de herramientas que se usan con poca frecuencia, en lugar de exponerlas todas desde el principio.
Aprovecha los recursos de OpenAI.
Genera esquemas de funciones y mejóralos de forma iterativa en el Playground.
Considera el ajuste fino para aumentar la precisión de las llamadas a funciones cuando haya muchas funciones o tareas difíciles. (Cookbook)
Uso de tokens
Internamente, las funciones se insertan en el mensaje del sistema con una sintaxis con la que se entrenó al modelo. Esto significa que las definiciones de las funciones que se pueden llamar cuentan para el límite de contexto del modelo y se facturan como tokens de entrada. Si alcanzas los límites de tokens, te sugerimos limitar la cantidad de funciones que se cargan al inicio, acortar las descripciones cuando sea posible o usar la búsqueda de herramientas para que las herramientas de carga diferida solo se carguen cuando se necesiten.
También puedes usar el ajuste fino para reducir la cantidad de tokens utilizados si tienes muchas funciones definidas en tu especificación de herramientas.
Manejo de llamadas a funciones
Cuando el modelo llama a una función, debes ejecutarla y devolver el resultado. Como las respuestas del modelo pueden incluir cero, una o varias llamadas, la práctica recomendada es asumir que habrá varias.
La respuesta contiene un arreglo de tool_calls, cada una con un id (que se usa después para enviar el resultado de la función) y una function que contiene un name y arguments codificados en JSON.
Ejemplo de respuesta con varias llamadas a funciones
El arreglo output de la respuesta contiene una entrada cuyo type tiene el valor function_call. Cada entrada incluye un call_id (que se usa después para enviar el resultado de la función), un name y arguments codificados en JSON.
Ejemplo de respuesta con varias llamadas a funciones
Si usas la búsqueda de herramientas, también puedes ver elementos tool_search_call y tool_search_output antes de un function_call. Una vez cargada la función, maneja la llamada a la función de la misma manera que se muestra aquí.
Ejecuta las llamadas a funciones y agrega los resultados
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16def call_function(name, arguments) case name when "get_weather" FunctionCallingExample.get_weather( arguments.fetch("latitude"), arguments.fetch("longitude") ) when "send_email" FunctionCallingExample.send_email( arguments.fetch("to"), arguments.fetch("body") ) else raise ArgumentError, "Unknown function: #{name}" endend
Formato de los resultados
Por lo general, el resultado que pases en el mensaje function_call_output debe ser una cadena de texto cuyo formato puedes elegir (JSON, códigos de error, texto sin formato, etc.). El modelo interpretará esa cadena según sea necesario.
Si tu función no tiene un valor de retorno (por ejemplo, send_email), devuelve una cadena de texto que indique si la operación tuvo éxito o falló, como "success".
Incorporación de los resultados en la respuesta
Después de agregar los resultados a messages, puedes enviarlos de vuelta al modelo para obtener una respuesta final.
"It's about 15°C in Paris, 18°C in Bogotá, and I've sent that email to Bob."
Configuraciones adicionales
Selección de herramientas
De forma predeterminada, el modelo determinará cuándo usar herramientas y cuántas usar. Puedes forzar un comportamiento específico con el parámetro tool_choice.
Automática: (Predeterminada) llamar a cero, una o varias funciones. tool_choice: "auto"
Obligatoria: llamar a una o más funciones.
tool_choice: "required"
Función forzada: llamar exactamente a una función específica.
tool_choice: {"type": "function", "name": "get_weather"}
Herramientas permitidas: restringir las llamadas a herramientas que puede hacer el modelo a un subconjunto de
las herramientas disponibles para el modelo.
Cuándo usar allowed_tools
Puedes configurar una lista allowed_tools si quieres que solo esté disponible
un subconjunto de herramientas en las solicitudes al modelo, sin modificar la lista de herramientas que envías, para maximizar el ahorro del almacenamiento de prompts en caché.
También puedes establecer tool_choice en "none" para simular el comportamiento de no pasar ninguna función.
Cuando usas la búsqueda de herramientas, tool_choice sigue aplicándose a las herramientas que se pueden llamar en ese momento del turno. Esto resulta especialmente útil después de cargar un subconjunto de herramientas, cuando quieres limitar al modelo a ese subconjunto.
Llamadas a funciones en paralelo
En los modelos compatibles a partir de GPT-5, se puede llamar a funciones en paralelo
cuando también hay herramientas integradas disponibles. Las herramientas
integradas no pueden incluirse en un lote de llamadas a funciones en paralelo.
El modelo puede optar por llamar a varias funciones en un solo turno. Puedes evitarlo estableciendo parallel_tool_calls en false, lo que garantiza que se llame a una sola herramienta o a ninguna.
Nota: actualmente, si usas un modelo con ajuste fino y este llama a varias funciones en un turno, el modo estricto se desactivará para esas llamadas.
Nota sobre gpt-4.1-nano-2025-04-14: esta versión de gpt-4.1-nano a veces puede incluir varias llamadas a la misma herramienta si las llamadas a herramientas en paralelo están habilitadas. Se recomienda desactivar esta función al usar esta versión.
Modo estricto
Establecer strict en true garantiza que las llamadas a funciones cumplan de manera confiable el esquema de la función, en lugar de solo intentar cumplirlo sin garantías. Recomendamos activar siempre el modo estricto.
Internamente, el modo estricto utiliza nuestra función de resultados estructurados y, por lo tanto, introduce un par de requisitos:
additionalProperties debe establecerse en false para cada objeto de parameters.
Todos los campos de properties deben marcarse como required.
Puedes indicar que un campo es opcional agregando null como opción de type (consulta el ejemplo a continuación).
Si envías strict: true y tu esquema no cumple con los requisitos anteriores,
la solicitud se rechazará con detalles sobre las restricciones faltantes. Si
omites strict, el comportamiento predeterminado depende de la API: las solicitudes a Responses
intentarán normalizar tu esquema para usar el modo estricto cuando sea posible y recurrirán
a llamadas a funciones no estrictas, que intentan cumplir el esquema sin garantizarlo, si este no puede hacerse
compatible con el modo estricto. Cuando esto ocurra, la herramienta en la respuesta mostrará
strict: false. Las solicitudes a Chat Completions siguen siendo no estrictas de forma predeterminada. Para desactivar
el modo estricto en Responses y mantener las llamadas a funciones no estrictas, que intentan cumplir el esquema sin garantizarlo,
establece explícitamente strict: false.
Modo estricto activado
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24{"type": "function","function": {"name": "get_weather","description": "Retrieves current weather for the given location.","strict": true,"parameters": {"type": "object","properties": {"location": {"type": "string","description": "City and country e.g. Bogotá, Colombia" },"units": {"type": ["string", "null"],"enum": ["celsius", "fahrenheit"],"description": "Units the temperature will be returned in." } },"required": ["location", "units"],"additionalProperties": false } }}
Modo estricto desactivado
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22{"type": "function","function": {"name": "get_weather","description": "Retrieves current weather for the given location.","parameters": {"type": "object","properties": {"location": {"type": "string","description": "City and country e.g. Bogotá, Colombia" },"units": {"type": "string","enum": ["celsius", "fahrenheit"],"description": "Units the temperature will be returned in." } },"required": ["location"], } }}
Modo estricto activado
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22{"type": "function","name": "get_weather","description": "Retrieves current weather for the given location.","strict": true,"parameters": {"type": "object","properties": {"location": {"type": "string","description": "City and country e.g. Bogotá, Colombia" },"units": {"type": ["string", "null"],"enum": ["celsius", "fahrenheit"],"description": "Units the temperature will be returned in." } },"required": ["location", "units"],"additionalProperties": false }}
Modo estricto desactivado
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20{"type": "function","name": "get_weather","description": "Retrieves current weather for the given location.","parameters": {"type": "object","properties": {"location": {"type": "string","description": "City and country e.g. Bogotá, Colombia" },"units": {"type": "string","enum": ["celsius", "fahrenheit"],"description": "Units the temperature will be returned in." } },"required": ["location"], }}
Todos los esquemas generados en el
Playground tienen el modo estricto activado.
Aunque recomendamos activar el modo estricto, tiene algunas limitaciones:
Algunas características de los esquemas JSON no son compatibles. (Consulta los esquemas compatibles.)
Específicamente para los modelos con ajuste fino:
Los esquemas pasan por un procesamiento adicional en la primera solicitud (y luego se almacenan en caché). Si tus esquemas varían entre solicitudes, esto puede generar latencias más altas.
Los esquemas se almacenan en caché para mejorar el rendimiento y no pueden acogerse a la retención cero de datos.
Streaming
El streaming permite mostrar el progreso indicando a qué función se llama mientras el modelo completa sus argumentos, e incluso mostrando los argumentos en tiempo real.
El streaming de llamadas a funciones es muy similar al de las respuestas normales: estableces stream en true y recibes fragmentos con objetos delta.
Streaming de llamadas a funciones
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40import { OpenAI } from "openai";const openai = new OpenAI();const tools = [ { type: "function", function: { name: "get_weather", description: "Get current temperature for a given location.", parameters: { type: "object", properties: { location: { type: "string", description: "City and country e.g. Bogotá, Colombia", }, }, required: ["location"], additionalProperties: false, }, strict: true, }, },];const stream = await openai.chat.completions.create({ model: "gpt-5.6", messages: [ { role: "user", content: "What's the weather like in Paris today?" }, ], tools, stream: true, store: true,});for await (const chunk of stream) { const delta = chunk.choices[0].delta; console.log(delta.tool_calls);}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36from openai import OpenAIclient = OpenAI()tools = [ {"type": "function","function": {"name": "get_weather","description": "Get current temperature for a given location.","parameters": {"type": "object","properties": {"location": {"type": "string","description": "City and country e.g. Bogotá, Colombia", } },"required": ["location"],"additionalProperties": False, },"strict": True, }, }]stream = client.chat.completions.create(model="gpt-5.6",messages=[{"role": "user", "content": "What's the weather like in Paris today?"}],tools=tools,stream=True,)for chunk in stream: delta = chunk.choices[0].deltaprint(delta.tool_calls)
El streaming permite mostrar el progreso indicando qué función se llama mientras el modelo completa sus argumentos, e incluso mostrar los argumentos en tiempo real.
El streaming de llamadas a funciones es muy similar al de respuestas normales: estableces stream en true y recibes distintos objetos event.
Sin embargo, en lugar de combinar los fragmentos en una sola cadena content, los combinas en un objeto JSON arguments codificado.
Cuando el modelo llama a una o más funciones, se emite un evento de tipo response.output_item.added por cada llamada a función. Este evento contiene los siguientes campos:
Campo
Descripción
response_id
El identificador de la respuesta a la que pertenece la llamada a función
output_index
El índice del elemento de salida en la respuesta. Representa las llamadas a funciones individuales de la respuesta.
item
El elemento de llamada a función en curso que incluye los campos name, arguments y id
Después recibirás una serie de eventos de tipo response.function_call_arguments.delta que contendrán el delta del campo arguments. Estos eventos contienen los siguientes campos:
Campo
Descripción
response_id
El identificador de la respuesta a la que pertenece la llamada a función
item_id
El identificador del elemento de llamada a función al que pertenece el delta
output_index
El índice del elemento de salida en la respuesta. Representa las llamadas a funciones individuales de la respuesta.
delta
El delta del campo arguments.
El siguiente fragmento de código muestra cómo combinar los delta en un objeto tool_call final.
Cuando el modelo termine de llamar a las funciones, se emitirá un evento de tipo response.function_call_arguments.done. Este evento contiene la llamada a función completa, incluidos los siguientes campos:
Campo
Descripción
response_id
El identificador de la respuesta a la que pertenece la llamada a función
output_index
El índice del elemento de salida en la respuesta. Representa las llamadas a funciones individuales de la respuesta.
item
El elemento de llamada a función que incluye los campos name, arguments y id.
Herramientas personalizadas
Las herramientas personalizadas funcionan de forma muy similar a las herramientas de función basadas en esquemas JSON. Sin embargo, en lugar de darle al modelo instrucciones explícitas sobre la entrada que requiere tu herramienta, el modelo puede pasarle una cadena arbitraria como entrada. Esto permite evitar envolver innecesariamente una respuesta en JSON o aplicar una gramática personalizada a la respuesta (más detalles a continuación).
El siguiente ejemplo de código muestra cómo crear una herramienta personalizada que espera recibir como respuesta una cadena de texto con código Python.
Ejemplo de llamada a una herramienta personalizada
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16import OpenAI from "openai";const client = new OpenAI();const response = await client.responses.create({ model: "gpt-6-astra", input: "Use the code_exec tool to print hello world to the console.", tools: [ { type: "custom", name: "code_exec", description: "Executes arbitrary Python code.", }, ],});console.log(response.output);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16from openai import OpenAIclient = OpenAI()response = client.responses.create(model="gpt-6-astra",input="Use the code_exec tool to print hello world to the console.",tools=[ {"type": "custom","name": "code_exec","description": "Executes arbitrary Python code.", } ],)print(response.output)
Como antes, el arreglo output contendrá una llamada a herramienta generada por el modelo. La diferencia es que esta vez la entrada de la llamada a herramienta se proporciona como texto sin formato.
Una gramática libre de contexto (CFG) es un conjunto de reglas que definen cómo producir texto válido en un formato determinado. Para las herramientas personalizadas, puedes proporcionar una CFG que restrinja el texto que el modelo envía como entrada a una herramienta personalizada.
Puedes proporcionar una CFG personalizada mediante el parámetro grammar al configurar una herramienta personalizada. Actualmente, admitimos dos formas de sintaxis de CFG para definir gramáticas: lark y regex.
Las gramáticas se especifican mediante una variante de Lark. El muestreo del modelo se restringe mediante LLGuidance. Algunas funciones de Lark no son compatibles:
Aserciones de anticipación y retrospección en las expresiones regulares del analizador léxico
Modificadores no codiciosos (*?, +?, ??) en las expresiones regulares del analizador léxico
Prioridades de los terminales
Plantillas
Importaciones (excepto la instrucción integrada %import common)
Directivas %declare
Recomendamos usar el Lark IDE para experimentar con gramáticas personalizadas.
Limitar la complejidad de la gramática
Limita tu gramática a las reglas y los patrones que necesita tu herramienta. La API de OpenAI puede devolver un error si la gramática es demasiado compleja, por lo que debes asegurarte de que la gramática que quieres usar sea compatible antes de utilizarla en la API.
Perfeccionar las gramáticas de Lark puede ser difícil. Las gramáticas menos complejas funcionan con mayor fiabilidad, mientras que las complejas suelen requerir ajustes sucesivos en la propia definición de la gramática, el prompt y la descripción de la herramienta para garantizar que el modelo no se salga de la distribución.
NO hagas esto (dividir entre reglas o terminales). Este enfoque intenta que las reglas repartan el texto libre entre terminales. El analizador léxico buscará coincidencias de forma voraz en los fragmentos de texto libre y perderás el control:
Las reglas en minúsculas no influyen en cómo se extraen los terminales de la entrada; solo lo hacen las definiciones de los terminales. Cuando necesites “texto libre entre anclas”, exprésalo como un único terminal con una gran expresión regular para que el analizador léxico lo reconozca exactamente una vez con la estructura que buscas.
Terminales y reglas
Lark usa terminales para los tokens del analizador léxico (por convención, UPPERCASE) y reglas para las producciones del analizador sintáctico (por convención, lowercase). La forma más práctica de mantenerse dentro del subconjunto admitido y evitar sorpresas es definir la gramática de forma explícita, evitar la complejidad innecesaria y usar terminales y reglas con una clara separación de responsabilidades.
El analizador léxico se ejecuta antes que el analizador sintáctico
El analizador léxico reconoce los terminales de forma voraz (prevalece la coincidencia más larga) antes de que se aplique la lógica de cualquier regla de la CFG. Si intentas “dar forma” a un terminal dividiéndolo entre varias reglas, esas reglas no pueden guiar al analizador léxico; solo pueden hacerlo las expresiones regulares de los terminales.
Prefiere un solo terminal para extraer texto de fragmentos de formato libre
Si necesitas reconocer un patrón dentro de un texto arbitrario (por ejemplo, lenguaje natural con “cualquier cosa” entre anclas), exprésalo como un solo terminal. No intentes intercalar terminales de texto libre con reglas del analizador sintáctico; el analizador léxico voraz no respetará los límites que pretendes establecer y es muy probable que el modelo se salga de la distribución.
Usa reglas para combinar tokens discretos
Las reglas son ideales para combinar terminales delimitados explícitamente (números, palabras clave, signos de puntuación) en estructuras más grandes. No son la herramienta adecuada para restringir “lo que hay entre” dos terminales.
Mantén los terminales específicos, acotados y autocontenidos
Prioriza las clases de caracteres explícitas y los cuantificadores acotados ({0,10}, en lugar de usar * sin límites en todas partes). Si necesitas “cualquier texto hasta un punto”, usa algo como /[^.\n]{0,10}*\./ en lugar de /.+\./ para evitar un crecimiento descontrolado.
Usa reglas para combinar tokens, no para controlar el funcionamiento interno de las expresiones regulares
Ejemplo de uso adecuado de reglas:
start: exprNUMBER: /[0-9]+/PLUS: "+"MINUS: "-"expr: term (("+"|"-") term)*term: NUMBER
Maneja los espacios en blanco de forma explícita
No dependas de directivas %ignore sin límites. Usar directivas de omisión sin límites puede hacer que la gramática sea demasiado compleja o que el modelo se salga de la distribución, o ambas cosas. Prefiere insertar terminales explícitos en cada lugar donde se permitan espacios en blanco.
Solución de problemas
Si la API rechaza la gramática porque es demasiado compleja, simplifica las reglas y los terminales y elimina las directivas %ignore sin límites.
Si se llama a las herramientas personalizadas con tokens inesperados, confirma que los terminales no se superpongan; revisa el comportamiento voraz del analizador léxico.
Cuando el modelo se desvía “fuera de la distribución” (esto se manifiesta en salidas excesivamente largas o repetitivas, sintácticamente válidas pero semánticamente incorrectas):
Restringe más la gramática.
Ajusta de forma iterativa el prompt (agrega unos pocos ejemplos) y la descripción de la herramienta (explica la gramática e indica al modelo que razone y se ajuste a ella).
Prueba un mayor esfuerzo de razonamiento (por ejemplo, pasa de Media a Alta).
CFG con expresiones regulares
Ejemplo de gramática libre de contexto con expresiones regulares
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import OpenAI from "openai";const client = new OpenAI();const grammar = "^(?P<month>January|February|March|April|May|June|July|August|September|October|November|December)\\s+(?P<day>\\d{1,2})(?:st|nd|rd|th)?\\s+(?P<year>\\d{4})\\s+at\\s+(?P<hour>0?[1-9]|1[0-2])(?P<ampm>AM|PM)$";const response = await client.responses.create({ model: "gpt-6-astra", input: "Use the timestamp tool to save a timestamp for August 7th 2025 at 10AM.", tools: [ { type: "custom", name: "timestamp", description: "Saves a timestamp in date + time in 24-hr format.", format: { type: "grammar", syntax: "regex", definition: grammar, }, }, ],});console.log(response.output);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23from openai import OpenAIclient = OpenAI()grammar =r"^(?P<month>January|February|March|April|May|June|July|August|September|October|November|December)\s+(?P<day>\d{1,2})(?:st|nd|rd|th)?\s+(?P<year>\d{4})\s+at\s+(?P<hour>0?[1-9]|1[0-2])(?P<ampm>AM|PM)$"response = client.responses.create(model="gpt-6-astra",input="Use the timestamp tool to save a timestamp for August 7th 2025 at 10AM.",tools=[ {"type": "custom","name": "timestamp","description": "Saves a timestamp in date + time in 24-hr format.","format": {"type": "grammar","syntax": "regex","definition": grammar, }, } ],)print(response.output)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses" "github.com/openai/openai-go/v3/shared")func main() { client := openai.NewClient() grammar := `^(?P<month>January|February|March|April|May|June|July|August|September|October|November|December)\s+(?P<day>\d{1,2})(?:st|nd|rd|th)?\s+(?P<year>\d{4})\s+at\s+(?P<hour>0?[1-9]|1[0-2])(?P<ampm>AM|PM)$` tool := responses.ToolParamOfCustom("timestamp") tool.OfCustom.Description = openai.String("Saves a timestamp in date and time format.") tool.OfCustom.Format = shared.CustomToolInputFormatParamOfGrammar(grammar, "regex") response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Input: responses.ResponseNewParamsInputUnion{OfString: openai.String("Use the timestamp tool to save a timestamp for August 7th 2025 at 10AM.")}, Tools: []responses.ToolUnionParam{tool}, }) if err != nil { panic(err) } fmt.Println(response.Output)}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.CustomToolInputFormat;import com.openai.models.responses.CustomTool;import com.openai.models.responses.ResponseCreateParams;String grammar = "^(January|February|March|April|May|June|July|August|September|October|November|December) " + "\\d{1,2}(st|nd|rd|th)? \\d{4} at (0?[1-9]|1[0-2])(AM|PM)$";ResponseCreateParams params = ResponseCreateParams.builder() .model("gpt-6-astra") .input("Use timestamp to save August 7th 2025 at 10AM.") .addTool( CustomTool.builder() .name("timestamp") .description("Saves a timestamp in date and time format.") .format( CustomToolInputFormat.Grammar.builder() .syntax(CustomToolInputFormat.Grammar.Syntax.REGEX) .definition(grammar) .build()) .build()) .build();client.responses().create(params).output().forEach(System.out::println);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22require "openai"client = OpenAI::Client.newgrammar = "^(January|February|March|April|May|June|July|August|September|October|November|December) \\d{1,2}(st|nd|rd|th)? \\d{4} at (0?[1-9]|1[0-2])(AM|PM)$"response = client.responses.create( model: "gpt-6-astra", input: "Use timestamp to save August 7th 2025 at 10AM.", tools: [ { type: :custom, name: "timestamp", description: "Saves a timestamp in date and time format.", format: { type: :grammar, syntax: :regex, definition: grammar } } ])puts(response.output)
La salida de la herramienta debería ajustarse entonces a la CFG con expresiones regulares que definiste:
Algunas funciones de las expresiones regulares no son compatibles:
Aserciones de anticipación y retrospección
Modificadores no voraces (*?, +?, ??)
Conceptos clave y prácticas recomendadas
El patrón debe estar en una sola línea
Si necesitas reconocer un salto de línea en la entrada, usa la secuencia de escape \n. No uses el modo detallado o extendido, que permite que los patrones abarquen varias líneas.
Proporciona la expresión regular como una cadena que contenga solo el patrón