
OpenAI ofrece dos tipos de modelos: modelos de razonamiento (como o3 y o4-mini) y modelos GPT (como GPT-4.1). Estas familias de modelos se comportan de manera diferente.
En esta guía aprenderás:
- En qué se diferencian nuestros modelos de razonamiento de nuestros modelos GPT sin razonamiento
- Cuándo usar nuestros modelos de razonamiento
- Cómo escribir prompts eficaces para los modelos de razonamiento
Conoce más sobre los modelos de razonamiento y cómo funcionan.
Diferencias entre los modelos de razonamiento y los modelos GPT
Los modelos de la serie o se destacan en tareas distintas de las que mejor resuelven los modelos GPT y requieren prompts diferentes. Cada familia tiene sus fortalezas. Ninguna es superior a la otra en todos los casos.
Entrenamos nuestros modelos de la serie o (“los planificadores”) para que dediquen más tiempo y esfuerzo a razonar sobre tareas complejas. Por eso son eficaces para diseñar estrategias, planificar soluciones a problemas complejos y tomar decisiones a partir de grandes volúmenes de información ambigua. También pueden ejecutar tareas con gran exactitud y precisión, lo que los hace ideales para ámbitos que, de otro modo, requerirían la intervención de un especialista, como las matemáticas, las ciencias, la ingeniería y los servicios financieros y legales.
Por su parte, nuestros modelos GPT (“los ejecutores”) tienen menor latencia, son más económicos y están diseñados para ejecutar tareas sencillas. Una aplicación podría usar modelos de la serie o para definir la estrategia con la que resolverá un problema y modelos GPT para ejecutar tareas específicas, sobre todo cuando la velocidad y el costo importan más que la exactitud absoluta.
Cómo elegir un modelo
¿Qué es lo más importante en tu caso de uso?
- Velocidad y costo → Los modelos GPT son más rápidos y suelen costar menos
- Ejecución de tareas bien definidas → Los modelos GPT resuelven bien las tareas definidas de forma explícita
- Exactitud y confiabilidad → Los modelos de la serie o toman decisiones confiables
- Resolución de problemas complejos → Los modelos de la serie o pueden abordar problemas complejos incluso cuando la información es ambigua
Si la velocidad y el costo son los factores más importantes para completar tus tareas y tu caso de uso consiste en tareas sencillas y bien definidas, nuestros modelos GPT son la mejor opción para ti. En cambio, si lo más importante es la exactitud y la confiabilidad y necesitas resolver un problema muy complejo en varios pasos, probablemente te convengan nuestros modelos de la serie o.
La mayoría de los flujos de trabajo de IA combinarán ambas familias: los agentes usarán la serie o para planificar y tomar decisiones, y la serie GPT para ejecutar tareas.
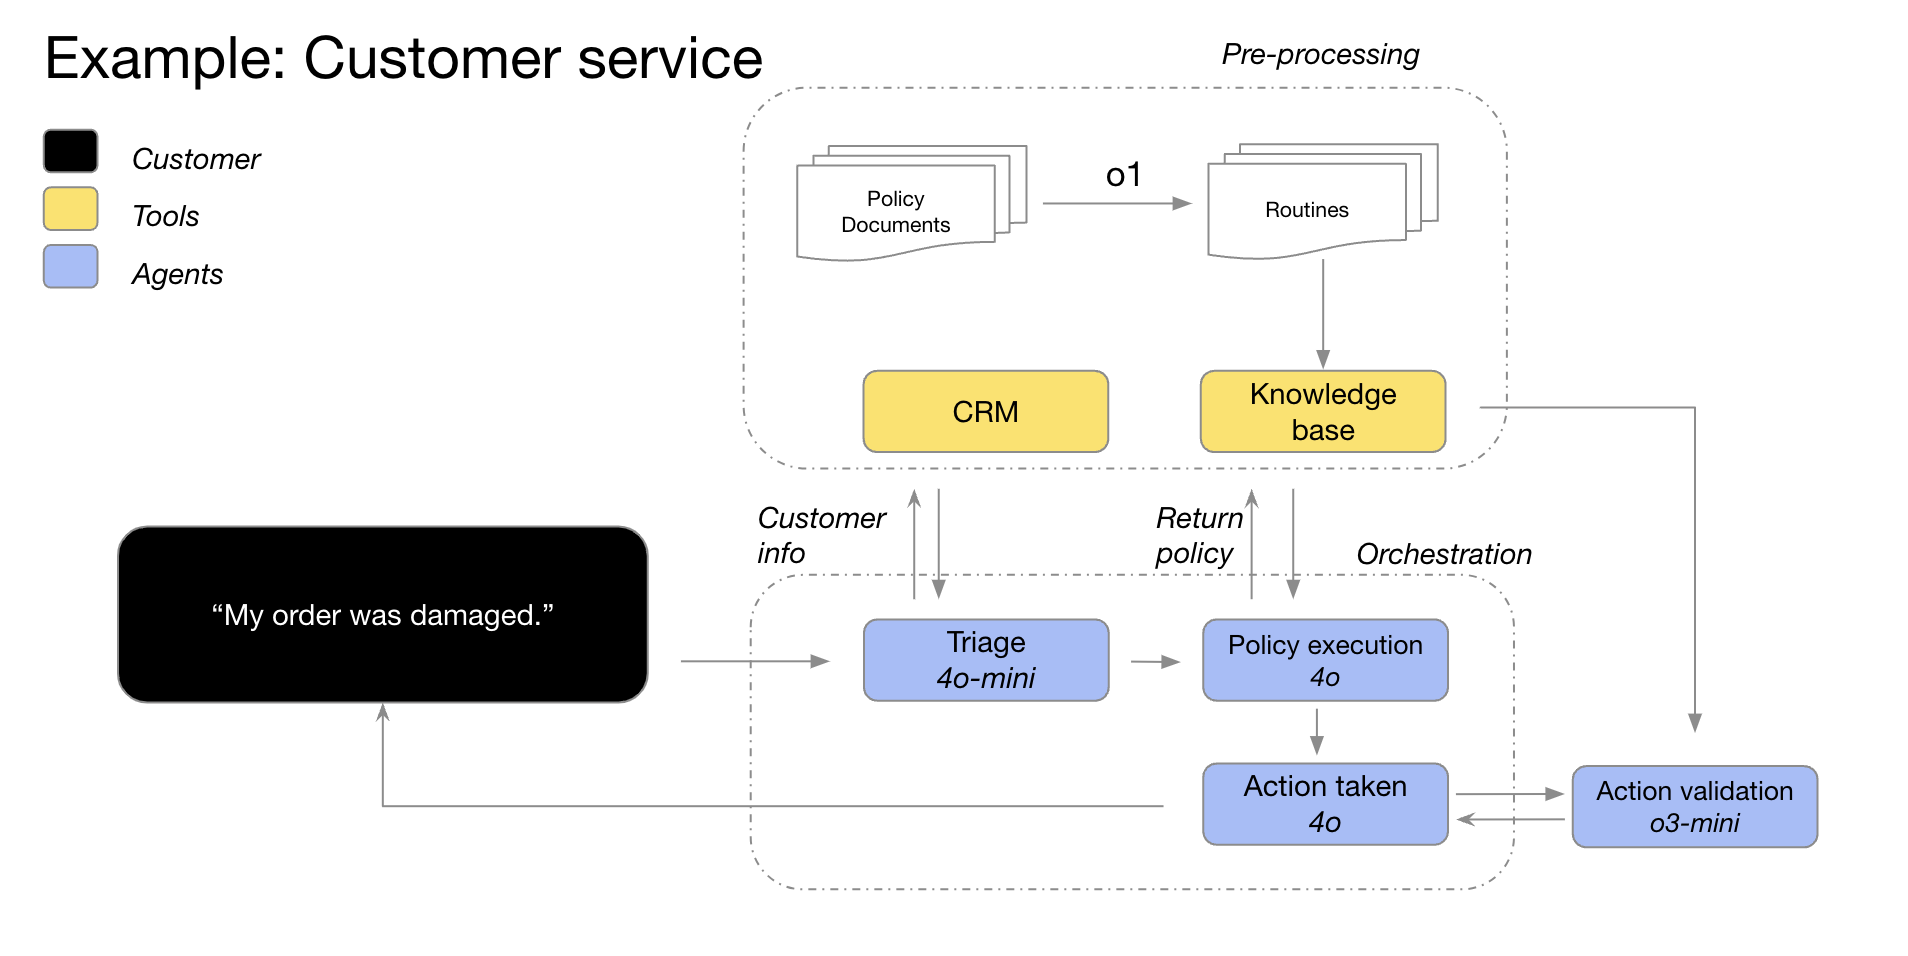
Nuestros modelos GPT-4o y GPT-4o mini clasifican los detalles del pedido a partir de la información del cliente, identifican los problemas del pedido y la política de devoluciones aplicable, y envían todos esos datos a o3-mini para que tome la decisión final sobre si procede la devolución según la política.
Cuándo usar nuestros modelos de razonamiento
Estos son algunos usos que han dado buenos resultados tanto a nuestros clientes como a los equipos de OpenAI. Los ejemplos sirven de orientación práctica para probar nuestros modelos de la serie o, aunque hay muchos otros casos de uso posibles.
¿Quieres usar un modelo de razonamiento? Ve a la guía de inicio rápido →
1. Resolver tareas ambiguas
Con un prompt sencillo, los modelos de razonamiento pueden interpretar la intención del usuario aunque la información sea escasa o esté dispersa, y abordar los vacíos en las instrucciones. De hecho, suelen pedir aclaraciones antes de hacer suposiciones sin fundamento o intentar completar la información que falta.
“Gracias a las capacidades de razonamiento de o1, nuestra plataforma multiagente Matrix genera respuestas exhaustivas, detalladas y con un formato claro al procesar documentos complejos. Por ejemplo, con un prompt básico, o1 permitió que Matrix identificara fácilmente los cupos disponibles para efectuar pagos restringidos según un contrato de crédito. Ningún modelo anterior alcanza ese nivel de rendimiento. En el 52 % de los prompts complejos sobre contratos de crédito densos, o1 obtuvo mejores resultados que otros modelos”.
—Hebbia, empresa que ofrece una plataforma de conocimiento con IA para los sectores legal y financiero
2. Encontrar una aguja en un pajar
Cuando proporcionas grandes cantidades de información no estructurada, los modelos de razonamiento son especialmente eficaces para interpretarla y extraer solo lo más relevante para responder una pregunta.
“Para analizar la adquisición de una empresa, o1 revisó decenas de documentos de la compañía, como contratos y arrendamientos, en busca de condiciones difíciles de detectar que pudieran afectar la operación. Le pedimos que señalara las condiciones clave y, al hacerlo, identificó en las notas al pie una cláusula crucial de ‘cambio de control’: si se vendía la empresa, tendría que liquidar de inmediato un préstamo de 75 millones de dólares. Gracias a la extraordinaria atención al detalle de o1, nuestros agentes de IA pueden ayudar a los profesionales de finanzas a identificar información decisiva”.
—Endex, plataforma de inteligencia financiera con IA
3. Identificar relaciones y matices en un conjunto de datos amplio
Hemos observado que los modelos de razonamiento son especialmente eficaces al analizar documentos complejos con cientos de páginas de información densa y no estructurada, como contratos, estados financieros y reclamaciones de seguros. Se destacan por encontrar correspondencias entre documentos y tomar decisiones a partir de hechos que se desprenden de los datos, aunque no estén expresados de manera explícita.
“La investigación fiscal exige sintetizar información de varios documentos para llegar a una respuesta final bien fundamentada. Sustituimos GPT-4o por o1 y descubrimos que o1 razonaba mucho mejor sobre la relación entre los documentos. Así llegó a conclusiones lógicas que no eran evidentes en ninguno de ellos por separado. Al cambiar a o1, cuadruplicamos el rendimiento de principio a fin. ¡Increíble!”
—Blue J, plataforma de IA para la investigación fiscal
Los modelos de razonamiento también saben interpretar los matices de las políticas y las reglas, y aplicarlas a la tarea en cuestión para llegar a una conclusión razonable.
“En los análisis financieros, es habitual abordar situaciones complejas que afectan al capital de los accionistas y que exigen comprender los detalles legales pertinentes. Probamos unos 10 modelos de distintos proveedores con una pregunta difícil pero frecuente: ¿cómo afecta una ronda de financiamiento a los accionistas actuales, especialmente cuando ejercen sus derechos antidilución? Para responder había que razonar sobre las valuaciones previas y posteriores a la inversión y resolver cálculos de dilución con dependencias circulares. Incluso los mejores analistas financieros tardarían entre 20 y 30 minutos en resolverlo. ¡Descubrimos que o1 y o3-mini pueden hacerlo sin errores! Los modelos incluso generaron una tabla de cálculos que mostraba con claridad el impacto para un accionista con una inversión de 100 000 dólares”.
–BlueFlame AI, plataforma de IA para la gestión de inversiones
4. Planificar tareas de varios pasos con agentes
Los modelos de razonamiento son fundamentales para que los agentes planifiquen y desarrollen estrategias. Hemos obtenido buenos resultados al usar un modelo de razonamiento como “planificador”: elabora una solución detallada en varios pasos y luego selecciona y asigna a cada paso el modelo GPT adecuado (“el ejecutor”), según se dé prioridad a la capacidad del modelo o a una latencia baja.
“Usamos o1 como planificador en nuestra infraestructura de agentes. Dejamos que coordine otros modelos del flujo de trabajo para completar una tarea de varios pasos. Hemos visto que o1 es muy bueno para seleccionar tipos de datos y descomponer preguntas amplias en otras más pequeñas, lo que permite a los demás modelos concentrarse en la ejecución”.
—Argon AI, plataforma de conocimiento con IA para la industria farmacéutica
“o1 impulsa muchos de los flujos de trabajo con agentes de Lindy, nuestro asistente de IA para el trabajo. El modelo usa la llamada a funciones para obtener información de tu calendario o correo electrónico y luego puede ayudarte automáticamente a programar reuniones, enviar correos y gestionar otras tareas cotidianas. Pasamos a o1 todos los pasos en los que nuestros agentes solían tener problemas. ¡De un día para otro, los agentes empezaron a funcionar prácticamente sin errores!”
—Lindy.AI, asistente de IA para el trabajo
5. Razonamiento visual
Por el momento, o1 es el único modelo de razonamiento con capacidades de visión. Se distingue de GPT-4o porque puede interpretar incluso imágenes muy difíciles de analizar, como gráficos y tablas con una estructura ambigua o fotos de baja calidad.
“Automatizamos las revisiones de riesgos y cumplimiento de millones de productos en línea, entre ellos imitaciones de joyas de lujo, especies en peligro de extinción y sustancias controladas. GPT-4o alcanzó una exactitud del 50 % en nuestras tareas más difíciles de clasificación de imágenes. Con o1 alcanzamos un impresionante 88 % de exactitud sin modificar ninguna etapa de nuestro proceso”.
—SafetyKit, plataforma de riesgos y cumplimiento basada en IA
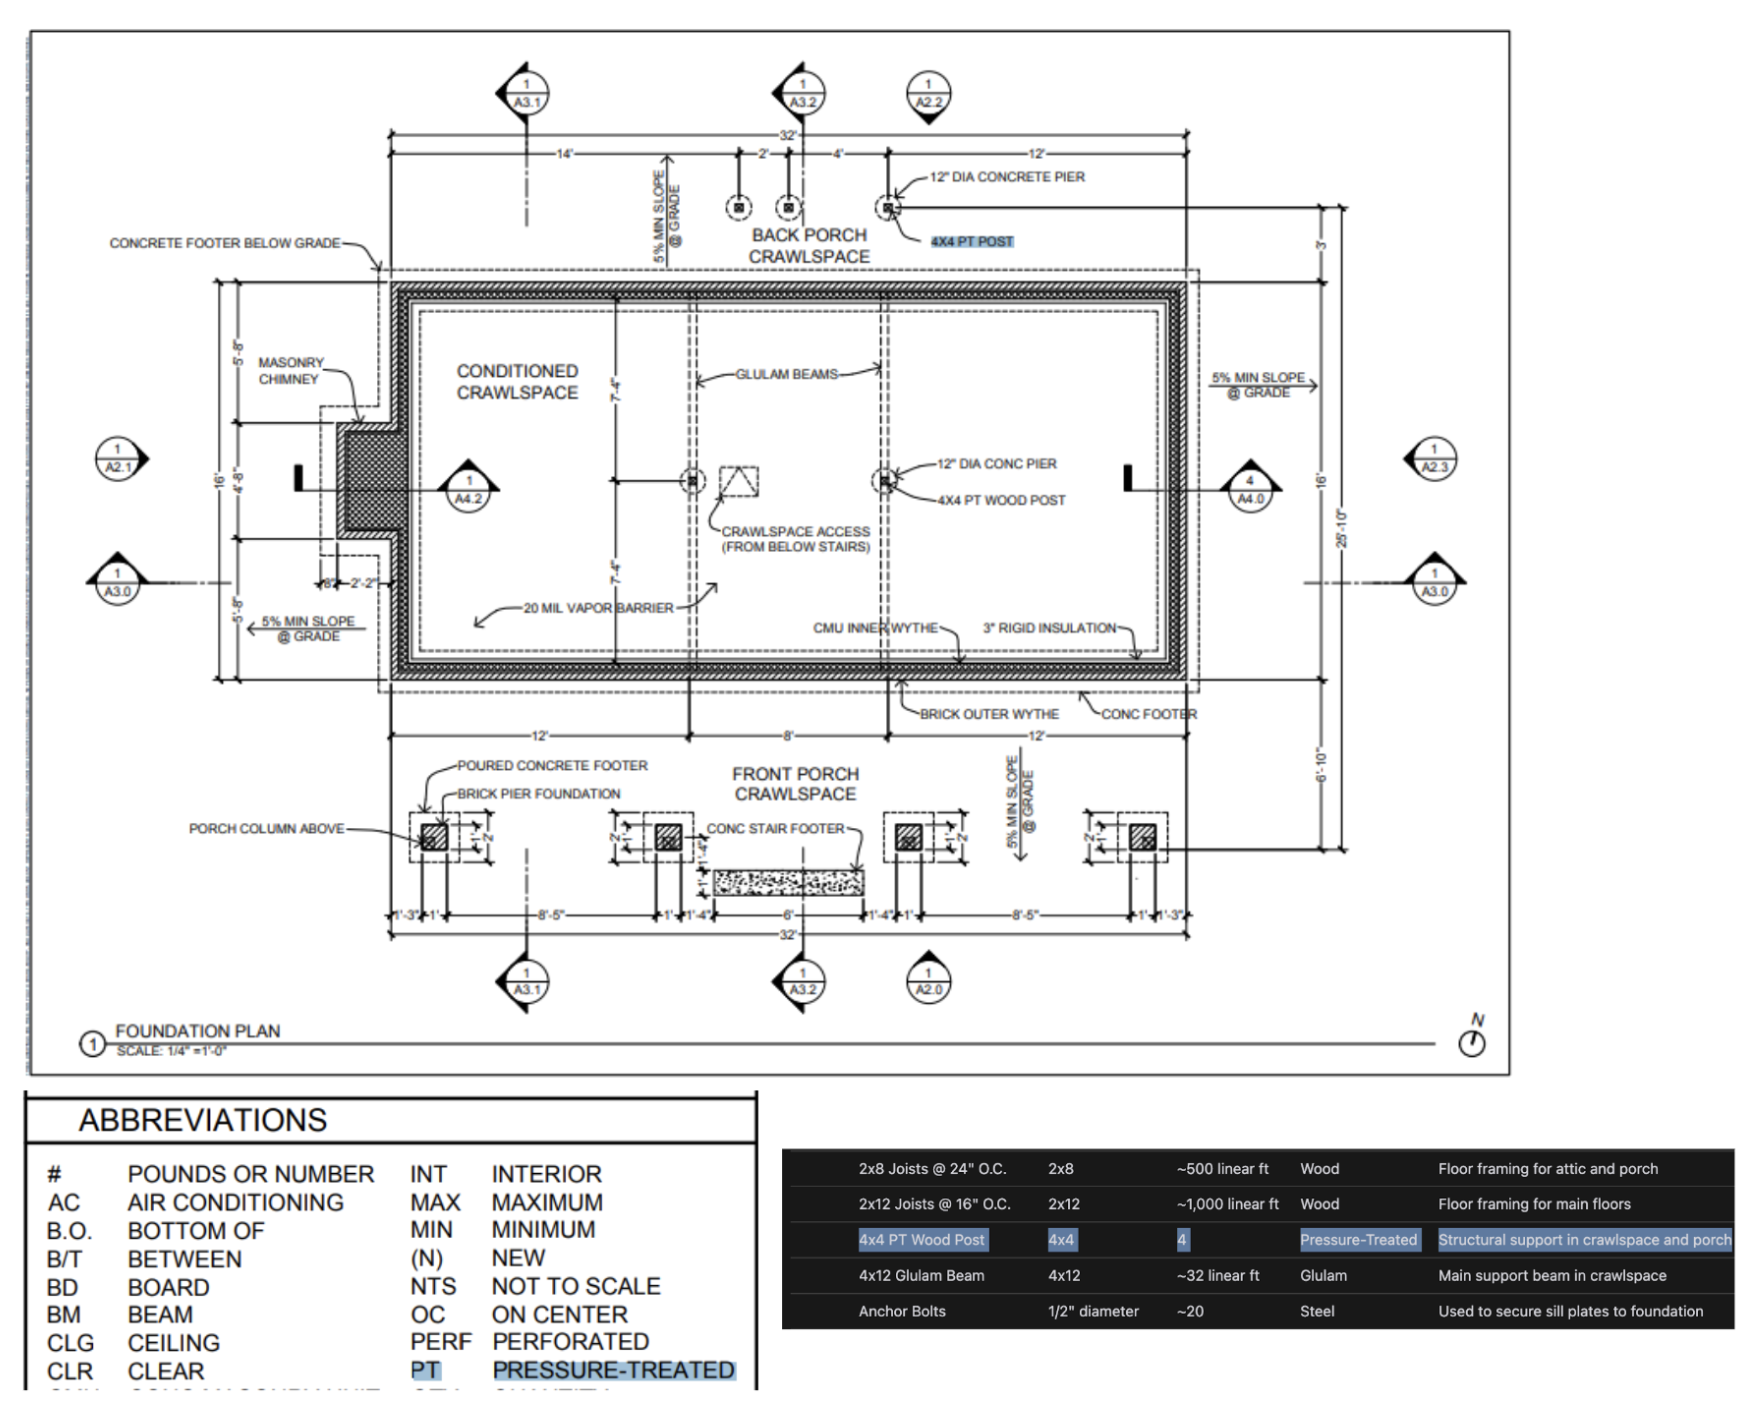
En nuestras pruebas internas, observamos que o1 puede identificar elementos fijos y materiales en planos arquitectónicos muy detallados para generar una lista completa de materiales. Nos sorprendió especialmente su capacidad para relacionar distintas imágenes: tomó la leyenda de una página de los planos y la aplicó correctamente a otra sin instrucciones explícitas. En el siguiente ejemplo, puedes ver que, en el caso de los postes de madera 4x4 PT, o1 reconoció a partir de la leyenda que “PT” indica que la madera está tratada a presión.
6. Revisar, depurar y mejorar la calidad del código
Los modelos de razonamiento son especialmente eficaces para revisar y mejorar grandes volúmenes de código. Dado que estos modelos tienen mayor latencia, las revisiones suelen ejecutarse en segundo plano.
“Ofrecemos revisiones de código automatizadas con IA en plataformas como GitHub y GitLab. Aunque la revisión de código no es en sí un proceso sensible a la latencia, sí requiere comprender los cambios en el código de varios archivos. Ahí es donde o1 se destaca: detecta de manera confiable cambios pequeños en una base de código que podrían pasarle inadvertidos a una persona. Después de adoptar los modelos de la serie o, logramos triplicar las tasas de conversión de nuestro producto”.
—CodeRabbit, startup de revisión de código con IA
Aunque GPT-4o y GPT-4o mini pueden ser más adecuados para escribir código por su menor latencia, también hemos visto que o3-mini se destaca al generar código en casos de uso algo menos sensibles a la latencia.
“o3-mini genera de forma sistemática código de alta calidad que resuelve el problema planteado. Cuando el problema está bien definido, llega con mucha frecuencia a la solución correcta, incluso en tareas de programación muy difíciles. Otros modelos quizá solo sean útiles para hacer ajustes rápidos y pequeños en el código, pero o3-mini se destaca al planificar y llevar a la práctica diseños de software complejos”.
—Windsurf, IDE colaborativo desarrollado por Codeium que utiliza IA con agentes
7. Evaluar y comparar las respuestas de otros modelos
También hemos observado que los modelos de razonamiento dan buenos resultados al evaluar y comparar las respuestas de otros modelos. La validación de datos es importante para garantizar la calidad y la confiabilidad de un conjunto de datos, especialmente en ámbitos sensibles como la atención médica. Los métodos tradicionales de validación usan reglas y patrones predefinidos. Los modelos avanzados como o1 y o3-mini, en cambio, pueden comprender el contexto y razonar sobre los datos, lo que permite validarlos de manera más flexible e inteligente.
“Muchos clientes usan un LLM como juez en su proceso de evaluación en Braintrust. Por ejemplo, una empresa de atención médica podría resumir las preguntas de los pacientes con un modelo ejecutor como gpt-4o y luego evaluar la calidad del resumen con o1. ¡Uno de nuestros clientes vio que la puntuación F1 de su juez pasó de 0,12 con 4o a 0,74 con o1! En estos casos, los clientes han comprobado que el razonamiento de o1 marca una gran diferencia al detectar matices entre las respuestas en las tareas de calificación más difíciles y complejas”.
—Braintrust, plataforma de evaluación de IA
Cómo escribir prompts eficaces para los modelos de razonamiento
Estos modelos funcionan mejor con prompts directos. Algunas técnicas de ingeniería de prompts, como darle al modelo la instrucción “piensa paso a paso”, pueden no mejorar su rendimiento y, en ocasiones, incluso perjudicarlo. Consulta las buenas prácticas que aparecen a continuación o empieza con estos ejemplos de prompts.
- Los mensajes de desarrollador son los nuevos mensajes de sistema: a partir de
o1-2024-12-17, los modelos de razonamiento admiten mensajes de desarrollador en lugar de mensajes de sistema para ajustarse a la jerarquía de instrucciones descrita en las especificaciones del modelo. - Escribe prompts sencillos y directos: estos modelos se destacan por su capacidad para comprender instrucciones breves y claras y responder a ellas.
- Evita los prompts de cadena de pensamiento: como estos modelos razonan internamente, no hace falta incluir instrucciones como “piensa paso a paso” o “explica tu razonamiento”.
- Usa delimitadores para dar claridad: usa delimitadores como Markdown, etiquetas XML y títulos de sección para distinguir con claridad las partes de la entrada y ayudar al modelo a interpretar cada sección correctamente.
- Prueba primero sin ejemplos y, si hace falta, usa pocos ejemplos: los modelos de razonamiento suelen obtener buenos resultados sin ejemplos, así que empieza con prompts que solo incluyan instrucciones. Si tienes requisitos más complejos para la salida, puede ser útil incluir en el prompt unos pocos ejemplos de entradas y salidas deseadas. Asegúrate de que los ejemplos se ajusten fielmente a las instrucciones del prompt, ya que las discrepancias pueden producir malos resultados.
- Da indicaciones específicas: si quieres imponer límites concretos a la respuesta del modelo (por ejemplo, “propón una solución con un presupuesto inferior a 500 dólares”), indica esas restricciones de forma explícita en el prompt.
- Define con precisión tu objetivo final: en tus instrucciones, especifica los criterios que debe cumplir una buena respuesta y pide al modelo que siga razonando y refinando la respuesta hasta que cumpla esos criterios.
- Formato Markdown: a partir de
o1-2024-12-17, los modelos de razonamiento de la API evitan generar respuestas con formato Markdown. Cuando quieras una respuesta con ese formato, incluye la cadenaFormatting re-enableden la primera línea de tu mensaje de desarrollador.
Cómo mantener los costos bajos y la exactitud alta
Con la llegada de los modelos o3 y o4-mini, cambió la forma en que la API de respuestas trata los elementos de razonamiento guardados. Antes (con o1, o3-mini, o1-mini y o1-preview), la API siempre ignoraba los elementos de razonamiento en las solicitudes posteriores, incluso si figuraban entre los elementos de entrada de esas solicitudes. Con o3 y o4-mini, algunos elementos de razonamiento adyacentes a las llamadas a funciones se incluyen en el contexto del modelo para mejorar su rendimiento usando la menor cantidad posible de tokens de razonamiento.
Para obtener los mejores resultados con este cambio, te recomendamos usar la API de respuestas con el parámetro store establecido en true y pasar todos los elementos de razonamiento de las solicitudes anteriores. Para hacerlo, puedes usar previous_response_id o tomar todos los elementos de salida de una solicitud anterior y pasarlos como elementos de entrada de una nueva solicitud. OpenAI incluirá automáticamente los elementos de razonamiento pertinentes en el contexto del modelo e ignorará los demás. En casos de uso más avanzados en los que quieras controlar con mayor precisión qué entra en el contexto del modelo, te recomendamos incluir, como mínimo, todos los elementos de razonamiento que se encuentren entre la llamada a una función más reciente y el mensaje de usuario anterior. Así, cuando respondas a una llamada a una función, el modelo podrá retomar su razonamiento sin empezar de nuevo. Esto mejora el rendimiento de la llamada a funciones y reduce el consumo total de tokens.
Si usas la API para completar chats, los elementos de razonamiento nunca se incluyen en el contexto del modelo, ya que esta API no conserva el estado entre solicitudes. En casos complejos en los que los agentes realizan muchas llamadas a funciones, esto reduce ligeramente el rendimiento del modelo y aumenta el consumo de tokens de razonamiento. En los casos que no implican múltiples llamadas complejas a funciones, el rendimiento no debería disminuir, independientemente de la API que uses.
Otros recursos
Si buscas más ideas, visita el OpenAI Cookbook, donde encontrarás ejemplos de código y enlaces a recursos de terceros, o consulta estos recursos sobre nuestros modelos y sus capacidades de razonamiento: