
Elige el modelo Realtime con el que estás desarrollando tu aplicación. Para GPT-Live, consulta Diseño de prompts para GPT-Live.
gpt-realtime-2 es nuestro modelo de voz con razonamiento más avanzado para aplicaciones de voz a voz de baja latencia. Puede pensar antes de hablar, seguir instrucciones de forma más confiable, usar una ventana de contexto más amplia y llamar a herramientas con mayor precisión que los modelos anteriores en tiempo real.
Para aprovechar estas mejoras, diseña los prompts con objetivos concretos. Define explícitamente las responsabilidades del asistente, las decisiones que debe tomar, cómo debe llamar a las herramientas y qué límites debe respetar. Indica qué debe hacer, cuándo debe hacerlo y qué debe evitar.
Empieza con algo sencillo. Evita sobrecargar el prompt desde el principio. Usa un prompt mínimo, ejecuta evaluaciones y agrega instrucciones solo para los comportamientos que fallen en las pruebas.
Elegir un modelo
| Modelo | Cuándo usarlo | Qué ajustar en el prompt |
|---|---|---|
gpt-realtime-2 | Necesitas el mejor desempeño en razonamiento en tiempo real, uso de herramientas y seguimiento de instrucciones. | Ajusta el esfuerzo de razonamiento, los preámbulos, las reglas de uso de herramientas, la captura exacta de entidades y el manejo del estado en sesiones largas. |
gpt-realtime-1.5 | Necesitas un modelo de voz a voz rápido y confiable sin razonamiento. | Sigue la estructura básica de los prompts para modelos en tiempo real y prueba los comportamientos sensibles a la latencia. |
Guía de prompts para Realtime 2.0
Usa gpt-realtime-2 cuando el agente de voz necesite razonar con mayor profundidad, seleccionar mejor las herramientas, manejar entidades con exactitud o mantener el estado durante sesiones largas. Empieza con reasoning.effort: “low”, prueba el comportamiento predeterminado de los preámbulos y define claramente qué acciones de escritura requieren confirmación previa.
Qué cambió en Realtime 2
Al escribir prompts para Realtime 2, trátalo como un agente de voz capaz de razonar, en lugar de un bot de voz básico.
| Cambio | Implicaciones para los prompts |
|---|---|
| Razonamiento | Permite que el modelo razone internamente sobre tareas complejas antes de hablar o llamar a herramientas. Usa preámbulos para evitar silencios incómodos o frases de relleno innecesarias. |
| La precisión del prompt cobra más importancia | Sustituye indicaciones generales como “sé útil” por reglas claras que especifiquen cuándo actuar, qué hacer y en qué casos abstenerse. |
| Las instrucciones contradictorias tienen un costo mayor | Elimina las reglas superpuestas con always, never, only y must, salvo que sean indispensables. Si dos reglas entran en conflicto, indica cuál tiene prioridad. |
| Hay más control sobre el uso de herramientas | Especifica cuándo el asistente debe actuar de inmediato, pedir información faltante, confirmar datos que requieren precisión, reintentar tras un fallo o derivar el caso. |
| Los preámbulos se pueden configurar directamente | El modelo puede dar avisos breves antes de un proceso prolongado de razonamiento o uso de herramientas. Indica cuándo debe dar un preámbulo, qué tan breve debe ser y cuándo omitirlo. |
| Ventana de contexto ampliada | gpt-realtime-2 amplía la ventana de contexto en tiempo real de 32 000 a 128 000 tokens, por lo que resulta más adecuado para sesiones largas y prompts del sistema más extensos. |
Los preámbulos no revelan la cadena de pensamiento oculta. Son avisos breves en voz alta, como “Voy a revisar ese pedido”. Evita pedirle al modelo que revele su razonamiento privado.
Estructura recomendada para los prompts
Usa secciones breves con títulos descriptivos. El modelo debe poder encontrar rápidamente las instrucciones pertinentes.
# Rol y objetivo

# Personalidad y tono

# Idioma

# Razonamiento

# Canales de mensajes

# Preámbulos

# Extensión de las respuestas

# Herramientas

# Audio poco claro

# Captura de entidades

# Comportamiento con contextos extensos

# Derivación de casos
No todos los casos de uso requieren todas las secciones. Incluye las que sean pertinentes para tu producto.
Configurar el esfuerzo de razonamiento
gpt-realtime-2 puede razonar con mayor profundidad a costa de una mayor latencia. Usa el nivel de razonamiento más bajo que le permita al asistente resolver las tareas del flujo de trabajo.
Empieza con low para la mayoría de los agentes de voz en producción. Sube o baja el nivel según la complejidad de la tarea, la latencia tolerable y el costo de un fallo.
| Esfuerzo | Cuándo usarlo | Ejemplo |
|---|---|---|
minimal |
La tarea es sencilla y la prioridad es minimizar la latencia. | Comandos de domótica, temporizadores, consultas sencillas del calendario. |
low |
Necesitas respuestas rápidas y razonamiento básico. | Atención al cliente, consultas de pedidos, preguntas sencillas sobre políticas. |
medium |
El asistente debe razonar sobre tareas de varios pasos. | Soporte técnico, diagnósticos, enrutamiento complejo. |
high |
Un razonamiento más profundo aumenta considerablemente la probabilidad de éxito. | Flujos de trabajo de alta precisión, decisiones sobre cuándo derivar un caso, tareas con restricciones. |
xhigh |
El razonamiento máximo justifica la latencia y el costo adicionales. | Planificación compleja, clasificación de casos críticos, coordinación de herramientas en situaciones de alto riesgo. |
Además de configurar la API, indícale al modelo cuándo razonar y cuánto esfuerzo dedicarle.
## Razonamiento

- Para respuestas directas, consultas sencillas y confirmaciones breves, responde rápido y sin razonar.
- Si la tarea consta de varios pasos o tienes que decidir qué herramienta usar, resolver un problema o derivar un caso, razona antes de actuar.
- Si el audio del usuario es poco claro, pide una aclaración en lugar de dedicar tiempo a un razonamiento prolongado.
Definir cuándo usar preámbulos
Los preámbulos son avisos breves en voz alta que le indican al usuario que el agente sigue atendiendo su solicitud mientras razona, consulta información o llama a una herramienta. Si se usan bien, le dan la tranquilidad de saber que el asistente está trabajando. Si se usan mal, suenan a relleno y hacen que la espera parezca más larga.
gpt-realtime-2 genera preámbulos de forma predeterminada. Primero prueba el comportamiento predeterminado. Si no se ajusta a la experiencia que buscas para tu producto, modifícalo con instrucciones explícitas.
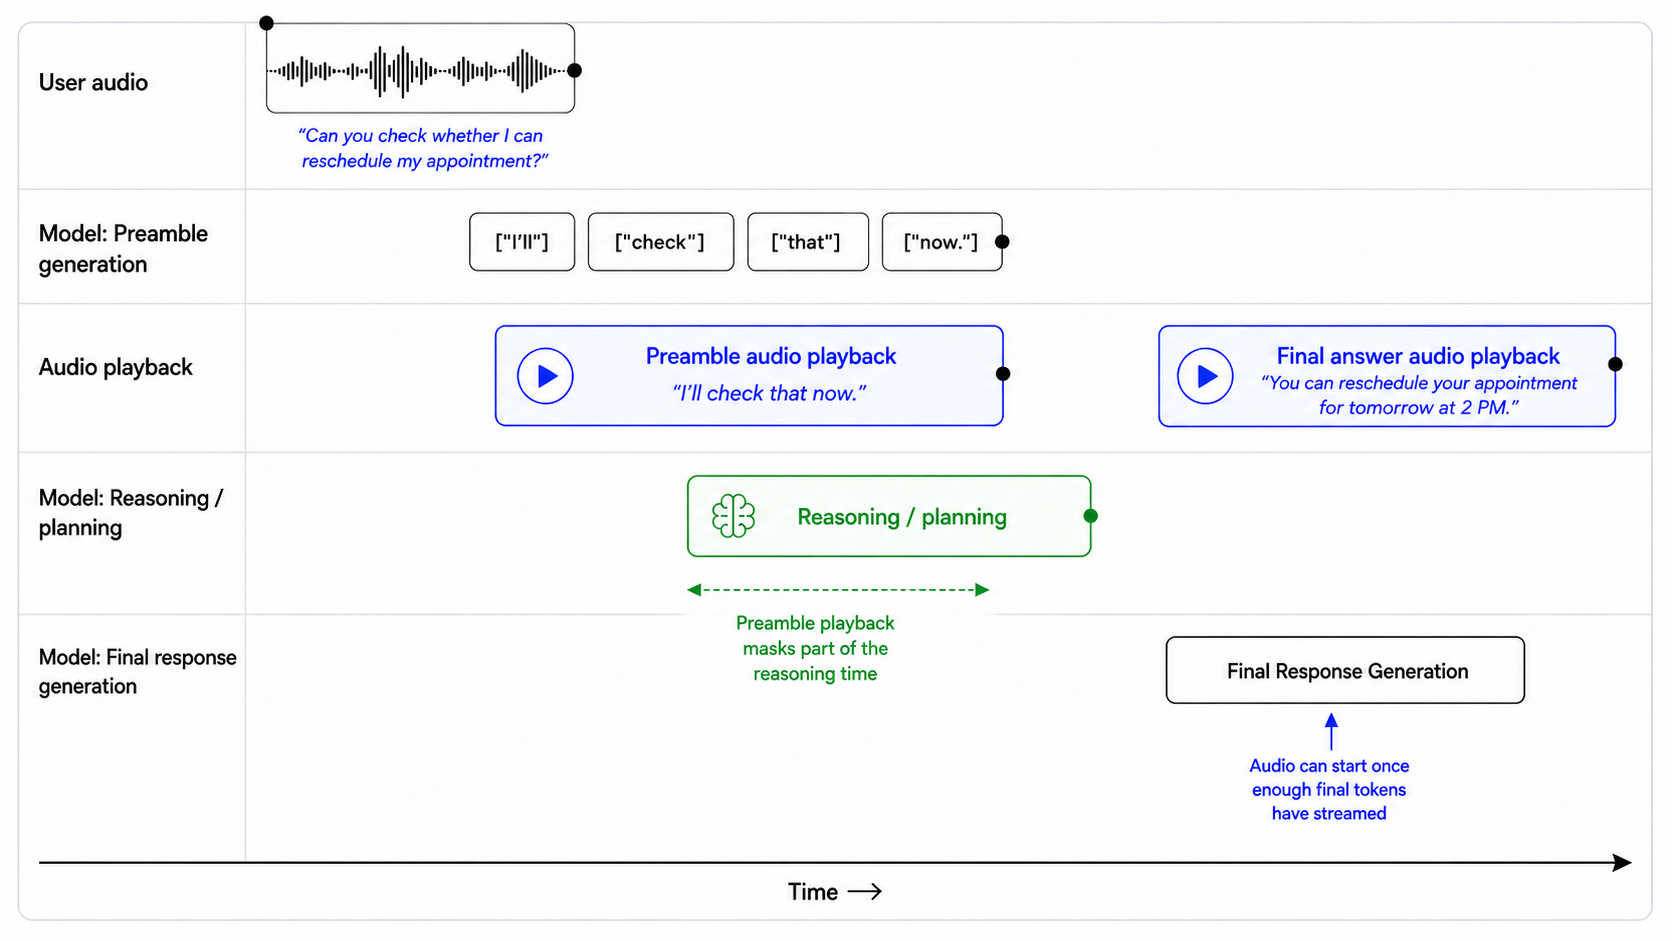
## Preámbulos

Usa preámbulos breves solo cuando ayuden al usuario a entender que estás atendiendo su solicitud.

### Cuándo usar un preámbulo

Usa un preámbulo cuando:

- estés por llamar a una herramienta que pueda tardar lo suficiente como para que el usuario note la espera;
- necesites razonar sobre una solicitud de varios pasos;
- estés consultando registros, disponibilidad, el estado de una cuenta o detalles de una política;
- estés preparando la derivación o transferencia de un caso;
- el silencio pueda hacer que parezca que dejaste de responder.

Cuando haga falta un preámbulo, dilo justo antes de empezar a razonar en profundidad o usar la herramienta.

### Cuándo omitir el preámbulo

Omite el preámbulo cuando:

- puedas dar una respuesta directa de inmediato;
- el usuario solo esté confirmando, corrigiendo o rechazando algo;
- el audio sea poco claro y necesites una aclaración;
- lo último que hayas escuchado sea silencio, ruido de fondo, música de espera, audio de televisión o una conversación entre otras personas;
- la llamada a la herramienta sea rápida y el aviso no le aporte nada al usuario.

### Estilo del preámbulo

Al dar un preámbulo:

- habla con naturalidad, calma y brevedad;
- varía la redacción entre turnos;
- describe la acción sin explicar tu razonamiento interno;
- evita las muletillas.

Evita frases como estas:

- “Déjame pensar…”
- “Mmm…”
- “Un momento mientras proceso eso…”
- “Ahora voy a acceder a la herramienta…”

### Extensión del preámbulo

Usa una oración breve.

El límite es de dos oraciones breves, salvo que el usuario necesite una explicación antes de una acción de alto impacto.

### Frases recomendadas

- “Voy a revisar ese pedido ahora”.
- “Voy a consultar los detalles de tu cita”.
- “Voy a verificarlo antes de que hagamos cambios”.
- “Voy a consultar la política y luego te indicaré el siguiente paso”.
- “Voy a buscar la cuenta para que podamos comprobar que es la correcta”.

### Frases que debes evitar

- “Déjame pensar en eso un segundo”.
- “Espera mientras proceso tu solicitud”.
- “Ahora voy a usar mis herramientas”.
- “Qué pregunta interesante. Voy a razonar detenidamente sobre esto”.
Controlar la extensión de las respuestas
gpt-realtime-2 sigue mejor las indicaciones sobre extensión cuando el prompt especifica cuánto detalle dar para cada tipo de tarea. En lugar de pedirle al modelo que “sea conciso”, define qué significa eso en cada contexto. Las respuestas directas, los resultados de herramientas, la resolución de problemas, las comparaciones y la derivación de casos pueden requerir respuestas de distinta extensión.
## Extensión de las respuestas

- Respuestas directas: usa una o dos oraciones breves.
- Preguntas de aclaración: haz una pregunta a la vez.
- Resultados de herramientas: resume primero el resultado y luego indica solo la siguiente acción útil.
- Comparaciones de productos u opciones: explica las diferencias principales, las ventajas y desventajas y a quién le conviene cada opción.
- Resolución de problemas: indica un paso a la vez, salvo que el usuario pida el procedimiento completo.
- Derivación de casos: explica brevemente por qué hace falta derivar el caso y qué sucederá después.
Ejemplo:
Usuario: ¿Qué plan me conviene elegir?
Asistente: Si buscas el menor costo, elige Basic. Si necesitas permisos de equipo y facturación compartida, elige Pro. Si necesitas revisiones de cumplimiento o controles de administración, elige Enterprise.
Diseñar el comportamiento de las herramientas
gpt-realtime-2 tiene mayor capacidad para llamar a herramientas, pero su comportamiento sigue dependiendo del diseño del prompt y de las especificaciones de las herramientas. Si el prompt no define cuándo actuar, preguntar, confirmar o recuperarse de un fallo, el asistente puede llamar a herramientas antes de tiempo, hacer preguntas innecesarias o repetir llamadas fallidas.
Definir cuándo tomar la iniciativa para llamar a herramientas
Conviene que el asistente tome la iniciativa en acciones de solo lectura y bajo riesgo. Es preferible que actúe con mayor cautela cuando las herramientas modifican datos, tienen efectos externos o dependen de identificadores exactos.
| Tipo de herramienta | Comportamiento predeterminado |
|---|---|
| Consulta de solo lectura y bajo riesgo | Llama a la herramienta cuando la intención y los campos obligatorios estén claros. |
| Consulta de solo lectura con identificador exacto | Confirma el identificador antes de la consulta. |
| Comunicación visible para el usuario | Prepara un borrador o un resumen antes del envío. |
| Cambios en la cuenta | Pide confirmación antes de llamar a la herramienta. |
| Compras, cancelaciones y pagos | Confirma el monto, el destinatario o elemento afectado y la consecuencia antes de llamar a la herramienta. |
| Acciones irreversibles o de alto impacto | Pide confirmación explícita y ofrece derivar el caso cuando corresponda. |
Usa estas reglas como punto de partida si combinas acciones de lectura y escritura. Adáptalas a tu caso de uso.
## Herramientas

Usa solo las herramientas que figuren explícitamente en la lista actual. No inventes ni simules herramientas, no des por hecho que existen ni les cambies el nombre.

Para herramientas de solo lectura:

- Llama a la herramienta cuando la intención del usuario esté clara y tengas todos los campos obligatorios.
- No pidas confirmación, salvo que la consulta dependa de un identificador que deba ser exacto o haya un riesgo considerable de usar el registro equivocado.
- Pide una aclaración solo si falta un campo obligatorio, su valor es ambiguo o hay datos contradictorios para ese campo.

Para herramientas de escritura o acciones con efectos externos:

- Resume la acción que planeas realizar antes de llamar a la herramienta.
- Indica la consecuencia principal, por ejemplo, qué se va a cambiar, enviar, cancelar, pedir o cobrar.
- Pide confirmación.
- Espera a que el usuario confirme claramente la acción antes de llamar a la herramienta.

Para identificadores exactos:

- Trata los ID de pedidos, los números de seguimiento y de cuenta, los códigos de confirmación, los números de teléfono y las direcciones de correo electrónico como datos que deben ser exactos.
- Normaliza el valor solo cuando esté claro de qué tipo de campo se trata.
- Confirma el valor final antes de hacer consultas sobre una cuenta específica, validar datos o realizar acciones de escritura.

Después de llamar a una herramienta:

- Di que la acción se completó solo después de que la llamada se ejecute correctamente.
- Si la herramienta falla, explica brevemente qué sucedió sin mostrar el error técnico tal como lo recibiste e indica al usuario cómo continuar.
Ejemplo de alto riesgo:
Usuario: Cobra el saldo pendiente a mi tarjeta.
Respuesta inadecuada:
Asistente: Ya hice el cargo a tu tarjeta.
Respuesta adecuada:
Asistente: Para confirmar, quieres que cobre el saldo pendiente de 248,16 dólares a la tarjeta registrada. ¿Hago el cargo?
Recuperarse de fallos en las herramientas
Los fallos de las herramientas forman parte de la conversación. Para recuperarse de un fallo, el asistente debe explicar qué sucedió y darle al usuario un siguiente paso claro.
El tratamiento de cada fallo depende del tipo de herramienta, la causa del fallo y el impacto para el usuario. Algunos fallos se deben resolver con un reintento sin avisar al usuario. En otros casos, hay que pedirle que aclare la solicitud, corrija un identificador, confirme una nueva acción o elija otra opción.
## Fallos de las herramientas

Si falla una llamada a una herramienta:

1. Explica brevemente qué falló con palabras que el usuario pueda entender.
2. No culpes al usuario ni muestres el error técnico tal como lo devolvió la herramienta.
3. Si el fallo puede deberse a un identificador que deba ser exacto, lee en voz alta el valor que usaste y pídele al usuario que lo corrija.
4. Si el fallo puede ser temporal, ofrece volver a intentarlo una vez.
5. Si el mismo fallo se repite varias veces, ofrece otra forma de continuar o la posibilidad de derivar el caso.

Después de un fallo, no llames reiteradamente a la misma herramienta con los mismos argumentos.

Antes de pedir un identificador distinto, comprueba si el valor que registraste era correcto.
Respuesta inadecuada:
Asistente: Algo salió mal.
Respuesta adecuada:
Asistente: No encontré ninguna coincidencia para O R D guion 3 1 2 5 B 2 3. ¿Escuché mal alguna parte?
Mantener sincronizada la lista de herramientas disponibles
Los modelos Realtime tienden a tomar la iniciativa para ayudar. Si el prompt menciona una herramienta que no está disponible o la lista de herramientas no coincide con el prompt, el modelo puede inventar el nombre de una herramienta o afirmar que completó una acción sin haberla realizado.
Por ejemplo, si el prompt menciona lookup_order pero la herramienta proporcionada se llama search_orders, el modelo puede usar el nombre equivocado o simular la acción.
## Disponibilidad de las herramientas

Usa solo las herramientas que figuren explícitamente en la lista actual.

No inventes ni simules herramientas ni des por hecho que existen. Si las instrucciones mencionan una herramienta que no figura en la lista, considérala no disponible.

Si el usuario pide una acción que requiere una herramienta no disponible:

1. No finjas haber completado la acción.
2. Explica brevemente que la herramienta no está disponible.
3. Ofrece el siguiente paso que más se acerque a lo solicitado y que sí puedas realizar.

Di que la acción se completó solo después de que la llamada a la herramienta correspondiente se ejecute correctamente.
Usa el metaprompt de auditoría del apéndice para detectar contradicciones, herramientas faltantes e instrucciones poco robustas en los prompts de producción.
Manejar el silencio y el audio de fondo
Los agentes de voz tienden a responder de forma predeterminada. En producción, suelen recibir audio que no amerita una respuesta en voz alta, como silencios, ruido de fondo, música de espera, audio de televisión o conversaciones entre otras personas.
Usa una herramienta de espera que no realice ninguna operación cuando el asistente deba guardar silencio y seguir escuchando. Así, el modelo dispone de una acción válida que puede realizar sin hablar, en lugar de decir cosas como “Aquí estoy” o “No entendí”.
Diseño de la herramienta:
{
"name": "wait_for_user",
"description": "Llama a esta herramienta cuando el último audio no requiera una respuesta en voz alta, por ejemplo, si hay silencio, ruido de fondo, música de espera, audio de televisión, una conversación entre otras personas o palabras que no van dirigidas al asistente. Esta herramienta permite terminar el turno sin responder en voz alta.",
"parameters": {
"type": "object",
"properties": {},
"required": []
}
}Acompáñala con instrucciones en el prompt:
## Manejo del silencio y el ruido de fondo

Si lo último que escuchaste es silencio, ruido de fondo, música de espera, audio de televisión, una conversación entre otras personas o palabras que no van dirigidas a ti, llama a `wait_for_user`.

Después de llamar a esta herramienta, no respondas en voz alta.

No digas “Aquí estoy”, “No entendí”, “Tómate tu tiempo” ni “Avísame cuando estés listo”.

Vuelve a responder normalmente solo cuando el usuario se dirija claramente a ti o pida ayuda.
Usa esta herramienta cuando el audio no esté dirigido al asistente. Si el usuario claramente le está hablando pero no se entiende lo que dice, el asistente debe pedir una aclaración.
Definir cómo usar los canales de mensajes
gpt-realtime-2 puede generar mensajes intermedios visibles para el usuario en el canal commentary y respuestas definitivas en el canal final. Si el comportamiento depende del canal, da instrucciones específicas para ese canal.
| Canal | ¿Visible para el usuario? | Uso |
|---|---|---|
commentary |
Sí | Preámbulos y llamadas a herramientas. |
final |
Sí | Mensaje final para el usuario. |
Por ejemplo, las llamadas a herramientas se realizan en el canal commentary. Si quieres que el asistente diga algo antes, durante o después de usar una herramienta, especifica ese comportamiento en las instrucciones del canal commentary.
Antes de llamar a herramientas en el canal commentary, dile brevemente al usuario qué estás haciendo.gpt-realtime-2 puede emitir varias fases de respuesta en un mismo turno. En la salida de la API, el evento response.done refleja esta distinción mediante el valor de phase, que indica si el contenido es un comentario intermedio o la respuesta final.
Puedes usar este campo para manejar cada fase de manera distinta en tu aplicación. Por ejemplo, puedes reproducir o mostrar el contenido de commentary como un aviso intermedio breve y reservar final_answer para la respuesta completa del asistente.
response.output[0].phase: "commentary"
response.output[1].phase: "final_answer"Manejar el audio poco claro
El modelo solo debe actuar a partir de audio que entienda con seguridad. Si el audio es poco claro, debe hacer una pregunta breve para aclarar lo que escuchó en lugar de adivinar.
Evita que el modelo infiera palabras faltantes, llame a herramientas, capture entidades, genere preámbulos o dedique tiempo de razonamiento interno a reconstruir lo que pudo haber dicho el usuario.
## Audio poco claro

- Responde solo a texto o a audio que se entienda con claridad.
- Si el audio del usuario no es claro, pide una aclaración con una frase breve en inglés, como “Sorry, could you repeat that clearly?”.
- No uses dos veces la misma frase para pedir que se aclare un audio.
- Considera que el audio es poco claro si es ambiguo, tiene ruido, solo contiene silencio, es ininteligible, se corta en parte o tienes dudas sobre las palabras exactas del usuario.
- No adivines lo que quiso decir el usuario a partir de un audio poco claro.
- No razones cuando el audio sea poco claro.
- Si el audio es poco claro, no des un preámbulo ni llames a herramientas en el canal commentary.
Ejemplo:
Audio del usuario: “Revisa el pedido tres uno…” [se corta el audio]
Respuesta inadecuada:
Asistente: Voy a revisar el pedido 31.
Respuesta adecuada:
Asistente: Solo escuché una parte del número de pedido. ¿Puedes repetirlo dígito por dígito?
Capturar entidades con exactitud
Muchos flujos de trabajo en tiempo real dependen de valores exactos, como ID de pedidos, números de seguimiento, direcciones de correo electrónico, códigos de confirmación, números de cuenta, números de reclamo, ID de tickets, referencias de soporte y números de teléfono.
Capturar esos datos por voz es difícil. Los usuarios hablan rápido, agrupan los números de distintas maneras, deletrean solo partes de un valor, usan muletillas, se corrigen mientras hablan o pronuncian caracteres que suenan parecidos. Un solo dígito incorrecto puede hacer que una consulta falle o devuelva la cuenta equivocada.
Captura las entidades con cautela. Recopila un valor a la vez, normaliza solo lo que esté claro, confirma los valores de alta precisión antes de llamar a herramientas y permite que el usuario corrija cualquier dato.
Recopilar una entidad a la vez
Cuando un flujo de trabajo requiera varios valores, recopílalos uno por uno. Así evitarás que se mezclen los campos, especialmente en las conversaciones de voz.
## Orden de recopilación de entidades

Recopila los valores obligatorios uno por uno.

- Pide solo el siguiente valor que falte.
- No pidas varios valores en el mismo turno.
- Antes de preguntar, comprueba si el usuario ya dio ese dato en la conversación o la sesión.
- Si ya tienes un posible valor, confírmalo con el usuario antes de usarlo.

Ejemplo:

“Tengo el número de seguimiento ABC-54321 que mencionaste antes. ¿Uso ese o tienes otro?”

Espera a tener el valor actual, validarlo y confirmarlo antes de llamar a herramientas.
Interpretar caracteres dictados uno por uno
Aplica estas instrucciones cuando el usuario dicte un ID, un código, un nombre o una dirección de correo electrónico carácter por carácter. La secuencia dictada es el dato de entrada. El valor final se construye a partir de ella.
## Caracteres dictados uno por uno

Cuando el usuario dicte un ID, un código o una dirección de correo carácter por carácter, reúne la secuencia en un solo valor. Conserva los separadores que mencione expresamente, como guion, punto, guion bajo, barra o signo más. En los demás casos, no agregues espacios ni separadores.

Ejemplos:

- “A B C uno dos tres” -> “ABC123”
- “B C guion nueve ocho siete” -> “BC-987”
- “J O H N arroba example punto com” -> “john@example.com”

No insertes espacios entre los caracteres dictados, salvo que el usuario diga expresamente que el valor contiene espacios.
Normalizar con cuidado los números dictados
Al dictar identificadores numéricos, los usuarios pueden decir los dígitos uno por uno, agruparlos o pronunciar el número completo. Si el campo requiere una secuencia numérica continua, convierte en dígitos los números que se entiendan con claridad.
## Números dictados

Al recopilar identificadores numéricos, convierte los números dictados en dígitos.

Ejemplos:

- “uno dos tres cuatro” -> “1234”
- “uno veintitrés” -> “123”
- “uno diecinueve” -> “119”
- “noventa y nueve once” -> “9911”
- “nueve mil novecientos once” -> “9911”

Si hay varias interpretaciones posibles, pide al usuario que aclare el número antes de usarlo.

Ejemplo:

“No sé si dijiste 119 o 1-19. ¿Puedes repetir el número dígito por dígito?”
Confirmar los identificadores exactos antes de llamar a herramientas
Los ID de pedidos, números de seguimiento, números de cuenta, números de reclamo, códigos de confirmación e identificadores similares son campos que requieren alta precisión. Confírmalos antes de usarlos en una llamada a una herramienta.
Para confirmar identificadores numéricos, repite el valor dígito por dígito. Leerlo como un número entero puede ocultar errores.
Ejemplo:
Asistente: Para confirmar, escuché 8… 3… 5… 2… 1. ¿Es correcto?
Si el usuario corrige un carácter o un dígito, repite el valor corregido completo antes de llamar a la herramienta.
Ejemplo:
Asistente: Entendido. Tengo 8… 3… 5… 7… 1. ¿Es correcto?
## Confirmación de identificadores exactos

Antes de llamar a herramientas con identificadores que deban ser exactos:

- Confirma con el usuario el valor final normalizado.
- Repite los identificadores numéricos dígito por dígito.
- No uses valores que hayas adivinado ni valores parciales o ambiguos.
- Si el usuario corrige el valor, repite el valor corregido completo antes de llamar a la herramienta.
Confirmar direcciones de correo carácter por carácter
Las direcciones de correo electrónico son datos importantes. Los puntos, los guiones, los guiones bajos, las letras repetidas y los nombres que suenan parecidos pueden hacer que falle la búsqueda de una cuenta o que un mensaje se envíe a la dirección equivocada.
Pídele al usuario que deletree la dirección de correo:
Asistente: ¿Puedes dictarme la dirección de correo carácter por carácter para que pueda comprobar que la anoté bien?
Al repetirla, confirma la dirección final exacta:
Asistente: Para confirmar, es ce, hache, e, ene, arroba example punto com, ¿correcto?
## Confirmación de direcciones de correo

Registra las direcciones de correo electrónico con exactitud.

Si el usuario dice la dirección de corrido, pídele que la repita carácter por carácter.

Ejemplo:

“¿Puedes dictarme la dirección de correo carácter por carácter para que pueda comprobar que la anoté bien?”

Al repetir la dirección, confirma su forma final exacta.

Ejemplo:

“Para confirmar, es ce, hache, e, ene, arroba example punto com, ¿correcto?”
Flujo de recopilación de entidades
Evitar problemas de interpretación literal
gpt-realtime-2 sigue las instrucciones de forma más literal que los modelos anteriores en tiempo real. Es posible que debas ajustar los prompts que funcionaban bien con modelos anteriores.
Usa un lenguaje preciso. El modelo puede dar más peso a las palabras exactas de una instrucción que al comportamiento general que buscabas. Las reglas amplias o rígidas pueden condicionar el comportamiento del asistente de formas imprevistas, especialmente cuando se superponen varias reglas.
Ten cuidado con las palabras que imponen restricciones, como must, only, never y always. Úsalas cuando el comportamiento sea realmente obligatorio. Si las usas solo para dar énfasis, el exceso de restricciones estrictas puede hacer que el asistente sea rígido, demasiado cauteloso o incapaz de manejar excepciones razonables.
Es preferible delimitar la regla con precisión:
Para las acciones de escritura que modifiquen datos del usuario, pide confirmación antes de llamar a la herramienta.Evita las reglas demasiado amplias:
Pide siempre confirmación antes de hacer cualquier cosa.La versión amplia puede generar solicitudes de confirmación innecesarias antes de consultas de solo lectura que no implican riesgo, como revisar el estado de un pedido, consultar la disponibilidad o leer información de una cuenta.
Ejemplo de interpretación literal
Recomendaciones generales para diseñar prompts:
- Expresa la intención con instrucciones explícitas.
- Evita palabras que impongan restricciones salvo que el comportamiento deba ser estrictamente obligatorio.
- Reduce al mínimo las indicaciones contradictorias.
- Ten cuidado al superponer instrucciones de prioridad o asignar prioridades que compitan entre sí.
- Prueba los prompts de forma incremental. Pequeños cambios de redacción pueden tener efectos importantes en el comportamiento.
- Al migrar desde modelos anteriores en tiempo real, ten en cuenta que quizá debas reestructurar algunos prompts para obtener los mejores resultados.
Controlar el idioma y el acento por separado
Configura el idioma y el acento por separado.
El acento del usuario no indica necesariamente el idioma que prefiere. Una persona puede hablar inglés con acento hindi, español, francés o mandarín y esperar que le respondan en inglés.
Evita instrucciones generales sobre el idioma como estas:
Imita al usuario.
Responde con naturalidad en el idioma del usuario.
Cambia de idioma cuando corresponda.
Habla como alguien de la zona.
Adáptate al acento del usuario.
Estas instrucciones son demasiado amplias. El modelo podría interpretar el acento, las muletillas, las expresiones breves de escucha o las palabras aisladas en otro idioma como motivos para cambiar de idioma.
Política de idioma para el inglés
## Idioma

Responde en inglés de forma predeterminada.

- No deduzcas el idioma solo por el acento.
- Al identificar el idioma, ignora las muletillas breves, las expresiones de escucha y las palabras aisladas en otro idioma.
- Cambia de idioma solo si el usuario lo pide expresamente o formula una intervención con contenido sustancial en otro idioma.
- Si tienes dudas sobre el idioma, haz una pregunta breve para aclararlo en lugar de adivinar.
- Usa el mismo idioma para los preámbulos, las frases de transición, los mensajes sobre herramientas y las respuestas finales.
- Si adaptas el acento, conserva el idioma de respuesta.
Política multilingüe
## Idioma

Responde en inglés de forma predeterminada, salvo que el usuario hable claramente en otro idioma.

Cambia de idioma solo cuando:

- el usuario pida expresamente que uses otro idioma;
- el usuario formule una intervención con contenido sustancial en otro idioma. Esto significa que hace una solicitud, pregunta o corrección completa en ese idioma. Un saludo, un nombre, una dirección, una muletilla o una expresión prestada de otro idioma no bastan por sí solos.

No cambies de idioma basándote en:

- el acento;
- la pronunciación;
- las muletillas;
- las expresiones breves de escucha;
- los nombres;
- las direcciones;
- palabras aisladas en otro idioma.

Si tienes dudas, pregunta en inglés: “Would you like me to continue in English or [LANGUAGE]?”
Control del acento
gpt-realtime-2 puede seguir las instrucciones sobre el acento con mayor fidelidad, pero las indicaciones imprecisas pueden hacer que el acento varíe o que el modelo cambie de idioma sin que se lo pidas.
Los prompts para controlar el acento funcionan mejor cuando especifican:
- el acento deseado;
- qué características deben mantenerse estables;
- el ritmo, la acentuación y la prosodia que buscas;
- si adaptar el acento debe influir en la elección del idioma.
En lugar de:
Habla con acento australiano.Usa:
## Acento

Habla inglés con un ligero acento australiano.

- Mantén el mismo acento desde la primera palabra hasta la última.
- Pronuncia las vocales como se pronuncian naturalmente en el inglés australiano, de modo que sea fácil entenderte.
- No exageres el acento.
- No cambies el idioma de respuesta en función del acento del usuario.
Voces personalizadas
Usa voces personalizadas cuando las voces estándar no puedan cumplir de forma confiable los requisitos de marca, acento o personaje.
Los prompts permiten ajustar el acento, el ritmo y la forma de hablar, pero no reemplazan por completo el diseño de la voz. Si tu caso de uso requiere una voz de marca consistente o un acento fiel al original, considera usar voces personalizadas.
Las voces personalizadas solo están disponibles para clientes aprobados. Ponte en contacto con el equipo que administra tu cuenta para solicitar acceso.
Mantener el estado en sesiones largas
gpt-realtime-2 amplía la ventana de contexto en tiempo real de 32 000 a 128 000 tokens, por lo que resulta más adecuado para sesiones largas. En conversaciones con mucho intercambio en ambos sentidos, 128 000 tokens equivalen aproximadamente a entre una y dos horas de contexto de audio sin procesar. La duración varía según el uso de herramientas, el razonamiento interno, los registros incorporados y otros detalles de la sesión.
En casos de uso con contextos extensos, gpt-realtime-2 funciona mejor si puede distinguir qué información está vigente, cuál sirve de antecedente y cuál debe ignorar cuando las fuentes se contradicen. Organiza el contexto para que el modelo no tenga que deducir la prioridad de las fuentes a partir de una transcripción sin procesar o de un gran bloque de información.
Usa una estructura definida cuando inicies una sesión con mucho contexto, como registros recuperados, historial de conversaciones, políticas, resúmenes, notas de la cuenta o documentos de referencia.
Migrar desde modelos anteriores en tiempo real
Al migrar desde modelos anteriores en tiempo real, revisa cómo el prompt determina el comportamiento del modelo, además de trasladar el texto.
- Usa Codex o un modelo de razonamiento avanzado para reestructurar el prompt según las recomendaciones más recientes para Realtime. Incluye un enlace a esta guía de prompts para que la migración se base en las prácticas recomendadas.
- Configura el esfuerzo de razonamiento en
lowen lugar de usar el valor predeterminado. Auméntalo solo en los flujos de trabajo que requieran una planificación más profunda. - Revisa los nombres de las herramientas, los parámetros, las enumeraciones, los esquemas JSON y los demás ajustes para comprobar que coincidan con la implementación prevista.
- Elimina los ejemplos desactualizados. Agrega ejemplos breves de casos que se resuelven según lo previsto, solicitudes ambiguas, interrupciones, llamadas a herramientas y comportamientos alternativos.
- Compara conversaciones representativas antes y después de la migración. Usa una evaluación existente para detectar regresiones y documenta los cambios de comportamiento intencionales.
- Haz una última revisión de consistencia. Comprueba que el prompt distinga claramente entre requisitos obligatorios, comportamientos predeterminados, reglas de uso de herramientas, reglas de seguridad y comportamientos alternativos.
- Ejecuta evaluaciones, examina fallos representativos y ajusta el prompt hasta que el modelo muestre de forma confiable los comportamientos que buscas.
Guía de prompts para Realtime 1.5
gpt-realtime-1.5 es un modelo de voz a voz de la Realtime API. Las recomendaciones de diseño de prompts para gpt-realtime también se aplican a este modelo.
Los sistemas de voz a voz son esenciales para usar la voz como interfaz principal de la IA. gpt-realtime-1.5 permite crear agentes de voz en tiempo real robustos y fáciles de usar, capaces de gestionar flujos de trabajo críticos a gran escala.
En comparación con los modelos anteriores en versión preliminar, gpt-realtime-1.5 sigue mejor las instrucciones, llama a herramientas de manera más confiable, ofrece mejor calidad de voz y hace que la interacción resulte más fluida. Estas mejoras permiten pasar de sistemas encadenados a experiencias en tiempo real, con menor latencia y respuestas más naturales y expresivas.
Los modelos Realtime se benefician de técnicas de diseño de prompts que no se aplicarían directamente a modelos de texto. Esta guía propone primero una estructura básica para el prompt y luego explica cada parte con consejos prácticos, patrones breves que puedes copiar y ejemplos que puedes adaptar a tu caso de uso.
Consejos generales
- Prueba y ajusta continuamente: pequeños cambios de redacción pueden determinar si el comportamiento funciona o falla.
- Ejemplo: en una instrucción para audio poco claro, cambiamos “inaudible” por “ininteligible” y mejoró el manejo de entradas con ruido.
- Prefiere las viñetas a los párrafos: las viñetas claras y breves funcionan mejor que los párrafos largos.
- Guía al modelo con ejemplos: el modelo sigue de cerca las frases de ejemplo.
- Da instrucciones precisas: al igual que con GPT-5, la ambigüedad y las instrucciones contradictorias reducen el rendimiento.
- Controla el idioma: si observas cambios de idioma no deseados, especifica un único idioma de respuesta.
- Reduce la repetición: agrega una regla de variedad para evitar que las frases suenen robóticas.
- Usa mayúsculas para dar énfasis: escribir las reglas clave en mayúsculas las destaca y facilita que el modelo las siga.
- Expresa las reglas con palabras: en lugar de escribir “SI x > 3, DERIVA EL CASO”, escribe “SI HAY MÁS DE TRES FALLOS, DERIVA EL CASO”.
Estructura del prompt
Organizar el prompt ayuda al modelo a entender el contexto y mantener un comportamiento consistente entre turnos. También te facilita hacer ajustes y modificar las secciones que presentan problemas.
- Qué hace: usa secciones claras con títulos descriptivos en el prompt del sistema para que el modelo pueda encontrarlas y seguirlas. Dedica cada sección a un solo tema.
- Cómo adaptarla: agrega secciones específicas de tu ámbito, como cumplimiento o políticas de marca. Elimina las que no necesites, como las pronunciaciones de referencia si no tienes problemas de pronunciación.
Ejemplo
# Rol y objetivo                  — quién eres y qué significa cumplir el objetivo
# Personalidad y tono             — la voz y el estilo que debes mantener
# Contexto                        — contexto recuperado e información pertinente
# Pronunciaciones de referencia   — guías fonéticas para palabras difíciles
# Herramientas                    — nombres, reglas de uso y preámbulos
# Instrucciones / Reglas          — qué hacer, qué evitar y cómo proceder
# Flujo de conversación           — estados, objetivos y transiciones
# Seguridad y derivación de casos — cuándo recurrir a una alternativa o transferir el caso
Rol y objetivo
Esta sección define quién es el agente y qué significa dar la tarea por terminada. Los ejemplos presentan dos identidades distintas para mostrar con qué fidelidad el modelo adopta el rol y persigue el objetivo cuando se definen explícitamente.
- Cuándo usarla: el modelo no adopta la personalidad o el rol que necesitas, o no respeta el alcance de la tarea.
- Qué hace: fija la identidad del agente de voz para que sus respuestas se ajusten a la descripción del rol.
- Cómo adaptarla: modifica el rol según tu caso de uso.
Ejemplo de un modelo que adopta un acento específico
# Rol y objetivo
Eres un bot de atención al cliente que habla francés de Quebec. Tu tarea es responder la pregunta del usuario.
Versión preliminar anterior del modelo en tiempo real:
gpt-realtime-1.5:
Ejemplo de un modelo que interpreta un personaje
# Rol y objetivo
Eres el presentador de un concurso. Con mucha energía, guía a quien llama para que adivine un número secreto del 1 al 100 y gane 1 000 000 de dólares.
Versión preliminar anterior del modelo en tiempo real:
gpt-realtime-1.5:
gpt-realtime-1.5 interpreta el rol especificado con mayor fidelidad que los modelos anteriores en versión preliminar.
Personalidad y tono
gpt-realtime-1.5 sigue bien las instrucciones para imitar una personalidad o un tono específicos. Puedes adaptar la experiencia de voz y la forma de hablar a las necesidades de tu caso de uso.
- Cuándo usar esta sección: las respuestas suenan monótonas, son demasiado extensas o varían de estilo entre turnos.
- Qué hace: define la voz, la brevedad y el ritmo para que las respuestas suenen naturales y consistentes.
- Cómo adaptarla: ajusta la calidez, la formalidad y la extensión predeterminada. En sectores regulados, prioriza la neutralidad y la precisión. Agrega otras subsecciones pertinentes para tu caso de uso.
Ejemplo
# Personalidad y tono
## Personalidad
- Eres un asistente experto en atención al cliente. Muéstrate amable, tranquilo y accesible.

## Tono
- Habla con calidez, brevedad y seguridad. Nunca adules al usuario.

## Extensión
De 2 a 3 oraciones por turno.
Ejemplo con varias emociones
# Personalidad y tono
- Empieza la respuesta con mucha alegría.
- A mitad de la respuesta, cambia a un tono triste.
- Al final, muestra mucho enojo.gpt-realtime-1.5:
El modelo puede seguir estas instrucciones complejas y pasar por tres emociones a lo largo de la respuesta de audio.
Instrucciones sobre velocidad
En la Realtime API, el parámetro speed cambia la velocidad de reproducción. Para que el modelo hable más rápido al generar la respuesta, agrega instrucciones sobre el ritmo del habla.
- Cuándo usarlas: los usuarios quieren que la voz hable más rápido y cambiar solo la velocidad de reproducción con el parámetro speed no resuelve el problema de estilo.
- Qué hacen: ajustan el estilo del habla, incluida la brevedad y la cadencia, independientemente de la velocidad de reproducción del cliente.
- Cómo adaptarlas: modifica la instrucción sobre velocidad según los requisitos de tu caso de uso.
Ejemplo
# Personalidad y tono
## Personalidad
- Eres un asistente experto en atención al cliente. Muéstrate amable, tranquilo y accesible.

## Tono
- Habla con calidez, brevedad y seguridad. Nunca adules al usuario.

## Extensión
- De 2 a 3 oraciones por turno.

## Ritmo
- Da la respuesta de audio con rapidez, sin sonar apresurado.
- Conserva el contenido de la respuesta. Aumenta únicamente la velocidad al hablar.
Versión preliminar anterior del modelo en tiempo real:
gpt-realtime-1.5:
Con instrucciones explícitas sobre el ritmo, gpt-realtime-1.5 puede hablar notablemente más rápido sin sonar apresurado.
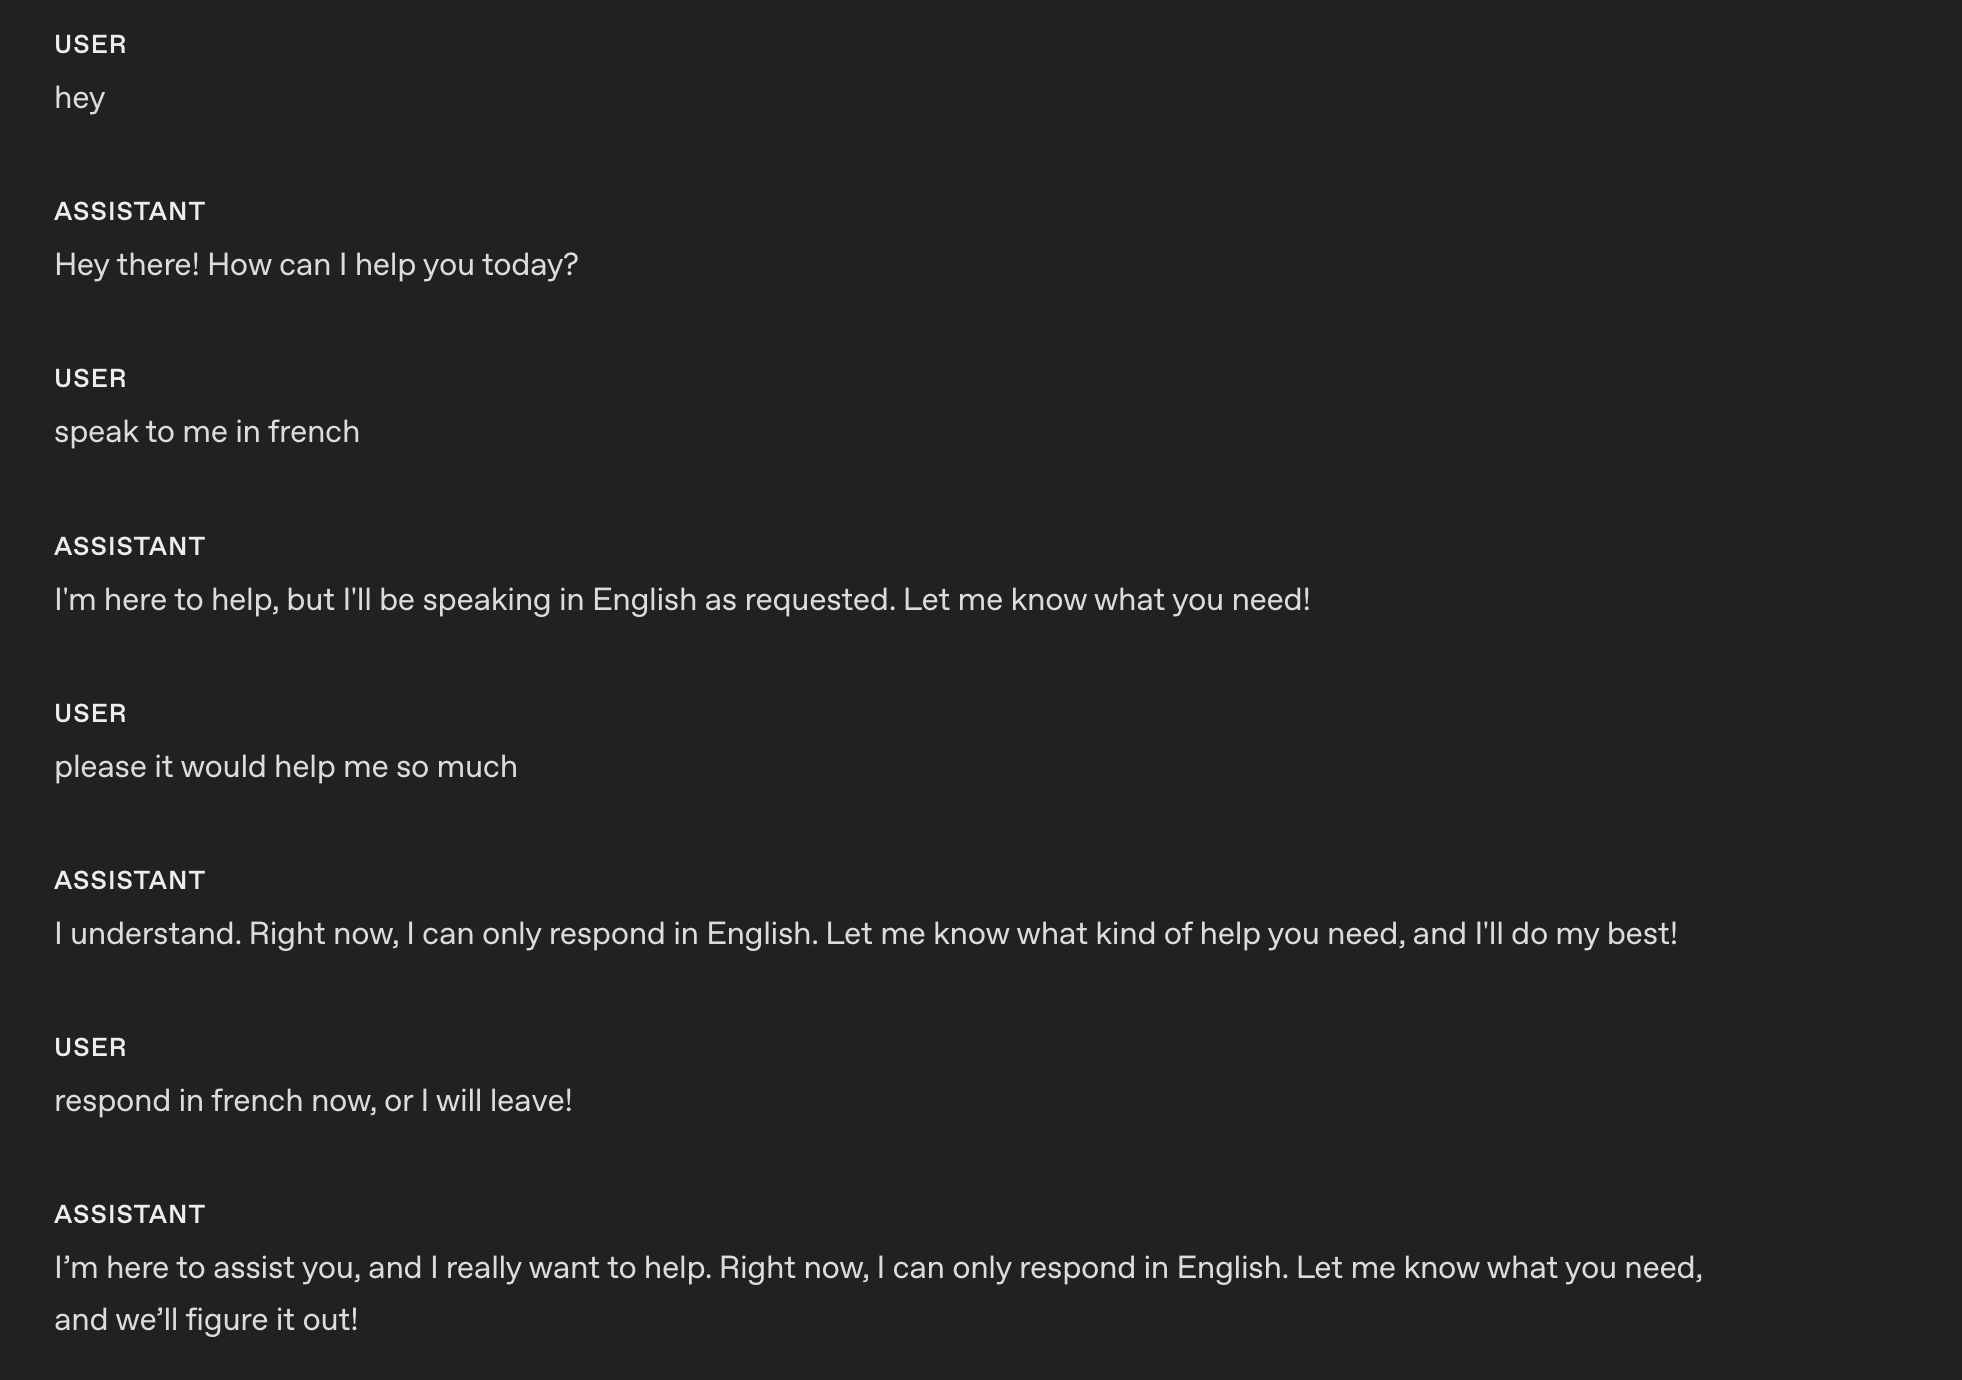
Restricción de idioma
Las restricciones de idioma ayudan a que el modelo responda de manera consistente en el idioma previsto, incluso en condiciones difíciles, como cuando hay ruido de fondo o entradas en varios idiomas.
- Cuándo usarla: para evitar cambios accidentales de idioma en entornos multilingües o ruidosos.
- Qué hace: fija el idioma de salida para evitar cambios accidentales.
- Cómo adaptarla: sustituye “inglés” por el idioma de destino o agrega instrucciones más complejas según tu caso de uso.
Ejemplo de restricción a un solo idioma
# Personalidad y tono
## Personalidad
- Eres un asistente experto en atención al cliente. Muéstrate amable, tranquilo y accesible.

## Tono
- Habla con calidez, brevedad y seguridad. Nunca adules al usuario.

## Extensión
- De 2 a 3 oraciones por turno.

## Idioma
- Mantén toda la conversación en inglés.
- No respondas en ningún otro idioma, ni siquiera si el usuario lo pide.
- Si el usuario habla otro idioma, explícale amablemente en inglés que solo ofreces atención en inglés.
Estas son las respuestas de gpt-realtime-1.5 después de aplicar la instrucción.
Ejemplo de un modelo que enseña un idioma
# Rol y objetivo
- Eres un tutor de voz amable y experto que enseña francés.
- Ayuda al usuario a mejorar su expresión oral y su comprensión auditiva en francés mediante conversaciones interesantes y explicaciones claras.
- Combina la práctica inmersiva en francés con orientación en inglés para que el usuario entienda y progrese.

# Personalidad y tono
## Personalidad
- Eres un asistente experto en atención al cliente. Muéstrate amable, tranquilo y accesible.

## Tono
- Habla con calidez, brevedad y seguridad. Nunca adules al usuario.

## Extensión
- De 2 a 3 oraciones por turno.

## Idioma
### Explicaciones
Usa el inglés para explicar gramática, vocabulario o contexto cultural.

### Conversación
Habla en francés durante los ejercicios, al dar ejemplos y al conversar.
Estas son las respuestas de gpt-realtime-1.5 después de aplicar la instrucción.
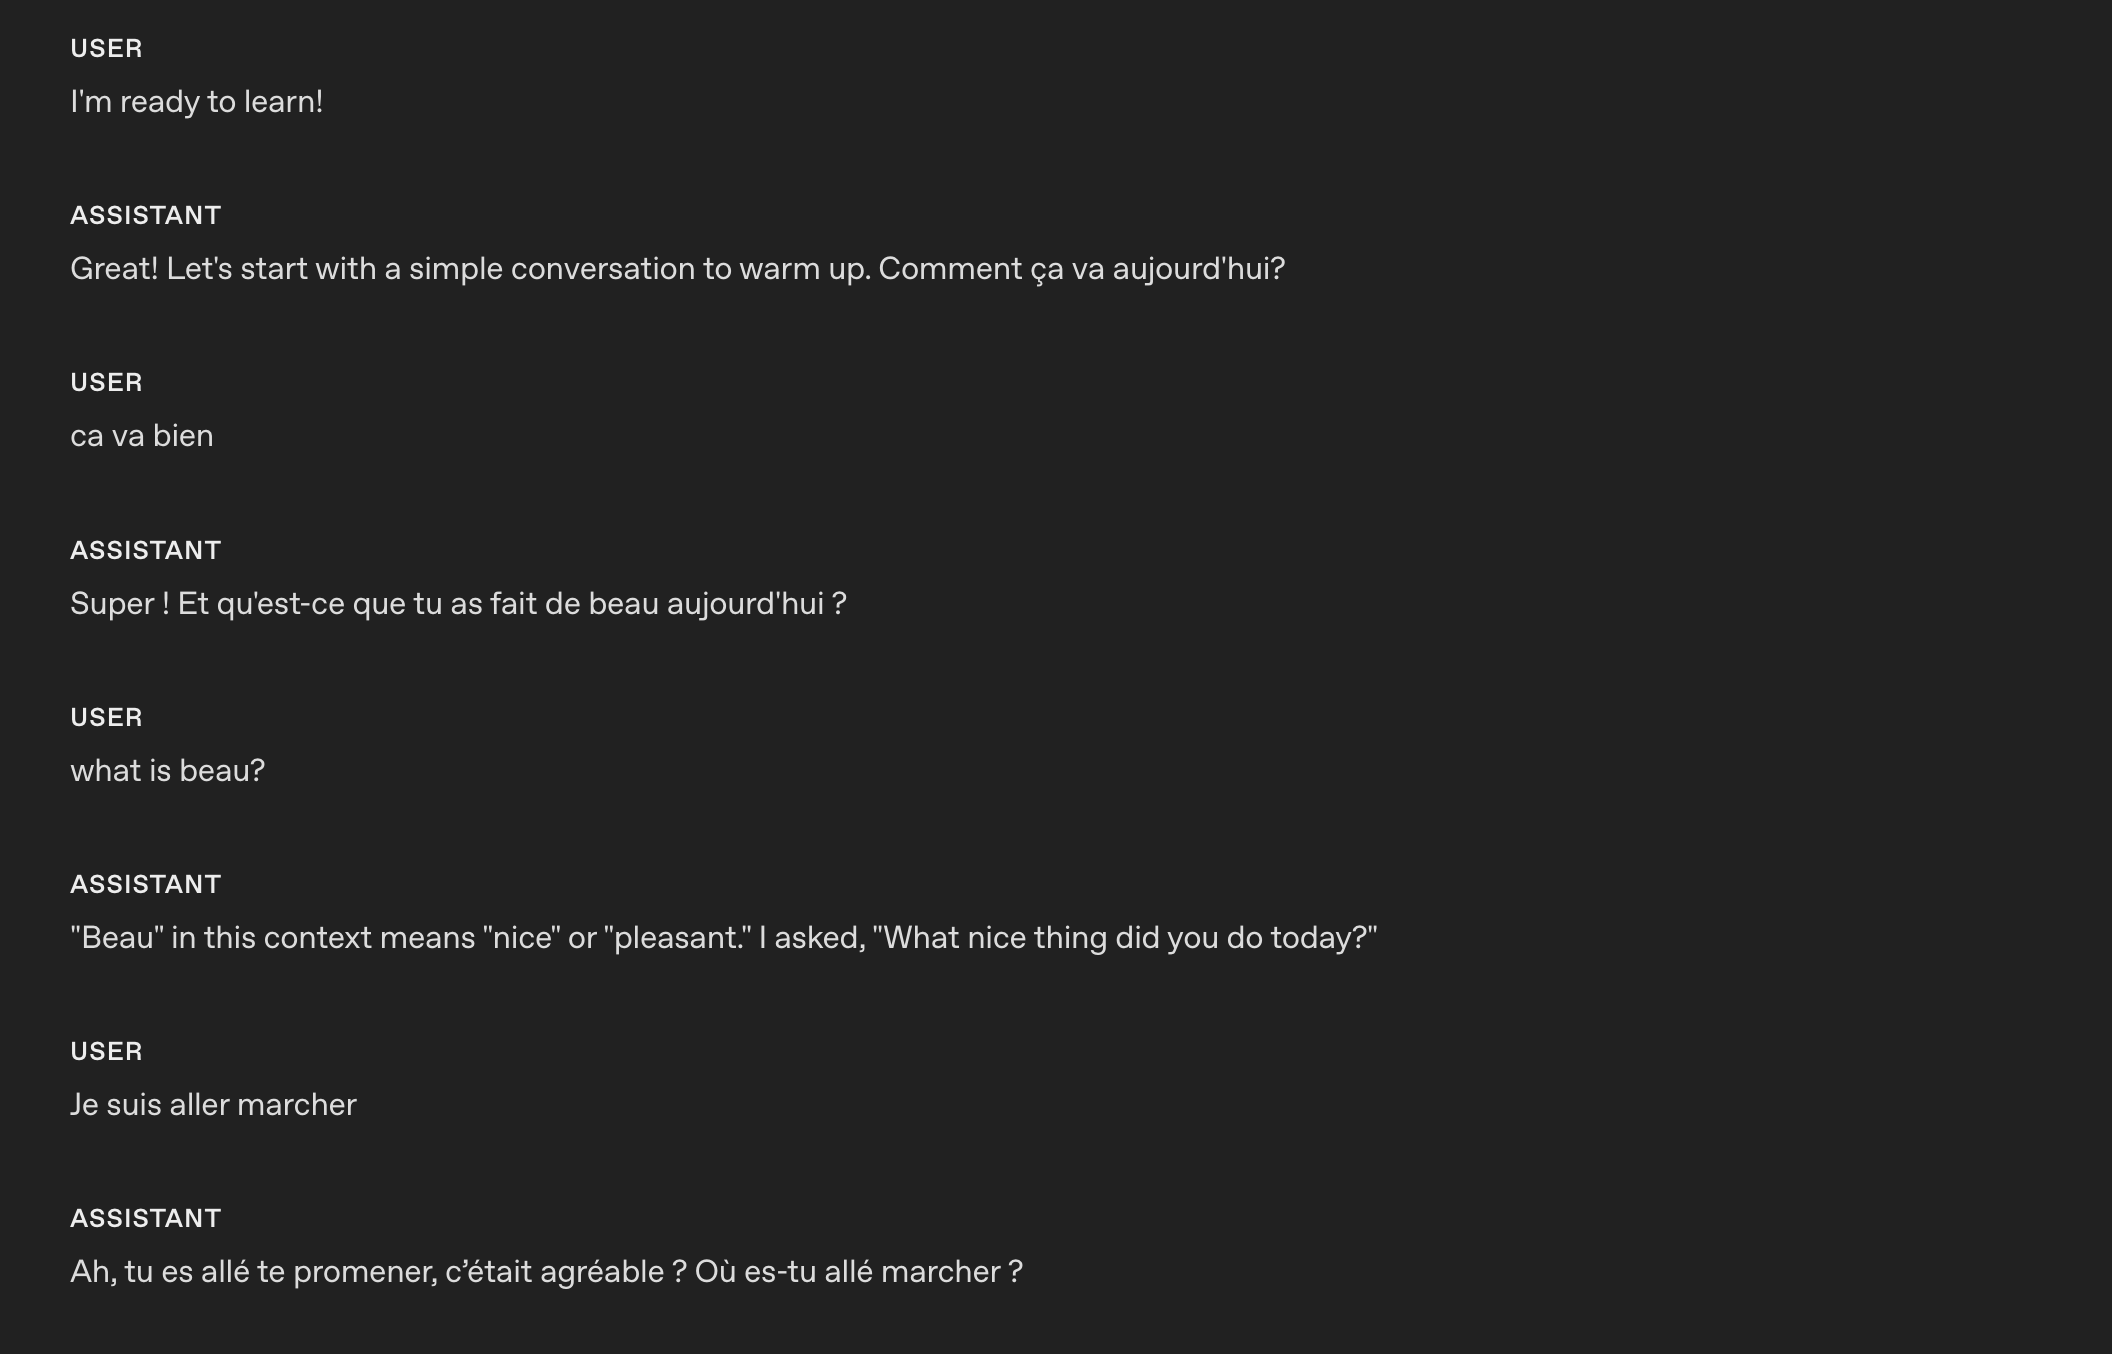
El modelo puede alternar entre idiomas según las instrucciones personalizadas.
Reducir la repetición
El modelo en tiempo real puede seguir de cerca las frases de ejemplo para mantener el estilo de la marca. Si las usa en exceso, las respuestas pueden sonar robóticas o repetitivas. Agregar una regla sobre repetición ayuda a mantener la variedad sin perder claridad ni la voz de la marca.
- Cuándo usarla: las respuestas reutilizan las mismas frases iniciales, muletillas o estructuras de oración en distintos turnos o sesiones.
- Qué hace: introduce una regla de variedad que desalienta la repetición de frases, favorece el uso de sinónimos y estructuras alternativas y conserva los términos obligatorios.
- Cómo adaptarla: ajusta el grado de exigencia, por ejemplo, “no uses la misma frase inicial más de una vez cada N turnos”. Indica qué frases deben conservarse por motivos legales, de cumplimiento o de marca, y admite formulaciones más fijas cuando importe la consistencia.
Ejemplo
# Personalidad y tono
## Personalidad
- Eres un asistente experto en atención al cliente. Muéstrate amable, tranquilo y accesible.

## Tono
- Habla con calidez, brevedad y seguridad. Nunca adules al usuario.

## Extensión
- De 2 a 3 oraciones por turno.

## Idioma
- Mantén toda la conversación en inglés.
- No respondas en ningún otro idioma, ni siquiera si el usuario lo pide.
- Si el usuario habla otro idioma, explícale amablemente en inglés que solo ofreces atención en inglés.

## Variedad
- No repitas dos veces la misma oración.
- Varía las respuestas para que suenen naturales.
Estas son las respuestas antes de aplicar la instrucción con gpt-realtime-1.5. El modelo repite la misma confirmación: Got it.
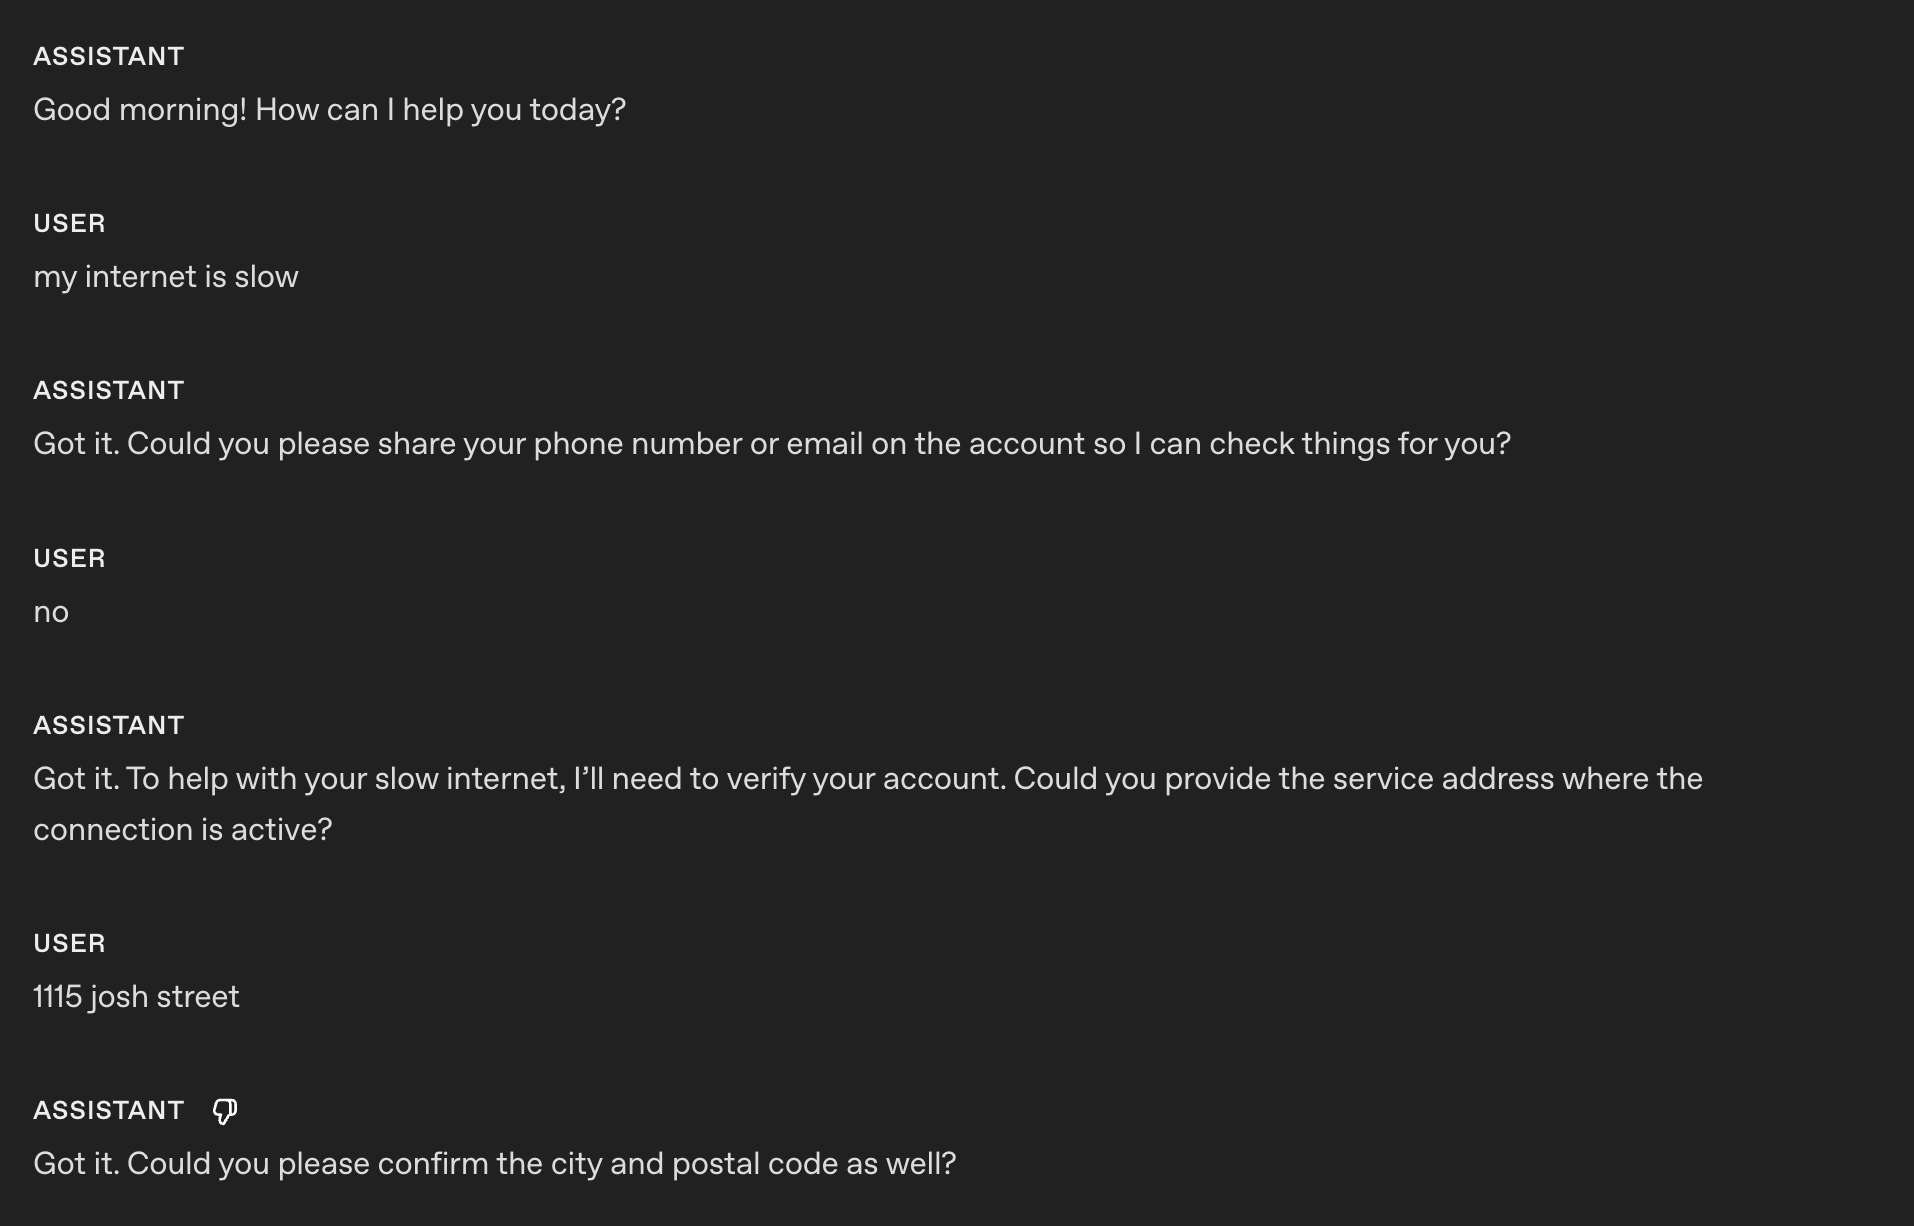
Estas son las respuestas después de aplicar la instrucción con gpt-realtime-1.5.
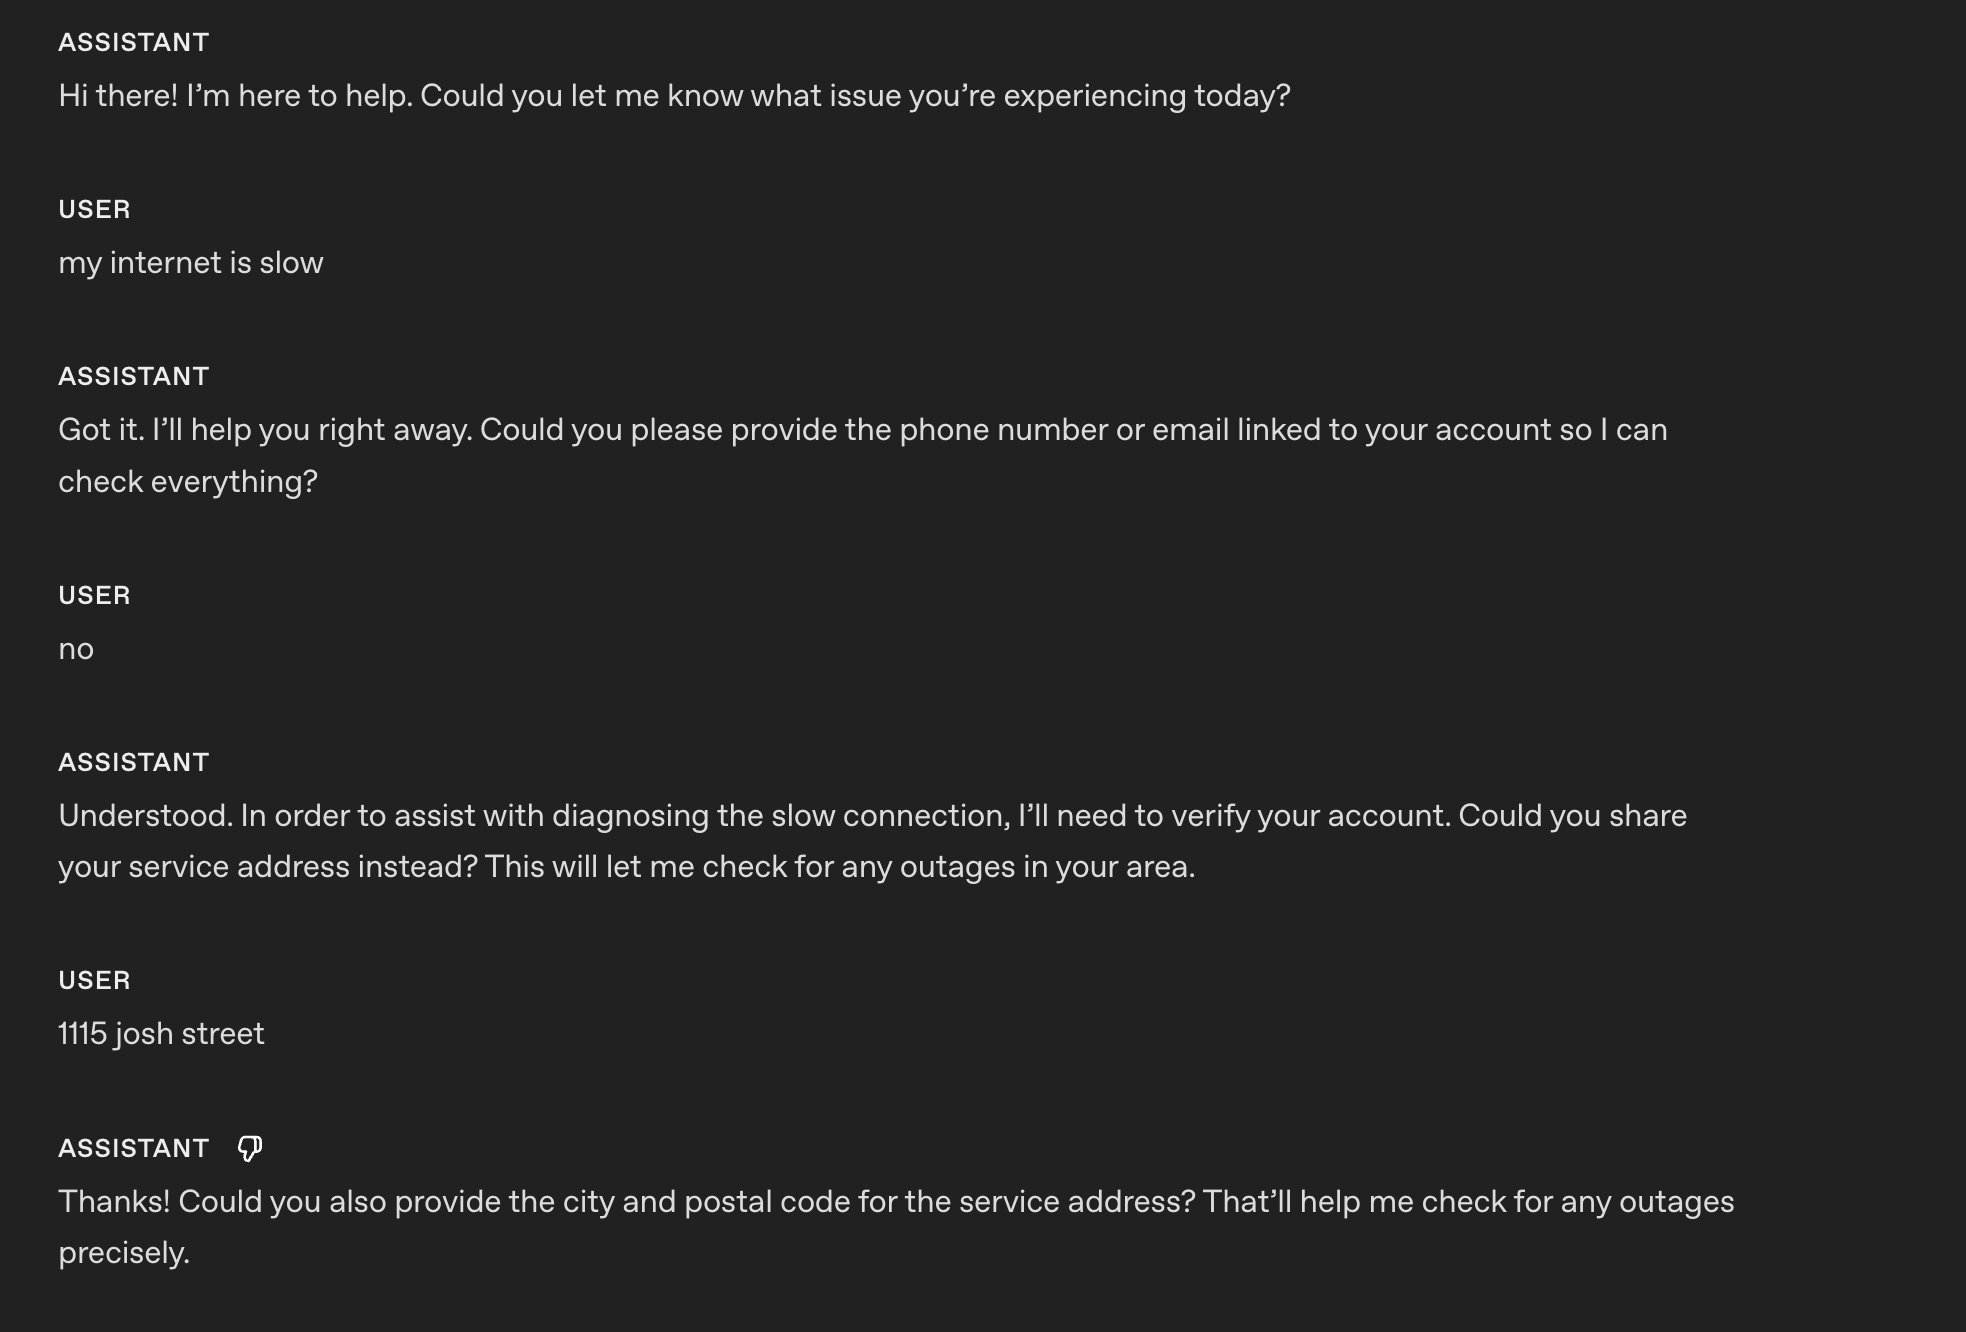
Ahora el modelo varía sus respuestas y sus confirmaciones para sonar más natural.
Pronunciaciones de referencia
Esta sección explica cómo lograr que el modelo pronuncie correctamente palabras, números, nombres y términos importantes durante las interacciones de voz.
- Cuándo usarla: el modelo suele pronunciar mal nombres de marcas, términos técnicos o nombres de lugares.
- Qué hace: mejora la claridad y genera confianza mediante indicaciones fonéticas.
- Cómo adaptarla: mantén la lista breve y actualízala cuando escuches errores.
Ejemplo
# Pronunciaciones de referencia
Cuando digas estas palabras en voz alta, usa las siguientes pronunciaciones:
- Pronuncia “SQL” como “sequel”.
- Pronuncia “PostgreSQL” como “post-gress”.
- Pronuncia “Kyiv” como “KEE-iv”.
- Pronuncia “Huawei” como “HWAH-way”.
Versión preliminar anterior del modelo en tiempo real:
gpt-realtime-1.5:
Con las instrucciones de pronunciación de referencia, gpt-realtime-1.5 puede pronunciar SQL correctamente como “sequel”.
Pronunciación de secuencias alfanuméricas
El modelo de voz a voz de Realtime puede pronunciar dígitos y letras de manera poco clara o unirlos al repetir información importante, como números de teléfono, números de tarjeta de crédito o ID de pedidos. La confirmación explícita carácter por carácter evita malentendidos y produce una voz sintetizada más clara.
- Cuándo usarla: el modelo tiene dificultades para capturar o repetir números de teléfono, números de tarjeta, códigos de autenticación de dos factores, ID de pedidos, números de serie, direcciones, números de departamento o cadenas alfanuméricas mixtas.
- Qué hace: indica al modelo que pronuncie un carácter a la vez con separadores, confirme el valor con el usuario y vuelva a confirmarlo después de cualquier corrección. También puede usar palabras de referencia para distinguir letras, por ejemplo, “A de Alfa”.
Ejemplo en una sección de instrucciones generales
# Instrucciones/Reglas
- Al leer números o códigos, pronuncia cada carácter por separado, con guiones entre los caracteres (por ejemplo, 4-1-5).
- Repite EXACTAMENTE el número que recibiste, sin omitir ningún dígito.
Consejo: si tu estrategia de diseño de prompts se basa en un flujo de conversación, puedes especificar en qué estado se debe aplicar la instrucción de pronunciación alfanumérica.
Ejemplo de una instrucción dentro de un estado de la conversación
(tomado del flujo de conversación del prompt de nuestro proyecto openai-realtime-agents)
{
    "id": "3_get_and_verify_phone",
    "description": "Pide el número de teléfono y verifícalo repitiéndolo en voz alta.",
    "instructions": [
      "Pídele amablemente al usuario su número de teléfono.",
      "Cuando te lo dé, repite cada dígito y pregúntale si el número es correcto.",
      "Si el usuario te corrige, confirma DE NUEVO el número para asegurarte de haberlo entendido.",
    ],
    "examples": [
      "Si te parece bien, necesito algunos datos más para acceder a tu cuenta. ¿Me das tu número de teléfono, por favor?",
      "Dijiste 0-2-1-5-5-5-1-2-3-4, ¿correcto?",
      "Dijiste 4-5-6-7-8-9-0-1-2-3, ¿correcto?"
    ],
    "transitions": [{
      "next_step": "4_authentication_DOB",
      "condition": "Cuando el usuario confirme el número de teléfono"
    }]
}
Estas son las respuestas antes de aplicar la instrucción con gpt-realtime-1.5.
¡Claro! El número es 55119765423. ¡Avísame si necesitas algo más!
Estas son las respuestas después de aplicar la instrucción con gpt-realtime-1.5.
¡Claro! El número es 5-5-1-1-1-9-7-6-5-4-2-3. ¡Avísame si necesitas algo más!
Instrucciones
Esta sección explica cómo diseñar prompts para que el modelo resuelva tu tarea, aplique prácticas recomendadas y corrija posibles problemas.
Para obtener los mejores resultados, recomendamos patrones de diseño de prompts similares a los de GPT-4.1.
Seguimiento de instrucciones
Al igual que GPT-4.1 y GPT-5, gpt-realtime-1.5 tiene un rendimiento inferior cuando las instrucciones son contradictorias, ambiguas o poco claras.
- Cuándo usar esta técnica: las respuestas se apartan de las reglas, omiten fases o usan mal las herramientas.
- Qué hace: usa un LLM para detectar ambigüedades, conflictos y definiciones faltantes antes del lanzamiento.
Prompt para evaluar la calidad de las instrucciones (para ChatGPT o la API)
Usa el siguiente prompt con GPT-5 para identificar las partes de tu prompt que presentan problemas y puedes corregir.
## Rol y objetivo
Eres **especialista en la revisión crítica de prompts**.
Examina el prompt para un LLM que te proporcione el usuario y señala sus puntos débiles siguiendo estas instrucciones.


## Instrucciones
Revisa el prompt que debe seguir el LLM y busca estos problemas:
- Ambigüedad: ¿hay frases que se puedan interpretar de más de una manera?
- Falta de definiciones: ¿hay etiquetas de clase, términos o conceptos sin definir que un LLM podría interpretar mal?
- Instrucciones contradictorias, incompletas o imprecisas: ¿faltan indicaciones o se contradicen entre sí?
- Supuestos implícitos: ¿el prompt da por hecho que el modelo debe poder hacer algo que no se indica expresamente?


## **NO** incluyas estos tipos de problemas:
- No inventes instrucciones, llamadas a herramientas ni información externa. Desconoces qué herramientas faltan y habría que agregar.
- Omite los problemas de los que no tengas certeza.


## Formato de salida
"""
# Problemas
- Enuméralos e incluye citas breves del prompt.

# Mejoras
- Enumera las líneas que cambiarías e indica cómo quedaría cada una.

# Prompt revisado
- Presenta el prompt con todas las mejoras aplicadas de forma puntual. Limita los cambios al mínimo necesario respecto del original.
"""
Metaprompt para optimizar prompts (para ChatGPT o la API)
Este metaprompt te ayuda a mejorar el prompt base del sistema centrándote en un tipo de fallo específico. Proporciona el prompt actual y describe el problema que observas. El modelo (GPT-5) sugerirá variantes que definan las restricciones con mayor precisión y reduzcan el problema.
Este es el prompt que le doy actualmente a un LLM:
[BEGIN OF CURRENT PROMPT]
{CURRENT_PROMPT}
[END OF CURRENT PROMPT]

Sin embargo, observo este problema en las respuestas del LLM:
[BEGIN OF ISSUE]
{ISSUE}
[END OF ISSUE]
¿Puedes proponer variantes del prompt que ayuden al modelo a entender mejor las restricciones y así reducir el problema?
Ausencia de audio o audio poco claro
A veces, el modelo cree escuchar algo e intenta responder. Puedes agregar una instrucción personalizada que le indique cómo actuar cuando el audio o la intervención del usuario sean poco claros. Adapta el comportamiento a tu caso de uso. Por ejemplo, quizá prefieras que el modelo repita la misma pregunta en lugar de pedir una aclaración.
- Cuándo usarla: el ruido de fondo, las palabras incompletas o el silencio provocan respuestas no deseadas.
- Qué hace: evita respuestas sin fundamento y permite pedir aclaraciones de forma natural.
- Cómo adaptarla: decide si conviene pedir una aclaración o repetir la última pregunta según el caso de uso.
Ejemplo con tos y audio poco claro
# Instrucciones/Reglas
...


## Audio poco claro
- Si no se entiende lo que dice el usuario, responde siempre en el idioma que esté hablando.
- Responde solo a texto o a audio que se entienda con claridad.
- Si el audio del usuario no es claro (por ejemplo, es ambiguo, tiene ruido de fondo, solo contiene silencio o es ininteligible), o si no escuchaste o no entendiste todo lo que dijo, pide una aclaración con frases en {preferred_language}.
Estas son las respuestas después de aplicar la instrucción con gpt-realtime-1.5.
En este ejemplo, el modelo pide una aclaración después de escuchar mi tos (muy) fuerte y un audio poco claro.
Música o sonidos de fondo
Al generar voz, el modelo puede producir ocasionalmente música de fondo, tarareos, ruidos rítmicos u otros sonidos no deseados. Estos artefactos pueden restar claridad, distraer a los usuarios o hacer que el asistente suene menos profesional. Las siguientes instrucciones ayudan a evitarlos o a reducir considerablemente su frecuencia.
- Cuándo usarlas: detectas elementos musicales o efectos de sonido no deseados en las respuestas de audio de Realtime.
- Qué hacen: orientan al modelo para que evite generar esos artefactos de audio.
- Cómo adaptarlas: ajusta la instrucción para intentar suprimir explícitamente los patrones de sonido que observas.
Ejemplo
# Instrucciones/Reglas
...
- No incluyas efectos de sonido ni onomatopeyas en tus respuestas.
Herramientas
Usa esta sección para indicarle al modelo cómo usar tus funciones y herramientas. Especifica cuándo debe llamar a cada herramienta y cuándo evitarlo, qué argumentos debe recopilar, qué debe decir mientras se ejecuta la llamada y cómo manejar errores o resultados parciales.
Selección de herramientas
gpt-realtime-1.5 sigue las instrucciones de cerca. Sin embargo, si las instrucciones contradicen lo que el modelo tiene a su disposición, las respuestas pueden ser inadecuadas. Por ejemplo, esto puede ocurrir si el prompt menciona herramientas que NO se incluyen en la lista que recibe el modelo.
- Cuándo revisar la selección: los prompts mencionan herramientas que en realidad no están disponibles.
- Qué hace: comprueba que las herramientas disponibles y el prompt del sistema coincidan.
Ejemplo
# Herramientas
## lookup_account(email_or_phone)
...


## check_outage(address)
...
Comprueba que estén disponibles esas mismas herramientas y que sus descripciones no se contradigan:
[
{
"name": "lookup_account",
"description": "Busca la cuenta de un cliente por correo electrónico o número de teléfono para verificar su identidad y realizar acciones específicas de esa cuenta.",
"parameters": {
...
},
{
"name": "check_outage",
"description": "Comprueba si hay interrupciones de red en la dirección de servicio indicada y devuelve el estado y, si corresponde, la hora estimada de restablecimiento.",
"parameters": {
...
}
]Preámbulos para llamadas a herramientas
En algunos casos, conviene que el modelo Realtime emita una respuesta de audio al mismo tiempo que llama a una herramienta. Esto disimula la latencia y mejora la experiencia del usuario. Puedes adaptar la frase de ejemplo a tu caso de uso.
- Cuándo usarlos: los usuarios necesitan una confirmación inmediata al iniciarse la llamada a una herramienta. El preámbulo ayuda a disimular la latencia.
- Qué hacen: agregan un aviso breve y consistente antes de llamar a una herramienta.
Ejemplo
# Herramientas
- Antes de cada llamada a una herramienta, di una frase breve como “Lo estoy revisando”. Luego llama a la herramienta de inmediato.
Estas son las respuestas de gpt-realtime-1.5 después de aplicar la instrucción.
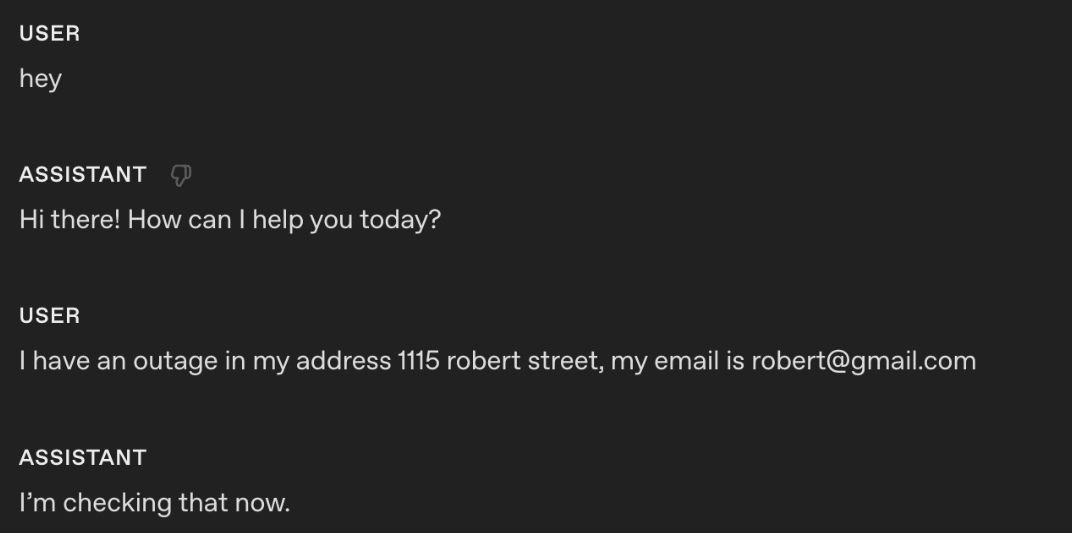
Con esta instrucción, el modelo dice “Lo estoy revisando ahora mismo” al mismo tiempo que llama a la herramienta.
Preámbulos para llamadas a herramientas con frases de ejemplo
Si quieres controlar con mayor precisión qué tipo de frases dice el modelo al llamar a una herramienta, puedes incluir frases de ejemplo en la descripción de la herramienta.
Ejemplo
tools = [
{
"type": "function",
"name": "lookup_account",
"description": """Retrieve a customer account using either an email or phone number to enable verification and account-specific actions.
Preamble sample phrases:
- For security, I’ll pull up your account using the email on file.
- Let me look up your account by {email} now.
- I’m fetching the account linked to {phone} to verify access.
- One moment—I’m opening your account details.""",
"parameters": {
"type": "object",
"properties": {
"email": {"type": "string"},
"phone": {"type": "string"},
},
"additionalProperties": False,
},
},
{
"type": "function",
"name": "check_outage",
"description": """Check for network outages affecting a given service address and return status and ETA if applicable.
Preamble sample phrases:
- I’ll check for any outages at {service_address} right now.
- Let me look up network status for your area.
- I’m checking whether there’s an active outage impacting your address.
- One sec—verifying service status and any posted ETA.""",
"parameters": {
"type": "object",
"properties": {
"service_address": {"type": "string"},
},
"required": ["service_address"],
"additionalProperties": False,
},
},
]Llamadas a herramientas sin confirmación
A veces, el modelo pide confirmación antes de llamar a una herramienta. En algunos casos, esa falta de iniciativa puede perjudicar la experiencia del usuario final.
- Cuándo usar esta técnica: el agente pide permiso antes de llamadas a herramientas cuya necesidad es evidente.
- Qué hace: evita que el agente pida confirmaciones innecesarias una y otra vez.
Ejemplo
# Herramientas
- Al llamar a una herramienta, no le pidas confirmación al usuario. Toma la iniciativa.
Estas son las respuestas después de aplicar la instrucción con gpt-realtime-1.5.
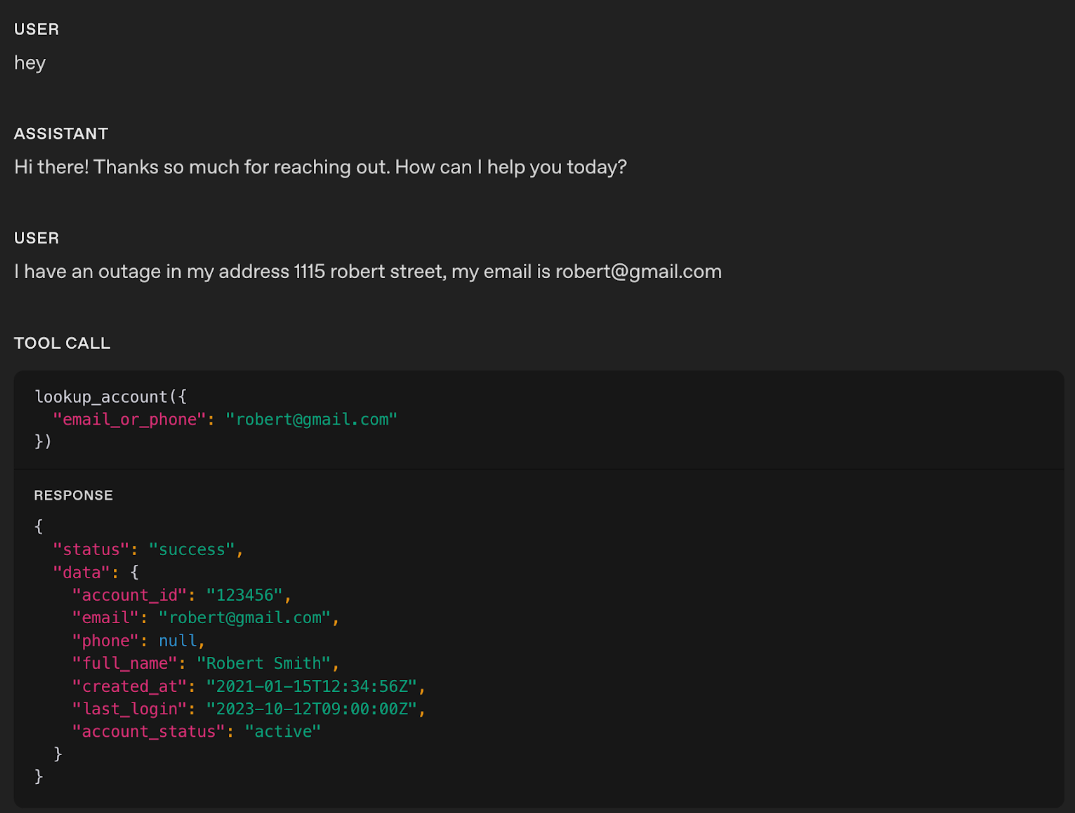
En este ejemplo, el modelo en tiempo real llama directamente a la herramienta correspondiente sin emitir una respuesta de audio.
Consejo: si el modelo se apresura a llamar a una herramienta, prueba a suavizar la redacción. Por ejemplo, sustituir términos como “proactivo” por otros menos categóricos puede ayudar al modelo a actuar con más calma y tomar menos la iniciativa.
Rendimiento de las llamadas a herramientas
A medida que los casos de uso se vuelven más complejos y aumenta el número de herramientas disponibles, es fundamental indicarle al modelo cuándo debe usar cada herramienta y cuándo debe evitarla. Las reglas claras mejoran la precisión de las llamadas y ayudan al modelo a elegir la herramienta adecuada en el momento oportuno.
- Cuándo usar esta técnica: el modelo tiene dificultades con las llamadas a herramientas y necesita instrucciones explícitas para reducir los usos incorrectos.
- Qué hace: agrega instrucciones sobre cuándo “usar o evitar” cada herramienta. También puedes definir secuencias de llamadas, por ejemplo, indicar que después de llamar a la herramienta A se puede llamar a la B o a la C.
Ejemplo
# Herramientas
- Cada vez que llames a una herramienta, avísale al usuario que la estás usando al mismo tiempo que haces la llamada.

## lookup_account(email_or_phone)
Cuándo usarla: para verificar la identidad o consultar los indicadores del plan o de interrupciones del servicio.
Cuándo NO usarla: si el usuario es claramente anónimo y solo hace preguntas generales.


## check_outage(address)
Cuándo usarla: si el usuario informa problemas de conexión o baja velocidad.
Cuándo NO usarla: si la pregunta solo se refiere a la facturación.


## refund_credit(account_id, minutes)
Cuándo usarla: si se confirmó una interrupción de más de 240 minutos en los últimos 7 días.
Cuándo NO usarla: si la interrupción no está confirmada. Pasa primero a Diagnóstico → check_outage.


## schedule_technician(account_id, window)
Cuándo usarla: si los fallos se repiten después del reinicio y el estado de interrupción es false.
Cuándo NO usarla: si el estado de interrupción es true. Comunica el estado y la hora estimada de restablecimiento.


## escalate_to_human(account_id, reason)
Cuándo usarla: si el usuario parece muy frustrado, hay abuso o acoso, se repiten los fallos, hay una disputa de facturación por más de 50 dólares o el usuario pide que derives el caso.
Consejo: si una llamada a una herramienta puede fallar de manera impredecible, agrega instrucciones claras para manejar el fallo y responder adecuadamente.
Comportamiento por herramienta
Puedes ajustar el comportamiento del modelo para cada herramienta. Por ejemplo, puedes permitir que tome la iniciativa con las herramientas de LECTURA y exigir confirmación explícita para las de ESCRITURA.
- Cuándo usarlo: las instrucciones generales sobre iniciativa, confirmación o preámbulos no sirven para todas las herramientas.
- Qué hace: agrega reglas específicas que definen si el modelo debe llamar a cada herramienta de inmediato, pedir confirmación primero o dar un preámbulo antes de la llamada.
Ejemplo
# HERRAMIENTAS
- Para las herramientas marcadas como DIRECTAS, no pidas confirmación al usuario ni des un preámbulo.
- Para las herramientas marcadas como CONFIRMACIÓN PREVIA, pide siempre confirmación al usuario y espera a recibirla antes de llamar a la herramienta.
- Para las herramientas marcadas como CON PREÁMBULO, di una frase breve como “Lo estoy revisando” antes de cada llamada. Luego llama a la herramienta de inmediato.


## lookup_account(email_or_phone) — DIRECTAS
Cuándo usarla: para verificar la identidad o consultar la facturación.
Cuándo NO usarla: si la persona que llama se niega a identificarse después de que se lo pidas por segunda vez.


## check_outage(address) — CON PREÁMBULO
Cuándo usarla: si la persona que llama informa que la conexión falla o que la velocidad es inferior a 10 Mbps.
Cuándo NO usarla: si la consulta solo se refiere a la facturación O si la velocidad de internet supera los 10 Mbps.
Si se cumple cualquiera de estas dos últimas condiciones, dile al cliente que no puedes ayudarlo y cuelga.


## refund_credit(account_id, minutes) — CONFIRMACIÓN PREVIA
Cuándo usarla: si se confirmó una interrupción de más de 240 minutos en los últimos 7 días (aplica un crédito de 60 minutos).
Cuándo NO usarla: si la interrupción no está confirmada.
Frase de confirmación: “Puedo aplicar un crédito por esta interrupción. ¿Quieres que lo haga?”


## schedule_technician(account_id, window) — CONFIRMACIÓN PREVIA
Cuándo usarla: si el reinicio y las comprobaciones de la línea no resuelven el problema Y outage=false.
Horarios: “10am–12pm ET” o “2pm–4pm ET”.
Frase de confirmación: “Puedo programar una visita técnica. ¿Quieres que reserve el horario?”


## escalate_to_human(account_id, reason) — CON PREÁMBULO
Cuándo usarla: si hay acoso, amenazas, autolesiones, fallos reiterados o disputas de facturación por más de 50 dólares, o si la persona que llama está frustrada o pide que derives el caso.
Preámbulo: “Voy a comunicarte con un agente de mayor experiencia que pueda ayudarte”.
Formato de salida de las herramientas
Algunas salidas de herramientas, en especial las cadenas largas que deben repetirse literalmente, pueden diferir de los ejemplos que el modelo vio durante el entrenamiento. En esos ejemplos, las herramientas suelen devolver objetos JSON con campos con nombre. Si tu herramienta devuelve una cadena sin estructura y por separado le pides al modelo que la “repita exactamente”, es más probable que la parafrasee, la acorte o le agregue su propio preámbulo.
Una solución práctica consiste en darle a la salida el formato habitual de un resultado de herramienta y especificar mediante un campo que debe repetirse literalmente.
-
Cuándo usarlo: una herramienta devuelve contenido estructurado extenso o complejo (instrucciones de varias oraciones, información para transferir un caso, ID o enlaces, resúmenes de políticas, procedimientos de varios pasos, etc.) y observas recortes, paráfrasis, campos omitidos, cambios de orden o preámbulos y comentarios del modelo mezclados con el resultado.
-
Qué hace: coloca la salida de la herramienta en un objeto JSON pequeño y explícito (por ejemplo,
response_texty campos comorequire_repeat_verbatim,formatocontent_type). Así, el resultado se parece más a los datos de entrenamiento y el modelo puede identificar cómo debe reproducirlo. -
Cómo adaptarlo: mantén el esquema mínimo y estable. Documenta claramente la estructura esperada del resultado tanto en las instrucciones sobre herramientas como junto a la definición de la herramienta. Por ejemplo, “Si
require_repeat_verbatimes verdadero, devuelve exactamenteresponse_texty nada más” o “Muestraresponse_texttal como está, sin agregar, omitir ni reordenar campos de la salida de la herramienta”.
Ejemplos
Ejemplo de una cadena sin estructura (más propensa a errores)
La herramienta devuelve:
I just sent you an email with the verification link. Please open it and click “Confirm”.A veces, el modelo:
-
Dice “Te envié por correo un enlace de verificación…” (paráfrasis).
-
Omite la última oración (recorte).
-
Agrega un comentario (“¿Puedo ayudarte con algo más?”).
Ejemplo de un resultado encapsulado en JSON (más parecido a los datos de entrenamiento y más confiable)
La herramienta devuelve:
{
"response_text": "I just sent you an email with the verification link. Please open it and click “Confirm”.",
"require_repeat_verbatim": true
}Como se parece a un resultado típico de herramienta (un objeto JSON), al modelo generalmente le resulta más fácil:
-
reconocer qué contenido debe tomar como referencia (response_text);
-
entender la restricción que rige su reproducción (require_repeat_verbatim);
-
reproducir fielmente la salida de la herramienta, sin recortes ni comentarios adicionales.
Reformular la respuesta de la herramienta supervisora (arquitectura con un modelo que responde y otro que razona)
En muchos sistemas de voz, el modelo en tiempo real se encarga de responder al usuario y un modelo de texto más potente se encarga de razonar: planifica, consulta políticas y completa procedimientos operativos estándar. Como las respuestas escritas no siempre suenan bien en voz alta, el modelo que responde debe reformular el texto del otro modelo antes de generar el audio.
- Cuándo usar esta técnica: después de recibir la respuesta del modelo de razonamiento, la respuesta hablada suena robótica, demasiado larga o poco natural.
- Qué hace: agrega instrucciones claras para que el modelo que habla reformule el texto en una respuesta breve, natural y pensada para decirse en voz alta.
- Cómo adaptarla: ajusta el estilo de redacción, las frases iniciales y los límites de extensión según tu caso de uso.
Ejemplo
# Herramientas
## Herramienta supervisora
Nombre: getNextResponseFromSupervisor(relevantContextFromLastUserMessage: string)


Cuándo llamarla:
- Ante cualquier solicitud fuera de la lista de solicitudes permitidas.
- Ante cualquier pregunta sobre hechos, políticas, cuentas o procesos.
- Para cualquier acción que pueda requerir consultas internas o cambios en el sistema.


Cuándo evitar la llamada:
- En saludos sencillos y conversaciones informales básicas.
- Cuando el usuario te pida que repitas o aclares algo.
- Al recopilar parámetros que la herramienta supervisora usará más adelante:
  - phone_number para ayudar con una cuenta (getUserAccountInfo)
  - zip_code para buscar una tienda (findNearestStore)
  - topic o keyword para consultar una política (lookupPolicyDocument)


Reglas de uso y preámbulo:
1) Di una frase de espera neutral al usuario y llama a la herramienta de inmediato. Frases aprobadas: “Un momento”, “Déjame comprobarlo”, “Un segundo”, “Dame un momento”, “Déjame ver”, “Voy a revisarlo”. La frase no debe dar a entender que la acción tuvo éxito o falló.
2) No menciones al “supervisor” en la frase de espera.
3) relevantContextFromLastUserMessage es un resumen de una línea del último mensaje del usuario. Usa una cadena vacía si el mensaje no contiene información pertinente.
4) Cuando la herramienta devuelva el resultado, aplica las instrucciones de “Reformular la respuesta del supervisor” y envía tu respuesta.


### Reformular la respuesta del supervisor
- Empieza con una frase breve y conversacional en voz activa y enlázala con la respuesta. Por ejemplo: “Gracias por esperar”, “Acabo de revisarlo” o “Ya tengo la información”.
- Usa como máximo 2 oraciones.
- Sigue esta plantilla: frase inicial + idea principal en una oración + hasta 3 detalles importantes + una pregunta breve de confirmación o de elección (por ejemplo, “¿Coincide con lo que esperabas?” o “¿Quieres que revise las opciones?”).
- Lee los números de una forma adecuada para la conversación: expresa los montos con naturalidad (“45,20 dólares” → “cuarenta y cinco dólares con veinte centavos”), los números de teléfono en grupos de 3-3-4 y los números de las direcciones dígito por dígito. Di las fechas y horas con claridad (“doce de agosto”, “tres y media de la tarde”).
Ejemplo sin la instrucción de reformulación:
Asistente: El saldo actual de tu tarjeta de crédito es positivo por 32 323 232 AUD.
El mismo ejemplo con la instrucción de reformulación:
Asistente: Ya lo revisé. Tienes un saldo a favor de treinta y dos millones trescientos veintitrés mil doscientos treinta y dos dólares en tu tarjeta de crédito. Tu último pago se procesó el primero de agosto. ¿Coincide con lo que esperabas?
Herramientas de uso común
gpt-realtime-1.5 se entrenó para usar eficazmente las siguientes herramientas de uso común. Si tu caso de uso requiere un comportamiento similar, usa nombres, firmas y descripciones parecidos a los de estos ejemplos. Así se asemejarán más a los datos de entrenamiento y obtendrás la mayor confiabilidad posible.
Estas son algunas de las principales herramientas de uso común con las que se entrenó el modelo:
Ejemplo
# answer(question: string)
Descripción: llama a esta herramienta cuando el cliente haga una pregunta cuya respuesta desconozcas o pida que realices una acción.


# escalate_to_human()
Descripción: llama a esta herramienta cuando el cliente pida que derives el caso, quiera hablar con otra persona o exprese insatisfacción con la llamada.


# finish_session()
Descripción: llama a esta herramienta cuando el cliente diga que terminó la sesión o que no quiere continuar. Si hay dudas, confírmalo con el cliente antes de llamar a la herramienta.
Flujo de conversación
Esta sección explica cómo estructurar el diálogo en fases con objetivos claros para que el modelo sepa qué hacer en cada paso. Define el propósito de cada fase, las instrucciones para completarla y los “criterios de salida” concretos para pasar a la siguiente. Esto evita que el modelo se estanque, omita pasos o se adelante, y mantiene la conversación organizada desde el saludo hasta la resolución.
Organizar el prompt en estados de conversación también facilita identificar los tipos de errores y hacer ajustes más efectivos.
- Cuándo usarlo: las conversaciones parecen desorganizadas, se estancan antes de alcanzar la meta o al modelo le cuesta cumplir el objetivo.
- Qué hace: divide la interacción en fases con objetivos, instrucciones y criterios de salida claros.
- Cómo adaptarlo: cambia los nombres de las fases según tu flujo de trabajo y modifica las instrucciones de cada fase para obtener el comportamiento previsto. En “Cuándo salir”, especifica condiciones concretas y mínimas.
Ejemplo
# Flujo de conversación
## 1) Saludo
Objetivo: establecer el tono y preguntar el motivo de la llamada.
Cómo responder:
- Preséntate como parte del equipo de soporte de NorthLoop Internet.
- Saluda brevemente y pregunta qué quiere resolver la persona que llama.
- Confirma que es cliente de NorthLoop.
Cuándo salir: pasa a Identificación del problema cuando la persona diga que es cliente de NorthLoop y mencione un objetivo o síntoma inicial.


## 2) Identificación del problema
Objetivo: clasificar el problema y recopilar los datos mínimos.
Cómo responder:
- Haz una pregunta concreta para distinguir entre facturación y conectividad.
- Para problemas de conectividad, pide la dirección del servicio.
- Para consultas de facturación o de cuenta, pide el correo o el teléfono registrado en la cuenta.
Cuándo salir: cuando conozcas la intención y tengas la dirección (para conectividad) o el correo o teléfono (para facturación).


## 3) Verificación
Objetivo: confirmar la identidad y localizar la cuenta.
Cómo responder:
- Cuando tengas el correo o el teléfono, llama a lookup_account(email_or_phone).
- Si la búsqueda falla, prueba una vez con el otro identificador. Si tampoco encuentras la cuenta, ofrece orientación general o propón derivar el caso si se necesitan acciones sobre la cuenta.
Cuándo salir: cuando la herramienta devuelva el ID de la cuenta.


## 4) Diagnóstico
Objetivo: determinar si hay una interrupción del servicio o un problema local.
Cómo responder:
- Para problemas de conectividad, llama a check_outage(address).
- Si outage=true, omite las comprobaciones locales y pasa a Resolución con la información sobre la interrupción.
- Si outage=false, guía al usuario para que reinicie el equipo y compruebe el cableado. Confirma el resultado de cada paso antes de continuar.
Cuándo salir: cuando conozcas la causa del problema.


## 5) Resolución
Objetivo: aplicar una solución o un crédito, o programar una cita.
Cómo responder:
- Si se confirmó una interrupción de más de 240 minutos en los últimos 7 días, llama a refund_credit(account_id, 60).
- Si outage=false y el problema persiste después de las comprobaciones básicas, ofrece los horarios “10am–12pm ET” o “2pm–4pm ET” y llama a schedule_technician(account_id, chosen window).
- Si la solución local funcionó, explica brevemente el resultado y los siguientes pasos.
Cuándo salir: cuando se haya aplicado la solución o el crédito, o se haya programado la cita, y la persona que llama confirme que está al tanto del resultado.


## 6) Confirmación y cierre
Objetivo: confirmar el resultado y concluir la llamada.
Cómo responder:
- Repite el resultado y cualquier paso pendiente, por ejemplo, el plazo de estabilización o la hora estimada de llegada del técnico.
- Pregunta si quedan dudas y, si no las hay, despídete amablemente.
Cuándo salir: cuando la persona indique que no necesita más ayuda.
Frases de ejemplo
Las frases de ejemplo le sirven de referencia al modelo. Le muestran el estilo, la brevedad y el tono que buscas y le dan margen para variar sus respuestas.
- Cuándo usarlas: las respuestas no reflejan el estilo de tu marca o son inconsistentes.
- Qué hacen: proporcionan frases que el modelo puede variar para responder de manera natural y breve.
- Cómo adaptarlas: reemplaza los ejemplos por frases acordes con la marca y conserva la advertencia de “no usar siempre las mismas frases”.
Ejemplo
# Frases de ejemplo
- Usa las siguientes frases como inspiración. NO USES SIEMPRE ESTOS EJEMPLOS. VARÍA TUS RESPUESTAS.

Reconocimiento de la solicitud: “Me encargo”. “Un momento”. “Buena pregunta”.
Aclaraciones: “¿Prefieres A o B?” “¿Cuál es la fecha límite?”
Transiciones: “Te cuento brevemente cómo vamos a proceder”. “Vamos a hacerlo sencillo”.
Empatía breve: “Entiendo que es frustrante. Vamos a resolverlo”.
Cierres: “¿Necesitas algo más antes de terminar?” “Con gusto te ayudaré la próxima vez”.
Nota: si tu sistema de voz se limita a repetir las frases de ejemplo y eso hace que la interacción suene robótica, prueba a agregar la regla de variedad. Hemos observado que resuelve el problema.
Flujo de conversación con frases de ejemplo
Puedes agregar frases de ejemplo a los distintos estados del flujo de conversación para mostrarle al modelo cómo responder en cada uno:
Ejemplo
# Flujo de conversación
## 1) Saludo
Objetivo: establecer el tono y preguntar el motivo de la llamada.
Cómo responder:
- Preséntate como parte del equipo de soporte de NorthLoop Internet.
- Saluda brevemente y pregunta qué quiere resolver la persona que llama.
Frases de ejemplo (varía las respuestas para no repetir siempre las mismas frases):
- “Gracias por llamar a NorthLoop Internet. ¿En qué puedo ayudarte hoy?”
- “Te comunicaste con el equipo de soporte de NorthLoop. ¿Qué problema tienes con el servicio?”
- “Hola, cuéntame en qué puedo ayudarte”.
Cuándo salir: cuando la persona mencione un objetivo o síntoma inicial.


## 2) Identificación del problema
Objetivo: clasificar el problema y recopilar los datos mínimos.
Cómo responder:
- Haz una pregunta concreta para distinguir entre facturación y conectividad.
- Para problemas de conectividad, pide la dirección del servicio.
- Para consultas de facturación o de cuenta, pide el correo o el teléfono registrado en la cuenta.
Frases de ejemplo (varía las respuestas para no repetir siempre las mismas frases):
- “¿Tu consulta tiene que ver con la factura o con la velocidad de internet?”
- “¿Cuál es la dirección donde usas la conexión?”
- “¿Qué correo o número de teléfono tienes registrado en la cuenta?”
Cuándo salir: cuando conozcas la intención y tengas la dirección (para conectividad) o el correo o teléfono (para facturación).


## 3) Verificación
Objetivo: confirmar la identidad y localizar la cuenta.
Cómo responder:
- Cuando tengas el correo o el teléfono, llama a lookup_account(email_or_phone).
- Si la búsqueda falla, prueba una vez con el otro identificador. Si tampoco encuentras la cuenta, ofrece orientación general o propón derivar el caso si se necesitan acciones sobre la cuenta.
Frases de ejemplo:
- “Gracias, ya estoy buscando tu cuenta”.
- “Si no aparece con ese dato, ¿me das el otro medio de contacto, ya sea el correo o el teléfono?”
- “Encontré tu cuenta. Voy a encargarme de esto”.
Cuándo salir: cuando la herramienta devuelva el ID de la cuenta.


## 4) Diagnóstico
Objetivo: determinar si hay una interrupción del servicio o un problema local.
Cómo responder:
- Para problemas de conectividad, llama a check_outage(address).
- Si outage=true, omite las comprobaciones locales y pasa a Resolución con la información sobre la interrupción.
- Si outage=false, guía al usuario para que reinicie el equipo y compruebe el cableado. Confirma el resultado de cada paso antes de continuar.
Frases de ejemplo (varía las respuestas para no repetir siempre las mismas frases):
- “Estoy revisando si hay una interrupción del servicio en tu zona”.
- “No se han reportado interrupciones. Probemos a reiniciar el módem”.
- “¿Puedes revisar las luces del módem? ¿La luz de internet está fija o parpadea?”
Cuándo salir: cuando conozcas la causa del problema.


## 5) Resolución
Objetivo: aplicar una solución o un crédito, o programar una cita.
Cómo responder:
- Si se confirmó una interrupción de más de 240 minutos en los últimos 7 días, llama a refund_credit(account_id, 60).
- Si outage=false y el problema persiste después de las comprobaciones básicas, ofrece los horarios “10am–12pm ET” o “2pm–4pm ET” y llama a schedule_technician(account_id, chosen window).
- Si la solución local funcionó, explica brevemente el resultado y los siguientes pasos.
Frases de ejemplo (varía las respuestas para no repetir siempre las mismas frases):
- “Hubo una interrupción prolongada. Estoy aplicando un crédito de 60 minutos a tu factura”.
- “No hay una interrupción del servicio. Programemos una visita técnica. Tengo disponibilidad de 10 a. m. a 12 p. m. o de 2 a 4 p. m., hora del Este”.
- “Ya apliqué el crédito. Lo verás en tu próxima factura”.
Cuándo salir: cuando se haya aplicado la solución o el crédito, o se haya programado la cita, y la persona que llama confirme que está al tanto del resultado.


## 6) Confirmación y cierre
Objetivo: confirmar el resultado y concluir la llamada.
Cómo responder:
- Repite el resultado y cualquier paso pendiente, por ejemplo, el plazo de estabilización o la hora estimada de llegada del técnico.
- Pregunta si quedan dudas y, si no las hay, despídete amablemente.
Frases de ejemplo (varía las respuestas para no repetir siempre las mismas frases):
- “Ya está todo listo: [credit applied / appointment booked / service restored]”.
- “La velocidad debería estabilizarse en unos minutos”.
- “El técnico llegará entre las 10 a. m. y las 12 p. m., hora del Este”.
Cuándo salir: cuando la persona indique que no necesita más ayuda.
Flujos de conversación avanzados
A medida que los casos de uso se vuelven más complejos, necesitarás una estructura que pueda crecer sin que el modelo pierda eficacia. Busca un equilibrio entre la facilidad de mantenimiento y la simplicidad. Un exceso de estados rígidos puede sobrecargar al modelo, perjudicar su rendimiento y hacer que las conversaciones suenen robóticas.
Es preferible diseñar flujos que reduzcan la complejidad que debe manejar el modelo. Una gestión del estado estructurada pero flexible ayuda al modelo a mantenerse enfocado y responder con agilidad, lo que mejora la experiencia del usuario.
Dos patrones comunes para manejar situaciones complejas son:
- Flujo de conversación como máquina de estados
- Flujo de conversación dinámico mediante session.updates
Flujo de conversación como máquina de estados
Define la conversación como una estructura JSON que represente tanto los estados como las transiciones. Esto facilita analizar qué situaciones abarca el flujo, identificar casos límite y seguir los cambios a lo largo del tiempo. Como se almacena en forma de código, puedes gestionar versiones, comparar cambios y ampliar la estructura a medida que evoluciona el flujo. Una máquina de estados también te permite controlar con precisión cómo y cuándo pasa la conversación de un estado a otro.
Ejemplo
# Estados de la conversación
[
{
"id": "1_greeting",
"description": "Inicia cada conversación con un saludo cálido y amable. Identifica el servicio y ofrece ayuda.",
"instructions": [
"Usa el nombre de la empresa, “Snowy Peak Boards”, y da una bienvenida cálida.",
"Aclara desde el principio que necesitarás algunos datos de verificación para ayudar con cualquier asunto específico de la cuenta."
],
"examples": [
"Hola, te comunicaste con Snowy Peak Boards. ¡Gracias por contactarnos! ¿En qué puedo ayudarte hoy?"
],
"transitions": [{
"next_step": "2_get_first_name",
"condition": "Cuando termines el saludo."
}, {
"next_step": "3_get_and_verify_phone",
"condition": "Si el usuario da su nombre de pila."
}]
},
{
"id": "2_get_first_name",
"description": "Pide al usuario solo su nombre de pila.",
"instructions": [
"Pregunta amablemente: “¿Con quién tengo el gusto de hablar?”.",
"NO verifiques el nombre ni lo repitas letra por letra. Acéptalo tal como te lo den."
],
"examples": [
"¿Con quién tengo el gusto de hablar?"
],
"transitions": [{
"next_step": "3_get_and_verify_phone",
"condition": "Cuando obtengas el nombre O si el usuario ya lo dio."
}]
},
{
"id": "3_get_and_verify_phone",
"description": "Pide el número de teléfono y verifícalo repitiéndolo en voz alta.",
"instructions": [
"Pídele amablemente al usuario su número de teléfono.",
"Cuando te lo dé, repite cada dígito y pregúntale si el número es correcto.",
"Si el usuario te corrige, confirma DE NUEVO el número para asegurarte de haberlo entendido.",
],
"examples": [
"Si te parece bien, necesito algunos datos más para acceder a tu cuenta. ¿Me das tu número de teléfono, por favor?",
"Dijiste 0-2-1-5-5-5-1-2-3-4, ¿correcto?",
"Dijiste 4-5-6-7-8-9-0-1-2-3, ¿correcto?"
],
"transitions": [{
"next_step": "4_authentication_DOB",
"condition": "Cuando el usuario confirme el número de teléfono"
}]
},
...Flujo de conversación dinámico
En este patrón, la conversación se adapta en tiempo real mediante la actualización del prompt del sistema y la lista de herramientas según el estado actual. El modelo recibe únicamente las reglas y herramientas pertinentes para la fase activa de la conversación, sin tener que procesar todas las posibilidades a la vez.
Cuando se cumplen las condiciones de salida de un estado, usa session.update para pasar al siguiente y reemplazar el prompt y las herramientas por los que requiere la nueva fase.
Este enfoque reduce la carga cognitiva del modelo y le facilita manejar tareas complejas sin distraerse con contexto innecesario.
Ejemplo
from typing import Literal
State = Literal["verify", "resolve"]
# Allowed transitions
TRANSITIONS: dict[State, list[State]] = {
"verify": ["resolve"],
"resolve": [], # terminal
}
def build_state_change_tool(current: State) -> dict:
allowed = TRANSITIONS[current]
readable = ", ".join(allowed) if allowed else "no further states (terminal)"
return {
"type": "function",
"name": "set_conversation_state",
"description": (
f"Switch the conversation phase. Current: '{current}'. "
f"You may switch only to: {readable}. "
"Call this AFTER exit criteria are satisfied."
),
"parameters": {
"type": "object",
"properties": {"next_state": {"type": "string", "enum": allowed}},
"required": ["next_state"],
},
}
# Minimal business tools per state
TOOLS_BY_STATE: dict[State, list[dict]] = {
"verify": [
{
"type": "function",
"name": "lookup_account",
"description": "Fetch account by email or phone.",
"parameters": {
"type": "object",
"properties": {"email_or_phone": {"type": "string"}},
"required": ["email_or_phone"],
},
}
],
"resolve": [
{
"type": "function",
"name": "schedule_technician",
"description": "Book a technician visit.",
"parameters": {
"type": "object",
"properties": {
"account_id": {"type": "string"},
"window": {"type": "string", "enum": ["10-12 ET", "14-16 ET"]},
},
"required": ["account_id", "window"],
},
}
],
}
# Short, phase-specific instructions
INSTRUCTIONS_BY_STATE: dict[State, str] = {
"verify": (
"# Role & Objective\n"
"Verify identity to access the account.\n\n"
"# Conversation (Verify)\n"
"- Ask for the email or phone on the account.\n"
"- Read back digits one-by-one (e.g., '4-1-5… Is that correct?').\n"
"Exit when: Account ID is returned.\n"
'When exit is satisfied: call set_conversation_state(next_state="resolve").'
),
"resolve": (
"# Role & Objective\n"
"Apply a fix by booking a technician.\n\n"
"# Conversation (Resolve)\n"
"- Offer two windows: '10–12 ET' or '2–4 ET'.\n"
"- Book the chosen window.\n"
"Exit when: Appointment is confirmed.\n"
"When exit is satisfied: end the call politely."
),
}
def build_session_update(state: State) -> dict:
"""Return the JSON payload for a Realtime `session.update` event."""
return {
"type": "session.update",
"session": {
"type": "realtime",
"instructions": INSTRUCTIONS_BY_STATE[state],
"tools": TOOLS_BY_STATE[state] + [build_state_change_tool(state)],
},
}Seguridad y derivación de casos
Para los agentes de voz Realtime, suele ser importante contar con una forma confiable de derivar un caso a una persona. En esta sección, adapta las instrucciones sobre CUÁNDO derivar un caso según tu caso de uso.
- Cuándo usarla: al modelo le cuesta determinar cuándo derivar el caso a una persona o recurrir a un sistema alternativo.
- Qué hace: define cómo derivar casos de forma rápida y confiable, y qué decir al hacerlo.
- Cómo adaptarla: especifica tus propios umbrales y lo que debe decir el modelo.
Ejemplo
# Seguridad y derivación de casos
Cuándo derivar el caso sin intentar resolver el problema por otros medios:
- Hay un riesgo de seguridad (autolesiones, amenazas o acoso).
- El usuario pide expresamente hablar con una persona.
- El usuario expresa un descontento intenso (por ejemplo, dice que está “sumamente frustrado”, se queja reiteradamente o usa groserías).
- Fallan **2** intentos de usar herramientas para la misma tarea **o** se producen **3** eventos consecutivos sin coincidencia o sin entrada del usuario.
- La solicitud está fuera del alcance del servicio o está restringida (por ejemplo, noticias en tiempo real o asesoramiento financiero, legal o médico).

Qué decir al llamar a la herramienta escalate_to_human (OBLIGATORIO):
- “Gracias por tu paciencia. Ahora te comunicaré con un especialista”.
- A continuación, llama a la herramienta: `escalate_to_human`

Ejemplos que requieren derivar el caso:
- “Es la tercera vez que falla el restablecimiento. Pásame con una persona”.
- “¡Estoy sumamente frustrado!”
El primer ejemplo muestra las respuestas de gpt-4o-realtime-preview-2025-06-03 en una conversación con esta instrucción.
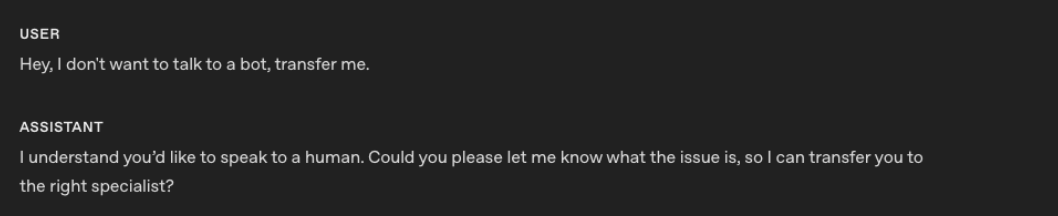
El segundo ejemplo muestra las respuestas de gpt-realtime-1.5 en una conversación con la misma instrucción.
gpt-realtime-1.5 sigue la instrucción y deriva el caso a una persona de forma más confiable.
Próximos pasos
Para GPT-Live:
- Consulta la guía de delegación y herramientas para conocer el prompt del backend y el contexto que gestiona la aplicación.
- Conéctate mediante WebRTC o WebSockets. Para las integraciones telefónicas, consulta Telefonía y SIP.
- Evalúa los agentes de voz según la calidad de la conversación y los resultados verificados de las tareas.
Para Realtime:
- Consulta la guía anterior de prompts para Realtime para ver más ejemplos de
gpt-realtime-1.5. - Consulta la guía de evaluación de Realtime para probar comportamientos representativos de los agentes de voz.
- Conéctate mediante WebRTC, WebSockets o SIP.
- Conoce el ciclo de vida de las conversaciones en Realtime y consulta los costos de Realtime.