
Esta guía presenta los principios básicos que puedes aplicar para reducir la latencia en una amplia variedad de casos de uso con LLM. Estas técnicas surgen del trabajo con clientes y desarrolladores en aplicaciones en producción, por lo que deberían servirte tanto si diseñas un flujo de trabajo con pasos muy específicos como si desarrollas una aplicación de chat completa.
Aunque existen muchas técnicas, esta guía las agrupa en siete principios que resumen los distintos enfoques para reducir la latencia.
Al final, veremos cómo aplicarlos en un ejemplo.
Siete principios
- Procesa los tokens más rápido.
- Genera menos tokens.
- Usa menos tokens de entrada.
- Haz menos solicitudes.
- Ejecuta tareas en paralelo.
- Reduce la espera de tus usuarios.
- Evita recurrir a un LLM por defecto.
Procesa los tokens más rápido
La velocidad de inferencia probablemente sea lo primero que consideres al abordar la latencia, aunque, como verás, hay muchos otros factores. Se refiere a la velocidad a la que el LLM procesa los tokens y suele medirse en TPM (tokens por minuto) o TPS (tokens por segundo).
El factor que más influye en la velocidad de inferencia es el tamaño del modelo. Los modelos más pequeños suelen ser más rápidos y económicos y, si los usas bien, incluso pueden dar mejores resultados que los más grandes. Para mantener la calidad de los resultados con modelos más pequeños, puedes probar lo siguiente:
- usar un prompt más detallado y extenso,
- incluir unos pocos ejemplos o agregar más si ya los usas, o
- recurrir al ajuste fino o a la destilación.
También puedes optimizar la inferencia con funciones como las salidas predichas. Las salidas predichas permiten reducir considerablemente la latencia de la generación cuando conoces de antemano gran parte de la salida, como ocurre al editar código. Si le das una predicción al modelo, el LLM puede centrarse más en los cambios y dedicar menos tiempo al contenido que seguirá igual.
En la velocidad de inferencia también influyen la
capacidad de cómputo disponible y las demás
optimizaciones de inferencia que apliques.
La mayoría de las personas no pueden modificar estos factores directamente, pero si te interesa explorarlos y tienes cierto control sobre tu infraestructura, usar hardware más rápido o
ejecutar los motores con un menor nivel de saturación puede aumentar un poco la cantidad de tokens procesados por minuto. Si trabajas directamente en la implementación, hay muchas otras
optimizaciones de inferencia
que quedan fuera del alcance de esta guía.
Genera menos tokens
Al usar un LLM, la generación de tokens casi siempre es el paso con mayor latencia. Como regla general, reducir a la mitad los tokens de salida puede reducir la latencia en aproximadamente un 50 %. La forma de reducir el tamaño de la salida depende de su tipo:
Si generas lenguaje natural, puede servir pedirle al modelo que sea más conciso (“usa menos de 20 palabras” o “sé breve”). También puedes enseñarle a dar respuestas más cortas con unos pocos ejemplos, con ajuste fino o con ambas técnicas.
Si generas resultados estructurados, procura simplificar al máximo la sintaxis de salida cuando sea posible: acorta los nombres de las funciones, omite los argumentos con nombre, combina parámetros, etc.
Por último, aunque es poco habitual, también puedes usar max_tokens o stop_tokens para terminar la generación antes.
Recuerda: ¡cada token de salida que ahorras te devuelve tiempo, aunque sea en milisegundos!
Usa menos tokens de entrada
Reducir la cantidad de tokens de entrada disminuye la latencia, pero el efecto suele ser pequeño: acortar el prompt a la mitad puede reducir la latencia apenas entre un 1 % y un 5 %. Salvo que trabajes con contextos muy extensos (documentos, imágenes), quizá te convenga concentrar tus esfuerzos en otros aspectos.
Si sí trabajas con contextos muy extensos (o quieres aprovechar hasta la última mejora de rendimiento y ya agotaste las demás opciones), puedes usar estas técnicas para reducir los tokens de entrada:
- Aplica ajuste fino al modelo para que no necesite instrucciones ni ejemplos extensos.
- Filtra el contexto de entrada, por ejemplo, descartando resultados de RAG o limpiando el HTML.
- Amplía el prefijo que comparten los prompts colocando las partes dinámicas (por ejemplo, los resultados de RAG y el historial) más adelante en el prompt. Así, la solicitud aprovecha mejor la caché KV, que usa la mayoría de los proveedores de LLM, y se procesan menos tokens de entrada por solicitud.
Consulta la documentación para saber cómo funciona el almacenamiento de prompts en caché.
Haz menos solicitudes
Cada solicitud implica cierta latencia de ida y vuelta, y esos tiempos pueden acumularse.
Si el LLM debe ejecutar varios pasos en secuencia, en lugar de enviar una solicitud por paso, considera reunir los pasos en un solo prompt y obtener todos los resultados en una sola respuesta. Así evitarás la latencia de cada ida y vuelta adicional y es posible que también simplifiques el procesamiento de las respuestas.
Una forma de hacerlo es enumerar los pasos en el prompt combinado y pedirle al modelo que devuelva cada resultado en un campo con nombre dentro de un objeto JSON. Así podrás extraer cada resultado y hacer referencia a él.
Ejecuta tareas en paralelo
El procesamiento en paralelo puede ser muy eficaz cuando usas un LLM para ejecutar varios pasos.
Si los pasos no tienen que ejecutarse en un orden estricto, puedes distribuirlos entre llamadas en paralelo. Dos camisas tardan lo mismo en secarse que una sola.
Incluso si los pasos sí tienen que ejecutarse en un orden estricto, quizá puedas aprovechar la ejecución especulativa. Esta técnica es especialmente eficaz en pasos de clasificación donde un resultado es más probable que los demás, como ocurre con la moderación.
- Inicia los pasos 1 y 2 al mismo tiempo (por ejemplo, la moderación de la entrada y la generación de una historia).
- Verifica el resultado del paso 1.
- Si el resultado difiere del esperado, cancela el paso 2 y vuelve a intentarlo si es necesario.
Si aciertas con el resultado del paso 1, ¡en la práctica lo habrás ejecutado sin añadir latencia!
Reduce la espera de tus usuarios
Hay una gran diferencia entre esperar y ver cómo avanza una tarea. Procura que tus usuarios puedan ver ese avance. Puedes usar estas técnicas:
- Transmisión en tiempo real: es la técnica más eficaz, ya que reduce el tiempo de espera a un segundo o menos. (La experiencia de usar ChatGPT sería muy distinta si tuvieras que esperar a que terminara cada respuesta para ver algo).
- Procesamiento por fragmentos: si la salida requiere procesamiento adicional antes de mostrarse al usuario (moderación, traducción), considera procesarla por fragmentos en lugar de hacerlo todo de una vez. Para ello, transmite la salida al backend a medida que se genera y envía los fragmentos procesados al frontend.
- Muestra los pasos: si tu aplicación ejecuta varios pasos o usa herramientas, muéstraselo al usuario. Cuanto más avance real puedas mostrar, mejor.
- Estados de carga: los indicadores de carga y las barras de progreso son de gran ayuda.
Aunque mostrar los pasos y los estados de carga tiene un efecto principalmente psicológico, la transmisión en tiempo real y el procesamiento por fragmentos sí reducen la latencia total si consideras tanto a la aplicación como al usuario: el usuario termina de leer la respuesta antes.
Evita recurrir a un LLM por defecto
Los modelos de lenguaje son potentes y versátiles. Por eso, a veces se usan en situaciones en las que sería más adecuado un método tradicional más rápido. Detectar esos casos puede ayudarte a reducir considerablemente la latencia. Considera estos ejemplos:
- Respuestas predefinidas en el código: si la salida tiene muy pocas variantes posibles, quizá no necesites un LLM para generarla. Puedes definir directamente en el código las confirmaciones de acciones, los mensajes de rechazo y las solicitudes de datos estándar. (Incluso puedes recurrir al método de siempre y redactar unas cuantas variantes de cada mensaje).
- Cálculo previo: si las opciones de entrada son limitadas (por ejemplo, al seleccionar una categoría), puedes generar varias respuestas de antemano. Solo asegúrate de que un usuario nunca vea la misma respuesta dos veces.
- Uso de la interfaz: a veces, los componentes de interfaz tradicionales diseñados a medida comunican mejor las métricas resumidas, los informes o los resultados de búsqueda que el texto generado por un LLM.
- Técnicas de optimización tradicionales: una aplicación con LLM sigue siendo una aplicación. La búsqueda binaria, el almacenamiento en caché, los mapas hash y el análisis de la complejidad temporal siguen siendo útiles al trabajar con modelos de lenguaje.
Ejemplo
Veamos una aplicación de ejemplo, identifiquemos dónde se podría reducir la latencia y propongamos algunas soluciones.
Analizaremos la arquitectura y los prompts de un bot de atención al cliente hipotético, inspirado en aplicaciones reales en producción. En la sección sobre arquitectura y prompts veremos cómo funciona el bot y en la sección sobre análisis y optimizaciones recorreremos el proceso de optimización de la latencia.
Este ejemplo solo abarca algunos de los principios, tal como sucede en los casos reales, en los que no siempre hace falta aplicar todas las técnicas.
Arquitectura y prompts
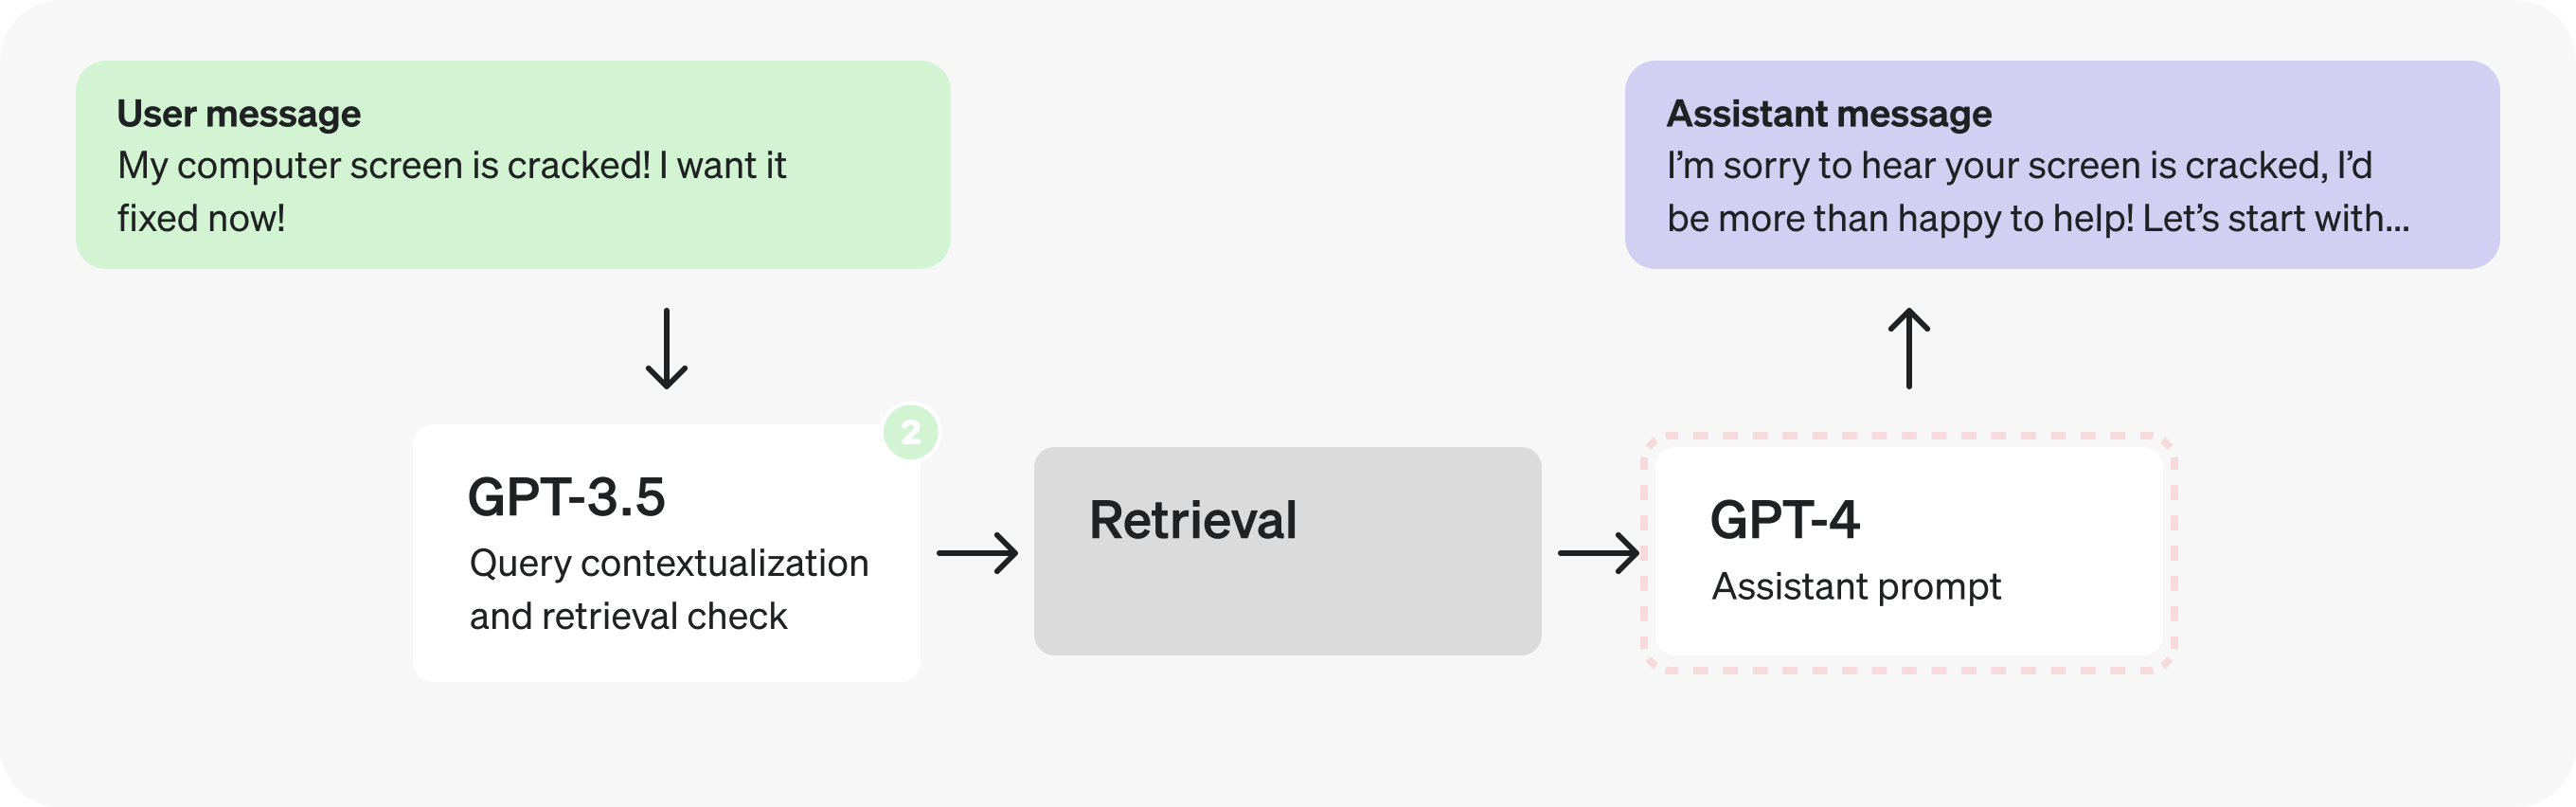
Esta es la arquitectura inicial de un bot de atención al cliente hipotético. Sobre ella haremos los cambios.
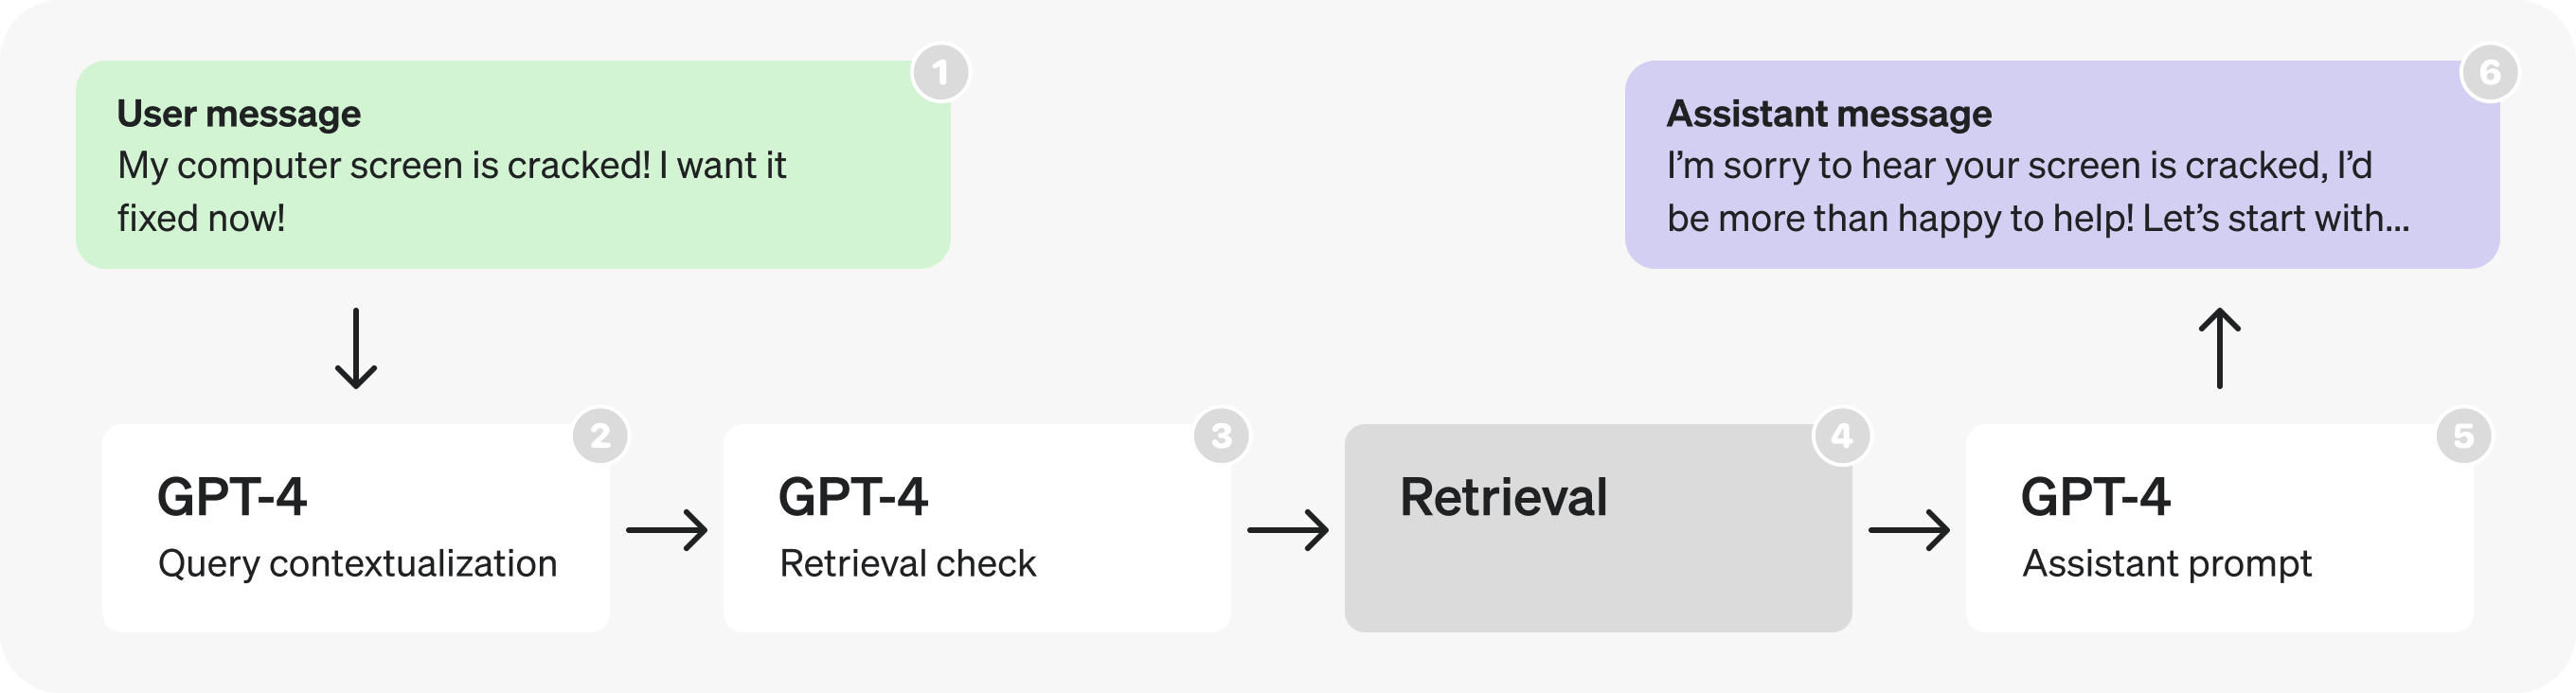
En términos generales, el flujo del diagrama describe este proceso:
- El usuario envía un mensaje en una conversación en curso.
- El último mensaje se reformula como una consulta que se entiende por sí sola (consulta los ejemplos del prompt).
- Determinamos si hace falta buscar información adicional en tiempo real para responder a la consulta.
- Si hace falta, se recupera la información y se obtienen los resultados de búsqueda.
- El asistente razona sobre la consulta del usuario y los resultados de búsqueda, y genera una respuesta.
- Se envía la respuesta al usuario.
A continuación se muestran los prompts que se usan en cada parte del diagrama. Aunque son hipotéticos y simplificados, tienen la estructura y la redacción que encontrarías en una aplicación en producción.
Los marcadores de posición como “[user input here]” representan partes dinámicas que se reemplazan con datos reales en tiempo de ejecución.
Análisis y optimizaciones
Parte 1: revisión de los prompts de recuperación de información
Lo primero que llama la atención en la arquitectura son las llamadas consecutivas a GPT-4. Podrían ser ineficientes y a menudo es posible sustituirlas por una sola llamada o por varias llamadas en paralelo.
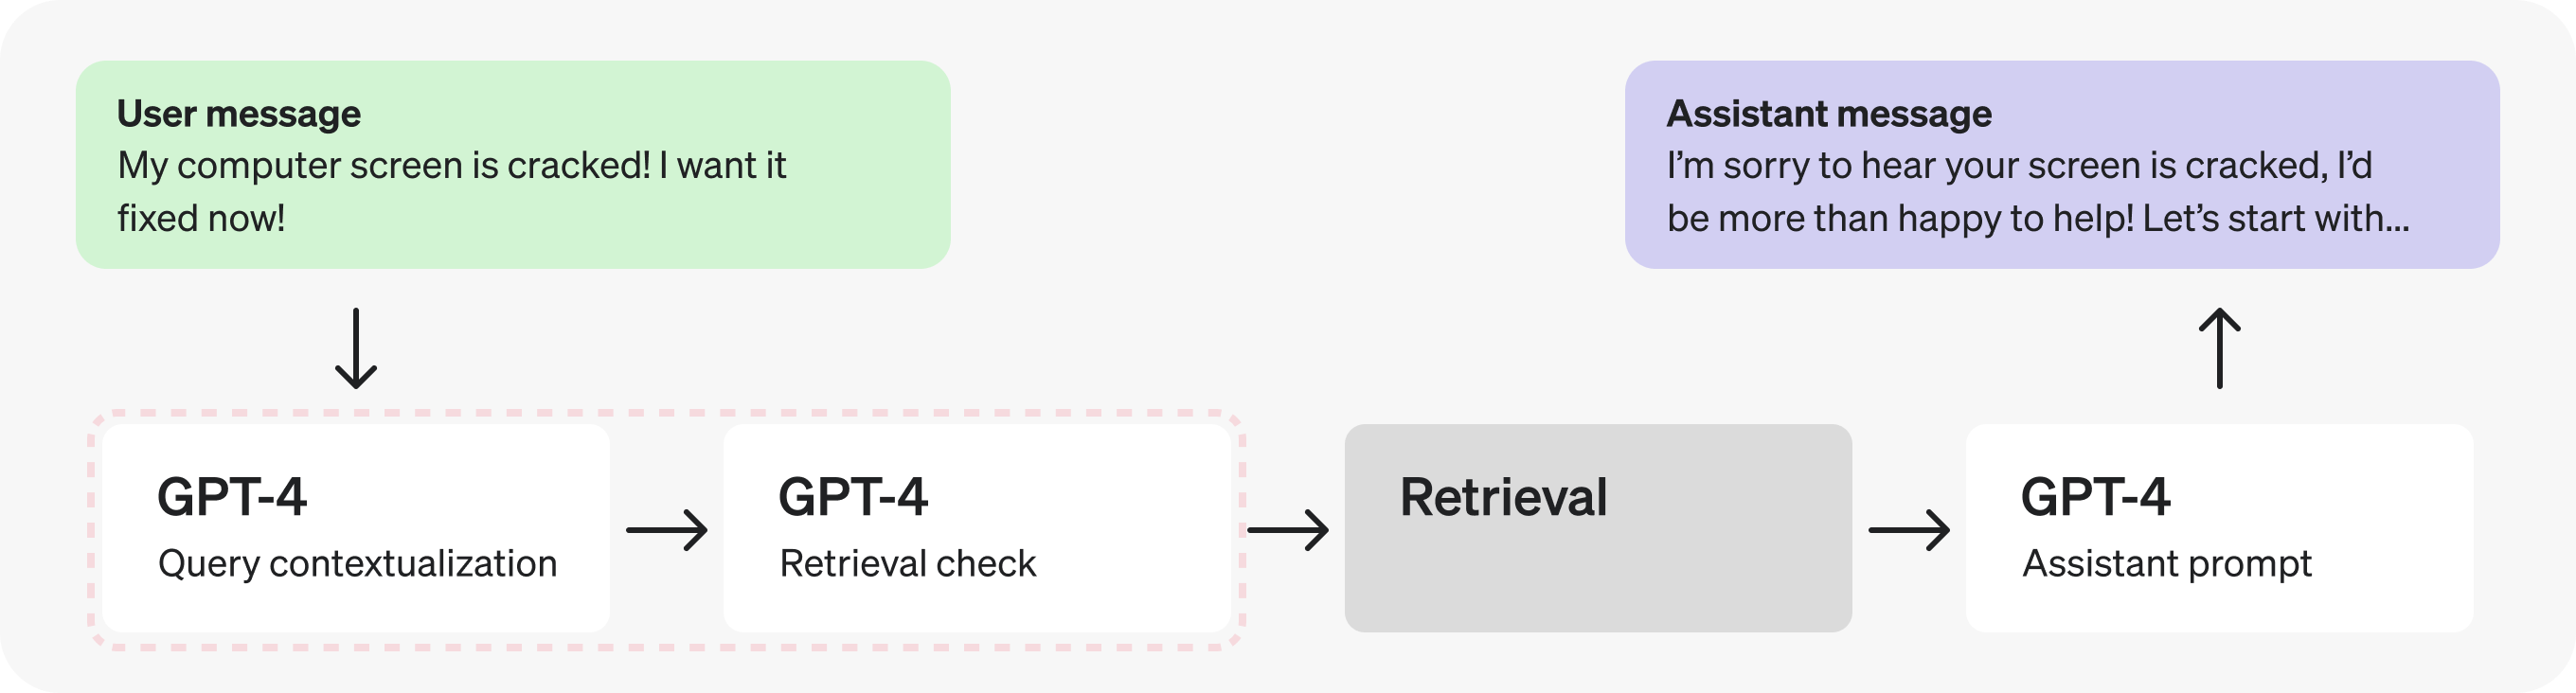
En este caso, para verificar si hace falta una búsqueda en tiempo real necesitamos la consulta contextualizada. Por eso, combinemos ambos pasos en un solo prompt para hacer menos solicitudes.
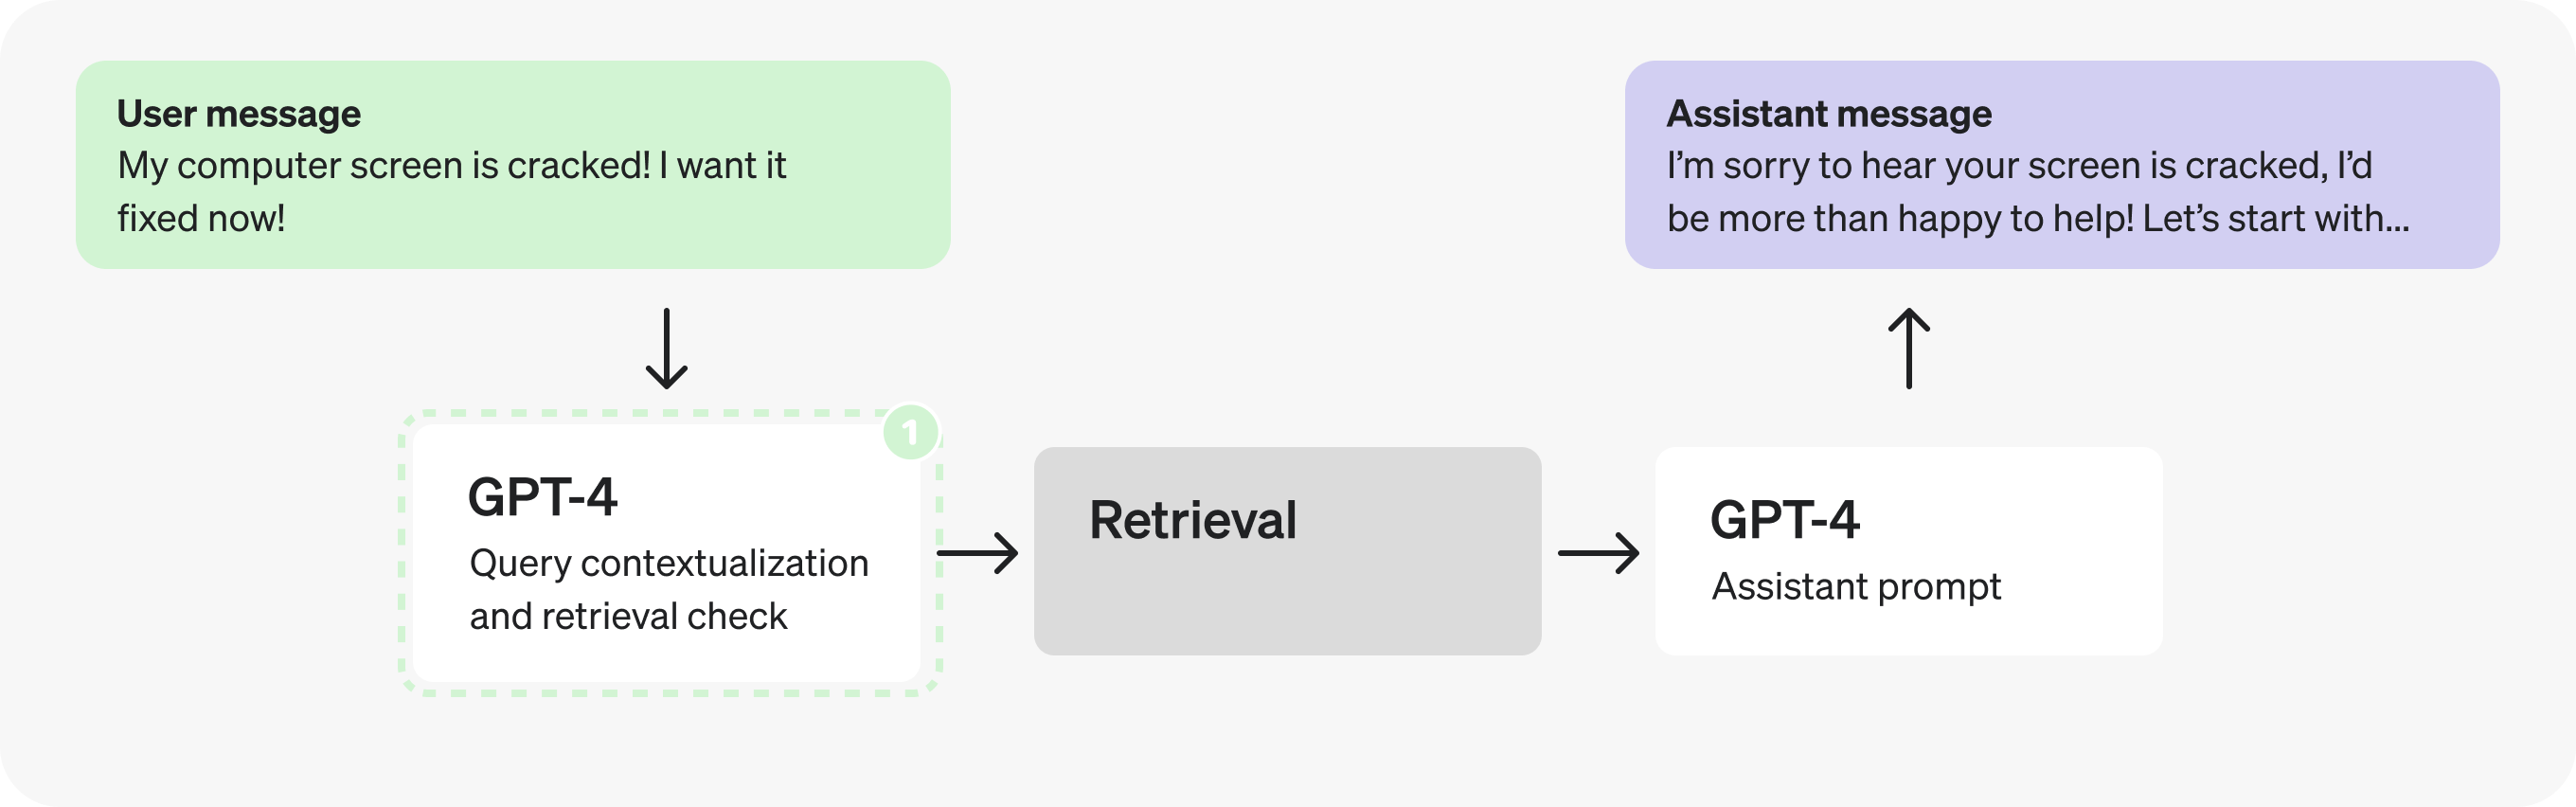
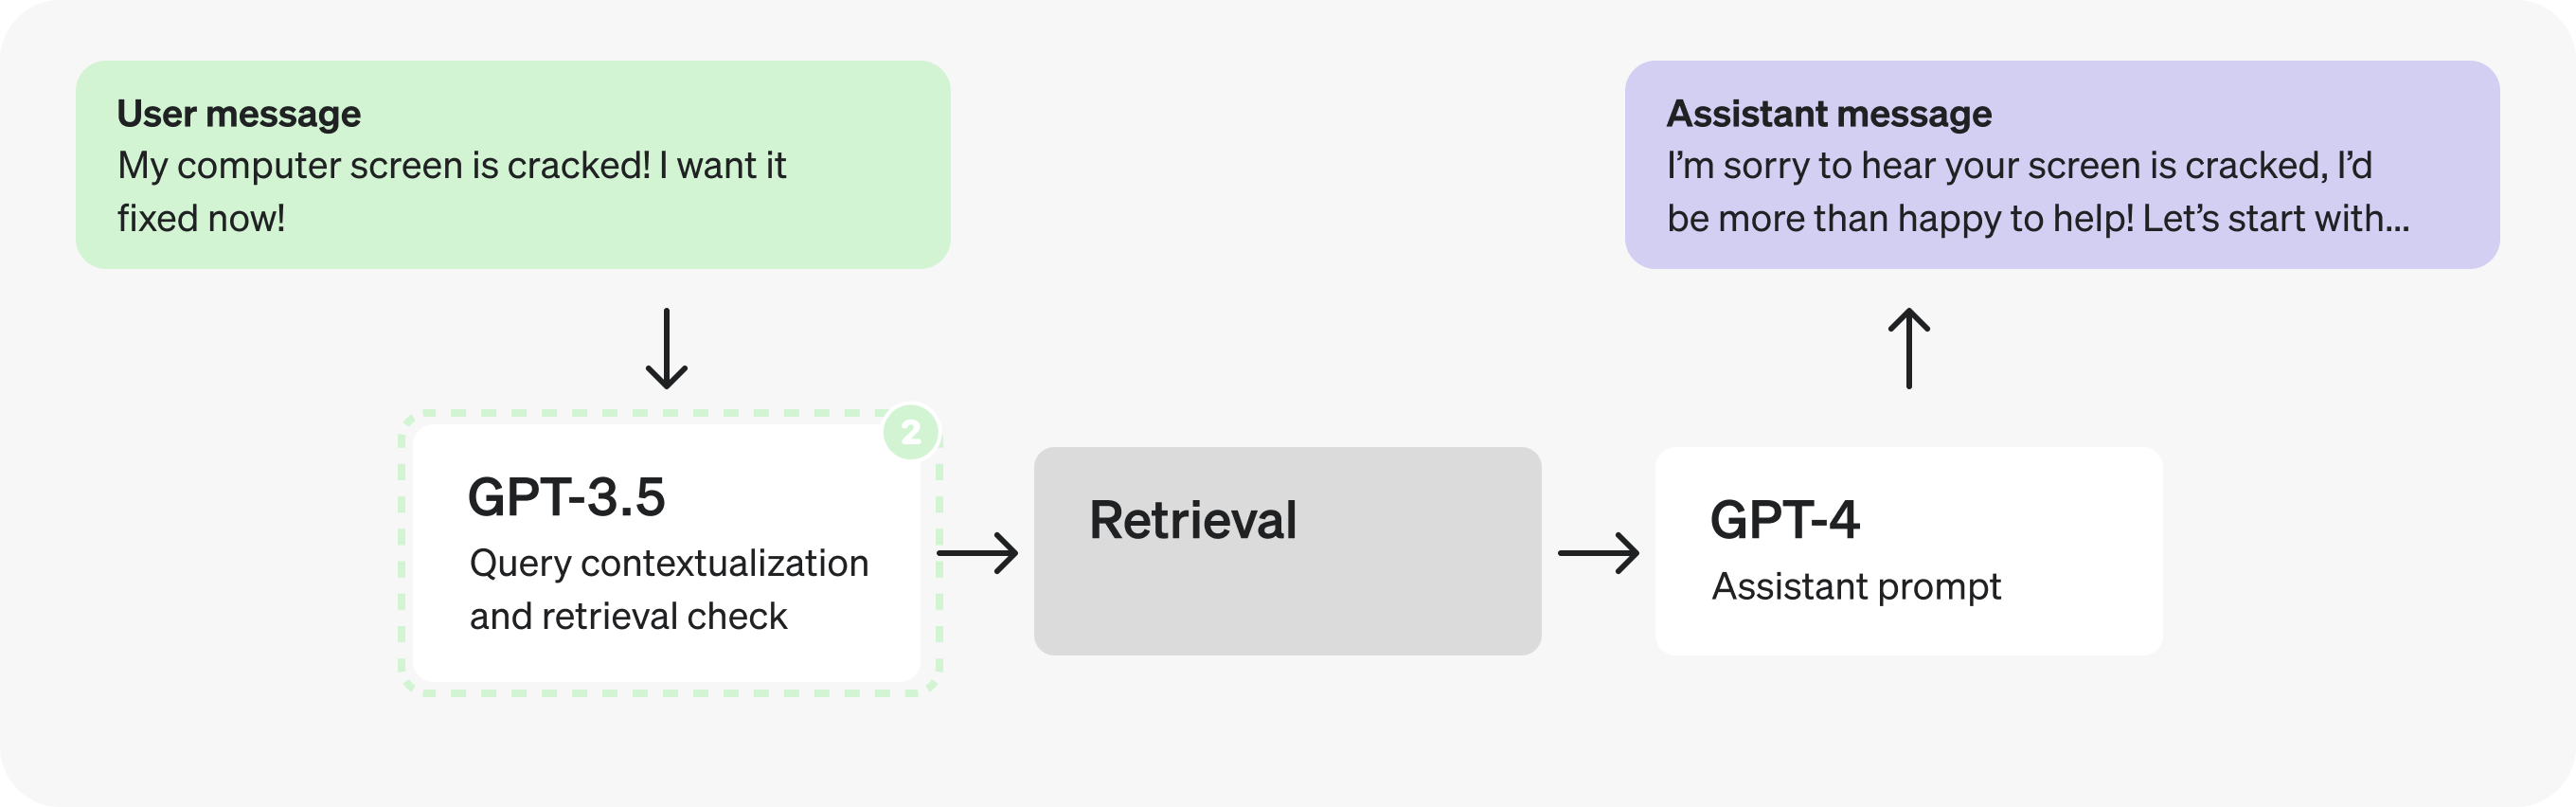
Agregar contexto y decidir si hace falta buscar información en tiempo real son tareas sencillas y bien definidas, así que probablemente podamos usar un modelo más pequeño con ajuste fino. Cambiar a GPT-3.5 nos permitirá procesar los tokens más rápido.
Parte 2: análisis del prompt del asistente
Veamos ahora el prompt del asistente. Al completar los campos del JSON, el asistente parece seguir varios pasos distintos. Quizá podamos ejecutarlos en paralelo.
Sin embargo, supongamos que hicimos algunas pruebas y descubrimos que separar los pasos de razonamiento del JSON empeora las respuestas. En ese caso, necesitamos explorar otras soluciones.
¿Podríamos usar GPT-3.5 con ajuste fino en lugar de GPT-4? Tal vez, aunque, en general, conviene dejar las respuestas abiertas del asistente a cargo de GPT-4, que puede manejar mejor una mayor variedad de casos. Si examinamos los pasos de razonamiento por separado, quizá no todos exijan la capacidad de razonamiento de GPT-4. Como su alcance es limitado y está bien definido, podrían resolverse bien con ajuste fino.
{
message_is_conversation_continuation: "True", // <-
number_of_messages_in_conversation_so_far: "1", // <-
user_sentiment: "Aggravated", // <-
query_type: "Hardware Issue", // <-
response_tone: "Validating and solution-oriented", // <-
response_requirements: "Propose options for repair or replacement.", // <-
user_requesting_to_talk_to_human: "False", // <-
enough_information_in_context: "True", // <-
response: "...", // X -- benefits from GPT-4
};Esto nos plantea una disyuntiva. ¿Mantenemos una sola solicitud cuya respuesta genera íntegramente GPT-4 o la dividimos en dos solicitudes consecutivas y usamos GPT-3.5 para todo salvo la respuesta final? Aquí entran en conflicto dos principios: la primera opción nos permite hacer menos solicitudes, pero la segunda podría permitirnos procesar los tokens más rápido.
Como sucede con muchas decisiones de optimización, la respuesta dependerá de los detalles. Por ejemplo:
- La proporción de tokens del campo
responserespecto de los demás campos. - La reducción promedio de la latencia al procesar más rápido la mayoría de los campos.
- El aumento promedio de la latencia al hacer dos solicitudes en lugar de una.
La conclusión variará según el caso. La mejor manera de decidir es hacer pruebas con ejemplos de producción. En este caso, supongamos que las pruebas indican que conviene dividir el prompt en dos para procesar los tokens más rápido.
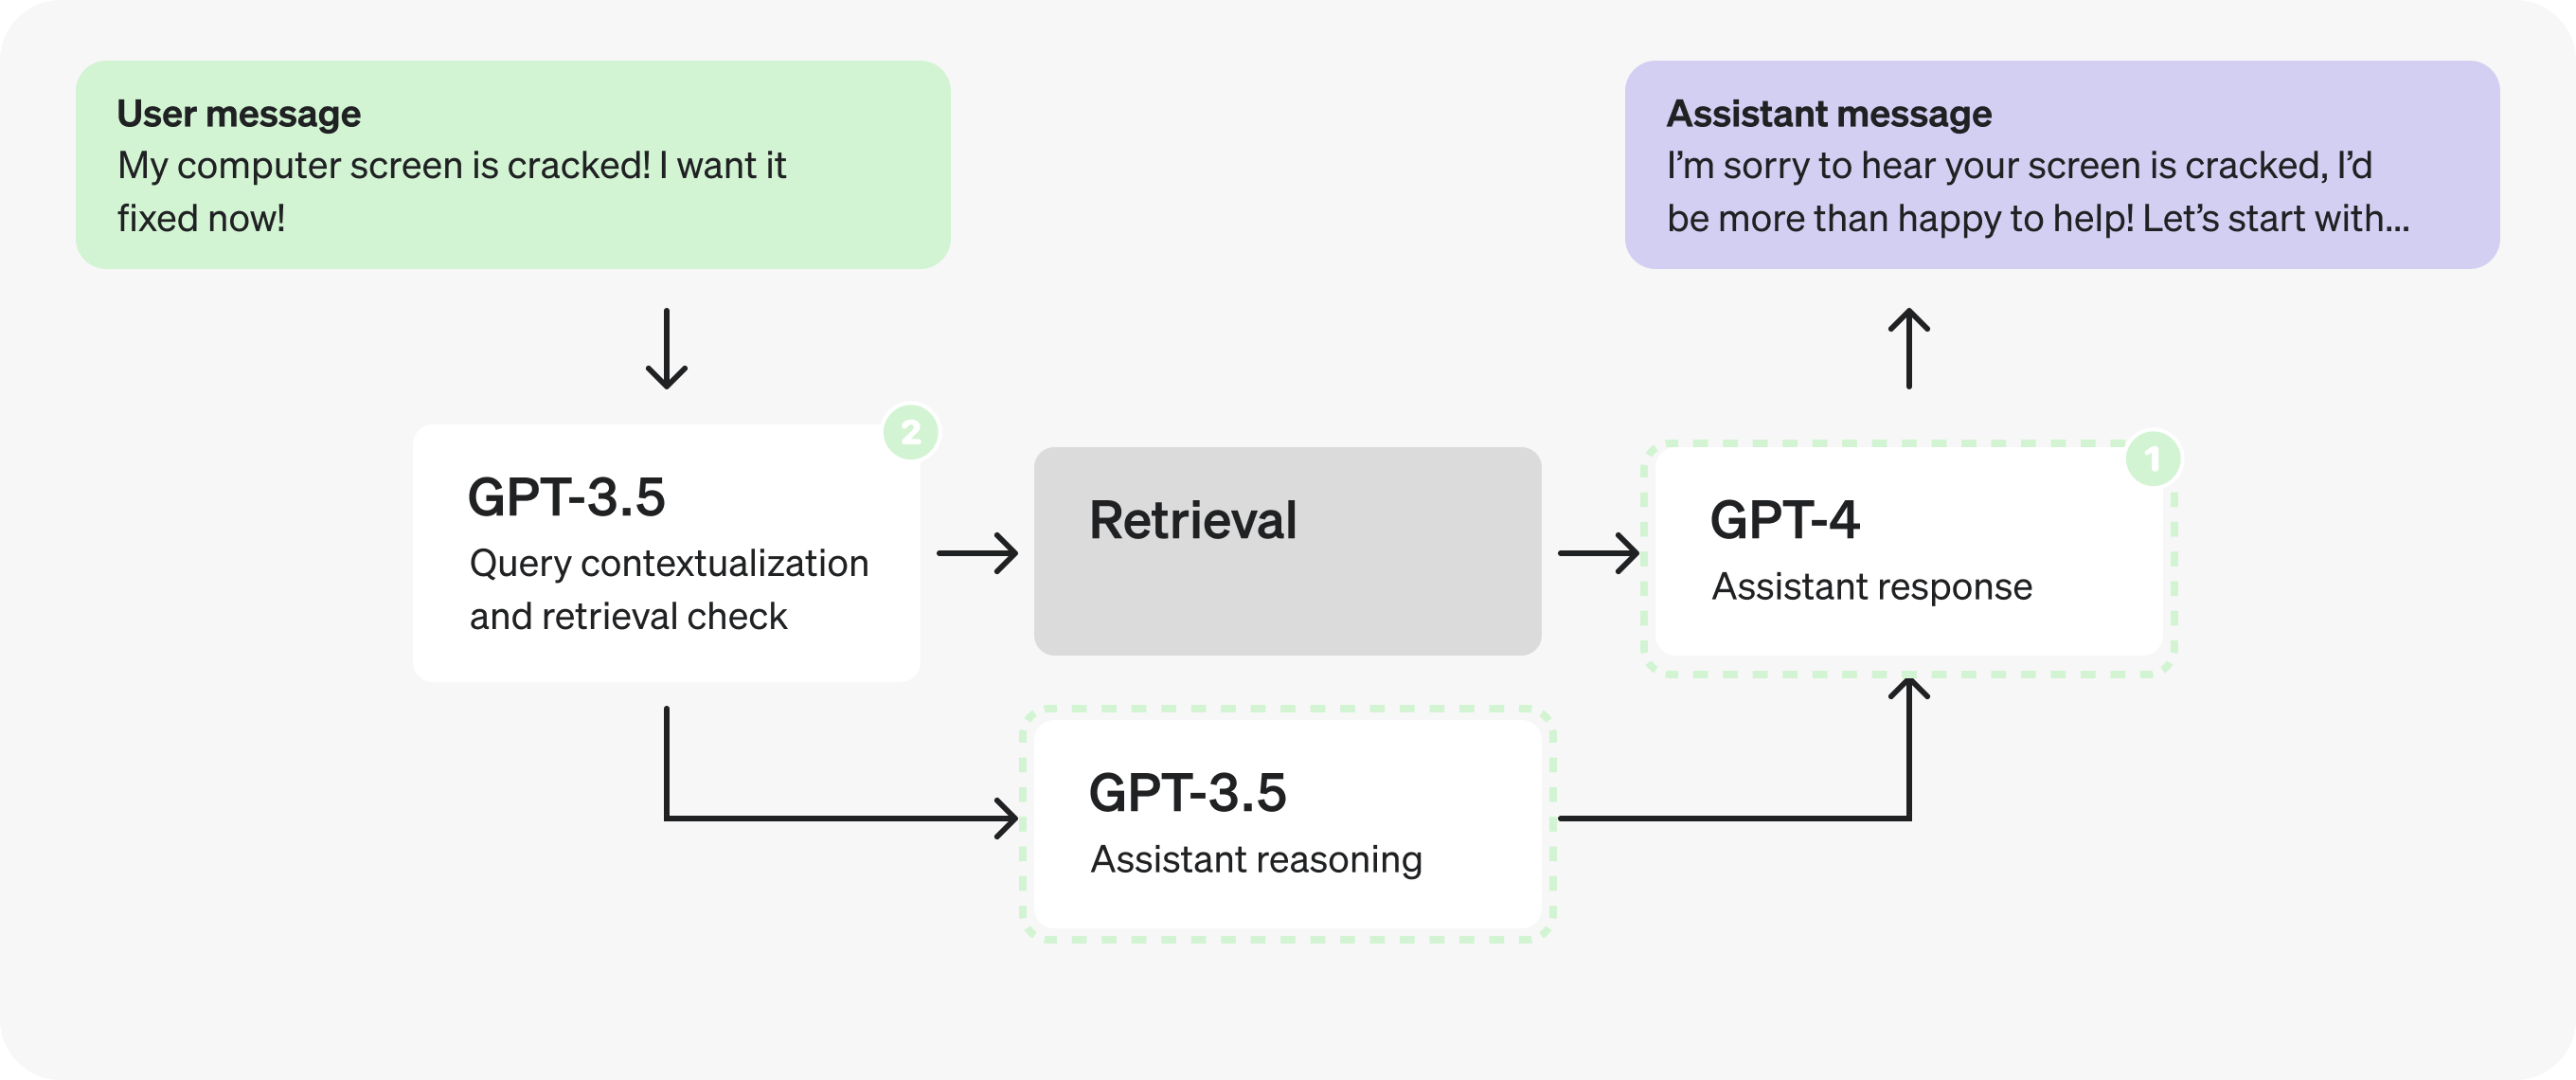
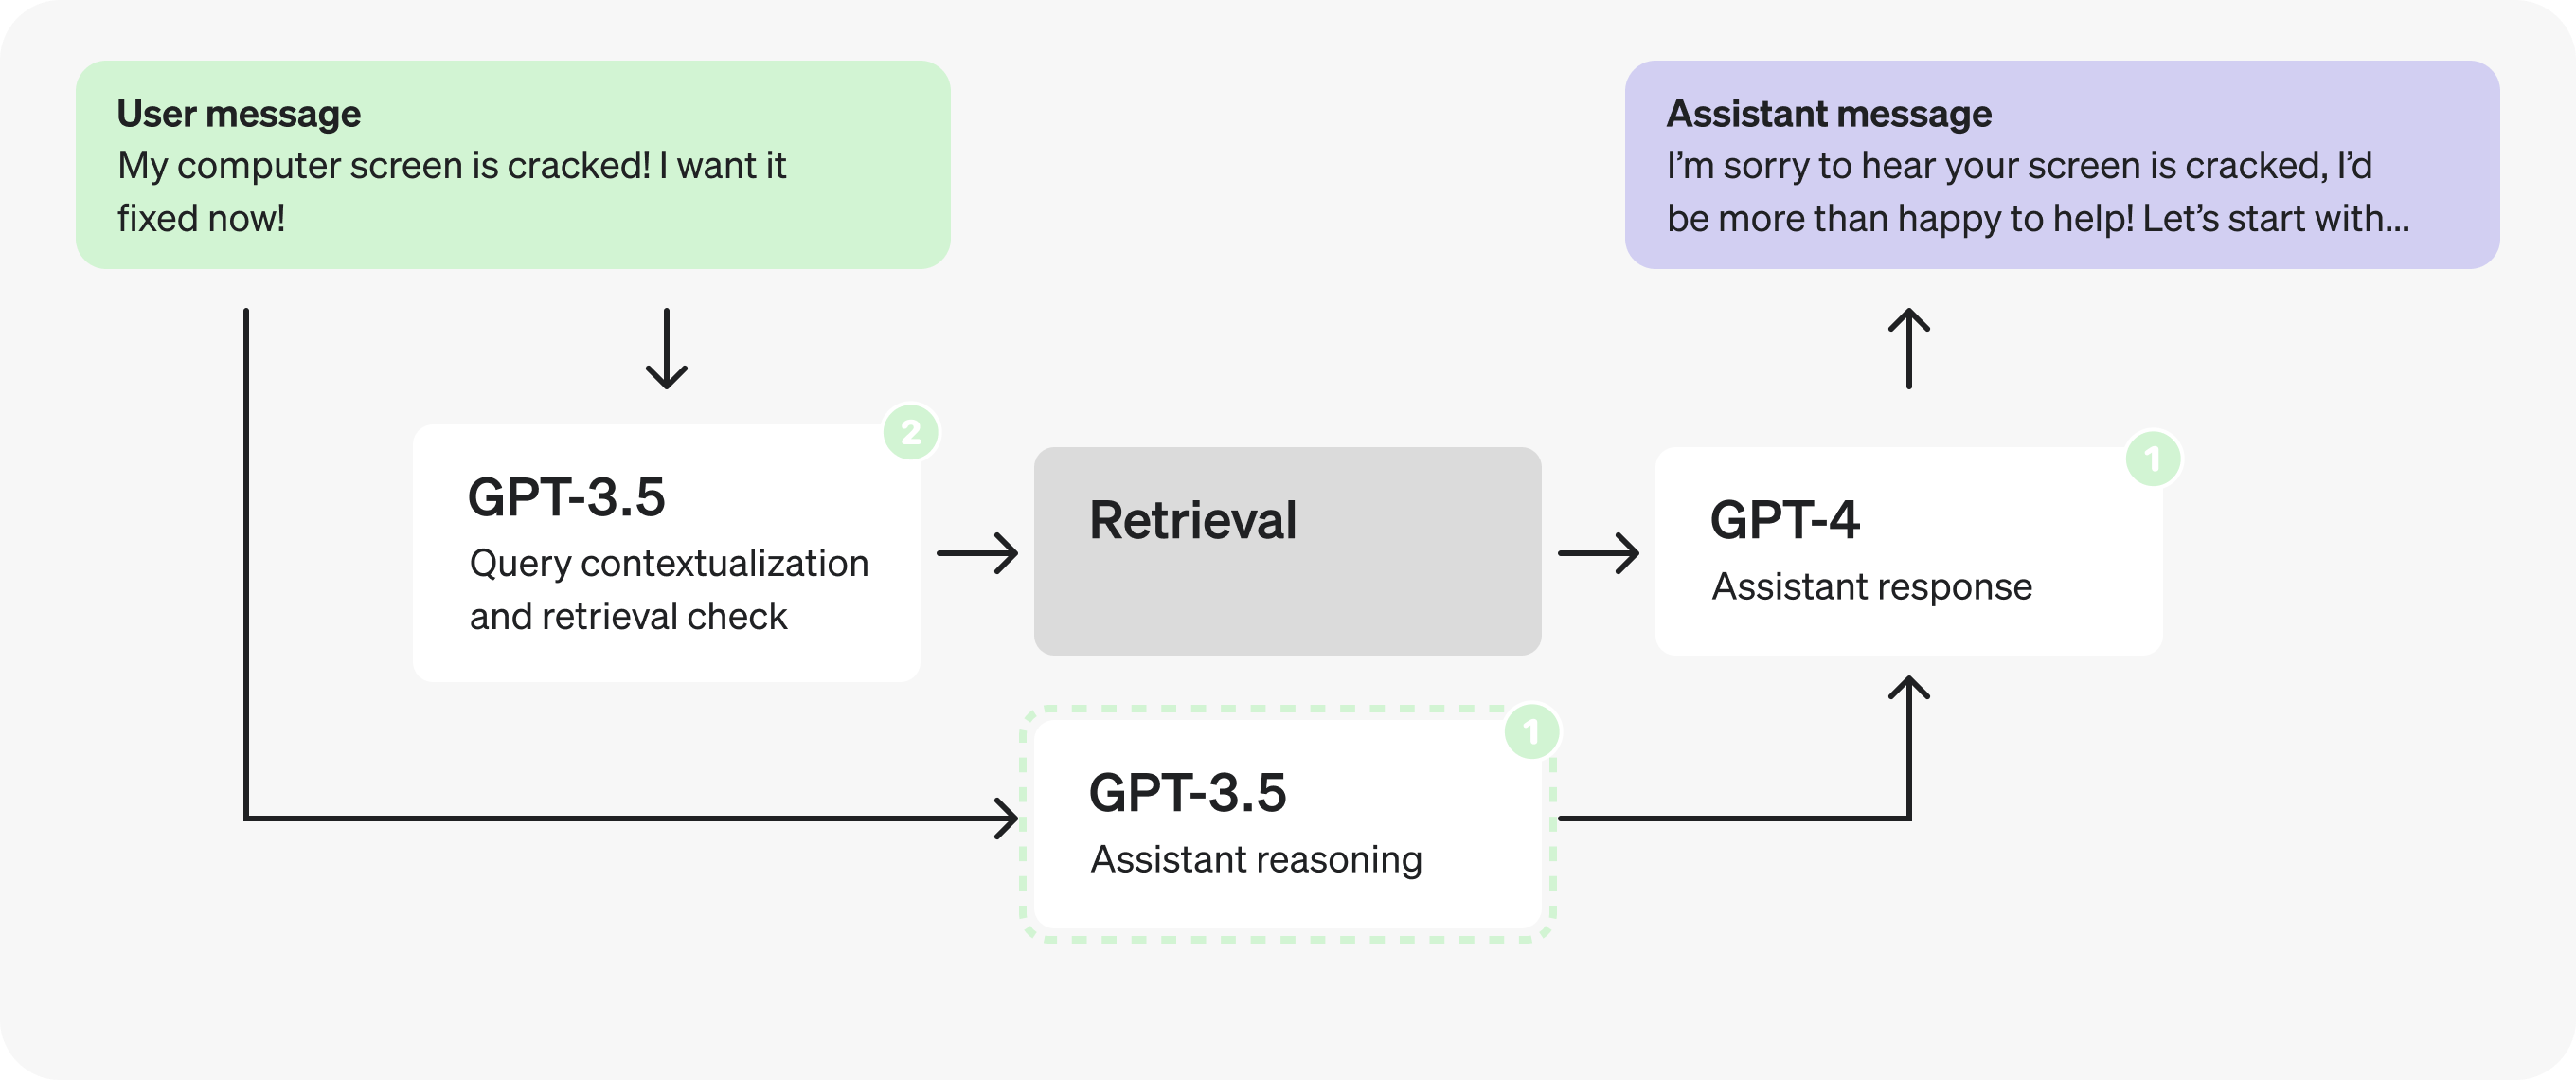
Nota: agruparemos response y enough_information_in_context en el segundo prompt para evitar pasar el contexto recuperado a los dos prompts nuevos.
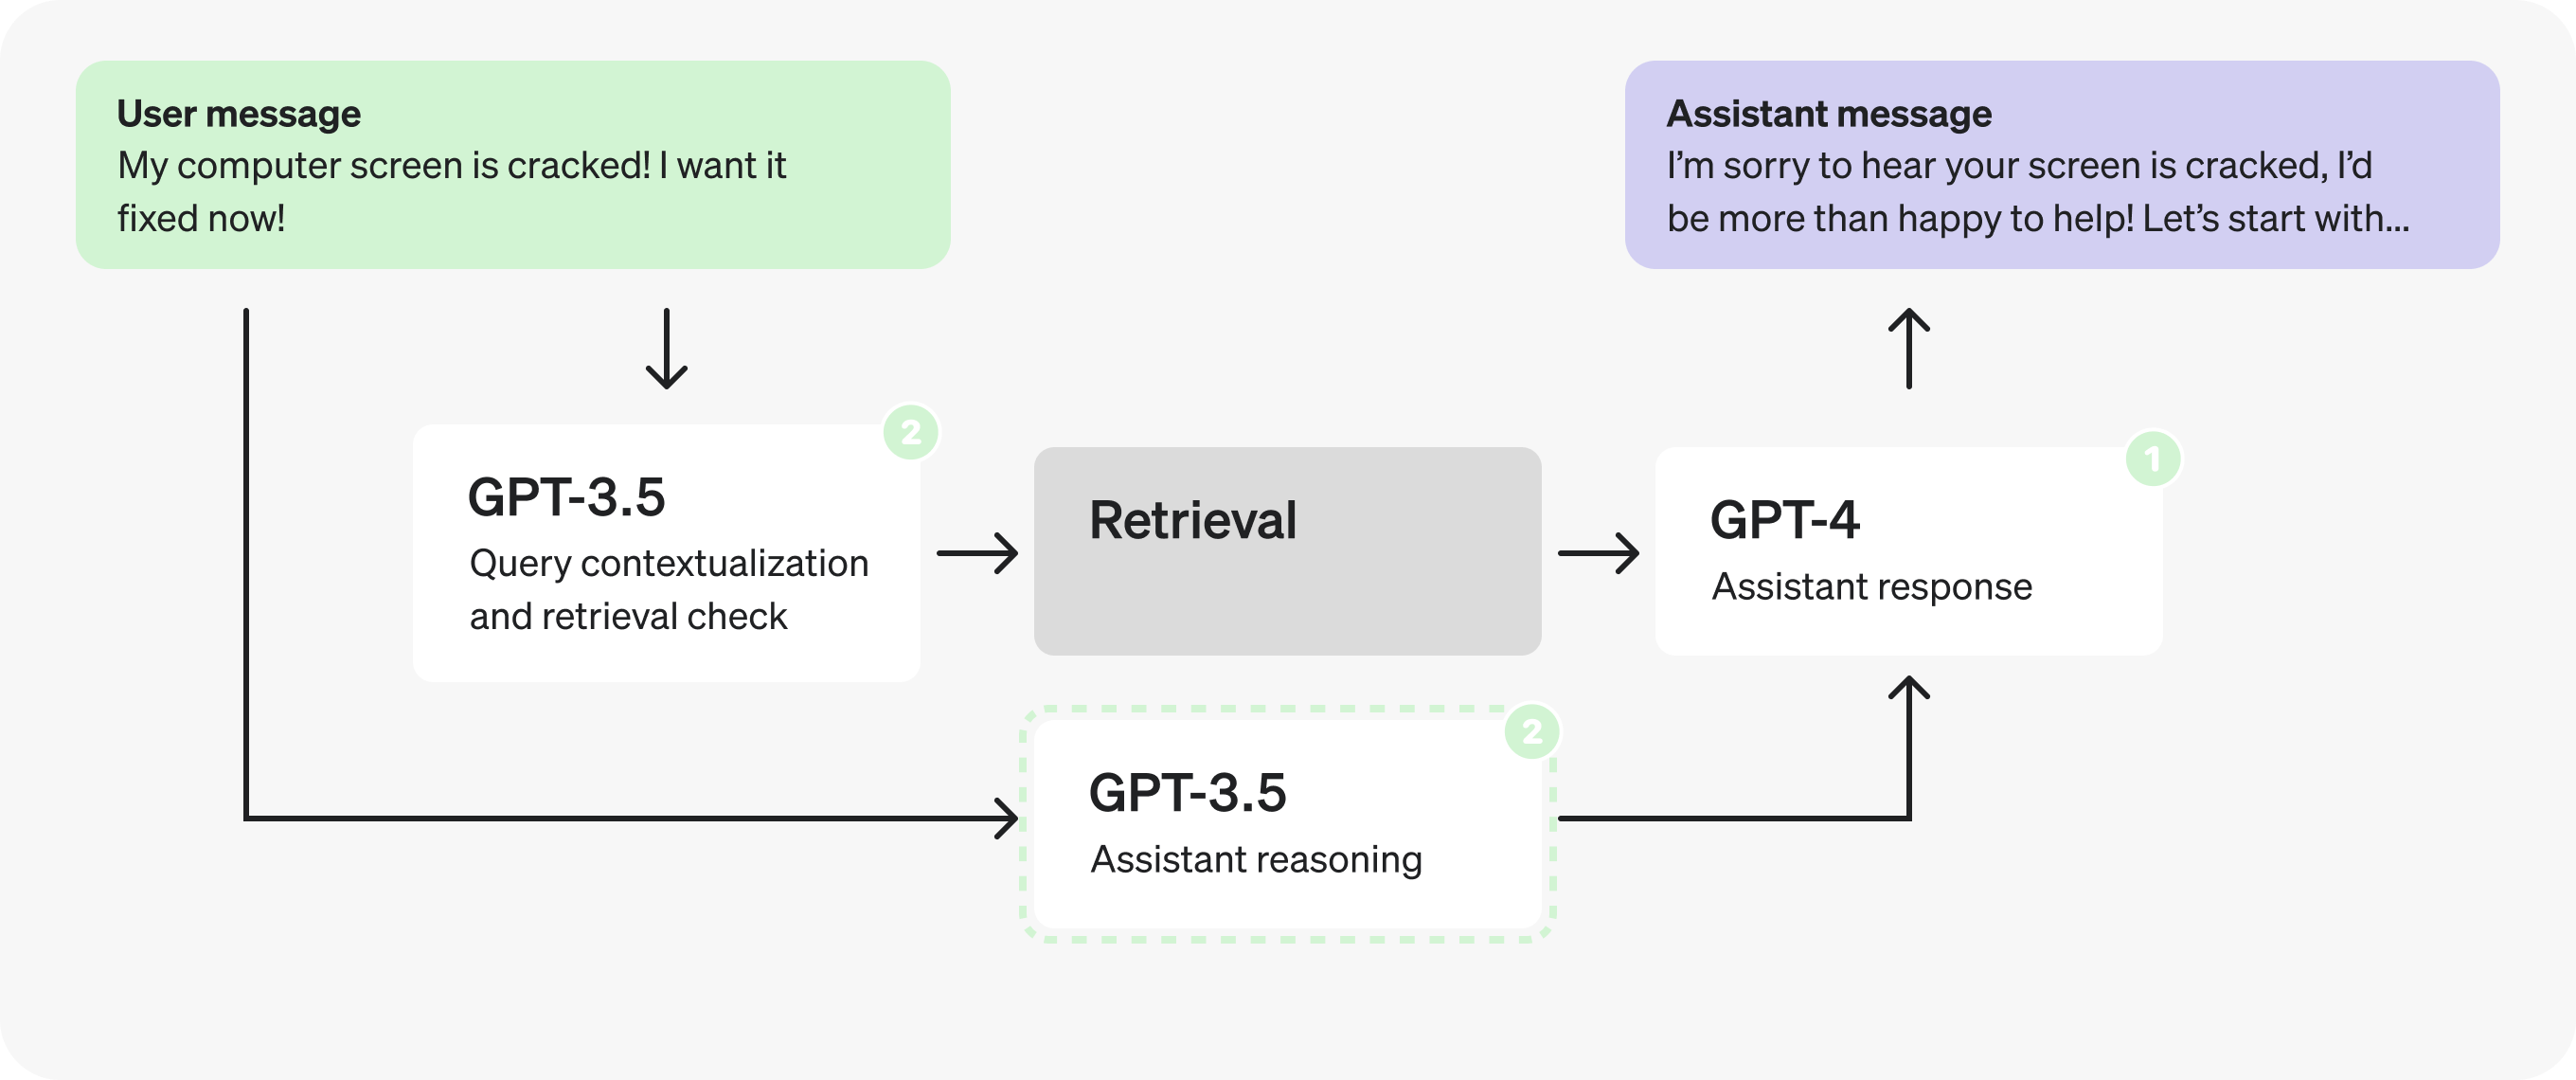
Ahora que el prompt de razonamiento ya no depende del contexto recuperado, podemos ejecutar las llamadas en paralelo y enviar ese prompt al mismo tiempo que los de recuperación de información.
Parte 3: optimización del resultado estructurado
Volvamos al prompt de razonamiento.
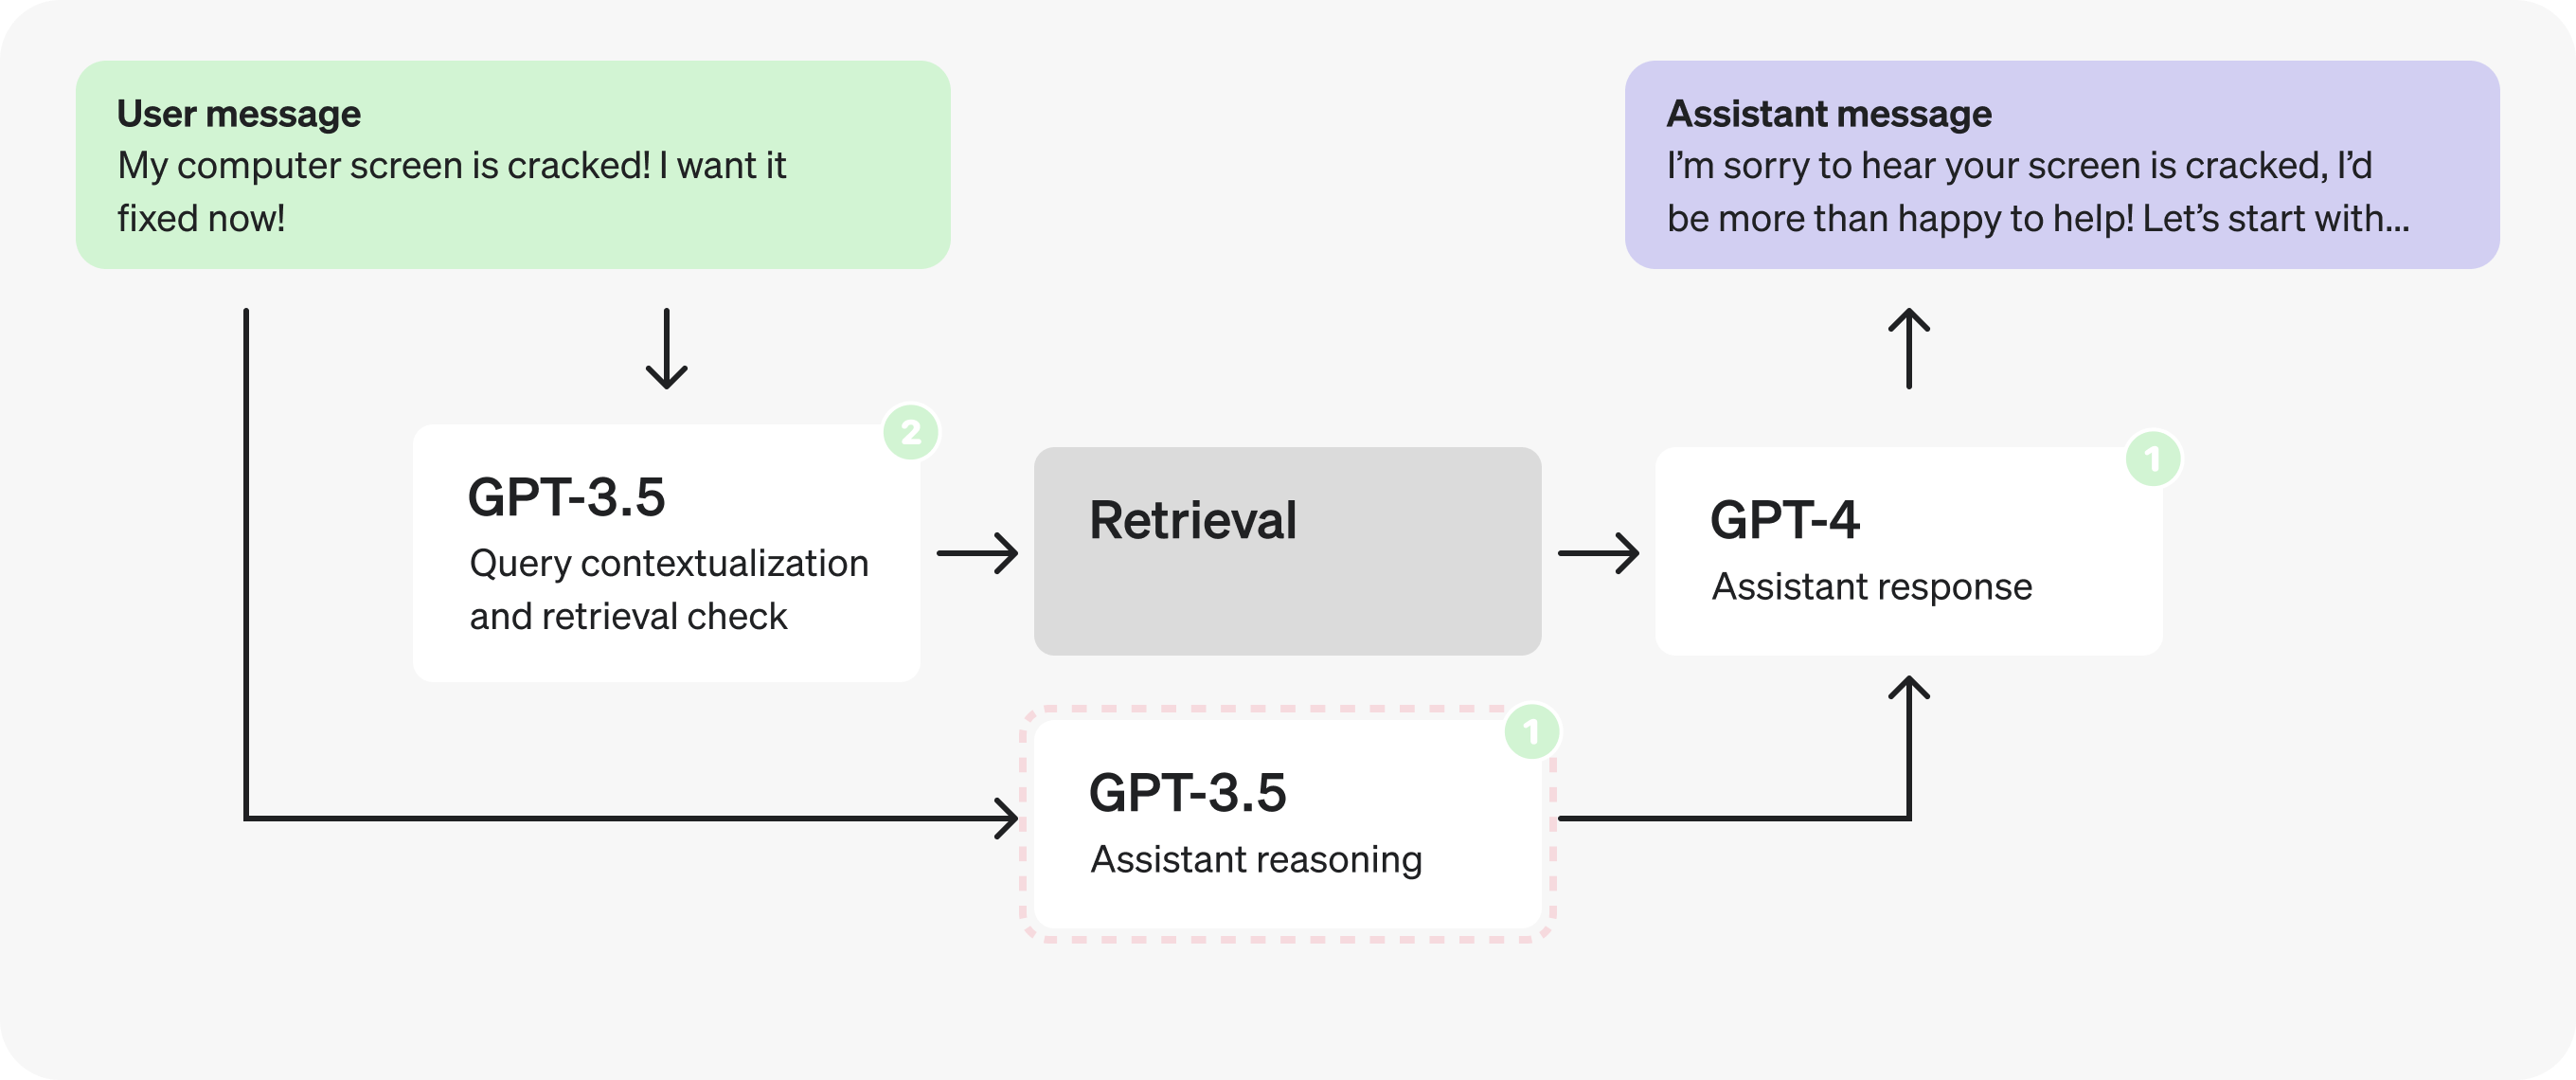
Si examinas el JSON de razonamiento, verás que los nombres de los campos son bastante largos.
{
message_is_conversation_continuation: "True", // <-
number_of_messages_in_conversation_so_far: "1", // <-
user_sentiment: "Aggravated", // <-
query_type: "Hardware Issue", // <-
response_tone: "Validating and solution-oriented", // <-
response_requirements: "Propose options for repair or replacement.", // <-
user_requesting_to_talk_to_human: "False", // <-
};Si los acortamos y pasamos las explicaciones a los comentarios, podemos generar menos tokens.
{
cont: "True", // whether last message is a continuation
n_msg: "1", // number of messages in the continued conversation
tone_in: "Aggravated", // sentiment of user query
type: "Hardware Issue", // type of the user query
tone_out: "Validating and solution-oriented", // desired tone for response
reqs: "Propose options for repair or replacement.", // response requirements
human: "False", // whether user is expressing want to talk to human
};
Este pequeño cambio eliminó 19 tokens de salida. Con GPT-3.5, el ahorro quizá sea de apenas unos milisegundos, pero con GPT-4 podría llegar a un segundo.
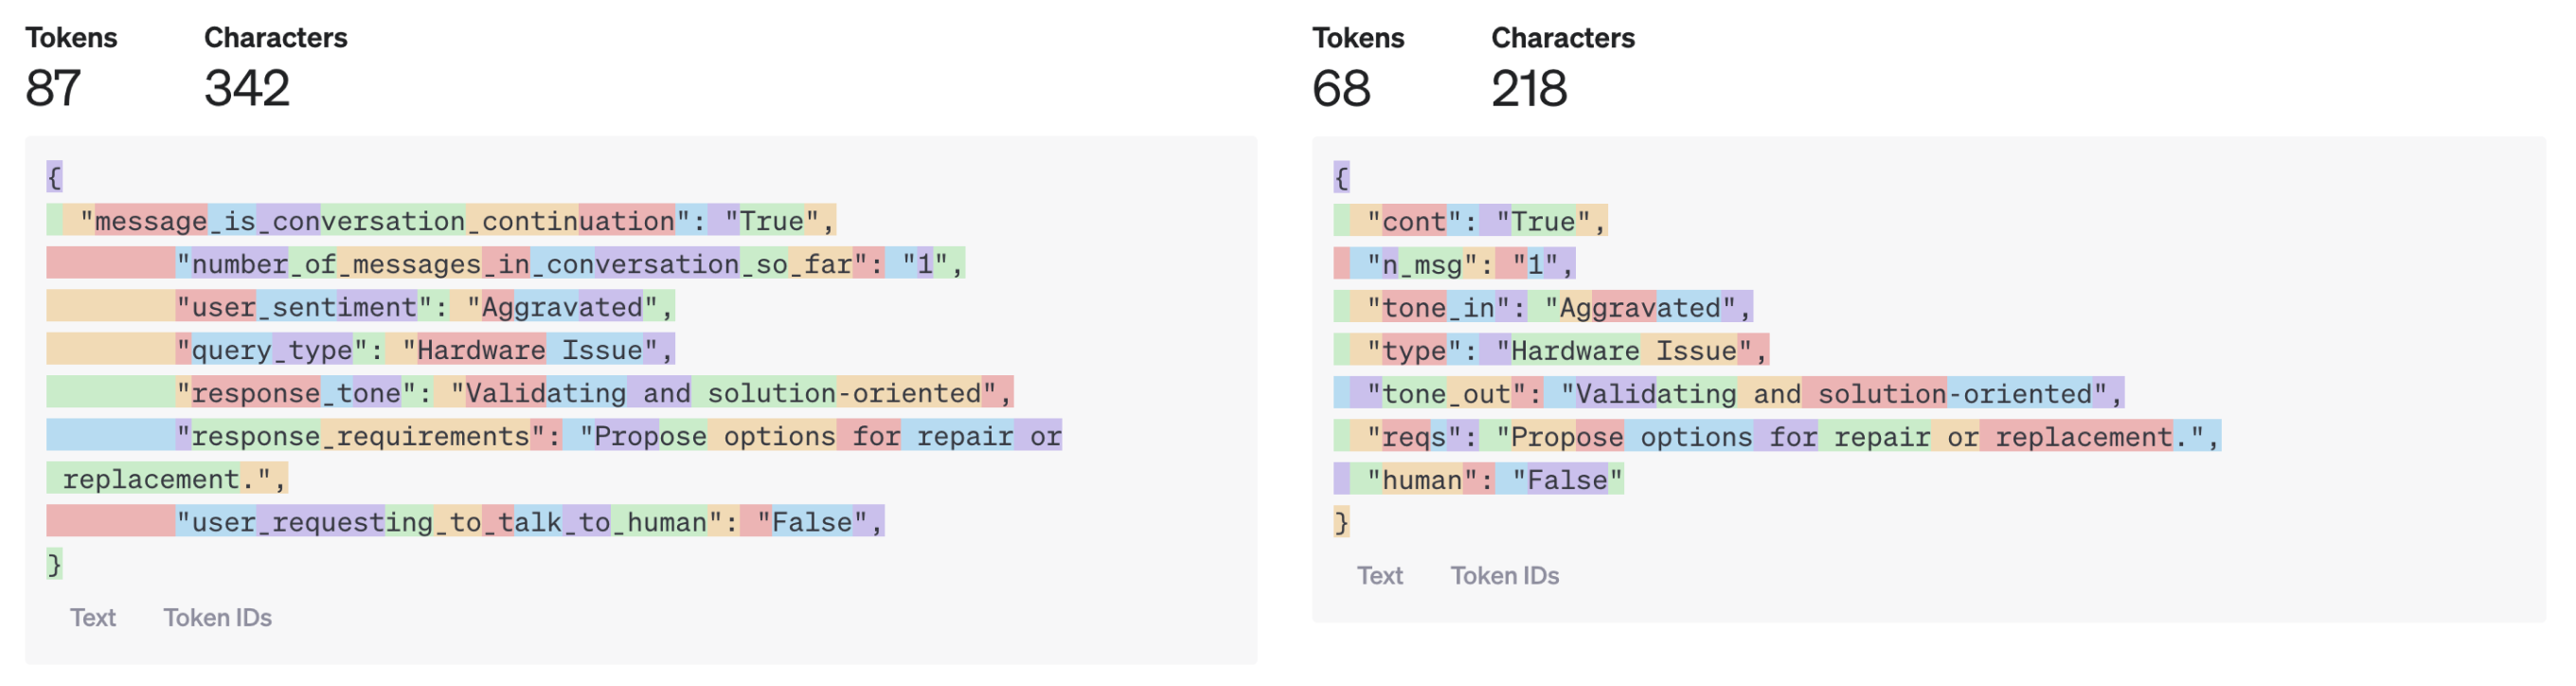
Como puedes imaginar, el ahorro puede ser considerable cuando el modelo genera salidas más extensas.
Podríamos ir más lejos y usar un solo carácter para el nombre de cada campo del JSON o colocar todo en un arreglo, pero eso podría empezar a perjudicar la calidad de las respuestas. Una vez más, la mejor forma de saberlo es hacer pruebas.
Resumen del ejemplo
Repasemos las optimizaciones que implementamos en el bot de atención al cliente del ejemplo:
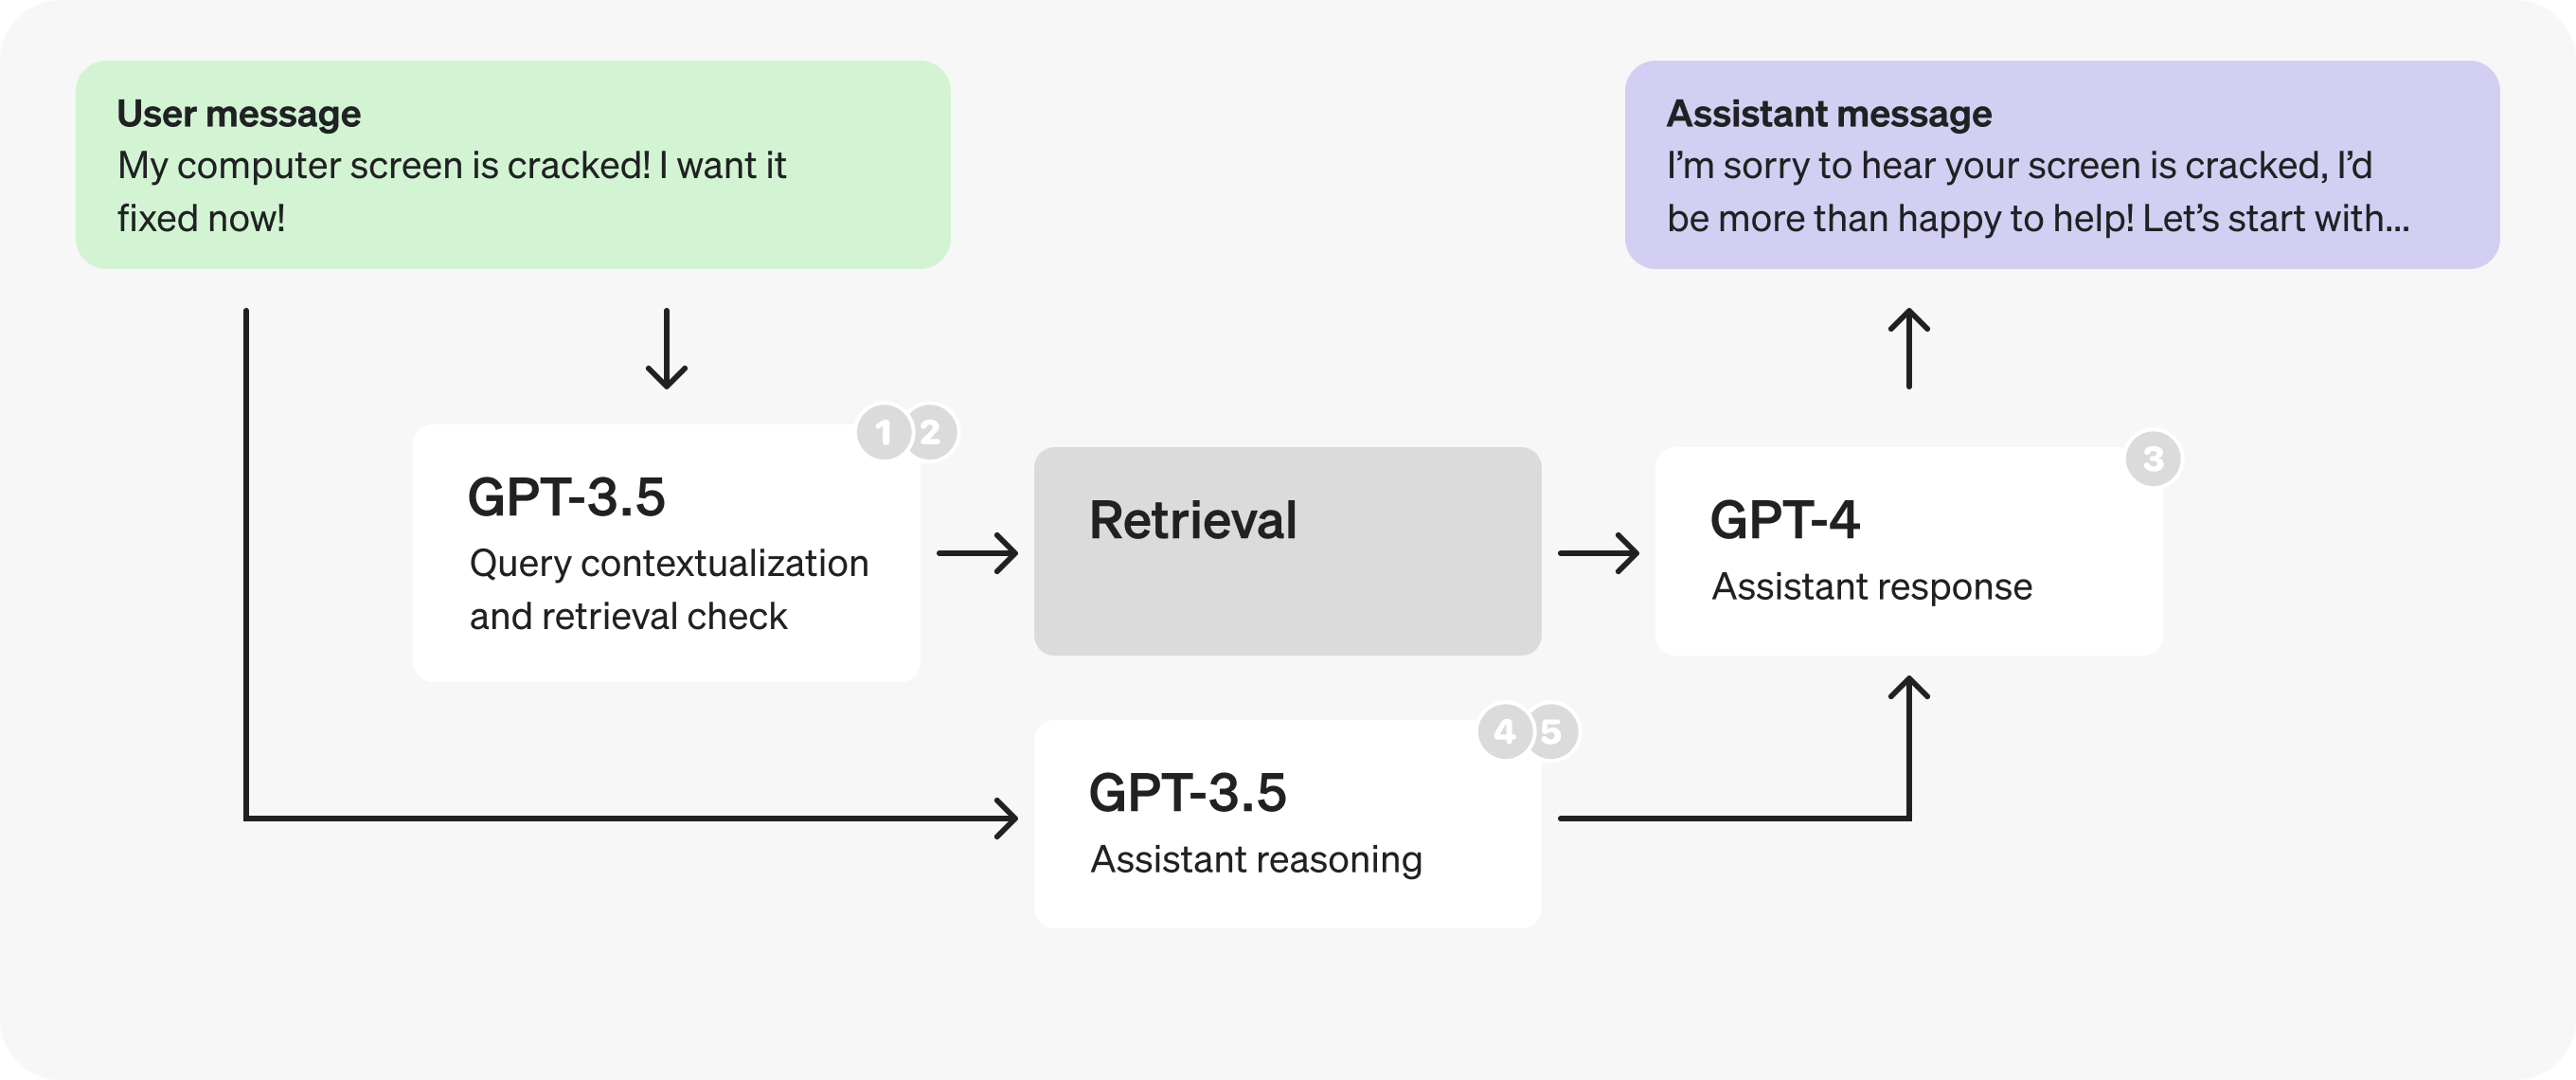
- Combinamos la contextualización de la consulta y la verificación de si hacía falta una búsqueda en tiempo real para hacer menos solicitudes.
- Para el nuevo prompt, pasamos a GPT-3.5, un modelo más pequeño al que aplicamos ajuste fino, para procesar los tokens más rápido.
- Dividimos el prompt del asistente en dos y pasamos a GPT-3.5, un modelo más pequeño con ajuste fino, para la parte de razonamiento, también con el fin de procesar los tokens más rápido.
- Ejecutamos en paralelo la verificación de si hacía falta una búsqueda en tiempo real y los pasos de razonamiento.
- Acortamos los nombres de los campos de razonamiento y trasladamos los comentarios al prompt para generar menos tokens.