
Descripción general
El modo multiagente permite que un modelo cree subagentes, coordine su trabajo en paralelo y sintetice sus resultados en una respuesta final. Es especialmente eficaz en aplicaciones con tareas complejas que se benefician de delegar trabajo en paralelo, como explorar una base de código, redactar documentación o implementar código.
El modo multiagente está disponible en versión beta con GPT-6.1 Sol y todos los modelos GPT-5.6. Consulta la página del modelo antes de activar el modo multiagente en tu aplicación.
Cuándo usar el modo multiagente
A menudo puedes dividir una tarea en partes independientes. Un solo agente las completaría una tras otra, pero varios agentes pueden abordarlas en paralelo. En el modo multiagente, un agente raíz puede delegar trabajo a varios subagentes que lo realizan de forma simultánea. Esto puede ofrecer varias ventajas:
- Ejecución en paralelo. Las tareas independientes de investigación, análisis o implementación pueden avanzar al mismo tiempo, lo que puede reducir el tiempo de ejecución.
- Contexto específico para cada tarea. Cada subagente recibe una tarea bien delimitada y mantiene su propio contexto. Así se reduce la interferencia entre tareas que no guardan relación y mejora el rendimiento.
- Coordinación a cargo del modelo. El agente raíz puede crear subagentes, enviarles información adicional, esperar sus resultados y sintetizarlos en una respuesta final sin que tengas que implementar la orquestación en tu aplicación.
La orquestación multiagente resulta más útil cuando puedes dividir una tarea en actividades concretas e independientes, como las siguientes:
- Explorar distintas partes de una base de código extensa
- Comparar varias propuestas, documentos o hipótesis
- Investigar varias fuentes en paralelo
- Implementar componentes independientes o escribir conjuntos de pruebas independientes
- Investigar en paralelo distintas causas posibles de una falla
- Explorar al mismo tiempo distintos enfoques para resolver un problema
Ten en cuenta que agregar subagentes puede aumentar el consumo de tokens. También puede resultar menos útil si la tarea depende de una sola secuencia ordenada de razonamiento, requiere escrituras frecuentes en un estado mutable compartido o si una sola operación externa lenta ya consume la mayor parte del tiempo de ejecución.
| Usa el modo multiagente cuando | Prefiere un solo agente cuando |
|---|---|
| Puedes dividir el trabajo en tareas independientes y bien delimitadas | Cada paso depende directamente del anterior |
| Un contexto separado ayuda a cada agente a concentrarse en su tarea | La tarea es lo bastante pequeña como para completarla en una sola ejecución breve |
| La exploración en paralelo puede reducir el tiempo total transcurrido | Los agentes competirían por el mismo recurso mutable |
| Comparar resultados independientes permite cubrir más aspectos de la tarea | Necesitas un grafo de ejecución fijo y determinista |
Inicio rápido
Los ejemplos de Python y JavaScript usan el SDK beta de Responses. Para las solicitudes HTTP,
usa client.beta.responses y pasa responses_multi_agent=v1 en el argumento
betas. Para las solicitudes HTTP directas y las conexiones WebSocket, incluye
OpenAI-Beta: responses_multi_agent=v1 en los encabezados de la solicitud o de la conexión.
Los esquemas de los elementos pueden cambiar mientras el modo multiagente esté en versión beta.
Activa el modo multiagente en tu solicitud a la API de Responses con multi_agent.enabled. Cuando multi_agent.enabled tiene el valor true, el agente raíz puede crear un árbol de subagentes. Los subagentes comparten el modelo y las herramientas disponibles en la solicitud. Para coordinarse, los agentes usan operaciones básicas de colaboración que les permiten crear subagentes, enviar mensajes y esperar resultados (consulta Cómo funciona el modo multiagente). El agente raíz se encarga de sintetizar las respuestas de los subagentes y entregar la respuesta final.
from openai import OpenAI
client = OpenAI()
def review_pull_request(diff: str) -> str:
response = client.beta.responses.create(
model="gpt-6.1-sol",
input=(
"Review the pull-request diff below with three agents: one for "
"correctness, one for security, and one for missing tests. "
"Reconcile duplicate or conflicting findings, then return a "
"prioritized review with file and line references.\n\n"
f"<diff>\n{diff}\n</diff>"
),
multi_agent={
"enabled": True,
"max_concurrent_subagents": 3,
},
betas=["responses_multi_agent=v1"],
)
return "".join(
part.text
for item in response.output
if (
item.type == "message"
and item.agent is not None
and item.agent.agent_name == "/root"
and item.phase == "final_answer"
)
for part in item.content
if part.type == "output_text"
)max_concurrent_subagents establece el número máximo de subagentes que pueden estar activos al mismo tiempo en todo el árbol de agentes. Incluye a todos los descendientes (hijos, nietos y subagentes de niveles inferiores) y excluye al agente raíz.
La API no impone un límite superior fijo para este parámetro. El valor predeterminado es 3 y es el recomendado para la mayoría de las cargas de trabajo. Tampoco hay un límite fijo para la profundidad del árbol ni para el número total de subagentes que se pueden crear durante una ejecución en modo multiagente.
Agrega un mensaje de desarrollador para ajustar cuándo debe crear subagentes el modelo del agente raíz. Este mensaje complementa las instrucciones que se inyectan para el agente raíz y los subagentes.
Ejemplos de mensajes de desarrollador:
- “Crea subagentes solo si el usuario pide explícitamente usar subagentes, delegar tareas o trabajar con agentes en paralelo”.
- “La delegación proactiva en modo multiagente está activa. Usa subagentes cuando el trabajo en paralelo pueda mejorar considerablemente la velocidad o la calidad”.
Cómo funciona el modo multiagente
La API de Responses proporciona a los modelos del agente raíz y de los subagentes acciones de orquestación alojadas en la API e instrucciones para usarlas. El agente raíz se llama /root. Los subagentes que se crean usan rutas jerárquicas como estas:
/root
├── /root/researcher
├── /root/reviewer
└── /root/reviewer/tester
El modo multiagente no impone un límite fijo para el número total de subagentes ni para la profundidad del árbol. Para la mayoría de las tareas, usa el valor predeterminado de max_concurrent_subagents, que es 3. Este parámetro limita el número de turnos activos de subagentes en todo el árbol, incluidos los de los hijos y los descendientes de niveles inferiores.
Cuando activas el modo multiagente, la API de Responses ofrece seis acciones de colaboración alojadas en la API. Pueden aparecer como elementos multi_agent_call. Tu aplicación no debe ejecutar estas acciones ni enviar resultados para ellas.
| Acción | Propósito |
|---|---|
spawn_agent |
Crea un subagente y le asigna su tarea inicial. |
send_message |
Pone un mensaje en la cola de un agente existente sin iniciar un turno nuevo. |
followup_task |
Asigna más trabajo a un agente existente distinto del agente raíz e inicia o reanuda su turno. |
wait_agent |
Espera a que llegue una actualización al buzón del agente que realiza la llamada. |
interrupt_agent |
Interrumpe el turno activo de otro agente sin eliminar su contexto. |
list_agents |
Devuelve el árbol actual de agentes, sus estados y el valor de last_task_message de cada agente. |
Las llamadas a herramientas definidas por el desarrollador se gestionan de la misma manera que cuando el modo multiagente está desactivado. Cualquier agente del árbol puede emitir un elemento function_call. Tu aplicación debe ejecutar la llamada y enviar el function_call_output correspondiente.
Ten en cuenta que todos los agentes del árbol tienen acceso a las herramientas configuradas para la llamada al modelo en la solicitud a la API.
Uso del modo multiagente en la API de Responses
Comparación del rendimiento de HTTP y WebSocket
HTTP y WebSocket admiten las mismas funciones del modo multiagente, pero se recomienda WebSocket para flujos de trabajo de larga duración o que hacen un uso intensivo de herramientas. Su conexión persistente permite que tu aplicación devuelva los resultados de las funciones en cuanto estén disponibles. Esto reduce el costo de reanudar la ejecución y el tiempo que los agentes pasan esperando.
Con HTTP, la respuesta se completa cuando todos los agentes activos han terminado o se han detenido a la espera de que el cliente ejecute una función. Tu aplicación ejecuta entonces todas las llamadas a funciones pendientes y envía sus resultados en una nueva solicitud a la API de Responses para que los agentes en pausa puedan reanudar su trabajo.
Con WebSocket, tu aplicación puede inyectar el resultado de cada función en la respuesta en cuanto esté disponible, sin esperar a que se complete la respuesta activa. El agente que está en espera puede reanudar su tarea de inmediato mientras los demás siguen trabajando. Esto reduce las demoras de coordinación y evita intercambios adicionales de solicitudes y respuestas cuando los agentes terminan o solicitan herramientas en distintos momentos.
HTTP puede ser suficiente para flujos de trabajo que requieren llamadas a varias herramientas alojadas, como las búsquedas web en paralelo, o para flujos de una sola solicitud con pocas llamadas a funciones. En la mayoría de los flujos de trabajo multiagente, es probable que WebSocket ofrezca menor latencia y mejor rendimiento de principio a fin.
Ejecución de llamadas a funciones con HTTP
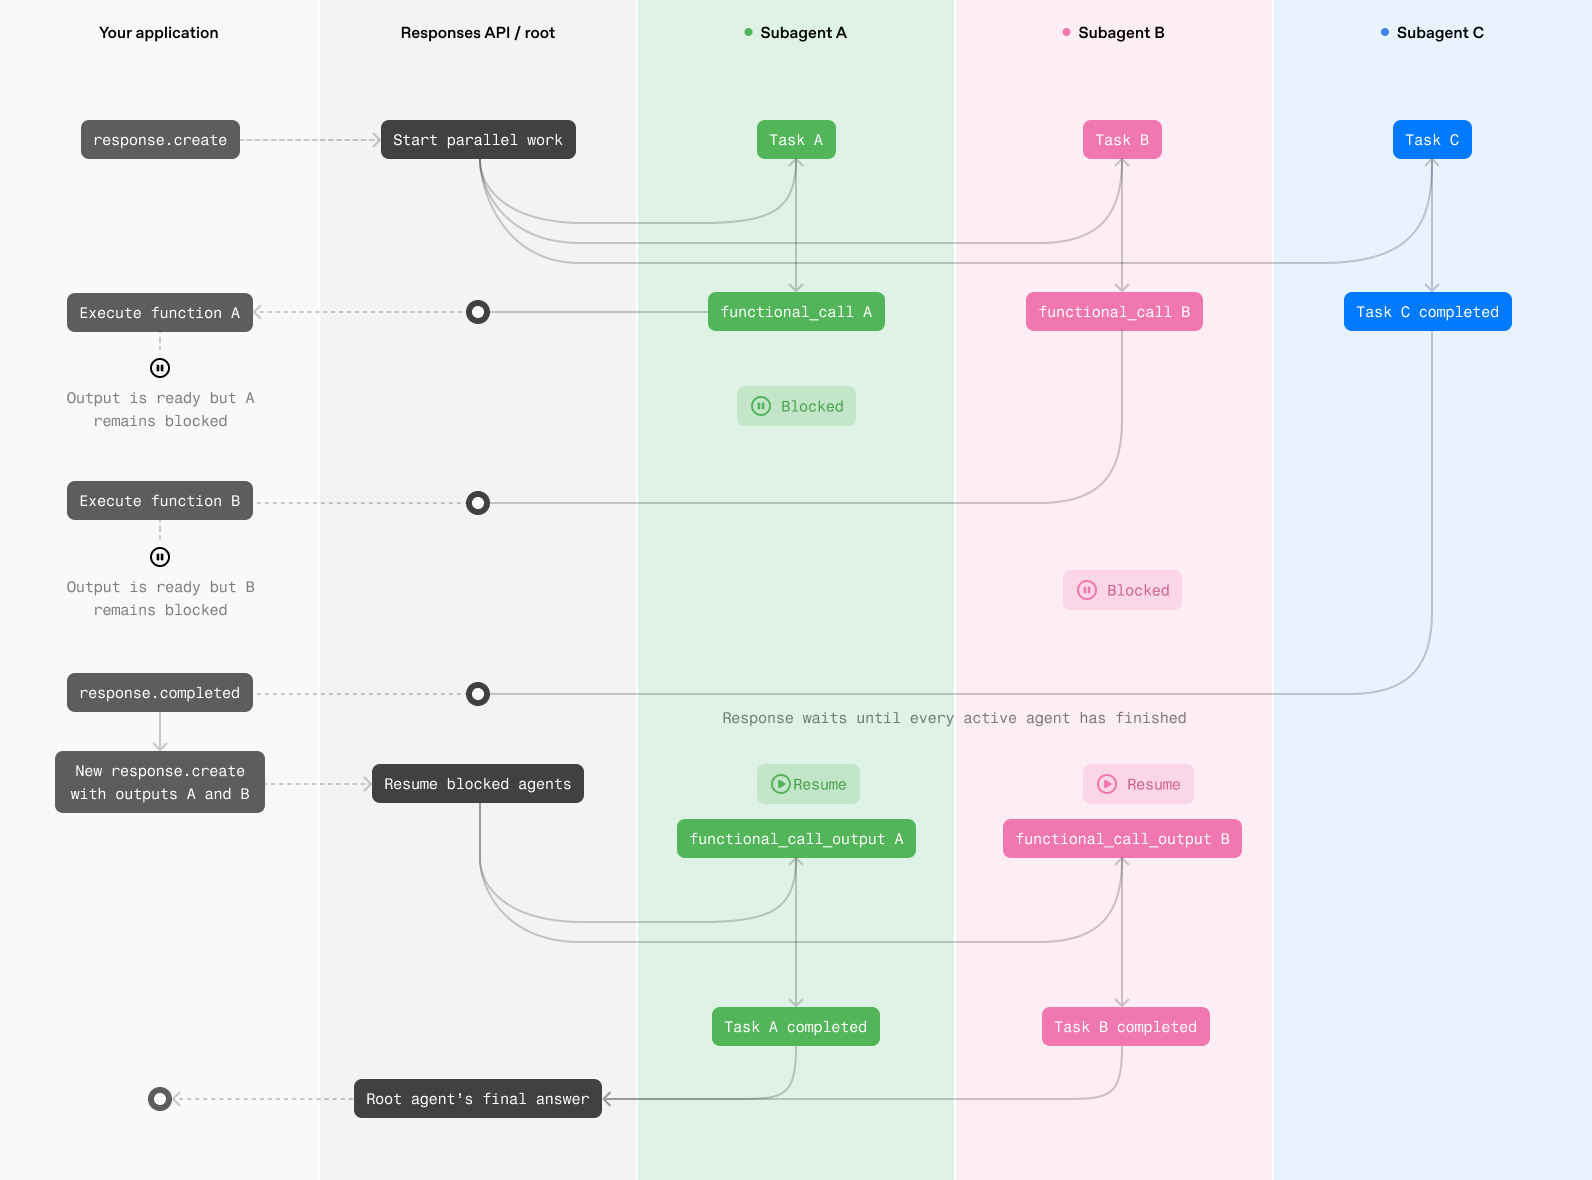
Ejecución de llamadas a funciones con WebSocket
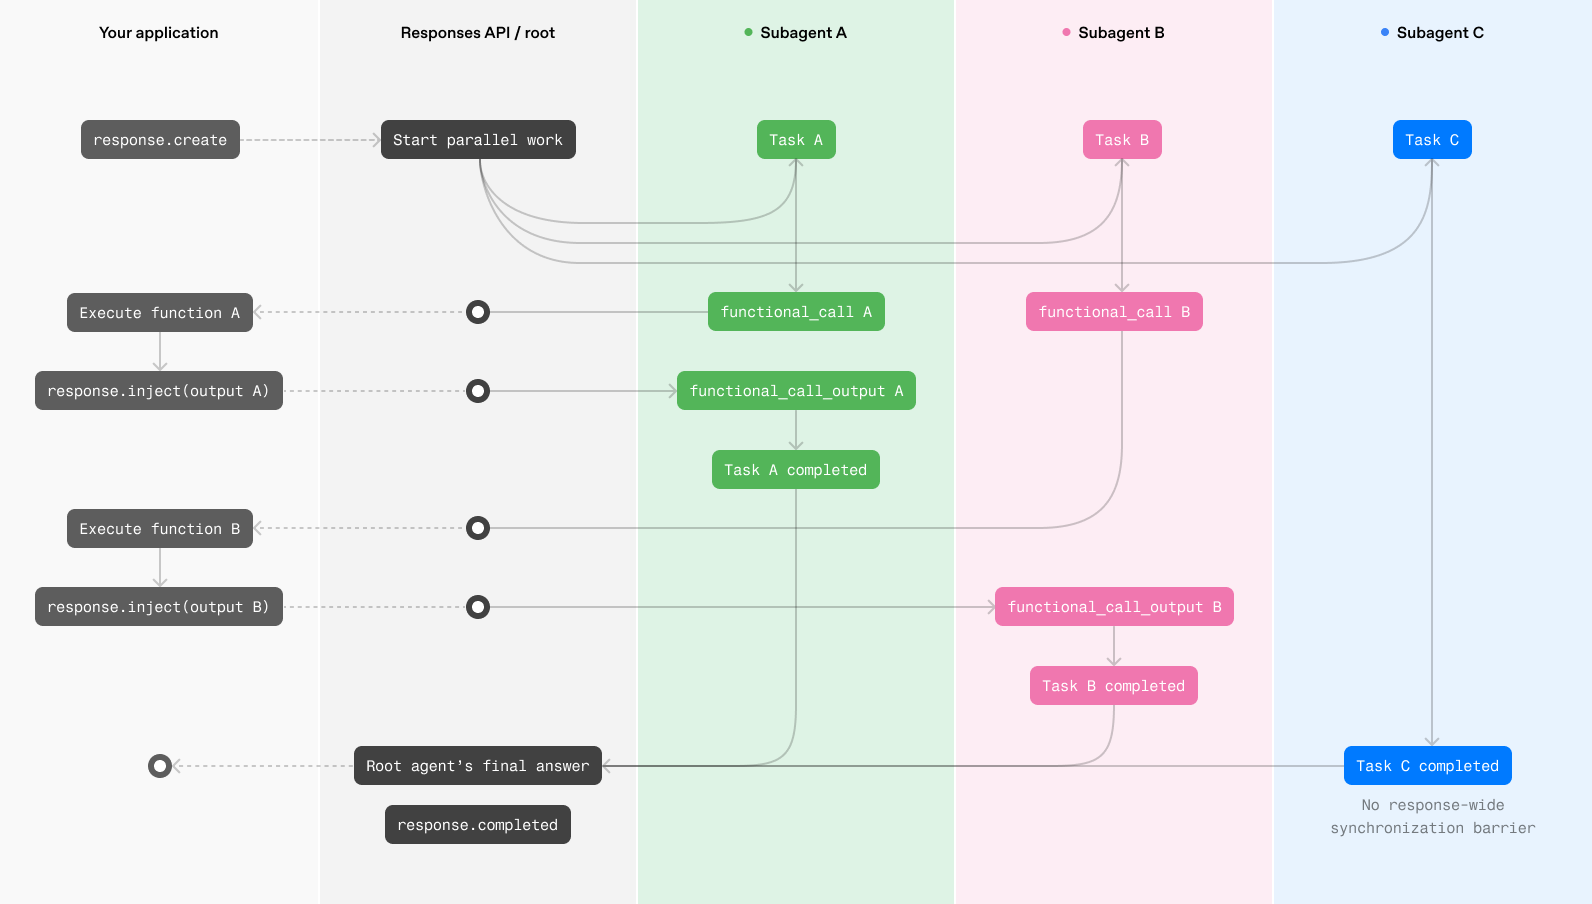
HTTP
Estos ejemplos requieren versiones beta del SDK que den acceso a la versión beta de la API de Responses. Para la transmisión por HTTP, llama a client.beta.responses.create y pasa responses_multi_agent=v1 mediante el argumento betas. Así se habilitan los tipos beta y el autocompletado. En Python, importa los tipos de elementos de respuesta beta desde openai.types.beta cuando agregues anotaciones de tipo.
Ejemplo de código del lado del cliente:
from __future__ import annotations
import json
import sys
from openai import OpenAI
from openai.types.beta import BetaResponseOutputItem
client = OpenAI()
ROOT = "/root"
PROPOSALS = {
"alpha": {"estimated_weeks": 6, "risk": "medium"},
"beta": {"estimated_weeks": 8, "risk": "low"},
}
tools = [
{
"type": "function",
"name": "get_proposal",
"description": "Return details for a proposal that the agents should compare.",
"parameters": {
"type": "object",
"properties": {
"proposal": {
"type": "string",
"enum": ["alpha", "beta"],
}
},
"required": ["proposal"],
"additionalProperties": False,
},
"strict": True,
}
]
history = [
{
"role": "user",
"content": (
"Use two subagents, one for proposal alpha and one for proposal beta. "
"Have each call get_proposal, then compare their findings."
),
}
]
def agent_name(item: BetaResponseOutputItem) -> str:
return item.agent.agent_name if item.agent else ROOT
def render_to_user(delta: str) -> None:
print(delta, end="", flush=True)
def log_subagent_text(agent: str, delta: str) -> None:
print(f"[{agent}] {delta}", end="", file=sys.stderr, flush=True)
def process_tool_call(name: str, arguments: str) -> str:
if name != "get_proposal":
raise ValueError(f"Unknown tool: {name}")
parsed_arguments = json.loads(arguments)
return json.dumps(PROPOSALS[parsed_arguments["proposal"]])
while True:
output_items = []
pending_calls = []
item_agents: dict[int, str] = {}
stream = client.beta.responses.create(
model="gpt-6.1-sol",
input=history,
tools=tools,
store=False,
multi_agent={
"enabled": True,
"max_concurrent_subagents": 3,
},
stream=True,
betas=["responses_multi_agent=v1"],
)
for event in stream:
if event.type == "response.output_item.added":
item_agents[event.output_index] = agent_name(event.item)
elif event.type == "response.output_text.delta":
agent = item_agents.get(event.output_index, ROOT)
if agent == ROOT:
render_to_user(event.delta)
else:
log_subagent_text(agent, event.delta)
elif event.type == "response.output_item.done":
output_items.append(event.item)
if event.item.type == "function_call":
# Handle function calls from both the root agent and subagents.
pending_calls.append(event.item)
elif event.type == "response.completed":
print(f"\nUsage: {event.response.usage}", file=sys.stderr)
break
elif event.type in {
"error",
"response.failed",
"response.incomplete",
}:
raise RuntimeError(event)
history.extend(output_items)
for call in pending_calls:
history.append(
{
"type": "function_call_output",
"call_id": call.call_id,
"output": process_tool_call(call.name, call.arguments),
}
)
if not pending_calls:
breakSi uno o más agentes llaman a funciones definidas por el desarrollador, ejecuta cada llamada pendiente y crea una solicitud de continuación que incluya sus resultados.
WebSocket
En modo WebSocket, cuando un agente llama a una función definida por el desarrollador, ejecuta la función en tu aplicación y envía su resultado a la respuesta activa mediante un evento response.inject. El agente que está en espera puede reanudar su tarea sin esperar a que se complete toda la respuesta multiagente.
{
"type": "response.inject",
"response_id": "resp_123",
"input": [
{
"type": "function_call_output",
"call_id": "call_123",
"output": "{\"temperature\":72}"
}
]
}Ante una solicitud response.inject válida, el servidor responde con uno de estos dos eventos:
response.inject.created: el servidor validó y aceptó la entrada para inyectarlaresponse.inject.failed: la entrada no se inyectó. Revisaerror.code
{
"type": "response.inject.created",
"sequence_number": 42,
"response_id": "resp_123"
}{
"type": "response.inject.failed",
"sequence_number": 43,
"response_id": "resp_123",
"input": [
{
"type": "function_call_output",
"call_id": "call_123",
"output": "{\"temperature\":72}"
}
],
"error": {
"code": "response_already_completed",
"message": "Response 'resp_123' has already completed."
}
}Si una solicitud no se ajusta al esquema de response.inject, el servidor envía un error genérico con el código de estado 400 y cierra la conexión WebSocket. Corrige la solicitud y abre una nueva conexión WebSocket antes de enviar otro evento.
El SDK beta de Python permite usar el modo WebSocket mediante client.beta.responses.connect. En el SDK beta de TypeScript, puedes acceder a este modo mediante ResponsesWS. Incluye OpenAI-Beta: responses_multi_agent=v1 en los encabezados de la conexión. A diferencia de la transmisión por HTTP, los conectores WebSocket aún no aceptan el argumento betas.
Guarda el ID de la respuesta que recibes en el evento response.created e inclúyelo en cada evento response.inject que envíes para esa respuesta. Después de enviar un elemento para su inyección, sigue leyendo los eventos de la conexión WebSocket hasta que se haya completado la respuesta y cada inyección haya generado un evento response.inject.created o response.inject.failed.
from __future__ import annotations
import json
from openai import OpenAI
client = OpenAI()
PROPOSALS = {
"alpha": {"estimated_weeks": 6, "risk": "medium"},
"beta": {"estimated_weeks": 8, "risk": "low"},
}
tools = [
{
"type": "function",
"name": "get_proposal",
"description": "Return details for a proposal that the agents should compare.",
"parameters": {
"type": "object",
"properties": {
"proposal": {
"type": "string",
"enum": ["alpha", "beta"],
}
},
"required": ["proposal"],
"additionalProperties": False,
},
"strict": True,
}
]
def process_tool_call(name: str, arguments: str) -> str:
if name != "get_proposal":
raise ValueError(f"Unknown tool: {name}")
parsed_arguments = json.loads(arguments)
return json.dumps(PROPOSALS[parsed_arguments["proposal"]])
def run_multi_agent(connection):
previous_response_id: str | None = None
pending_input: list[dict[str, object]] = [{"role": "user", "content": input()}]
while pending_input:
request = {
"type": "response.create",
"model": "gpt-6.1-sol",
"store": True,
"multi_agent": {"enabled": True},
"tools": tools,
"input": pending_input,
}
if previous_response_id is not None:
request["previous_response_id"] = previous_response_id
connection.send(request)
next_input: list[dict[str, object]] = []
completed_response = None
response_id: str | None = None
pending_injections = 0
for event in connection:
event_type = event.type
if event_type == "response.created":
response_id = event.response.id
elif event_type == "response.output_item.done":
item = event.item
if item.type == "function_call":
if response_id is None:
raise RuntimeError(
"Received a function call before response.created"
)
output = {
"type": "function_call_output",
"call_id": item.call_id,
"output": process_tool_call(item.name, item.arguments),
}
pending_injections += 1
connection.send(
{
"type": "response.inject",
"response_id": response_id,
"input": [output],
}
)
elif event_type == "response.inject.created":
pending_injections -= 1
elif event_type == "response.inject.failed":
pending_injections -= 1
if event.error.code != "response_already_completed":
raise RuntimeError(event.error)
next_input.extend(item.model_dump(mode="json") for item in event.input)
elif event_type == "response.completed":
completed_response = event.response
elif event_type in {
"error",
"response.failed",
"response.incomplete",
}:
raise RuntimeError(event)
if completed_response is not None and pending_injections == 0:
break
if completed_response is None:
raise RuntimeError("Connection ended before response.completed")
if pending_injections:
raise RuntimeError("Connection ended with unacknowledged tool results")
if not next_input:
return completed_response
previous_response_id = completed_response.id
pending_input = next_input
with client.beta.responses.connect(
extra_headers={"OpenAI-Beta": "responses_multi_agent=v1"},
) as connection:
response = run_multi_agent(connection)
print(
"".join(
part.text
for item in response.output
if (
item.type == "message"
and item.agent is not None
and item.agent.agent_name == "/root"
and item.phase == "final_answer"
)
for part in item.content
if part.type == "output_text"
)
)Después de enviar un evento response.inject, sigue leyendo los eventos de la conexión WebSocket y procesa el acuse de recibo:
response.inject.created: se agregó el resultado de la función a la respuesta activa. Sigue leyendo los eventos de esa respuesta.response.inject.failedconresponse_already_completed: la respuesta se completó antes de que se pudiera agregar el resultado de la función. Toma el valor deinputque devuelve el evento de error y envíalo en una nueva solicitudresponse.createque continúe a partir de la respuesta completada.response.inject.failedconresponse_not_found: el servidor no encontró la respuesta identificada porresponse_id. Verifica que estés usando el ID recibido enresponse.created.
Una sola ejecución en modo multiagente puede abarcar varias solicitudes a la API de Responses. Con HTTP, cuando un agente llama a una función definida por el desarrollador, tu aplicación ejecuta la función y envía el resultado en una nueva llamada a response.create. Con WebSocket, tu aplicación inyecta el resultado de la función directamente en la respuesta activa.
Nuevos elementos de salida del modo multiagente
Las respuestas en modo multiagente pueden incluir tres tipos adicionales de elementos de salida:
multi_agent_call: registra una acción multiagente alojada en la API, comospawn_agent.multi_agent_call_output: contiene el resultado de ejecutar una acción alojada en la API.agent_message: transmite un mensaje cifrado de un agente a otro.
El campo call_id vincula cada multi_agent_call con su multi_agent_call_output correspondiente.
Cada elemento también incluye un atributo agent. En un elemento agent_message, agent.agent_name identifica al agente destinatario. Usa author y recipient para rastrear quién envía el mensaje y quién lo recibe.
Cuando tu aplicación reciba un elemento multi_agent_call, no lo ejecutes como una llamada a una función ni envíes un resultado. La API de Responses ejecuta la acción alojada y devuelve el multi_agent_call_output correspondiente. Conserva ambos elementos si tu aplicación los necesita para reproducir la ejecución o seguir su rastro.
[
{
"type": "multi_agent_call",
"id": "mac_123",
"call_id": "call_spawn_a",
"action": "spawn_agent",
"arguments": "{\"task_name\":\"agent_a\",\"fork_turns\":\"all\",\"message\":\"enc_...\"}",
"agent": { "agent_name": "/root" }
},
{
"type": "multi_agent_call_output",
"id": "maco_123",
"call_id": "call_spawn_a",
"action": "spawn_agent",
"output": [
{
"type": "output_text",
"text": "{\"task_name\":\"/root/agent_a\"}",
"annotations": [],
"logprobs": []
}
],
"agent": { "agent_name": "/root" }
},
{
"type": "agent_message",
"id": "amsg_123",
"author": "/root/agent_a",
"recipient": "/root",
"content": [
{
"type": "encrypted_content",
"encrypted_content": "enc_..."
}
],
"agent": { "agent_name": "/root" }
}
]Los eventos SSE atribuidos a un agente incluyen el atributo agent en el nivel superior. En un evento agent_message, agent.agent_name identifica al agente destinatario. Los eventos del ciclo de vida de la respuesta, como response.created y response.completed, describen la respuesta en su conjunto y por eso no incluyen un atributo agent.
{
"type": "response.output_item.done",
"agent": { "agent_name": "/root" },
"item": {
"type": "agent_message",
"id": "amsg_123",
"author": "/root/agent_a",
"recipient": "/root",
"content": [
{
"type": "encrypted_content",
"encrypted_content": "enc_..."
}
],
"agent": { "agent_name": "/root" }
}
}Limitaciones
- Compactación:
- El punto de acceso
/responses/compactno está disponible cuando el modo multiagente está activo. - Cuando
multi_agent.enabledtiene el valortrue, la compactación automática del lado del servidor se activa de forma implícita, incluso si la solicitud no configuracontext_management. La compactación se aplica por separado al agente raíz y a cada subagente, de modo que cada uno conserva su propio contexto. Aun así, puedes sobrescribir el valor decompact_thresholdsi estableces un valor explícito paracontext_management.compact_thresholden la solicitud.
- El punto de acceso
reasoning.summaryno está disponible cuando el modo multiagente está activo.max_tool_callsno está disponible cuando el modo multiagente está activo.max_concurrent_subagentstiene el valor predeterminado3, que es el recomendado.
Pautas para redactar prompts
Cuando el modo multiagente está activo, nuestros sistemas agregan automáticamente estas instrucciones en un nuevo mensaje de desarrollador para el agente raíz y los subagentes. No puedes editar ni eliminar estas instrucciones. Redacta tus instrucciones de desarrollador de modo que complementen las que se inyectan automáticamente.
Agente raíz
You are `/root`, the primary agent in a team of agents collaborating to fulfill the user's goals.

At the start of your turn, you are the active agent.
You can spawn sub-agents to handle subtasks, and those sub-agents can spawn their own sub-agents.
All agents in the team, including the agents that you can assign tasks to, are equally intelligent and capable, and have access to the same set of tools.

You can use `spawn_agent` to create a new agent, `followup_task` to give an existing agent a new task and trigger a turn, and `send_message` to pass a message to a running agent without triggering a turn.
Child agents can also spawn their own sub-agents.
You can decide how much context you want to propagate to your sub-agents with the `fork_turns` parameter.

You will receive messages in the form:
```
Message Type: MESSAGE | FINAL_ANSWER
Task name: <recipient>
Sender: <author>
Payload:
<payload text>
```
They may be addressed as to=/root

There are {max_concurrent_subagents + 1} available concurrency slots, meaning that up to {max_concurrent_subagents + 1} agents can be active at once, including you.
Subagente
You are an agent in a team of agents collaborating to complete a task.

You can spawn sub-agents to handle subtasks, and those sub-agents can spawn their own sub-agents. All agents in the team, including the agents that you can assign tasks to, are equally intelligent and capable, and have access to the same set of tools.

You can use `spawn_agent` to create a new agent, `followup_task` to give an existing agent a new task and trigger a turn, and `send_message` to pass a message to a running agent.
Child agents can also spawn their own sub-agents.

When you provide a response in the final channel, that content is immediately delivered back to your parent agent.

You will receive messages in the form:
```
Message Type: NEW_TASK | MESSAGE | FINAL_ANSWER
Task name: <recipient>
Sender: <author>
Payload:
<payload text>
```
You may also see them addressed as to=/root/..., which indicates your identity is /root/...

There are {max_concurrent_subagents + 1} available concurrency slots, meaning that up to {max_concurrent_subagents + 1} agents can be active at once, including you.