Elige la API que usas para conocer cómo se mide el uso y cómo administrar los costos de tu aplicación de voz.
Uso y costos de GPT-Live
GPT-Live separa la conversación de voz del backend que razona y ejecuta herramientas. Estima los dos costos por separado. El costo de la sesión de voz depende de su duración y el del backend depende de los modelos y las herramientas que uses.
Costos de la sesión de voz
Las sesiones de voz de GPT-Live se facturan por segundo según la tarifa vigente del modelo. La duración de la sesión no se redondea al minuto siguiente.
El tiempo activo de la sesión incluye los períodos en los que habla el usuario, habla el asistente, ambos están en silencio o el backend está trabajando.
Para estimar el costo, cuenta el tiempo activo de la sesión desde el inicio hasta el cierre. Usa la duración que informa la API en lugar de medir solo el audio que reproduces. Silenciar el micrófono no cierra la sesión. Cuando termine la conversación, cierra la sesión y registra los datos finales de uso.
Consulta los precios de la API para conocer las tarifas de los modelos y las herramientas del backend.
Cargos por inicialización de WebRTC
Al crear una sesión de WebRTC con una solicitud POST /v1/live/sessions, se facturan 15 segundos de voz durante la inicialización. Una vez que la sesión está en marcha, ese importe se descuenta del cargo por duración. Al estimar el costo, no sumes otros 15 segundos a la duración de la sesión.
Por ejemplo, la sesión de 90 segundos que se muestra más adelante ya incluye los 15 segundos facturados al inicializarla. No se facturan 105 segundos. Ten en cuenta los cargos por crear sesiones cuando evalúes las reconexiones o las aplicaciones que crean sesiones antes de que el usuario esté listo para hablar.
Costos del backend
Las llamadas del backend se facturan por separado de la sesión de voz, igual que en las aplicaciones sin voz. Incluye los tokens de entrada y salida del modelo, la entrada en caché cuando se admita y los cargos por imágenes o herramientas que correspondan. Si tu aplicación llama a otros servicios, incluye también sus costos en la estimación.
Puedes optimizar estas operaciones por separado del frontend de voz. Consulta la guía de optimización de costos para reducir la cantidad de solicitudes y el uso de tokens. Para aprovechar el almacenamiento en caché de prompts en los modelos de backend compatibles, coloca las instrucciones reutilizables, las definiciones de herramientas y el resto del contenido estable al inicio del prompt.
Las decisiones que tomes sobre el backend también pueden cambiar la duración de la conversación. Compara el costo total cuando una optimización prolongue la espera del usuario o afecte la fiabilidad con la que el asistente completa la tarea.
Cómo estimar el costo de una conversación
Para una conversación con una sola sesión de voz:
Costo total = (segundos de voz facturables ÷ 60 × tarifa de voz por minuto) + costos del backend
Por ejemplo, con una tarifa de voz hipotética de $0,05 por minuto, una sesión de voz de 90 segundos cuesta $0,075. Si los costos del modelo y las herramientas del backend suman $0,02, la conversación cuesta $0,095:
| Componente | Cálculo | Costo |
|---|---|---|
| Sesión de voz | 90 segundos ÷ 60 × $0,05 | $0,075 |
| Operaciones del backend | Costo total del modelo y las herramientas | $0,02 |
| Total de la conversación | $0,075 + $0,02 | $0,095 |
Las tarifas y el costo del backend que se muestran son ejemplos. Usa la tarifa de voz vigente, el uso que hayas medido en el backend y las tarifas de los modelos y las herramientas que correspondan. Si la tarea abarca varias sesiones de voz, suma sus duraciones e incluye las operaciones que realiza el backend entre sesiones.
Estrategias de optimización
Ayuda al usuario a completar la tarea con menos intercambios y esperas innecesarios. Conserva las confirmaciones y las verificaciones que requiera la tarea.
Proporciona contexto relevante antes de la sesión
Antes de iniciar la sesión de voz, reúne la información que tu aplicación ya tiene permiso para usar. Por ejemplo, un asistente que ayuda al usuario con un pedido puede empezar con el número de pedido y su estado actual. Así, el usuario no tiene que repetir esos datos ni esperar otra consulta.
Mantén el contexto actualizado y limitado a la tarea. Proporciona al modelo de voz la información que necesita para la conversación y conserva los registros detallados y los flujos de trabajo en el backend. Consulta la configuración de la sesión y la guía de delegación y herramientas.
Reduce el tiempo de espera de las herramientas
Acortar las esperas puede mejorar la experiencia del usuario y reducir los costos de la sesión de voz. Por ejemplo, supongamos que tu backend usa gpt-5.6-luna con el Modo rápido y ejecuta en paralelo las llamadas a herramientas que son independientes entre sí. Si estas optimizaciones ayudan al usuario a terminar y cerrar la sesión de voz un minuto antes, ahorras $0,05 en cargos por voz. El costo total disminuye si el costo adicional del backend es menor que ese ahorro.
También puedes iniciar una consulta especulativa a partir de fragmentos de la transcripción antes de recibir un evento de delegación. Al medir los costos del backend, incluye las operaciones especulativas cuyos resultados no se usaron.
Consulta Cómo reducir la latencia del backend para optimizar el modelo, la conexión, el streaming y las herramientas. Comprueba cuánto tarda el usuario en recibir una respuesta de voz útil y si se completa la tarea mediante evaluaciones de agentes de voz.
Cierra la sesión durante las tareas largas
El frontend de voz y el backend que administra tu aplicación pueden funcionar de forma independiente. Con la delegación al cliente, el proceso del backend puede seguir ejecutándose tanto si la sesión de voz está abierta como si está cerrada. Guarda el estado de la tarea y el contexto de la conversación antes de cerrar la sesión de voz.
Para conocer el tiempo de espera por inactividad, qué activa el reinicio y cómo se restaura el contexto, consulta Cómo cerrar y reanudar sesiones inactivas.
Si usas un agente ambiental, cierra la sesión de voz mientras el backend realiza una tarea de larga duración, como programar en modo objetivo. Ofrece un botón con la etiqueta Reanudar conversación para iniciar una nueva sesión de voz cuando regrese el usuario, o usa un evento de finalización del backend para iniciar una nueva sesión y avisarle que el resultado está listo.
Para restaurar la conversación, inicia una nueva sesión e incluye el contexto guardado y el resultado verificado de la tarea en input. Por ejemplo, envía este evento de inicio a través de una nueva conexión WebSocket:
{
"type": "session.start",
"session": {
"model": "gpt-live-1",
"instructions": "Help the user review completed work and delegate follow-up tasks.",
"input": [
{
"type": "message",
"role": "developer",
"content": [
{
"type": "input_text",
"text": "Saved task: add CSV export. Result: code is ready for review."
}
]
}
],
"delegation": { "type": "client" }
}
}Espera a recibir session.started antes de transmitir audio. Consulta Cómo iniciar una sesión con una conversación anterior para conocer el formato de historial admitido.
Si guardaste la sesión anterior con store: true, también puedes crear un fork de esa sesión. Sea cual sea el método que uses, conserva en tu aplicación el estado verificado de la tarea del backend.
Cerrar la sesión ahorra $0,05 por cada minuto de inactividad de la sesión de voz. Compara ese ahorro con los costos de reconexión y la interrupción que experimenta el usuario.
Elige el modelo adecuado para el backend
Empieza con modelos que cumplan los requisitos de precisión y fiabilidad de la tarea. Luego compara el costo total de la conversación, incluida la duración de la sesión de voz, el uso del modelo, las llamadas a herramientas y los reintentos. La guía de selección de modelos explica cómo sopesar estos factores.
Un modelo de backend más grande puede tener un costo total menor si completa la tarea más rápido y el ahorro en la sesión de voz supera el costo adicional de los tokens. Un modelo más económico puede tener un costo total mayor si tarda más, repite llamadas a herramientas o no logra completar la tarea.
Compara el costo por tarea completada con éxito, la tasa de finalización y el tiempo necesario para completarla. Incluye en el total los intentos fallidos y los reintentos para que una configuración más económica no parezca mejor solo porque completa menos trabajo. Consulta el ejemplo del Cookbook sobre la evaluación de agentes de voz al planificar la comparación.
Monitorea el uso real
Registra por separado la duración de la sesión de voz y el uso del backend en cada sesión. GPT-Live informa la duración acumulada de voz en segundos:
{
"type": "session.usage.updated",
"event_id": "event_usage_1",
"usage": { "seconds": 12 },
"context_window": { "usage_ratio": 0.42 }
}Cada actualización reemplaza el valor anterior de la duración. No sumes los valores de las actualizaciones. Después de enviar session.close, sigue recibiendo eventos hasta que llegue session.closed y registra una sola vez su valor final de usage.seconds. Sigue el procedimiento de cierre ordenado para que tu aplicación pueda registrar el uso final antes de desconectarse.
Si usas la delegación a Responses, lee el campo usage de la respuesta del backend en los eventos response.completed anidados que recibes a través de response.event. Usa el ID de cada respuesta del backend para contarla una sola vez. Conserva el desglose de los tokens de entrada, de salida y en caché que necesites para aplicar las tarifas de ese modelo. Si tu aplicación ejecuta operaciones de backend por su cuenta, registra también el uso de esas solicitudes.
Compara los totales estimados y reales en conversaciones representativas. Registra por separado las llamadas al modelo que solo se hacen para evaluarlo y las que realiza la aplicación. Analiza el costo junto con el éxito de la tarea.
Costos de la Realtime API
En este documento se explica cómo funciona la facturación de la Realtime API y qué estrategias puedes usar para optimizar los costos. Las sesiones de agentes de voz acumulan tokens de entrada y salida de texto, audio e imagen. Las sesiones de traducción y de transcripción en streaming se facturan según la duración del audio. Los precios varían según el modelo y se publican en la página de cada uno (por ejemplo, gpt-realtime-2, gpt-realtime-translate, gpt-realtime-whisper y gpt-realtime).
Las sesiones conversacionales de la Realtime API constan de una serie de turnos. En cada turno, el usuario agrega una entrada que activa una Response para generar la salida del modelo. El servidor mantiene una Conversation, que contiene una lista de Items que conforman la entrada del siguiente turno. Cuando se devuelve una Response, la salida se agrega automáticamente a la Conversation.
Las sesiones de traducción y transcripción usan otra arquitectura de streaming. El cliente transmite audio de forma continua y, a medida que llega el audio original, recibe audio traducido, actualizaciones incrementales de la transcripción o eventos de transcripción. Estas sesiones no siguen el ciclo de vida habitual de una Response. Para estimar y monitorear su costo, usa las tarifas por duración en lugar del uso de tokens por Response.
Costos por Response
La Realtime API genera cargos cuando se crea una Response. Los cargos dependen de la cantidad de tokens de entrada y salida, salvo en el caso de la transcripción de entrada, que se explica más adelante. Actualmente no se cobra por el ancho de banda de la red ni por las conexiones. Puedes crear una Response manualmente o dejar que se cree de forma automática si activas la detección de actividad de voz (VAD). La VAD filtra el audio de entrada sin voz, por lo que ese audio no se contabiliza como tokens de entrada a menos que el cliente lo agregue manualmente como entrada de la conversación.
En cada Response se envía toda la conversación al modelo. La salida de cada turno se agrega como Items a la Conversation del servidor y pasa a formar parte de la entrada de los turnos siguientes. Por eso, los turnos posteriores de la sesión cuestan más.
Puedes estimar el costo de los tokens de texto con nuestras herramientas de tokenización. En los mensajes del usuario se cuenta un token de audio por cada 100 ms de audio. En los mensajes del asistente se cuenta uno por cada 50 ms. Además del contenido de los mensajes, el recuento incluye tokens especiales, lo que produce pequeñas variaciones. Por ejemplo, un mensaje del usuario con 10 tokens de texto puede contabilizarse como 12 tokens.
Ejemplo
Veamos cómo se calculan los costos de los tokens en una sesión de la Realtime API con varios turnos.
En el primer turno agregamos 100 tokens de instrucciones y un mensaje del usuario con 20 tokens de audio (por ejemplo, un mensaje agregado por la VAD cuando detecta que el usuario habla). En total son 120 tokens de entrada. Al crear una Response, se genera un mensaje de salida del asistente con 20 tokens de audio y 10 de texto.
Luego creamos un segundo turno con otro mensaje de audio del usuario. ¿Cuántos tokens se cuentan en este turno? La Conversation ya incluye las instrucciones iniciales, el primer mensaje del usuario, el mensaje de salida del asistente del primer turno y el segundo mensaje del usuario (25 tokens de audio). Este turno tendrá 110 tokens de texto y 64 tokens de audio como entrada, además de los tokens de salida de otro mensaje del asistente.
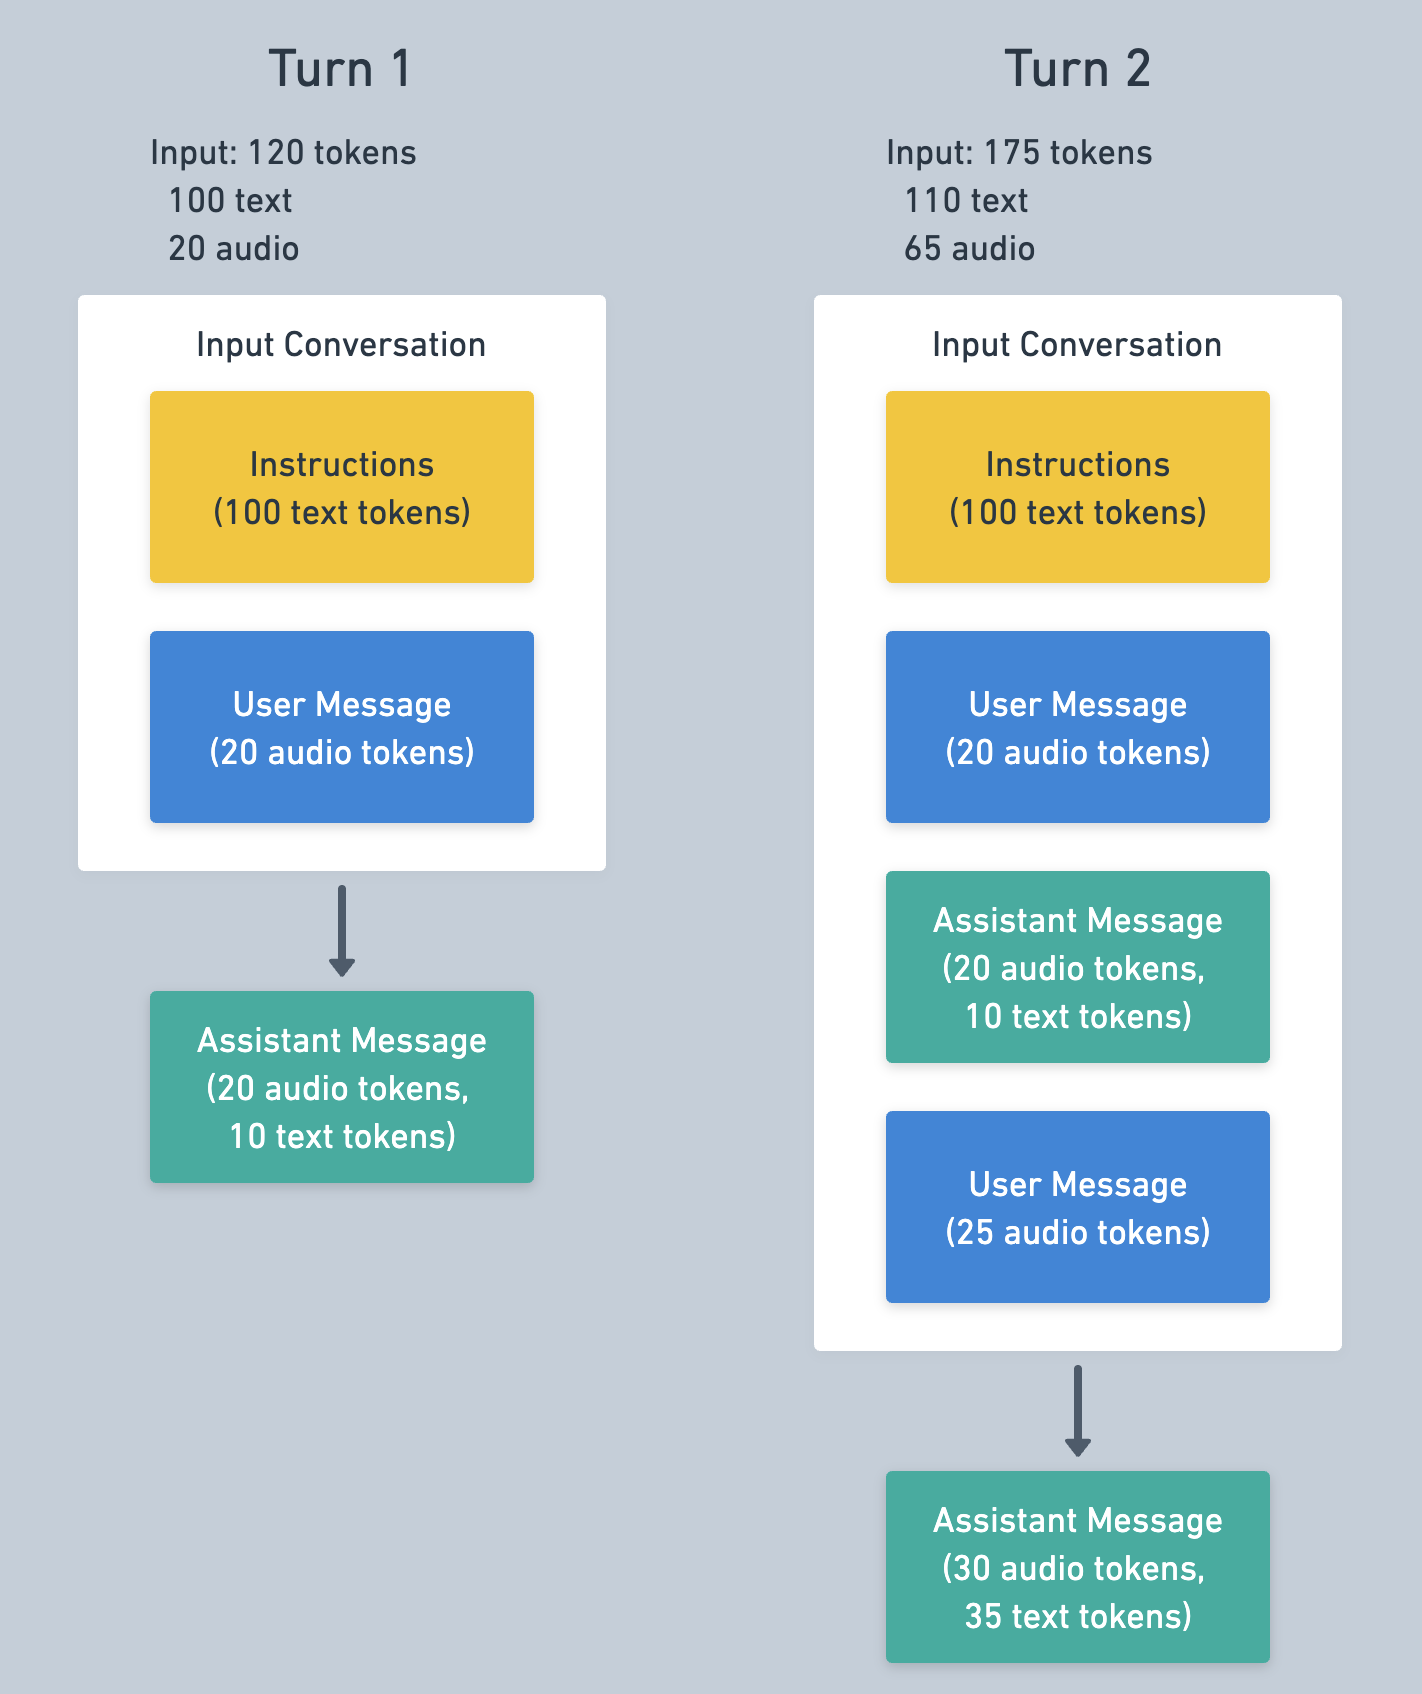
Es probable que los mensajes del primer turno estén en caché para el segundo, lo que reduce el costo de la entrada. Más adelante encontrarás información sobre el almacenamiento en caché.
Puedes consultar los tokens utilizados para una Response en el evento response.done, que tiene el siguiente formato:
{
"type": "response.done",
"response": {
...
"usage": {
"total_tokens": 253,
"input_tokens": 132,
"output_tokens": 121,
"input_token_details": {
"text_tokens": 119,
"audio_tokens": 13,
"image_tokens": 0,
"cached_tokens": 64,
"cached_tokens_details": {
"text_tokens": 64,
"audio_tokens": 0,
"image_tokens": 0
}
},
"output_token_details": {
"text_tokens": 30,
"audio_tokens": 91
}
}
}
}Costos de la transcripción de entrada
Si activas la transcripción de entrada, la Realtime API la factura por separado. La transcripción de entrada usa un modelo y tarifas distintos de los del modelo de voz a voz. Usa gpt-transcribe para la transcripción de un turno confirmado. La transcripción comienza una vez que se escribe el audio en el búfer de entrada y se confirma su contenido.
Consulta el uso de la transcripción de entrada en el evento conversation.item.input_audio_transcription.completed. Los campos de uso dependen del modelo de transcripción. El uso de gpt-transcribe se factura según la duración del audio, mientras que los modelos que se facturan por token devuelven la cantidad de tokens. Por ejemplo, el uso medido por duración tiene este formato:
{
"type": "conversation.item.input_audio_transcription.completed",
"transcript": "Hi, can you hear me?",
"usage": {
"type": "duration",
"seconds": 3
}
}Almacenamiento en caché
La Realtime API admite el almacenamiento en caché de prompts, que se aplica automáticamente y puede reducir considerablemente el costo de los tokens de entrada en sesiones de varios turnos. Los tokens de entrada de una Response pueden recuperarse de la caché si coinciden con los de una Response anterior, aunque no se garantiza que esto ocurra.
La mejor manera de maximizar la proporción de tokens que se recuperan de la caché es mantener intacto el historial de la sesión. Si eliminas o modificas contenido, la caché solo se puede aprovechar hasta el punto del cambio, porque la porción de la entrada que coincide con la anterior se reduce. Las instrucciones y las definiciones de herramientas están al inicio de la conversación. Si las cambias durante la sesión, se aprovechará menos la caché en los turnos siguientes.
Truncamiento
Cuando la cantidad de tokens de una conversación supera el límite de tokens de entrada del modelo, la conversación se trunca. Se omiten mensajes de la entrada de la Response, empezando por los más antiguos. Un modelo con una ventana de contexto de 32 mil tokens y un máximo de 4096 tokens de salida solo puede incluir 28 224 tokens en el contexto antes de que se trunque.
El cliente puede definir una ventana de tokens menor que la máxima del modelo para controlar el uso de tokens y el costo. Para ello, usa token_limits.post_instructions si configuras el truncamiento con el tipo retention_ratio, como se muestra más adelante. Como indica el nombre, este ajuste controla la cantidad máxima de tokens de entrada de una Response, sin contar los tokens de las instrucciones. Si estableces post_instructions en 1000, los elementos que excedan el límite de 1000 tokens de entrada no se enviarán al modelo para generar una Response.
El truncamiento invalida la caché cerca del inicio de la conversación. Si la conversación se trunca en cada turno, la proporción de tokens recuperados de la caché será muy baja. Para evitarlo, el cliente puede configurar el truncamiento de modo que descarte más mensajes de los estrictamente necesarios. Así queda más espacio disponible antes del próximo truncamiento. Puedes controlar este comportamiento con el ajuste session.truncation.retention_ratio. El servidor usa el valor 1.0 de forma predeterminada, por lo que solo elimina los elementos necesarios. Con un valor de 0.8, el truncamiento conserva el 80 % del máximo y descarta un 20 % adicional.
Para reducir el costo por sesión de la Realtime API con un modelo determinado, recomendamos limitar la cantidad de tokens y establecer un retention_ratio menor que 1, como en el siguiente ejemplo. Ten en cuenta que reducir el costo puede dejar al modelo con menos información de la conversación en un turno dado.
{
"event": "session.update",
"session": {
"truncation": {
"type": "retention_ratio",
"retention_ratio": 0.8,
"token_limits": {
"post_instructions": 8000
}
}
}
}También puedes desactivar por completo el truncamiento, como se muestra a continuación. Si lo desactivas y la Conversation es demasiado larga para crear una Response, el servidor devolverá un error. Esta opción puede ser útil si quieres administrar manualmente el tamaño de la Conversation.
{
"event": "session.update",
"session": {
"truncation": "disabled"
}
}Otras estrategias de optimización
Usar un modelo mini
Los modelos Realtime de voz a voz están disponibles en tamaño “normal” y en tamaño mini, que es considerablemente más económico. El modelo mini suele ser menos eficaz para seguir instrucciones y realizar llamadas a funciones. Recomendamos probar primero tu aplicación con el modelo más grande, ajustar la aplicación y el prompt y luego intentar optimizar el costo con el modelo mini.
Editar la Conversation
Aunque el servidor trunca la conversación automáticamente, otra estrategia para administrar los costos es editar la Conversation de forma manual. La API está diseñada para que el cliente tenga pleno control sobre la Conversation del servidor y pueda agregar o eliminar elementos cuando lo necesite.
{
"type": "conversation.item.delete",
"item_id": "item_CCXLecNJVIVR2HUy3ABLj"
}Eliminar mensajes antiguos reduce la cantidad de tokens de entrada y su costo. Como podrías perder contenido importante, una estrategia habitual es reemplazar los mensajes antiguos por un resumen. Puedes eliminar elementos de la Conversation con un mensaje conversation.item.delete, como en el ejemplo anterior, y agregarlos con un mensaje conversation.item.create.
Estimación de costos
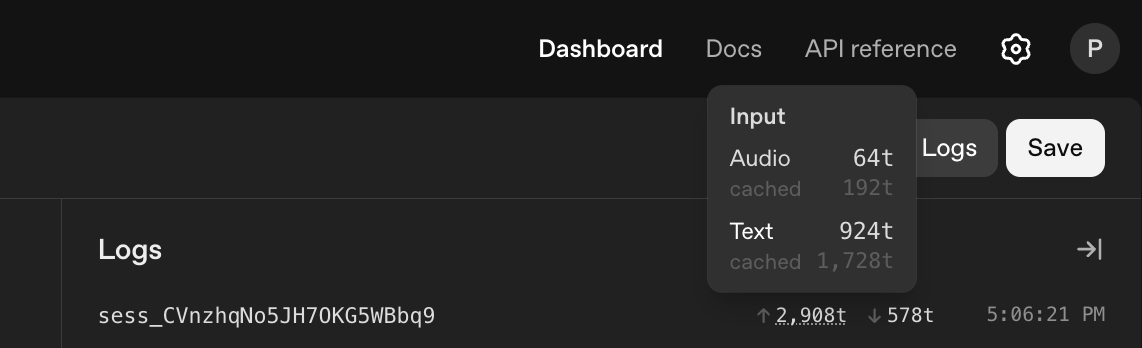
Dada la complejidad del uso de tokens en la Realtime API, puede ser difícil estimar los costos de antemano. Una forma de hacerlo es probar en el Realtime Playground los prompts y las funciones que planeas usar y medir el uso de tokens durante una sesión de muestra. En la pestaña Logs del Realtime Playground, junto al ID de la sesión, puedes consultar cuántos tokens se usaron.