
Cómo maximizar la exactitud de las respuestas y la consistencia del comportamiento al trabajar con LLM
Optimizar los LLM es difícil.
Hemos trabajado con muchos desarrolladores, tanto en empresas emergentes como en grandes empresas, y las dificultades de la optimización suelen resumirse en tres cuestiones:
- Saber por dónde empezar a mejorar la exactitud
- Decidir qué método usar y cuándo
- Determinar qué nivel de exactitud es suficiente para producción
Esta guía propone un marco para entender cómo optimizar la exactitud y el comportamiento de los LLM. Exploraremos métodos como la ingeniería de prompts, la generación aumentada por recuperación (RAG) y el ajuste fino. También veremos cómo y cuándo usar cada técnica y qué dificultades puedes encontrar.
Mientras lees, relaciona estos principios con lo que significa la exactitud en tu caso de uso. Puede parecer obvio, pero hay una diferencia entre generar un texto deficiente que una persona debe corregir y reembolsarle $1000 a un cliente en lugar de $100. Antes de hablar de la exactitud de un LLM, conviene tener una idea de cuánto te cuesta cada error y cuánto ahorras o ganas con cada acierto. Volveremos a este tema al final, cuando veamos qué nivel de exactitud es “suficiente” para producción.
Contexto de la optimización de los LLM
Muchas guías prácticas presentan la optimización como una secuencia lineal: empiezas con la ingeniería de prompts, pasas a la generación aumentada por recuperación y terminas con el ajuste fino. En la práctica, el proceso suele ser distinto. Cada método resuelve problemas diferentes y, para avanzar en la dirección correcta, necesitas elegir el que corresponde a tu problema.
Resulta útil representar la optimización de los LLM como una matriz:

Para una tarea típica con un LLM, empezamos en la esquina inferior izquierda, con la ingeniería de prompts. Allí hacemos pruebas, aprendemos de los resultados y los evaluamos para establecer un punto de referencia. Una vez que revisamos esos ejemplos iniciales y determinamos por qué algunas respuestas son incorrectas, podemos elegir qué optimizar:
- Optimización del contexto: necesitas optimizar el contexto cuando 1) al modelo le faltan conocimientos porque no estaban en sus datos de entrenamiento, 2) sus conocimientos están desactualizados o 3) necesita información de uso exclusivo de una organización. Este eje maximiza la exactitud de las respuestas.
- Optimización del LLM: necesitas optimizar el LLM cuando 1) el modelo produce resultados inconsistentes con un formato incorrecto, 2) el tono o la forma de expresarse son inadecuados o 3) no sigue de manera consistente el razonamiento esperado. Este eje maximiza la consistencia del comportamiento.
En la práctica, la optimización se hace en varias etapas: evaluamos los resultados, formulamos una hipótesis sobre cómo mejorarlos, aplicamos el cambio y volvemos a evaluar para decidir el siguiente paso. Este es un ejemplo bastante habitual:
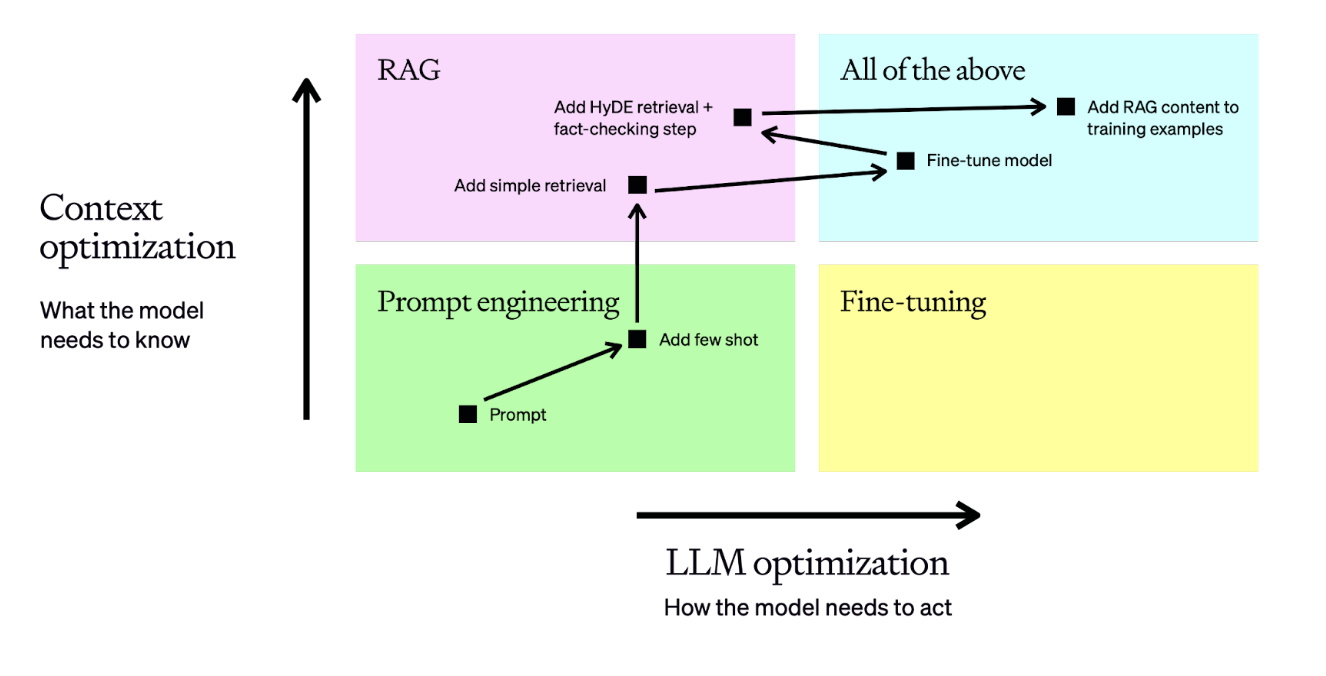
En este ejemplo, seguimos estos pasos:
- Empezamos con un prompt y evaluamos su rendimiento.
- Agregamos unos pocos ejemplos fijos, lo que debería mejorar la consistencia de los resultados.
- Agregamos una etapa de recuperación que selecciona dinámicamente unos pocos ejemplos según la pregunta. Esto mejora el rendimiento porque cada entrada recibe contexto pertinente.
- Preparamos un conjunto de datos con 50 ejemplos o más y hacemos un ajuste fino del modelo para aumentar la consistencia.
- Afinamos la recuperación y agregamos una etapa de verificación de datos para detectar alucinaciones y mejorar la exactitud.
- Volvemos a entrenar el modelo que ya pasó por el ajuste fino con nuevos ejemplos de entrenamiento que incluyen las entradas de RAG mejoradas.
Este proceso es bastante habitual cuando hay que resolver un problema empresarial complejo. Nos ayuda a decidir si necesitamos contexto más pertinente o un comportamiento más consistente del modelo. Una vez que lo sabemos, podemos elegir por dónde empezar a optimizar.
Con este marco en mente, veamos qué métodos podemos aplicar en cada área. Empezaremos en la esquina inferior izquierda, con la ingeniería de prompts.
Ingeniería de prompts
La ingeniería de prompts suele ser el mejor punto de partida**. A menudo es el único método necesario para tareas como resumir, traducir o generar código, en las que un enfoque sin ejemplos puede alcanzar la exactitud y la consistencia necesarias para producción.
Esto se debe a que te obliga a definir qué significa la exactitud en tu caso de uso. Empiezas por lo más básico: proporcionas una entrada y necesitas poder determinar si el resultado cumple tus expectativas. Si no obtienes lo que buscas, entender por qué te ayudará a decidir qué usar para seguir mejorando.
Empieza siempre con un prompt sencillo y una idea clara del resultado esperado. Después, optimiza el prompt agregando contexto, instrucciones o ejemplos hasta obtener lo que buscas.
Optimización
Para optimizar tus prompts, me basaré principalmente en las estrategias de la guía de ingeniería de prompts de la documentación de la API de OpenAI. Cada estrategia te ayuda a ajustar el contexto, el LLM o ambos:
| Estrategia | Optimización del contexto | Optimización del LLM |
|---|---|---|
| Escribe instrucciones claras | X | |
| Divide las tareas complejas en subtareas más sencillas | X | X |
| Dales tiempo a los GPT para “pensar” | X | |
| Prueba los cambios de manera sistemática | X | X |
| Proporciona un texto de referencia | X | |
| Usa herramientas externas | X |
Puede ser difícil imaginar cómo aplicar estas estrategias, así que vamos a probarlas con un ejemplo práctico. Usaremos gpt-4-turbo para corregir oraciones en islandés y ver cómo funciona.
Vimos que la ingeniería de prompts es un buen punto de partida y que podemos mejorar considerablemente el rendimiento con los métodos de ajuste adecuados.
La principal dificultad es que la ingeniería de prompts a menudo tiene límites de escala. Para que el modelo pueda abordar una variedad de problemas mayor de la que podemos cubrir agregando contenido al prompt, necesitamos proporcionarle contexto dinámico. En otros casos, necesitamos un comportamiento más consistente del que podemos lograr con unos pocos ejemplos.
Los modelos con ventanas de contexto largas permiten ampliar el alcance de la ingeniería de prompts. Sin embargo, a los modelos puede costarles mantener la atención a lo largo de prompts muy extensos con instrucciones complejas. Por eso, evalúa siempre estos modelos con contextos de distintos tamaños para comprobar que la información no se pierda en el medio. La expresión “perderse en el medio” describe la dificultad de un LLM para prestar la misma atención a todos los tokens que recibe a la vez. Por eso puede pasar por alto información de manera aparentemente aleatoria. Puedes usar contextos largos, pero debes acompañarlos de una evaluación exhaustiva. Greg Kamradt, colaborador de proyectos de código abierto, creó una evaluación llamada Aguja en un pajar (NITA). Ocultó un dato en distintas posiciones de documentos largos y evaluó qué tan bien se recuperaba. Esto ilustra la dificultad de los contextos largos: prometen simplificar mucho la recuperación porque puedes incluir todo en el contexto, pero a costa de la exactitud.
Entonces, ¿hasta dónde puedes llegar con la ingeniería de prompts? Depende del caso. Las evaluaciones te permiten decidir.
Evaluación
Por eso, lo mejor que puedes obtener de esta etapa es un buen prompt y un conjunto de evaluación con preguntas y respuestas de referencia. Si tenemos al menos 20 preguntas con sus respuestas, analizamos en detalle los errores y tenemos una hipótesis sobre sus causas, ya contamos con un punto de referencia adecuado para probar métodos de optimización más avanzados.
Antes de pasar a métodos más sofisticados, también conviene pensar cómo automatizar la evaluación para acelerar las iteraciones. Estas son algunas prácticas habituales que nos han dado buenos resultados:
- Usar métodos como ROUGE o BERTScore para obtener una estimación aproximada. Sus resultados no coinciden demasiado con las evaluaciones humanas, pero permiten medir de manera rápida y eficaz cuánto cambiaron las respuestas del modelo de una iteración a otra.
- Usar GPT-4 como evaluador, tal como se describe en el artículo sobre G-Eval. Le das al LLM una tabla de criterios de puntuación para que evalúe el resultado con la mayor objetividad posible.
Si quieres profundizar, consulta esta guía práctica, que muestra cómo aplicar cada método.
Cómo elegir las herramientas
Ya aplicaste la ingeniería de prompts y tienes un conjunto de evaluación, pero el modelo aún no hace lo que necesitas. El siguiente paso, y el más importante, es diagnosticar en qué falla y qué herramienta te conviene usar para mejorarlo.
Puedes guiarte por este esquema básico:
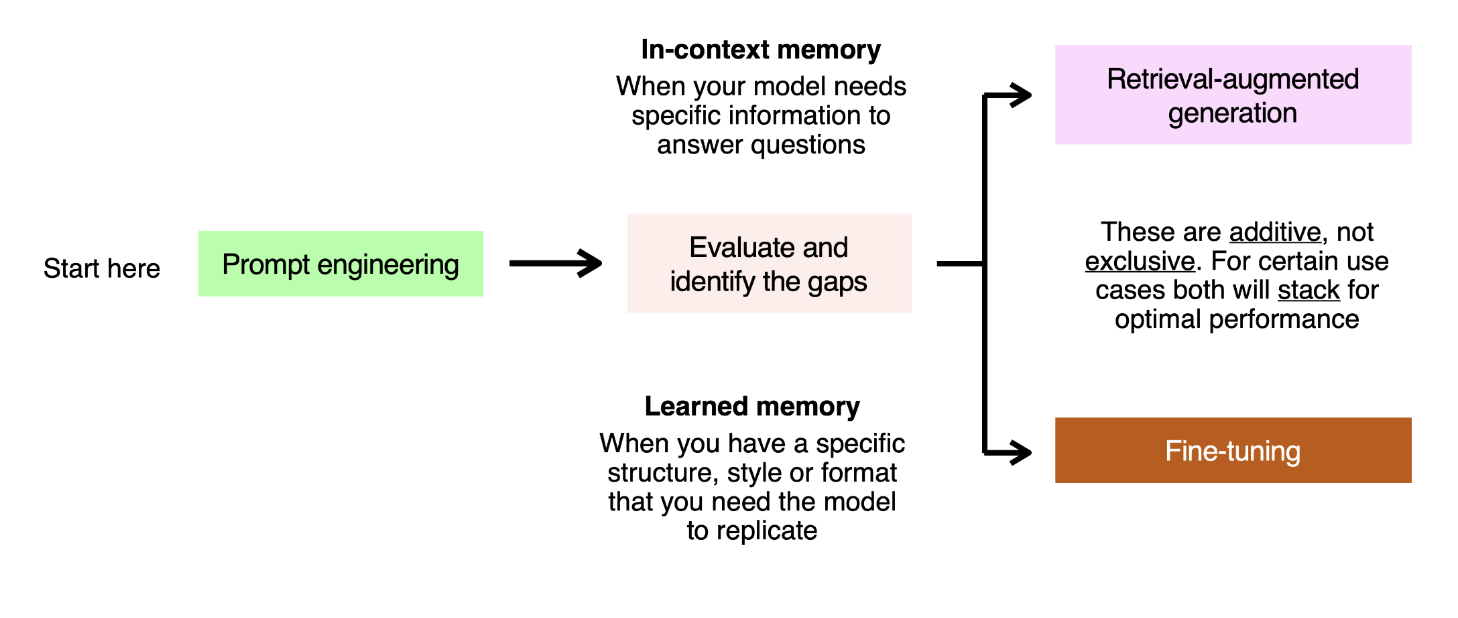
Para cada pregunta que el modelo respondió mal en la evaluación, considera si el problema está en la memoria en contexto o en la memoria aprendida. Imagina que estás presentando un examen. Hay dos maneras de asegurarte de responder correctamente:
- Durante los últimos seis meses asististe a clase y viste una y otra vez ejemplos de cómo funciona un concepto. Esa es la memoria aprendida. En los LLM, abordamos este tipo de problema mostrando ejemplos del prompt y de la respuesta esperada para que el modelo aprenda de ellos.
- Tienes contigo el libro de texto y puedes consultar la información que necesitas para responder la pregunta. Esa es la memoria en contexto. En los LLM, abordamos este problema incorporando información pertinente a la ventana de contexto, ya sea de manera estática con ingeniería de prompts o a gran escala con RAG.
Estos dos métodos de optimización se complementan y no son excluyentes. Puedes combinarlos y, en algunos casos de uso, tendrás que hacerlo para lograr el mejor rendimiento.
Supongamos que nos enfrentamos a un problema de memoria a corto plazo. En ese caso usaremos RAG para resolverlo.
Generación aumentada por recuperación (RAG)
RAG consiste en recuperar contenido para ampliar el prompt del LLM antes de generar una respuesta. Sirve para darle al modelo acceso al contexto específico de un área que necesita para resolver una tarea.
RAG es una herramienta muy valiosa para aumentar la exactitud y la consistencia de un LLM. En OpenAI, muchas de las implementaciones de mayor escala para clientes se hicieron únicamente con ingeniería de prompts y RAG.
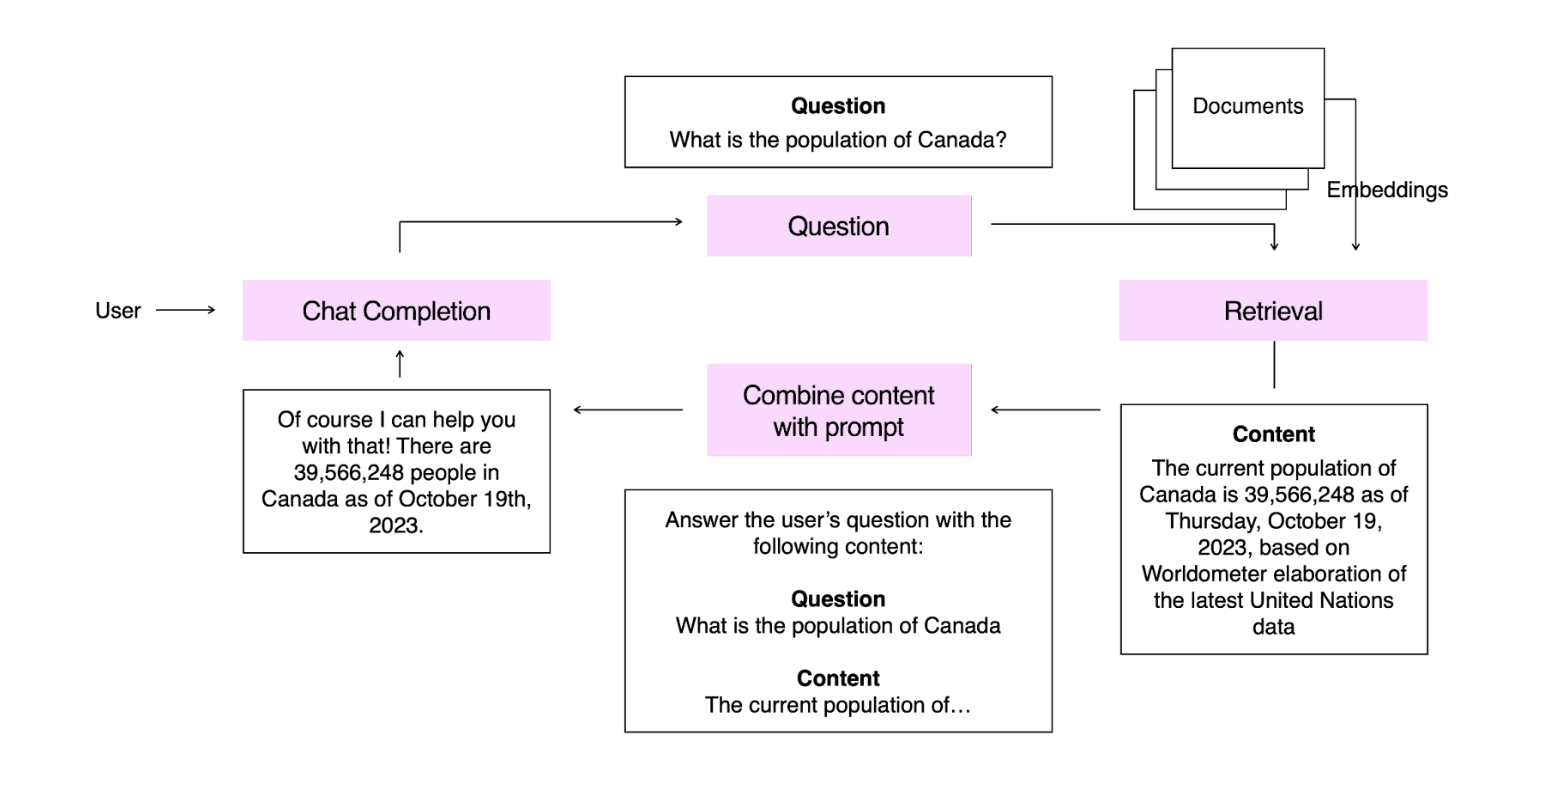
En este ejemplo, generamos representaciones vectoriales de una base de conocimientos sobre estadística. Cuando el usuario hace una pregunta, generamos su representación vectorial y recuperamos el contenido más pertinente de la base de conocimientos. Le damos ese contenido al modelo para que responda la pregunta.
Las aplicaciones de RAG introducen un nuevo eje de optimización: la recuperación. Para que RAG funcione, debemos darle al modelo el contexto adecuado y después evaluar si responde correctamente. Esta matriz ofrece una forma sencilla de abordar la evaluación con RAG:
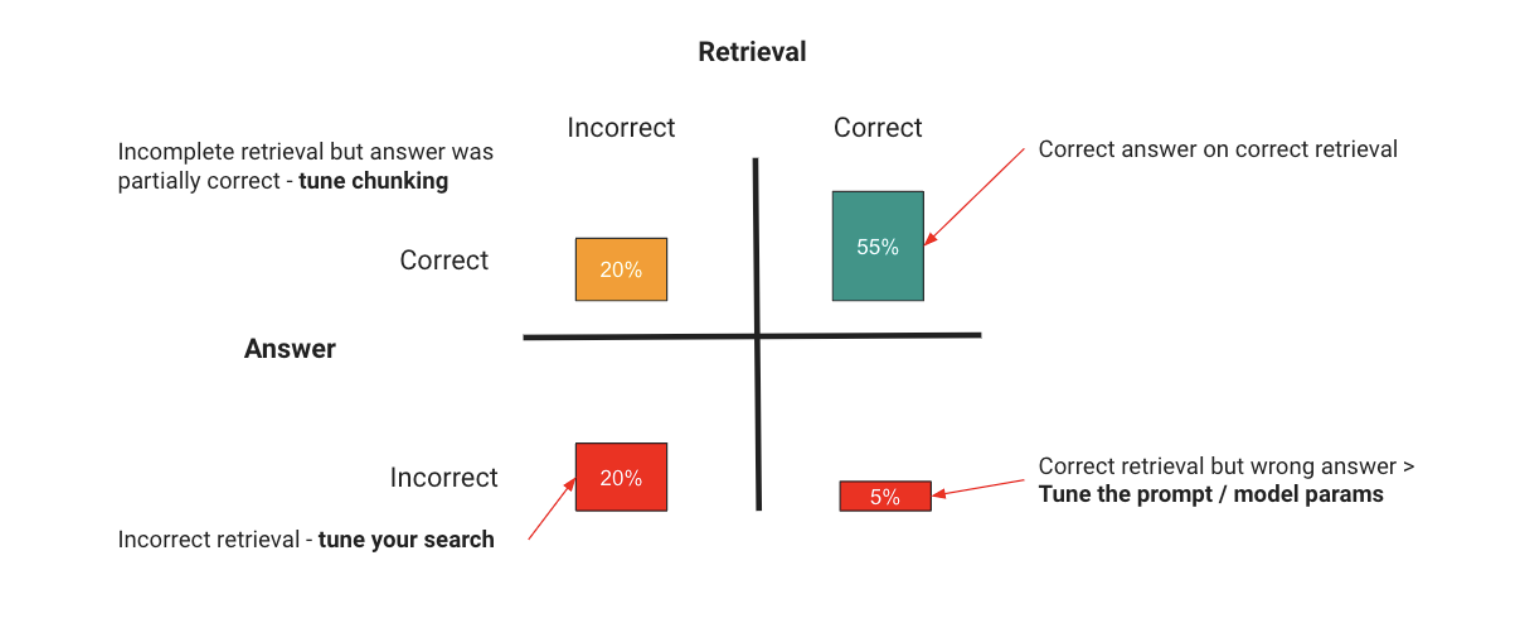
Tu aplicación de RAG puede fallar en dos áreas:
| Área | Problema | Solución |
|---|---|---|
| Recuperación | Si das un contexto incorrecto, el modelo no tendrá cómo responder. Si incluyes demasiado contexto irrelevante, la información que importa puede perderse entre el resto y provocar alucinaciones. | Optimiza la recuperación. Por ejemplo, puedes: - ajustar la búsqueda para que devuelva los resultados adecuados. - ajustar la búsqueda para que incluya menos ruido. - proporcionar más información en cada resultado recuperado. Estas son solo algunas posibilidades. La optimización del rendimiento de RAG es toda una especialidad, y bibliotecas como LlamaIndex y LangChain ofrecen muchos enfoques. |
| LLM | El modelo también puede recibir el contexto correcto y usarlo de manera incorrecta. | Aplica ingeniería de prompts para mejorar las instrucciones y el método que sigue el modelo. Si mostrarle ejemplos mejora la exactitud, incorpora el ajuste fino. |
Se mantiene el principio del marco inicial: evalúa para detectar qué salió mal y aplica una mejora para corregirlo. La única diferencia con RAG es que ahora también debes considerar la recuperación.
Aunque es útil, RAG solo resuelve los problemas de aprendizaje en contexto. En muchos casos, el desafío consiste en que el LLM aprenda una tarea para poder realizarla de manera consistente y confiable. Para eso recurrimos al ajuste fino.
Ajuste fino
Para resolver un problema de memoria aprendida, muchos desarrolladores continúan el entrenamiento del LLM con un conjunto de datos más pequeño y específico de un área, a fin de optimizarlo para una tarea concreta. Este proceso se conoce como ajuste fino.
El ajuste fino suele hacerse por uno de dos motivos:
- Mejorar la exactitud del modelo en una tarea específica: entrenas el modelo con datos propios de la tarea para resolver un problema de memoria aprendida. Le muestras muchos ejemplos de cómo realizar correctamente esa tarea.
- Mejorar la eficiencia del modelo: logras la misma exactitud con menos tokens o con un modelo más pequeño.
El ajuste fino comienza con la preparación de un conjunto de ejemplos de entrenamiento. Este es el paso más importante, porque los ejemplos deben representar fielmente lo que el modelo verá en condiciones reales.
Muchos clientes usan un proceso conocido como prompt baking, que consiste en registrar en detalle las entradas y salidas de los prompts durante una prueba piloto. A partir de esos registros, puedes seleccionar ejemplos realistas para crear un conjunto de entrenamiento eficaz.
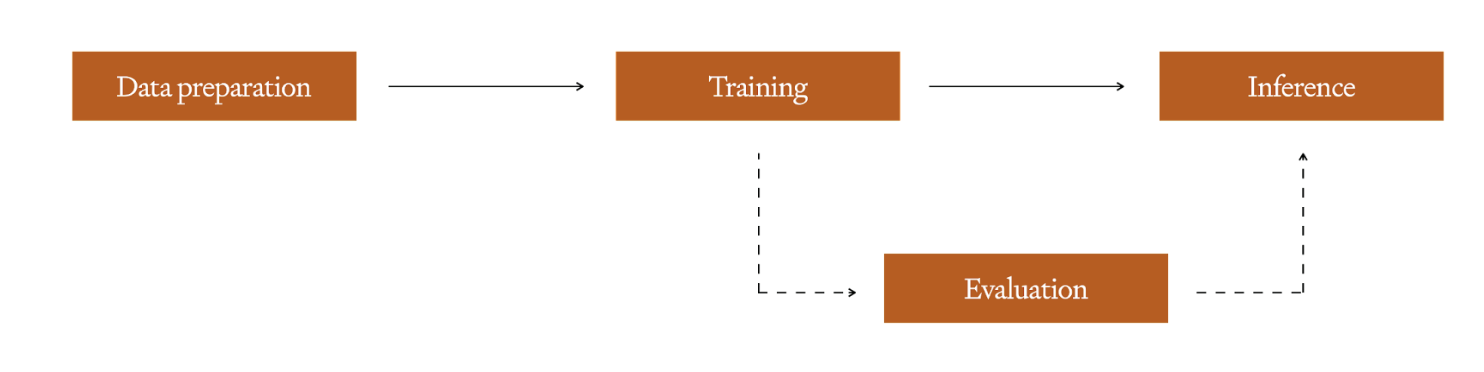
Una vez depurado el conjunto de datos, puedes hacer el ajuste fino mediante una ejecución de entrenamiento. Según la plataforma o el marco que uses, es posible que puedas modificar hiperparámetros, como harías con cualquier otro modelo de aprendizaje automático. Siempre recomendamos reservar un conjunto de datos para la evaluación posterior al entrenamiento, que permite detectar el sobreajuste. Si necesitas consejos para crear un buen conjunto de entrenamiento, consulta las recomendaciones de nuestra documentación sobre ajuste fino. Una vez finalizado el entrenamiento, el nuevo modelo ajustado está disponible para inferencia.
Para optimizar el ajuste fino, nos centraremos en prácticas que han dado buenos resultados con las opciones de personalización de modelos de OpenAI. Estos principios también deberían servir con otros proveedores y con herramientas de código abierto. Ten en cuenta estas prácticas:
- Empieza con la ingeniería de prompts: prepara un conjunto de evaluación sólido durante esta etapa para usarlo como punto de referencia. Así puedes limitar la inversión hasta que tengas confianza en tu prompt de base.
- Empieza con pocos datos y prioriza la calidad: al aplicar ajuste fino a un modelo fundacional, la calidad de los datos de entrenamiento importa más que la cantidad. Empieza con al menos 50 ejemplos y evalúa los resultados. Aumenta el tamaño del conjunto si todavía no alcanzas la exactitud que necesitas y los errores se deben a la consistencia o al comportamiento del modelo, en lugar de al contexto.
- Asegúrate de que los ejemplos sean representativos: uno de los problemas más habituales es usar ejemplos de entrenamiento cuya forma o formato difieren ligeramente de lo que el LLM verá en producción. Por ejemplo, si tienes una aplicación de RAG, incluye ejemplos de RAG en el ajuste fino para que el modelo no tenga que aprender a usar el contexto sin ejemplos.
Cómo combinar los métodos
Estas técnicas se complementan. Si las primeras evaluaciones revelan problemas tanto de contexto como de comportamiento, es probable que tu solución de producción termine usando ajuste fino y RAG. Es una combinación válida, ya que cada método compensa las limitaciones del otro. Estas son algunas de sus principales ventajas:
- Usar el ajuste fino para minimizar la cantidad de tokens que requiere la ingeniería de prompts. Las instrucciones y los pocos ejemplos del prompt se sustituyen por muchos ejemplos de entrenamiento que enseñan al modelo a comportarse de manera consistente.
- Enseñar comportamientos complejos mediante un ajuste fino exhaustivo.
- Usar RAG para incorporar contexto, ya sea contenido más reciente o cualquier otro contexto especializado que requieran tus casos de uso.
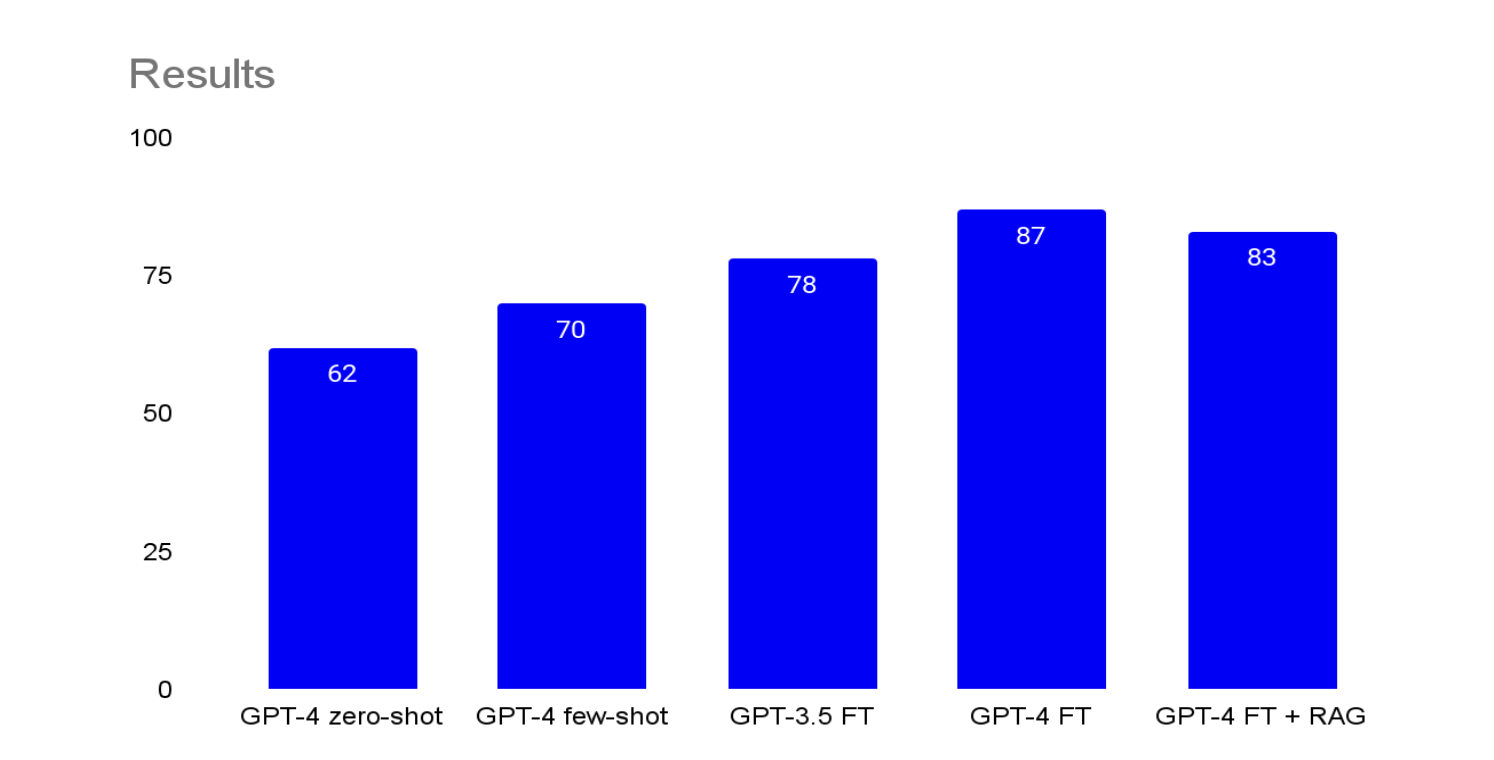 Puntuación BLEU por método de ajuste (sobre 100)
Ya vimos cómo funcionan RAG y el ajuste fino, y cuándo conviene usar cada uno. Falta considerar cómo cambia la velocidad de iteración cuando incorporas estas herramientas:
- Con RAG, debes ajustar tanto la recuperación como el comportamiento del LLM.
- Con el ajuste fino, cada vez que haces ajustes adicionales debes repetir el proceso y gestionar los conjuntos de entrenamiento y validación.
Ambos procesos pueden ser complejos y llevar tiempo. A medida que tu aplicación con LLM se vuelve más compleja, pueden aparecer regresiones. Si te quedas con una idea de esta guía, que sea esta: consigue toda la exactitud que puedas con los métodos básicos antes de recurrir a métodos más complejos como RAG o el ajuste fino. Guíate por la exactitud que necesitas alcanzar y evita elegir la combinación de RAG y ajuste fino solo porque parezca la opción más sofisticada.
Qué nivel de exactitud es “suficiente” para producción
Mejorar la exactitud de los LLM puede ser una tarea interminable: es poco probable que alcancen un 99,999 % de exactitud con métodos estándar. En esta sección veremos cómo decidir cuándo la exactitud es suficiente para llevar un LLM a producción con confianza y cómo gestionar los riesgos de la solución que implementes.
Me resulta útil considerar la cuestión desde una perspectiva empresarial y otra técnica. Describiré el enfoque general para cada una y usaré el ejemplo de un servicio de atención al cliente para mostrar cómo gestionamos el riesgo en ambos casos.
Perspectiva empresarial
A una empresa puede costarle confiar en los LLM si está acostumbrada a la relativa previsibilidad de los sistemas basados en reglas, de los sistemas tradicionales de aprendizaje automático o incluso de las personas. Es difícil confiar en un sistema cuando no puedes prever de cuántas formas podría fallar ni cuáles serían esos fallos.
En un caso de atención al cliente, vi que daba buenos resultados el siguiente enfoque:
Primero identificamos los principales escenarios de éxito y de fallo, y asignamos a cada uno un costo estimado. Así podemos usar los resultados de la prueba piloto para explicar claramente cuánto podría ahorrar o costar la solución.
- Por ejemplo, si la IA resuelve un caso que antes resolvía una persona, podríamos ahorrar $20.
- Derivar a un cliente a un agente humano cuando no era necesario podría costarnos $40.
- En el peor de los casos, un cliente se frustra tanto con la IA que deja de usar el servicio, lo que nos cuesta $1000. Suponemos que esto ocurre en el 5 % de los casos.
| Evento | Valor | Cantidad de casos | Valor total |
|---|---|---|---|
| Acierto de la IA | +20 | 815 | $16 300 |
| Fallo de la IA (derivación a un agente humano) | -40 | 175,75 | $7030 |
| Fallo de la IA (pérdida del cliente) | -1000 | 9,25 | $9250 |
| Resultado | +20 | ||
| Exactitud necesaria para cubrir los costos | 81,5 % |
También recopilamos datos sobre el funcionamiento real del proceso para medir el impacto global de la solución. Siguiendo con el ejemplo de atención al cliente, podríamos comparar:
- La puntuación de satisfacción del cliente (CSAT) en interacciones atendidas exclusivamente por personas y en interacciones con IA.
- La exactitud de las decisiones de personas y de la IA en casos revisados retrospectivamente.
- El tiempo que tardan las personas y la IA en resolver un caso.
En el ejemplo de atención al cliente, hicimos varias pruebas piloto para obtener datos claros, que nos ayudaron a tomar dos decisiones importantes:
- Aunque nuestra solución con LLM derivaba más casos de los que queríamos a agentes humanos, reducía considerablemente los costos operativos frente a la solución existente. Esto significaba que incluso una exactitud del 85 % podía ser aceptable si la mayoría de los casos del 15 % restante eran derivaciones prematuras.
- Cuando el costo de un error era muy alto, como al resolver mal un caso de fraude, decidimos que una persona tomaría la decisión y que la IA actuaría como asistente. En ese caso, los datos de exactitud de las decisiones nos llevaron a concluir que no teníamos suficiente confianza para darle plena autonomía a la IA.
Perspectiva técnica
Desde el punto de vista técnico, la tarea es más clara. Una vez que la empresa entiende el valor que espera obtener y el costo de los posibles errores, tu función es crear una solución que pueda recuperarse de los fallos sin interrumpir la experiencia del usuario.
Volvamos al ejemplo de atención al cliente y supongamos que nuestro modelo identifica correctamente la intención del cliente en el 85 % de los casos. Como equipo técnico, podemos reducir el impacto de los errores en el 15 % restante de varias maneras:
- Podemos diseñar el prompt para que el modelo le pida más información al cliente si tiene dudas. Es posible que la exactitud en el primer intento disminuya, pero que mejore si el modelo tiene dos oportunidades para identificar la intención.
- Podemos darle al asistente de segundo nivel la opción de volver a la etapa de identificación de la intención. Esto permite corregir el rumbo durante la interacción, aunque el usuario deba esperar un poco más.
- Podemos diseñar el prompt para que el modelo derive el caso a una persona si la intención no está clara. Esto reduce parte del ahorro operativo a corto plazo, pero puede disminuir el riesgo de perder clientes a largo plazo.
Estas decisiones afectan la experiencia del usuario: mejorar la exactitud puede prolongar la interacción o exigir que una persona intervenga con más frecuencia. Esas intervenciones se reflejan en el modelo de costos de la sección empresarial.
Ahora tienes un enfoque para analizar por separado las decisiones empresariales y técnicas que te permitirán fijar un objetivo de exactitud acorde con la realidad de tu empresa.
Cómo ponerlo en práctica
Este marco general te ayuda a pensar cómo maximizar la exactitud de los LLM, qué herramientas usar y cómo decidir cuándo la exactitud es suficiente para producción. Ya cuentas con un marco y herramientas que puedes aplicar de manera sistemática para llevar tus soluciones a producción. Si quieres conocer lo que otros lograron con estos métodos, consulta las historias de nuestros clientes. Los casos de Morgan Stanley y Klarna muestran lo que puedes conseguir con estas técnicas.
¡Mucho éxito! Nos entusiasma ver qué crearás con estas herramientas.