
GPT-Live mejora la experiencia de los usuarios al seguir el ritmo de la conversación. Pueden intervenir, cambiar de tema y desarrollar una idea mientras hablan. Los sistemas de voz en cascada procesan el habla con modelos separados de transcripción, lenguaje y generación de voz. GPT-Live, en cambio, escucha y habla al mismo tiempo. Así permite intercambios más naturales, en los que el momento de intervenir o interrumpir importa tanto como las palabras.
En este artículo, los equipos de Juno, Picsart, Treater y Weekend cuentan en sus propias palabras cómo desarrollan sus productos con GPT-Live y qué han aprendido al:
- Mejorar las llamadas a partir de datos de producción en tiempo real
- Encontrar voces que inspiren confianza
- Coordinarse con agentes que trabajan en segundo plano
- Orquestar agentes de voz que colaboran entre sí
Veremos los prompts, los flujos de trabajo y los comentarios de los usuarios que dan forma a sus productos, con ideas prácticas que otros desarrolladores pueden probar en sus propias aplicaciones.
Historias de startups
Juno: cómo usamos GPT-Live para que los pacientes conversen con naturalidad con su asistente de voz
Por Marshall Gould, cofundador y director ejecutivo, e Isaac Tolley, cofundador y director de tecnología
Estamos desarrollando Juno, un asistente personal de salud para quienes viven con afecciones crónicas como el COVID prolongado, el síndrome de taquicardia ortostática postural (POTS) y el síndrome de Ehlers-Danlos (EDS).
Lo que nos propusimos crear
Hay que vivir con una enfermedad crónica para entender de verdad lo que implica. A los síntomas intensos, la fatiga, las citas médicas y la ansiedad de no saber qué te pasa se suma todo lo que tienes que gestionar: recordar que te toca reponer un medicamento, leer las investigaciones más recientes, llevar un registro de los síntomas y relacionarlos con cientos de variables que cambian a diario. Y, mientras tanto, intentas llevar una vida normal.
Para quienes viven con una enfermedad crónica, sobre todo si les deja poca energía, el seguimiento supone una carga. Registrar todo a mano resulta agotador y muchas personas terminan abandonando las aplicaciones de seguimiento, aunque les ayuden.
Por eso la voz ha supuesto un cambio tan grande. Con solo decir una frase, puedes hacer que Juno registre varias cosas por ti a la vez.
Lo que todavía cuesta lograr con la voz
Lo que la voz permite hacer desde el primer momento es increíble. Hablar es nuestra forma más natural de comunicarnos, pero todavía estamos aprendiendo a trasladar esa naturalidad a una aplicación. Estos son algunos de los retos pendientes:
- Registrar un síntoma o incorporar contexto sin interrumpir la conversación.
- Llevar a la conversación de voz lo que el agente recuerda del chat de texto sin hacer esperar al usuario.
- Sostener conversaciones largas.
Los modelos de voz me recuerdan a las medusas. Reaccionan rápido, pero tienen poco sentido de la orientación. Se dejan llevar por lo último que dijo el usuario y suelen detenerse a pedir confirmación. Los modelos de texto toman más la iniciativa porque disponen de un contexto mucho más amplio y no necesitan que el usuario explique su situación cada vez. Con la voz, te toca marcar el rumbo.
Cómo mejoramos nuestros agentes de voz
Registrar datos y consultar la memoria sin interrumpir la conversación
Si le pides algo a un agente de voz, lo habitual es que envíe la solicitud a una herramienta y espere la respuesta. Mientras tanto, solo se oye silencio. GPT-Live puede delegar el trabajo en otro agente, pero la conversación queda bloqueada hasta que llega la respuesta. En nuestra primera versión, cuatro de cada cinco llamadas tenían al menos una pausa de ese tipo: “Un momento”, seguido de unos 10 segundos de silencio.
Nuestra solución es sencilla. Después de cada turno, un modelo pequeño y rápido (la Decisions API de OpenAI) responde dos preguntas en segundo plano:
- ¿Hay algo que registrar? ¿De qué tipo?
- ¿Qué información de tu historial es relevante en este momento?
Si dices “Registra un dolor de cabeza”, Juno recibe de inmediato la confirmación del registro mientras el sistema guarda el dato en segundo plano. Es tan rápido que, si preguntas por el dolor de cabeza en el turno siguiente, el dato ya está guardado.
La segunda respuesta determina qué se recupera de la memoria. Solo la información pertinente de tu historial pasa al contexto del turno siguiente. Esto importa porque un modelo de voz trabaja con mucho menos contexto que uno de texto y hay que elegir bien qué incluir.
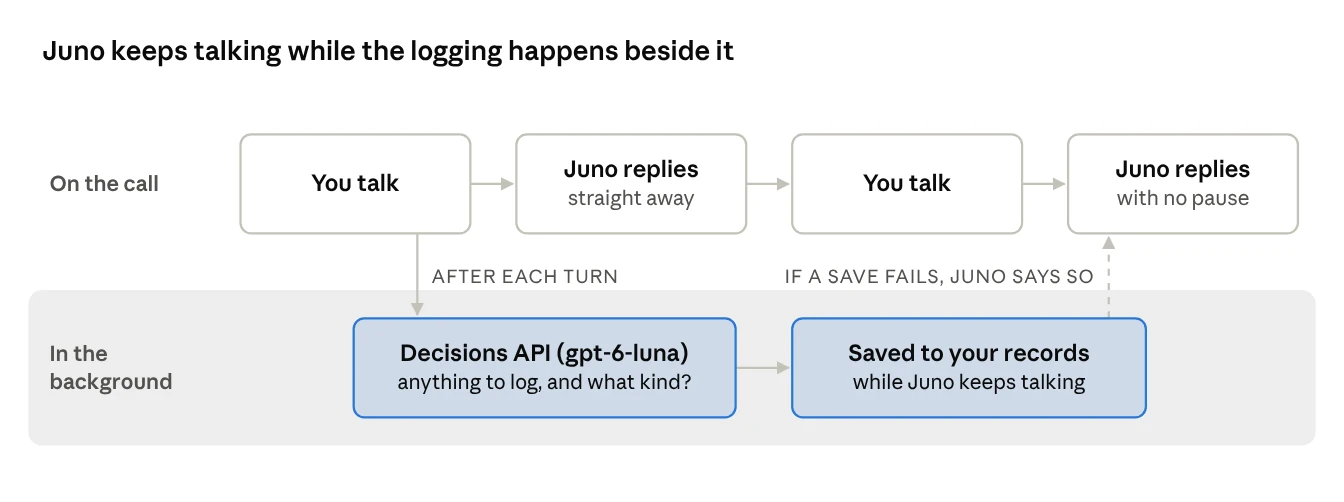
Así redujimos en un 40 % las solicitudes que se delegan al agente de texto. En una llamada de prueba, el silencio más largo pasó de 9,3 segundos a 3,2. Es la diferencia entre una espera incómoda y una pausa natural.
Conversaciones largas
Las conversaciones largas requieren el mismo cuidado. Recuerda la medusa: el modelo tiene poco sentido de la orientación, así que hay que guiarlo. Un agente se ocupa de actualizar el contexto de la llamada. Así, en el turno 100, Juno todavía sabe qué se dijo en el primero y qué tema sacar si la conversación se estanca. Si quieres sostener conversaciones largas, tienes que implementar este mecanismo. Y vale la pena: es ahí donde aparecen los patrones y las tendencias que ayudan a las personas a entender su salud.
Cómo encontramos la voz de Juno con pruebas de escucha
Otro reto es crear una voz que suene justo como queremos. Es más fácil decirlo que hacerlo. La voz que ofrece GPT-Live de serie supone un gran avance frente a las versiones anteriores, pero todavía hay quienes dicen que suena a IA. ¿Se puede crear una voz que funcione para nueve de cada diez personas?
En un grupo de discusión, personas que viven con enfermedades crónicas nos dijeron que nuestra voz hablaba un poco despacio y sonaba algo condescendiente. Tomamos en serio esos comentarios y realizamos un estudio para mejorarla.
Con la función de generación de voz a partir de prompts de GPT-Live, diseñamos voces a partir de breves descripciones escritas. Para compararlas con la voz actual, hicimos una prueba con 290 adultos de Estados Unidos que viven con afecciones crónicas. Todos escucharon las mismas tres frases, puntuaron cada voz y eligieron la que más les gustaba, la que menos les gustaba y la que querrían oír un día en que se sintieran sin energía.
A lo largo de cinco rondas con grupos pequeños, conservamos las mejores voces y reescribimos las descripciones de las demás. Luego, 171 participantes nuevos compararon la voz actual con las dos mejores voces nuevas.
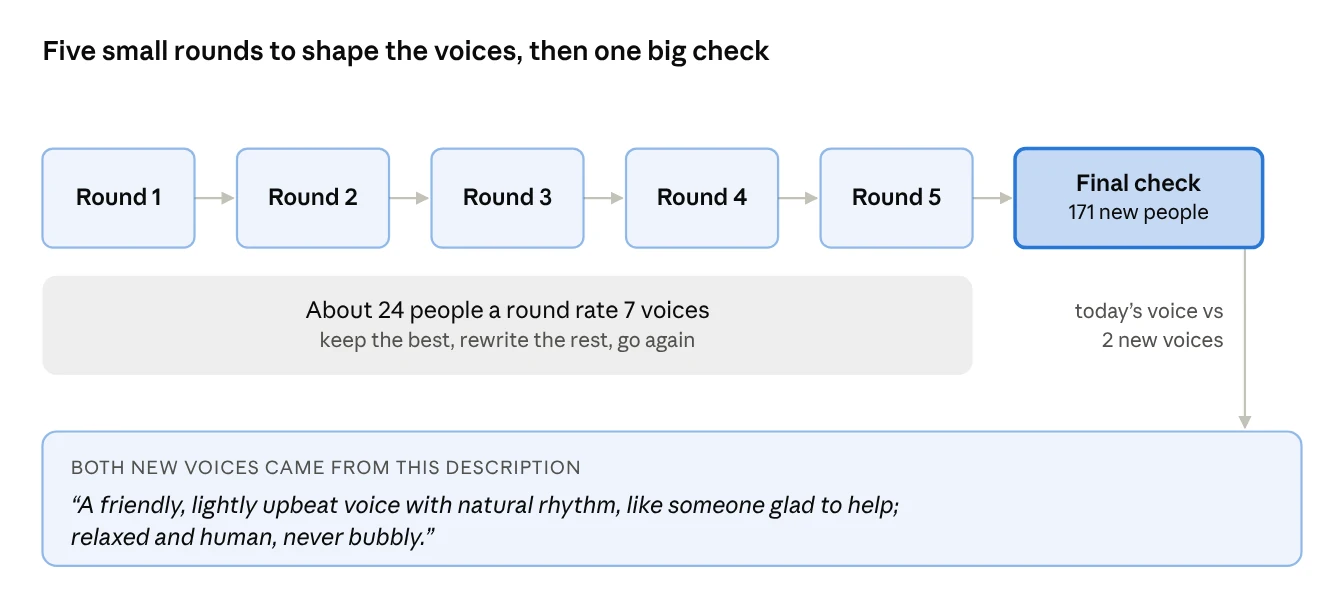
Ganó una voz nueva creada a partir de la descripción del diagrama anterior. En la prueba final, más personas la eligieron como favorita que a la voz actual, menos la señalaron como la que menos les gustaba y muchas menos dijeron que le faltaba calidez.
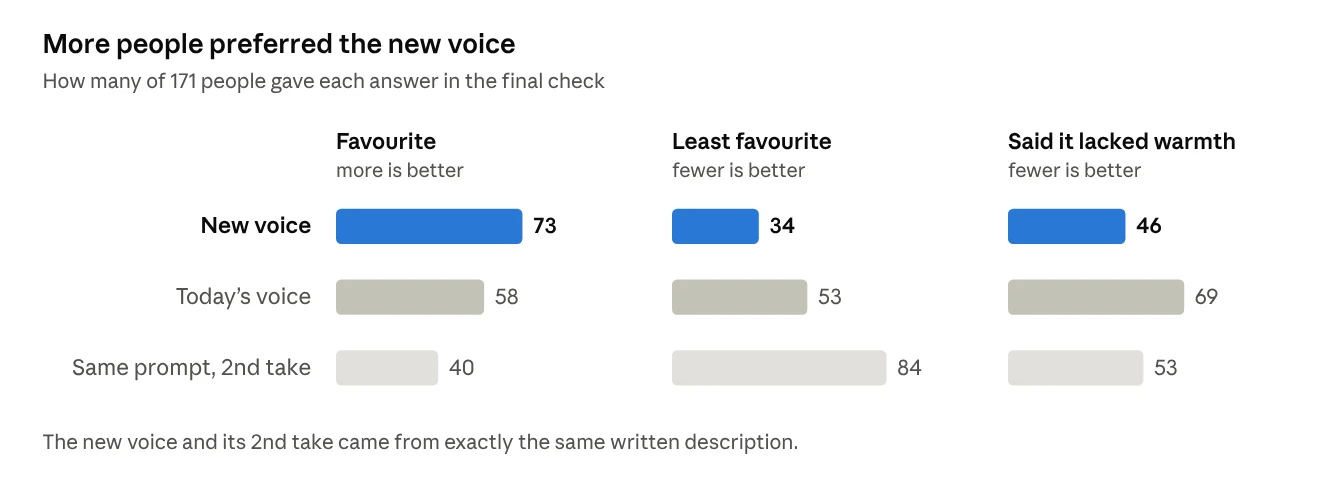
El estudio tiene limitaciones. Los participantes solo escucharon tres frases, las puntuaciones fueron parejas y las condiciones de un estudio son distintas de las de una llamada real. El siguiente paso será probar la voz nueva en llamadas reales con personas que usan Juno por primera vez y ver si más de ellas vuelven al día siguiente.
¿Qué voz elegirías un día en que te sientes sin energía?
También preguntamos qué voz querrían escuchar los participantes un día en que se sintieran sin energía. En esa pregunta, la voz actual superó por poco a la nueva. La diferencia es pequeña, pero nos lleva a una pregunta más amplia: ¿por qué nos empeñamos tanto en encontrar una sola voz perfecta?

Nuestra propia voz cambia. Ajustamos el tono, la velocidad y el volumen según la situación. ¿Y si la voz de Juno se adaptara a cómo te sientes? Las personas confían más en una voz cuando su velocidad y su volumen se parecen a los suyos (Levitan et al., 2016). GPT-Live ya nos permite cambiar la forma de hablar de Juno en plena llamada. Eso es lo que pondremos a prueba en nuestro próximo estudio. Puedes escuchar todas las voces y consultar los resultados completos en junocompanion.com/voice-study.
Ha sido increíble ver lo que ahora pueden hacer con la voz las personas que viven con enfermedades crónicas y cuánto les ha facilitado la vida. GPT-Live es un gran modelo de base, y unos pequeños ajustes se traducen en mejoras que se sienten en el uso diario.
Sobre el autor y la empresa
Soy Marshall Gould, fundador de Juno. Desarrollé la voz de Juno junto con tres investigadores: Isaac Tolley, Sean Lees y Dawid Wraga. Nuestra misión como empresa de IA es ayudar a las personas a vivir con una enfermedad crónica y a manejarla en el día a día. Nos enorgullece que la mayoría de nuestro equipo tenga esa experiencia en primera persona. Hoy, cientos de miles de personas usan Juno y nos encantaría contar con tu ayuda para continuar esta labor. Puedes conocer más en junocompanion.com.
Picsart: cómo sincronizamos la voz con las tareas del agente
Por Dmitry Ivanov, ingeniero de software de nivel Senior Staff en Picsart
Lo que nos propusimos crear
Un proyecto creativo puede durar más que una llamada. Queríamos que los usuarios pudieran hablar con naturalidad con los agentes de IA de Picsart mientras se ejecutaba una tarea, o salir de la llamada y volver cuando estuvieran listos los resultados. Las ideas creativas no siempre llegan del todo definidas. A veces es más fácil conversar sobre el ambiente que quieres transmitir o el rumbo que imaginas que escribir una solicitud precisa.
GPT-Live fue la primera tecnología que nos permitió hacer realidad esa idea. La naturalidad de la conversación en vivo hizo de la voz un medio para desarrollar ideas en conjunto, más allá de dictar órdenes. Eso nos dio la base para llevar esa experiencia a los agentes de IA de Picsart.
Por eso creamos una interfaz de voz independiente para interactuar con el agente, que comparte el hilo con el chat de texto. Elegimos GPT-Live para gestionar la conversación en vivo. Nuestra capa de inteligencia se encarga del razonamiento, las herramientas, los planes y el contexto guardado.
Nuestra solución para separar la conversación de la ejecución de tareas

Como muestra el diagrama, la aplicación envía tareas a la capa de inteligencia y devuelve contexto y respuestas a GPT-Live. Usa una conexión WebSocket compartida para enviar tareas y recibir información sobre su avance y sus resultados. La voz y el texto usan el mismo agente, el mismo proceso de ejecución de tareas y las mismas reglas de aprobación.
Nuestra puerta de enlace de voz configura la sesión con las instrucciones del agente seleccionado. El audio en vivo fluye directamente entre el navegador y OpenAI a través de WebRTC. Una tarea enviada puede seguir ejecutándose después de que termine la llamada.
Cómo se envía una solicitud al agente
Cuando GPT-Live le pide al agente principal que haga algo, enviamos la solicitud oral, los mensajes recientes y los archivos adjuntos al agente y al hilo actuales, con una marca que indica el modo de voz. Guardamos el contexto en el momento del envío para que lo que se diga después no pueda sobrescribir una solicitud en cola.
Le pedimos al agente principal que escriba para quien lo va a escuchar: que dé respuestas breves y naturales, haga una sola pregunta a la vez y evite repetir lo que la voz ya confirmó. También le pedimos que deje claro qué trabajo propone, cuánto cuesta y qué requiere aprobación.
Qué sabe la voz y qué dice en voz alta
Le damos a la voz tres tipos de información:
| Canal | Qué enviamos y cómo lo usa la voz |
|---|---|
| instructions | Identidad del agente, reglas para decidir cuándo encargarle una tarea y reglas de conversación |
| thinking | Mensajes recientes, estado de las tareas, datos seleccionados de las herramientas y acciones del usuario que sirven de contexto sin leerse en voz alta |
| commentary | Respuestas, preguntas y novedades importantes sobre las tareas que deben comunicarse en voz alta |
El canal thinking transmite contexto de la aplicación. El razonamiento privado del agente principal queda fuera de ese canal. Antes de transmitir los resultados seleccionados de las herramientas, eliminamos los campos habituales de credenciales y los datos binarios, limitamos el tamaño de los resultados e indicamos cuáles están incompletos.
Cuando una acción en pantalla envía una solicitud al agente, se lo comunicamos a la voz por el canal thinking. Así puede confirmar la acción sin volver a preguntar ni enviar la solicitud de nuevo.
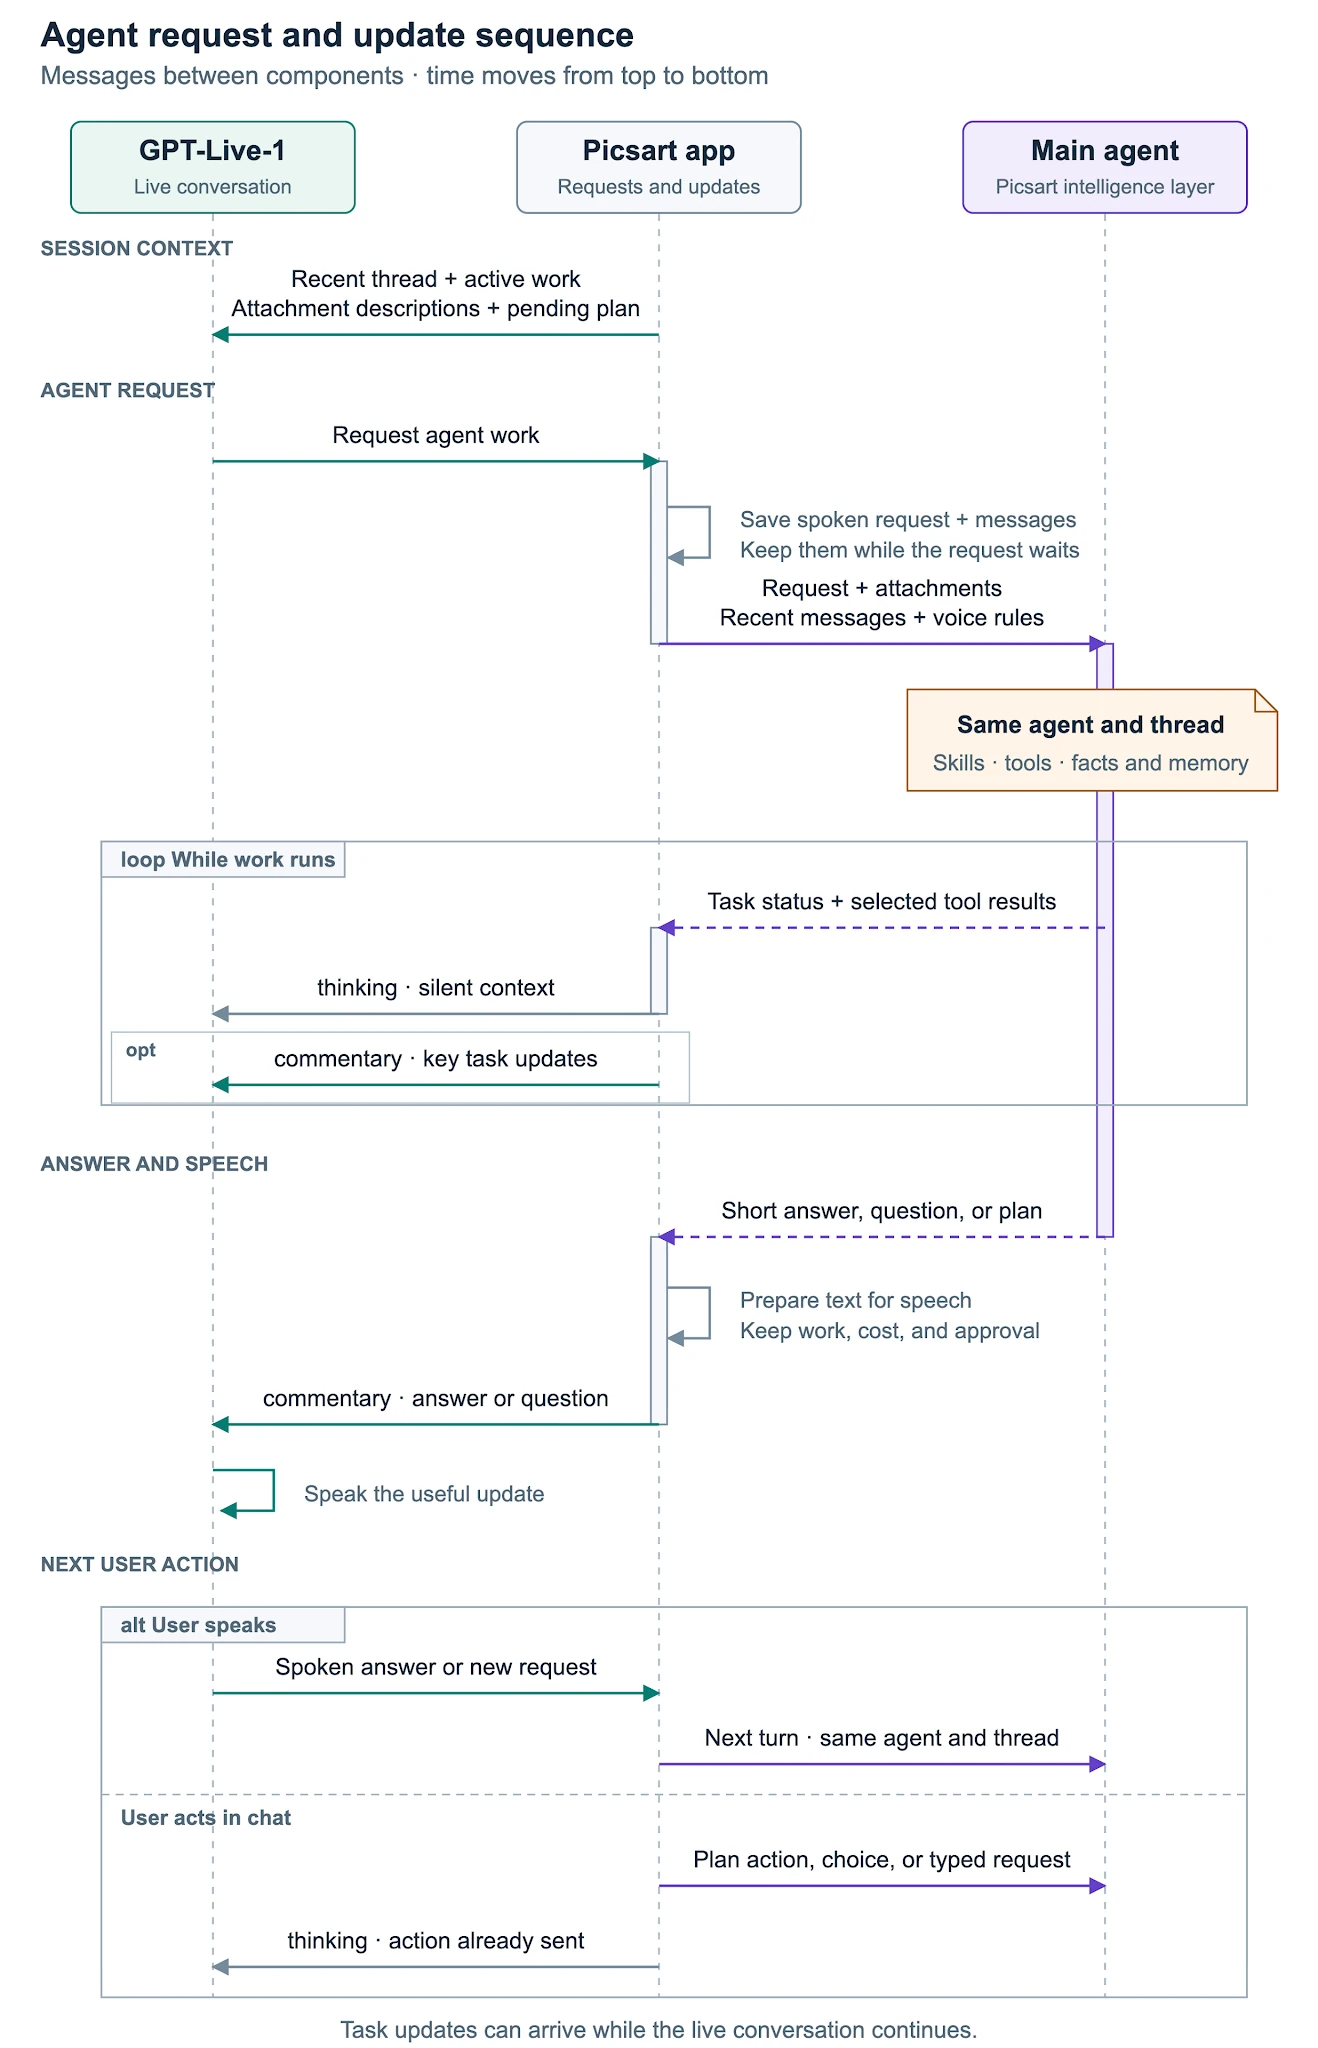
Los pasos rutinarios de las herramientas se ejecutan en silencio. La voz avisa cuando se empieza a ejecutar un plan o se completa una tarea. Agrupamos en oraciones los fragmentos de respuesta a medida que llegan y esperamos una pausa antes de enviarlos a la voz. Cuando llega la respuesta final, omitimos el texto ya enviado, pero sí transmitimos las correcciones y las solicitudes de aprobación.
Qué información se recupera para una llamada y qué se guarda
Las instrucciones de la sesión definen el rol del agente. La información que recuerda del usuario se gestiona por separado. Al inicio de una llamada, cargamos los mensajes recientes, las descripciones de los archivos adjuntos, las tareas activas y las aprobaciones pendientes para que la voz pueda retomar el hilo donde lo dejó el usuario.
La memoria a largo plazo queda a cargo del agente principal. Cuando está activada, el agente puede usar el historial del hilo, los resúmenes, los datos guardados y las preferencias del usuario o del proyecto.
Si el usuario dice “Usa el estilo que guardamos”, el agente principal puede buscarlo o hacer una pregunta aclaratoria y luego devolver la respuesta a la voz. Si la memoria no está disponible, la llamada puede continuar con menos contexto.
En el hilo se guardan las solicitudes enviadas al agente con sus mensajes adjuntos. Solo esos intercambios quedan registrados, de modo que una preferencia mencionada al pasar en una conversación se conserva únicamente si el agente principal la recibe y la guarda.
Cuándo empieza, continúa o se detiene una tarea
La voz comunica el plan después de que el agente lo explica. Solo anunciamos que el trabajo está en marcha cuando el agente confirma que empezó. Presentamos juntos el trabajo propuesto, su costo y la pregunta para solicitar aprobación. Recibir más contexto no autoriza al agente a hacer más trabajo ni a gastar más.
Si nos perdemos una actualización, recuperamos el estado de la tarea existente. Así evitamos reiniciarla o repetir resultados y solicitudes de aprobación.
Interrumpir a la voz o salir de la llamada no cancela la tarea. Para detenerla hace falta una solicitud aparte, y es posible que las acciones que ya están en marcha sigan ejecutándose. Las solicitudes nuevas conservan su contexto original y esperan a que termine el turno actual, sin modificar el trabajo en curso.
Lo que aprendimos: la voz puede saber más de lo que dice
Estas son las lecciones prácticas que nos dejó la integración:
- Prepara las respuestas para la voz en el agente principal.
- Guarda el contexto de cada solicitud al enviarla.
- Usa el mismo hilo y las mismas reglas para la voz, el texto y las acciones en pantalla.
- Mantén la conversación separada de la ejecución de la tarea.
Sobre Picsart
Picsart es una plataforma de producción y distribución de contenido multimedia con IA en la que más de 100 millones de creadores y empresas de todo el mundo crean, promocionan y monetizan contenido.
Hace más de 14 años que Picsart ayuda a una nueva generación de narradores a crear contenido en video, ampliar su producción y, ahora, monetizarlo. Picsart combina herramientas de diseño intuitivas, creación de imágenes y video con IA y funciones de MCP y CLI para que los creadores puedan trabajar en sus entornos habituales. Con más de 100 millones de usuarios activos al mes y más de 2500 millones de descargas hasta la fecha, Picsart permite que cada vez más personas creen contenido por su cuenta, expresen su identidad, amplíen su influencia y pongan en marcha sus propios negocios.
Treater: cómo ajustamos los agentes de voz para mejorar los resultados de las llamadas
Por Britt O’Daly, cofundador y director ejecutivo, Ayaz Hafiz, cofundador y director de tecnología, y Sayd Agzamkhodjaev, desarrollador de software
Cómo lograr resultados a través de una conversación
En una llamada a una agencia de empleo, nuestro agente de voz habló con el dueño sobre las dificultades que tenía su equipo de reclutamiento con el software para programar citas.
Mientras el dueño explicaba por qué la solución anterior no les había funcionado, el agente lo interrumpía una y otra vez con “Ajá” y “Claro, claro”. Al final, el dueño dio por terminada la conversación:
Bueno, mejor mándame un correo.
El agente entendía lo que le decía el dueño, pero sus interrupciones hicieron incómoda la conversación. Una persona que trabaja en ventas aprendería de ese intercambio y ajustaría su manera de conversar en futuras llamadas. Queríamos que nuestros agentes hicieran lo mismo.
En Treater, desarrollamos agentes de IA que ayudan a las empresas a contactar a sus socios y trabajar con ellos por teléfono, correo electrónico y SMS. Queremos que nuestros agentes alcancen los objetivos de nuestros clientes mediante conversaciones de calidad excepcional. Creamos un sistema de aprendizaje que evalúa conversaciones reales, identifica oportunidades de mejora y prueba nuevas configuraciones de los agentes en función de los resultados que buscan los clientes.
En esta demostración, nuestro agente coordina a varias personas para reponer un producto agotado en un supermercado.
Agentes que aprenden con la práctica
Antes de GPT-Live, dedicábamos gran parte de nuestro tiempo a crear y mantener un sistema de voz a la medida. Al adoptar GPT-Live, pudimos sustituir casi todo ese sistema por prompts sencillos y obtuvimos un mejor rendimiento. Las conversaciones más largas se correlacionan con mejores resultados para nuestros clientes. Desde que adoptamos GPT-Live, la mediana de duración de las conversaciones ha aumentado entre un 26 % y un 30 %, con aumentos de hasta un 40 % en el percentil 90.
La tasa de cumplimiento de los objetivos que les importan a nuestros clientes aumentó, en promedio, 6 puntos porcentuales.
Eso nos deja más tiempo para dedicarnos a “lo que hace que nuestra cerveza sepa mejor”: aprender y adaptarnos al entorno siempre cambiante en el que trabajamos. Así como las personas se desarrollan en sus puestos, queremos que nuestros agentes aprendan en la práctica qué significa hacer un trabajo excelente.
Para mejorar nuestros agentes, probamos distintas combinaciones de voz, prompt, ritmo y herramientas disponibles en la configuración de cada uno. Puntuamos cada conversación según criterios nuestros (como el sentimiento expresado y los pasos que se siguieron) y del cliente (como el respeto a sus preferencias y el grado de cumplimiento del objetivo). Usamos un algoritmo de bandido multibrazo para dirigir más tráfico a las configuraciones con buenas puntuaciones y descartar rápidamente las que obtienen peores resultados.
Fuera de línea, un sistema de revisión analiza llamadas anteriores y propone configuraciones nuevas. Probamos cada propuesta con conversaciones pasadas y estimamos la recompensa que obtendría en producción para descartar los cambios que no aportarían una mejora apreciable. Enviamos los cambios a nuestros clientes para que los revisen o, si lo prefieren, los implementamos automáticamente.
Con GPT-Live es muy fácil ajustar muchos de estos parámetros. Antes teníamos que coordinar varios componentes del sistema de voz para cambiar el tono, el ritmo, el grado de formalidad, la frecuencia de las expresiones de asentimiento o la decisión de reflejar la energía del interlocutor. Ahora, en la mayoría de los casos basta con una línea en un prompt, lo que facilita comparar las versiones.
Volvamos a la demostración. ¿Qué aprendió nuestro agente de la llamada con el dueño de la agencia de empleo?
Abre la simulación en una página completa.
La demostración presenta una versión anonimizada y simplificada de la campaña de la introducción. Una empresa parte de un agente con una configuración base para programar demostraciones con agencias de empleo.
- Nuestro sistema detectó una oportunidad. El sistema de revisión fuera de línea analizó llamadas con recompensas bajas y encontró varios patrones. Por ejemplo, en el 20 % de las llamadas, el agente interrumpía a los dueños con expresiones de asentimiento. Propuso cuatro configuraciones nuevas.
- El sistema propuso mejoras. Simulamos cada propuesta con llamadas anteriores y le asignamos una recompensa según los criterios que usamos en producción. La variante que hablaba más despacio obtuvo una puntuación baja y se descartó de inmediato. Las demás se revisaron y aprobaron.
- Evaluación en producción. El tráfico se distribuye entre las versiones nuevas según la recompensa esperada. En un día, la versión B ya atiende la mayoría de las llamadas. La versión C nunca la alcanza y se desactiva el día 3. La versión D, incorporada el día 2, toma la delantera al inicio del día 3 y acaba atendiendo cerca del 90 % de las llamadas. A y B conservan una pequeña proporción por si cambian las condiciones. Las demostraciones programadas por cada 100 llamadas pasan de 3,0 a 4,3.
El sistema tiene una estructura jerárquica. Las mejoras en los arneses de ejecución compartidos benefician a todos los casos de uso, y lo aprendido en un flujo de trabajo sirve como punto de partida para otros similares.
Lecciones que ponemos en práctica
- ¡Todo es una hipótesis! Uno de los ejemplos más claros surgió cuando un cliente quiso que el agente abriera las llamadas con una promoción que iba a lanzar. Las llamadas que empezaban hablando del aumento reciente en la proporción de inventario vendido dieron resultados mucho mejores.
- Asigna recompensas en función de resultados que den información clara y sean importantes para el negocio. Cuando esos resultados tarden en evaluarse (por ejemplo, cerrar un trato nuevo), invierte en recompensas que puedas medir rápido (como programar la siguiente reunión), pero comprueba que ambas medidas estén relacionadas.
- Invierte en poder observar y medir lo que ocurre en el entorno donde trabajan tus agentes. Para que las simulaciones y las pruebas de referencia sean representativas, deben reflejar con precisión la distribución de las situaciones reales.
- Con GPT-Live, prueba a describir lo que buscas en vez de dictar cada paso. Los agentes de GPT-Live responden bien a las pautas generales y pueden adaptarse al contexto sin un guion completo.
Con GPT-Live seguimos dando grandes saltos en la calidad de las conversaciones. ¡Tenemos muchas ganas de descubrir qué nos deparan los próximos diez peldaños!
Sobre Treater
Treater conversa con personas en el mundo real para cumplir los objetivos de tu empresa y trata cada oportunidad como si fuera la más importante. Nuestra plataforma gestiona cientos de miles de llamadas con miles de agentes distintos. Durante el último año, el volumen de llamadas creció un 25 % mensual. Entre nuestros clientes hay desde empresas que cotizan en bolsa hasta startups en rápido crecimiento. Conoce más en trytreater.com.
Weekend: cómo dos personajes de GPT-Live comparten una escena en Wit’s End
Por Kevin Shen, ingeniero sénior de software, y James Wilsterman, cofundador y director de tecnología de Weekend
Lo que nos propusimos crear
Nuestro juego, Wit’s End, es un juego de mesa de fantasía que se juega principalmente con la voz. Sir Bart, un director de juego de IA, cuenta la historia y aplica las reglas. A los jugadores les basta con hablar. Gracias al audio dúplex completo de GPT-Live, la partida se siente como si todos estuvieran sentados a la misma mesa. Los jugadores se interrumpen, bromean y discuten, y Sir Bart reacciona mientras todavía están hablando.
Nuestro punto débil era el reparto. Una sesión de GPT-Live habla con una sola voz, así que tanto el capitán malhumorado de la entrada del pueblo como la anciana asustada de la taberna sonaban igual que el narrador. Queríamos que el personaje principal de cada escena hablara por sí mismo, con voz y personalidad propias, sin perder lo que hace funcionar el juego: los jugadores tienen la libertad de decir cualquier cosa y, aun así, la historia llega a su desenlace.
Así transcurre ahora una escena. El grupo llega a la entrada de Timberfall. Sir Bart describe lo que ve el grupo y hace una pausa: “Un grupo de guardias imperturbables vigila la entrada. Su capitán da un paso al frente, con la mano en la espada, y los mira de arriba abajo”. El capitán Dmitri toma la palabra con una voz grave y áspera. Busca a una traidora llamada Jade y los miembros del grupo encajan con la descripción de sus cómplices. Un jugador discute con él y Dmitri le responde en el mismo tono. Otro le desliza una moneda de oro. Sir Bart interviene para anunciar la tirada de dados, cuenta qué efecto tiene el soborno y le devuelve la palabra a Dmitri, que reacciona a lo ocurrido.
Nuestra solución: dos voces y un director
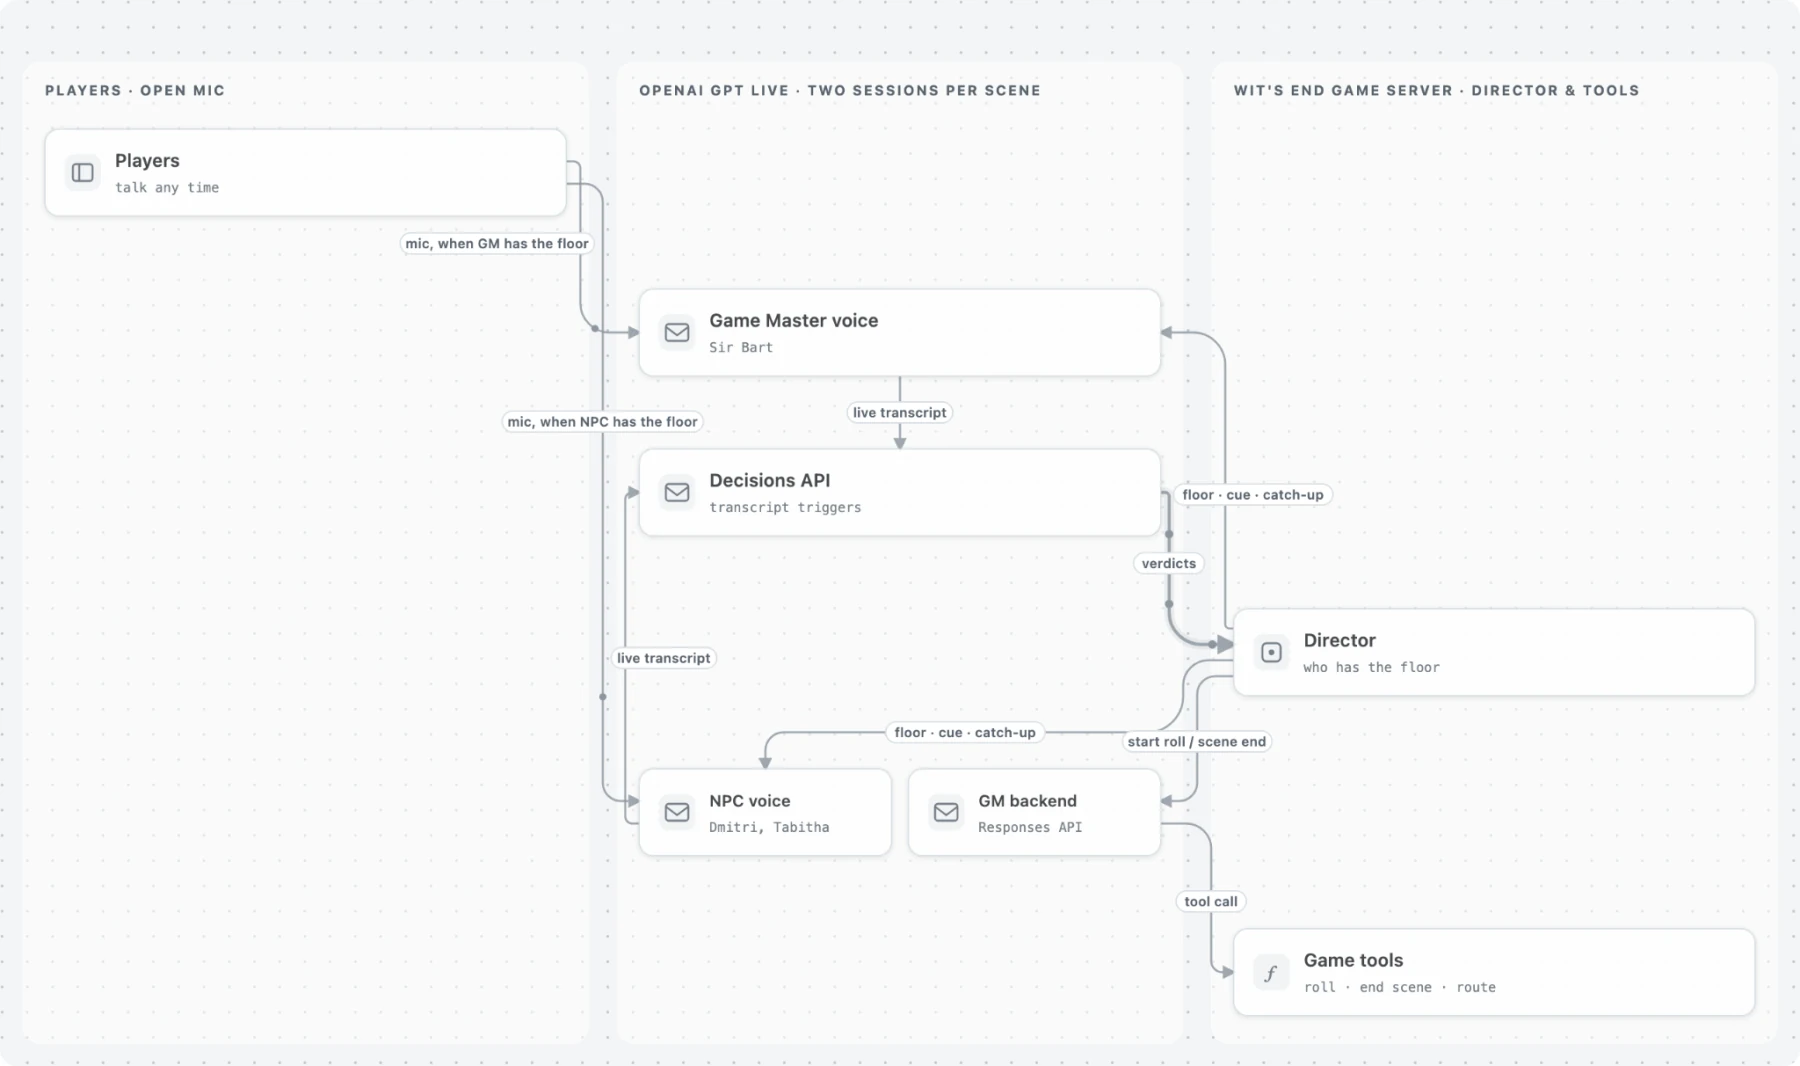
Quién tiene la palabra. A partir de las transcripciones de ambas sesiones, la Decisions API emite dictámenes que indican al director quién debe hablar a continuación. El director alterna la palabra entre las dos voces e inicia las tiradas de dados y el cierre de las escenas en el backend del director de juego.
En cada escena se ejecutan dos sesiones de GPT-Live en paralelo: una para Sir Bart y otra para el personaje de la escena (Dmitri en la entrada del pueblo, Tabitha en la taberna). Cada una tiene su propio prompt y una voz personalizada. Un director que se ejecuta en el servidor del juego decide quién tiene la palabra. Solo la sesión que tiene la palabra oye a los jugadores. En ambas sesiones, los activadores basados en la transcripción de la Decisions API indican al director qué está ocurriendo en la conversación. El backend del director de juego, un modelo de Responses, es el único componente que llama a las herramientas del juego para las tiradas de dados, los cierres de escena y las rutas.
Dos personalidades y una sola historia
Para cada personaje, distinguimos entre lo que le es propio y lo que comparte con los demás.
Su personalidad se define en su propio prompt.
Cada prompt también describe la voz del personaje con las mismas palabras que usamos para diseñarla.
Ejemplo de una escena compartida
La escena es común a ambas voces. Sir Bart y el personaje reciben el mismo conflicto, el mismo desenlace y los mismos momentos clave de la historia. En cada uno se indica quién debe hablar. Dmitri se presenta y dice a quién busca. Tabitha le cuenta al grupo dónde se reunirá Jade con ellos. El juego solo da por terminada una escena cuando cada voz ha dicho las partes que le corresponden.
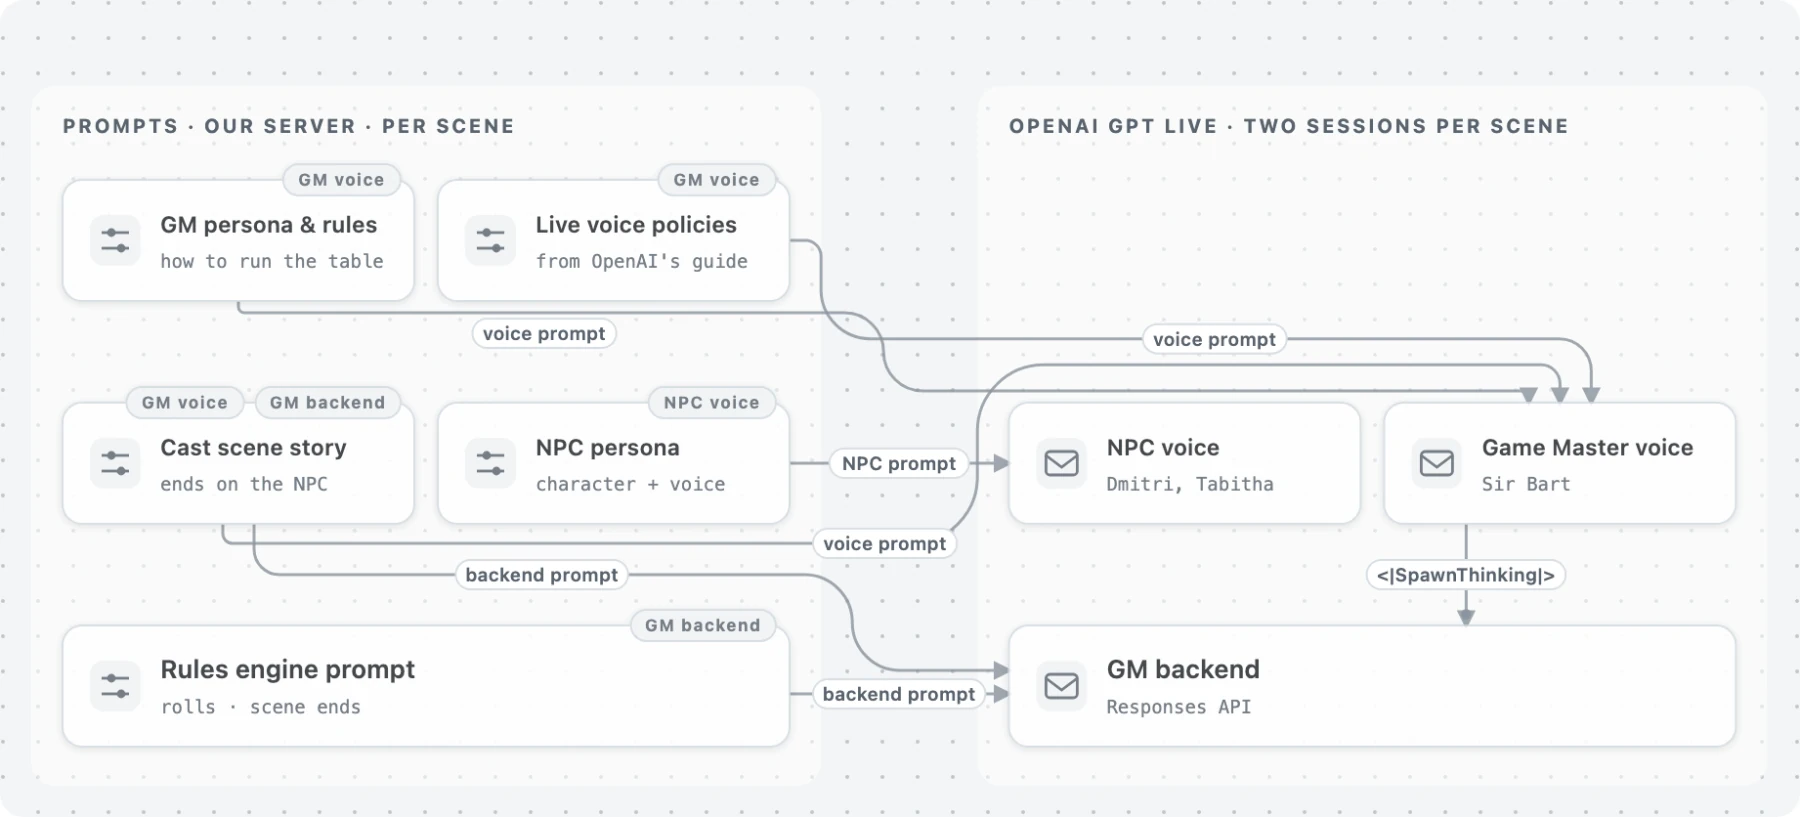
Estructura de los prompts. La voz de Sir Bart y su backend comparten la historia de la escena. El personaje recibe un prompt propio que define su personalidad.
Fragmento del prompt del personaje
Interpretas a un personaje en una escena oral en vivo.
Un narrador describe el mundo. Habla siempre como tu
personaje, en voz alta y en primera persona.
- Nunca narres, describas tus acciones o tu voz, ni
  hables en nombre de los viajeros o del narrador.
- Nunca decidas si un intento arriesgado tiene éxito.
  Reacciona con una sola frase breve y detente.
  El narrador decide el resultado.
- Habla solo cuando un viajero se dirija a ti o
  cuando te den la palabra.
Cómo elige el director quién habla a continuación
El director no genera voz. Usa los dictámenes que emite la Decisions API a medida que llegan fragmentos de la transcripción para identificar a quién se dirige un jugador, si una acción requiere una tirada de dados y cuándo la narración o la última frase de un personaje indica que es momento de ceder la palabra.

Los dictámenes cambian mientras habla el jugador. Para identificar al destinatario, el director espera el dictamen definitivo al final del turno. En cambio, envía las acciones arriesgadas al director de juego en cuanto las reconoce.
Quién habla a continuación
| Cuándo | Quién habla a continuación |
|---|---|
| Sir Bart termina de narrar y la puntuación de la señal para ceder la palabra es de 0,6 o más, o su intervención termina con un verbo de habla (“Tabitha los llama mientras se alejan”) | El personaje |
| Un jugador le habla al personaje mientras Sir Bart tiene la palabra | El personaje, que recibe la frase a la que debe responder |
| Un jugador intenta algo arriesgado, como sobornar, mentir, pasar a escondidas o pelear | Sir Bart, de inmediato, incluso a mitad de una frase si hace falta. El director inicia la tirada en el backend de Sir Bart. Sir Bart narra el resultado y devuelve la palabra al personaje |
| Un jugador le pregunta algo al narrador o describe lo que hace su personaje | Sir Bart |
| Los jugadores hablan entre sí | Nadie. Quien tiene la palabra recibe una indicación válida solo en esa ocasión para que deje pasar el comentario |
| El personaje concluye su intervención con sus propias palabras (“Pasen, entonces. Procuren que no los vean”) | Sir Bart, una vez que el personaje termina de hablar. El director inicia el cierre de la escena en el backend de Sir Bart |
| Quien recibió la palabra permanece en silencio durante 2,5 s | La misma voz, que recibe de nuevo la indicación de hablar |
Cómo se cede la palabra
Cada cambio de turno consta de cuatro pasos:
- El director silencia la sesión que cede la palabra, le indica que se detenga y descarta el audio que tenga en cola.
- Pone al día a la sesión que recibe la palabra mediante
session.thinking.append, con contexto que no se lee en voz alta. Añade las mismas frases a su contexto de Decisions para que los activadores evalúen la situación con el mismo historial. - Reactiva el audio de la sesión que recibe la palabra y le da la señal para hablar.
- Mantiene en pausa los micrófonos de los jugadores hasta que la nueva voz termina su primera oración, con un máximo de 8 s, para que nadie hable encima durante el cambio.
Como la sesión del personaje ya está en marcha, al cambiar de turno se oye el primer audio al cabo de 0,84 s en promedio, frente a 1,54 s si se inicia una sesión nueva.
Cómo hacer que la partida avance hacia un desenlace
Las voces improvisan. La aplicación decide cuándo ocurre algo.
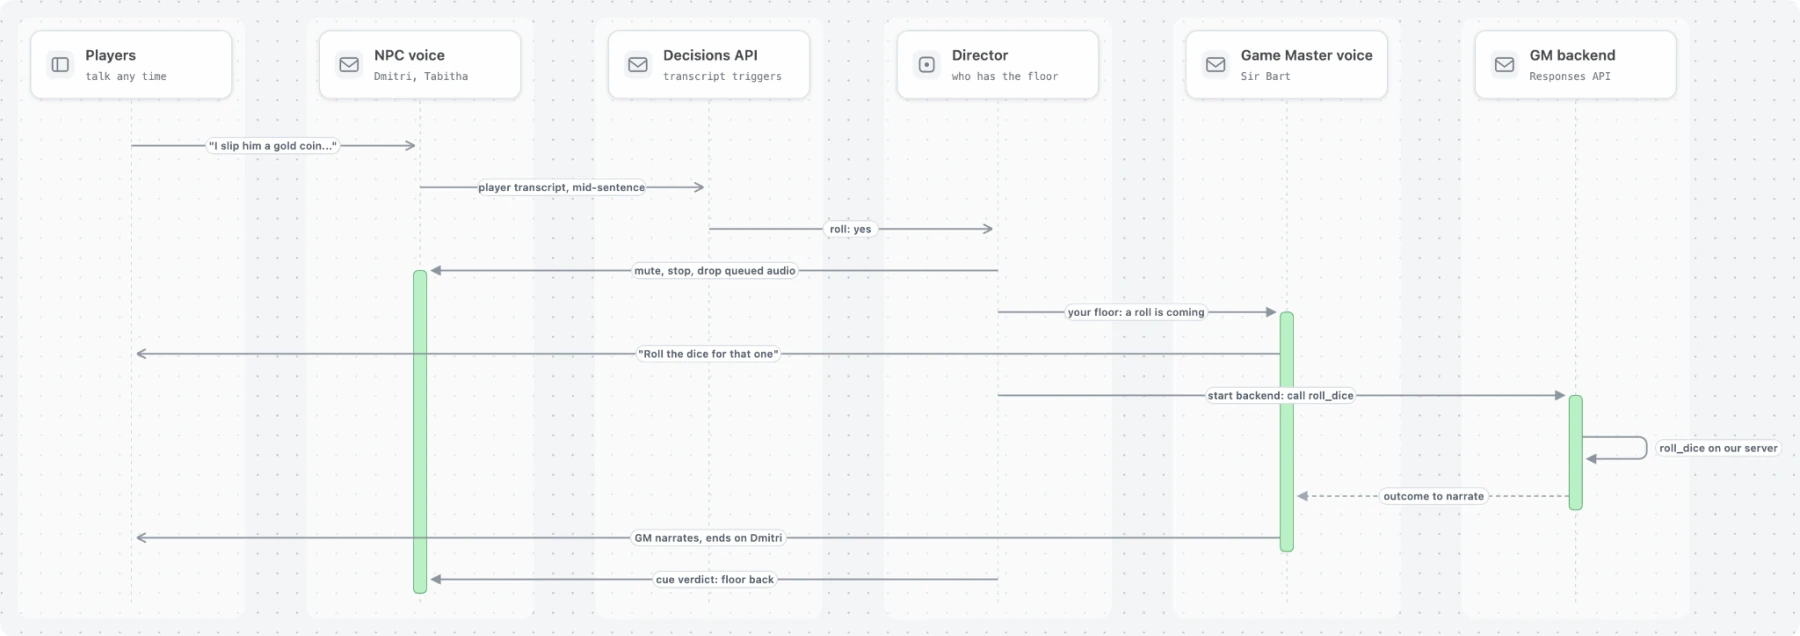
Un soborno mientras Dmitri tiene la palabra. El dictamen que indica que hace falta una tirada llega a mitad de la frase. El director le da la palabra a Sir Bart e inicia la tirada en su backend. Una vez que Sir Bart narra el resultado, otro dictamen indica que es hora de devolverle la palabra a Dmitri.
- El propio director inicia las tiradas y los cierres de escena. En una partida de prueba, Sir Bart dijo “Para eso vas a tener que tirar los dados”, pero nunca envió la solicitud a su backend. No hubo tirada y Sir Bart inventó el resultado. Ahora el director inicia una respuesta directamente en el backend de Sir Bart. La voz dice una frase breve mientras se ejecuta la tirada y luego narra el resultado.
- Los dados resuelven cada escena. La escena 1 termina con una tirada exitosa. Si Dmitri cede antes de que se tiren los dados, el director somete el intento de los jugadores a una tirada en vez de cerrar la escena.
- Un personaje puede dar por terminada su intervención y el director de juego cierra la escena. Cuando Tabitha le dice al grupo que Jade se reunirá con ellos en el Altar de los Duendes, el director le da la palabra a Sir Bart. Su backend marca la escena como completada y Sir Bart ofrece los dos caminos de salida.
Lo que aprendimos
- Solo una sesión debe oír a los jugadores. Cuando nuestros dos sistemas escuchaban a la vez, ambos respondían a cada frase de prueba y a menudo se contradecían. Dmitri rechazaba un soborno mientras el director de juego contaba cómo se guardaba la moneda en el bolsillo.
- Silenciar el audio de una sesión no basta para que deje de hablar. Indícale que se detenga y descarta el audio en cola. Cuando recupere la palabra, retira de forma explícita la instrucción “Guarda silencio”. Una vez, un director de juego siguió sujeto a esa regla y pasó una escena entera sin responderle a nadie.
- Mantén activa la sesión de cada voz. La voz de una sesión se establece al iniciarla, por lo que cada voz necesita su propia sesión. Iniciar la sesión del personaje al comienzo de la escena ahorra unos 0,7 s cada vez que se cede la palabra. Es la diferencia entre un cambio de turno fluido y una pausa incómoda.
- Actúa en el momento adecuado para cada dictamen. Los dictámenes empiezan a llegar mientras el jugador todavía habla. La mediana del tiempo que tarda en llegar el último desde que el jugador deja de hablar es de 0,19 s. Envía una acción arriesgada al director de juego en cuanto se reconozca. Para decidir a quién se dirigía el jugador, espera a que termine el turno y se estabilice el dictamen.
- Formula predicados como preguntas de sí o no, fija los umbrales con frases reales y conserva una regla sencilla de respaldo. La pregunta “Should Dmitri speak next?” acertó en 11 de 12 casos al formularse como predicado y en 8 de 12 al plantearse como una elección entre dos opciones. Con un umbral de 0,4, la frase “You’re going to have to roll the dice for that one” se interpretó como señal de cambio de turno y Dmitri recibió la palabra en plena tirada. Las señales reales obtuvieron puntuaciones de 0,94 o más, así que usamos un umbral de 0,6. La frase “Tabitha calls after you” obtuvo 0,04. Por eso también comprobamos si hay un verbo de habla para reconocer los casos en que la narración termina justo donde empieza el diálogo del personaje.
- Asigna un solo responsable a cada resultado. Solo el backend del director de juego llama a las herramientas, y es la aplicación la que inicia las tiradas y los cierres de escena. Así, cada personaje puede improvisar con libertad sin alterar las reglas del juego.
Sobre los autores y la empresa
El equipo de Weekend crea Wit’s End, un juego de mesa de fantasía centrado en la voz. Un director de juego de IA lleva la historia y los jugadores solo tienen que hablar, ya sea en el navegador o en el televisor. Pruébalo en witsend.ai.
Weekend, antes Volley, crea juegos de voz para televisión con los que las familias pueden pasar tiempo juntas y jugar en voz alta. Sus más de 25 juegos, entre ellos Jeopardy!, Wheel of Fortune, Song Quiz y Wit’s End, funcionan en Roku, Fire TV y televisores Samsung y LG. Ya se han jugado en más de 30 millones de hogares. Weekend cuenta con el respaldo de M12 de Microsoft, Lightspeed Venture Partners y Y Combinator.
Qué viene para los agentes de voz
El siguiente paso para la voz va más allá de mejorar las conversaciones. Se trata de crear software que pueda seguir escuchando mientras se ejecuta una tarea, trasladar el contexto de una interfaz a otra y coordinar varias voces sin perder el hilo. Como GPT-Live puede escuchar y hablar al mismo tiempo, los desarrolladores tienen una base para crear experiencias que sigan el ritmo de la conversación sin obligar a las personas a esperar su turno.
Estas cuatro historias muestran cómo se logra en la práctica. Juno pone a prueba las voces con las personas que las usan. Picsart sincroniza la conversación con las tareas en segundo plano. Treater aprende de llamadas reales. Weekend le da una voz a cada personaje sin perder el control de la partida.
GPT-Live ofrece una forma intuitiva de interactuar con el software y amplía lo que pueden hacer los agentes. Las personas pueden dar forma a una idea creativa mientras hablan, orientar un trabajo en curso o entrar en una historia e influir en lo que sucede después. Estos proyectos son solo el comienzo de lo que pueden crear los desarrolladores cuando la conversación pasa a formar parte del funcionamiento del software.
Para crear tu propia experiencia, explora la guía de introducción a GPT-Live y la documentación sobre delegación y herramientas.