Aprende cómo funcionan los modelos de razonamiento y cómo usarlos de manera eficaz.
Responses
Los modelos de razonamiento usan tokens internos de razonamiento antes de generar una respuesta. Esto ayuda al modelo a planificar, usar herramientas de manera eficaz, evaluar alternativas, resolver ambigüedades y abordar tareas más difíciles de varios pasos. Los modelos de razonamiento funcionan especialmente bien para resolver problemas complejos, programar, aplicar el razonamiento científico y ejecutar flujos de trabajo de varios pasos con agentes. También son los mejores modelos para Codex CLI, nuestro agente de programación ligero.
Para la mayoría de las cargas de trabajo que requieren razonamiento, empieza con gpt-6-astra. Para reducir el costo, considera gpt-5.6-terra, o elige gpt-5.6-luna para obtener el menor costo y la menor latencia. Si usas un modelo GPT-5.6 o GPT-6, consulta la sección sobre el modo de razonamiento para conocer la opción pro.
Los modelos de razonamiento funcionan mejor con la API de Responses. Aunque la API para completar chats sigue siendo compatible, con Responses obtendrás mejores resultados tanto en inteligencia como en rendimiento del modelo.
Primeros pasos con el razonamiento
Llama a la API de Responses y especifica el modelo y el esfuerzo de razonamiento:
Usar un modelo de razonamiento en la API de Responses
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21import OpenAI from "openai";const openai = new OpenAI();const prompt = `Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format.`;const response = await openai.responses.create({ model: "gpt-6-astra", reasoning: { effort: "low" }, input: [ { role: "user", content: prompt, }, ],});console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16from openai import OpenAIclient = OpenAI()prompt ="""Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format."""response = client.responses.create(model="gpt-6-astra",reasoning={"effort": "low"},input=[{"role": "user", "content": prompt}],)print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() prompt := `Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format.` response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Reasoning: responses.ReasoningParam{ Effort: responses.ReasoningEffortLow, }, Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String(prompt), }, }) if err != nil { panic(err) } fmt.Println(response.OutputText())}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.Reasoning;import com.openai.models.ReasoningEffort;import com.openai.models.responses.ResponseCreateParams;String prompt = """ Write a bash script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format. """ .strip();ResponseCreateParams params = ResponseCreateParams.builder() .model("gpt-6-astra") .input(prompt) .reasoning(Reasoning.builder().effort(ReasoningEffort.LOW).build()) .build();client.responses().create(params).output().stream() .flatMap(item -> item.message().stream()) .flatMap(message -> message.content().stream()) .flatMap(content -> content.outputText().stream()) .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);string prompt = """ Write a bash script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format. """;CreateResponseOptions options = new(){ Model = "gpt-6-astra", ReasoningOptions = new ResponseReasoningOptions { ReasoningEffortLevel = ResponseReasoningEffortLevel.Low, },};options.InputItems.Add(ResponseItem.CreateUserMessageItem(prompt));ResponseResult response = await client.CreateResponseAsync(options);Console.WriteLine(response.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15require "openai"client = OpenAI::Client.newprompt = <<~PROMPT Write a bash script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format.PROMPTresponse = client.responses.create( model: "gpt-6-astra", reasoning: { effort: :low }, input: prompt)puts(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13curl https://api.openai.com/v1/responses \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -d '{
    "model": "gpt-6-astra",
    "reasoning": {"effort": "low"},
    "input": [
      {
        "role": "user",
        "content": "Write a bash script that takes a matrix represented as a string with format \"[1,2],[3,4],[5,6]\" and prints the transpose in the same format."
      }
    ]
  }'
Esfuerzo de razonamiento
El parámetro reasoning.effort orienta al modelo sobre cuánto debe razonar al realizar una tarea.
Los valores admitidos dependen del modelo y pueden incluir none, minimal, low, medium, high, xhigh y max. Un esfuerzo menor favorece la velocidad y reduce el consumo de tokens. Con un esfuerzo mayor, el modelo razona más a fondo para ofrecer respuestas de mayor calidad. En todos los niveles de esfuerzo, los modelos también adaptan su razonamiento a la tarea: usan menos tokens para las tareas sencillas y razonan más a fondo para las complejas.
GPT-6 Astra no admite el nivel de esfuerzo de razonamiento none. Si configuras reasoning.effort (Responses) o reasoning_effort (Chat Completions) en none, la API devuelve un error HTTP 400. GPT-6.1 Sol no admite none ni minimal y usa medium de forma predeterminada.
Usa la API de Responses para la llamada a funciones. Chat Completions no admite la llamada a funciones con GPT-6 Astra ni con GPT-6.1 Sol.
El valor predeterminado también depende del modelo. En gpt-5.5, el esfuerzo de razonamiento predeterminado es medium. Es el mejor punto de partida para aprovechar el equilibrio entre calidad, confiabilidad y rendimiento que ofrece gpt-5.5.
Esfuerzo
Cuándo usarlo
none
Para tareas en las que la latencia es crítica y que no se benefician del razonamiento ni de encadenar varias llamadas a herramientas. Si la latencia es importante y usas gpt-5.5, recomendamos probar primero low y pasar a none si es necesario.
Los casos de uso habituales incluyen aplicaciones de voz, recuperación rápida de información y clasificación.
low
Para razonar de manera eficiente con un aumento moderado de la latencia. Es ideal para tareas que requieren usar herramientas, planificar, buscar o tomar decisiones en varios pasos y en las que se busca optimizar la velocidad y el costo.
Los casos de uso habituales incluyen el análisis de datos, la redacción de borradores, la programación orientada a la ejecución y los flujos de trabajo de atención al cliente o de asistentes de chat.
medium
Cuando la calidad y la confiabilidad son importantes y la tarea requiere planificación, razonamiento complejo y criterio. Es la configuración predeterminada para la mayoría de las cargas de trabajo y ofrece un buen equilibrio en la curva de Pareto entre latencia, rendimiento y costo.
Los casos de uso habituales incluyen la codificación con agentes, la investigación, el trabajo con hojas de cálculo y diapositivas, y la delegación de tareas a largo plazo.
high
Para problemas de razonamiento difíciles, depuración compleja, planificación detallada y tareas de alto valor en las que la calidad y la inteligencia importan más que la latencia. Se recomienda para flujos de trabajo complejos y tareas con agentes.
Los casos de uso habituales incluyen la codificación con agentes, la investigación a largo plazo y el trabajo intelectual. Según la complejidad de la tarea, evalúa tanto medium como high.
xhigh
Para investigación profunda, flujos de trabajo asíncronos y tareas con agentes que requieren ejecuciones prolongadas. Úsalo solo si tus evaluaciones muestran un beneficio claro que justifique la latencia y el costo adicionales.
Los casos de uso habituales incluyen las revisiones de seguridad y de código, la productividad empresarial, las tareas de investigación más exhaustivas y los flujos de trabajo de programación difíciles.
max
Para aplicar el máximo razonamiento a tus tareas más complejas. Si actualmente usas xhigh, evalúa si max ofrece un mejor rendimiento.
Para que el primer token visible aparezca antes en aplicaciones sensibles a la latencia, pide al modelo que genere un preámbulo breve antes de continuar con un razonamiento más profundo.
Algunos modelos solo admiten un subconjunto de estos valores. Consulta la página del modelo correspondiente antes de elegir una configuración.
Modo de razonamiento
Los modelos GPT-5.6 y GPT-6 admiten los modos de razonamiento standard y pro en la API de Responses. El modo predeterminado es standard. Configura reasoning.mode en pro para tareas difíciles que exijan más trabajo del modelo y que puedan tolerar una mayor latencia y un mayor consumo de tokens.
El modo y el esfuerzo de razonamiento son independientes. El modo determina si la ejecución es estándar o Pro, mientras que reasoning.effort controla cuánto razona el modelo dentro de ese modo. Si omites reasoning.effort, GPT-5.6 usa medium de forma predeterminada en ambos modos. GPT-6.1 Sol, GPT-6 Sol y GPT-6 Luna también usan medium como esfuerzo de razonamiento predeterminado.
El modo Pro suma el trabajo que realiza el modelo para generar la respuesta final y factura los tokens correspondientes según las tarifas por token estándar del modelo seleccionado. En el modo Pro, el modelo realiza más trabajo que en el modo estándar, lo que aumenta el consumo de tokens y el costo. Los identificadores de los modelos Pro existentes conservan su comportamiento y sus precios actuales.
Cómo funciona el razonamiento
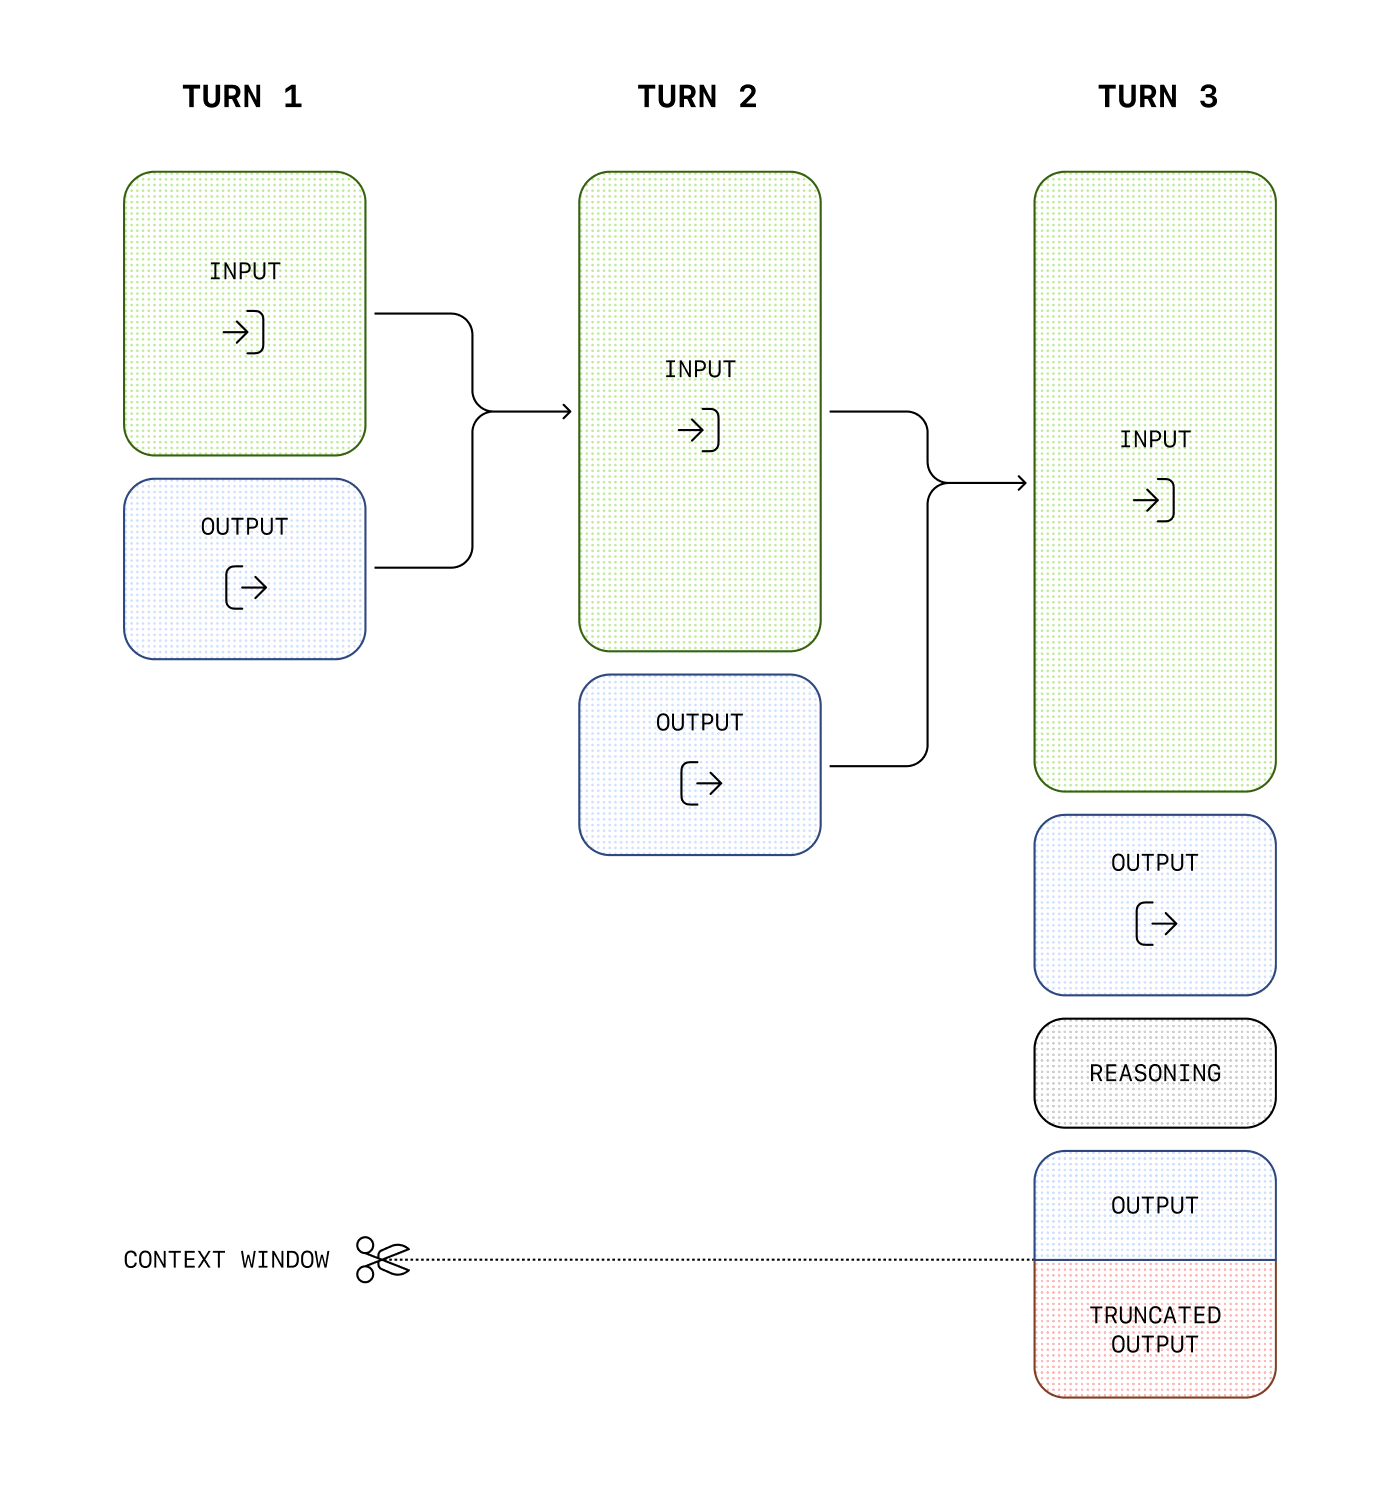
Además de los tokens de entrada y de salida, los modelos de razonamiento usan tokens de razonamiento. Los modelos usan estos tokens para “pensar”: descomponen el prompt y consideran distintos enfoques para generar una respuesta. Nuestros modelos de razonamiento, como gpt-5.5 y gpt-5.4, pueden intercalar el razonamiento con otras acciones. Pueden generar tokens de salida visibles antes de razonar y entre etapas de razonamiento, así como razonar entre llamadas a herramientas.
En una conversación de varios pasos, los modelos anteriores a GPT-5.6 conservan de forma predeterminada los tokens de entrada y de salida de cada paso sin incorporar el razonamiento de turnos anteriores al contexto de la siguiente generación. En cambio, los modelos GPT-5.6 incorporan de forma predeterminada el razonamiento disponible de turnos anteriores. Usa reasoning.context para elegir entre estos dos comportamientos en los modelos compatibles.
Aunque la API no muestra los tokens de razonamiento, estos ocupan espacio en la ventana de contexto del modelo y se facturan como tokens de salida.
Control de costos
Para administrar los costos de los modelos de razonamiento, puedes limitar la cantidad total de tokens que genera el modelo con el parámetro max_output_tokens. El límite incluye los tokens de razonamiento, los tokens de salida visibles y los tokens de formato no visibles. Consulta el recuento de tokens de salida para saber cómo se contabilizan los tokens generados en el consumo y en los límites de salida.
Administración de la ventana de contexto
Al generar respuestas, asegúrate de que la ventana de contexto tenga suficiente espacio para los tokens de razonamiento. Según la complejidad del problema, los modelos pueden generar desde unos cientos hasta decenas de miles de tokens de razonamiento. Puedes ver la cantidad exacta de tokens de razonamiento utilizados en el objeto de uso del objeto de respuesta, dentro de output_tokens_details:
Puedes consultar el tamaño de la ventana de contexto en la página de referencia de modelos. El tamaño varía entre versiones del modelo.
Reserva de espacio para el razonamiento
Si los tokens generados alcanzan el límite de la ventana de contexto o el valor que configuraste en max_output_tokens, recibirás una respuesta con status establecido en incomplete y, dentro de incomplete_details, con reason establecido en max_output_tokens. Esto puede ocurrir antes de que se genere el primer token de salida visible. En ese caso, podrías incurrir en costos por los tokens de entrada y de razonamiento sin recibir una respuesta visible.
Para evitarlo, asegúrate de que haya suficiente espacio en la ventana de contexto o aumenta el valor de max_output_tokens. OpenAI recomienda reservar al menos 25 000 tokens para el razonamiento y la salida cuando empieces a experimentar con estos modelos. A medida que conozcas la cantidad de tokens de razonamiento que requieren tus prompts, podrás ajustar ese margen.
Manejar respuestas incompletas
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32import OpenAI from "openai";const openai = new OpenAI();const prompt = `Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format.`;const response = await openai.responses.create({ model: "gpt-6-astra", reasoning: { effort: "medium" }, input: [ { role: "user", content: prompt, }, ], max_output_tokens: 300,});if ( response.status === "incomplete" && response.incomplete_details.reason === "max_output_tokens") { console.log("Ran out of tokens"); if (response.output_text?.length > 0) { console.log("Partial output:", response.output_text); } else { console.log("Ran out of tokens during reasoning"); }}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25from openai import OpenAIclient = OpenAI()prompt ="""Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format."""response = client.responses.create(model="gpt-6-astra",reasoning={"effort": "medium"},input=[{"role": "user", "content": prompt}],max_output_tokens=300,)if ( response.status =="incomplete"and response.incomplete_details.reason =="max_output_tokens"):print("Ran out of tokens")if response.output_text:print("Partial output:", response.output_text)else:print("Ran out of tokens during reasoning")
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() prompt := `Write a bash script that takes a matrix represented as a string withformat '[1,2],[3,4],[5,6]' and prints the transpose in the same format.` response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", MaxOutputTokens: openai.Int(300), Reasoning: responses.ReasoningParam{ Effort: responses.ReasoningEffortMedium, }, Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String(prompt), }, }) if err != nil { panic(err) } if response.Status == responses.ResponseStatusIncomplete { fmt.Println("Ran out of tokens") if text := response.OutputText(); text != "" { fmt.Println("Partial output:", text) } }}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.Reasoning;import com.openai.models.ReasoningEffort;import com.openai.models.responses.Response;import com.openai.models.responses.ResponseCreateParams;import com.openai.models.responses.ResponseStatus;ResponseCreateParams params = ResponseCreateParams.builder() .model("gpt-6-astra") .input( "Write a bash script that takes a matrix represented as a string with format " + "'[1,2],[3,4],[5,6]' and prints the transpose in the same format.") .maxOutputTokens(300) .reasoning(Reasoning.builder().effort(ReasoningEffort.MEDIUM).build()) .build();var response = client.responses().create(params);if (response.status().filter(ResponseStatus.INCOMPLETE::equals).isPresent() && response .incompleteDetails() .flatMap(Response.IncompleteDetails::reason) .filter(Response.IncompleteDetails.Reason.MAX_OUTPUT_TOKENS::equals) .isPresent()) { System.out.println("Ran out of tokens"); response.output().stream() .flatMap(item -> item.message().stream()) .flatMap(message -> message.content().stream()) .flatMap(content -> content.outputText().stream()) .forEach(text -> System.out.println("Partial output: " + text.text()));}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);CreateResponseOptions options = new(){ Model = "gpt-6-astra", MaxOutputTokenCount = 300, ReasoningOptions = new ResponseReasoningOptions { ReasoningEffortLevel = ResponseReasoningEffortLevel.Medium, },};options.InputItems.Add( ResponseItem.CreateUserMessageItem("Write a bash script that transposes a matrix."));ResponseResult response = await client.CreateResponseAsync(options);if ( response.Status == ResponseStatus.Incomplete && response.IncompleteStatusDetails?.Reason == ResponseIncompleteStatusReason.MaxOutputTokens){ Console.WriteLine("The response ended before all output tokens were generated."); string partialOutput = response.GetOutputText(); Console.WriteLine( string.IsNullOrWhiteSpace(partialOutput) ? "Ran out of tokens during reasoning." : $"Partial output: {partialOutput}" );}else if ( response.Status == ResponseStatus.Incomplete && response.IncompleteStatusDetails?.Reason == ResponseIncompleteStatusReason.ContentFilter){ Console.WriteLine("The response was interrupted by the content filter.");}else if (response.Status == ResponseStatus.Completed){ Console.WriteLine(response.GetOutputText());}else{ throw new InvalidOperationException($"The response ended with status: {response.Status}");}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19require "openai"client = OpenAI::Client.newprompt = <<~PROMPT Write a bash script that takes a matrix represented as a string with format '[1,2],[3,4],[5,6]' and prints the transpose in the same format.PROMPTresponse = client.responses.create( model: "gpt-6-astra", max_output_tokens: 300, reasoning: { effort: :medium }, input: prompt)if response.status == OpenAI::Responses::ResponseStatus::INCOMPLETE puts("Ran out of tokens") puts("Partial output: #{response.output_text}") unless response.output_text.empty?end
Conservar el razonamiento entre llamadas
El estado de la conversación y el estado del razonamiento cumplen funciones distintas. Al pasar los mensajes de una llamada a otra, proporcionas al modelo el historial visible de la conversación. En los modelos compatibles, conservar el razonamiento también permite que el modelo incorpore a su siguiente contexto los elementos de razonamiento compatibles de turnos anteriores.
Conservar el razonamiento da continuidad al proceso sin exponer el razonamiento interno del modelo. Los elementos de razonamiento siguen siendo opacos y la API no devuelve el texto que contienen. Configura reasoning.context para controlar qué elementos de razonamiento disponibles puede usar el modelo:
La familia de modelos GPT-5.6 admite all_turns y lo usa de forma predeterminada. Los modelos anteriores usan current_turn de forma predeterminada. GPT-6.1 Sol también admite all_turns. Omite reasoning.context o configúralo en auto para usar el valor predeterminado del modelo seleccionado.
Valor
Comportamiento
auto
Usa el valor predeterminado del modelo seleccionado. Omitir reasoning.context tiene el mismo efecto que usar auto.
current_turn
Permite usar el razonamiento del turno actual, pero excluye el de turnos anteriores del contexto de la siguiente generación.
all_turns
Incorpora los elementos de razonamiento disponibles y compatibles de turnos anteriores al contexto de la siguiente generación. Los modelos GPT-5.6 y GPT-6.1 Sol admiten este valor.
El campo reasoning.context de la respuesta contiene el modo que se aplicó, ya sea current_turn o all_turns. Revisa este campo en cada respuesta para confirmar qué modo usó el modelo. Esta configuración solo se aplica a los elementos de razonamiento disponibles, sin crear elementos nuevos.
all_turns solo tiene efecto si la solicitud tiene acceso a elementos de respuestas anteriores. Usa previous_response_id, vincula la respuesta a una conversación o vuelve a enviar manualmente el historial completo de respuestas. En la primera solicitud, current_turn y all_turns se comportan de la misma manera porque aún no hay razonamiento previo.
El razonamiento conservado solo puede reutilizarse dentro de la misma familia de modelos. Por ejemplo, gpt-5.6-sol, gpt-5.6-terra y gpt-5.6-luna pueden reutilizar el razonamiento de los demás modelos de su familia, pero el razonamiento no se transfiere entre las familias GPT-5.6 y GPT-5.5.
Cuando cambias de familia de modelos, la API excluye del contexto del modelo el razonamiento incompatible, incluso si reasoning.context está configurado en all_turns.
Continuar el razonamiento con respuestas almacenadas
Usa previous_response_id para implementar una integración con estado con el mínimo de pasos:
Conservar el razonamiento con una respuesta anterior
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18import OpenAI from "openai";const client = new OpenAI();const first = await client.responses.create({ model: "gpt-6.1-sol", input: "Inspect this repository and identify the likely bug.", reasoning: { context: "current_turn" },});const second = await client.responses.create({ model: "gpt-6.1-sol", previous_response_id: first.id, input: "Now patch the bug and explain the change.", reasoning: { context: "all_turns" },});console.log(second.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19from openai import OpenAIclient = OpenAI()model ="gpt-6.1-sol"first = client.responses.create(model=model,input="Inspect this repository and identify the likely bug.",reasoning={"context": "current_turn"},)second = client.responses.create(model=model,previous_response_id=first.id,input="Now patch the bug and explain the change.",reasoning={"context": "all_turns"},)print(second.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18require "openai"client = OpenAI::Client.newfirst = client.responses.create( model: "gpt-6.1-sol", input: "Inspect this repository and identify the likely bug.", reasoning: { context: :current_turn })second = client.responses.create( model: "gpt-6.1-sol", previous_response_id: first.id, input: "Now patch the bug and explain the change.", reasoning: { context: :all_turns })puts(second.output_text)
Usa current_turn cuando vuelvas a enviar elementos de respuestas anteriores que el modelo ya no necesita. Esos elementos de razonamiento pueden permanecer en el cuerpo de la solicitud a la API para mantener la continuidad, pero el servicio no los incorpora al contexto de la nueva generación. Así puedes reducir el contexto que recibe el modelo en flujos de trabajo de larga duración.
Conservar el razonamiento sin almacenar respuestas
Cuando creas una respuesta en modo sin estado, los elementos de razonamiento del arreglo output de la respuesta incluyen de forma predeterminada la propiedad encrypted_content. El modo sin estado se aplica cuando store tiene el valor false o cuando tu organización usa la retención cero de datos (ZDR). Por compatibilidad, la API sigue aceptando el valor heredado reasoning.encrypted_content en include, aunque ya no lo requiere.
La siguiente solicitud devuelve el contenido de razonamiento cifrado sin especificar include:
1
2
3
4
5
6
7
8
9
10curlhttps://api.openai.com/v1/responses\-H"Content-Type: application/json"\-H"Authorization: Bearer $OPENAI_API_KEY"\-d'{ "model": "gpt-6-astra", "store": false, "reasoning": {"effort": "medium"}, "input": "What is the weather like today?", "tools": [ ... function config here ... ] }'
Los elementos de razonamiento del arreglo output incluirán la propiedad encrypted_content, que contiene tokens de razonamiento cifrados que puedes pasar a llamadas posteriores.
Para usar all_turns con store: false, conserva todos los elementos de salida, agrega el siguiente mensaje del usuario al final y vuelve a enviar el historial completo:
Conservar el razonamiento sin almacenar respuestas
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34import OpenAI from "openai";import { toResponseInputItems } from "openai/lib/responses/ResponseInputItems";const client = new OpenAI();const history = [ { role: "user", content: "Inspect this repository and identify the likely bug.", },];const first = await client.responses.create({ model: "gpt-6.1-sol", store: false, input: history, reasoning: { context: "current_turn" },});// Keep replayable output, including encrypted reasoning and assistant phase.history.push(...toResponseInputItems(first.output));history.push({ role: "user", content: "Now patch the bug and explain the change.",});const second = await client.responses.create({ model: "gpt-6.1-sol", store: false, input: history, reasoning: { context: "all_turns" },});console.log(second.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36from openai import OpenAIclient = OpenAI()model ="gpt-6.1-sol"history = [ {"role": "user","content": "Inspect this repository and identify the likely bug.", }]first = client.responses.create(model=model,store=False,input=history,reasoning={"context": "current_turn"},)# Keep every output item, including encrypted reasoning and assistant phase.history.extend(item.to_dict() for item in first.output)history.append( {"role": "user","content": "Now patch the bug and explain the change.", })second = client.responses.create(model=model,store=False,input=history,reasoning={"context": "all_turns"},)print(second.output_text)
Mantener los elementos de razonamiento en el contexto
Si usas la llamada a funciones con un modelo de razonamiento en la API de Responses, vuelve a enviar los elementos de razonamiento que recibiste con las llamadas a funciones junto con las salidas de las herramientas. Así, el modelo puede seguir razonando después de llamar a una herramienta.
Puedes conservar los elementos de razonamiento entre llamadas con previous_response_id. Si administras el historial de la conversación por tu cuenta, incluye la entrada original y todos los elementos de salida de cada respuesta en la entrada de la siguiente solicitud. Conserva el orden original de esos elementos y agrega los nuevos al final.
En los modelos de vanguardia más recientes, si modificas el historial anterior a un elemento de razonamiento, la API podría descartar ese razonamiento. Consulta Mantener el prefijo sin cambios para saber cómo modificar las instrucciones y las salidas de las herramientas y cómo administrar conversaciones largas.
Cambiar el razonamiento durante una conversación
Usa configuration_update para aumentar el esfuerzo de razonamiento en tareas difíciles o reducirlo en consultas de seguimiento rutinarias. Agrega la actualización entre respuestas y conserva el valor de reasoning.effort establecido en la solicitud. Así mantienes el prefijo original del prompt para el almacenamiento en caché de prompts.
En los modelos compatibles de GPT-6 y de generaciones posteriores, puedes actualizar el esfuerzo de razonamiento y el formato de respuesta en el modo estándar con un solo agente.
Agrega el siguiente elemento antes del próximo mensaje del usuario en el arreglo input de una solicitud HTTP a Responses o de una solicitud WebSocket response.create:
Por ejemplo, si la conversación comienza con un esfuerzo de low en la solicitud, esta actualización selecciona high para la siguiente respuesta y las posteriores, hasta que otra actualización cambie el valor.
Aumentar el esfuerzo de razonamiento para una consulta de seguimiento
Conserva las actualizaciones con previous_response_id o vuelve a enviarlas en sus posiciones originales si administras manualmente el historial de la conversación. El campo reasoning.effort de la respuesta sigue indicando el valor establecido en la solicitud, aunque la actualización haya seleccionado otro nivel de esfuerzo.
Puedes configurar reasoning.effort y text.format en el mismo elemento configuration_update. Si actualizas solo uno de los dos parámetros, el otro conserva su valor.
No combines las actualizaciones de configuración con la compactación automática ni con el truncamiento automático. El punto de acceso independiente /responses/compact también rechaza los historiales que contienen estas actualizaciones.
Puedes compactar el historial de forma explícita si incluyes un elemento compaction_trigger en una solicitud a /responses. Después de la compactación, agrega un nuevo elemento configuration_update antes del siguiente mensaje del usuario. En esa actualización, vuelve a especificar el valor de cada parámetro que hayas cambiado, incluido el formato de respuesta si lo cambiaste.
Siguen vigentes los requisitos habituales para el almacenamiento en caché de prompts. Para enviar instrucciones del usuario mientras se genera una respuesta, consulta Cómo orientar al modelo durante un turno.
Resúmenes de razonamiento
Aunque no exponemos los tokens de razonamiento que genera el modelo, puedes ver un resumen de su razonamiento con el parámetro summary. Consulta la documentación de los modelos para saber cuáles admiten resúmenes de razonamiento.
Las opciones de resumen de razonamiento varían según el modelo. Por ejemplo, nuestro modelo de uso de la computadora admite la opción concise, mientras que o4-mini admite detailed. Para obtener el resumen más detallado que admite un modelo, configura el parámetro en auto. Actualmente, auto equivale a detailed en la mayoría de los modelos de razonamiento, aunque en el futuro podría haber más niveles de detalle.
El resumen de razonamiento aparece en el arreglo summary de reasoning, el elemento de salida que corresponde al razonamiento. La salida solo incluye el resumen si lo solicitas explícitamente.
El siguiente ejemplo muestra cómo hacer una solicitud a la API que incluya un resumen de razonamiento.
Incluir un resumen de razonamiento en la respuesta de la API
Python
1
2
3
4
5
6
7
8
9
10
11
12
13import OpenAI from "openai";const openai = new OpenAI();const response = await openai.responses.create({ model: "gpt-6-astra", input: "What is the capital of France?", reasoning: { effort: "low", summary: "auto", },});console.log(response.output);
1
2
3
4
5
6
7
8
9
10
11from openai import OpenAIclient = OpenAI()response = client.responses.create(model="gpt-6-astra",input="What is the capital of France?",reasoning={"effort": "low", "summary": "auto"},)print(response.output)
Esta solicitud a la API devolverá un arreglo de salida que incluye un mensaje del asistente y un resumen del razonamiento que siguió el modelo para generar esa respuesta.
1234567891011121314151617181920212223242526[ { "id": "rs_6876cf02e0bc8192b74af0fb64b715ff06fa2fcced15a5ac", "type": "reasoning", "summary": [ { "type": "summary_text", "text": "**Answering a simple question**\n\nI\u2019m looking at a straightforward question: the capital of France is Paris. It\u2019s a well-known fact, and I want to keep it brief and to the point. Paris is known for its history, art, and culture, so it might be nice to add just a hint of that charm. But mostly, I\u2019ll aim to focus on delivering a clear and direct answer, ensuring the user gets what they\u2019re looking for without any extra fluff." } ] }, { "id": "msg_6876cf054f58819284ecc1058131305506fa2fcced15a5ac", "type": "message", "status": "completed", "content": [ { "type": "output_text", "annotations": [], "logprobs": [], "text": "The capital of France is Paris." } ], "role": "assistant" }]
En los flujos de larga duración o que usan herramientas de forma intensiva con GPT-5.5 y GPT-5.4 en la API de Responses, usa el campo phase del mensaje del asistente para evitar interrupciones prematuras y otros comportamientos inesperados.
El campo phase es opcional en la API, pero OpenAI recomienda usarlo. Usa phase: "commentary" para las actualizaciones intermedias del asistente, como los preámbulos antes de las llamadas a herramientas, y phase: "final_answer" para la respuesta final. No agregues phase a los mensajes del usuario.
Usar previous_response_id suele ser la opción más sencilla porque conserva el estado anterior del asistente. Si vuelves a enviar el historial del asistente de forma manual, conserva cada valor original de phase.
Si omites o descartas phase, los preámbulos podrían interpretarse como respuestas finales en estos flujos de trabajo. Para obtener orientación sobre cómo escribir prompts para este modelo, consulta Cómo escribir prompts para GPT-5.5.
Reenviar los valores de fase del asistente
Reenviar los valores de fase del asistente
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import OpenAI from "openai";const client = new OpenAI();const response = await client.responses.create({ model: "gpt-6-astra", input: [ { role: "assistant", phase: "commentary", content: "I’ll inspect the logs and then summarize root cause and remediation.", }, { role: "assistant", phase: "final_answer", content: "Root cause: cache invalidation race.", }, { role: "user", content: "Great—now give me a rollout-safe fix plan.", }, ],});console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25from openai import OpenAIclient = OpenAI()response = client.responses.create(model="gpt-6-astra",input=[ {"role": "assistant","phase": "commentary","content": "I’ll inspect the logs and then summarize root cause and remediation.", }, {"role": "assistant","phase": "final_answer","content": "Root cause: cache invalidation race.", }, {"role": "user","content": "Great—now give me a rollout-safe fix plan.", }, ],)print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25require "openai"client = OpenAI::Client.newresponse = client.responses.create( model: "gpt-6-astra", input: [ { role: :assistant, phase: :commentary, content: "I'll inspect the logs and then summarize root cause and remediation." }, { role: :assistant, phase: :final_answer, content: "Root cause: cache invalidation race." }, { role: :user, content: "Great—now give me a rollout-safe fix plan." } ])puts(response.output_text)
Consejos para escribir prompts
Ten en cuenta estas diferencias cuando escribas prompts para un modelo de razonamiento. Los modelos GPT-5 con capacidad de razonamiento suelen funcionar mejor cuando les das un objetivo claro, restricciones bien definidas y requisitos explícitos para la salida, sin indicar cada paso intermedio.
Indica al modelo la tarea, las restricciones y el formato de salida deseado.
Usa reasoning.effort para afinar el comportamiento del modelo. Evita depender principalmente de este parámetro para recuperar la calidad de las respuestas.
En los flujos de trabajo con agentes o que requieren mucha investigación, define cuándo se considera terminada la tarea y cómo debe verificar el modelo su trabajo.
Para obtener más información sobre las prácticas recomendadas al usar modelos de razonamiento, consulta esta guía.
Ejemplos de prompts
Programación (refactorización)
Los modelos de razonamiento pueden implementar algoritmos complejos y generar código. Este prompt le pide al modelo que refactorice un componente de React siguiendo criterios específicos.
Refactorizar código
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44import OpenAI from"openai";constopenai=newOpenAI();constprompt=`Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply- Do not include any additional formatting, such as markdown code blocks- For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columnsconst books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> );}`.trim();constcompletion=await openai.chat.completions.create({ model: "gpt-6-astra", messages: [ { role: "user", content: prompt, }, ], store: true,});console.log(completion.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45from openai import OpenAIclient = OpenAI()prompt = """Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply- Do not include any additional formatting, such as markdown code blocks- For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columnsconst books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> );}"""response = client.chat.completions.create( model="gpt-6-astra", messages=[ { "role": "user", "content": [ {"type": "text", "text": prompt}, ], } ],)print(response.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3")func main() { client := openai.NewClient() prompt := `Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply.- Do not include any additional formatting, such as markdown code blocks.const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];` completion, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{ Model: "gpt-6-astra", Messages: []openai.ChatCompletionMessageParamUnion{ openai.UserMessage(prompt), }, }) if err != nil { panic(err) } fmt.Println(completion.Choices[0].Message.Content)}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.chat.completions.ChatCompletionCreateParams;String prompt = """ Instructions: - Given the React component below, change it so that nonfiction books have red text. - Return only the code in your reply. - Do not include any additional formatting, such as markdown code blocks. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ]; """ .strip();ChatCompletionCreateParams params = ChatCompletionCreateParams.builder().model("gpt-6-astra").addUserMessage(prompt).build();client.chat().completions().create(params).choices().stream() .flatMap(choice -> choice.message().content().stream()) .forEach(System.out::println);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35using OpenAI.Chat;string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;string model = "gpt-6-astra";ChatClient client = new(model, key);string prompt = """ Instructions: - Given the React component below, make nonfiction book titles red. - Return only the updated component code in your reply. - Do not include any additional formatting, such as markdown code blocks. - For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columns. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ]; export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> ); } """;ChatCompletion completion = await client.CompleteChatAsync(new UserChatMessage(prompt));Console.WriteLine(completion.Content[0].Text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27require "openai"client = OpenAI::Client.newprompt = <<~PROMPT Instructions: - Given the React component below, change it so that nonfiction books have red text. - Return only the code in your reply. - Do not include any additional formatting, such as markdown code blocks. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ];PROMPTcompletion = client.chat.completions.create( model: "gpt-6-astra", messages: [ { role: :user, content: prompt } ])puts(completion.choices.fetch(0).message.content)
Refactorizar código
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43import OpenAI from"openai";constopenai=newOpenAI();constprompt=`Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply- Do not include any additional formatting, such as markdown code blocks- For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columnsconst books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> );}`.trim();constresponse=await openai.responses.create({ model: "gpt-6-astra", input: [ { role: "user", content: prompt, }, ],});console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43from openai import OpenAIclient = OpenAI()prompt = """Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply- Do not include any additional formatting, such as markdown code blocks- For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columnsconst books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> );}"""response = client.responses.create( model="gpt-6-astra", input=[ { "role": "user", "content": prompt, } ],)print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() prompt := `Instructions:- Given the React component below, change it so that nonfiction books have red text.- Return only the code in your reply.- Do not include any additional formatting, such as markdown code blocks.const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 },];` response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String(prompt), }, }) if err != nil { panic(err) } fmt.Println(response.OutputText())}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.responses.ResponseCreateParams;String prompt = """ Instructions: - Given the React component below, change it so that nonfiction books have red text. - Return only the code in your reply. - Do not include any additional formatting, such as markdown code blocks. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ]; """ .strip();ResponseCreateParams params = ResponseCreateParams.builder().model("gpt-6-astra").input(prompt).build();client.responses().create(params).output().stream() .flatMap(item -> item.message().stream()) .flatMap(message -> message.content().stream()) .flatMap(content -> content.outputText().stream()) .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);string prompt = """ Instructions: - Given the React component below, make nonfiction book titles red. - Return only the updated component code in your reply. - Do not include any additional formatting, such as markdown code blocks. - For formatting, use four space tabs, and do not allow any lines of code to exceed 80 columns. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ]; export default function BookList() { const listItems = books.map(book => <li> {book.title} </li> ); return ( <ul>{listItems}</ul> ); } """;ResponseResult response = await client.CreateResponseAsync( "gpt-6-astra", [ResponseItem.CreateUserMessageItem(prompt)]);Console.WriteLine(response.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22require "openai"client = OpenAI::Client.newprompt = <<~PROMPT Instructions: - Given the React component below, change it so that nonfiction books have red text. - Return only the code in your reply. - Do not include any additional formatting, such as markdown code blocks. const books = [ { title: 'Dune', category: 'fiction', id: 1 }, { title: 'Frankenstein', category: 'fiction', id: 2 }, { title: 'Moneyball', category: 'nonfiction', id: 3 }, ];PROMPTresponse = client.responses.create( model: "gpt-6-astra", input: prompt)puts(response.output_text)
Programación (planificación)
Los modelos de razonamiento también pueden crear planes de varios pasos. En este prompt de ejemplo, se le pide al modelo que cree la estructura de archivos y directorios de una solución completa y escriba el código en Python que implemente el caso de uso deseado.
Planifica y crea un proyecto en Python
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26import OpenAI from"openai";constopenai=newOpenAI();constprompt=`I want to build a Python app that takes user questions and looksthem up in a database where they are mapped to answers. If thereis close match, it retrieves the matched answer. If there isn't,it asks the user to provide an answer and stores thequestion/answer pair in the database. Make a plan for the directorystructure you'll need, then return each file in full. Only supplyyour reasoning at the beginning and end, not throughout the code.`.trim();constcompletion=await openai.chat.completions.create({ model: "gpt-6-astra", messages: [ { role: "user", content: prompt, }, ], store: true,});console.log(completion.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27from openai import OpenAIclient = OpenAI()prompt = """I want to build a Python app that takes user questions and looksthem up in a database where they are mapped to answers. If thereis close match, it retrieves the matched answer. If there isn't,it asks the user to provide an answer and stores thequestion/answer pair in the database. Make a plan for the directorystructure you'll need, then return each file in full. Only supplyyour reasoning at the beginning and end, not throughout the code."""response = client.chat.completions.create( model="gpt-6-astra", messages=[ { "role": "user", "content": [ {"type": "text", "text": prompt}, ], } ],)print(response.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3")func main() { client := openai.NewClient() prompt := `I want to build a Python app that takes user questions and looks them upin a database where they are mapped to answers. If there is a close match, itretrieves the matched answer. If there is not, it asks the user to provide ananswer and stores the question/answer pair in the database. Make a plan for thedirectory structure you will need, then return each file in full.` completion, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{ Model: "gpt-6-astra", Messages: []openai.ChatCompletionMessageParamUnion{ openai.UserMessage(prompt), }, }) if err != nil { panic(err) } fmt.Println(completion.Choices[0].Message.Content)}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.chat.completions.ChatCompletionCreateParams;String prompt = """ I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full. """ .strip();ChatCompletionCreateParams params = ChatCompletionCreateParams.builder().model("gpt-6-astra").addUserMessage(prompt).build();client.chat().completions().create(params).choices().stream() .flatMap(choice -> choice.message().content().stream()) .forEach(System.out::println);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19using OpenAI.Chat;string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;string model = "gpt-6-astra";ChatClient client = new(model, key);string prompt = """ I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full. Only supply your reasoning at the beginning and end, not throughout the code. """;ChatCompletion completion = await client.CompleteChatAsync( new UserChatMessage(prompt));Console.WriteLine(completion.Content[0].Text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21require "openai"client = OpenAI::Client.newprompt = <<~PROMPT I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full.PROMPTcompletion = client.chat.completions.create( model: "gpt-6-astra", messages: [ { role: :user, content: prompt } ])puts(completion.choices.fetch(0).message.content)
Planifica y crea un proyecto en Python
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import OpenAI from"openai";constopenai=newOpenAI();constprompt=`I want to build a Python app that takes user questions and looksthem up in a database where they are mapped to answers. If thereis close match, it retrieves the matched answer. If there isn't,it asks the user to provide an answer and stores thequestion/answer pair in the database. Make a plan for the directorystructure you'll need, then return each file in full. Only supplyyour reasoning at the beginning and end, not throughout the code.`.trim();constresponse=await openai.responses.create({ model: "gpt-6-astra", input: [ { role: "user", content: prompt, }, ],});console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25from openai import OpenAIclient = OpenAI()prompt = """I want to build a Python app that takes user questions and looksthem up in a database where they are mapped to answers. If thereis close match, it retrieves the matched answer. If there isn't,it asks the user to provide an answer and stores thequestion/answer pair in the database. Make a plan for the directorystructure you'll need, then return each file in full. Only supplyyour reasoning at the beginning and end, not throughout the code."""response = client.responses.create( model="gpt-6-astra", input=[ { "role": "user", "content": prompt, } ],)print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() prompt := `I want to build a Python app that takes user questions and looks them upin a database where they are mapped to answers. If there is a close match, itretrieves the matched answer. If there is not, it asks the user to provide ananswer and stores the question/answer pair in the database. Make a plan for thedirectory structure you will need, then return each file in full.` response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String(prompt), }, }) if err != nil { panic(err) } fmt.Println(response.OutputText())}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.responses.ResponseCreateParams;String prompt = """ I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full. """ .strip();ResponseCreateParams params = ResponseCreateParams.builder().model("gpt-6-astra").input(prompt).build();client.responses().create(params).output().stream() .flatMap(item -> item.message().stream()) .flatMap(message -> message.content().stream()) .flatMap(content -> content.outputText().stream()) .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);string prompt = """ I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full. Only supply your reasoning at the beginning and end, not throughout the code. """;ResponseResult response = await client.CreateResponseAsync("gpt-6-astra", prompt);Console.WriteLine(response.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16require "openai"client = OpenAI::Client.newprompt = <<~PROMPT I want to build a Python app that looks up user questions in a database where they are mapped to answers. If there is a close match, it retrieves the answer. Otherwise, it asks the user for an answer and stores the question and answer. Plan the directory structure, then return each file in full.PROMPTresponse = client.responses.create( model: "gpt-6-astra", input: prompt)puts(response.output_text)
Investigación en STEM
Los modelos de la serie o de OpenAI han demostrado un excelente desempeño en la investigación en disciplinas STEM. Si usas un prompt para pedir ayuda con tareas de investigación básica, deberías obtener buenos resultados.
Haz preguntas sobre investigación científica básica
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22import OpenAI from"openai";constopenai=newOpenAI();constprompt=`What are three compounds we should consider investigating toadvance research into new antibiotics? Why should we considerthem?`;constcompletion=await openai.chat.completions.create({ model: "gpt-6-astra", messages: [ { role: "user", content: prompt, }, ], store: true,});console.log(completion.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15from openai import OpenAIclient = OpenAI()prompt = """What are three compounds we should consider investigating toadvance research into new antibiotics? Why should we considerthem?"""response = client.chat.completions.create( model="gpt-6-astra", messages=[{"role": "user", "content": prompt}])print(response.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3")func main() { client := openai.NewClient() prompt := `What are three compounds we should consider investigating to advanceresearch into new antibiotics? Why should we consider them?` completion, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{ Model: "gpt-6-astra", Messages: []openai.ChatCompletionMessageParamUnion{ openai.UserMessage(prompt), }, }) if err != nil { panic(err) } fmt.Println(completion.Choices[0].Message.Content)}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.chat.completions.ChatCompletionCreateParams;String prompt = """ What are three compounds we should consider investigating to advance research into new antibiotics? Why should we consider them? """ .strip();ChatCompletionCreateParams params = ChatCompletionCreateParams.builder().model("gpt-6-astra").addUserMessage(prompt).build();client.chat().completions().create(params).choices().stream() .flatMap(choice -> choice.message().content().stream()) .forEach(System.out::println);
1
2
3
4
5
6
7
8
9
10
11
12
13using OpenAI.Chat;string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;string model = "gpt-6-astra";ChatClient client = new(model, key);string prompt = """ What are three compounds we should investigate to advance research into new antibiotics? Why should we consider them? """;ChatCompletion completion = await client.CompleteChatAsync(new UserChatMessage(prompt));Console.WriteLine(completion.Content[0].Text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19require "openai"client = OpenAI::Client.newprompt = <<~PROMPT What are three compounds we should consider investigating to advance research into new antibiotics? Why should we consider them?PROMPTcompletion = client.chat.completions.create( model: "gpt-6-astra", messages: [ { role: :user, content: prompt } ])puts(completion.choices.fetch(0).message.content)
Haz preguntas sobre investigación científica básica
JavaScript
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21import OpenAI from"openai";constopenai=newOpenAI();constprompt=`What are three compounds we should consider investigating toadvance research into new antibiotics? Why should we considerthem?`;constresponse=await openai.responses.create({ model: "gpt-6-astra", input: [ { role: "user", content: prompt, }, ],});console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15from openai import OpenAIclient = OpenAI()prompt = """What are three compounds we should consider investigating toadvance research into new antibiotics? Why should we considerthem?"""response = client.responses.create( model="gpt-6-astra", input=[{"role": "user", "content": prompt}])print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() prompt := `What are three compounds we should consider investigating to advanceresearch into new antibiotics? Why should we consider them?` response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String(prompt), }, }) if err != nil { panic(err) } fmt.Println(response.OutputText())}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.responses.ResponseCreateParams;String prompt = """ What are three compounds we should consider investigating to advance research into new antibiotics? Why should we consider them? """ .strip();ResponseCreateParams params = ResponseCreateParams.builder().model("gpt-6-astra").input(prompt).build();client.responses().create(params).output().stream() .flatMap(item -> item.message().stream()) .flatMap(message -> message.content().stream()) .flatMap(content -> content.outputText().stream()) .forEach(text -> System.out.println(text.text()));
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);string prompt = """ What are three compounds we should investigate to advance research into new antibiotics? Why should we consider them? """;ResponseResult response = await client.CreateResponseAsync( "gpt-6-astra", [ResponseItem.CreateUserMessageItem(prompt)]);Console.WriteLine(response.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14require "openai"client = OpenAI::Client.newprompt = <<~PROMPT What are three compounds we should consider investigating to advance research into new antibiotics? Why should we consider them?PROMPTresponse = client.responses.create( model: "gpt-6-astra", input: prompt)puts(response.output_text)
Ejemplos de casos de uso
En el Cookbook de OpenAI encontrarás ejemplos de cómo usar modelos de razonamiento en situaciones reales.