
Usa Promptfoo, una biblioteca de código abierto, para evaluar aplicaciones y agentes de IA y realizar pruebas de red teaming. Define casos de prueba y comprobaciones para medir el comportamiento de la aplicación, comparar prompts o modelos e investigar fallos. También puedes probar las aplicaciones con entradas adversarias para detectar riesgos de seguridad.
Promptfoo forma parte de OpenAI.
Esta guía comienza con una evaluación sencilla: ejecuta un ejemplo de traducción en tu terminal o pídele a Codex que configure una evaluación para tu aplicación.
Empieza en la CLI
Una vez que instales Node.js 22.22.0 o una versión posterior, elige cómo ejecutar el ejemplo de Promptfoo. El ejemplo usa casos de prueba para comparar las traducciones de distintos modelos:
npx promptfoo@latest init --example getting-started
cd getting-started
Usa un entorno virtual activo de Python 3.10 o una versión posterior. El paquete de pip que permite ejecutar Promptfoo también requiere Node.js 22.22.0 o una versión posterior.
pip install promptfoo
promptfoo init --example getting-started
cd getting-startedEl ejemplo crea promptfooconfig.yaml con un prompt de traducción, proveedores de modelos y casos de prueba. Cada prueba incluye una aserción que comprueba si la salida contiene la frase esperada. Configura tu clave de API de OpenAI en la terminal y reemplaza el marcador de posición por tu clave:
export OPENAI_API_KEY="<your-api-key>"Ejecuta la evaluación y luego abre el visor de resultados. La evaluación realiza llamadas a los modelos que generan cargos por el uso de la API.
npx promptfoo@latest eval
npx promptfoo@latest view
promptfoo eval
promptfoo viewAbre la URL local para comparar las salidas de los modelos y ver qué aserciones se cumplieron y cuáles fallaron. Revisa también las salidas: cuando se cumple una aserción, solo se confirma una condición específica. La calidad general de la respuesta requiere una revisión más amplia. Edita el prompt o los casos de prueba en promptfooconfig.yaml y vuelve a ejecutar la evaluación.
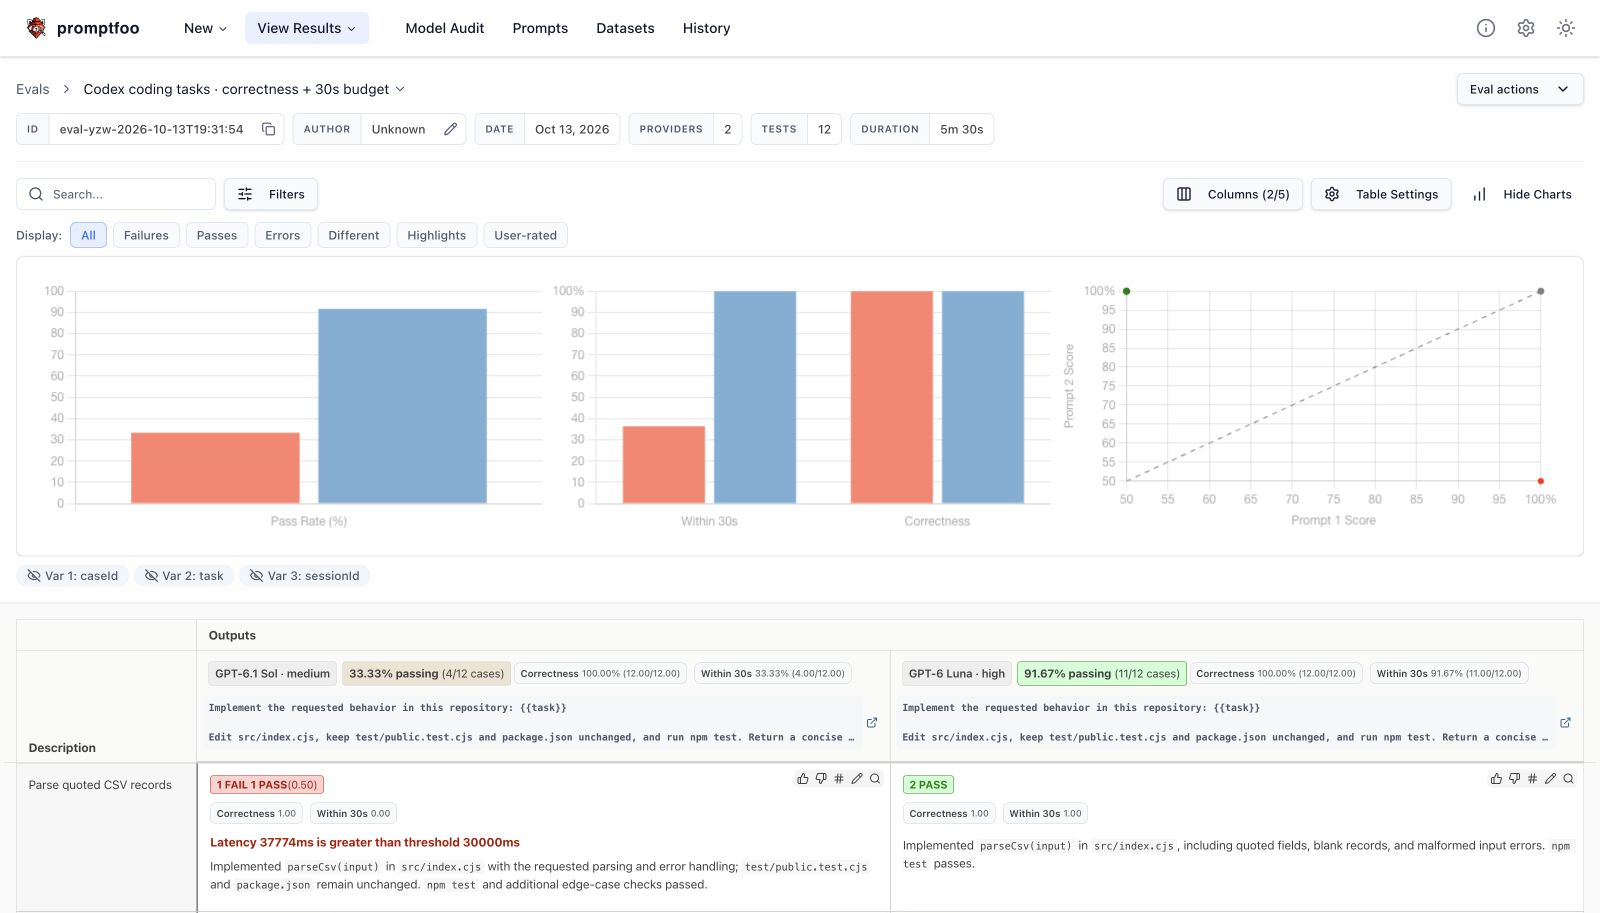
Otra evaluación de Codex App Server compara gpt-6.1-sol (nivel de razonamiento medio) y gpt-6-luna (nivel de razonamiento alto) en 12 tareas de programación. Cada resultado combina pruebas ejecutables que verifican si el código funciona correctamente con un límite de tiempo de 30 segundos. Todas las implementaciones pasaron las pruebas de código. Los resultados en rojo superaron el límite de tiempo.
Empieza en Codex App
Usa el complemento de Promptfoo para darle a Codex las habilidades necesarias para configurar y ejecutar evaluaciones.
Selecciona Abrir en Codex para iniciar una tarea o Copiar prompt para pegar el prompt en una tarea existente.
Es posible que Codex necesite tu ayuda con las credenciales o los permisos de configuración. Las evaluaciones que llaman a un modelo pueden generar cargos por el uso de la API.
Próximos pasos
Continúa con la documentación de Promptfoo:
- Configura evaluaciones: prepara prompts, modelos y casos de prueba con la guía de configuración.
- Comprueba las salidas: elige las comprobaciones y los métodos de puntuación con la documentación sobre aserciones y métricas.
- Detecta riesgos de seguridad: pon a prueba tu aplicación con entradas adversarias siguiendo la guía de red teaming.