
La API de Decisions ya está disponible de forma general. Consulta las novedades desde la beta pública.
La API de Decisions evalúa texto, imágenes y datos JSON y devuelve respuestas de un tipo definido unas diez veces más rápido que la API de Responses. Obtén la probabilidad de que se cumpla una condición, una opción de un conjunto predefinido o una puntuación según una rúbrica. Usa esas respuestas para clasificar contenido, dirigir solicitudes al destino adecuado y priorizar tareas en tu aplicación.
Prueba la API de Decisions en el Playground para experimentar con preguntas y entradas antes de escribir código.
Envía solicitudes a POST /v1/decisions con gpt-6-luna, el único modelo compatible por ahora.
Novedades
Desde el lanzamiento de la beta pública, la API de Decisions incorporó estas funciones:
- Almacenamiento en caché de prompts. Reutiliza la entrada compartida entre solicitudes y obtén descuentos por las lecturas de la caché.
- Imágenes en las instrucciones de las preguntas. Incluye imágenes propias en cada pregunta para compararlas con la evidencia compartida.
- Entrada JSON. Pasa datos estructurados directamente en una parte de contenido de tipo
input_json. - Más preguntas por solicitud. Haz hasta 400 preguntas por solicitud. Durante la beta pública, el límite era de 200.
- Imágenes alojadas como entrada. Pasa URL HTTP o HTTPS de imágenes de acceso público, además de URL de datos con imágenes en base64 incluidas directamente en la solicitud.
- Historial de conversación. Evalúa los mensajes junto con las llamadas a funciones o a herramientas personalizadas y sus resultados.
- Informes de uso de la organización. Consulta el consumo de tokens y la cantidad de solicitudes.
- Integración nativa con GPT-Live. Permite que Live llame directamente a Decisions o activa decisiones a medida que lleguen las transcripciones de entrada o salida.
- Private Link. Envía solicitudes a Decisions a través de una conexión privada.
Cómo funcionan las decisiones
Una solicitud consta de tres partes:
| Campo | Función |
|---|---|
model |
El modelo que evalúa la solicitud. Actualmente, solo se admite gpt-6-luna. |
input |
La evidencia que comparten las preguntas: una cadena de texto o un arreglo ordenado de mensajes, llamadas a herramientas y resultados de herramientas. |
questions |
Lo que se debe evaluar, incluido el tipo de cada pregunta, sus instrucciones y las opciones o los niveles de puntuación permitidos. |
La respuesta contiene un arreglo answers. Asigna a cada pregunta un name único para identificar su respuesta. La API devuelve ese mismo nombre en la respuesta.
Elige un tipo de pregunta
| Tipo | Para qué sirve | Resultado principal |
|---|---|---|
predicate |
Comprobar una condición, como la presencia de daños visibles o la pertinencia de un fragmento de texto. | probability: estimación de 0 a 1 de la probabilidad de que se cumpla la condición. |
choice |
Seleccionar una opción, como un departamento o una categoría de contenido. | choice: uno de los valores que proporcionaste. |
score |
Evaluar una entrada según niveles ordenados, como los de gravedad de un problema. | score: promedio de los índices de los niveles, ponderado por sus probabilidades. |
Tanto choice como score devuelven probabilidades para opciones discretas. Usa choice para categorías sin un orden definido, como los departamentos. Usa score para niveles ordenados, como los de gravedad. La puntuación es el promedio de los índices numéricos de los niveles, ponderado por sus respectivas probabilidades, por lo que puede quedar entre dos niveles.
Usa Decisions cuando tu aplicación necesite uno de estos tipos de respuesta. Usa resultados estructurados con la API de Responses cuando necesites generar un objeto que se ajuste a tu propio esquema JSON, por ejemplo, con campos extraídos o una explicación escrita. Usa la llamada a funciones cuando necesites que un modelo solicite una llamada a una herramienta con argumentos.
Evalúa una conversación
Pasa el historial de conversación en input para evaluar una solicitud en contexto. Incluye en orden los mensajes, las llamadas a funciones o a herramientas personalizadas y sus resultados. Asocia cada resultado con la llamada correspondiente mediante call_id.
El contenido admitido depende del rol del mensaje o del tipo de elemento:
| Elemento de entrada | Contenido admitido |
|---|---|
| Mensaje del usuario | Texto, imágenes y datos JSON |
| Mensaje del desarrollador o del sistema | Solo texto de entrada. Los mensajes del sistema se tratan como mensajes del desarrollador |
| Mensaje del asistente | Texto de salida o respuestas de rechazo |
| Resultado de una función o herramienta personalizada | Texto e imágenes asociados con la llamada a la herramienta correspondiente |
Las llamadas a herramientas y sus resultados aportan evidencia para tus preguntas. Decisions devuelve respuestas de un tipo definido y tu aplicación ejecuta las acciones que esas respuestas indiquen. No se admiten archivos, audio ni referencias a elementos. Consulta los campos de entrada admitidos en la referencia de creación de decisiones.
Evalúa datos JSON
Usa una parte de contenido de tipo input_json para pasar evidencia estructurada sin convertirla primero en una cadena. Coloca el objeto o arreglo JSON en data, junto con las partes de texto o imagen que incluyas en el mensaje del usuario. Dentro del contenido de un mensaje, input_json solo se admite para el rol user.
Por ejemplo, envía este cuerpo de solicitud JSON a POST /v1/decisions para evaluar un ticket de soporte con los datos de un pedido:
{
"model": "gpt-6-luna",
"input": [
{
"role": "user",
"content": [
{
"type": "input_text",
"text": "Evaluate the ticket using the order evidence."
},
{
"type": "input_json",
"data": {
"ticket": { "body": "Please refund the duplicate charge." },
"order": { "charges": [49, 49] }
}
}
]
}
],
"questions": [
{
"type": "predicate",
"name": "duplicate_charge",
"instructions": "Does the ticket describe a duplicate charge supported by the order?"
}
]
}Las claves JSON como role o image_url dentro de data son datos comunes: no crean mensajes ni recuperan imágenes. La respuesta sigue siendo del tipo de pregunta seleccionado. La entrada JSON no cambia el formato de la respuesta.
Detecta daños visibles en una imagen
Usa una pregunta de tipo predicate para comprobar si un producto presenta daños visibles en una foto. Esta solicitud combina la imagen con instrucciones para buscar grietas, rasgaduras o abolladuras.
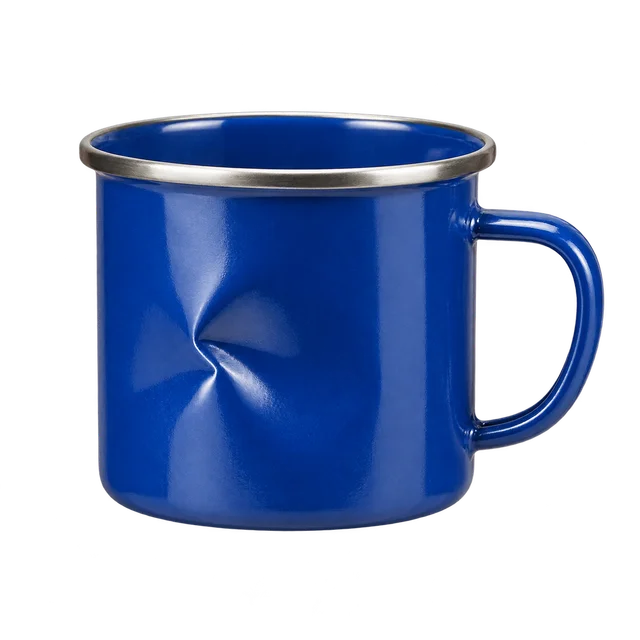
IMAGE_BASE64="$(base64 < product.png | tr -d '\r\n')"
curl https://api.openai.com/v1/decisions \
-H "Authorization: Bearer $OPENAI_API_KEY" \
-H "Content-Type: application/json" \
--data-binary @- <<JSON
{
"model": "gpt-6-luna",
"input": [{
"role": "user",
"content": [
{"type": "input_text", "text": "Inspect the product in this photo."},
{"type": "input_image", "image_url": "data:image/png;base64,$IMAGE_BASE64"}
]
}],
"questions": [{
"type": "predicate",
"name": "visible_damage",
"instructions": "Does the product have visible damage, such as a crack, tear, or dent? Ignore shadows and damage to the packaging."
}]
}
JSONEjemplo de un fragmento de la respuesta:
{
"answers": [
{
"type": "predicate",
"name": "visible_damage",
"probability": 0.92
}
]
}El campo probability indica la probabilidad estimada por el modelo de que se cumpla la condición. Úsalo para marcar fotos que requieran revisión según el umbral que elijas.
Proporciona las imágenes como URL de datos en base64 incluidas directamente en la solicitud o como URL HTTP o HTTPS de acceso público. Este punto de acceso no admite entradas file_id. Combina partes input_text e input_image en un mensaje del usuario para evaluar las imágenes junto con las instrucciones u otra información de contexto.
Incluye imágenes en las instrucciones de las preguntas
Coloca en input la evidencia que comparten todas las preguntas. Para asignar una imagen diferente a cada pregunta, establece su campo instructions en un arreglo no vacío de partes input_text e input_image. Esto funciona con preguntas de predicado, selección y puntuación. Si las instrucciones solo contienen texto, pueden seguir siendo una cadena.
Por ejemplo, envía este cuerpo de solicitud JSON a POST /v1/decisions para comparar una imagen candidata con una imagen de referencia compartida. Reemplaza las dos URL de ejemplo por URL de imágenes de acceso público o usa URL de datos de imagen en base64:
{
"model": "gpt-6-luna",
"input": [
{
"role": "user",
"content": [
{
"type": "input_text",
"text": "The shared image is reference image A."
},
{
"type": "input_image",
"image_url": "https://example.com/reference.jpg"
}
]
}
],
"questions": [
{
"type": "predicate",
"name": "candidate_matches_reference",
"instructions": [
{
"type": "input_text",
"text": "Is candidate image B a derivative or variant of reference image A, including recompression or resizing?"
},
{
"type": "input_image",
"image_url": "https://example.com/candidate.jpg"
}
]
}
]
}Al agregar imágenes a las instrucciones de las preguntas:
- Agrega una pregunta por cada imagen candidata. Cada pregunta compara su propia imagen candidata con la misma imagen de referencia compartida.
- Incluye las partes de contenido directamente en
instructions, sin envolverlas en un mensaje ni agregarrole. - Los límites de imágenes de la solicitud se aplican al conjunto de imágenes de las preguntas y de
input.
Elige entre opciones predefinidas
Una pregunta de tipo choice selecciona un valor entre las opciones que proporcionas. Usa valores distintos y descripciones que expliquen cuándo corresponde cada opción.
Esta solicitud asigna el reclamo de un cliente al departamento correspondiente:
curl https://api.openai.com/v1/decisions \
-H "Authorization: Bearer $OPENAI_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"model": "gpt-6-luna",
"input": "I was charged twice for my order.",
"questions": [{
"type": "choice",
"name": "department",
"instructions": "Which department should handle this complaint?",
"choices": [
{"value": "billing", "description": "Payments, invoices, and refunds."},
{"value": "technical", "description": "Problems using the product."},
{"value": "shipping", "description": "Delivery and tracking."},
{"value": "other", "description": "Requests outside these categories."}
]
}]
}'Ejemplo de un fragmento de la respuesta:
{
"answers": [
{
"type": "choice",
"name": "department",
"choice": "billing",
"probabilities": [
{ "value": "billing", "probability": 0.95 },
{ "value": "technical", "probability": 0.02 },
{ "value": "shipping", "probability": 0.01 },
{ "value": "other", "probability": 0.02 }
],
"confidence": 0.93
}
]
}El campo choice de la respuesta contiene uno de los valores que proporcionaste, en este caso "billing". La respuesta también incluye un arreglo probabilities para las opciones y un campo confidence. Consulta Interpreta las respuestas para saber cómo establecer umbrales.
Incluye una opción alternativa como "other" si tus categorías no abarcan todas las entradas posibles. Tu aplicación puede enviar ese resultado a una cola de revisión general.
Puntúa según una rúbrica
Una pregunta de tipo score evalúa una entrada según una escala de 2 a 10 niveles ordenados en levels. Define los criterios de cada nivel y ordena los niveles de menor a mayor.
curl https://api.openai.com/v1/decisions \
-H "Authorization: Bearer $OPENAI_API_KEY" \
-H "Content-Type: application/json" \
-d '{
"model": "gpt-6-luna",
"input": "Export fails in Safari but works in Chrome.",
"questions": [{
"type": "score",
"name": "severity",
"instructions": "How severe is this issue?",
"levels": [
{"label": "Cosmetic", "description": "Appearance only; no lost functionality."},
{"label": "Workaround available", "description": "A task fails, but another way works."},
{"label": "Fully blocked", "description": "A task fails with no workaround."}
]
}]
}'Ejemplo de un fragmento de la respuesta:
{
"answers": [
{
"type": "score",
"name": "severity",
"score": 1.1,
"probabilities": [
{ "value": 0, "label": "Cosmetic", "probability": 0.1 },
{ "value": 1, "label": "Workaround available", "probability": 0.7 },
{ "value": 2, "label": "Fully blocked", "probability": 0.2 }
],
"confidence": 0.55
}
]
}Los índices de los niveles comienzan en 0. En este caso, 0 indica que el problema es estético, 1 que existe una solución alternativa y 2 que el bloqueo es total. El valor de score es un promedio ponderado por las probabilidades, por lo que puede quedar entre dos niveles. En este ejemplo, las probabilidades de 0,1, 0,7 y 0,2 dan una puntuación de 1,1.
La respuesta también incluye confidence y el arreglo probabilities con las probabilidades de cada nivel. La puntuación resume la distribución entre los niveles. Usa choice para seleccionar una sola categoría.
Haz varias preguntas
Incluye entre 1 y 400 preguntas en una solicitud. Coloca las preguntas independientes en el mismo arreglo questions para evaluar una entrada compartida. Por ejemplo, con una sola solicitud puedes comprobar si el producto de una foto presenta daños y determinar a qué categoría pertenece. Cada pregunta puede ser de un tipo diferente.
Si una decisión depende de una respuesta anterior, envía solicitudes por separado. Por ejemplo, comprueba primero si hay daños y luego usa el resultado para decidir si necesitas solicitar una categoría de reparación.
Formula las preguntas a partir de criterios observables. Aborda cada aspecto en una pregunta independiente, asigna un significado distinto a cada opción y define los niveles de puntuación con criterios que permitan distinguir un nivel del siguiente.
Interpreta las respuestas
Las preguntas de predicado devuelven la probabilidad estimada de que se cumpla una condición. Las respuestas de selección y puntuación devuelven una distribución de probabilidades y un campo confidence independiente.
Usa ejemplos etiquetados de tu aplicación para establecer umbrales de asignación, filtrado o revisión. Elige los umbrales según el costo de los falsos positivos y los falsos negativos.
Reutiliza la entrada compartida con el almacenamiento en caché de prompts
El almacenamiento en caché de prompts permite que las solicitudes repetidas reutilicen un prefijo idéntico de la entrada compartida en input y obtengan una tarifa reducida por la lectura de caché. Por ejemplo, conserva un documento o una imagen de referencia en input y cambia las preguntas en cada solicitud. El contenido de questions, incluidas las imágenes específicas de cada pregunta, queda fuera del prefijo reutilizable.
De forma predeterminada, Decisions marca implícitamente el final de input como límite del prefijo que se puede almacenar en caché. Las solicitudes existentes pueden aprovechar esta función sin modificar su cuerpo. El prefijo reutilizable debe contener al menos 1024 tokens. El contenido de las preguntas no cuenta para alcanzar este umbral. Mantén el prefijo idéntico en todas las solicitudes para poder reutilizarlo.
Usa prompt_cache_key para separar la reutilización de la caché según una clave proporcionada por quien realiza la llamada. Para controlar el límite del prefijo, agrega prompt_cache_breakpoint: {"mode": "explicit"} a las partes de texto o imagen de la entrada compartida en input. Establece prompt_cache_options.mode en "explicit" para usar únicamente los límites marcados. En modo explícito, una solicitud sin límites marcados no utiliza el almacenamiento en caché de prompts. No se pueden marcar límites en las instrucciones de las preguntas.
Consulta usage.input_tokens_details.cached_tokens para ver cuántos tokens se leyeron de la caché y usage.input_tokens_details.cache_write_tokens para ver cuántos se escribieron. Ambos conteos ya están incluidos en usage.input_tokens, así que no los sumes a ese total. Consulta la guía de almacenamiento en caché de prompts para conocer los conceptos de caché y la referencia de Decisions para ver qué controles admiten las solicitudes.
Monitorea el uso
Usa GET /v1/organization/usage/decisions para obtener el consumo de tokens y la cantidad de solicitudes de Decisions de tu organización. Autentícate con una clave de API de administrador y el permiso api.usage.read.
Elige un intervalo de tiempo y la duración de cada grupo. Luego filtra o agrupa los resultados por proyecto, clave de API o modelo. El campo num_model_requests cuenta cada solicitud una sola vez, aunque contenga varias preguntas. Consulta la referencia de uso de Decisions para conocer los filtros y la paginación.
Precios y disponibilidad
Con gpt-6-luna, la entrada sin almacenar en caché cuesta $0,10 por millón de tokens. Cuando se encuentra una coincidencia en la caché de prompts, se aplica una tarifa reducida a la entrada. Las escrituras en caché tienen costo. Las tarifas de lectura y escritura en caché coinciden con las tarifas estándar de almacenamiento en caché de prompts de gpt-6-luna. Los tokens de salida no tienen costo.
Se aplican recargos por procesamiento regional y multiplicadores de precio para entradas de contexto largo. Estas tarifas se aplican a /v1/decisions. Las demás solicitudes que usan gpt-6-luna se cobran según los precios correspondientes al modelo y al nivel de procesamiento.
La API de Decisions admite la retención cero de datos (ZDR) y el uso conforme a la HIPAA para los clientes que cumplen los requisitos. La residencia de datos está disponible en todas las regiones admitidas por la API. El procesamiento regional está disponible en Estados Unidos y en Europa (EEE y Suiza). Consulta los controles de datos para conocer los requisitos de elegibilidad, los acuerdos necesarios y las limitaciones.
Agrega control por voz
Conecta la voz con Decisions para elegir una acción a partir de una solicitud oral o reaccionar mientras habla el usuario o GPT-Live.