Elige tu API para comprender cómo se mide el uso y encontrar formas de administrar los costos de tu aplicación de voz.
Uso y costos de GPT-Live
GPT-Live separa la conversación de voz del backend que razona y ejecuta herramientas. Estima estos dos costos por separado: el costo de la sesión de voz depende de su duración, mientras que los costos del backend dependen de los modelos y las herramientas que uses.
Costos de las sesiones de voz
Las sesiones de voz de GPT-Live se facturan por segundo según la tarifa vigente del modelo. La duración de la sesión no se redondea al siguiente minuto completo.
El tiempo de sesión activa incluye los períodos en los que habla el usuario, habla el asistente, ambos están en silencio o el backend está trabajando.
Para hacer estimaciones, cuenta el tiempo de sesión activa desde el inicio hasta el cierre. Usa la duración que informa la API en lugar de medir solo el audio que reproduces. Silenciar la entrada del micrófono no cierra la sesión. Cuando termine la conversación, cierra la sesión y recopila sus datos finales de uso.
Consulta los precios de la API para conocer los precios de los modelos y las herramientas del backend.
Cargos de inicialización de WebRTC
Una solicitud POST /v1/live/sessions para crear una sesión de WebRTC genera un cargo equivalente a 15 segundos de voz mientras se inicializa la sesión. Ese importe se descuenta de los cargos por duración una vez que la sesión comienza a ejecutarse. No agregues otros 15 segundos a la duración de la sesión en ejecución al estimar su costo.
Por ejemplo, la sesión de 90 segundos que se muestra a continuación ya incluye los 15 segundos facturados durante la inicialización. No se factura como una sesión de 105 segundos. Ten en cuenta los cargos por creación de sesiones al evaluar reconexiones o aplicaciones que crean sesiones antes de que el usuario esté listo para hablar.
Costos del backend
Las llamadas al backend se facturan por separado de la sesión de voz, al igual que en las aplicaciones sin voz. Incluye los tokens de entrada y salida del modelo, la entrada en caché cuando sea compatible y los cargos por imágenes o herramientas que correspondan. Si tu aplicación llama a otros servicios, incluye también sus costos en la estimación.
Puedes optimizar este trabajo por separado del frontend de voz. Usa la guía general de optimización de costos para reducir las solicitudes y el uso de tokens. Usa el almacenamiento de prompts en caché en los modelos de backend compatibles y mantén las instrucciones reutilizables, las definiciones de herramientas y otros contenidos estables al comienzo del prompt.
Las decisiones sobre el backend también pueden cambiar la duración de la conversación. Compara el costo combinado cuando una optimización hace que el usuario espere más o cambia la fiabilidad con la que el asistente completa la tarea.
Estima los costos de las conversaciones
Para una conversación con una sola sesión de voz:
Costo total = (segundos de voz facturables ÷ 60 × tarifa de voz por minuto) + costos del backend
Por ejemplo, con una tarifa de voz ilustrativa de $0,05 por minuto, una sesión de voz de 90 segundos cuesta $0,075. Si los costos del modelo y las herramientas del backend suman $0,02, la conversación cuesta $0,095:
| Componente | Cálculo | Costo |
|---|---|---|
| Sesión de voz | 90 segundos ÷ 60 × $0,05 | $0,075 |
| Trabajo del backend | Costos totales del modelo y las herramientas | $0,02 |
| Total de la conversación | $0,075 + $0,02 | $0,095 |
Las tarifas y el costo del backend anteriores son ejemplos; usa la tarifa de voz vigente, el uso medido de tu backend y las tarifas de modelos y herramientas que correspondan. Si la tarea abarca varias sesiones de voz, suma sus duraciones e incluye el trabajo del backend realizado entre sesiones.
Estrategias de optimización
Concéntrate en ayudar al usuario a completar la tarea con menos conversación y esperas innecesarias. Mantén las confirmaciones y verificaciones que requiera la tarea.
Proporciona contexto relevante antes de la sesión
Recopila la información que tu aplicación ya tiene permiso para usar antes de iniciar la sesión de voz. Por ejemplo, un asistente que ayuda con un pedido puede comenzar con el número de pedido y su estado actual, para que el usuario no tenga que repetirlos ni esperar otra consulta.
Mantén este contexto actualizado y centrado en la tarea. Dale al modelo de voz la información que necesita para la conversación; conserva los registros detallados y los flujos de trabajo en el backend. Consulta configuración de la sesión y delegación y herramientas.
Reduce el tiempo de espera de las herramientas
Las esperas más cortas pueden mejorar la experiencia del usuario y reducir los costos de las sesiones de voz.
Por ejemplo, supongamos que tu backend usa gpt-5.6-luna con
Modo rápido y ejecuta llamadas independientes a herramientas en
paralelo. Si estas optimizaciones ayudan al usuario a terminar y cerrar la sesión de voz
un minuto antes, ahorras $0,05 en cargos de voz. El costo total
disminuye si el costo adicional del backend es menor que ese ahorro.
También puedes iniciar una consulta especulativa a partir de fragmentos de transcripción antes de que llegue un evento de delegación. Incluye el trabajo especulativo que no se utilice en tus mediciones de costos del backend.
Consulta Reducir la latencia del backend para conocer las optimizaciones de modelos, conexiones, transmisión continua y herramientas. Valida el tiempo que se tarda en obtener una respuesta hablada útil y el éxito de la tarea con evaluaciones de agentes de voz.
Cierra la sesión durante las tareas largas
El frontend de voz y el backend administrado por tu aplicación pueden ejecutarse de forma independiente. Con la delegación al cliente, el proceso de trabajo de tu backend puede seguir ejecutándose tanto si la sesión de voz está abierta como si está cerrada. Guarda el estado de la tarea y el contexto de la conversación antes de cerrar la sesión de voz.
Para un agente ambiental, cierra la sesión de voz mientras el backend se encarga de una tarea de larga duración, como programar en modo de objetivos. Ofrece un botón con la etiqueta Reanudar conversación para iniciar una nueva sesión de voz cuando el usuario regrese, o usa un evento de finalización del backend para iniciar una nueva sesión y notificar al usuario que el resultado está listo.
Restablece la conversación iniciando una nueva sesión con el contexto guardado y el
resultado verificado de la tarea en input. Por ejemplo, envía este evento de inicio a través de una
nueva conexión WebSocket:
{
"type": "session.start",
"session": {
"model": "gpt-live-1",
"instructions": "Help the user review completed work and delegate follow-up tasks.",
"input": [
{
"type": "message",
"role": "developer",
"content": [
{
"type": "input_text",
"text": "Saved task: add CSV export. Result: code is ready for review."
}
]
}
],
"delegation": { "type": "client" }
}
}Espera a recibir session.started antes de transmitir audio. Consulta
inicializar una sesión con una conversación anterior
para conocer el formato de historial compatible.
Si la sesión anterior se almacenó con store: true, también puedes crear un fork de esa sesión. Conserva en tu aplicación el estado verificado de la tarea del backend, sea cual sea el método que uses.
Cerrar la sesión ahorra $0,05 por cada minuto de inactividad de voz; compara ese ahorro con los costos de reconexión y la interrupción de la experiencia del usuario.
Elige el modelo adecuado para el backend
Comienza con modelos que cumplan los requisitos de precisión y fiabilidad de la tarea. Luego compara el costo total de la conversación, incluida la duración de voz, el uso del modelo, las llamadas a herramientas y los reintentos. La guía de selección de modelos describe cómo equilibrar estas ventajas y desventajas.
Un modelo de backend más grande puede tener un costo total menor si completa la tarea más rápido y el ahorro en la sesión de voz supera sus costos adicionales de tokens. Un modelo más barato puede tener un costo total mayor si tarda más, repite llamadas a herramientas o no logra completar la tarea.
Compara el costo por tarea completada con éxito junto con la tasa de finalización y el tiempo necesario para completarla. Incluye los intentos fallidos y los reintentos en el total para que una configuración más barata no parezca mejor por completar menos trabajo. Usa el Cookbook de evaluación de agentes de voz al planificar tu comparación.
Monitorea el uso real
Registra por separado la duración de voz y el uso del backend para cada sesión. GPT-Live informa la duración acumulada de voz en segundos:
{
"type": "session.usage.updated",
"event_id": "event_usage_1",
"usage": { "seconds": 12 },
"context_window": { "usage_ratio": 0.42 }
}Cada actualización reemplaza el valor de duración anterior. No sumes estos valores.
Después de enviar session.close, sigue recibiendo eventos hasta que llegue session.closed y
registra su valor final de usage.seconds una sola vez. Sigue el
procedimiento de cierre ordenado
para que tu aplicación pueda recopilar los datos finales de uso antes de desconectarse.
Para la delegación a Responses, lee el campo usage de la respuesta del backend en los eventos anidados
response.completed que se reciben a través de response.event. Cuenta cada
respuesta del backend una sola vez usando su ID de respuesta y conserva los detalles de los tokens de entrada, salida y
caché necesarios para aplicar las tarifas de ese modelo. Para el trabajo del backend que tu
aplicación ejecute de forma independiente, recopila también los datos de uso de esas solicitudes.
Compara los totales estimados y reales en conversaciones representativas. Mantén las llamadas al modelo destinadas exclusivamente a evaluación separadas del uso de la aplicación y revisa el costo junto con el éxito de la tarea.
Costos de Realtime API
Este documento describe cómo funciona la facturación de Realtime API y ofrece estrategias para optimizar los costos. Las sesiones con agentes de voz acumulan tokens de entrada y salida en las modalidades de texto, audio e imagen. Las sesiones de traducción y transcripción con transmisión continua se facturan según la duración del audio. Los precios varían según el modelo y se indican en las páginas de cada modelo (por ejemplo, gpt-realtime-2, gpt-realtime-translate, gpt-realtime-whisper y gpt-realtime).
Las sesiones conversacionales de Realtime API son una serie de turnos en los que el usuario agrega una entrada que activa una Response para producir la salida del modelo. El servidor mantiene una Conversation, que es una lista de Items que conforman la entrada del siguiente turno. Cuando se devuelve una Response, la salida se agrega automáticamente a la Conversation.
Las sesiones de traducción y transcripción usan una arquitectura de transmisión continua diferente. El cliente transmite audio de forma continua y recibe audio traducido, actualizaciones incrementales de la transcripción o eventos de transcripción a medida que llega el audio de origen. Estas sesiones no usan el ciclo de vida habitual de Response, así que estima y monitorea sus costos con las tarifas basadas en la duración, en lugar del uso de tokens por Response.
Costos por Response
Los costos de Realtime API se generan cuando se crea una Response y se calculan según la cantidad de tokens de entrada y salida (excepto los costos de transcripción de entrada, que se describen más adelante). Actualmente, no hay cargos por el ancho de banda de la red ni por las conexiones. Una Response se puede crear manualmente o de forma automática si la detección de actividad de voz (VAD) está activada. La VAD filtra el audio de entrada vacío, por lo que este no se cuenta como tokens de entrada a menos que el cliente lo agregue manualmente como entrada de la conversación.
La conversación completa se envía al modelo para cada Response. La salida de un turno se agrega como Items a la Conversation del servidor y pasa a ser la entrada de los turnos siguientes, por lo que los turnos posteriores de la sesión serán más costosos.
Puedes estimar los costos de los tokens de texto con nuestras herramientas de tokenización. Los mensajes del usuario consumen 1 token de audio por cada 100 ms de audio, mientras que los mensajes del asistente consumen 1 token de audio por cada 50 ms de audio. Ten en cuenta que los recuentos incluyen tokens especiales además del contenido del mensaje, lo que genera pequeñas variaciones. Por ejemplo, un mensaje del usuario con 10 tokens de texto de contenido puede contabilizarse como 12 tokens.
Ejemplo
Este ejemplo sencillo ilustra los costos de tokens a lo largo de una sesión de Realtime API con varios turnos.
Para el primer turno de la conversación, agregamos 100 tokens de instrucciones y un mensaje del usuario de 20 tokens de audio (por ejemplo, agregado por la VAD al detectar que el usuario habla), para un total de 120 tokens de entrada. Al crear una Response, se genera un mensaje de salida del asistente (20 tokens de audio y 10 de texto).
Luego creamos un segundo turno con otro mensaje de audio del usuario. ¿Cómo se distribuyen los tokens del turno 2? En este punto, la Conversation incluye las instrucciones iniciales, el primer mensaje del usuario, el mensaje de salida del asistente del primer turno y el segundo mensaje del usuario (25 tokens de audio). Este turno tendrá 110 tokens de texto y 64 tokens de audio como entrada, además de los tokens de salida de otro mensaje del asistente.
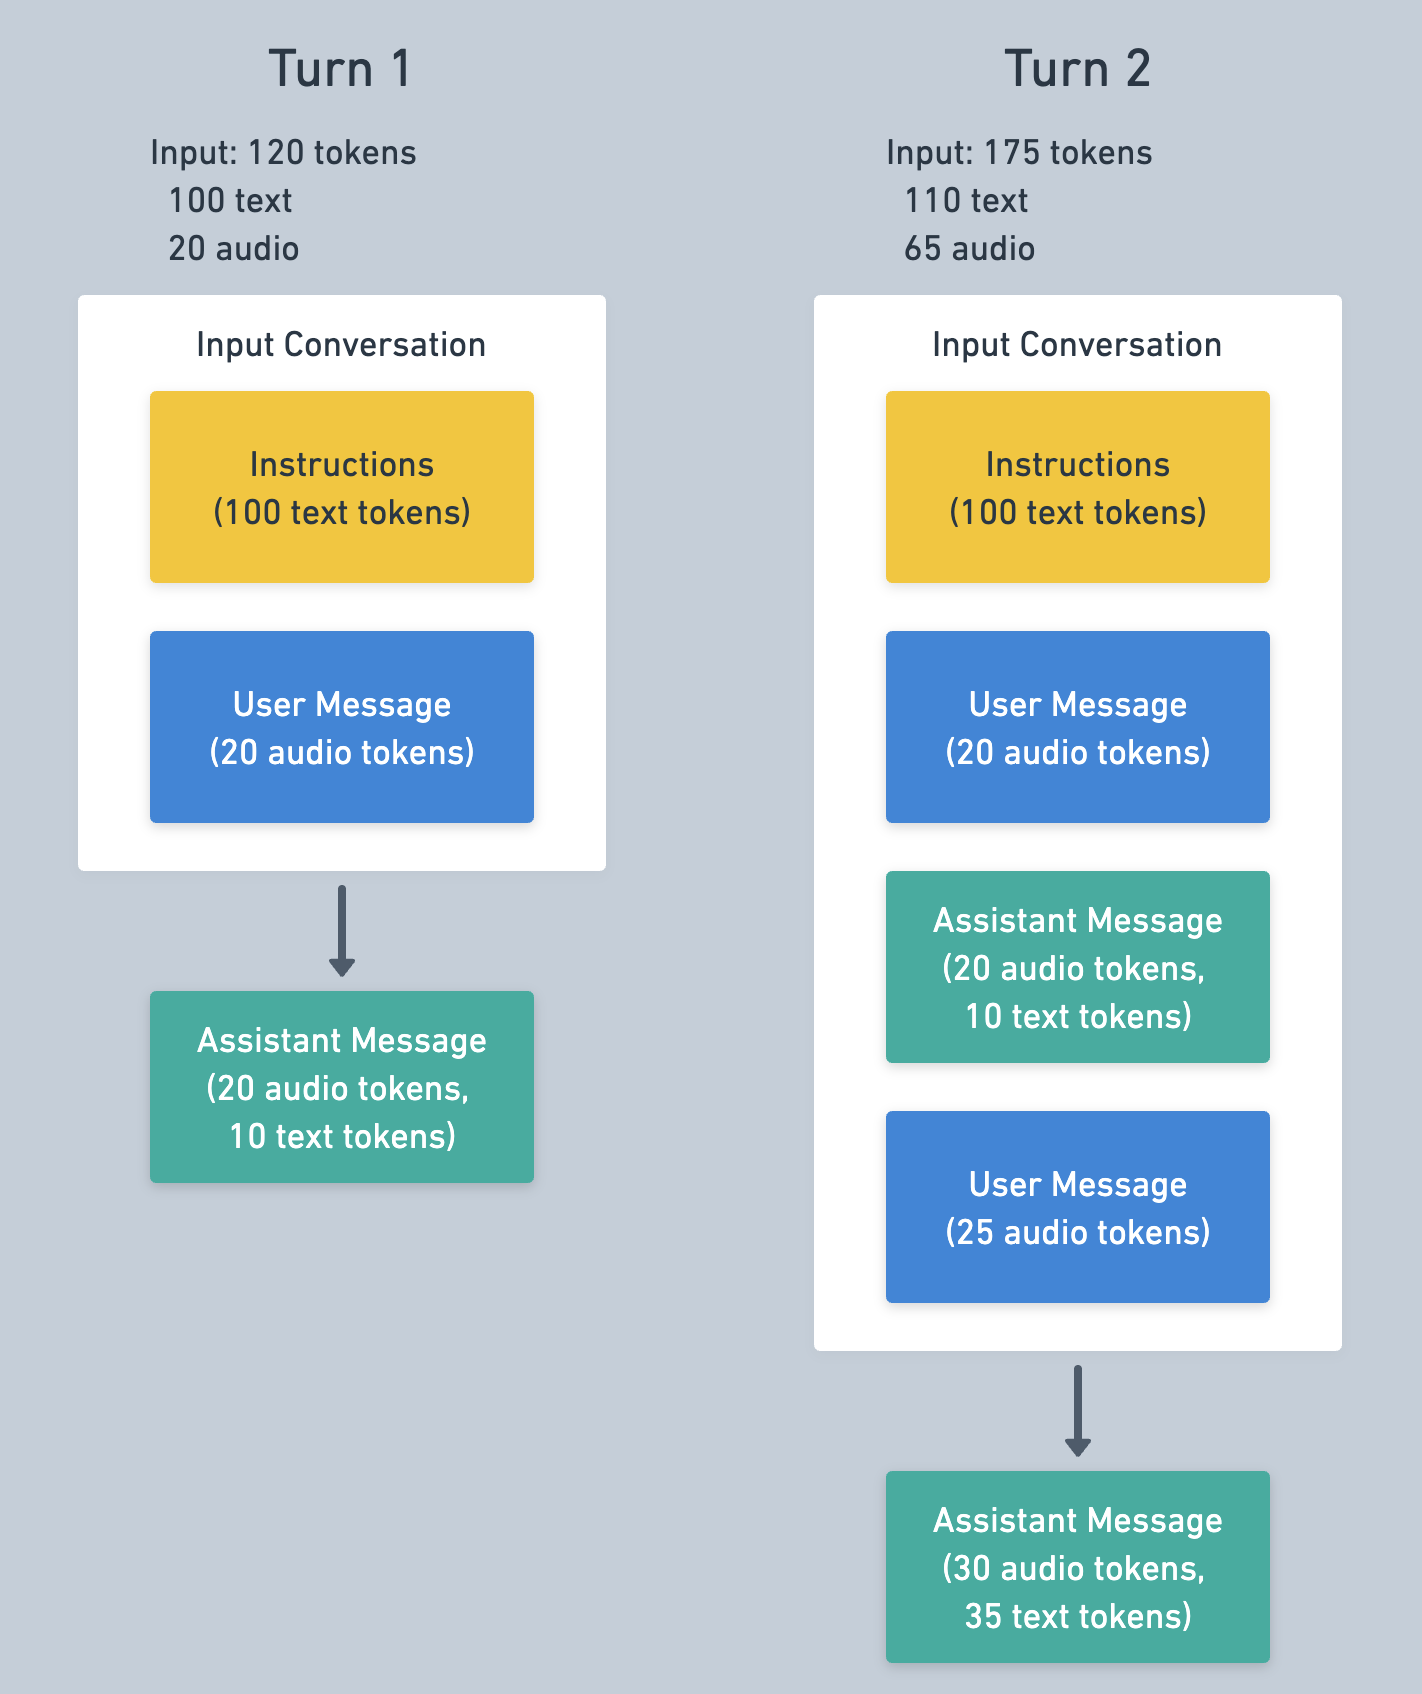
Es probable que los mensajes del primer turno estén almacenados en caché para el turno 2, lo que reduce el costo de entrada. Más adelante encontrarás información sobre el almacenamiento en caché.
Puedes consultar los tokens usados para una Response en el evento response.done, que tiene el siguiente formato.
{
"type": "response.done",
"response": {
...
"usage": {
"total_tokens": 253,
"input_tokens": 132,
"output_tokens": 121,
"input_token_details": {
"text_tokens": 119,
"audio_tokens": 13,
"image_tokens": 0,
"cached_tokens": 64,
"cached_tokens_details": {
"text_tokens": 64,
"audio_tokens": 0,
"image_tokens": 0
}
},
"output_token_details": {
"text_tokens": 30,
"audio_tokens": 91
}
}
}
}Costos de transcripción de entrada
Además de las Responses conversacionales, Realtime API factura las transcripciones de entrada si están habilitadas. La transcripción de entrada usa un modelo diferente del modelo speech2speech, como whisper-1 o gpt-4o-transcribe, por lo que se factura con tarifas diferentes. La transcripción se realiza cuando el audio se escribe en el búfer de audio de entrada y luego se confirma, ya sea manualmente o mediante la VAD.
Puedes consultar los recuentos de tokens de transcripción de entrada en el evento conversation.item.input_audio_transcription.completed, como se muestra en el siguiente ejemplo.
{
"type": "conversation.item.input_audio_transcription.completed",
...
"transcript": "Hi, can you hear me?",
"usage": {
"type": "tokens",
"total_tokens": 26,
"input_tokens": 17,
"input_token_details": {
"text_tokens": 0,
"audio_tokens": 17
},
"output_tokens": 9
}
}Almacenamiento en caché
Realtime API admite el almacenamiento de prompts en caché, que se aplica automáticamente y puede reducir de forma considerable los costos de tokens de entrada durante las sesiones de varios turnos. La caché se aprovecha cuando los tokens de entrada de una Response coinciden con los de una Response anterior, aunque esto se intenta siempre que es posible y no está garantizado.
La mejor estrategia para maximizar la proporción de tokens aprovechados de la caché es mantener sin cambios el historial de la sesión. Eliminar o cambiar contenido de la conversación “invalida” la caché hasta el punto del cambio: la entrada ya no coincide tanto como antes. Ten en cuenta que las instrucciones y las definiciones de herramientas se encuentran al principio de la conversación, por lo que cambiarlas durante la sesión reducirá el aprovechamiento de la caché en los turnos siguientes.
Truncamiento
Cuando la cantidad de tokens de una conversación supera el límite de tokens de entrada del modelo, la conversación se trunca: se eliminan mensajes de la entrada de la Response, empezando por los más antiguos. Un modelo con un contexto de 32k y un máximo de 4096 tokens de salida solo puede incluir 28 224 tokens en el contexto antes de que se produzca el truncamiento.
Los clientes pueden establecer una ventana de tokens menor que el máximo del modelo, lo cual es una buena forma de controlar el uso de tokens y el costo. Esto se controla con la configuración token_limits.post_instructions (si configuras el truncamiento con el tipo retention_ratio, como se muestra a continuación). Como indica el nombre, esta opción controla la cantidad máxima de tokens de entrada para una Response, sin contar los tokens de las instrucciones. Si estableces post_instructions en 1000, los elementos que excedan el límite de 1000 tokens de entrada no se enviarán al modelo para una Response.
El truncamiento invalida la caché cerca del inicio de la conversación y, si ocurre en cada turno, el aprovechamiento de la caché será muy bajo. Para mitigar este problema, los clientes pueden configurar el truncamiento para que elimine más mensajes de los necesarios, lo que dejará más margen antes de que sea necesario volver a truncar. Esto se puede controlar con la opción session.truncation.retention_ratio. El servidor usa el valor 1.0 de forma predeterminada, lo que significa que el truncamiento solo eliminará los elementos necesarios. Un valor de 0.8 significa que el truncamiento conservaría el 80 % del máximo y eliminaría un 20 % adicional.
Si buscas reducir el costo por sesión de Realtime API para un modelo determinado, recomendamos limitar la cantidad de tokens y establecer un valor de retention_ratio menor que 1, como en el siguiente ejemplo. Recuerda que un costo menor puede implicar que el modelo disponga de menos memoria en un turno determinado.
{
"event": "session.update",
"session": {
"truncation": {
"type": "retention_ratio",
"retention_ratio": 0.8,
"token_limits": {
"post_instructions": 8000
}
}
}
}También puedes desactivar por completo el truncamiento, como se muestra a continuación. Cuando está desactivado, se devuelve un error si la Conversation es demasiado larga para crear una Response. Esto puede ser útil si quieres administrar manualmente el tamaño de la Conversation.
{
"event": "session.update",
"session": {
"truncation": "disabled"
}
}Otras estrategias de optimización
Usar un modelo mini
Los modelos speech2speech de Realtime vienen en un tamaño “normal” y uno mini, que es considerablemente más económico. La contrapartida suele estar en la inteligencia para seguir instrucciones y realizar llamadas a funciones, tareas en las que el modelo mini será menos eficaz. Recomendamos probar primero las aplicaciones con el modelo más grande, ajustar la aplicación y el prompt, y luego intentar optimizar los costos con el modelo mini.
Editar la Conversation
Aunque el truncamiento se realiza automáticamente en el servidor, otra estrategia para administrar los costos es editar manualmente la Conversation. Uno de los principios de la API es darle al cliente el control total de la Conversation del servidor, de modo que pueda agregar y eliminar elementos libremente.
{
"type": "conversation.item.delete",
"item_id": "item_CCXLecNJVIVR2HUy3ABLj"
}Eliminar mensajes antiguos es una buena forma de reducir la cantidad de tokens de entrada y el costo. Esto podría eliminar contenido importante, pero una estrategia habitual consiste en reemplazar esos mensajes antiguos por un resumen. Puedes eliminar Items de la Conversation con un mensaje conversation.item.delete, como se mostró antes, y agregarlos con un mensaje conversation.item.create.
Estimar los costos
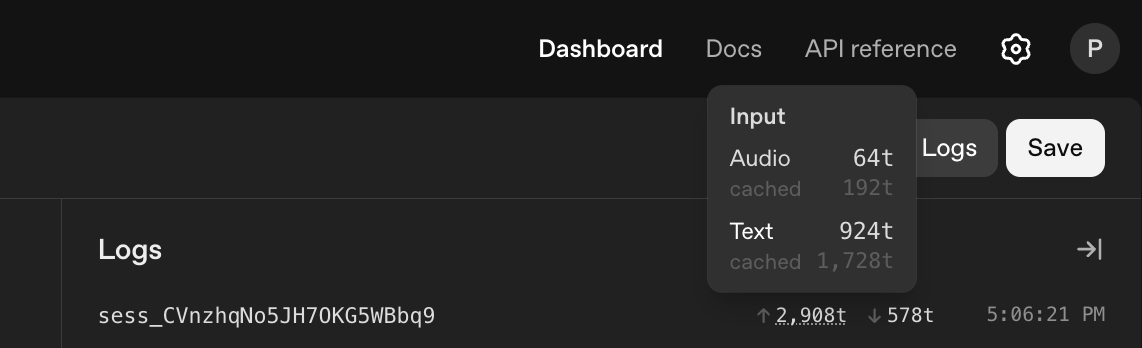
Dada la complejidad del uso de tokens en Realtime API, puede ser difícil estimar los costos de antemano. Una buena opción es usar Realtime Playground con los prompts y las funciones que planeas utilizar, y medir el uso de tokens durante una sesión de muestra. Puedes encontrar el uso de tokens de una sesión en la pestaña Registros de Realtime Playground, junto al ID de la sesión.