
Ahora que GPT-5 está disponible, queremos explicar por qué la mejor manera de integrarlo es con la API de Responses y cómo diseñamos Responses pensando en los modelos de razonamiento y en el futuro de los agentes.
Al diseñar cada generación de API de OpenAI, partimos de la misma pregunta: ¿cuál es la forma más sencilla y potente de que los desarrolladores interactúen con los modelos?
El funcionamiento de los modelos siempre ha guiado el diseño de nuestras API. Nuestro primer punto de acceso, /v1/completions, era sencillo, pero ofrecía pocas posibilidades. Le dabas un prompt al modelo y este completaba lo que habías empezado a escribir. Con técnicas como el uso de prompts con pocos ejemplos, los desarrolladores podían intentar guiar al modelo para que generara JSON o respondiera preguntas. Aun así, esos modelos eran mucho menos capaces que los que usamos hoy.
Después llegaron el RLHF, ChatGPT y la era del posentrenamiento. De pronto, los modelos hacían mucho más que completar un texto que habías dejado a medias: te respondían como lo haría alguien con quien conversas. Para seguirles el ritmo, creamos /v1/chat/completions (en un solo fin de semana, como cuenta la anécdota). Con roles como system, user y assistant, ofrecimos una estructura que permitía crear rápidamente interfaces de chat con instrucciones personalizadas y contexto.
Nuestros modelos siguieron mejorando. Pronto empezaron a ver, oír y hablar. La llamada a funciones, que incorporamos a finales de 2023, resultó ser una de las capacidades favoritas de los desarrolladores. Por esas fechas también lanzamos la versión beta de la API de Assistants. Fue nuestro primer intento de crear una interfaz diseñada de principio a fin para agentes, con herramientas alojadas como el intérprete de código y la búsqueda de archivos. A algunos desarrolladores les gustó, pero nunca llegó a adoptarse de forma masiva porque su diseño imponía limitaciones y era más difícil empezar a usarla que Chat Completions.
A finales de 2024, estaba claro que necesitábamos reunir esas capacidades en una sola API. Tenía que ser tan accesible como Chat Completions y tan potente como Assistants, además de estar diseñada expresamente para modelos multimodales y de razonamiento. Así nació /v1/responses.
/v1/responses es un ciclo de razonamiento y acción para agentes
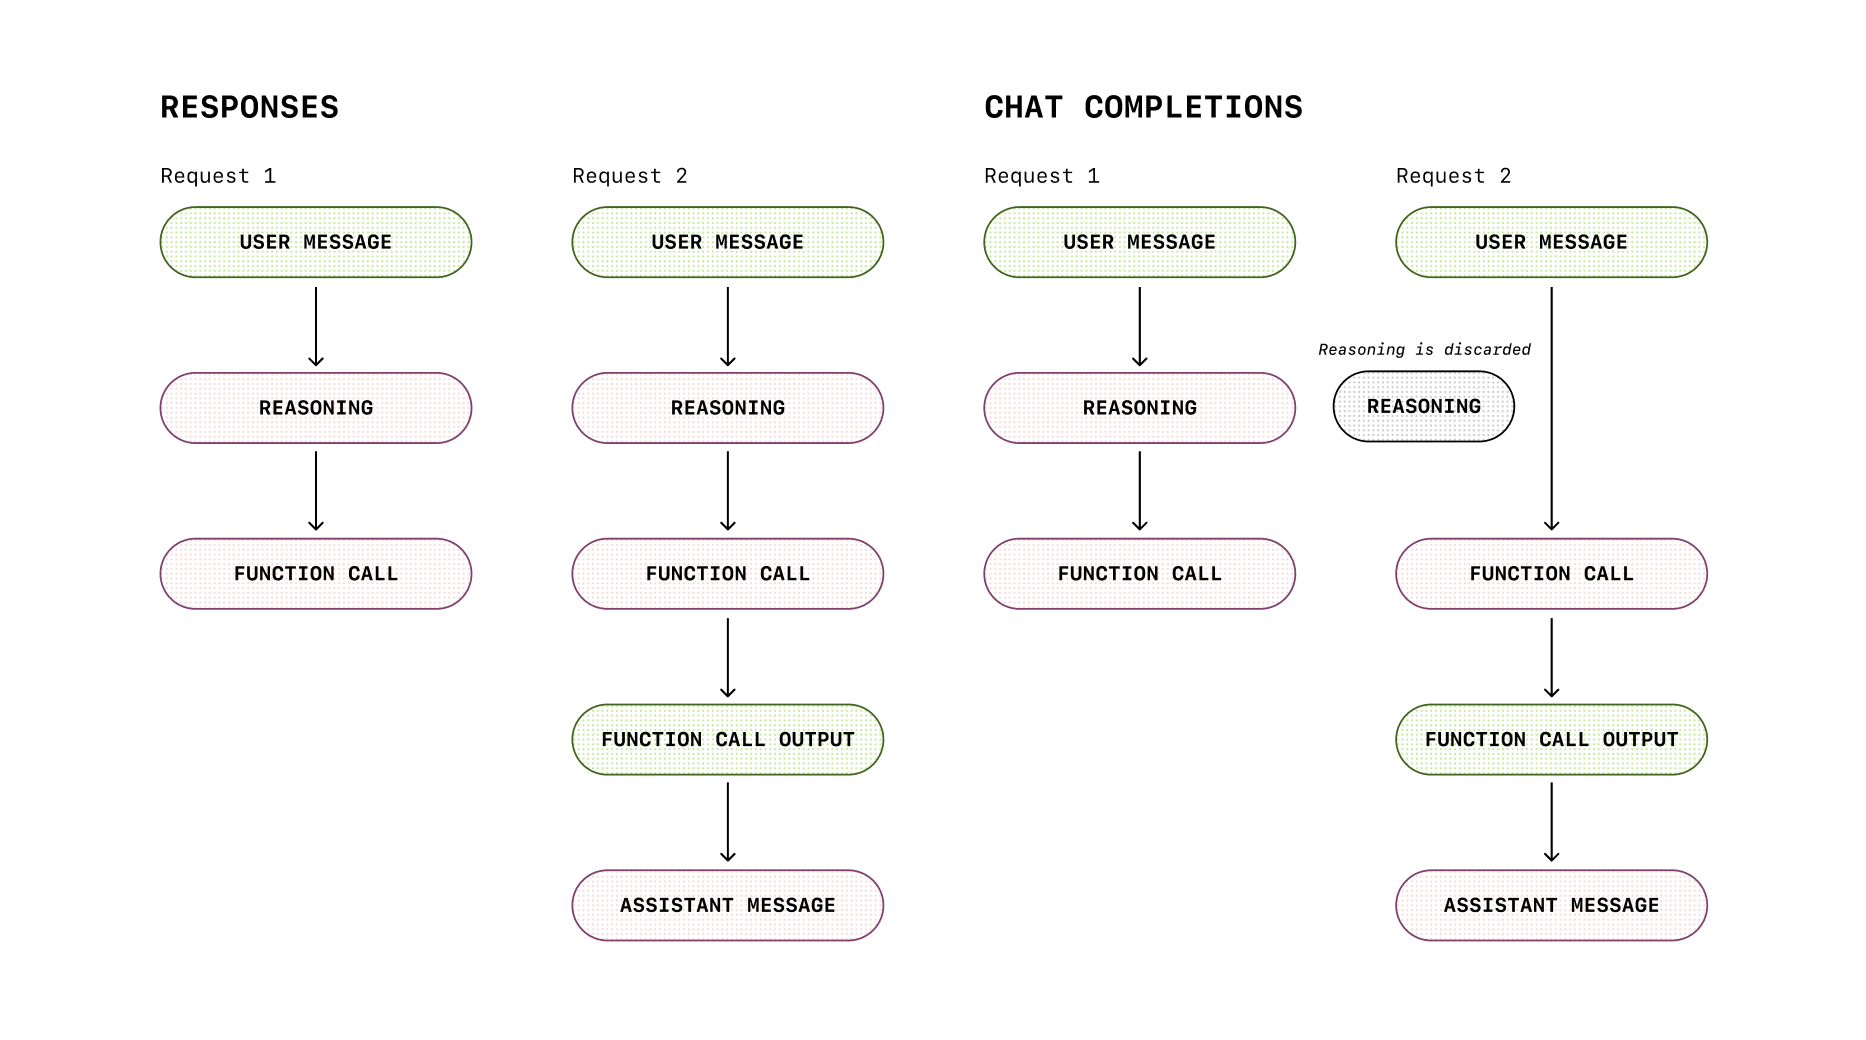
Chat Completions te ofrecía una interfaz sencilla de chat por turnos. Responses te ofrece un ciclo estructurado en el que el modelo razona y actúa. Imagina que trabajas con un detective. Le entregas las pruebas, él investiga, consulta a especialistas (las herramientas) si lo necesita y al final te informa de lo que descubrió. El detective conserva sus notas privadas (el estado del razonamiento) de un paso al siguiente, pero nunca se las entrega al cliente.
Aquí es donde los modelos de razonamiento se destacan. Responses conserva el estado del razonamiento del modelo entre turnos. En Chat Completions, el razonamiento se descarta entre llamadas, como si el detective olvidara las pistas cada vez que sale de la habitación. Con Responses, la libreta sigue abierta y el modelo conserva en el turno siguiente el razonamiento que desarrolló paso a paso. Esto se refleja en las pruebas de rendimiento (una mejora del 5 % en TAUBench), en un uso más eficiente de la caché y en una menor latencia.
Responses también puede devolver varios elementos de salida. Así puedes ver tanto lo que el modelo dijo como lo que hizo. Queda un registro de las llamadas a herramientas, los resultados estructurados y los pasos intermedios. Es como recibir el ensayo terminado junto con la hoja donde se hicieron los cálculos. Esto facilita la depuración, las auditorías y la creación de interfaces de usuario más completas.
{
  "message": {
    "role": "assistant",
    "content": "I'm going to use the get_weather tool to find the weather.",
    "tool_calls": [
      {
        "id": "call_88O3ElkW2RrSdRTNeeP1PZkm",
        "type": "function",
        "function": {
          "name": "get_weather",
          "arguments": "{\"location\":\"New York, NY\",\"unit\":\"f\"}"
        }
      }
    ],
    "refusal": null,
    "annotations": []
  }
} {
"id": "rs_6888f6d0606c819aa8205ecee386963f0e683233d39188e7",
"type": "reasoning",
"summary": [
{
"type": "summary_text",
"text": "**Determining weather response**\n\nI need to answer the user's question about the weather in San Francisco. ...."
},
},
{
"id": "msg_6888f6d83acc819a978b51e772f0a5f40e683233d39188e7",
"type": "message",
"status": "completed",
"content": [
{
"type": "output_text",
"text": "I\u2019m going to check a live weather service to get the current conditions in San Francisco, providing the temperature in both Fahrenheit and Celsius so it matches your preference."
}
],
"role": "assistant"
},
{
"id": "fc_6888f6d86e28819aaaa1ba69cca766b70e683233d39188e7",
"type": "function_call",
"status": "completed",
"arguments": "{\"location\":\"San Francisco, CA\",\"unit\":\"f\"}",
"call_id": "call_XOnF4B9DvB8EJVB3JvWnGg83",
"name": "get_weather"
},Herramientas alojadas para trabajar a un nivel más alto de abstracción
Cuando introdujimos la llamada a funciones, observamos un patrón. Los desarrolladores usaban el modelo tanto para invocar API como para buscar en repositorios de documentos e incorporar datos de fuentes externas. Hoy conocemos esta última técnica como RAG. Pero si apenas estás empezando a desarrollar, crear desde cero un sistema de recuperación de información es una tarea compleja y costosa. Con Assistants introdujimos nuestras primeras herramientas alojadas, file_search y code_interpreter, que permitían al modelo usar RAG y escribir código para resolver los problemas que le planteabas. Con Responses fuimos más allá e incorporamos la búsqueda web, la generación de imágenes y MCP. Como las herramientas alojadas, entre ellas el intérprete de código y las herramientas de MCP, se ejecutan en el servidor, ya no tienes que hacer pasar cada llamada por tu propio backend. Esto reduce la latencia y el costo de las comunicaciones de ida y vuelta.
Cómo conservar el razonamiento de forma segura
¿Por qué nos tomamos tantas molestias para ocultar la cadena de pensamiento (CoT) del modelo en su forma original? ¿No sería más sencillo mostrarla y dejar que los clientes la procesaran como cualquier otra salida del modelo? La respuesta breve es que exponerla conlleva varios riesgos. Puede contener alucinaciones o contenido dañino que el modelo no generaría en una respuesta final. Para OpenAI, también supone riesgos frente a la competencia.
Cuando lanzamos o1-preview a finales del año pasado, nuestro director científico, Jakub Pachocki, escribió lo siguiente en nuestro blog:
Creemos que una cadena de pensamiento oculta ofrece una oportunidad única para monitorear los modelos. Si refleja fielmente el razonamiento del modelo y es comprensible, la cadena de pensamiento oculta nos permite “leer la mente” del modelo y entender cómo piensa. Por ejemplo, en el futuro quizá queramos monitorear la cadena de pensamiento para detectar indicios de que el modelo intenta manipular al usuario. Para que esto funcione, el modelo debe tener la libertad de expresar sus pensamientos tal como surgen. Por eso, no podemos entrenarlo para que su cadena de pensamiento se ajuste a políticas o a preferencias de los usuarios. Tampoco queremos mostrarles directamente a los usuarios una cadena de pensamiento que no esté alineada.
Así aborda Responses esta cuestión:
- Conserva el razonamiento internamente, cifrado y oculto para el cliente.
- Permite continuar el razonamiento de forma segura mediante
previous_response_ido elementos de razonamiento, sin exponer la cadena de pensamiento en su forma original.
Por qué /v1/responses es la mejor opción para desarrollar
Diseñamos Responses para que conserve el estado, admita varias modalidades y sea eficiente.
- Uso de herramientas por parte de los agentes: la API de Responses permite ampliar fácilmente las capacidades de los flujos de trabajo con agentes mediante herramientas como la búsqueda de archivos, la generación de imágenes, el intérprete de código y MCP.
- Conservación del estado de forma predeterminada. Responses lleva un registro automático de las conversaciones y del estado de las herramientas. Esto simplifica considerablemente el razonamiento y los flujos de trabajo de varios turnos. Cuando se integra mediante Responses, GPT-5 obtiene una puntuación un 5 % mayor en TAUBench que con Chat Completions por el solo hecho de aprovechar el razonamiento que se conserva entre turnos.
- Multimodal desde el principio. El texto, las imágenes, el audio y las llamadas a funciones tienen la misma importancia. En lugar de añadir modalidades a una API de texto sobre la marcha, diseñamos la casa con suficientes habitaciones desde el primer día.
- Menores costos y mejor rendimiento. Nuestras pruebas internas muestran que el aprovechamiento de la caché mejora entre un 40 % y un 80 % en comparación con Chat Completions. Esto se traduce en menor latencia y menores costos.
- Mejor diseño: aprovechamos lo aprendido con la API para completar chats y la API de Assistants e incorporamos pequeñas mejoras que facilitan el trabajo con la API de Responses y el SDK. Entre ellas se encuentran las siguientes:
- Eventos de streaming con significado propio.
- Polimorfismo con etiquetas internas.
- Funciones auxiliares de
output_texten el SDK (ya no necesitaschoices.[0].message.content). - Una mejor organización de los parámetros multimodales y de razonamiento.
¿Qué pasará con Chat Completions?
Chat Completions seguirá disponible. Si te funciona, sigue usándolo. Si buscas un razonamiento que se conserve entre turnos, interacciones multimodales integradas de forma nativa y un ciclo de razonamiento y acción para agentes que funcione sin soluciones improvisadas, Responses es el siguiente paso.
Lo que viene
Así como Chat Completions reemplazó a Completions, esperamos que Responses se convierta en la opción habitual para desarrollar con los modelos de OpenAI. Ofrece la sencillez que necesitas, la potencia que buscas y la flexibilidad suficiente para adaptarse a lo que traiga el próximo cambio de paradigma.
Esta es la API sobre la que seguiremos desarrollando en los próximos años.