Donnez aux modèles accès à de nouvelles fonctionnalités et données pour suivre des instructions et répondre aux prompts.
Responses
L’appel de fonction, aussi appelé appel d’outil, offre aux modèles OpenAI un moyen puissant et flexible d’interagir avec des systèmes externes et d’accéder à d’autres données que celles de leur entraînement. Ce guide explique comment donner à un modèle accès aux données et aux actions de votre application. Vous y verrez comment utiliser des outils de type fonction, définis par un schéma JSON, ainsi que des outils personnalisés qui acceptent et renvoient du texte libre.
Pour les sessions de l’API Agents, suivez les instructions de la page Fonctions pour enregistrer des fonctions et traiter les demandes d’action d’une session. Les exemples de ce guide illustrent les intégrations avec les API Responses et Chat Completions.
Si votre application comporte de nombreuses fonctions ou des schémas volumineux, vous pouvez associer l’appel de fonction à la recherche d’outils pour différer le chargement des outils rarement utilisés jusqu’à ce que le modèle en ait besoin. Seuls gpt-5.4 et les modèles ultérieurs prennent en charge tool_search.
Avec GPT-6 Astra et GPT-6.1 Sol, les appels d’outils nécessitent l’API Responses. Les exemples de l’API Chat Completions utilisent GPT-5.6 Terra avec le raisonnement désactivé. Consultez le guide de migration pour mettre à jour une intégration existante.
Fonctionnement
Quelques notions permettent de comprendre les appels d’outils. Une fois ces notions définies, nous verrons comment les mettre en pratique à partir d’exemples.
Une fonction ou un outil est une fonctionnalité que vous déclarez auprès du modèle pour lui indiquer qu’il peut l’utiliser. Lorsqu’il répond à un prompt, le modèle peut déterminer qu’il a besoin des données ou des fonctionnalités d’un outil pour suivre les instructions du prompt.
Vous pouvez par exemple donner au modèle accès à des outils qui permettent de :
Consulter la météo du jour pour un lieu donné
Accéder aux informations d’un compte à partir d’un identifiant utilisateur
Rembourser une commande perdue
Vous pouvez ainsi lui donner accès à toute autre information ou action dont il pourrait avoir besoin pour répondre à un prompt.
Lorsque vous envoyez un prompt au modèle dans une requête API, vous pouvez y joindre une liste d’outils qu’il pourra utiliser. Par exemple, pour lui permettre de répondre à des questions sur la météo actuelle n’importe où dans le monde, vous pouvez lui donner accès à un outil get_weather qui prend location comme argument.
Un appel de fonction ou appel d’outil est une réponse particulière que le modèle peut renvoyer lorsqu’il analyse un prompt et détermine qu’il doit appeler l’un des outils disponibles pour suivre les instructions.
Si le modèle reçoit un prompt comme « Quel temps fait-il à Paris ? » dans une requête API, il peut répondre en appelant l’outil get_weather avec Paris comme valeur de l’argument location.
Le résultat d’un appel de fonction ou résultat d’un appel d’outil est la réponse que l’outil produit à partir des données transmises par le modèle lors de l’appel. Ce résultat peut prendre la forme de données JSON structurées ou de texte brut. Il doit faire référence à l’appel précis effectué par le modèle (identifié par call_id dans les exemples qui suivent).
Reprenons l’exemple de la météo :
Le modèle dispose de get_weather, un outil qui prend location comme argument.
En réponse à un prompt comme « Quel temps fait-il à Paris ? », le modèle renvoie un appel d’outil dont l’argument location vaut Paris.
Le résultat de l’appel d’outil peut être un objet JSON (par exemple, {"temperature": "25", "unit": "C"} indique qu’il fait actuellement 25 degrés), le contenu d’une image ou le contenu d’un fichier.
Renvoyez ensuite au modèle la définition de l’outil, le prompt d’origine, l’appel d’outil effectué par le modèle et le résultat de cet appel. Vous obtenez alors une réponse textuelle comme celle-ci :
The weather in Paris today is 25C.
Une fonction est un type d’outil défini par un schéma JSON. Sa définition permet au modèle de transmettre des données à votre application, où votre code peut consulter des données ou exécuter les actions proposées par le modèle.
Outre les outils de type fonction, il existe des outils personnalisés (décrits dans ce guide) qui acceptent et renvoient du texte libre.
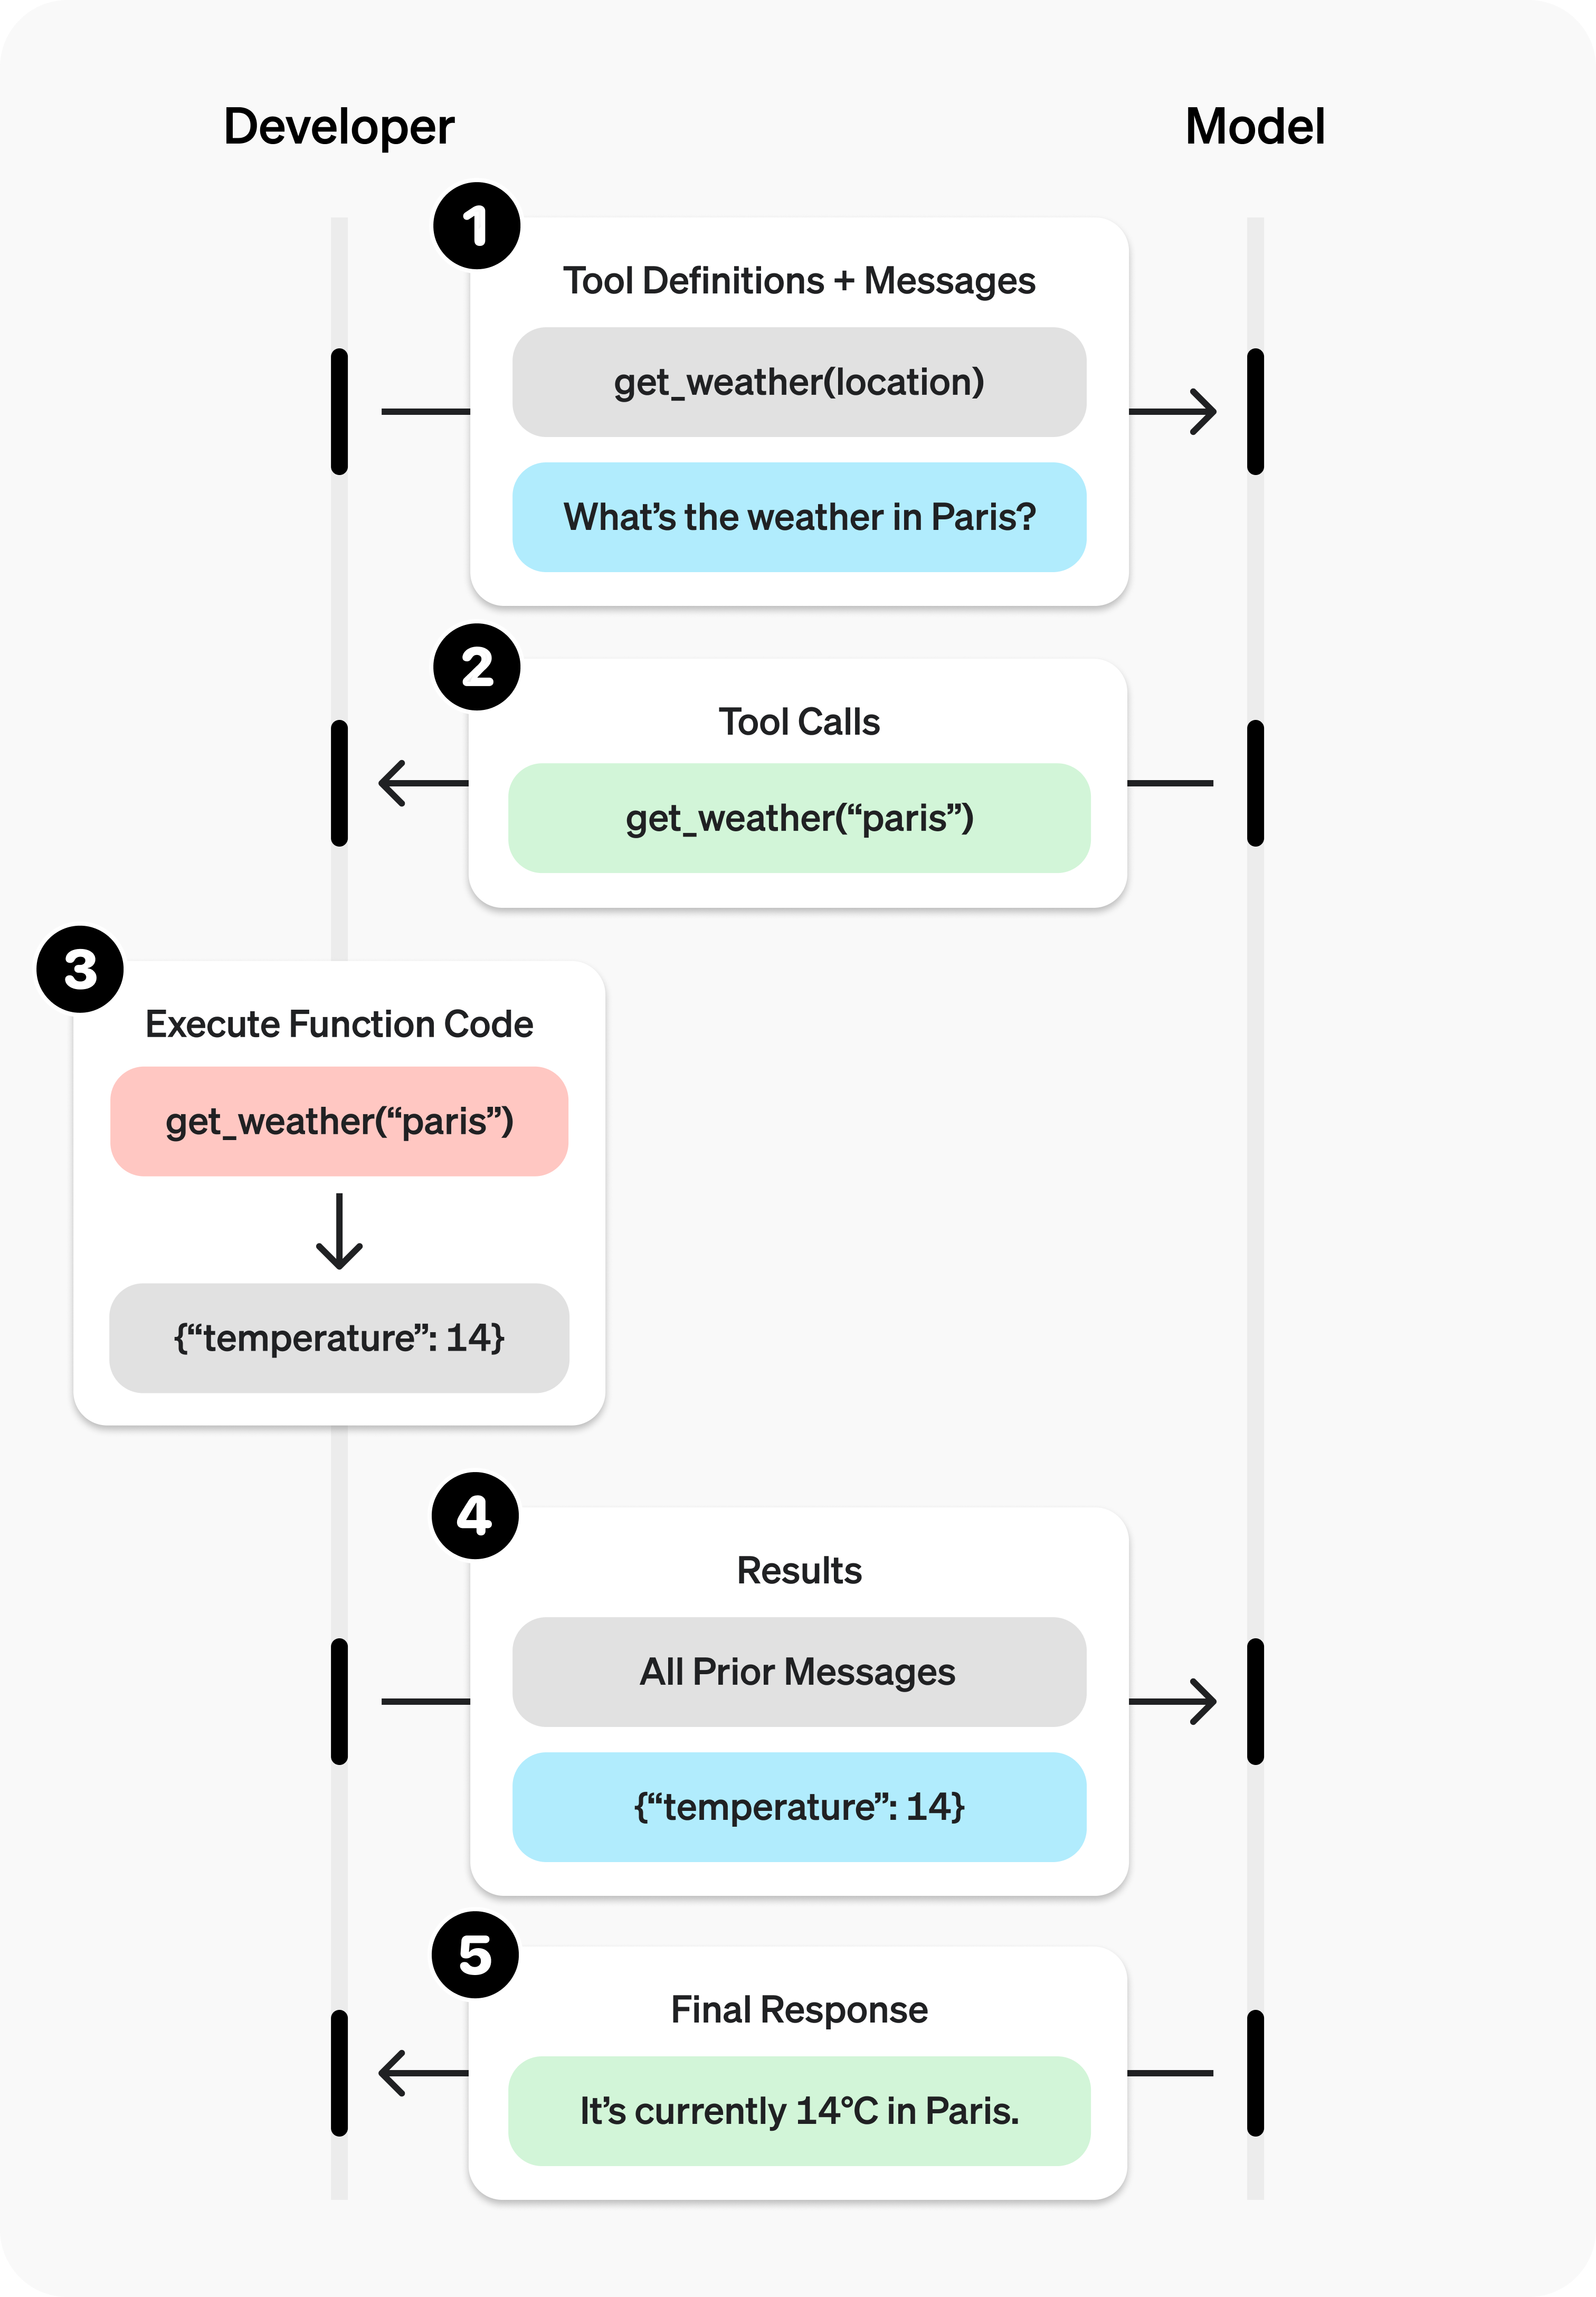
L’appel d’outil est un échange en plusieurs étapes entre votre application et un modèle via l’API OpenAI. Il se déroule en cinq grandes étapes :
Envoyez une requête au modèle en précisant les outils qu’il peut appeler.
Recevez un appel d’outil du modèle.
Exécutez le code côté application avec les données fournies dans l’appel.
Envoyez une deuxième requête au modèle avec le résultat de l’outil.
Recevez la réponse finale du modèle (ou d’autres appels d’outils).
Avec Responses, votre application peut poursuivre cet échange aussi longtemps que la tâche nécessite d’autres appels d’outils. Si vous recherchez un framework qui prend en charge les opérations récurrentes d’orchestration de cette boucle, consultez la comparaison entre l’API Responses et le SDK Agents.
Exemple d’outil de type fonction
Voyons comment se déroule un appel d’outil de bout en bout avec une fonction get_horoscope qui récupère l’horoscope du jour pour un signe astrologique.
Exemple complet d’appel d’outil
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72import OpenAI from "openai";const openai = new OpenAI();// 1. Define a list of callable tools for the modelconst tools = [ { type: "function", function: { name: "get_horoscope", description: "Get today's horoscope for an astrological sign.", parameters: { type: "object", properties: { sign: { type: "string", description: "An astrological sign like Taurus or Aquarius", }, }, required: ["sign"], additionalProperties: false, }, strict: true, }, },];function getHoroscope(sign) { return `${sign}: Next Tuesday you will befriend a baby otter.`;}const messages = [ { role: "user", content: "What is my horoscope? I am an Aquarius." },];// 2. Prompt the model with tools definedlet response = await openai.chat.completions.create({ model: "gpt-5.6-terra", reasoning_effort: "none", messages, tools,});messages.push(response.choices[0].message);for (const toolCall of response.choices[0].message.tool_calls ?? []) { if (toolCall.type !== "function") continue; if (toolCall.function.name === "get_horoscope") { // 3. Execute the function logic for get_horoscope const args = JSON.parse(toolCall.function.arguments); const horoscope = getHoroscope(args.sign); // 4. Provide function call results to the model messages.push({ role: "tool", tool_call_id: toolCall.id, content: JSON.stringify({ horoscope }), }); }}response = await openai.chat.completions.create({ model: "gpt-5.6-terra", reasoning_effort: "none", messages, tools,});// 5. The model should be able to give a response!console.log(response.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69from openai import OpenAIimport jsonclient = OpenAI()# 1. Define a list of callable tools for the modeltools = [ {"type": "function","function": {"name": "get_horoscope","description": "Get today's horoscope for an astrological sign.","parameters": {"type": "object","properties": {"sign": {"type": "string","description": "An astrological sign like Taurus or Aquarius", }, },"required": ["sign"],"additionalProperties": False, },"strict": True, }, },]defget_horoscope(sign):returnf"{sign}: Next Tuesday you will befriend a baby otter."messages = [{"role": "user", "content": "What is my horoscope? I am an Aquarius."}]# 2. Prompt the model with tools definedresponse = client.chat.completions.create(model="gpt-5.6-terra",reasoning_effort="none",messages=messages,tools=tools,)messages.append(response.choices[0].message)for tool_call in response.choices[0].message.tool_calls or []:if tool_call.function.name =="get_horoscope":# 3. Execute the function logic for get_horoscope args = json.loads(tool_call.function.arguments) horoscope = get_horoscope(args["sign"])# 4. Provide function call results to the model messages.append( {"role": "tool","tool_call_id": tool_call.id,"content": json.dumps({"horoscope": horoscope}), } )response = client.chat.completions.create(model="gpt-5.6-terra",reasoning_effort="none",messages=messages,tools=tools,)# 5. The model should be able to give a response!print(response.choices[0].message.content)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77import OpenAI from "openai";import { toResponseInputItems } from "openai/lib/responses/ResponseInputItems";const openai = new OpenAI();// 1. Define a list of callable tools for the modelconst tools = [ { type: "function", name: "get_horoscope", description: "Get today's horoscope for an astrological sign.", parameters: { type: "object", properties: { sign: { type: "string", description: "An astrological sign like Taurus or Aquarius", }, }, required: ["sign"], additionalProperties: false, }, strict: true, },];function getHoroscope(sign) { return `${sign}: Next Tuesday you will befriend a baby otter.`;}// Create a running input list we will add to over timelet input = [ { role: "user", content: "What is my horoscope? I am an Aquarius." },];// 2. Prompt the model with tools definedlet response = await openai.responses.create({ model: "gpt-6-astra", tools, input,});// Preserve model output for the next turninput.push(...toResponseInputItems(response.output));for (const item of response.output) { if (item.type !== "function_call") continue; if (item.name === "get_horoscope") { // 3. Execute the function logic for get_horoscope const { sign } = JSON.parse(item.arguments); const horoscope = getHoroscope(sign); // 4. Provide function call results to the model input.push({ type: "function_call_output", call_id: item.call_id, output: horoscope, }); }}console.log("Final input:");console.log(JSON.stringify(input, null, 2));response = await openai.responses.create({ model: "gpt-6-astra", instructions: "Respond only with a horoscope generated by a tool.", tools, input,});// 5. The model should be able to give a response!console.log("Final output:");console.log(response.output_text);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69from openai import OpenAIimport jsonclient = OpenAI()# 1. Define a list of callable tools for the modeltools = [ {"type": "function","name": "get_horoscope","strict": True,"description": "Get today's horoscope for an astrological sign.","parameters": {"type": "object","properties": {"sign": {"type": "string","description": "An astrological sign like Taurus or Aquarius", }, },"required": ["sign"],"additionalProperties": False, }, },]defget_horoscope(sign):returnf"{sign}: Next Tuesday you will befriend a baby otter."# Create a running input list we will add to over timeinput_list = [{"role": "user", "content": "What is my horoscope? I am an Aquarius."}]# 2. Prompt the model with tools definedresponse = client.responses.create(model="gpt-6-astra",tools=tools,input=input_list,)# Save function call outputs for subsequent requestsinput_list += response.outputfor item in response.output:if item.type =="function_call":if item.name =="get_horoscope":# 3. Execute the function logic for get_horoscope sign = json.loads(item.arguments)["sign"] horoscope = get_horoscope(sign)# 4. Provide function call results to the model input_list.append( {"type": "function_call_output","call_id": item.call_id,"output": horoscope, } )response = client.responses.create(model="gpt-6-astra",instructions="Respond only with a horoscope generated by a tool.",tools=tools,input=input_list,)# 5. The model should be able to give a response!print(response.output_text)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75package mainimport ( "context" "encoding/json" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses")func main() { client := openai.NewClient() tool := horoscopeResponseTool() response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Input: responses.ResponseNewParamsInputUnion{OfString: openai.String("What is my horoscope? I am an Aquarius.")}, Tools: []responses.ToolUnionParam{tool}, }) if err != nil { panic(err) } var functionOutput responses.ResponseInputItemUnionParam for _, output := range response.Output { if output.Type != "function_call" { continue } call := output.AsFunctionCall() if call.Name != "get_horoscope" { continue } var arguments struct { Sign string `json:"sign"` } if err := json.Unmarshal([]byte(call.Arguments), &arguments); err != nil { panic(err) } functionOutput = responses.ResponseInputItemParamOfFunctionCallOutput(getHoroscope(arguments.Sign)) functionOutput.OfFunctionCallOutput.CallID = openai.String(call.CallID) } if functionOutput.OfFunctionCallOutput == nil { panic("the model did not call get_horoscope") } response, err = client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", PreviousResponseID: openai.String(response.ID), Instructions: openai.String("Respond only with a horoscope generated by a tool."), Input: responses.ResponseNewParamsInputUnion{OfInputItemList: responses.ResponseInputParam{functionOutput}}, Tools: []responses.ToolUnionParam{tool}, }) if err != nil { panic(err) } fmt.Println(response.OutputText())}func horoscopeResponseTool() responses.ToolUnionParam { parameters := map[string]any{ "type": "object", "properties": map[string]any{ "sign": map[string]any{"type": "string", "description": "An astrological sign like Taurus or Aquarius"}, }, "required": []string{"sign"}, "additionalProperties": false, } tool := responses.ToolParamOfFunction("get_horoscope", parameters, true) tool.OfFunction.Description = openai.String("Get today's horoscope for an astrological sign.") return tool}func getHoroscope(sign string) string { return fmt.Sprintf("%s: Next Tuesday you will befriend a baby otter.", sign)}
Pour les modèles de raisonnement comme GPT-5 ou o4-mini, vous devez également renvoyer avec les résultats des appels d’outils tous les éléments de raisonnement que le modèle a inclus dans les réponses contenant ces appels. Pour savoir comment conserver l’historique des échanges qui ont conduit le modèle à produire ces éléments, consultez les bonnes pratiques pour modifier le préfixe.
Définition des fonctions
En général, vous déclarez les fonctions dans le paramètre tools de chaque requête API. Avec la recherche d’outils, votre application peut aussi charger certaines fonctions plus tard dans l’échange. Dans les deux cas, le schéma de chaque fonction appelable suit la même structure. Une définition de fonction comporte les propriétés suivantes :
Champ
Description
type
Doit toujours valoir function
name
Nom de la fonction (par exemple, get_weather)
description
Précisions sur les circonstances et la manière d’utiliser la fonction
parameters
Schéma JSON qui définit les arguments d’entrée de la fonction
strict
Indique si le mode strict s’applique à l’appel de fonction
Voici un exemple de définition pour la fonction get_weather :
12345678910111213141516171819202122{ "type": "function", "name": "get_weather", "description": "Retrieves current weather for the given location.", "parameters": { "type": "object", "properties": { "location": { "type": "string", "description": "City and country e.g. Bogotá, Colombia" }, "units": { "type": "string", "enum": ["celsius", "fahrenheit"], "description": "Units the temperature will be returned in." } }, "required": ["location", "units"], "additionalProperties": false }, "strict": true}
Comme le champ parameters contient un schéma JSON, vous pouvez utiliser de nombreuses fonctionnalités de ce format, notamment les types de propriétés, les énumérations, les descriptions, les objets imbriqués et les objets récursifs.
Définition des espaces de noms
Utilisez des espaces de noms pour regrouper les outils par domaine, par exemple crm, billing ou shipping. Ils permettent d’organiser les outils similaires et sont particulièrement utiles lorsque le modèle doit choisir entre des outils destinés à des systèmes ou à des usages différents, par exemple un outil de recherche pour votre CRM et un autre pour votre système de gestion des tickets d’assistance.
Si vous devez donner au modèle accès à un grand nombre d’outils, vous pouvez différer le chargement de tout ou partie de ces outils avec tool_search. L’outil tool_search permet au modèle de rechercher les outils pertinents, de les ajouter à son contexte, puis de les utiliser. Seuls gpt-5.4 et les modèles ultérieurs le prennent en charge. Pour en savoir plus, consultez le guide de recherche d’outils.
Définissez directement les schémas de vos fonctions lorsque c’est possible. Les bibliothèques clientes Python et JavaScript fournissent aussi des utilitaires pour convertir des objets pydantic et zod en schémas, mais ces utilitaires ne prennent pas en charge toutes les fonctionnalités.
Définition d’objets représentant un schéma de fonction
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27import OpenAI from "openai";import { z } from "zod";import { zodFunction } from "openai/helpers/zod";const openai = new OpenAI();const GetWeatherParameters = z.object({ location: z.string().describe("City and country e.g. Bogotá, Colombia"),});const tools = [ zodFunction({ name: "getWeather", parameters: GetWeatherParameters }),];const messages = [ { role: "user", content: "What's the weather like in Paris today?" },];const response = await openai.chat.completions.create({ model: "gpt-5.6-terra", reasoning_effort: "none", messages, tools, store: true,});console.log(response.choices[0].message.tool_calls);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20from openai import OpenAI, pydantic_function_toolfrom pydantic import BaseModel, Fieldclient = OpenAI()classGetWeather(BaseModel): location: str= Field(..., description="City and country e.g. Bogotá, Colombia")tools = [pydantic_function_tool(GetWeather)]completion = client.chat.completions.create(model="gpt-5.6-terra",reasoning_effort="none",messages=[{"role": "user", "content": "What's the weather like in Paris today?"}],tools=tools,)print(completion.choices[0].message.tool_calls)
Bonnes pratiques pour définir des fonctions
Choisissez des noms de fonctions explicites et rédigez des descriptions de paramètres et des instructions claires et détaillées.
Précisez le rôle de la fonction et de chaque paramètre, ainsi que le format de chaque paramètre et la signification du résultat.
Indiquez dans le prompt système quand utiliser chaque fonction et quand s’en abstenir. En règle générale, dites au modèle exactement quoi faire.
Incluez des exemples et des cas limites, en particulier pour corriger les erreurs récurrentes. (Remarque : l’ajout d’exemples peut nuire aux performances des modèles de raisonnement.)
Pour les outils à chargement différé, détaillez les consignes dans la description de la fonction et décrivez brièvement l’espace de noms. L’espace de noms aide le modèle à choisir les outils à charger. La description de la fonction l’aide à utiliser correctement l’outil une fois chargé.
Utilisez des énumérations et structurez les objets de façon à empêcher les états invalides. Par exemple, toggle_light(on: bool, off: bool) autorise des appels invalides.
Faites le test avec un stagiaire. Une personne qui découvre la fonction peut-elle l’utiliser correctement avec les seules informations fournies au modèle ? (Sinon, quelles questions vous pose-t-elle ? Ajoutez les réponses au prompt.)
Allégez le travail du modèle en utilisant du code chaque fois que possible.
Ne demandez pas au modèle de renseigner des arguments dont vous connaissez déjà la valeur. Par exemple, si vous disposez déjà d’un order_id à la suite d’un choix dans un menu, n’incluez pas de paramètre order_id. Définissez plutôt submit_refund() sans paramètres et transmettez order_id dans votre code.
Regroupez les fonctions que vous appelez toujours l’une après l’autre. Par exemple, si vous appelez toujours mark_location() après query_location(), intégrez simplement la logique de marquage à la fonction de recherche.
Limitez le nombre de fonctions disponibles au départ pour améliorer la précision des appels.
Évaluez les performances en faisant varier le nombre de fonctions.
Visez moins de 20 fonctions disponibles au début de chaque tour. Ce nombre est indicatif.
Utilisez la recherche d’outils pour différer le chargement des groupes d’outils volumineux ou peu utilisés au lieu de tout charger dès le départ.
Tirez parti des ressources OpenAI.
Générez et affinez vos schémas de fonctions dans le Playground.
Envisagez le fine-tuning pour améliorer la précision des appels de fonction si les fonctions sont nombreuses ou les tâches difficiles (exemple du Cookbook).
Consommation de tokens
Les fonctions sont insérées dans le message système selon une syntaxe que le modèle a apprise pendant son entraînement. Les définitions des fonctions appelables occupent donc une partie de la fenêtre de contexte du modèle et sont facturées en tokens d’entrée. Si vous atteignez les limites de tokens, nous vous conseillons de charger moins de fonctions au départ, de raccourcir les descriptions lorsque c’est possible ou d’utiliser la recherche d’outils pour charger les outils différés uniquement lorsque le modèle en a besoin.
Si votre spécification d’outils définit de nombreuses fonctions, vous pouvez aussi recourir au fine-tuning pour réduire le nombre de tokens utilisés.
Traitement des appels de fonction
Lorsque le modèle appelle une fonction, vous devez l’exécuter et renvoyer le résultat. Une réponse peut contenir zéro, un ou plusieurs appels. Prévoyez donc de traiter plusieurs appels.
La réponse contient un tableau tool_calls. Chaque entrée comprend un id (utilisé ensuite pour transmettre le résultat de la fonction) et un objet function contenant un champ name et des arguments encodés en JSON.
Exemple de réponse avec plusieurs appels de fonction
Le tableau output de la réponse contient une entrée dont le champ type vaut function_call. Chaque entrée de ce type comprend un call_id (utilisé ensuite pour transmettre le résultat de la fonction), un champ name et des arguments encodés en JSON.
Exemple de réponse avec plusieurs appels de fonction
Si vous utilisez la recherche d’outils, des éléments tool_search_call et tool_search_output peuvent aussi apparaître avant un élément function_call. Une fois la fonction chargée, traitez l’appel comme dans cet exemple.
Exécution des appels de fonction et ajout des résultats
L’exemple ci-dessus suppose l’existence d’une fonction call_function qui dirige chaque appel vers la fonction correspondante. Voici une implémentation possible :
Exécution des appels de fonction et ajout des résultats
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31import com.fasterxml.jackson.databind.JsonNode;import com.fasterxml.jackson.databind.ObjectMapper;import java.util.Map;var argsJson = new ObjectMapper().readTree("{\"location\":\"Paris, France\"}");System.out.println(callFunction("get_weather", argsJson));// These local fixtures demonstrate dispatch; replace them with your application services.// The email fixture prints its inputs and does not send a message.static Map<String, Object> callFunction(String name, JsonNode arguments) { return switch (name) { case "get_weather" -> getWeather(arguments.get("location").asText()); case "send_email" -> sendEmail(arguments.get("to").asText(), arguments.get("body").asText()); default -> throw new IllegalArgumentException("Unknown function: " + name); };}private static Map<String, Object> getWeather(String location) { int temperature = switch (location) { case "Bogotá, Colombia" -> 18; case "Paris, France" -> 15; default -> 20; }; return Map.of("location", location, "temperature_celsius", temperature);}private static Map<String, Object> sendEmail(String to, String body) { System.out.println("Sending email to " + to + ": " + body); return Map.of("status", "sent");}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22using System.Text.Json;using JsonDocument arguments = JsonDocument.Parse("{\"location\":\"Paris, France\"}");Console.WriteLine(FunctionDispatcher.CallFunction("get_weather", arguments.RootElement));internal static class FunctionDispatcher{ // These local fixtures demonstrate dispatch; replace them with your application services. // The email fixture prints its inputs and does not send a message. internal static string CallFunction(string name, JsonElement arguments) => name switch { "get_weather" => GetWeather(arguments.GetProperty("location").GetString()!), "send_email" => SendEmail(arguments.GetProperty("to").GetString()!, arguments.GetProperty("body").GetString()!), _ => throw new ArgumentException($"Unknown function: {name}", nameof(name)) }; private static string GetWeather(string location) => JsonSerializer.Serialize(new { location, temperature_celsius = location switch { "Bogotá, Colombia" => 18, "Paris, France" => 15, _ => 20 } }); private static string SendEmail(string to, string body) { Console.WriteLine($"Sending email to {to}: {body}"); return "{\"status\":\"sent\"}"; }}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16def call_function(name, arguments) case name when "get_weather" FunctionCallingExample.get_weather( arguments.fetch("latitude"), arguments.fetch("longitude") ) when "send_email" FunctionCallingExample.send_email( arguments.fetch("to"), arguments.fetch("body") ) else raise ArgumentError, "Unknown function: #{name}" endend
Format des résultats
Le résultat transmis dans le message function_call_output est généralement une chaîne de caractères dont vous choisissez le format (JSON, code d’erreur, texte brut, etc.). Le modèle interprète cette chaîne selon les besoins.
"It's about 15°C in Paris, 18°C in Bogotá, and I've sent that email to Bob."
Options de configuration supplémentaires
Choix des outils
Par défaut, le modèle décide quand utiliser des outils et combien en utiliser. Vous pouvez imposer un comportement précis avec le paramètre tool_choice.
Automatique : (par défaut) le modèle peut appeler zéro, une ou plusieurs fonctions. tool_choice: "auto"
Appel obligatoire : le modèle doit appeler au moins une fonction.
tool_choice: "required"
Fonction imposée : le modèle doit effectuer exactement un appel à la fonction spécifiée.
tool_choice: {"type": "function", "name": "get_weather"}
Outils autorisés : le modèle peut uniquement appeler un sous-ensemble des outils mis à sa disposition.
Quand utiliser allowed_tools
Configurez une liste allowed_tools si vous souhaitez rendre seulement certains outils accessibles selon la requête tout en conservant la même liste d’outils en entrée. Vous pouvez ainsi maximiser les économies liées à la mise en cache des prompts.
Vous pouvez également définir tool_choice sur "none" pour obtenir le même comportement que si vous ne transmettiez aucune fonction.
Lorsque vous utilisez la recherche d’outils, tool_choice s’applique toujours aux outils appelables à ce stade du tour. Cette option est particulièrement utile lorsque vous venez de charger un sous-ensemble d’outils et souhaitez limiter le modèle à ces outils.
Appels de fonction en parallèle
À partir de GPT-5, les modèles compatibles peuvent appeler des fonctions en parallèle même si des outils intégrés sont également disponibles. Un lot d’appels de fonction parallèles ne peut pas inclure d’outils intégrés.
Le modèle peut choisir d’appeler plusieurs fonctions au cours d’un même tour. Pour l’en empêcher, définissez parallel_tool_calls sur false. Le modèle appellera alors au plus un outil.
Remarque : actuellement, si un modèle ayant fait l’objet d’un fine-tuning appelle plusieurs fonctions au cours d’un même tour, le mode strict est désactivé pour ces appels.
Remarque concernant gpt-4.1-nano-2025-04-14 : cette version de gpt-4.1-nano peut parfois appeler plusieurs fois le même outil si les appels parallèles sont activés. Nous vous recommandons de désactiver cette fonctionnalité avec cette version.
Mode strict
Définissez strict sur true pour garantir que les appels de fonction respectent le schéma de la fonction. Sans cette garantie, le modèle fait au mieux pour s’y conformer. Nous vous recommandons de toujours activer le mode strict.
Le mode strict s’appuie sur les sorties structurées et impose donc deux contraintes :
additionalProperties doit valoir false pour chaque objet dans parameters.
Tous les champs de properties doivent figurer dans required.
Pour rendre un champ facultatif, ajoutez null aux valeurs possibles de type (voir l’exemple ci-dessous).
Si vous envoyez strict: true et que votre schéma ne respecte pas ces exigences, l’API rejette la requête et indique les contraintes manquantes. Si vous omettez strict, le comportement par défaut dépend de l’API. L’API Responses tente d’adapter votre schéma au mode strict. Si elle ne peut pas le rendre compatible, elle utilise le mode non strict, dans lequel le modèle fait au mieux pour respecter le schéma. Dans ce cas, l’outil figurant dans la réponse indique strict: false. Les requêtes Chat Completions utilisent par défaut le mode non strict. Pour désactiver le mode strict dans Responses et conserver les appels de fonction sans garantie de conformité, spécifiez explicitement strict: false.
Mode strict activé
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24{"type": "function","function": {"name": "get_weather","description": "Retrieves current weather for the given location.","strict": true,"parameters": {"type": "object","properties": {"location": {"type": "string","description": "City and country e.g. Bogotá, Colombia" },"units": {"type": ["string", "null"],"enum": ["celsius", "fahrenheit"],"description": "Units the temperature will be returned in." } },"required": ["location", "units"],"additionalProperties": false } }}
Mode strict désactivé
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22{"type": "function","function": {"name": "get_weather","description": "Retrieves current weather for the given location.","parameters": {"type": "object","properties": {"location": {"type": "string","description": "City and country e.g. Bogotá, Colombia" },"units": {"type": "string","enum": ["celsius", "fahrenheit"],"description": "Units the temperature will be returned in." } },"required": ["location"], } }}
Mode strict activé
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22{"type": "function","name": "get_weather","description": "Retrieves current weather for the given location.","strict": true,"parameters": {"type": "object","properties": {"location": {"type": "string","description": "City and country e.g. Bogotá, Colombia" },"units": {"type": ["string", "null"],"enum": ["celsius", "fahrenheit"],"description": "Units the temperature will be returned in." } },"required": ["location", "units"],"additionalProperties": false }}
Mode strict désactivé
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20{"type": "function","name": "get_weather","description": "Retrieves current weather for the given location.","parameters": {"type": "object","properties": {"location": {"type": "string","description": "City and country e.g. Bogotá, Colombia" },"units": {"type": "string","enum": ["celsius", "fahrenheit"],"description": "Units the temperature will be returned in." } },"required": ["location"], }}
Le mode strict est activé pour tous les schémas générés dans le Playground.
Nous vous recommandons d’activer le mode strict, mais il présente quelques limites :
Certaines fonctionnalités des schémas JSON ne sont pas prises en charge (voir les schémas pris en charge).
Les limites suivantes concernent spécifiquement les modèles ayant fait l’objet d’un fine-tuning :
Les schémas font l’objet d’un traitement supplémentaire lors de la première requête, puis sont mis en cache. Si vos schémas varient d’une requête à l’autre, la latence peut augmenter.
La diffusion en continu permet de suivre la progression d’un appel : vous pouvez afficher la fonction appelée pendant que le modèle renseigne ses arguments, et même afficher les arguments en temps réel.
La diffusion en continu des appels de fonction fonctionne comme celle des réponses ordinaires : définissez stream sur true pour recevoir des fragments contenant des objets delta.
Diffusion en continu des appels de fonction
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42import { OpenAI } from "openai";const openai = new OpenAI();const tools = [ { type: "function", function: { name: "get_weather", description: "Get current temperature for a given location.", parameters: { type: "object", properties: { location: { type: "string", description: "City and country e.g. Bogotá, Colombia", }, }, required: ["location"], additionalProperties: false, }, strict: true, }, },];const stream = await openai.chat.completions.create({ model: "gpt-5.6-terra", reasoning_effort: "none", messages: [ { role: "user", content: "What's the weather like in Paris today?" }, ], tools, tool_choice: "required", stream: true, store: true,});for await (const chunk of stream) { const delta = chunk.choices[0].delta; console.log(delta.tool_calls);}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37from openai import OpenAIclient = OpenAI()tools = [ {"type": "function","function": {"name": "get_weather","description": "Get current temperature for a given location.","parameters": {"type": "object","properties": {"location": {"type": "string","description": "City and country e.g. Bogotá, Colombia", } },"required": ["location"],"additionalProperties": False, },"strict": True, }, }]stream = client.chat.completions.create(model="gpt-5.6-terra",reasoning_effort="none",messages=[{"role": "user", "content": "What's the weather like in Paris today?"}],tools=tools,stream=True,)for chunk in stream: delta = chunk.choices[0].deltaprint(delta.tool_calls)
Au lieu d’assembler les fragments en une seule chaîne content, vous les assemblez pour reconstituer l’objet arguments encodé en JSON.
Lorsque le modèle appelle une ou plusieurs fonctions, il renseigne le champ tool_calls de chaque delta. Chaque tool_call contient les champs suivants :
Champ
Description
index
Identifie l’appel de fonction auquel se rapporte le delta.
id
Identifiant de l’appel d’outil.
function
Fragment de l’appel de fonction (name et arguments).
type
Type de tool_call (toujours function pour les appels de fonction).
De nombreux champs ne sont renseignés que dans le premier delta de chaque appel d’outil, notamment id, function.name et type.
L’extrait de code suivant montre comment assembler les delta pour obtenir l’objet tool_calls final.
La diffusion en continu permet de suivre la progression d’un appel : vous pouvez afficher la fonction appelée pendant que le modèle renseigne ses arguments, et même afficher les arguments en temps réel.
La diffusion en continu des appels de fonction fonctionne comme celle des réponses ordinaires : définissez stream sur true pour recevoir différents objets event.
Au lieu d’assembler les fragments en une seule chaîne content, vous les assemblez pour reconstituer l’objet arguments encodé en JSON.
Lorsque le modèle appelle une ou plusieurs fonctions, l’API émet pour chaque appel un événement de type response.output_item.added contenant les champs suivants :
Champ
Description
response_id
Identifiant de la réponse à laquelle appartient l’appel de fonction.
output_index
Indice de l’élément de sortie dans la réponse. Il permet de distinguer les différents appels de fonction dans cette réponse.
item
Élément représentant l’appel de fonction en cours, avec les champs name, arguments et id.
Vous recevez ensuite une série d’événements de type response.function_call_arguments.delta, qui contiennent le delta du champ arguments. Ces événements comportent les champs suivants :
Champ
Description
response_id
Identifiant de la réponse à laquelle appartient l’appel de fonction.
item_id
Identifiant de l’élément d’appel de fonction auquel appartient le fragment.
output_index
Indice de l’élément de sortie dans la réponse. Il permet de distinguer les différents appels de fonction dans cette réponse.
delta
Fragment du champ arguments.
L’extrait de code suivant montre comment assembler les delta pour obtenir l’objet tool_call final.
Lorsque le modèle a fini d’appeler les fonctions, l’API émet un événement de type response.function_call_arguments.done. Cet événement contient l’appel de fonction complet, avec les champs suivants :
Champ
Description
response_id
Identifiant de la réponse à laquelle appartient l’appel de fonction.
output_index
Indice de l’élément de sortie dans la réponse. Il permet de distinguer les différents appels de fonction dans cette réponse.
item
Élément représentant l’appel de fonction, avec les champs name, arguments et id.
Outils personnalisés
Les outils personnalisés fonctionnent de manière similaire aux outils de type fonction définis par un schéma JSON. Toutefois, vous n’avez pas à préciser explicitement la structure des données attendues : le modèle peut transmettre à l’outil une chaîne de caractères arbitraire en entrée. Vous évitez ainsi d’encapsuler inutilement une réponse dans du JSON. Vous pouvez aussi appliquer une grammaire personnalisée à la réponse, comme expliqué plus loin.
L’exemple suivant montre comment créer un outil personnalisé qui attend du modèle une chaîne de caractères contenant du code Python.
Exemple d’appel d’un outil personnalisé
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16import OpenAI from "openai";const client = new OpenAI();const response = await client.responses.create({ model: "gpt-6-astra", input: "Use the code_exec tool to print hello world to the console.", tools: [ { type: "custom", name: "code_exec", description: "Executes arbitrary Python code.", }, ],});console.log(response.output);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16from openai import OpenAIclient = OpenAI()response = client.responses.create(model="gpt-6-astra",input="Use the code_exec tool to print hello world to the console.",tools=[ {"type": "custom","name": "code_exec","description": "Executes arbitrary Python code.", } ],)print(response.output)
Comme précédemment, le tableau output contient un appel d’outil généré par le modèle. Cette fois, l’entrée de l’appel est fournie sous forme de texte brut.
Une grammaire hors contexte (CFG) est un ensemble de règles qui définissent comment produire du texte valide dans un format donné. Pour un outil personnalisé, vous pouvez fournir une CFG afin de contraindre le texte que le modèle lui transmet en entrée.
Lors de la configuration d’un outil personnalisé, utilisez le paramètre grammar pour fournir votre CFG. Deux syntaxes sont actuellement prises en charge pour définir les grammaires : lark et regex.
Les grammaires utilisent une variante de Lark. LLGuidance contraint l’échantillonnage du modèle. Certaines fonctionnalités de Lark ne sont pas prises en charge :
Les assertions avant et arrière dans les expressions régulières de l’analyseur lexical
Les quantificateurs non gourmands (*?, +?, ??) dans les expressions régulières de l’analyseur lexical
Les priorités des terminaux
Les modèles de règles
Les imports (sauf l’import intégré %import common)
Les directives %declare
Nous vous recommandons d’utiliser l’IDE Lark pour expérimenter avec vos grammaires personnalisées.
Limitez la complexité de la grammaire
Limitez votre grammaire aux règles et aux motifs nécessaires à votre outil. L’API OpenAI peut renvoyer une erreur si la grammaire est trop complexe. Vérifiez donc sa compatibilité avant de l’utiliser dans l’API.
La mise au point d’une grammaire Lark peut être délicate. Les grammaires simples sont les plus fiables. Pour une grammaire complexe, il faut souvent ajuster à plusieurs reprises sa définition, le prompt et la description de l’outil pour éviter que le modèle ne produise des sorties hors distribution.
Ne découpez PAS le motif en plusieurs règles ou terminaux comme ci-dessous. Cette approche suppose que les règles peuvent répartir le texte libre entre les terminaux. Or l’analyseur lexical retient la correspondance la plus longue pour chaque fragment de texte libre et vous perdez la maîtrise du découpage :
Seules les définitions des terminaux déterminent comment l’analyseur lexical découpe l’entrée. Les règles en minuscules n’influencent pas ce découpage. Si vous devez reconnaître du « texte libre entre des points d’ancrage », définissez un seul terminal dont l’expression régulière couvre tout le motif. L’analyseur lexical le reconnaîtra ainsi en une seule fois, selon la structure voulue.
Terminaux et règles
Lark utilise les terminaux pour les tokens de l’analyseur lexical (par convention, UPPERCASE) et les règles pour les productions de l’analyseur syntaxique (par convention, lowercase). Pour vous en tenir aux fonctionnalités prises en charge et éviter les surprises, définissez une grammaire explicite, évitez toute complexité superflue et attribuez des rôles distincts aux terminaux et aux règles.
L’analyseur lexical reconnaît les terminaux en retenant la correspondance la plus longue avant toute application des règles de la CFG. Si vous tentez de « façonner » un terminal en le répartissant sur plusieurs règles, l’analyseur lexical tiendra uniquement compte des expressions régulières des terminaux, sans suivre ces règles.
Privilégiez un seul terminal pour extraire un motif de passages en texte libre
Pour reconnaître un motif dans du texte arbitraire (par exemple, une phrase en langage naturel qui peut contenir « n’importe quoi » entre des points d’ancrage), exprimez-le sous la forme d’un seul terminal. Évitez d’alterner terminaux de texte libre et règles syntaxiques : l’analyseur lexical retient la correspondance la plus longue sans respecter les limites voulues, et le modèle risque fortement de produire des sorties hors distribution.
Utilisez les règles pour combiner des tokens distincts
Les règles conviennent pour assembler des terminaux explicitement délimités (nombres, mots-clés, signes de ponctuation) en structures plus grandes. Elles ne permettent pas de contraindre efficacement « ce qui se trouve entre » deux terminaux.
Définissez des terminaux ciblés, bornés et autonomes
Privilégiez les classes de caractères explicites et les quantificateurs bornés ({0,10} plutôt que * sans limite partout). Pour reconnaître « tout texte jusqu’au prochain point », préférez un motif comme /[^.\n]{0,10}*\./ à /.+\./ pour éviter que la longueur du texte n’augmente de façon incontrôlée.
Utilisez les règles pour combiner les tokens, sans intervenir dans le fonctionnement des expressions régulières
Exemple d’utilisation appropriée des règles :
start: exprNUMBER: /[0-9]+/PLUS: "+"MINUS: "-"expr: term (("+"|"-") term)*term: NUMBER
Traitez explicitement les espaces blancs
Évitez les directives %ignore sans limite. Elles peuvent rendre la grammaire trop complexe ou amener le modèle à produire des sorties hors distribution, voire les deux. Insérez plutôt des terminaux explicites partout où les espaces blancs sont autorisés.
Résolution des problèmes
Si l’API rejette une grammaire trop complexe, simplifiez les règles et les terminaux, puis supprimez les directives %ignore sans limite.
Si les appels d’outils personnalisés contiennent des tokens inattendus, vérifiez que les terminaux ne se chevauchent pas et examinez les correspondances retenues par l’analyseur lexical.
Si le modèle produit des sorties « hors distribution » (excessivement longues ou répétitives, syntaxiquement valides mais sémantiquement incorrectes) :
Rendez la grammaire plus restrictive.
Affinez le prompt en ajoutant des exemples few-shot. Revoyez aussi la description de l’outil : expliquez la grammaire et demandez au modèle de raisonner et de s’y conformer.
Essayez un effort de raisonnement plus élevé, par exemple en passant d’un niveau moyen à un niveau élevé.
CFG avec expression régulière
Exemple de grammaire hors contexte avec une expression régulière
Python
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import OpenAI from "openai";const client = new OpenAI();const grammar = "^(?P<month>January|February|March|April|May|June|July|August|September|October|November|December)\\s+(?P<day>\\d{1,2})(?:st|nd|rd|th)?\\s+(?P<year>\\d{4})\\s+at\\s+(?P<hour>0?[1-9]|1[0-2])(?P<ampm>AM|PM)$";const response = await client.responses.create({ model: "gpt-6-astra", input: "Use the timestamp tool to save a timestamp for August 7th 2025 at 10AM.", tools: [ { type: "custom", name: "timestamp", description: "Saves a timestamp in date + time in 24-hr format.", format: { type: "grammar", syntax: "regex", definition: grammar, }, }, ],});console.log(response.output);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23from openai import OpenAIclient = OpenAI()grammar =r"^(?P<month>January|February|March|April|May|June|July|August|September|October|November|December)\s+(?P<day>\d{1,2})(?:st|nd|rd|th)?\s+(?P<year>\d{4})\s+at\s+(?P<hour>0?[1-9]|1[0-2])(?P<ampm>AM|PM)$"response = client.responses.create(model="gpt-6-astra",input="Use the timestamp tool to save a timestamp for August 7th 2025 at 10AM.",tools=[ {"type": "custom","name": "timestamp","description": "Saves a timestamp in date + time in 24-hr format.","format": {"type": "grammar","syntax": "regex","definition": grammar, }, } ],)print(response.output)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28package mainimport ( "context" "fmt" "github.com/openai/openai-go/v3" "github.com/openai/openai-go/v3/responses" "github.com/openai/openai-go/v3/shared")func main() { client := openai.NewClient() grammar := `^(?P<month>January|February|March|April|May|June|July|August|September|October|November|December)\s+(?P<day>\d{1,2})(?:st|nd|rd|th)?\s+(?P<year>\d{4})\s+at\s+(?P<hour>0?[1-9]|1[0-2])(?P<ampm>AM|PM)$` tool := responses.ToolParamOfCustom("timestamp") tool.OfCustom.Description = openai.String("Saves a timestamp in date and time format.") tool.OfCustom.Format = shared.CustomToolInputFormatParamOfGrammar(grammar, "regex") response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Input: responses.ResponseNewParamsInputUnion{OfString: openai.String("Use the timestamp tool to save a timestamp for August 7th 2025 at 10AM.")}, Tools: []responses.ToolUnionParam{tool}, }) if err != nil { panic(err) } fmt.Println(response.Output)}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27import com.openai.client.OpenAIClient;import com.openai.client.okhttp.OpenAIOkHttpClient;import com.openai.models.CustomToolInputFormat;import com.openai.models.responses.CustomTool;import com.openai.models.responses.ResponseCreateParams;String grammar = "^(January|February|March|April|May|June|July|August|September|October|November|December) " + "\\d{1,2}(st|nd|rd|th)? \\d{4} at (0?[1-9]|1[0-2])(AM|PM)$";ResponseCreateParams params = ResponseCreateParams.builder() .model("gpt-6-astra") .input("Use timestamp to save August 7th 2025 at 10AM.") .addTool( CustomTool.builder() .name("timestamp") .description("Saves a timestamp in date and time format.") .format( CustomToolInputFormat.Grammar.builder() .syntax(CustomToolInputFormat.Grammar.Syntax.REGEX) .definition(grammar) .build()) .build()) .build();client.responses().create(params).output().forEach(System.out::println);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22require "openai"client = OpenAI::Client.newgrammar = "^(January|February|March|April|May|June|July|August|September|October|November|December) \\d{1,2}(st|nd|rd|th)? \\d{4} at (0?[1-9]|1[0-2])(AM|PM)$"response = client.responses.create( model: "gpt-6-astra", input: "Use timestamp to save August 7th 2025 at 10AM.", tools: [ { type: :custom, name: "timestamp", description: "Saves a timestamp in date and time format.", format: { type: :grammar, syntax: :regex, definition: grammar } } ])puts(response.output)
La sortie obtenue pour l’outil devrait alors respecter la CFG que vous avez définie avec une expression régulière :
Certaines fonctionnalités des expressions régulières ne sont pas prises en charge :
Les assertions avant et arrière
Les quantificateurs non gourmands (*?, +?, ??)
Principes et bonnes pratiques
Le motif doit tenir sur une seule ligne
Pour reconnaître un saut de ligne dans l’entrée, utilisez la séquence d’échappement \n. N’utilisez pas le mode détaillé ou étendu, qui permet de répartir les motifs sur plusieurs lignes.
Fournissez le motif de l’expression régulière sous forme de chaîne simple