Découvrez comment gérer l’état d’une conversation lors des échanges avec un modèle.
Responses
OpenAI propose plusieurs façons de gérer l’état d’une conversation pour conserver les informations d’un message ou d’un tour de conversation à l’autre.
Si GPT-5.5 interprète un message d’étape comme la réponse finale, vérifiez que votre intégration conserve correctement le champ phase du message de l’assistant. Pour plus de détails, consultez la section Paramètre de phase.
Gérer manuellement l’état d’une conversation
Chaque requête de génération de texte est indépendante et sans état. Vous pouvez néanmoins mettre en place des conversations à plusieurs tours en transmettant des messages supplémentaires comme paramètres de la requête. Prenons l’exemple d’une blague qui commence par « Toc toc ! ».
En alternant les messages user et assistant, vous transmettez l’état précédent de la conversation au modèle en une seule requête.
Pour transmettre manuellement le contexte d’une réponse à l’autre, reprenez la sortie de la réponse précédente du modèle et ajoutez-la aux données d’entrée de votre prochaine requête.
Pour les requêtes sans état adressées à un modèle de raisonnement, conservez tous les éléments du tableau output de la réponse. Par défaut, l’API Responses renvoie les éléments de raisonnement sous forme chiffrée. Renvoyer l’intégralité de la sortie permet de conserver tels quels les éléments de raisonnement et les valeurs du champ phase des messages de l’assistant. Avec les modèles qui prennent en charge la persistance du raisonnement, vous pouvez utiliser reasoning.context: "all_turns" pour intégrer le raisonnement disponible des tours précédents à la génération suivante. Consultez la section Conserver le raisonnement d’un appel à l’autre.
Lorsque vous renvoyez des éléments de raisonnement, conservez l’historique de conversation à partir duquel le modèle les a produits. Pour comprendre comment les modifications de cet historique influent sur le raisonnement, consultez le guide Conserver le préfixe tel quel.
Dans l’exemple suivant, nous demandons au modèle de raconter une blague, puis de nous en raconter une autre. En ajoutant ainsi les réponses précédentes aux nouvelles requêtes, vous aidez le modèle à poursuivre la conversation de manière naturelle et à conserver le contexte des échanges précédents.
Gérer manuellement l’état d’une conversation avec l’API Chat Completions
API OpenAI pour la gestion de l’état des conversations
Nos API facilitent la gestion automatique de l’état d’une conversation et vous évitent de transmettre manuellement les entrées à chaque tour.
Nous vous recommandons plutôt d’utiliser l’API Responses. Comme elle conserve l’état, un seul paramètre suffit pour gérer le contexte d’une conversation à l’autre.
Si vous utilisez le point de terminaison Chat Completions, vous devez gérer l’état manuellement, comme indiqué plus haut.
Utiliser l’API Conversations
L’API Conversations fonctionne avec l’API Responses pour conserver l’état d’une conversation dans un objet persistant doté de son propre identifiant stable. Une fois l’objet de conversation créé, vous pouvez le réutiliser dans d’autres sessions, sur d’autres appareils ou pour d’autres tâches.
Une conversation peut stocker différents éléments, notamment des messages, des appels d’outils, les sorties de ces outils et d’autres données.
Dans un échange à plusieurs tours, transmettez conversation lors de la création des réponses suivantes pour conserver l’état et partager le contexte entre ces réponses. Vous évitez ainsi d’avoir à chaîner plusieurs éléments de réponse.
Gérer l’état d’une conversation avec les API Conversations et Responses
Python
1
2
3
4
5
6
7const response = await client.responses.create({ model: "gpt-6-astra", input: [{ role: "user", content: "What are the five Ds of dodgeball?" }], conversation: conversation.id,});console.log(response.output_text);
1
2
3
4
5response = openai.responses.create(model="gpt-6-astra",input=[{"role": "user", "content": "What are the 5 Ds of dodgeball?"}],conversation=conversation.id,)
1
2
3
4
5
6
7
8
9
10
11
12
13response, err := client.Responses.New(context.Background(), responses.ResponseNewParams{ Model: "gpt-6-astra", Conversation: responses.ResponseNewParamsConversationUnion{ OfString: openai.String(conversation.ID), }, Input: responses.ResponseNewParamsInputUnion{ OfString: openai.String("What are the five Ds of dodgeball?"), },})if err != nil { panic(err)}fmt.Println(response.OutputText())
1
2
3
4
5
6
7response = client.responses.create( model: "gpt-6-astra", conversation: conversation.id, input: "What are the five Ds of dodgeball?")puts(response.output_text)
Transmettre le contexte de la réponse précédente
Vous pouvez également gérer l’état d’une conversation en transmettant le contexte d’une réponse à l’autre à l’aide du paramètre previous_response_id. Ce paramètre permet de chaîner les réponses pour créer un fil de conversation.
Chaîner les réponses d’un tour à l’autre en transmettant l’identifiant de la réponse précédente
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18using OpenAI.Responses;#pragma warning disable OPENAI001string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;ResponsesClient client = new(key);ResponseResult first = await client.CreateResponseAsync( "gpt-6-astra", "Tell me a joke.");Console.WriteLine(first.GetOutputText());ResponseResult second = await client.CreateResponseAsync( "gpt-6-astra", "Explain why this is funny.", previousResponseId: first.Id);Console.WriteLine(second.GetOutputText());
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16require "openai"client = OpenAI::Client.newfirst = client.responses.create( model: "gpt-6-astra", input: "Tell me a joke.")puts(first.output_text)second = client.responses.create( model: "gpt-6-astra", previous_response_id: first.id, input: "Explain why this is funny.")puts(second.output_text)
previous_response_id en mode WebSocket
Si vous utilisez le mode WebSocket de l’API Responses, previous_response_id permet de poursuivre la conversation selon les mêmes règles qu’en mode HTTP. Les échanges se font sur une connexion persistante au moyen d’événements response.create successifs.
Le cache propre à la connexion garde les réponses récentes en mémoire pour permettre une reprise à faible latence. Lorsque vous utilisez stream_id, chaque flux peut conserver sa dernière réponse. Le paramètre previous_response_id détermine toujours de quelle réponse découle la suivante. Un nouveau flux peut donc partir d’une réponse d’un autre flux tant que cette réponse reste disponible. Si l’identifiant est absent du cache et que l’API ne retrouve pas la réponse correspondante, envoyez un nouveau tour en définissant previous_response_id sur null et en transmettant tout le contexte en entrée.
Par défaut, les objets de réponse sont conservés pendant 30 jours. Vous pouvez les consulter sur la page des journaux du tableau de bord ou les récupérer via l’API. Pour désactiver cette conservation, définissez store sur false lors de la création d’une réponse.
La durée de conservation de 30 jours ne s’applique ni aux objets de conversation ni aux éléments qu’ils contiennent. Lorsque vous rattachez une réponse à une conversation, ses éléments sont conservés sans cette limite de 30 jours.
OpenAI n’utilise pas les données envoyées via l’API pour entraîner ses modèles sans votre consentement explicite. En savoir plus.
Même si vous utilisez previous_response_id, l’API facture comme tokens d’entrée tous les tokens d’entrée des réponses précédentes de la chaîne.
Gérer la fenêtre de contexte
Comprendre le fonctionnement des fenêtres de contexte vous aidera à créer des fils de conversation et à gérer l’état d’un échange à l’autre avec le modèle.
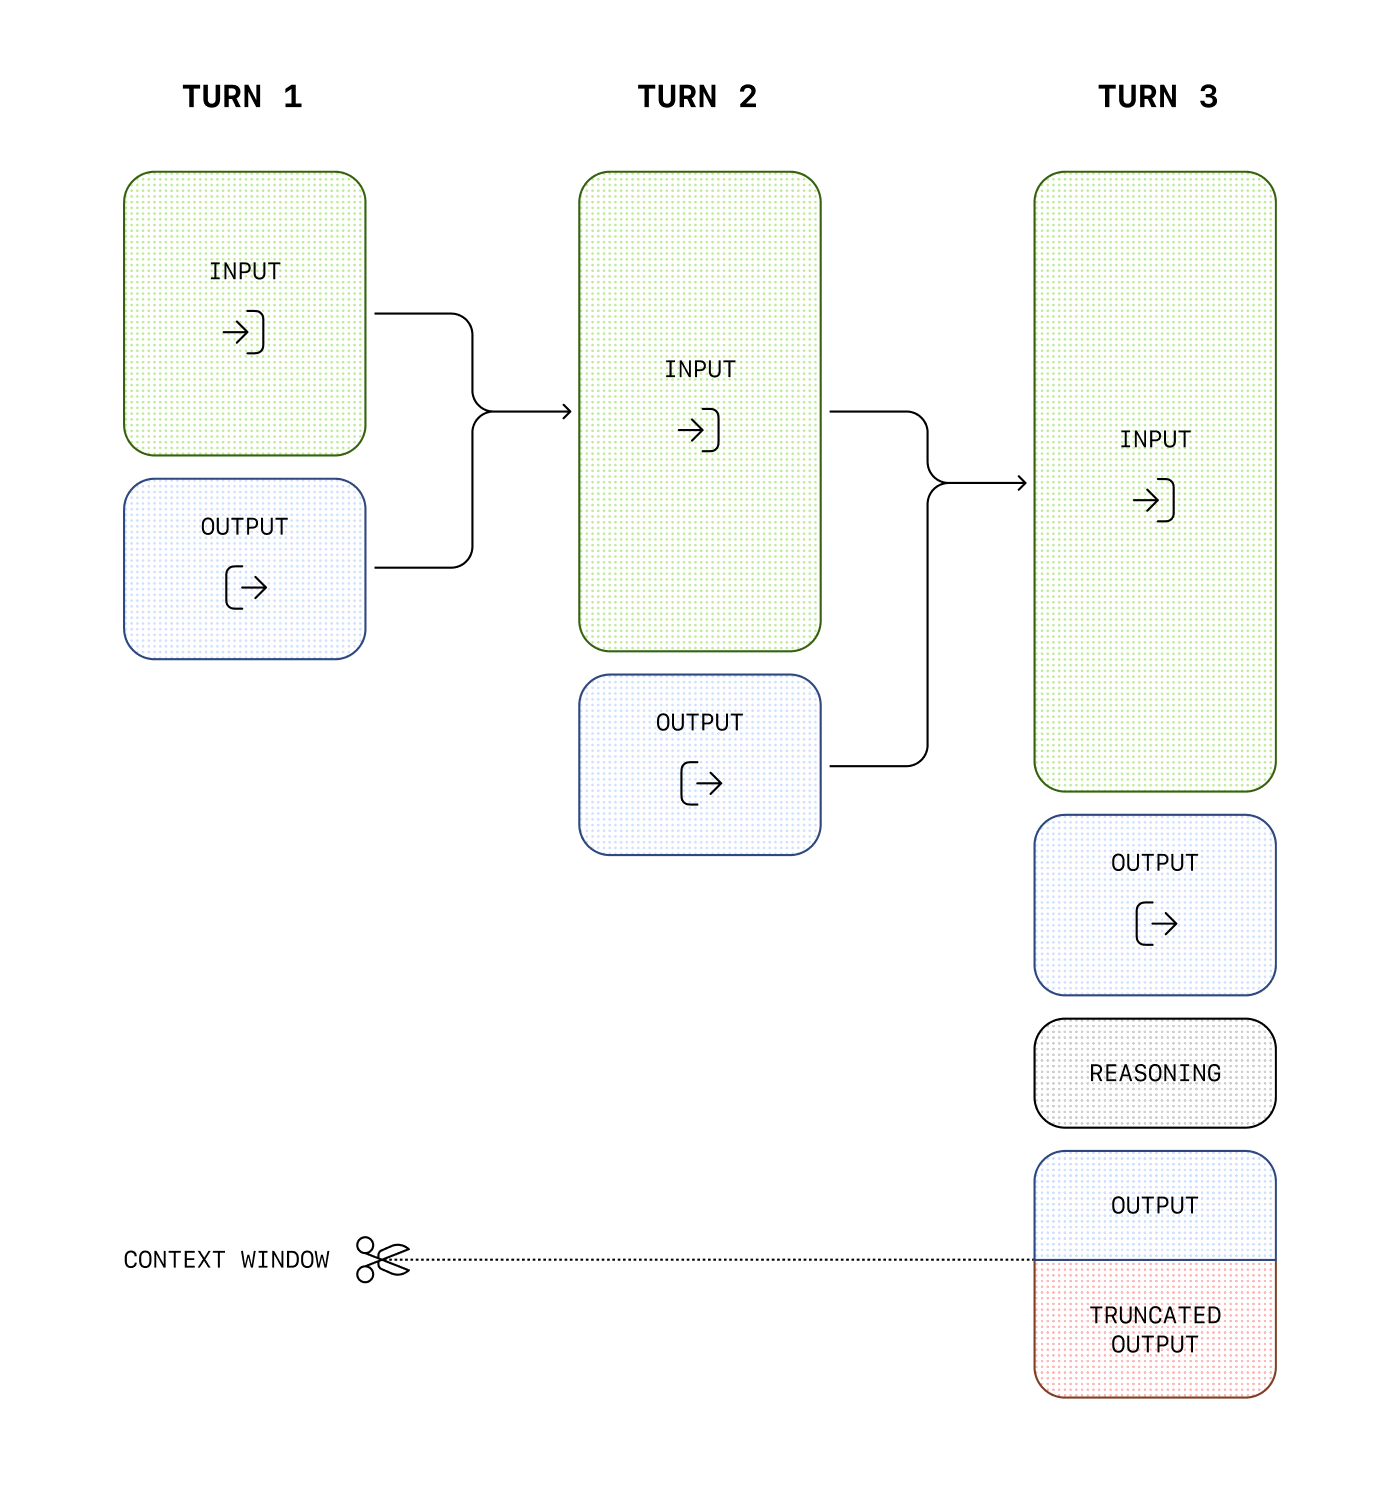
La fenêtre de contexte correspond au nombre maximal de tokens utilisables dans une seule requête. Ce total comprend les tokens d’entrée, de sortie et de raisonnement. Pour connaître la taille de la fenêtre de contexte de votre modèle, consultez les caractéristiques des modèles.
Gérer le contexte pour la génération de texte
À mesure que vos entrées se complexifient ou que la conversation s’allonge, tenez compte à la fois de la limite de tokens de sortie et de la taille de la fenêtre de contexte. Les entrées et les sorties des modèles se mesurent en tokens. Le modèle analyse les entrées en les décomposant en tokens pour en comprendre le contenu et l’intention, puis assemble des tokens pour produire une sortie cohérente. Chaque modèle impose des limites au nombre de tokens utilisables au cours d’une requête de génération de texte.
Les tokens de sortie sont les tokens que le modèle génère en réponse à un prompt. Les limites de tokens de sortie varient selon le modèle. Par exemple, gpt-4o-2024-08-06 peut générer jusqu’à 16 384 tokens de sortie.
La fenêtre de contexte fixe une limite commune aux tokens d’entrée et de sortie (et, pour certains modèles, aux tokens de raisonnement). Comparez les tailles des fenêtres de contexte de nos modèles. Par exemple, gpt-4o-2024-08-06 dispose d’une fenêtre de contexte de 128 000 tokens au total.
Un prompt volumineux, par exemple si vous ajoutez du contexte, des données ou des exemples pour le modèle, risque de dépasser la taille de sa fenêtre de contexte. Les sorties peuvent alors être tronquées.
Par exemple, si vous envoyez une requête à Chat Completions avec le modèle o1, les tokens suivants comptent dans le total de la fenêtre de contexte :
Tokens d’entrée (les entrées que vous incluez dans le tableau messages avec Chat Completions)
Tokens de sortie (les tokens générés en réponse à votre prompt)
Tokens de raisonnement (les tokens utilisés par le modèle pour préparer sa réponse)
Par exemple, si vous envoyez une requête à l’API Responses avec un modèle doté de capacités de raisonnement, comme le modèle o1, les tokens suivants comptent dans le total de la fenêtre de contexte :
Tokens d’entrée (les entrées que vous incluez dans le tableau input pour l’API Responses)
Tokens de sortie (les tokens générés en réponse à votre prompt)
Tokens de raisonnement (les tokens utilisés par le modèle pour préparer sa réponse)
Si le nombre de tokens générés dépasse la limite de la fenêtre de contexte, l’API peut tronquer la réponse.
Vous pouvez estimer le nombre de tokens que vos messages utiliseront avec l’outil de tokenisation.
Compactage
Les instructions détaillées sur le compactage figurent désormais dans le guide Compactage.
Pour utiliser /responses avec context_management et compact_threshold, consultez la section Compactage côté serveur.
Pour découvrir des exemples plus précis et des cas d’usage, consultez l’OpenAI Cookbook. Les guides suivants expliquent comment utiliser les API pour étendre les capacités des modèles :