
Vue d’ensemble
En mode multi-agent, un modèle peut lancer et coordonner des sous-agents qui travaillent en parallèle, puis synthétiser leurs résultats pour fournir une réponse finale. Ce mode est particulièrement efficace pour les applications qui traitent des tâches complexes dont certaines parties peuvent être déléguées et menées en parallèle, par exemple pour explorer du code source, rédiger de la documentation ou implémenter des fonctionnalités.
Le mode multi-agent est disponible en bêta avec GPT-6.1 Sol et tous les modèles GPT-5.6. Consultez la page du modèle avant d’activer ce mode dans votre application.
Quand utiliser le mode multi-agent
Une tâche se décompose souvent en plusieurs parties indépendantes. Un agent seul les traiterait l’une après l’autre, alors que plusieurs agents peuvent s’en charger en parallèle. En mode multi-agent, l’agent racine peut confier ces tâches à plusieurs sous-agents qui les exécutent simultanément. Cette approche présente plusieurs avantages :
- Exécution parallèle. Des tâches indépendantes de recherche, d’analyse ou d’implémentation peuvent avancer simultanément, ce qui peut réduire la durée d’exécution.
- Contexte ciblé. Chaque sous-agent reçoit une tâche bien délimitée et conserve son propre contexte. Les informations relatives à des tâches distinctes interfèrent ainsi moins entre elles, ce qui améliore les performances.
- Coordination par le modèle. L’agent racine peut créer des sous-agents, leur transmettre des informations complémentaires, attendre leurs résultats et en tirer une réponse finale. Votre application n’a pas besoin d’implémenter cette orchestration.
L’orchestration multi-agent est particulièrement utile lorsqu’une tâche peut être divisée en travaux concrets et indépendants, par exemple pour :
- Explorer différentes parties d’une vaste base de code
- Comparer plusieurs propositions, documents ou hypothèses
- Effectuer des recherches dans plusieurs sources en parallèle
- Implémenter des composants indépendants ou écrire des suites de tests indépendantes
- Examiner en parallèle plusieurs causes possibles d’une défaillance
- Explorer simultanément différentes approches pour résoudre un problème
L’ajout de sous-agents peut augmenter la consommation de tokens. Son intérêt peut être moindre si la tâche suit un raisonnement dont les étapes doivent s’enchaîner dans un ordre précis, nécessite des écritures fréquentes dans un état partagé modifiable ou prend du temps principalement à cause d’une seule opération externe lente.
| Utilisez le mode multi-agent lorsque… | Privilégiez un seul agent lorsque… |
|---|---|
| Le travail peut être réparti en tâches indépendantes et bien délimitées | Chaque étape dépend directement de la précédente |
| Des contextes séparés aident chaque agent à se concentrer sur sa tâche | Une seule exécution de courte durée suffit pour accomplir la tâche |
| Une exploration en parallèle peut réduire la durée totale | Les agents risquent d’entrer en concurrence pour modifier la même ressource |
| Comparer des résultats obtenus indépendamment permet de couvrir davantage d’aspects | Vous avez besoin d’un graphe d’exécution fixe et déterministe |
Démarrage rapide
Les exemples Python et JavaScript utilisent le SDK Responses en bêta. Pour les requêtes HTTP, utilisez client.beta.responses et transmettez responses_multi_agent=v1 dans l’argument betas. Pour les requêtes HTTP brutes et les connexions WebSocket, transmettez OpenAI-Beta: responses_multi_agent=v1 dans les en-têtes de la requête ou de la connexion. Les schémas des éléments peuvent évoluer tant que le mode multi-agent est en bêta.
Activez le mode multi-agent dans votre requête à l’API Responses avec multi_agent.enabled. Lorsque multi_agent.enabled vaut true, l’agent racine peut créer une arborescence de sous-agents. Les sous-agents utilisent le même modèle et les mêmes outils que ceux prévus dans la requête. Les agents se coordonnent grâce à des opérations de collaboration qui leur permettent notamment de créer des sous-agents, d’échanger des messages et d’attendre des résultats (voir Fonctionnement du mode multi-agent). L’agent racine synthétise les réponses des sous-agents et fournit la réponse finale.
from openai import OpenAI
client = OpenAI()
def review_pull_request(diff: str) -> str:
response = client.beta.responses.create(
model="gpt-6.1-sol",
input=(
"Review the pull-request diff below with three agents: one for "
"correctness, one for security, and one for missing tests. "
"Reconcile duplicate or conflicting findings, then return a "
"prioritized review with file and line references.\n\n"
f"<diff>\n{diff}\n</diff>"
),
multi_agent={
"enabled": True,
"max_concurrent_subagents": 3,
},
betas=["responses_multi_agent=v1"],
)
return "".join(
part.text
for item in response.output
if (
item.type == "message"
and item.agent is not None
and item.agent.agent_name == "/root"
and item.phase == "final_answer"
)
for part in item.content
if part.type == "output_text"
)max_concurrent_subagents définit le nombre maximal de sous-agents pouvant être actifs simultanément dans toute l’arborescence. Ce décompte inclut tous les descendants, des enfants directs aux sous-agents des niveaux les plus profonds, mais exclut l’agent racine.
L’API n’impose aucune limite supérieure fixe à ce paramètre. Sa valeur par défaut est 3, la valeur recommandée pour la plupart des charges de travail. Le mode multi-agent n’impose pas non plus de limite fixe à la profondeur de l’arborescence ni au nombre total de sous-agents créés au cours d’une exécution.
Ajoutez un message développeur pour préciser dans quels cas le modèle de l’agent racine doit lancer des sous-agents. Ce message complète les instructions injectées pour l’agent racine et les sous-agents.
Exemples de messages développeur :
- « Ne lancez de sous-agents que si l’utilisateur demande explicitement de faire appel à des sous-agents, de déléguer des tâches ou de faire travailler plusieurs agents en parallèle. »
- « La délégation proactive en mode multi-agent est activée. Faites appel à des sous-agents lorsque le travail en parallèle permettrait de gagner sensiblement en rapidité ou en qualité. »
Fonctionnement du mode multi-agent
L’API Responses met à la disposition des modèles de l’agent racine et des sous-agents des actions d’orchestration hébergées, ainsi que les instructions pour les utiliser. L’agent racine se nomme /root. Les sous-agents créés ont des chemins hiérarchiques comme ceux-ci :
/root
├── /root/researcher
├── /root/reviewer
└── /root/reviewer/tester
Le mode multi-agent n’impose aucune limite fixe au nombre total de sous-agents ni à la profondeur de l’arborescence. Pour la plupart des tâches, conservez la valeur par défaut de max_concurrent_subagents, soit 3. Ce paramètre limite le nombre de tours de sous-agents actifs simultanément dans toute l’arborescence, enfants directs et descendants plus éloignés compris.
Lorsque le mode multi-agent est activé, l’API Responses fournit six actions de collaboration hébergées. Elles peuvent apparaître sous forme d’éléments multi_agent_call. Votre application ne doit ni les exécuter ni transmettre de résultats pour ces actions.
| Action | Rôle |
|---|---|
spawn_agent |
Crée un sous-agent et lui attribue sa première tâche. |
send_message |
Place un message dans la file d’attente d’un agent existant sans démarrer de nouveau tour. |
followup_task |
Confie du travail supplémentaire à un agent existant autre que l’agent racine et démarre ou reprend son tour. |
wait_agent |
Attend qu’une mise à jour arrive dans la boîte de réception de l’agent appelant. |
interrupt_agent |
Interrompt le tour en cours d’un autre agent sans supprimer son contexte. |
list_agents |
Renvoie l’arborescence actuelle des agents, leur état et le last_task_message de chacun. |
Les appels aux outils définis par le développeur se traitent de la même façon que lorsque le mode multi-agent est désactivé. Tout agent de l’arborescence peut émettre un function_call. Votre application doit exécuter l’appel et transmettre le function_call_output correspondant.
Tous les agents de l’arborescence ont accès aux outils configurés pour l’appel au modèle dans la requête API.
Utilisation du mode multi-agent dans l’API Responses
Performances de HTTP et de WebSocket
HTTP et WebSocket offrent les mêmes fonctionnalités en mode multi-agent. WebSocket est toutefois recommandé pour les workflows de longue durée ou qui font souvent appel à des outils. Grâce à sa connexion persistante, votre application peut renvoyer les résultats des fonctions dès qu’ils sont disponibles, ce qui réduit le coût de reprise de l’exécution et le temps d’attente des agents.
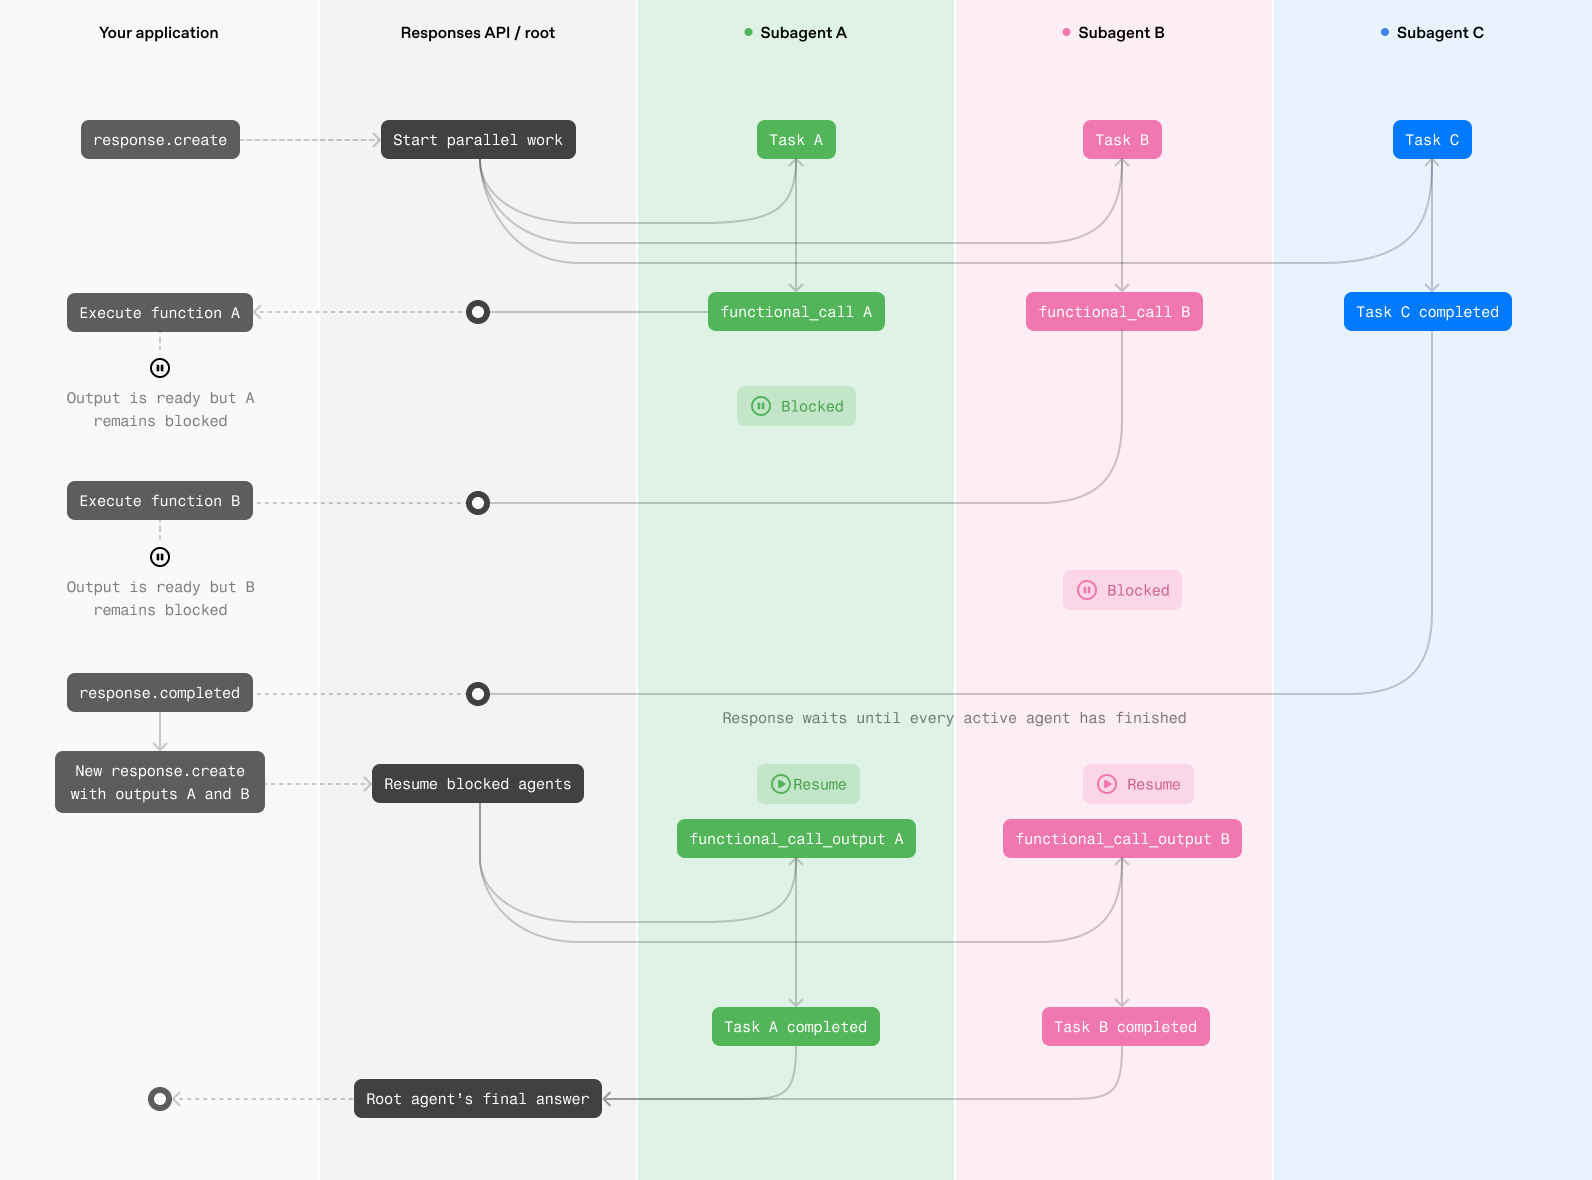
Avec HTTP, la réponse se termine une fois que chaque agent actif a fini son travail ou s’est mis en pause dans l’attente du résultat d’un appel de fonction exécuté côté client. Votre application exécute alors tous les appels de fonction en attente et transmet leurs résultats dans une nouvelle requête à l’API Responses. Les agents en pause peuvent ainsi reprendre leur travail.
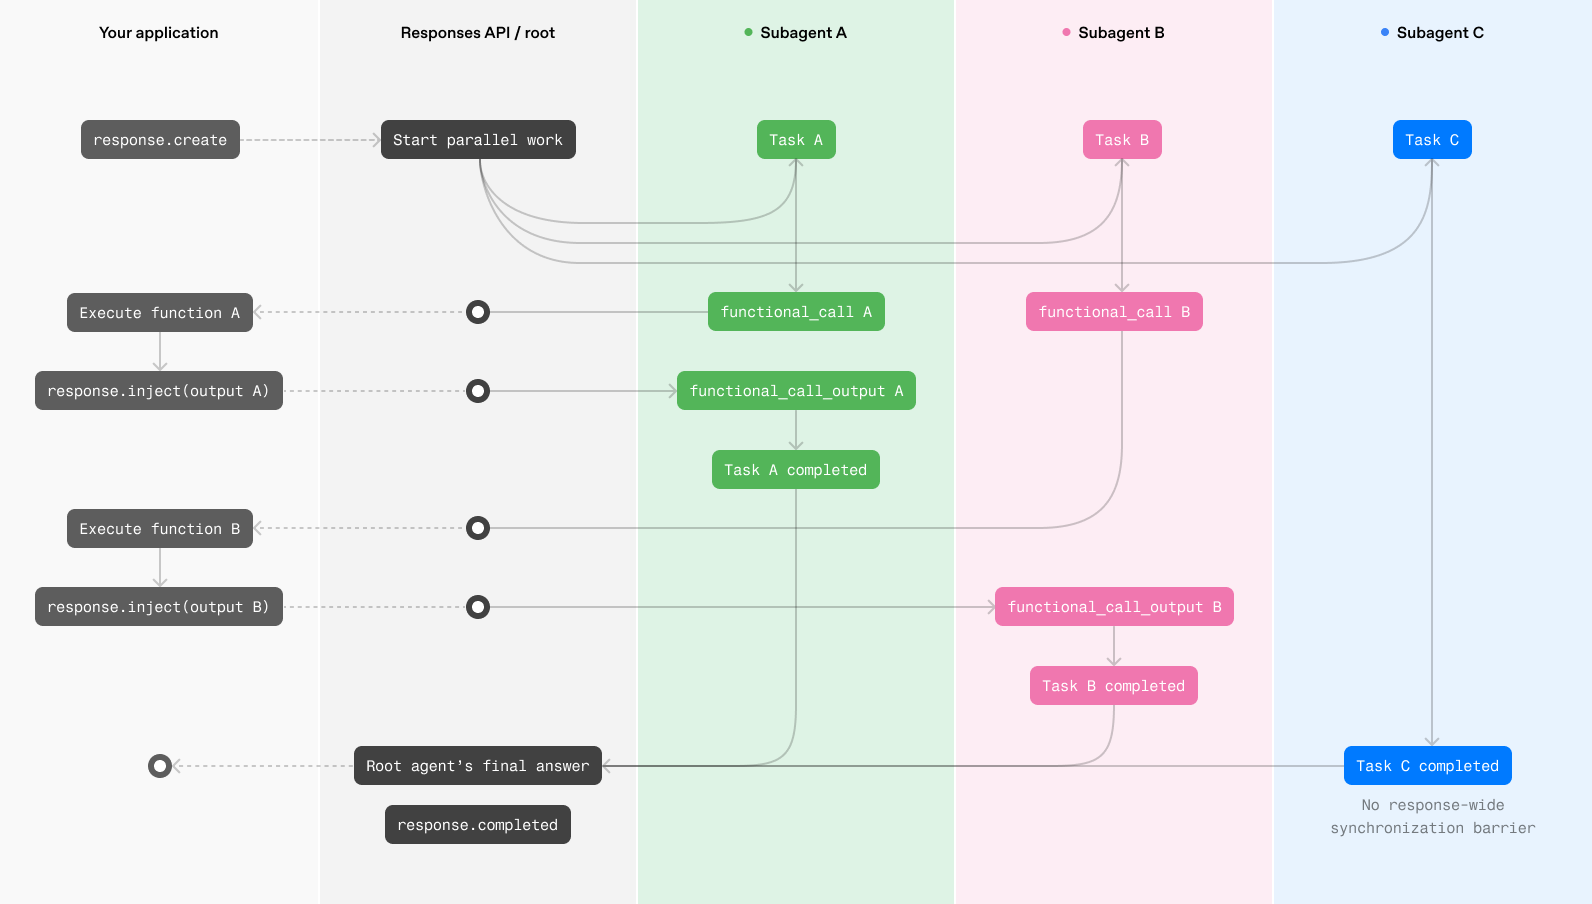
Avec WebSocket, votre application peut injecter chaque résultat de fonction dans la réponse dès qu’il est disponible, sans attendre la fin de la réponse en cours. L’agent en attente peut reprendre immédiatement, pendant que les autres poursuivent leur travail. Cela réduit les délais de coordination et évite des allers-retours supplémentaires lorsque les agents terminent leurs tâches ou demandent des outils à des moments différents.
HTTP peut suffire pour les workflows qui font appel à plusieurs outils hébergés, par exemple pour mener des recherches web en parallèle, ou pour ceux qui tiennent en une seule requête avec peu d’appels de fonction. Pour la plupart des workflows multi-agents, WebSocket devrait offrir une latence plus faible et de meilleures performances de bout en bout.
Exécution des appels de fonction avec HTTP
Exécution des appels de fonction avec WebSocket
HTTP
Ces exemples nécessitent une version bêta du SDK qui donne accès à l’API Responses en bêta. Pour recevoir la réponse en streaming via HTTP, appelez client.beta.responses.create et transmettez responses_multi_agent=v1 dans l’argument betas. Vous bénéficiez ainsi des types de la bêta et de l’autocomplétion. En Python, importez les types des éléments de réponse de la bêta depuis openai.types.beta lorsque vous ajoutez des annotations de type.
Exemple de code côté client :
from __future__ import annotations
import json
import sys
from openai import OpenAI
from openai.types.beta import BetaResponseOutputItem
client = OpenAI()
ROOT = "/root"
PROPOSALS = {
"alpha": {"estimated_weeks": 6, "risk": "medium"},
"beta": {"estimated_weeks": 8, "risk": "low"},
}
tools = [
{
"type": "function",
"name": "get_proposal",
"description": "Return details for a proposal that the agents should compare.",
"parameters": {
"type": "object",
"properties": {
"proposal": {
"type": "string",
"enum": ["alpha", "beta"],
}
},
"required": ["proposal"],
"additionalProperties": False,
},
"strict": True,
}
]
history = [
{
"role": "user",
"content": (
"Use two subagents, one for proposal alpha and one for proposal beta. "
"Have each call get_proposal, then compare their findings."
),
}
]
def agent_name(item: BetaResponseOutputItem) -> str:
return item.agent.agent_name if item.agent else ROOT
def render_to_user(delta: str) -> None:
print(delta, end="", flush=True)
def log_subagent_text(agent: str, delta: str) -> None:
print(f"[{agent}] {delta}", end="", file=sys.stderr, flush=True)
def process_tool_call(name: str, arguments: str) -> str:
if name != "get_proposal":
raise ValueError(f"Unknown tool: {name}")
parsed_arguments = json.loads(arguments)
return json.dumps(PROPOSALS[parsed_arguments["proposal"]])
while True:
output_items = []
pending_calls = []
item_agents: dict[int, str] = {}
stream = client.beta.responses.create(
model="gpt-6.1-sol",
input=history,
tools=tools,
store=False,
multi_agent={
"enabled": True,
"max_concurrent_subagents": 3,
},
stream=True,
betas=["responses_multi_agent=v1"],
)
for event in stream:
if event.type == "response.output_item.added":
item_agents[event.output_index] = agent_name(event.item)
elif event.type == "response.output_text.delta":
agent = item_agents.get(event.output_index, ROOT)
if agent == ROOT:
render_to_user(event.delta)
else:
log_subagent_text(agent, event.delta)
elif event.type == "response.output_item.done":
output_items.append(event.item)
if event.item.type == "function_call":
# Handle function calls from both the root agent and subagents.
pending_calls.append(event.item)
elif event.type == "response.completed":
print(f"\nUsage: {event.response.usage}", file=sys.stderr)
break
elif event.type in {
"error",
"response.failed",
"response.incomplete",
}:
raise RuntimeError(event)
history.extend(output_items)
for call in pending_calls:
history.append(
{
"type": "function_call_output",
"call_id": call.call_id,
"output": process_tool_call(call.name, call.arguments),
}
)
if not pending_calls:
breakSi un ou plusieurs agents appellent des fonctions définies par le développeur, exécutez chaque appel en attente et créez une requête de continuation contenant tous les résultats.
WebSocket
En mode WebSocket, lorsqu’un agent appelle une fonction définie par le développeur, exécutez la fonction dans votre application et envoyez son résultat à la réponse en cours au moyen d’un événement response.inject. L’agent en attente peut alors reprendre son travail sans attendre la fin de la réponse multi-agent dans son ensemble.
{
"type": "response.inject",
"response_id": "resp_123",
"input": [
{
"type": "function_call_output",
"call_id": "call_123",
"output": "{\"temperature\":72}"
}
]
}Pour une requête response.inject valide, le serveur renvoie l’un des deux événements suivants :
response.inject.created: le serveur a validé l’entrée et accepté son injection.response.inject.failed: le serveur n’a pas injecté l’entrée. Consultezerror.code.
{
"type": "response.inject.created",
"sequence_number": 42,
"response_id": "resp_123"
}{
"type": "response.inject.failed",
"sequence_number": 43,
"response_id": "resp_123",
"input": [
{
"type": "function_call_output",
"call_id": "call_123",
"output": "{\"temperature\":72}"
}
],
"error": {
"code": "response_already_completed",
"message": "Response 'resp_123' has already completed."
}
}Si une requête ne respecte pas le schéma response.inject, le serveur renvoie une erreur générique avec le code d’état 400 et ferme la connexion WebSocket. Corrigez la requête et ouvrez une nouvelle connexion WebSocket avant d’envoyer un autre événement.
Le SDK Python en bêta donne accès au mode WebSocket via client.beta.responses.connect. Dans le SDK TypeScript en bêta, utilisez ResponsesWS. Transmettez OpenAI-Beta: responses_multi_agent=v1 dans les en-têtes de connexion. Contrairement au streaming HTTP, les connecteurs WebSocket n’acceptent pas encore l’argument betas.
Conservez l’identifiant de réponse reçu dans l’événement response.created et incluez-le dans chaque événement response.inject que vous envoyez pour cette réponse. Après avoir envoyé un élément à injecter, continuez à lire les événements sur la connexion WebSocket jusqu’à ce que la réponse soit terminée et que chaque injection ait produit un événement response.inject.created ou response.inject.failed.
from __future__ import annotations
import json
from openai import OpenAI
client = OpenAI()
PROPOSALS = {
"alpha": {"estimated_weeks": 6, "risk": "medium"},
"beta": {"estimated_weeks": 8, "risk": "low"},
}
tools = [
{
"type": "function",
"name": "get_proposal",
"description": "Return details for a proposal that the agents should compare.",
"parameters": {
"type": "object",
"properties": {
"proposal": {
"type": "string",
"enum": ["alpha", "beta"],
}
},
"required": ["proposal"],
"additionalProperties": False,
},
"strict": True,
}
]
def process_tool_call(name: str, arguments: str) -> str:
if name != "get_proposal":
raise ValueError(f"Unknown tool: {name}")
parsed_arguments = json.loads(arguments)
return json.dumps(PROPOSALS[parsed_arguments["proposal"]])
def run_multi_agent(connection):
previous_response_id: str | None = None
pending_input: list[dict[str, object]] = [{"role": "user", "content": input()}]
while pending_input:
request = {
"type": "response.create",
"model": "gpt-6.1-sol",
"store": True,
"multi_agent": {"enabled": True},
"tools": tools,
"input": pending_input,
}
if previous_response_id is not None:
request["previous_response_id"] = previous_response_id
connection.send(request)
next_input: list[dict[str, object]] = []
completed_response = None
response_id: str | None = None
pending_injections = 0
for event in connection:
event_type = event.type
if event_type == "response.created":
response_id = event.response.id
elif event_type == "response.output_item.done":
item = event.item
if item.type == "function_call":
if response_id is None:
raise RuntimeError(
"Received a function call before response.created"
)
output = {
"type": "function_call_output",
"call_id": item.call_id,
"output": process_tool_call(item.name, item.arguments),
}
pending_injections += 1
connection.send(
{
"type": "response.inject",
"response_id": response_id,
"input": [output],
}
)
elif event_type == "response.inject.created":
pending_injections -= 1
elif event_type == "response.inject.failed":
pending_injections -= 1
if event.error.code != "response_already_completed":
raise RuntimeError(event.error)
next_input.extend(item.model_dump(mode="json") for item in event.input)
elif event_type == "response.completed":
completed_response = event.response
elif event_type in {
"error",
"response.failed",
"response.incomplete",
}:
raise RuntimeError(event)
if completed_response is not None and pending_injections == 0:
break
if completed_response is None:
raise RuntimeError("Connection ended before response.completed")
if pending_injections:
raise RuntimeError("Connection ended with unacknowledged tool results")
if not next_input:
return completed_response
previous_response_id = completed_response.id
pending_input = next_input
with client.beta.responses.connect(
extra_headers={"OpenAI-Beta": "responses_multi_agent=v1"},
) as connection:
response = run_multi_agent(connection)
print(
"".join(
part.text
for item in response.output
if (
item.type == "message"
and item.agent is not None
and item.agent.agent_name == "/root"
and item.phase == "final_answer"
)
for part in item.content
if part.type == "output_text"
)
)Après avoir envoyé un événement response.inject, continuez à lire les événements sur la connexion WebSocket et traitez l’accusé de réception :
response.inject.created: le résultat de la fonction a été ajouté à la réponse en cours. Continuez à lire les événements associés à cette réponse.response.inject.failedavecresponse_already_completed: la réponse s’est terminée avant que le résultat de la fonction puisse y être ajouté. Récupérez la valeur deinputrenvoyée dans l’événement d’échec et transmettez-la dans une nouvelle requêteresponse.createqui poursuit l’exécution à partir de la réponse terminée.response.inject.failedavecresponse_not_found: le serveur n’a pas trouvé la réponse correspondant àresponse_id. Vérifiez que vous utilisez l’identifiant reçu dansresponse.created.
Une seule exécution en mode multi-agent peut s’étendre sur plusieurs requêtes à l’API Responses. Avec HTTP, lorsqu’un agent appelle une fonction définie par le développeur, votre application exécute la fonction et transmet son résultat dans un nouvel appel response.create. Avec WebSocket, votre application injecte directement le résultat de la fonction dans la réponse en cours.
Nouveaux éléments de sortie du mode multi-agent
Les réponses en mode multi-agent peuvent inclure trois types d’éléments de sortie supplémentaires :
multi_agent_call: consigne une action multi-agent hébergée, telle quespawn_agent.multi_agent_call_output: contient le résultat de l’exécution d’une action hébergée.agent_message: transmet un message chiffré d’un agent à un autre.
Le champ call_id relie chaque multi_agent_call au multi_agent_call_output correspondant.
Chaque élément comprend également un attribut agent. Pour un élément agent_message, agent.agent_name identifie l’agent destinataire. Utilisez author et recipient pour savoir qui a envoyé le message et à qui.
Lorsque votre application reçoit un multi_agent_call, ne l’exécutez pas comme un appel de fonction et ne renvoyez aucun résultat. L’API Responses exécute l’action hébergée et renvoie le multi_agent_call_output correspondant. Conservez les deux éléments si votre application en a besoin pour rejouer ou tracer l’exécution.
[
{
"type": "multi_agent_call",
"id": "mac_123",
"call_id": "call_spawn_a",
"action": "spawn_agent",
"arguments": "{\"task_name\":\"agent_a\",\"fork_turns\":\"all\",\"message\":\"enc_...\"}",
"agent": { "agent_name": "/root" }
},
{
"type": "multi_agent_call_output",
"id": "maco_123",
"call_id": "call_spawn_a",
"action": "spawn_agent",
"output": [
{
"type": "output_text",
"text": "{\"task_name\":\"/root/agent_a\"}",
"annotations": [],
"logprobs": []
}
],
"agent": { "agent_name": "/root" }
},
{
"type": "agent_message",
"id": "amsg_123",
"author": "/root/agent_a",
"recipient": "/root",
"content": [
{
"type": "encrypted_content",
"encrypted_content": "enc_..."
}
],
"agent": { "agent_name": "/root" }
}
]Les événements SSE attribués à un agent comportent un attribut agent au premier niveau. Pour un événement agent_message, agent.agent_name identifie l’agent destinataire. Les événements du cycle de vie de la réponse, tels que response.created et response.completed, décrivent la réponse dans son ensemble. Ils ne se rapportent donc à aucun agent en particulier et ne comportent pas d’attribut agent.
{
"type": "response.output_item.done",
"agent": { "agent_name": "/root" },
"item": {
"type": "agent_message",
"id": "amsg_123",
"author": "/root/agent_a",
"recipient": "/root",
"content": [
{
"type": "encrypted_content",
"encrypted_content": "enc_..."
}
],
"agent": { "agent_name": "/root" }
}
}Limites
- Compactage :
- Le point de terminaison
/responses/compactn’est pas pris en charge en mode multi-agent. - Lorsque
multi_agent.enabledvauttrue, le compactage automatique côté serveur est activé implicitement, même si la requête ne définit pascontext_management. Le compactage s’applique séparément à l’agent racine et à chaque sous-agent, ce qui préserve leurs contextes respectifs. Vous pouvez toujours remplacer la valeur decompact_thresholden définissant explicitementcontext_management.compact_thresholddans la requête.
- Le point de terminaison
reasoning.summaryn’est pas pris en charge en mode multi-agent.max_tool_callsn’est pas pris en charge en mode multi-agent.max_concurrent_subagentsvaut par défaut3, la valeur recommandée.
Conseils de rédaction des prompts
Lorsque le mode multi-agent est activé, nos systèmes ajoutent automatiquement les instructions suivantes à celles de l’agent racine et des sous-agents, sous la forme d’un nouveau message développeur. Vous ne pouvez ni modifier ni supprimer ces instructions. Rédigez vos instructions développeur de façon à compléter celles qui sont injectées automatiquement.
Agent racine
You are `/root`, the primary agent in a team of agents collaborating to fulfill the user's goals.

At the start of your turn, you are the active agent.
You can spawn sub-agents to handle subtasks, and those sub-agents can spawn their own sub-agents.
All agents in the team, including the agents that you can assign tasks to, are equally intelligent and capable, and have access to the same set of tools.

You can use `spawn_agent` to create a new agent, `followup_task` to give an existing agent a new task and trigger a turn, and `send_message` to pass a message to a running agent without triggering a turn.
Child agents can also spawn their own sub-agents.
You can decide how much context you want to propagate to your sub-agents with the `fork_turns` parameter.

You will receive messages in the form:
```
Message Type: MESSAGE | FINAL_ANSWER
Task name: <recipient>
Sender: <author>
Payload:
<payload text>
```
They may be addressed as to=/root

There are {max_concurrent_subagents + 1} available concurrency slots, meaning that up to {max_concurrent_subagents + 1} agents can be active at once, including you.
Sous-agent
You are an agent in a team of agents collaborating to complete a task.

You can spawn sub-agents to handle subtasks, and those sub-agents can spawn their own sub-agents. All agents in the team, including the agents that you can assign tasks to, are equally intelligent and capable, and have access to the same set of tools.

You can use `spawn_agent` to create a new agent, `followup_task` to give an existing agent a new task and trigger a turn, and `send_message` to pass a message to a running agent.
Child agents can also spawn their own sub-agents.

When you provide a response in the final channel, that content is immediately delivered back to your parent agent.

You will receive messages in the form:
```
Message Type: NEW_TASK | MESSAGE | FINAL_ANSWER
Task name: <recipient>
Sender: <author>
Payload:
<payload text>
```
You may also see them addressed as to=/root/..., which indicates your identity is /root/...

There are {max_concurrent_subagents + 1} available concurrency slots, meaning that up to {max_concurrent_subagents + 1} agents can be active at once, including you.