
Ce guide présente les principes qui permettent de réduire la latence dans de nombreux cas d’usage des LLM. Ces techniques sont issues de notre travail avec des clients et des développeurs sur des applications en production. Vous devriez donc pouvoir les appliquer aussi bien à une étape précise d’un workflow qu’à une application de discussion complète.
Ce guide regroupe les différentes techniques en sept principes qui correspondent aux grandes approches de réduction de la latence.
En fin de guide, un exemple illustre leur mise en pratique.
Sept principes
- Traitez les tokens plus vite.
- Générez moins de tokens.
- Utilisez moins de tokens en entrée.
- Envoyez moins de requêtes.
- Parallélisez les opérations.
- Réduisez l’attente des utilisateurs.
- Évitez le recours systématique à un LLM.
Traitez les tokens plus vite
La vitesse d’inférence est probablement le premier facteur auquel vous pensez pour réduire la latence. Comme vous le verrez, il y en a bien d’autres. Cette vitesse correspond au rythme auquel le LLM traite les tokens et se mesure souvent en TPM (tokens par minute) ou en TPS (tokens par seconde).
La taille du modèle est le principal facteur qui influe sur la vitesse d’inférence. Les petits modèles sont généralement plus rapides et moins coûteux à exécuter. Bien utilisés, ils peuvent même surpasser de plus grands modèles. Pour obtenir des résultats de qualité avec un modèle plus petit, vous pouvez essayer plusieurs approches :
- utilisez un prompt plus détaillé et plus long,
- ajoutez des exemples few-shot ou augmentez leur nombre,
- recourez au fine-tuning ou à la distillation.
Vous pouvez aussi optimiser l’inférence grâce à notre fonctionnalité de prédiction des sorties. Si vous connaissez à l’avance l’essentiel de la sortie, comme c’est souvent le cas lors d’une modification de code, vous pouvez réduire considérablement la latence de génération. En fournissant une prédiction au modèle, vous lui permettez de se concentrer davantage sur les modifications à apporter et moins sur le contenu à reprendre tel quel.
La vitesse d’inférence dépend aussi de la
puissance de calcul disponible et des autres
optimisations de l’inférence que vous mettez en œuvre.
La plupart des utilisateurs ne peuvent pas agir directement sur ces facteurs. Si vous souhaitez explorer cette piste et maîtrisez une partie de votre infrastructure, vous pouvez augmenter légèrement le nombre de tokens traités par minute avec du matériel plus rapide ou en
réduisant la charge des moteurs d’inférence. Si vous travaillez directement sur ces moteurs, il existe de nombreuses autres
optimisations de l’inférence
qui dépassent le cadre de ce guide.
Générez moins de tokens
Avec un LLM, la génération des tokens est presque toujours l’étape qui prend le plus de temps. En règle générale, réduire de moitié le nombre de tokens en sortie peut réduire la latence d’environ 50 %. La manière de raccourcir la sortie dépend de son type.
Si vous générez du texte en langage naturel, vous pouvez demander au modèle d’être plus concis (« en moins de 20 mots » ou « soyez bref »). Vous pouvez aussi lui apprendre à produire des réponses plus courtes à l’aide d’exemples few-shot, du fine-tuning ou des deux.
Si vous générez une sortie structurée, essayez d’en alléger la syntaxe chaque fois que possible : raccourcissez les noms de fonctions, omettez les arguments nommés, regroupez des paramètres, etc.
Enfin, même si cette pratique est peu courante, vous pouvez utiliser max_tokens ou stop_tokens pour interrompre la génération plus tôt.
Chaque token de sortie en moins, c’est une (milli)seconde de gagnée !
Utilisez moins de tokens en entrée
Réduire le nombre de tokens en entrée diminue la latence, mais le gain est généralement faible : raccourcir le prompt de moitié peut ne réduire la latence que de 1 à 5 %. À moins de traiter des contextes particulièrement volumineux (documents, images), il est souvent plus intéressant de concentrer vos efforts ailleurs.
Si vous traitez effectivement de très grands contextes (ou si vous cherchez à gagner jusqu’à la dernière milliseconde et que vous avez épuisé les autres possibilités), vous pouvez réduire le nombre de tokens en entrée avec les techniques suivantes :
- Ajustez le modèle par fine-tuning pour vous passer de longues instructions ou de nombreux exemples.
- Filtrez le contexte fourni en écartant les résultats RAG superflus, en nettoyant le HTML, etc.
- Allongez autant que possible le préfixe commun aux prompts en plaçant les parties dynamiques (par exemple, les résultats RAG et l’historique) plus loin dans le prompt. Vos requêtes tirent ainsi mieux parti du cache KV, utilisé par la plupart des fournisseurs de LLM, et le modèle traite moins de tokens en entrée à chaque requête.
Consultez notre documentation pour comprendre le fonctionnement de la mise en cache des prompts.
Envoyez moins de requêtes
Chaque requête prend le temps d’un aller-retour. Ces délais peuvent vite s’accumuler.
Si le LLM doit enchaîner plusieurs étapes, envisagez de les regrouper dans un seul prompt pour obtenir tous les résultats en une seule réponse, au lieu d’envoyer une requête par étape. Vous éviterez les allers-retours supplémentaires et pourrez aussi simplifier le traitement des réponses.
Pour cela, numérotez les étapes dans le prompt commun, puis demandez au modèle de renvoyer les résultats dans les champs nommés d’un objet JSON. Vous pourrez ainsi extraire chaque résultat et y accéder par son nom.
Parallélisez les opérations
Le traitement parallèle peut être particulièrement efficace lorsqu’un LLM doit réaliser plusieurs étapes.
Si les étapes ne doivent pas nécessairement s’enchaîner, vous pouvez les répartir entre plusieurs appels parallèles. Deux chemises mises à sécher en même temps ne prennent pas plus de temps qu’une seule.
Si les étapes doivent impérativement s’enchaîner, vous pouvez parfois recourir à l’exécution spéculative. Cette technique est particulièrement efficace pour les étapes de classification dont un résultat est plus probable que les autres, comme la modération.
- Lancez les étapes 1 et 2 simultanément (par exemple, la modération du texte saisi et la génération d’une histoire).
- Vérifiez le résultat de l’étape 1.
- Si le résultat diffère de celui attendu, annulez l’étape 2 et relancez-la si nécessaire.
Si vous avez anticipé correctement le résultat de l’étape 1, vous l’aurez exécutée sans ajouter de latence !
Réduisez l’attente des utilisateurs
Pour l’utilisateur, attendre et voir le traitement avancer sont deux expériences très différentes. Voici comment lui permettre de suivre la progression :
- Diffusion en continu : c’est l’approche la plus efficace, car elle ramène le temps d’attente à une seconde ou moins. Imaginez l’expérience avec ChatGPT si rien ne s’affichait avant que chaque réponse soit complète.
- Traitement par blocs : si la sortie doit encore être traitée avant son affichage (modération, traduction), envisagez de la traiter par blocs au lieu d’attendre de la recevoir en entier. Transmettez la sortie en continu au backend, puis envoyez les blocs traités au frontend.
- Affichage des étapes : si votre application enchaîne plusieurs étapes ou utilise des outils, montrez-les à l’utilisateur. Plus il voit concrètement le travail avancer, mieux c’est.
- Indicateurs de chargement : une animation de chargement ou une barre de progression est déjà très utile.
Si l’affichage des étapes et les indicateurs de chargement ont surtout un effet psychologique, la diffusion en continu et le traitement par blocs réduisent réellement la latence globale lorsqu’on tient compte à la fois de l’application et de son utilisateur : celui-ci termine plus tôt la lecture de la réponse.
Évitez le recours systématique à un LLM
Les modèles de langage sont puissants et polyvalents. On les utilise donc parfois là où une méthode classique plus rapide conviendrait mieux. Repérer ces cas peut vous permettre de réduire sensiblement la latence. En voici quelques exemples :
- Messages prédéfinis : si votre sortie ne peut prendre que quelques formes, vous pouvez vous passer d’un LLM pour la générer. Les confirmations d’action, les messages de refus et les demandes de saisie standard se prêtent bien à la rédaction de messages prédéfinis. Vous pouvez même reprendre une méthode éprouvée : prévoir quelques variantes pour chacun.
- Calcul à l’avance : si les entrées possibles sont limitées (par exemple, lors du choix d’une catégorie), vous pouvez générer plusieurs réponses à l’avance et veiller à ne jamais présenter deux fois la même à un utilisateur.
- Composants d’interface : pour présenter des indicateurs synthétiques, des rapports ou des résultats de recherche, des composants d’interface classiques conçus à cet effet conviennent parfois mieux qu’un texte généré par un LLM.
- Techniques d’optimisation classiques : une application qui utilise un LLM reste une application. La recherche dichotomique, la mise en cache, les tables de hachage et l’analyse de la complexité temporelle gardent toute leur utilité avec les modèles de langage.
Exemple
Examinons une application pour repérer où réduire la latence et proposer des solutions.
Nous allons analyser l’architecture et les prompts d’un assistant de service client fictif, inspiré d’applications en production. La section Architecture et prompts présente son fonctionnement initial. La section Analyse et optimisations détaille ensuite la démarche suivie pour réduire la latence.
Cet exemple ne couvre qu’une partie des principes. En pratique aussi, un cas d’usage exige rarement d’appliquer toutes les techniques.
Architecture et prompts
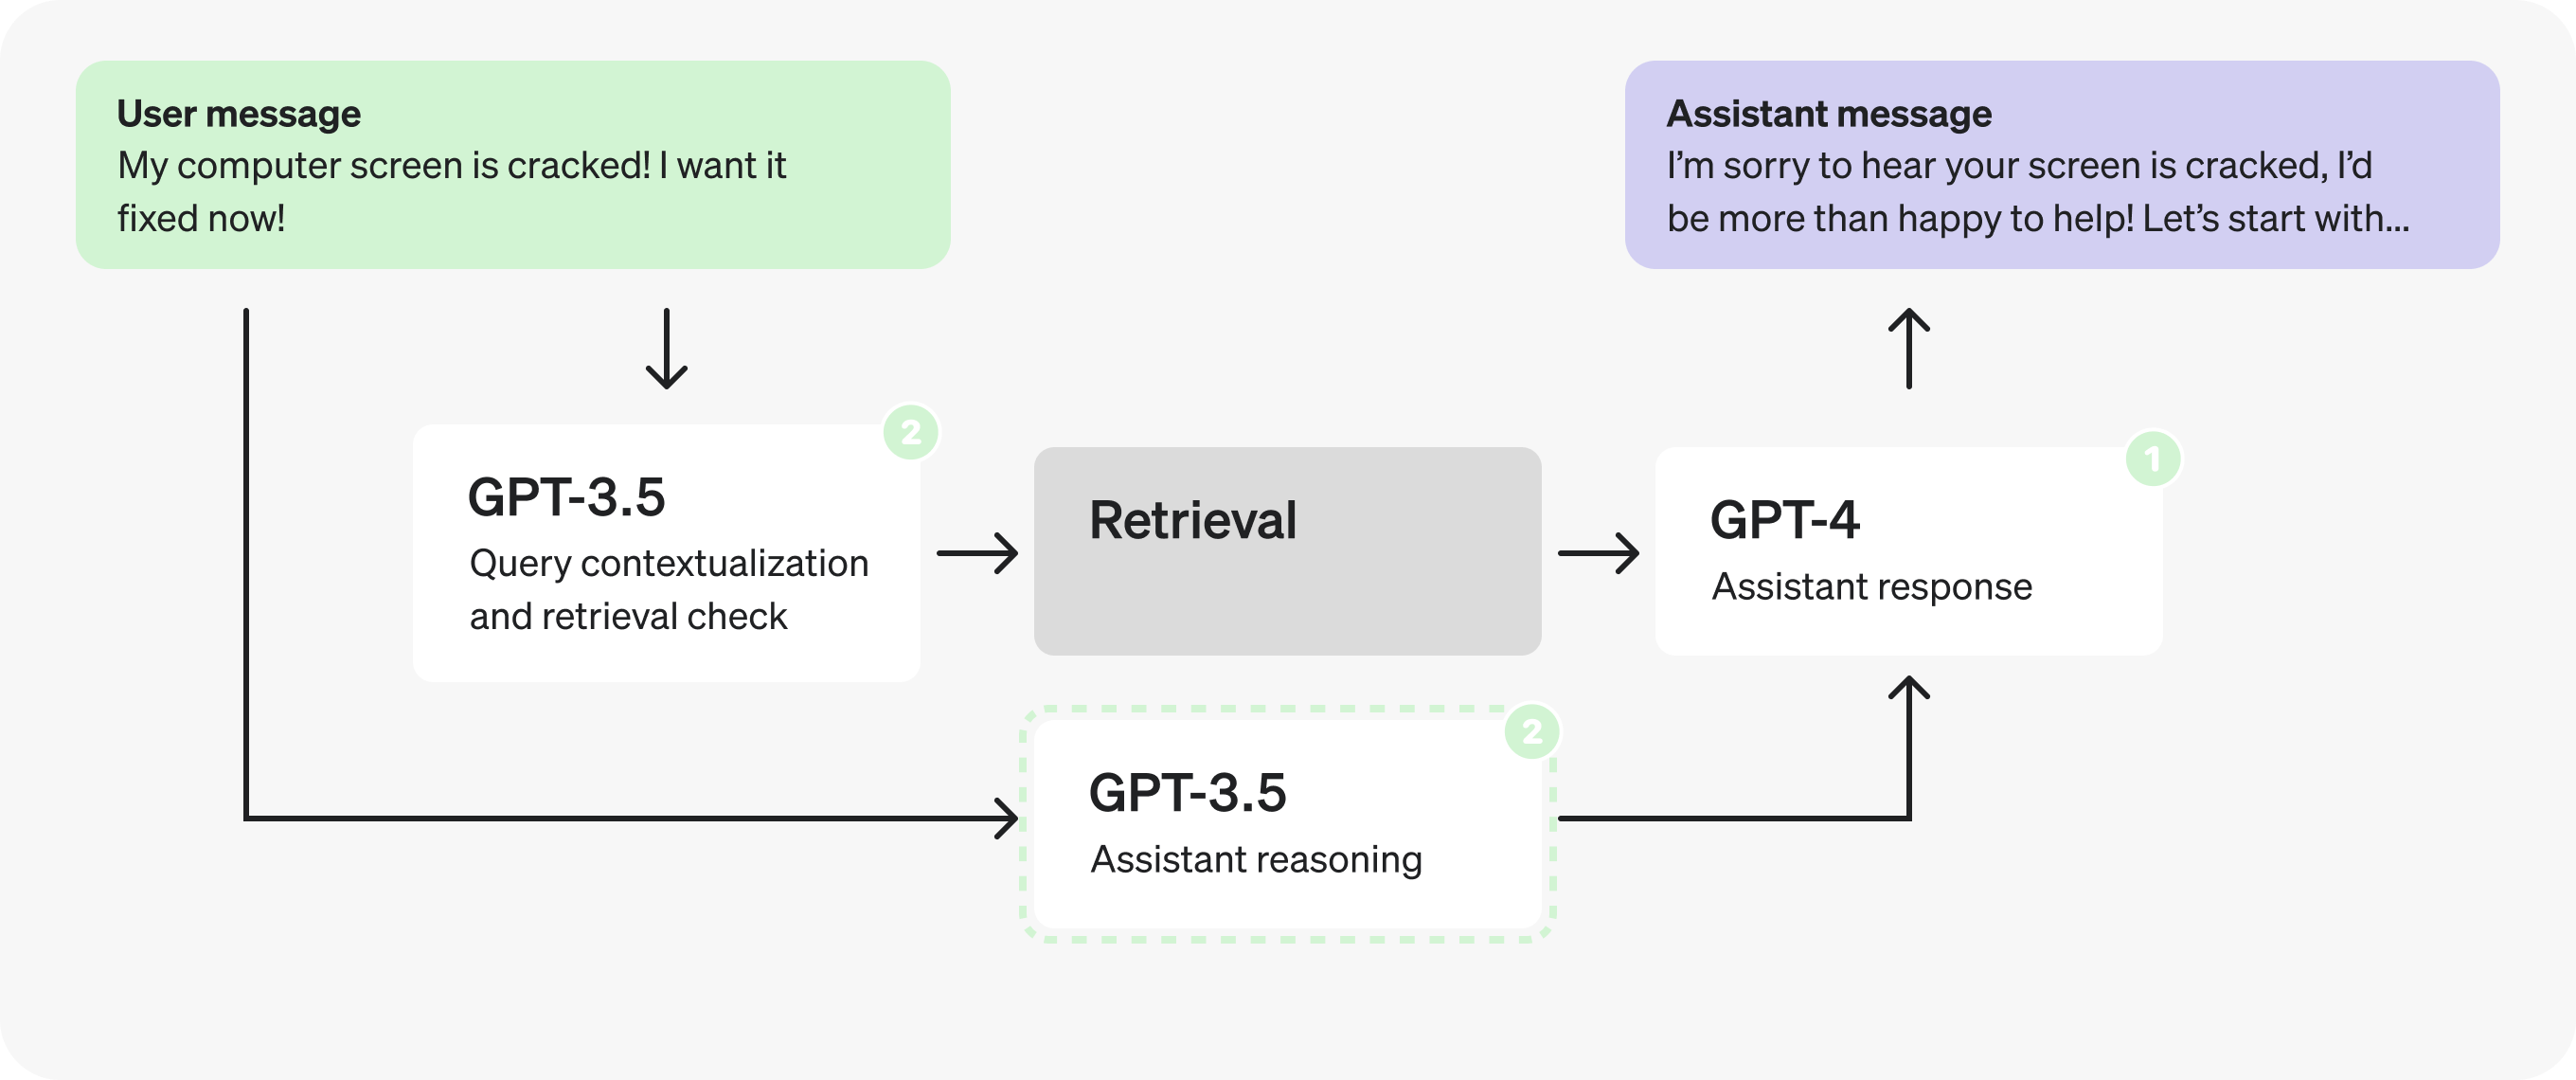
Voici l’architecture initiale de notre assistant de service client fictif. C’est cette architecture que nous allons modifier.
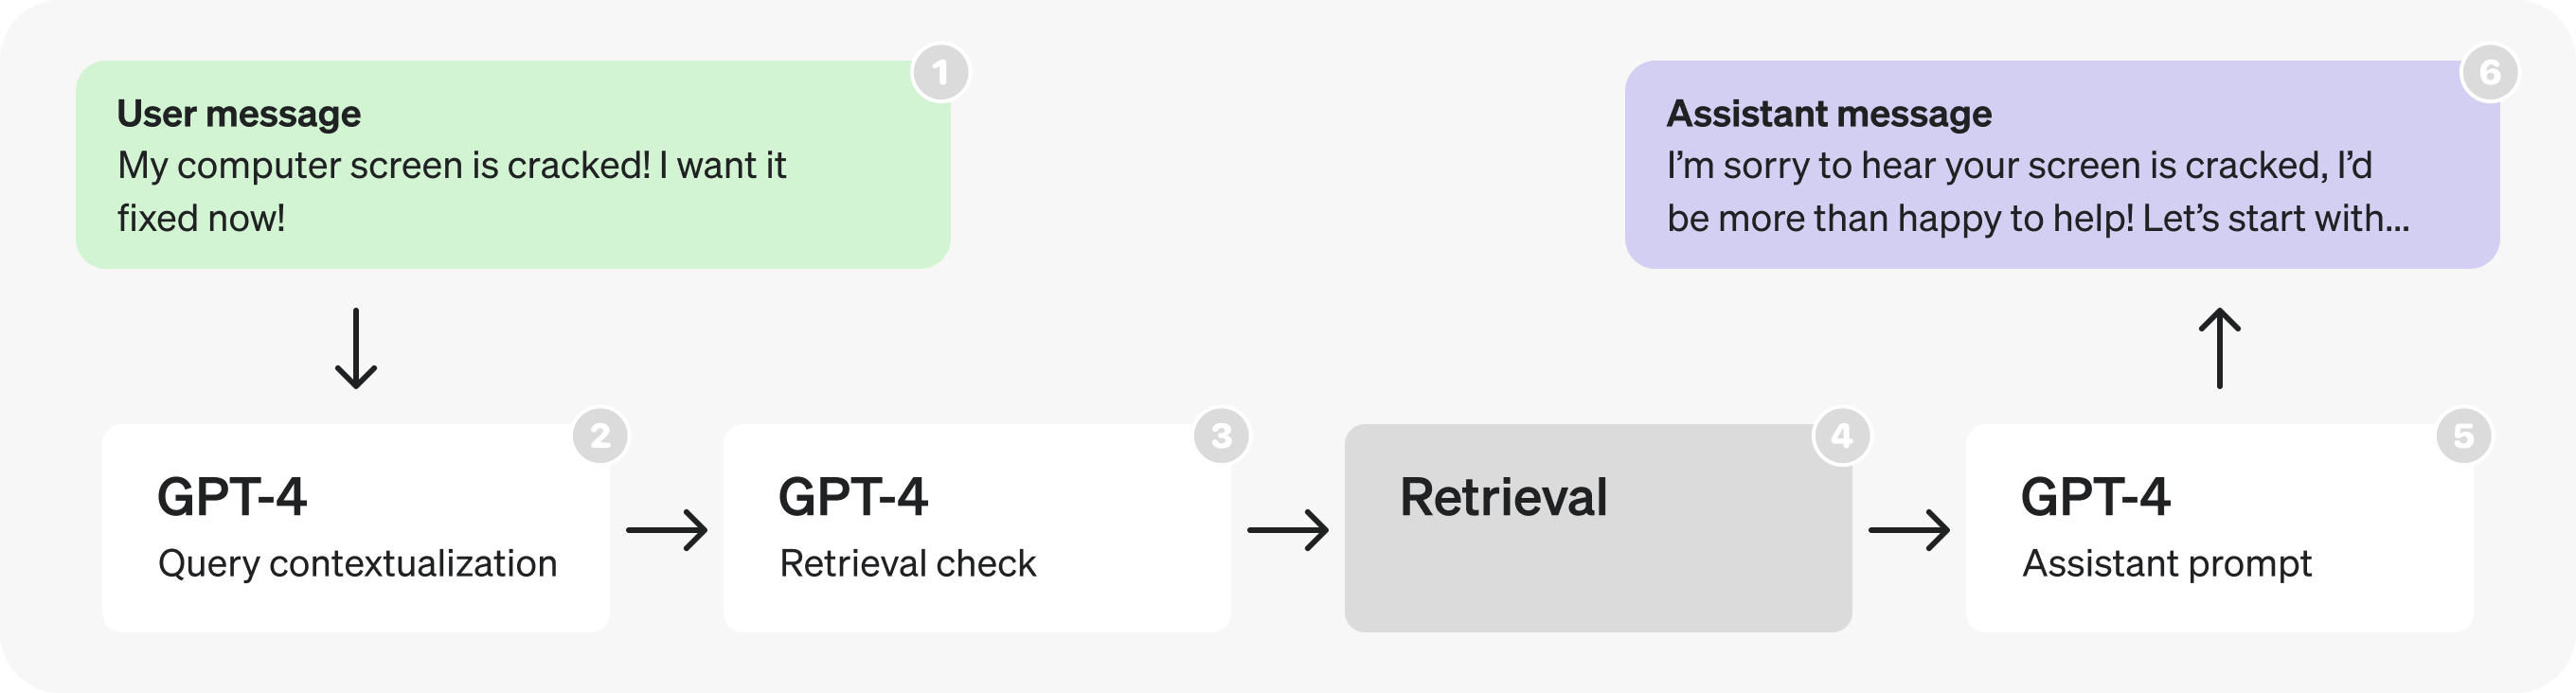
Le schéma illustre les grandes étapes du traitement :
- Un utilisateur envoie un message dans une conversation en cours.
- Le système reformule le dernier message en requête compréhensible hors contexte (voir les exemples dans le prompt).
- Le système détermine s’il doit rechercher des informations complémentaires pour répondre à cette requête.
- La recherche fournit des résultats.
- L’assistant raisonne à partir de la requête de l’utilisateur et des résultats de recherche, puis produit une réponse.
- Le système transmet la réponse à l’utilisateur.
Voici les prompts utilisés à chaque étape du schéma. Ces exemples fictifs et simplifiés reprennent la structure et les formulations que l’on trouve dans une application en production.
Les emplacements tels que « [user input here] » correspondent à des parties dynamiques que l’application remplace par les données réelles à l’exécution.
Analyse et optimisations
Partie 1 : examen des prompts de recherche
Dans cette architecture, on remarque d’abord les appels successifs à GPT-4. Cet enchaînement peut ralentir le traitement. Il est souvent possible de remplacer ces appels par un seul appel ou de les exécuter en parallèle.
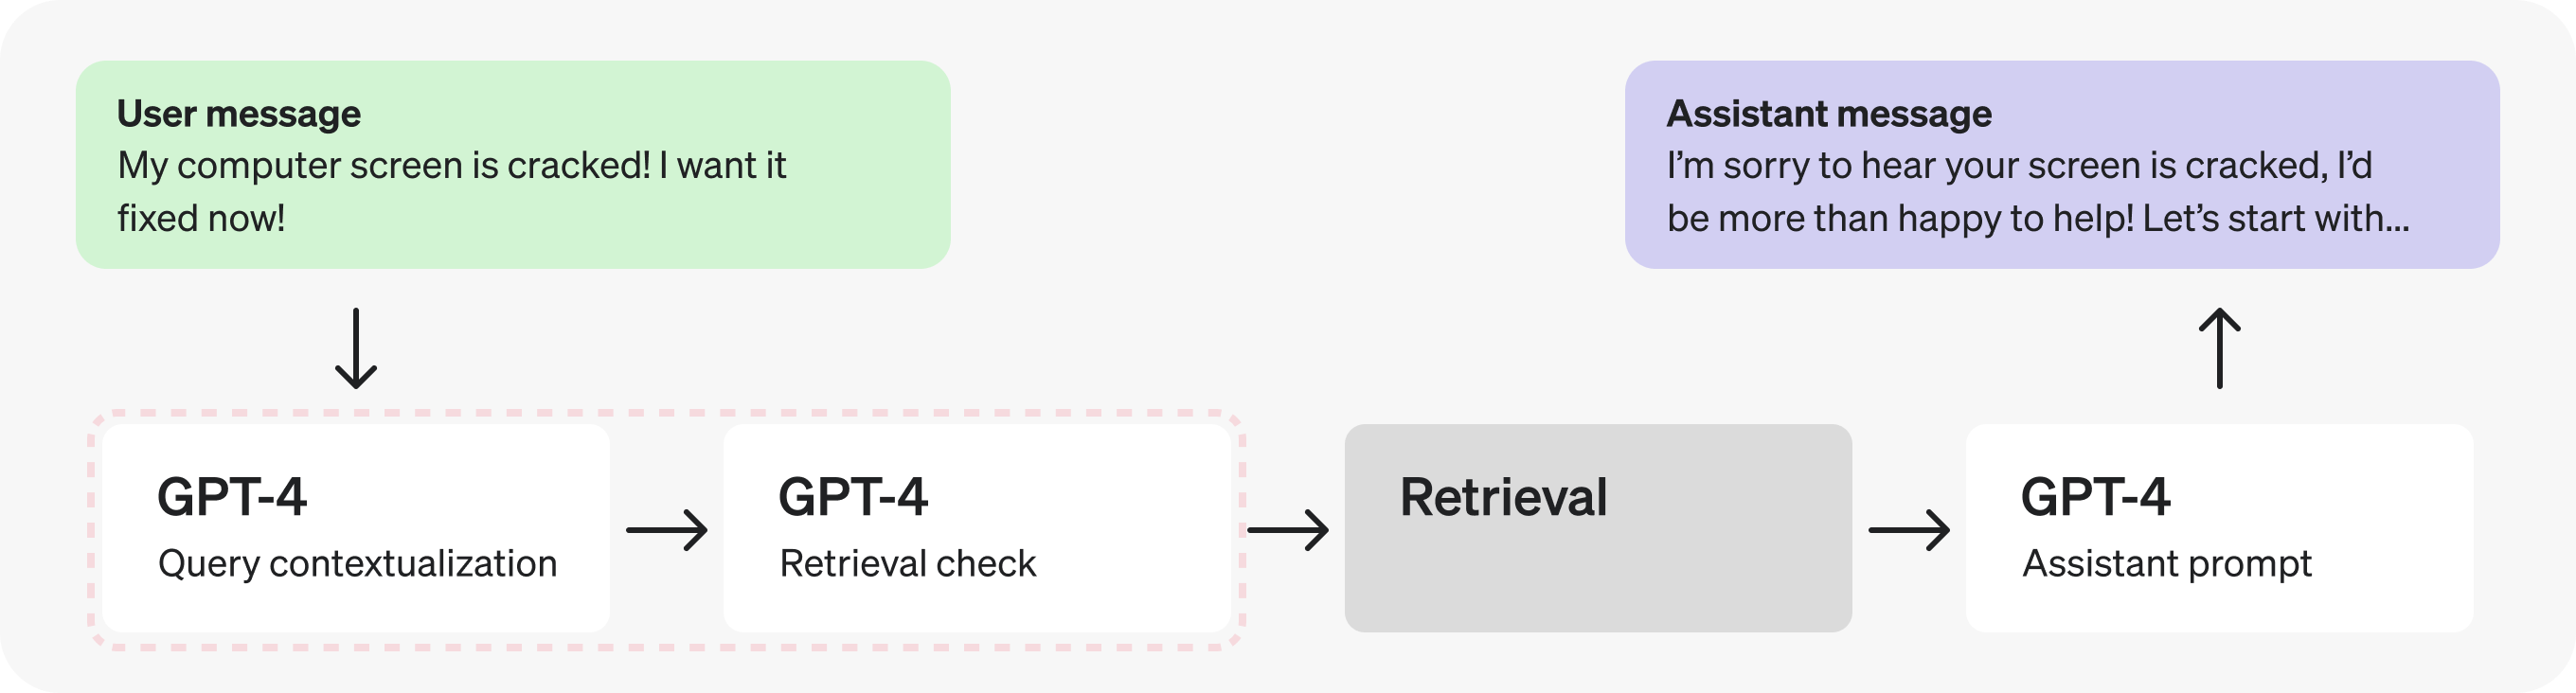
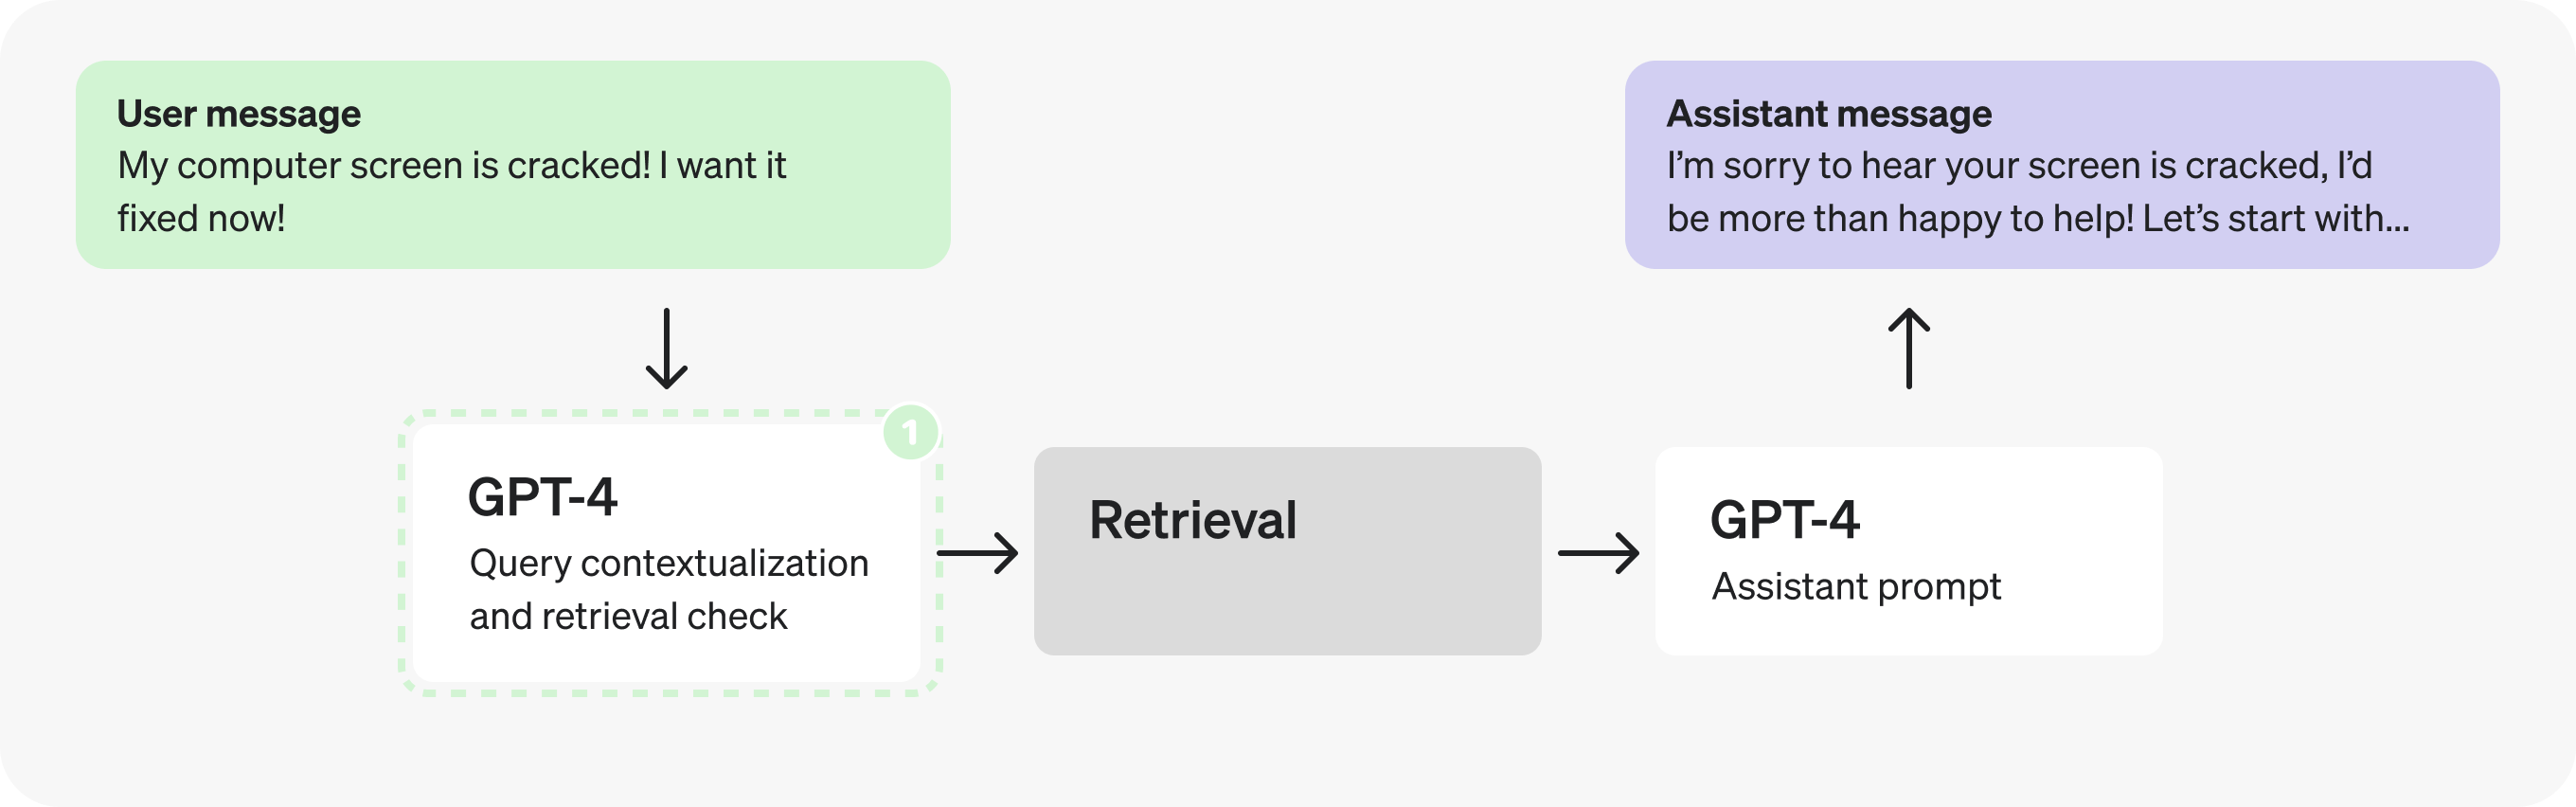
Ici, il faut disposer de la requête contextualisée pour déterminer si une recherche est nécessaire. Nous allons donc regrouper ces deux étapes dans un seul prompt pour envoyer moins de requêtes.
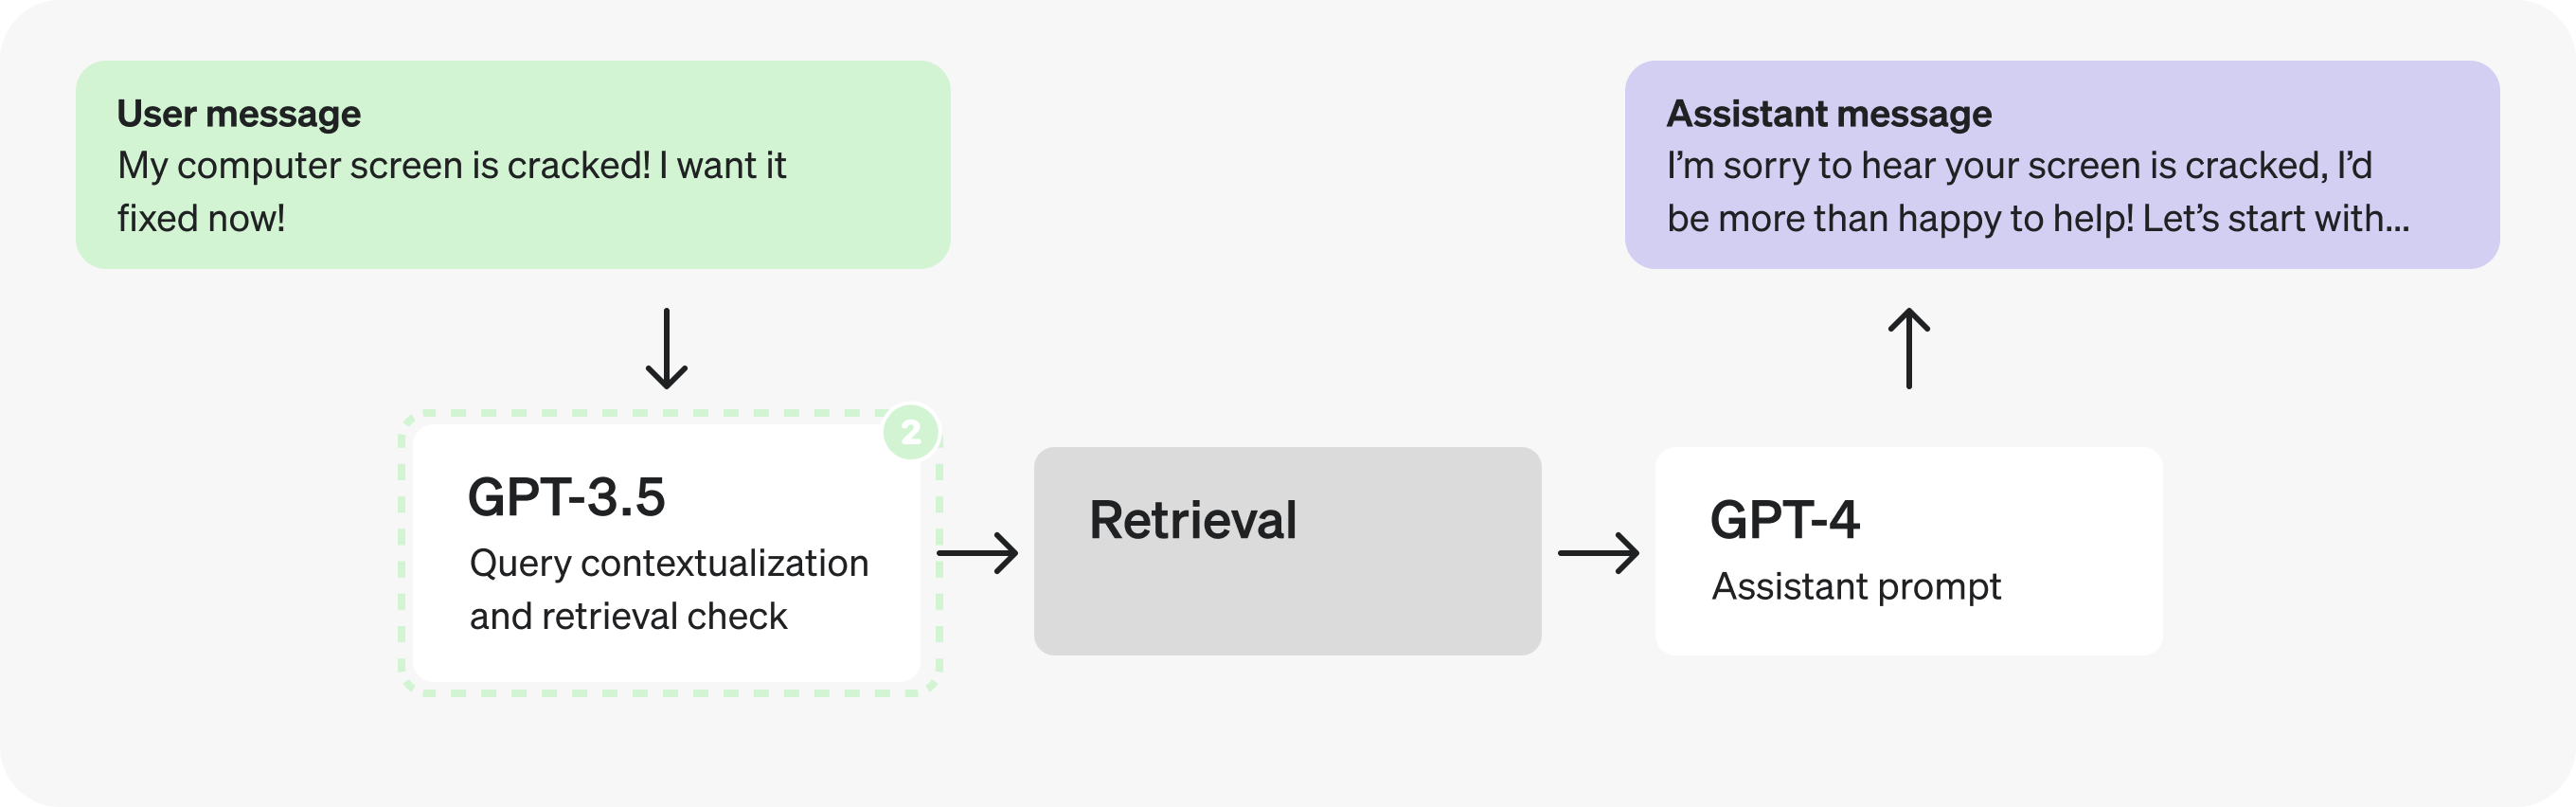
Ajouter du contexte et décider s’il faut effectuer une recherche sont deux tâches simples et bien définies. Nous pouvons donc probablement les confier à un modèle plus petit, ajusté par fine-tuning. Passer à GPT-3.5 nous permettra de traiter les tokens plus vite.
Partie 2 : analyse du prompt de l’assistant
Examinons maintenant le prompt de l’assistant. Le modèle semble passer par plusieurs étapes distinctes pour remplir les champs JSON. Il serait donc peut-être possible de paralléliser ces étapes.
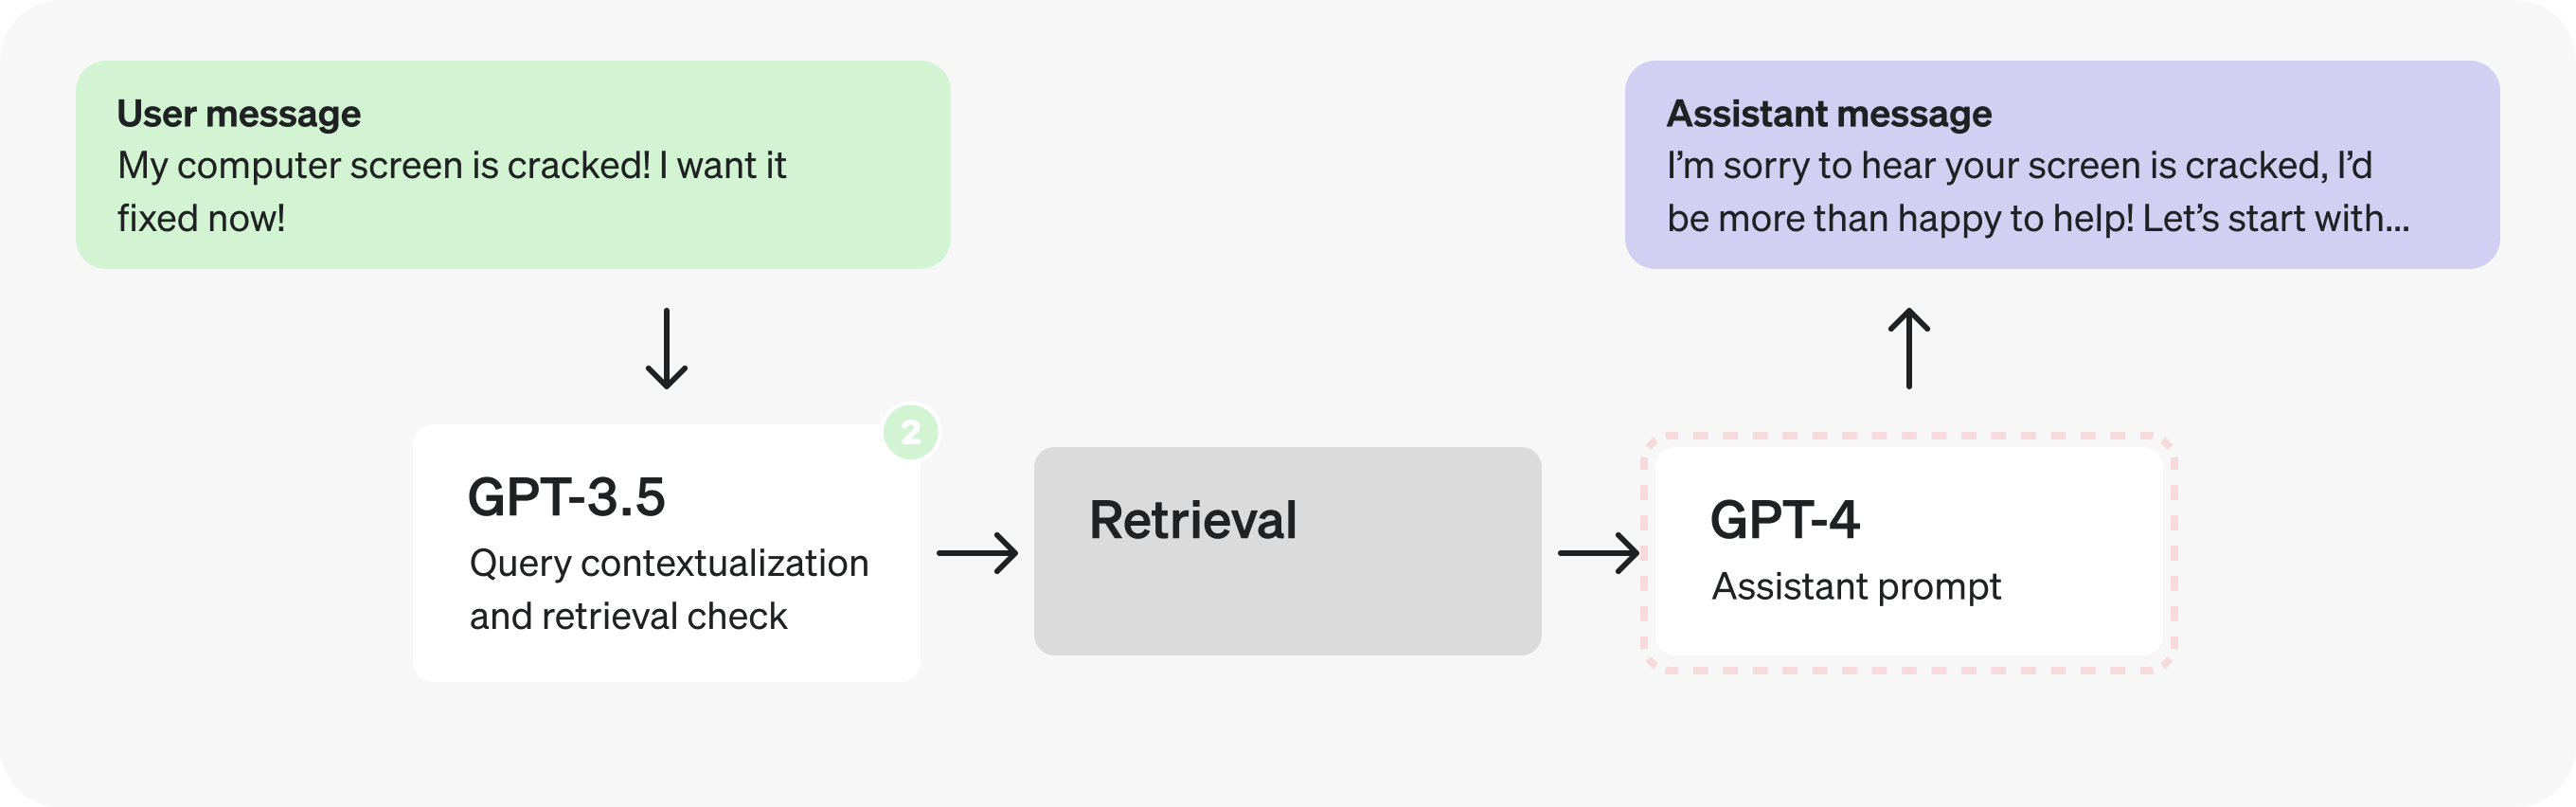
Supposons toutefois que nos tests montrent que séparer les étapes de raisonnement dans l’objet JSON dégrade les réponses. Il faut alors explorer d’autres solutions.
Pourrions-nous remplacer GPT-4 par une version de GPT-3.5 ajustée par fine-tuning ? Peut-être, mais pour les questions ouvertes, mieux vaut généralement laisser GPT-4 rédiger la réponse de l’assistant, car il gère mieux une plus grande variété de situations. En revanche, les étapes intermédiaires n’exigent peut-être pas toutes les capacités de raisonnement de GPT-4. Leur périmètre est limité et bien défini, ce qui en fait de bonnes candidates au fine-tuning.
{
message_is_conversation_continuation: "True", // <-
number_of_messages_in_conversation_so_far: "1", // <-
user_sentiment: "Aggravated", // <-
query_type: "Hardware Issue", // <-
response_tone: "Validating and solution-oriented", // <-
response_requirements: "Propose options for repair or replacement.", // <-
user_requesting_to_talk_to_human: "False", // <-
enough_information_in_context: "True", // <-
response: "...", // X -- benefits from GPT-4
};Deux options s’offrent à nous. Faut-il conserver une seule requête dont GPT-4 génère toute la sortie, ou la scinder en deux requêtes successives et confier à GPT-3.5 tout sauf la réponse finale ? Deux principes entrent ici en concurrence : la première option permet d’envoyer moins de requêtes, tandis que la seconde pourrait permettre de traiter les tokens plus vite.
Comme souvent en matière d’optimisation, le choix dépend de plusieurs facteurs, notamment :
- la proportion de tokens dans le champ
responsepar rapport aux autres champs, - la baisse moyenne de latence obtenue en traitant la plupart des champs plus vite,
- l’augmentation moyenne de latence due à l’envoi de deux requêtes au lieu d’une.
La conclusion varie selon les cas. Pour trancher, le mieux est de tester les deux options sur des exemples issus de la production. Supposons qu’ici les tests montrent qu’il est avantageux de scinder le prompt en deux pour traiter les tokens plus vite.
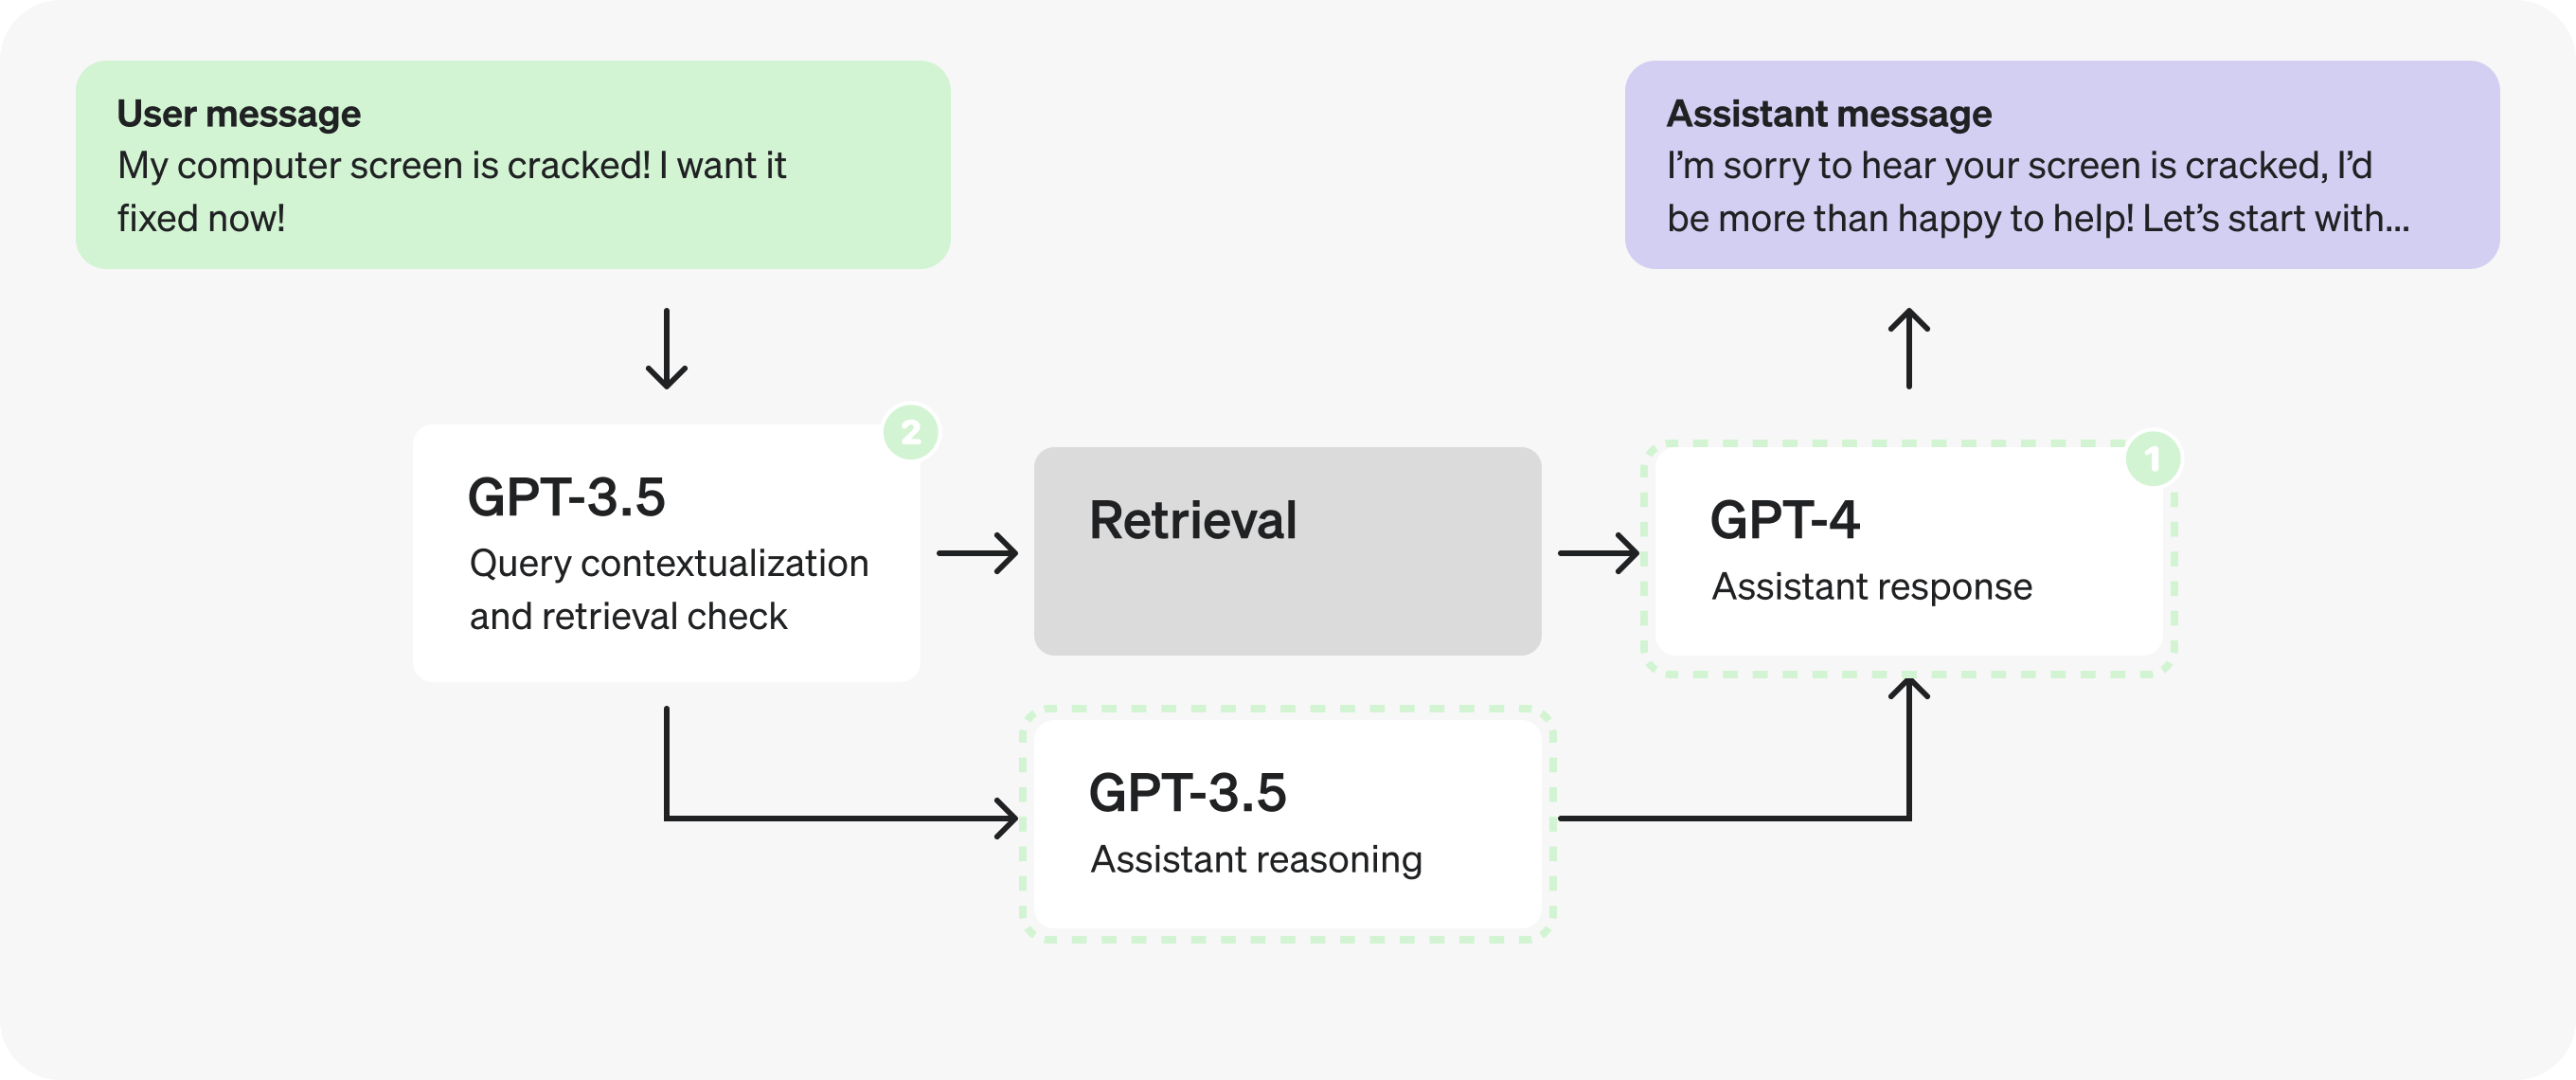
Remarque : nous regroupons response et enough_information_in_context dans le second prompt pour éviter de transmettre le contexte issu de la recherche aux deux nouveaux prompts.
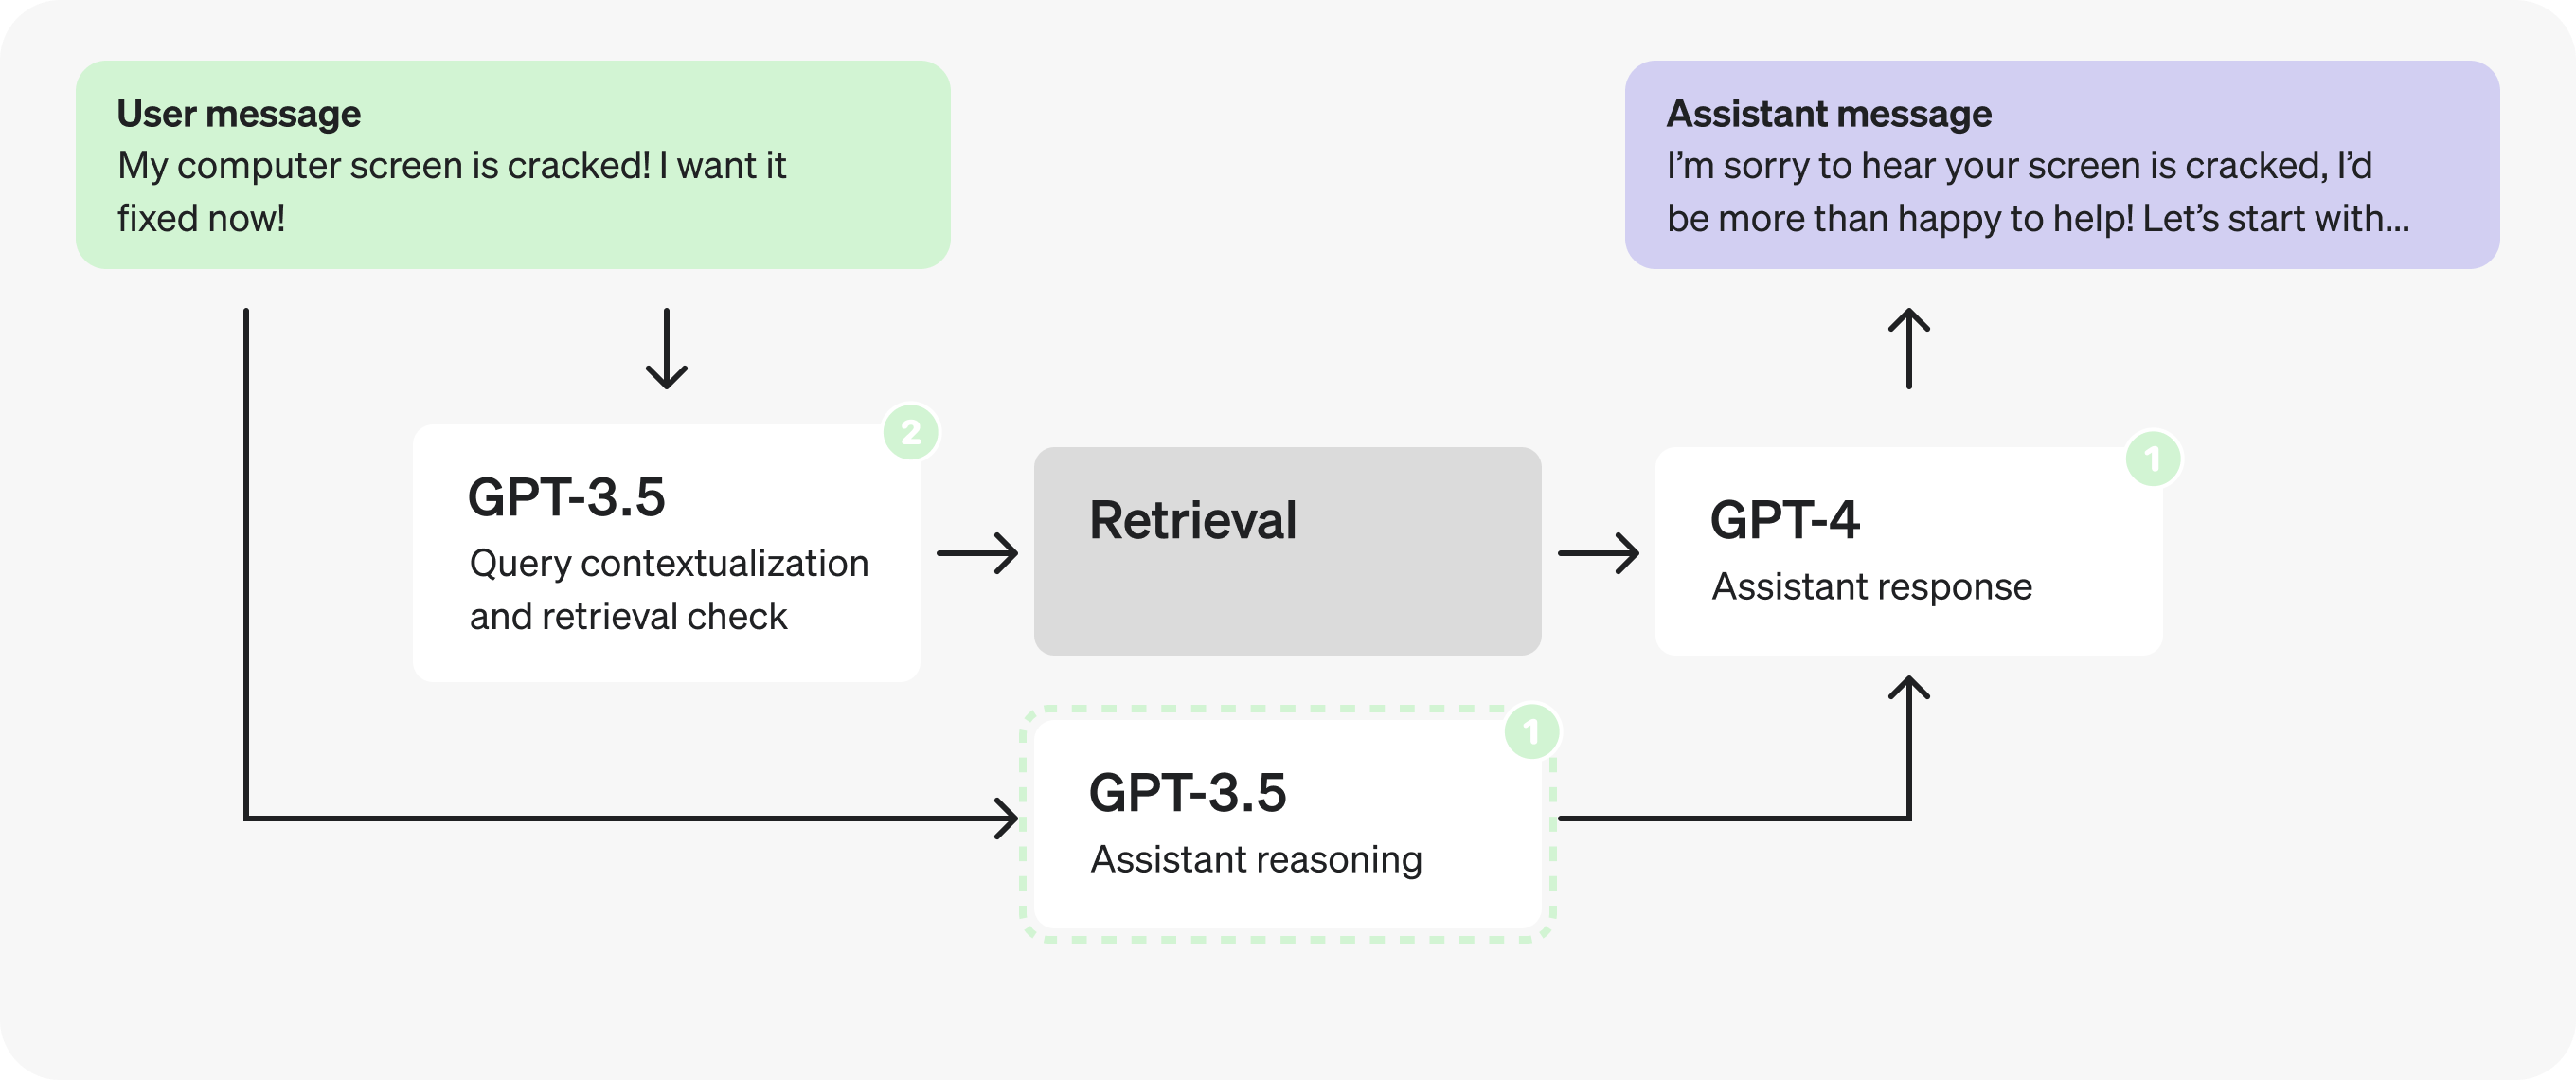
Le prompt de raisonnement ne dépend plus du contexte issu de la recherche. Nous pouvons donc paralléliser les appels en lançant ce prompt en même temps que les prompts de recherche.
Partie 3 : optimisation de la sortie structurée
Revenons au prompt de raisonnement.
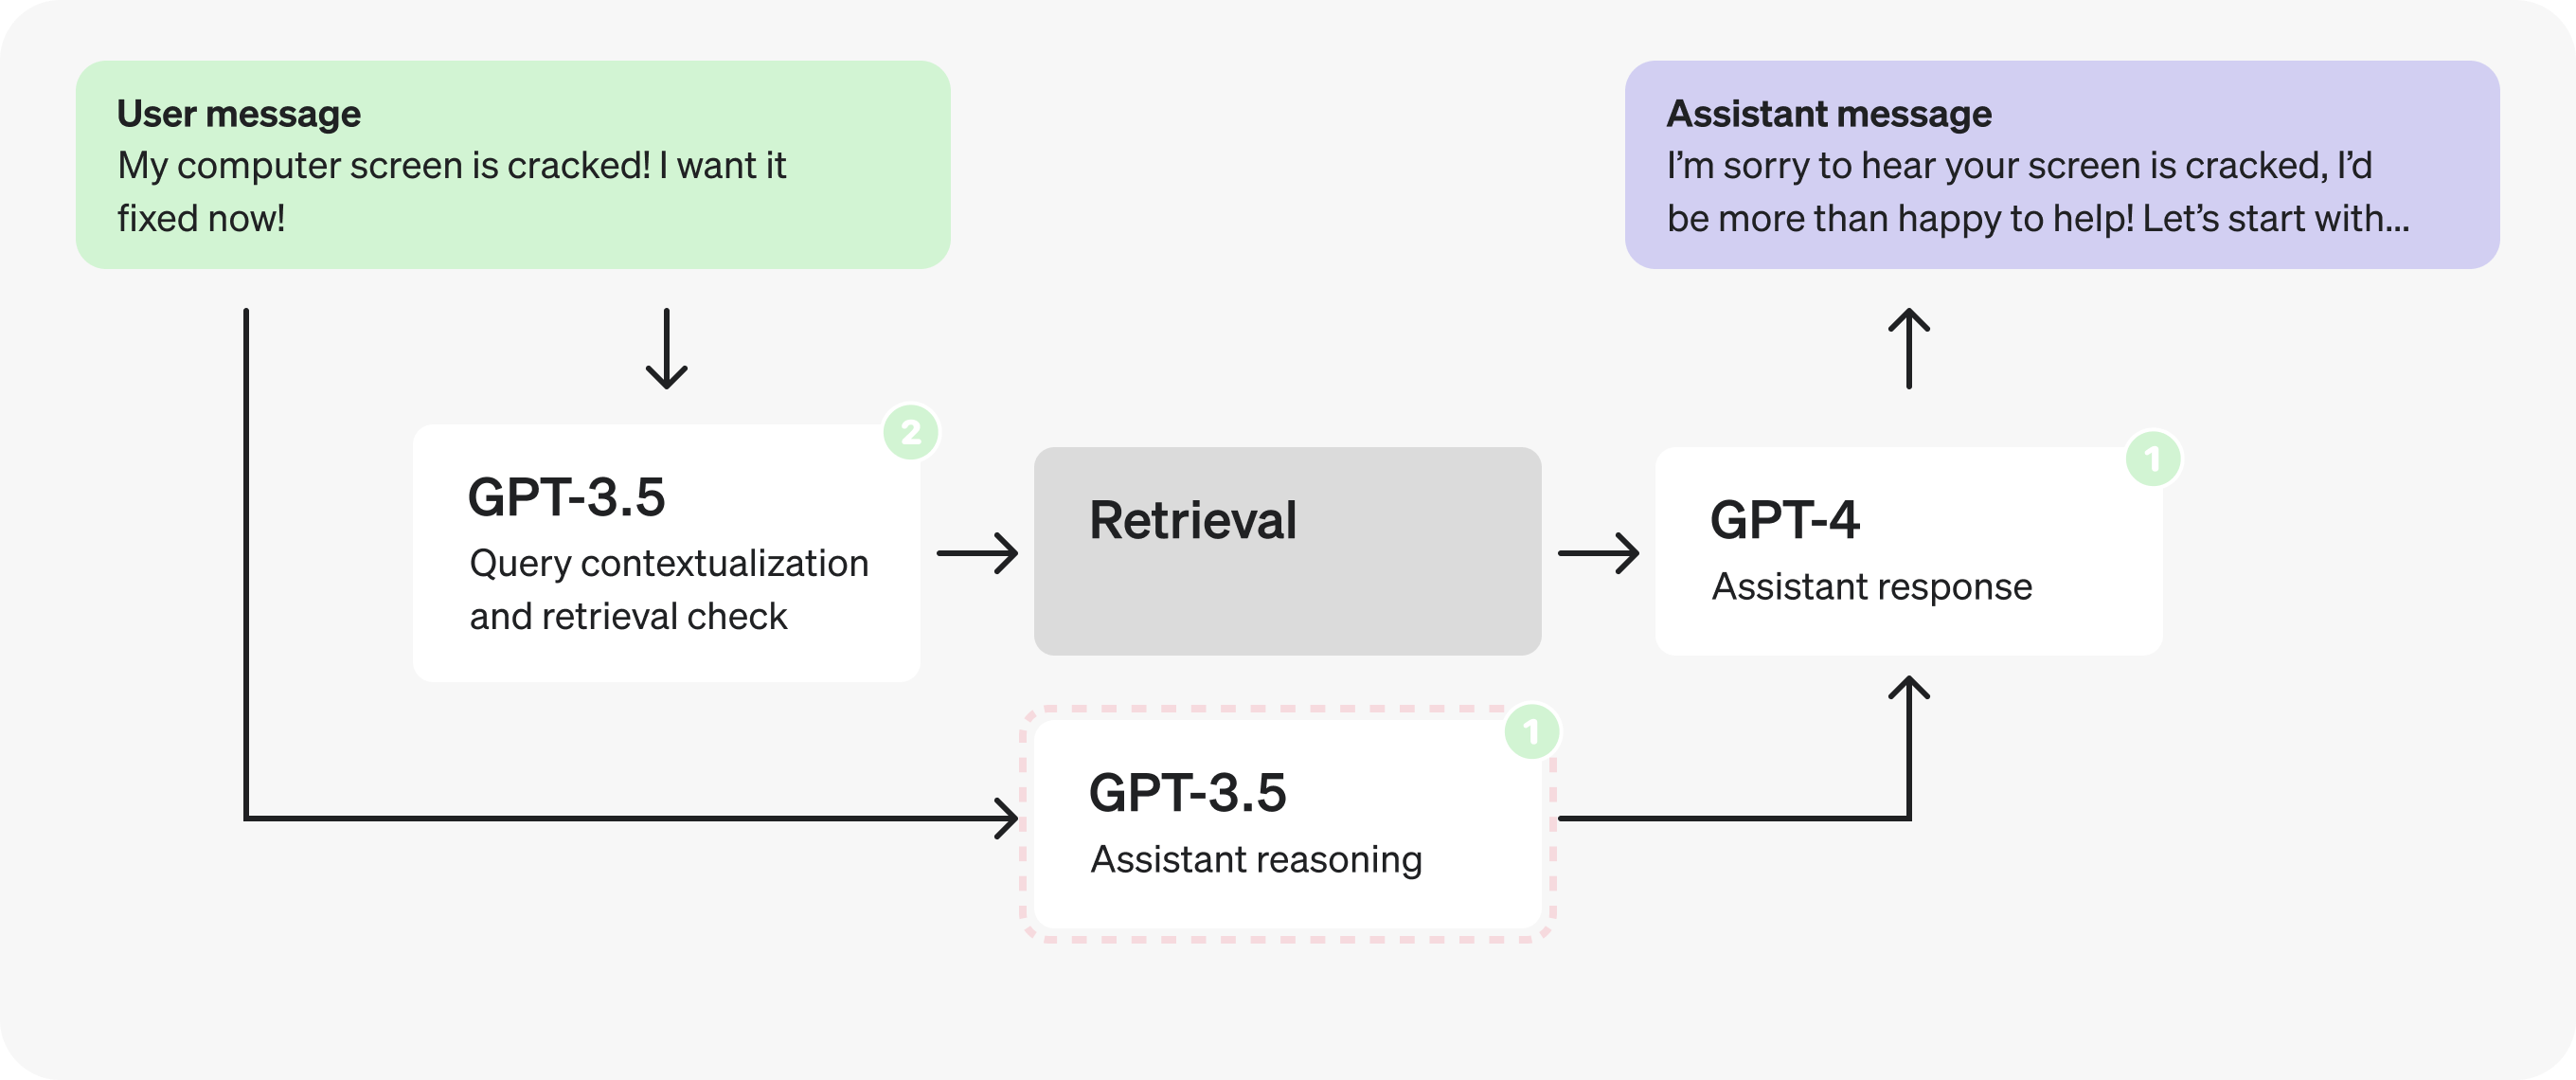
Dans l’objet JSON qui contient les résultats du raisonnement, les noms des champs sont assez longs.
{
message_is_conversation_continuation: "True", // <-
number_of_messages_in_conversation_so_far: "1", // <-
user_sentiment: "Aggravated", // <-
query_type: "Hardware Issue", // <-
response_tone: "Validating and solution-oriented", // <-
response_requirements: "Propose options for repair or replacement.", // <-
user_requesting_to_talk_to_human: "False", // <-
};En raccourcissant ces noms et en déplaçant les explications dans les commentaires, nous pouvons générer moins de tokens.
{
cont: "True", // whether last message is a continuation
n_msg: "1", // number of messages in the continued conversation
tone_in: "Aggravated", // sentiment of user query
type: "Hardware Issue", // type of the user query
tone_out: "Validating and solution-oriented", // desired tone for response
reqs: "Propose options for repair or replacement.", // response requirements
human: "False", // whether user is expressing want to talk to human
};
Cette modification a supprimé 19 tokens en sortie. Avec GPT-3.5, le gain peut se limiter à quelques millisecondes. Avec GPT-4, il pourrait atteindre une seconde.
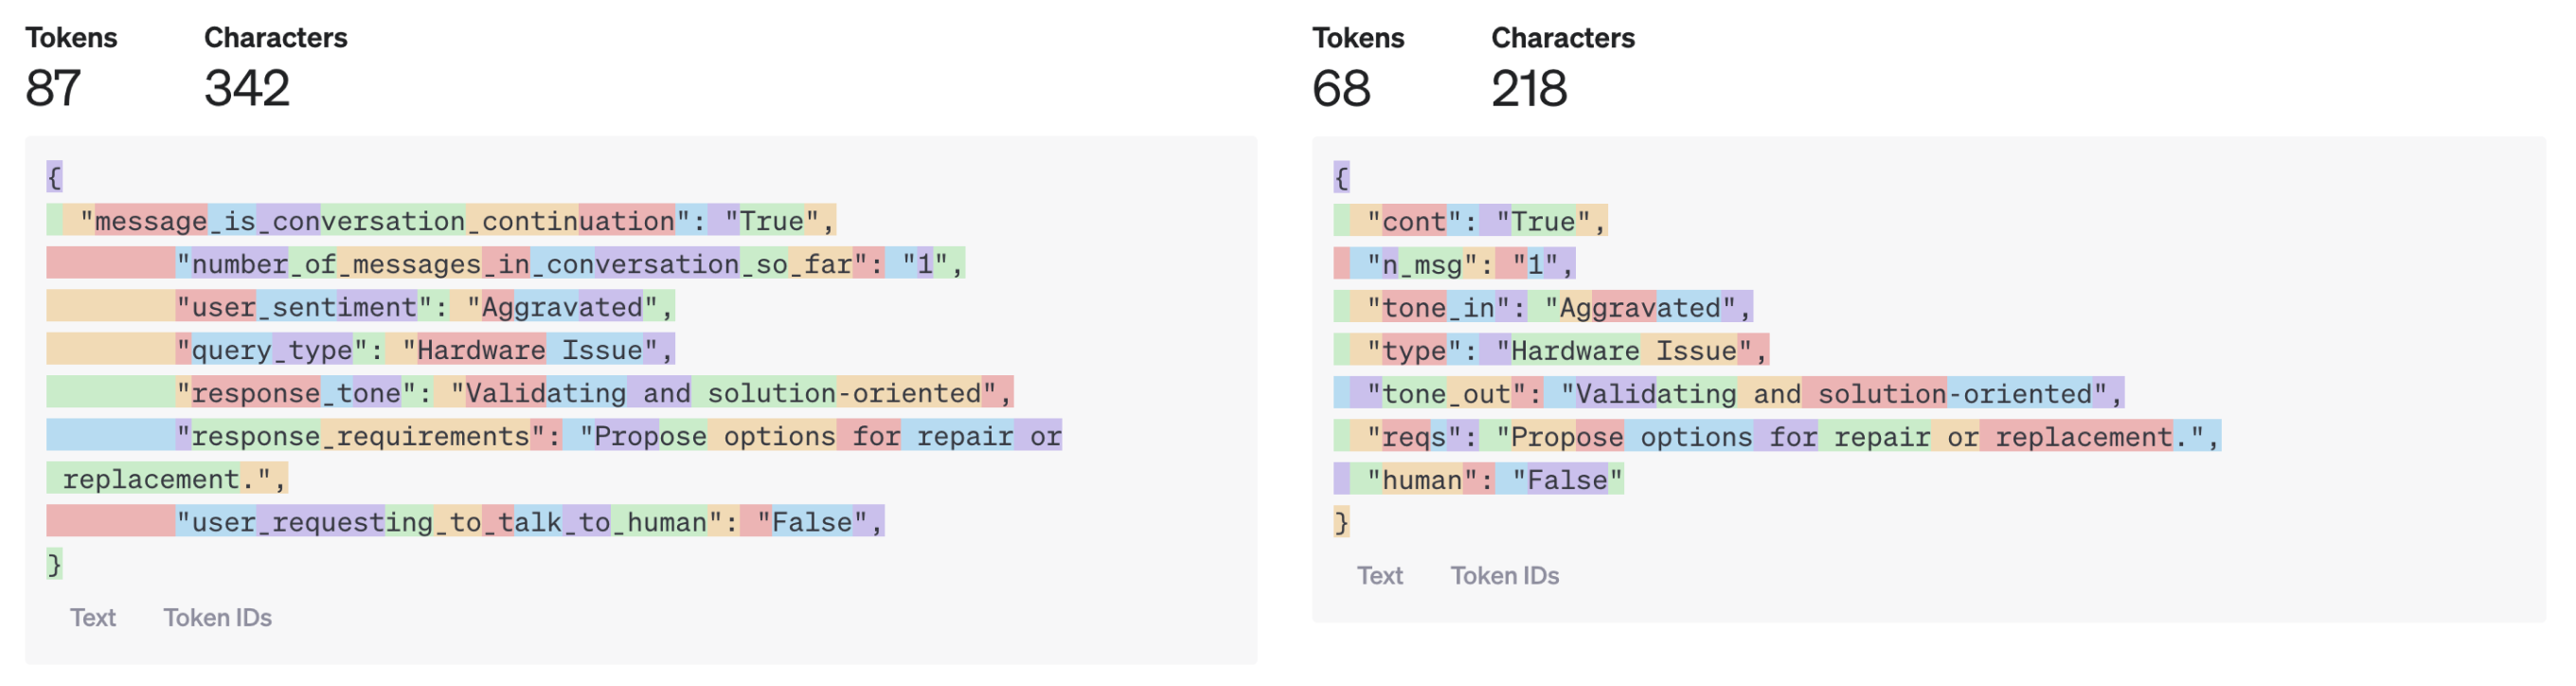
Pour des sorties plus longues, le gain peut être nettement plus important.
Nous pourrions aller plus loin en nommant chaque champ JSON avec un seul caractère ou en plaçant toutes les valeurs dans un tableau. La qualité des réponses risque toutefois d’en pâtir. Là encore, le mieux est de le vérifier par des tests.
Bilan de l’exemple
Voici les optimisations apportées à notre assistant de service client :
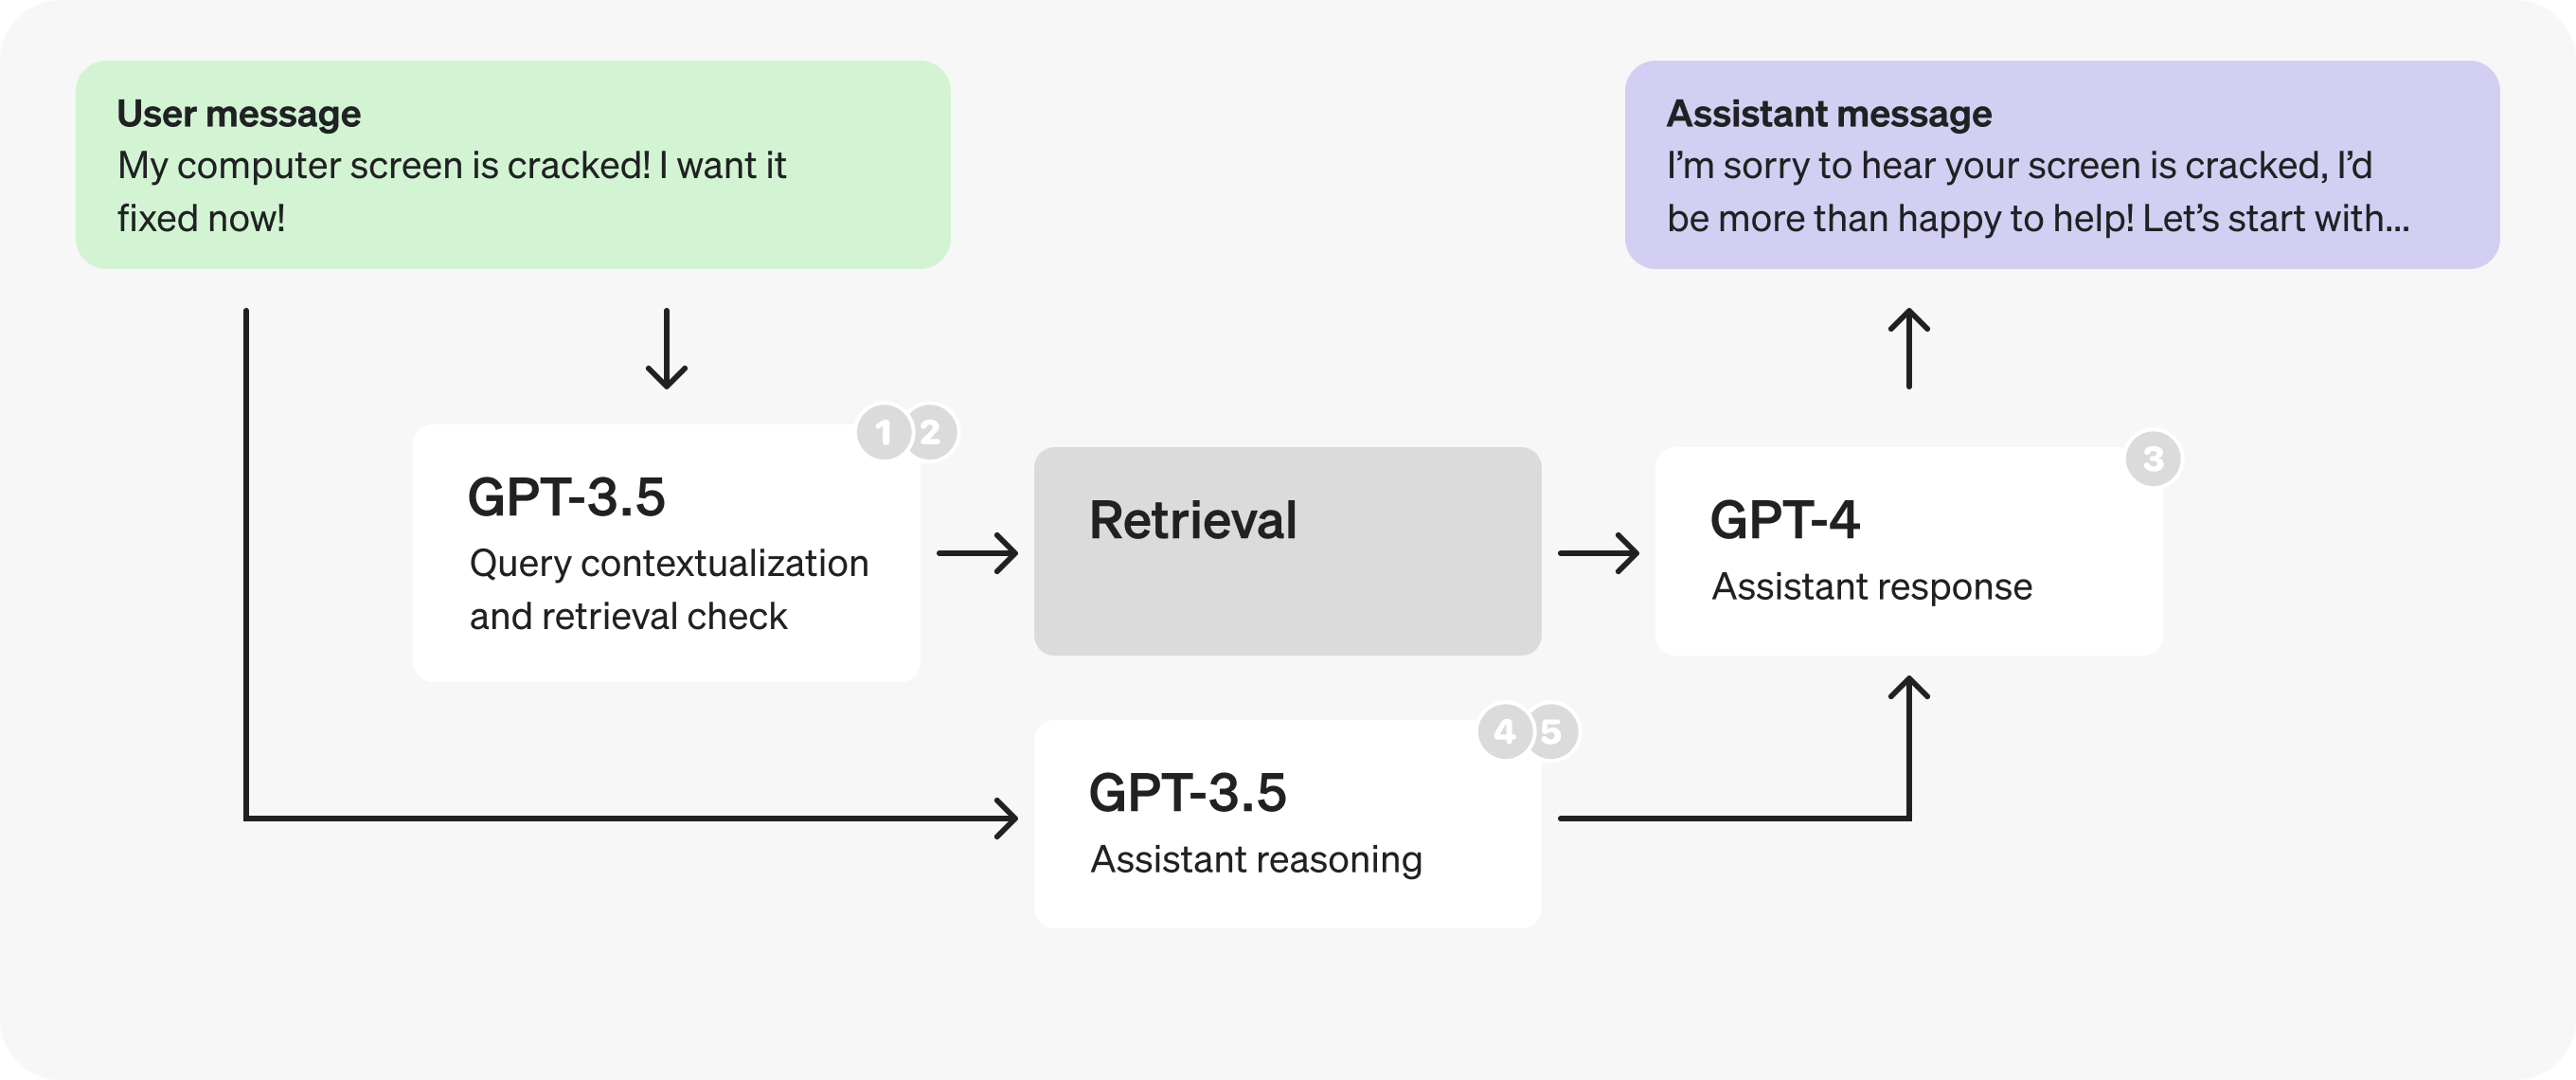
- Nous avons regroupé la contextualisation de la requête et la vérification du besoin de recherche pour envoyer moins de requêtes.
- Pour ce nouveau prompt, nous sommes passés à GPT-3.5, un modèle plus petit que nous avons ajusté par fine-tuning, afin de traiter les tokens plus vite.
- Nous avons scindé le prompt de l’assistant en deux et confié le raisonnement à GPT-3.5, un modèle plus petit ajusté par fine-tuning, là aussi pour traiter les tokens plus vite.
- Nous avons parallélisé la vérification du besoin de recherche et les étapes de raisonnement.
- Nous avons raccourci les noms des champs de raisonnement et déplacé les commentaires dans le prompt pour générer moins de tokens.