
text-embedding-3-small and text-embedding-3-large, our newest and most performant embedding models, are now available. They feature lower costs, higher multilingual performance, and new parameters to control the overall size.Qu’est-ce qu’un plongement vectoriel ?
Les plongements vectoriels de texte d’OpenAI permettent de mesurer la proximité sémantique entre des chaînes de caractères. Ils servent couramment aux tâches suivantes :
- Recherche (classer les résultats selon leur pertinence par rapport à une requête)
- Regroupement (regrouper des textes selon leur similarité)
- Recommandation (recommander des éléments dont les textes sont proches)
- Détection d’anomalies (repérer les éléments atypiques qui ressemblent peu aux autres)
- Mesure de la diversité (analyser la distribution des similarités)
- Classification (attribuer à chaque texte l’étiquette dont il est le plus proche)
Un plongement vectoriel est un vecteur (une liste) de nombres à virgule flottante. La distance entre deux vecteurs mesure leur proximité sémantique. Une faible distance indique que les textes ont probablement des sens proches, une grande distance que leurs sens sont probablement éloignés.
Consultez notre page de tarification pour connaître les tarifs des plongements vectoriels. La facturation des requêtes dépend du nombre de tokens dans les données d’entrée.
Comment obtenir des plongements vectoriels
Pour obtenir un plongement vectoriel, envoyez votre chaîne de caractères au point de terminaison de l’API dédié aux plongements vectoriels en indiquant le nom du modèle de plongement (par exemple text-embedding-3-small) :
1
2
3
4
5
6
7
8
9
10import OpenAI from "openai";
const openai = new OpenAI();

const embedding = await openai.embeddings.create({
  model: "text-embedding-3-small",
  input: "Your text string goes here",
  encoding_format: "float",
});

console.log(embedding);
1
2
3
4
5
6
7
8
9from openai import OpenAI
client = OpenAI()
response = client.embeddings.create(
input="Your text string goes here", model="text-embedding-3-small"
)
print(response.data[0].embedding)1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
)
func main() {
client := openai.NewClient()
embedding, err := client.Embeddings.New(context.Background(), openai.EmbeddingNewParams{
Model: openai.EmbeddingModelTextEmbedding3Small,
Input: openai.EmbeddingNewParamsInputUnion{
OfString: openai.String("Your text string goes here."),
},
})
if err != nil {
panic(err)
}
fmt.Println(len(embedding.Data[0].Embedding))
}1
2
3
4
5
6
7
8
9
10
11
12
13
14import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
var embedding =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.input("The food was delicious and the waiter...")
.build());
System.out.println(embedding.data().get(0).embedding());1
2
3
4
5
6
7
8
9
10
11using OpenAI.Embeddings;
string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "text-embedding-3-small";
EmbeddingClient client = new(model, key);
OpenAIEmbedding embedding = await client.GenerateEmbeddingAsync(
"The food was delicious and the waiter was friendly."
);
Console.WriteLine($"Dimensions: {embedding.ToFloats().Length}");1
2
3
4
5
6
7
8
9
10require "openai"
client = OpenAI::Client.new
response = client.embeddings.create(
model: "text-embedding-3-small",
input: "The food was delicious and the waiter..."
)
puts(response.data.fetch(0).embedding)1
2
3
4
5
6
7curl https://api.openai.com/v1/embeddings \
-H "Content-Type: application/json" \
-H "Authorization: Bearer $OPENAI_API_KEY" \
-d '{
"input": "Your text string goes here",
"model": "text-embedding-3-small"
}'La réponse contient le vecteur de plongement (une liste de nombres à virgule flottante) ainsi que des métadonnées. Vous pouvez extraire ce vecteur, l’enregistrer dans une base de données vectorielle et l’utiliser dans de nombreuses applications.
123456789101112131415161718{
  "object": "list",
  "data": [
    {
      "object": "embedding",
      "index": 0,
      "embedding": [
        -0.006929283495992422, -0.005336422007530928, -4.547132266452536e-5,
        -0.024047505110502243
      ]
    }
  ],
  "model": "text-embedding-3-small",
  "usage": {
    "prompt_tokens": 5,
    "total_tokens": 5
  }
}
Par défaut, le vecteur comporte 1536 dimensions pour text-embedding-3-small ou 3072 pour text-embedding-3-large. Pour réduire le nombre de dimensions tout en préservant la capacité du vecteur à représenter des concepts, utilisez le paramètre dimensions. Vous trouverez plus de détails sur les dimensions dans la section consacrée aux cas d’usage.
Modèles de plongement vectoriel
OpenAI propose deux modèles de plongement vectoriel performants de troisième génération, reconnaissables à la mention -3 dans leur identifiant. Consultez l’article annonçant les modèles de troisième génération pour en savoir plus.
L’utilisation est facturée par token d’entrée. Le tableau indique combien de pages de texte vous pouvez traiter pour un dollar américain, à raison d’environ 800 tokens par page :
| Modèle | Pages par dollar (environ) | Résultat à l’évaluation MTEB | Taille maximale de l’entrée (tokens) |
|---|---|---|---|
| text-embedding-3-small | 62 500 | 62,3 % | 8 192 |
| text-embedding-3-large | 9 615 | 64,6 % | 8 192 |
| text-embedding-ada-002 | 12 500 | 61,0 % | 8 192 |
Cas d’usage
Les exemples suivants illustrent plusieurs cas d’usage à partir du jeu de données d’avis sur des produits alimentaires vendus sur Amazon.
Obtention des plongements vectoriels
Le jeu de données contient 568 454 avis sur des produits alimentaires publiés par des utilisateurs d’Amazon jusqu’en octobre 2012. Pour cet exemple, nous retenons les 1 000 avis les plus récents. Rédigés en anglais, ces avis tendent à exprimer une opinion positive ou négative. Chaque avis comporte un identifiant de produit (ProductId), un identifiant d’utilisateur (UserId), une note (Score), un titre (Summary) et le texte de l’avis (Text). Par exemple :
| Identifiant du produit | Identifiant de l’utilisateur | Note | Titre | Texte |
|---|---|---|---|---|
| B001E4KFG0 | A3SGXH7AUHU8GW | 5 | Good Quality Dog Food | I have bought several of the Vitality canned… |
| B00813GRG4 | A1D87F6ZCVE5NK | 1 | Not as Advertised | Product arrived labeled as Jumbo Salted Peanut… |
Dans l’exemple ci-dessous, nous réunissons le titre et le corps de chaque avis en un seul texte. Le modèle encode ce texte et produit un seul vecteur de plongement.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21import { mkdir, writeFile } from "node:fs/promises";
import OpenAI from "openai";

const client = new OpenAI();
const reviews = ["A rich cup of coffee.", "A bright herbal tea."];

const response = await client.embeddings.create({
  model: "text-embedding-3-small",
  input: reviews.map((review) => review.replaceAll("\n", " ")),
});

const csvField = (value) => `"${value.replaceAll('"', '""')}"`;
const rows = response.data.map(({ embedding }, index) =>
  [csvField(reviews[index]), csvField(JSON.stringify(embedding))].join(",")
);

await mkdir("output", { recursive: true });
await writeFile(
  "output/embedded_1k_reviews.csv",
  ["combined,ada_embedding", ...rows].join("\n") + "\n"
);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17from pathlib import Path
from openai import OpenAI
client = OpenAI()
def get_embedding(text, model="text-embedding-3-small"):
text = text.replace("\n", " ")
return client.embeddings.create(input=[text], model=model).data[0].embedding
df["ada_embedding"] = df.combined.apply(
lambda x: get_embedding(x, model="text-embedding-3-small")
)
Path("output").mkdir(exist_ok=True)
df.to_csv("output/embedded_1k_reviews.csv", index=False)1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68import (
"context"
"encoding/csv"
"encoding/json"
"fmt"
"log"
"os"
"strings"
"github.com/openai/openai-go/v3"
)
func main() {
if err := run(); err != nil {
log.Fatal(err)
}
}
func run() error {
client := openai.NewClient()
ctx := context.Background()
reviews := []string{"A rich cup of coffee.", "A bright herbal tea."}
if err := os.MkdirAll("output", 0755); err != nil {
return err
}
file, err := os.Create("output/embedded_1k_reviews.csv")
if err != nil {
return err
}
defer file.Close()
writer := csv.NewWriter(file)
if err := writer.Write([]string{"combined", "ada_embedding"}); err != nil {
return err
}
for _, review := range reviews {
vector, err := embedding(ctx, &client, strings.ReplaceAll(review, "\n", " "))
if err != nil {
return err
}
encoded, err := json.Marshal(vector)
if err != nil {
return err
}
if err := writer.Write([]string{review, string(encoded)}); err != nil {
return err
}
}
writer.Flush()
if err := writer.Error(); err != nil {
return err
}
if err := file.Close(); err != nil {
return err
}
fmt.Println("Saved output/embedded_1k_reviews.csv")
return nil
}
func embedding(ctx context.Context, client *openai.Client, text string) ([]float64, error) {
response, err := client.Embeddings.New(ctx, openai.EmbeddingNewParams{
Model: openai.EmbeddingModelTextEmbedding3Small,
Input: openai.EmbeddingNewParamsInputUnion{OfString: openai.String(text)},
})
if err != nil {
return nil, err
}
return response.Data[0].Embedding, nil
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
import java.io.IOException;
import java.nio.file.Files;
import java.nio.file.Path;
import java.util.List;
static String csvField(String value) {
return "\"" + value.replace("\"", "\"\"") + "\"";
}
List<String> reviews = List.of("A rich cup of coffee.", "A bright herbal tea.");
Path output = Path.of("output", "embedded_1k_reviews.csv");
Files.createDirectories(output.getParent());
try (var writer = Files.newBufferedWriter(output)) {
writer.write("combined,ada_embedding\n");
for (String review : reviews) {
var embedding =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.inputOfArrayOfStrings(List.of(review.replace("\n", " ")))
.build())
.data()
.get(0)
.embedding();
writer.write(csvField(review) + "," + csvField(embedding.toString()) + "\n");
}
}
System.out.println(output);1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26using System.Text.Json;
using OpenAI.Embeddings;
string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "text-embedding-3-small";
EmbeddingClient client = new(model, key);
string[] reviews = ["A rich cup of coffee.", "A bright herbal tea."];
Directory.CreateDirectory("output");
using StreamWriter writer = new("output/embedded_1k_reviews.csv");
await writer.WriteLineAsync("combined,ada_embedding");
foreach (string review in reviews)
{
float[] vector = await EmbedAsync(client, review.Replace("\n", " ", StringComparison.Ordinal));
string encoded = JsonSerializer.Serialize(vector);
await writer.WriteLineAsync($"{CsvField(review)},{CsvField(encoded)}");
}
Console.WriteLine("Saved output/embedded_1k_reviews.csv");
static async Task<float[]> EmbedAsync(EmbeddingClient client, string text)
{
OpenAIEmbedding result = await client.GenerateEmbeddingAsync(text);
return result.ToFloats().ToArray();
}
static string CsvField(string value) => "\"" + value.Replace("\"", "\"\"", StringComparison.Ordinal) + "\"";1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20require "csv"
require "fileutils"
require "json"
require "openai"
client = OpenAI::Client.new
reviews = ["A rich cup of coffee.", "A bright herbal tea."]
response = client.embeddings.create(
model: "text-embedding-3-small",
input: reviews.map { |review| review.tr("\n", " ") }
)
FileUtils.mkdir_p("output")
CSV.open("output/embedded_1k_reviews.csv", "w") do |csv|
csv << ["combined", "ada_embedding"]
response.data.each do |embedding|
csv << [reviews.fetch(embedding.index), JSON.generate(embedding.embedding)]
end
endPour charger les données à partir d’un fichier enregistré, exécutez le code suivant :
1
2
3
4
5from ast import literal_eval
import pandas as pd

df = pd.read_csv("output/embedded_1k_reviews.csv")
df["ada_embedding"] = df.ada_embedding.apply(literal_eval).apply(np.array)Les vecteurs de grande dimension coûtent généralement plus cher et nécessitent davantage de calcul, de mémoire et d’espace de stockage que les vecteurs de petite dimension. C’est le cas, par exemple, lorsqu’on les conserve dans une base vectorielle pour effectuer des recherches.
Nous avons entraîné nos deux nouveaux modèles de plongement avec une technique qui permet aux développeurs de choisir un compromis entre performances et coût d’utilisation. Le paramètre dimensions de l’API permet de raccourcir les vecteurs (en supprimant les dernières composantes) tout en préservant leur capacité à représenter des concepts. Par exemple, dans l’évaluation MTEB, un vecteur produit par text-embedding-3-large et ramené à 256 dimensions reste plus performant qu’un vecteur produit par text-embedding-ada-002 avec ses 1 536 dimensions d’origine. Notre article sur le lancement des modèles de plongement de troisième génération détaille l’effet du nombre de dimensions sur les performances.
En règle générale, nous recommandons de définir le paramètre dimensions lors de la création du vecteur. Dans certains cas, vous devrez modifier le nombre de dimensions après sa génération. Si vous le faites manuellement, veillez à normaliser le vecteur obtenu, comme dans l’exemple suivant.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17import OpenAI from "openai";

const client = new OpenAI();

const response = await client.embeddings.create({
  model: "text-embedding-3-small",
  input: "Testing 123",
  encoding_format: "float",
});

const shortened = response.data[0].embedding.slice(0, 256);
const magnitude = Math.hypot(...shortened);
const normalized = shortened.map((value) =>
  magnitude === 0 ? 0 : value / magnitude
);

console.log(normalized);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26from openai import OpenAI
import numpy as np
client = OpenAI()
def normalize_l2(x):
x = np.array(x)
if x.ndim == 1:
norm = np.linalg.norm(x)
if norm == 0:
return x
return x / norm
else:
norm = np.linalg.norm(x, 2, axis=1, keepdims=True)
return np.where(norm == 0, x, x / norm)
response = client.embeddings.create(
model="text-embedding-3-small", input="Testing 123", encoding_format="float"
)
cut_dim = response.data[0].embedding[:256]
norm_dim = normalize_l2(cut_dim)
print(norm_dim)1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
import java.util.List;
private static List<Double> normalizeL2(List<Float> embedding) {
double norm =
Math.sqrt(embedding.stream().mapToDouble(value -> value.doubleValue() * value).sum());
return embedding.stream().map(value -> norm == 0 ? 0.0 : value / norm).toList();
}
var embedding =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.input("Testing 123")
.encodingFormat(EmbeddingCreateParams.EncodingFormat.FLOAT)
.build());
List<Float> shortened = embedding.data().get(0).embedding().subList(0, 256);
System.out.println(normalizeL2(shortened));1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16using OpenAI.Embeddings;
string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "text-embedding-3-small";
EmbeddingClient client = new(model, key);
OpenAIEmbedding embedding = await client.GenerateEmbeddingAsync("Testing 123");
float[] shortened = embedding.ToFloats().Span[..256].ToArray();
double magnitude = Math.Sqrt(shortened.Sum(value => (double)value * value));
double[] normalized =
magnitude == 0
? shortened.Select(value => (double)value).ToArray()
: shortened.Select(value => value / magnitude).ToArray();
Console.WriteLine(System.Text.Json.JsonSerializer.Serialize(normalized));1
2
3
4
5
6
7
8
9
10
11
12
13
14
15require "openai"
client = OpenAI::Client.new
response = client.embeddings.create(
model: "text-embedding-3-small",
input: "Testing 123",
encoding_format: :float
)
shortened = response.data.fetch(0).embedding.first(256)
magnitude = Math.sqrt(shortened.sum { |value| value**2 })
normalized = shortened.map { |value| magnitude.zero? ? 0 : value / magnitude }
puts(normalized)La possibilité d’ajuster le nombre de dimensions offre une grande souplesse. Par exemple, si votre base de données vectorielle accepte au plus 1 024 dimensions, vous pouvez tout de même utiliser notre modèle le plus performant, text-embedding-3-large. Fixez le paramètre dimensions de l’API à 1 024 pour ramener le vecteur de 3 072 à 1 024 dimensions, au prix d’une légère perte de précision.
Il arrive souvent que les données d’entraînement du modèle ne contiennent pas certaines informations essentielles dont vous souhaitez qu’il dispose pour répondre à une question. Comme le montre l’exemple ci-dessous, une solution consiste à ajouter ces informations dans la fenêtre de contexte du modèle. Cette approche fonctionne dans de nombreux cas, mais augmente le coût en tokens. Dans ce notebook, nous examinons les avantages et les inconvénients de cette approche et de la recherche par plongements vectoriels.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25import OpenAI from "openai";

const client = new OpenAI();
const article =
  "At the 2022 Winter Olympics, Great Britain won women's curling and Sweden won men's curling.";
const question = `Use the article below to answer the question. If the answer cannot be found, say "I don't know."

Article:
${article}

Question: Which athletes won the gold medal in curling at the 2022 Winter Olympics?`;

const response = await client.chat.completions.create({
  model: "gpt-4.1-mini",
  messages: [
    {
      role: "system",
      content: "You answer questions about the 2022 Winter Olympics.",
    },
    { role: "user", content: question },
  ],
  temperature: 0,
});

console.log(response.choices[0].message.content);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22query = f"""Use the below article on the 2022 Winter Olympics to answer the subsequent question. If the answer cannot be found, write "I don't know."
Article:
\"\"\"
{wikipedia_article_on_curling}
\"\"\"
Question: Which athletes won the gold medal in curling at the 2022 Winter Olympics?"""
response = client.chat.completions.create(
messages=[
{
"role": "system",
"content": "You answer questions about the 2022 Winter Olympics.",
},
{"role": "user", "content": query},
],
model=GPT_MODEL,
temperature=0,
)
print(response.choices[0].message.content)1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27import (
"context"
"fmt"
"log"
"github.com/openai/openai-go/v3"
)
func main() {
if err := run(); err != nil {
log.Fatal(err)
}
}
func run() error {
client := openai.NewClient()
completion, err := client.Chat.Completions.New(context.Background(), openai.ChatCompletionNewParams{
Model: "gpt-4.1-mini", Temperature: openai.Float(0), Messages: []openai.ChatCompletionMessageParamUnion{
openai.SystemMessage("You answer questions about the 2022 Winter Olympics."),
openai.UserMessage("Use the article to answer the question. If the answer cannot be found, write \"I don't know.\"\n\nArticle: At the 2022 Winter Olympics, Great Britain won women's curling and Sweden won men's curling.\n\nQuestion: Which athletes won the gold medal in curling at the 2022 Winter Olympics?")},
})
if err != nil {
return err
}
fmt.Println(completion.Choices[0].Message.Content)
return nil
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.chat.completions.ChatCompletionCreateParams;
String article =
"At the 2022 Winter Olympics, Great Britain won women's curling and Sweden won men's curling.";
String question =
"Use the below article on the 2022 Winter Olympics to answer the subsequent question. "
+ "If the answer cannot be found, write \"I don't know.\"\n\n"
+ "Article:\n"
+ article
+ "\n\nQuestion: Which athletes won the gold medal in curling at the 2022 Winter Olympics?";
ChatCompletionCreateParams params =
ChatCompletionCreateParams.builder()
.model("gpt-4.1-mini")
.addSystemMessage("You answer questions about the 2022 Winter Olympics.")
.addUserMessage(question)
.temperature(0)
.build();
client.chat().completions().create(params).choices().stream()
.flatMap(choice -> choice.message().content().stream())
.forEach(System.out::println);1
2
3
4
5
6
7
8
9
10
11
12using OpenAI.Chat;
string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "gpt-4.1-mini";
ChatClient client = new(model, key);
string article = "At the 2022 Winter Olympics, Great Britain won women's curling and Sweden won men's curling.";
string query = $"Use the article to answer the question. If the answer cannot be found, write I don't know.\nArticle: {article}\nQuestion: Which athletes won the gold medal in curling at the 2022 Winter Olympics?";
ChatCompletion result = await client.CompleteChatAsync(
[new SystemChatMessage("You answer questions about the 2022 Winter Olympics."), new UserChatMessage(query)],
new ChatCompletionOptions { Temperature = 0 });
Console.WriteLine(result.Content[0].Text);1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29require "openai"
client = OpenAI::Client.new
article = "At the 2022 Winter Olympics, Great Britain won women's curling and Sweden won men's curling."
question = <<~QUESTION
Use the article below to answer the question. If the answer cannot be found, say "I don't know."
Article:
#{article}
Question: Which athletes won the gold medal in curling at the 2022 Winter Olympics?
QUESTION
response = client.chat.completions.create(
model: "gpt-4.1-mini",
messages: [
{
role: :system,
content: "You answer questions about the 2022 Winter Olympics."
},
{
role: :user,
content: question
}
],
temperature: 0
)
puts(response.choices.fetch(0).message.content)Pour retrouver les documents les plus pertinents, nous calculons la similarité cosinus entre le vecteur de la requête et celui de chaque document, puis nous renvoyons les documents qui obtiennent les scores les plus élevés.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32import OpenAI from "openai";

const client = new OpenAI();
const reviews = [
  "A rich cup of coffee.",
  "Smooth beans in tomato sauce.",
  "Dark chocolate with orange.",
];

const { data } = await client.embeddings.create({
  model: "text-embedding-3-small",
  input: [...reviews, "delicious beans"],
});

const query = data.at(-1).embedding;
const similarity = (embedding) => {
  const dotProduct = embedding.reduce(
    (total, value, index) => total + value * query[index],
    0
  );
  return dotProduct / (Math.hypot(...embedding) * Math.hypot(...query));
};

const results = reviews
  .map((review, index) => ({
    review,
    score: similarity(data[index].embedding),
  }))
  .sort((left, right) => right.score - left.score)
  .slice(0, 3);

console.log(results);
1
2
3
4
5
6
7
8
9
10def search_reviews(df, product_description, n=3, pprint=True):
embedding = get_embedding(product_description, model="text-embedding-3-small")
df["similarities"] = df.ada_embedding.apply(
lambda x: cosine_similarity(x, embedding)
)
res = df.sort_values("similarities", ascending=False).head(n)
return res
res = search_reviews(df, "delicious beans", n=3)1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73import (
"context"
"fmt"
"log"
"math"
"sort"
"github.com/openai/openai-go/v3"
)
func main() {
if err := run(); err != nil {
log.Fatal(err)
}
}
func run() error {
client := openai.NewClient()
ctx := context.Background()
texts := []string{"A rich cup of coffee.", "Crunchy crackers with sea salt.", "Dark chocolate with orange.", "A bright herbal tea.", "Smooth beans in tomato sauce.", "A mild cheese with herbs.", "Spicy roasted nuts.", "A crisp sparkling water."}
vectors := make([][]float64, len(texts))
for i, text := range texts {
vector, err := embedding(ctx, &client, text)
if err != nil {
return err
}
vectors[i] = vector
}
query, err := embedding(ctx, &client, "delicious beans")
if err != nil {
return err
}
matches := nearest(query, vectors)
for _, match := range matches[:min(3, len(matches))] {
fmt.Printf("%0.3f: %s\n", match.Similarity, texts[match.Index])
}
return nil
}
func embedding(ctx context.Context, client *openai.Client, text string) ([]float64, error) {
response, err := client.Embeddings.New(ctx, openai.EmbeddingNewParams{
Model: openai.EmbeddingModelTextEmbedding3Small,
Input: openai.EmbeddingNewParamsInputUnion{OfString: openai.String(text)},
})
if err != nil {
return nil, err
}
return response.Data[0].Embedding, nil
}
func cosineSimilarity(a, b []float64) float64 {
var dot, left, right float64
for i := range a {
dot += a[i] * b[i]
left += a[i] * a[i]
right += b[i] * b[i]
}
return dot / math.Sqrt(left*right)
}
type match struct {
Index int
Similarity float64
}
func nearest(query []float64, vectors [][]float64) []match {
matches := make([]match, len(vectors))
for i, vector := range vectors {
matches[i] = match{Index: i, Similarity: cosineSimilarity(query, vector)}
}
sort.SliceStable(matches, func(i, j int) bool { return matches[i].Similarity > matches[j].Similarity })
return matches
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
import java.util.Comparator;
import java.util.List;
import java.util.stream.IntStream;
List<String> reviews =
List.of(
"A rich cup of coffee.",
"Smooth beans in tomato sauce.",
"Dark chocolate with orange.");
var reviewEmbeddings =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.inputOfArrayOfStrings(reviews)
.build())
.data();
List<Float> query =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.inputOfArrayOfStrings(List.of("delicious beans"))
.build())
.data()
.get(0)
.embedding();
IntStream.range(0, reviews.size())
.boxed()
.sorted(
Comparator.comparingDouble(
(Integer index) ->
cosineSimilarity(query, reviewEmbeddings.get(index).embedding()))
.reversed())
.limit(3)
.map(reviews::get)
.forEach(System.out::println);1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33using OpenAI.Embeddings;
string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "text-embedding-3-small";
EmbeddingClient client = new(model, key);
string[] texts = ["A rich cup of coffee.", "Crunchy crackers with sea salt.", "Dark chocolate with orange.", "A bright herbal tea.", "Smooth beans in tomato sauce.", "A mild cheese with herbs.", "Spicy roasted nuts.", "A crisp sparkling water."];
OpenAIEmbeddingCollection batch = await client.GenerateEmbeddingsAsync(texts);
float[][] vectors = batch.Select(item => item.ToFloats().ToArray()).ToArray();
float[] query = await EmbedAsync(client, "delicious beans");
var ranked = vectors.Select((vector, index) => new { Index = index, Similarity = CosineSimilarity(query, vector) }).OrderByDescending(match => match.Similarity);
foreach (var match in ranked.Take(3))
{
Console.WriteLine($"{match.Similarity:F3}: {texts[match.Index]}");
}
static async Task<float[]> EmbedAsync(EmbeddingClient client, string text)
{
OpenAIEmbedding result = await client.GenerateEmbeddingAsync(text);
return result.ToFloats().ToArray();
}
static double CosineSimilarity(float[] left, float[] right)
{
double dot = 0, leftNorm = 0, rightNorm = 0;
for (int i = 0; i < left.Length; i++)
{
dot += (double)left[i] * right[i];
leftNorm += (double)left[i] * left[i];
rightNorm += (double)right[i] * right[i];
}
return dot / Math.Sqrt(leftNorm * rightNorm);
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30require "openai"
client = OpenAI::Client.new
reviews = [
"A rich cup of coffee.",
"Smooth beans in tomato sauce.",
"Dark chocolate with orange."
]
response = client.embeddings.create(
model: "text-embedding-3-small",
input: reviews + ["delicious beans"]
)
query = response.data.fetch(-1).embedding
similarity = lambda do |embedding|
dot_product = embedding.zip(query).sum { |value, query_value| value * query_value }
magnitude = Math.sqrt(embedding.sum { |value| value**2 })
query_magnitude = Math.sqrt(query.sum { |value| value**2 })
dot_product / (magnitude * query_magnitude)
end
results = reviews.map.with_index do |review, index|
{
review: review,
score: similarity.call(response.data.fetch(index).embedding)
}
end.sort_by { |result| -result.fetch(:score) }.first(3)
puts(results)La recherche de code fonctionne sur le même principe que la recherche de texte par plongements vectoriels. Nous proposons une méthode pour extraire les fonctions Python de tous les fichiers Python d’un dépôt donné. Nous indexons ensuite chaque fonction à l’aide du modèle text-embedding-3-small.
Pour rechercher du code, nous utilisons le même modèle pour obtenir le vecteur de la requête formulée en langage naturel. Nous calculons ensuite la similarité cosinus entre ce vecteur et celui de chaque fonction. Les fonctions dont la similarité cosinus est la plus élevée sont les plus pertinentes.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30import OpenAI from "openai";

const client = new OpenAI();
const functions = [
  "function add(a, b) { return a + b; }",
  "function complete(prompt) { return prompt; }",
];

const { data } = await client.embeddings.create({
  model: "text-embedding-3-small",
  input: [...functions, "Completions API tests"],
});

const query = data.at(-1).embedding;
const similarity = (embedding) => {
  const dotProduct = embedding.reduce(
    (total, value, index) => total + value * query[index],
    0
  );
  return dotProduct / (Math.hypot(...embedding) * Math.hypot(...query));
};

const results = functions
  .map((source, index) => ({
    source,
    score: similarity(data[index].embedding),
  }))
  .sort((left, right) => right.score - left.score);

console.log(results);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16df["code_embedding"] = df["code"].apply(
lambda x: get_embedding(x, model="text-embedding-3-small")
)
def search_functions(df, code_query, n=3, pprint=True, n_lines=7):
embedding = get_embedding(code_query, model="text-embedding-3-small")
df["similarities"] = df.code_embedding.apply(
lambda x: cosine_similarity(x, embedding)
)
res = df.sort_values("similarities", ascending=False).head(n)
return res
res = search_functions(df, "Completions API tests", n=3)1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73import (
"context"
"fmt"
"log"
"math"
"sort"
"github.com/openai/openai-go/v3"
)
func main() {
if err := run(); err != nil {
log.Fatal(err)
}
}
func run() error {
client := openai.NewClient()
ctx := context.Background()
texts := []string{"def add(a, b): return a + b", "def complete(prompt): return prompt"}
vectors := make([][]float64, len(texts))
for i, text := range texts {
vector, err := embedding(ctx, &client, text)
if err != nil {
return err
}
vectors[i] = vector
}
query, err := embedding(ctx, &client, "Completions API tests")
if err != nil {
return err
}
matches := nearest(query, vectors)
for _, match := range matches[:min(3, len(matches))] {
fmt.Printf("%0.3f: %s\n", match.Similarity, texts[match.Index])
}
return nil
}
func embedding(ctx context.Context, client *openai.Client, text string) ([]float64, error) {
response, err := client.Embeddings.New(ctx, openai.EmbeddingNewParams{
Model: openai.EmbeddingModelTextEmbedding3Small,
Input: openai.EmbeddingNewParamsInputUnion{OfString: openai.String(text)},
})
if err != nil {
return nil, err
}
return response.Data[0].Embedding, nil
}
func cosineSimilarity(a, b []float64) float64 {
var dot, left, right float64
for i := range a {
dot += a[i] * b[i]
left += a[i] * a[i]
right += b[i] * b[i]
}
return dot / math.Sqrt(left*right)
}
type match struct {
Index int
Similarity float64
}
func nearest(query []float64, vectors [][]float64) []match {
matches := make([]match, len(vectors))
for i, vector := range vectors {
matches[i] = match{Index: i, Similarity: cosineSimilarity(query, vector)}
}
sort.SliceStable(matches, func(i, j int) bool { return matches[i].Similarity > matches[j].Similarity })
return matches
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
import java.util.Comparator;
import java.util.List;
import java.util.stream.IntStream;
List<String> functions =
List.of("def add(a, b): return a + b", "def complete(prompt): return prompt");
var functionEmbeddings =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.inputOfArrayOfStrings(functions)
.build())
.data();
List<Float> query =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.input("Completions API tests")
.build())
.data()
.get(0)
.embedding();
IntStream.range(0, functions.size())
.boxed()
.sorted(
Comparator.comparingDouble(
(Integer index) ->
cosineSimilarity(query, functionEmbeddings.get(index).embedding()))
.reversed())
.map(functions::get)
.forEach(System.out::println);1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36using OpenAI.Embeddings;
string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "text-embedding-3-small";
EmbeddingClient client = new(model, key);
string[] texts = ["def add(a, b): return a + b", "def complete(prompt): return prompt"];
List<float[]> vectors = [];
foreach (string text in texts)
{
vectors.Add(await EmbedAsync(client, text));
}
float[] query = await EmbedAsync(client, "Completions API tests");
var ranked = vectors.Select((vector, index) => new { Index = index, Similarity = CosineSimilarity(query, vector) }).OrderByDescending(match => match.Similarity);
foreach (var match in ranked.Take(3))
{
Console.WriteLine($"{match.Similarity:F3}: {texts[match.Index]}");
}
static async Task<float[]> EmbedAsync(EmbeddingClient client, string text)
{
OpenAIEmbedding result = await client.GenerateEmbeddingAsync(text);
return result.ToFloats().ToArray();
}
static double CosineSimilarity(float[] left, float[] right)
{
double dot = 0, leftNorm = 0, rightNorm = 0;
for (int i = 0; i < left.Length; i++)
{
dot += (double)left[i] * right[i];
leftNorm += (double)left[i] * left[i];
rightNorm += (double)right[i] * right[i];
}
return dot / Math.Sqrt(leftNorm * rightNorm);
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29require "openai"
client = OpenAI::Client.new
functions = [
"function add(a, b) { return a + b; }",
"function complete(prompt) { return prompt; }"
]
response = client.embeddings.create(
model: "text-embedding-3-small",
input: functions + ["Completions API tests"]
)
query = response.data.fetch(-1).embedding
similarity = lambda do |embedding|
dot_product = embedding.zip(query).sum { |value, query_value| value * query_value }
magnitude = Math.sqrt(embedding.sum { |value| value**2 })
query_magnitude = Math.sqrt(query.sum { |value| value**2 })
dot_product / (magnitude * query_magnitude)
end
results = functions.map.with_index do |source, index|
{
source: source,
score: similarity.call(response.data.fetch(index).embedding)
}
end.sort_by { |result| -result.fetch(:score) }
puts(results)Plus la distance entre deux vecteurs de plongement est faible, plus les éléments correspondants se ressemblent. On peut exploiter cette propriété pour formuler des recommandations.
L’exemple ci-dessous illustre un système de recommandation simple. Il prend en entrée une liste de chaînes de caractères et une chaîne « source », calcule leurs vecteurs de plongement, puis classe les chaînes de la plus proche à la plus éloignée de la source. Le notebook indiqué ci-dessus applique une variante de cette fonction au jeu de données d’articles de presse AG. À partir d’un échantillon de 2 000 descriptions d’articles, elle renvoie les cinq articles les plus proches d’un article source donné.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28import OpenAI from "openai";

const client = new OpenAI();
const strings = [
  "A cheetah is a fast land animal.",
  "A peregrine falcon is a fast bird.",
  "A tortoise moves slowly.",
];

const { data } = await client.embeddings.create({
  model: "text-embedding-3-small",
  input: strings,
});

const query = data[0].embedding;
const recommendations = data
  .map(({ embedding }, index) => {
    const dotProduct = embedding.reduce(
      (total, value, dimension) => total + value * query[dimension],
      0
    );
    const similarity =
      dotProduct / (Math.hypot(...embedding) * Math.hypot(...query));
    return { index, text: strings[index], similarity };
  })
  .sort((left, right) => right.similarity - left.similarity);

console.log(recommendations);
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23def recommendations_from_strings(
strings: list[str],
index_of_source_string: int,
model="text-embedding-3-small",
) -> list[int]:
"""Return nearest neighbors of a given string."""
# get embeddings for all strings
embeddings = [embedding_from_string(string, model=model) for string in strings]
# get the embedding of the source string
query_embedding = embeddings[index_of_source_string]
# get distances between the source embedding and other embeddings (function from embeddings_utils.py)
distances = distances_from_embeddings(
query_embedding, embeddings, distance_metric="cosine"
)
# get indices of nearest neighbors (function from embeddings_utils.py)
indices_of_nearest_neighbors = indices_of_nearest_neighbors_from_distances(
distances
)
return indices_of_nearest_neighbors1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70import (
"context"
"fmt"
"log"
"math"
"sort"
"github.com/openai/openai-go/v3"
)
func main() {
if err := run(); err != nil {
log.Fatal(err)
}
}
func run() error {
client := openai.NewClient()
ctx := context.Background()
texts := []string{"A cheetah is a fast land animal.", "A peregrine falcon is a fast bird.", "A tortoise moves slowly."}
vectors := make([][]float64, len(texts))
for i, text := range texts {
vector, err := embedding(ctx, &client, text)
if err != nil {
return err
}
vectors[i] = vector
}
query := vectors[0]
matches := nearest(query, vectors)
for _, match := range matches {
fmt.Println(match.Index)
}
return nil
}
func embedding(ctx context.Context, client *openai.Client, text string) ([]float64, error) {
response, err := client.Embeddings.New(ctx, openai.EmbeddingNewParams{
Model: openai.EmbeddingModelTextEmbedding3Small,
Input: openai.EmbeddingNewParamsInputUnion{OfString: openai.String(text)},
})
if err != nil {
return nil, err
}
return response.Data[0].Embedding, nil
}
func cosineSimilarity(a, b []float64) float64 {
var dot, left, right float64
for i := range a {
dot += a[i] * b[i]
left += a[i] * a[i]
right += b[i] * b[i]
}
return dot / math.Sqrt(left*right)
}
type match struct {
Index int
Similarity float64
}
func nearest(query []float64, vectors [][]float64) []match {
matches := make([]match, len(vectors))
for i, vector := range vectors {
matches[i] = match{Index: i, Similarity: cosineSimilarity(query, vector)}
}
sort.SliceStable(matches, func(i, j int) bool { return matches[i].Similarity > matches[j].Similarity })
return matches
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
import java.util.Comparator;
import java.util.List;
import java.util.stream.IntStream;
List<String> strings =
List.of(
"A cheetah is a fast land animal.",
"A peregrine falcon is a fast bird.",
"A tortoise moves slowly.");
var embeddings =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.inputOfArrayOfStrings(strings)
.build())
.data();
List<Float> query = embeddings.get(0).embedding();
var nearestNeighbors =
IntStream.range(0, embeddings.size())
.boxed()
.sorted(
Comparator.comparingDouble(
(Integer index) -> {
List<Float> candidate = embeddings.get(index).embedding();
double dotProduct = 0;
double queryMagnitude = 0;
double candidateMagnitude = 0;
for (int dimension = 0; dimension < query.size(); dimension++) {
double queryValue = query.get(dimension);
double candidateValue = candidate.get(dimension);
dotProduct += queryValue * candidateValue;
queryMagnitude += queryValue * queryValue;
candidateMagnitude += candidateValue * candidateValue;
}
return 1 - dotProduct / Math.sqrt(queryMagnitude * candidateMagnitude);
}))
.toList();
System.out.println(nearestNeighbors);1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36using OpenAI.Embeddings;
string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "text-embedding-3-small";
EmbeddingClient client = new(model, key);
string[] texts = ["A cheetah is a fast land animal.", "A peregrine falcon is a fast bird.", "A tortoise moves slowly."];
List<float[]> vectors = [];
foreach (string text in texts)
{
vectors.Add(await EmbedAsync(client, text));
}
float[] query = vectors[0];
var ranked = vectors.Select((vector, index) => new { Index = index, Similarity = CosineSimilarity(query, vector) }).OrderByDescending(match => match.Similarity);
foreach (var match in ranked)
{
Console.WriteLine(match.Index);
}
static async Task<float[]> EmbedAsync(EmbeddingClient client, string text)
{
OpenAIEmbedding result = await client.GenerateEmbeddingAsync(text);
return result.ToFloats().ToArray();
}
static double CosineSimilarity(float[] left, float[] right)
{
double dot = 0, leftNorm = 0, rightNorm = 0;
for (int i = 0; i < left.Length; i++)
{
dot += (double)left[i] * right[i];
leftNorm += (double)left[i] * left[i];
rightNorm += (double)right[i] * right[i];
}
return dot / Math.Sqrt(leftNorm * rightNorm);
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31require "openai"
client = OpenAI::Client.new
strings = [
"A cheetah is a fast land animal.",
"A peregrine falcon is a fast bird.",
"A tortoise moves slowly."
]
response = client.embeddings.create(
model: "text-embedding-3-small",
input: strings
)
query = response.data.fetch(0).embedding
similarity = lambda do |embedding|
dot_product = embedding.zip(query).sum { |value, query_value| value * query_value }
magnitude = Math.sqrt(embedding.sum { |value| value**2 })
query_magnitude = Math.sqrt(query.sum { |value| value**2 })
dot_product / (magnitude * query_magnitude)
end
recommendations = response.data.map.with_index do |embedding, index|
{
index: index,
text: strings.fetch(index),
similarity: similarity.call(embedding.embedding)
}
end.sort_by { |recommendation| -recommendation.fetch(:similarity) }
puts(recommendations)La taille des vecteurs de plongement varie selon la complexité du modèle sous-jacent. Pour visualiser ces données de grande dimension, nous utilisons l’algorithme t-SNE pour les projeter en deux dimensions.
Nous attribuons une couleur à chaque avis en fonction du nombre d’étoiles donné par son auteur :
- 1 étoile : rouge
- 2 étoiles : orange foncé
- 3 étoiles : doré
- 4 étoiles : turquoise
- 5 étoiles : vert foncé
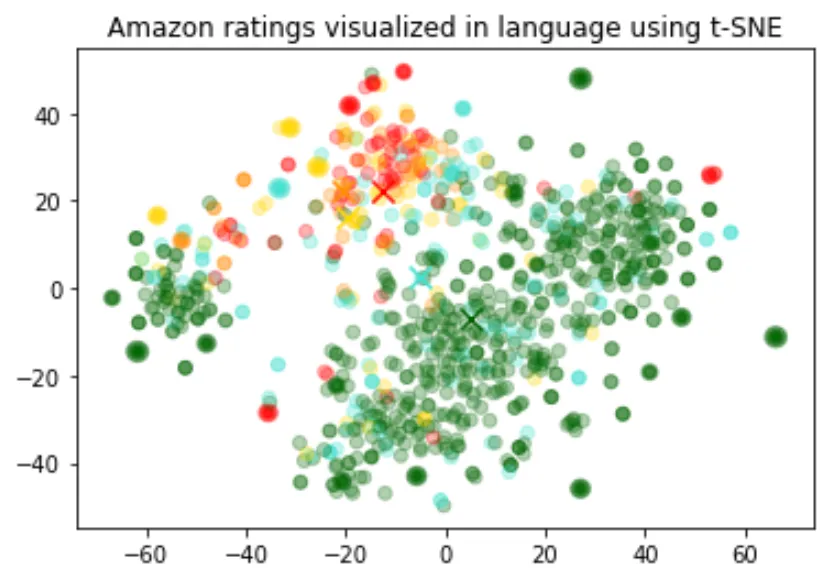
La visualisation semble faire apparaître trois groupes, dont un contient surtout des avis négatifs.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24from ast import literal_eval
import numpy as np
import pandas as pd
from sklearn.manifold import TSNE
import matplotlib.pyplot as plt
import matplotlib

df = pd.read_csv("output/embedded_1k_reviews.csv")
matrix = np.array(df.ada_embedding.apply(literal_eval).to_list())

# Create a t-SNE model and transform the data
tsne = TSNE(
    n_components=2, perplexity=15, random_state=42, init="random", learning_rate=200
)
vis_dims = tsne.fit_transform(matrix)

colors = ["red", "darkorange", "gold", "turquoise", "darkgreen"]
x = [x for x, y in vis_dims]
y = [y for x, y in vis_dims]
color_indices = df.Score.values - 1

colormap = matplotlib.colors.ListedColormap(colors)
plt.scatter(x, y, c=color_indices, cmap=colormap, alpha=0.3)
plt.title("Amazon ratings visualized in language using t-SNE")Un plongement vectoriel permet d’encoder les caractéristiques de tout texte libre pour un modèle d’apprentissage automatique. Si certaines entrées pertinentes sont du texte libre, l’intégration de plongements vectoriels améliore les performances de tout modèle d’apprentissage automatique. Les plongements permettent également d’encoder des caractéristiques catégorielles pour ces modèles. Cette approche est particulièrement utile lorsque les libellés des catégories sont nombreux et porteurs de sens, comme les intitulés de poste. Pour cette tâche, les plongements conçus pour mesurer la similarité donnent généralement de meilleurs résultats que ceux conçus pour la recherche.
Nous avons constaté que les représentations vectorielles concentrent généralement une grande quantité d’informations. Par exemple, réduire le nombre de dimensions des entrées par décomposition en valeurs singulières (SVD) ou par analyse en composantes principales (ACP), ne serait-ce que de 10 %, dégrade généralement les performances sur les tâches spécifiques effectuées ensuite.
Ce code répartit les données entre un jeu d’entraînement et un jeu de test. Nous les utiliserons dans les deux exemples suivants, consacrés à la régression et à la classification.
1
2
3
4
5from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(
    list(df.ada_embedding.values), df.Score, test_size=0.2, random_state=42
)
Régression à partir des caractéristiques vectorielles
Les plongements vectoriels offrent un moyen simple de prédire une valeur numérique. Dans cet exemple, nous prédisons la note en étoiles attribuée par l’auteur d’un avis à partir du texte qu’il a rédigé. Les vecteurs contiennent suffisamment d’informations sémantiques pour que la prédiction soit raisonnablement précise, même avec très peu d’avis.
Nous traitons la note comme une variable continue entre 1 et 5 et autorisons l’algorithme à prédire toute valeur à virgule flottante. L’algorithme d’apprentissage automatique minimise l’écart entre la valeur prédite et la note réelle. Il atteint une erreur absolue moyenne de 0,39, soit un écart moyen inférieur à une demi-étoile.
1
2
3
4
5from sklearn.ensemble import RandomForestRegressor

rfr = RandomForestRegressor(n_estimators=100)
rfr.fit(X_train, y_train)
preds = rfr.predict(X_test)Cette fois, au lieu de demander à l’algorithme de prédire une valeur continue entre 1 et 5, nous cherchons à déterminer le nombre exact d’étoiles en classant chaque avis dans l’une des cinq catégories, de 1 à 5 étoiles.
Après entraînement, le modèle prédit beaucoup mieux les notes de 1 et de 5 étoiles que celles des avis plus nuancés (2 à 4 étoiles), probablement parce que les avis à 1 ou 5 étoiles expriment des opinions plus tranchées.
1
2
3
4
5
6from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report, accuracy_score

clf = RandomForestClassifier(n_estimators=100)
clf.fit(X_train, y_train)
preds = clf.predict(X_test)Les plongements vectoriels permettent d’effectuer une classification zero-shot sans données d’entraînement étiquetées. Pour chaque classe, nous calculons le vecteur de son nom ou d’une brève description. Pour classer un nouveau texte en zero-shot, nous comparons son vecteur à ceux de toutes les classes et retenons la classe dont la similarité est la plus élevée.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21import OpenAI from "openai";

const client = new OpenAI();
const labels = ["negative", "positive"];

const { data } = await client.embeddings.create({
  model: "text-embedding-3-small",
  input: [...labels, "The coffee arrived quickly and tastes great."],
});

const review = data.at(-1).embedding;
const similarity = (embedding) => {
  const dotProduct = embedding.reduce(
    (total, value, index) => total + value * review[index],
    0
  );
  return dotProduct / (Math.hypot(...embedding) * Math.hypot(...review));
};

const [negative, positive] = data.map(({ embedding }) => similarity(embedding));
console.log(positive > negative ? "positive" : "negative");
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18df = df[df.Score != 3]
df["sentiment"] = df.Score.replace(
{1: "negative", 2: "negative", 4: "positive", 5: "positive"}
)
labels = ["negative", "positive"]
label_embeddings = [get_embedding(label, model=model) for label in labels]
def label_score(review_embedding, label_embeddings):
return cosine_similarity(review_embedding, label_embeddings[1]) - cosine_similarity(
review_embedding, label_embeddings[0]
)
prediction = (
"positive" if label_score(get_embedding("Sample Review", model=model), label_embeddings) > 0 else "negative"
)1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59import (
"context"
"fmt"
"log"
"math"
"github.com/openai/openai-go/v3"
)
func main() {
if err := run(); err != nil {
log.Fatal(err)
}
}
func run() error {
client := openai.NewClient()
ctx := context.Background()
negative, err := embedding(ctx, &client, "negative")
if err != nil {
return err
}
positive, err := embedding(ctx, &client, "positive")
if err != nil {
return err
}
review, err := embedding(ctx, &client, "Sample Review")
if err != nil {
return err
}
score := cosineSimilarity(review, positive) - cosineSimilarity(review, negative)
prediction := "negative"
if score > 0 {
prediction = "positive"
}
fmt.Println(prediction)
return nil
}
func embedding(ctx context.Context, client *openai.Client, text string) ([]float64, error) {
response, err := client.Embeddings.New(ctx, openai.EmbeddingNewParams{
Model: openai.EmbeddingModelTextEmbedding3Small,
Input: openai.EmbeddingNewParamsInputUnion{OfString: openai.String(text)},
})
if err != nil {
return nil, err
}
return response.Data[0].Embedding, nil
}
func cosineSimilarity(a, b []float64) float64 {
var dot, left, right float64
for i := range a {
dot += a[i] * b[i]
left += a[i] * a[i]
right += b[i] * b[i]
}
return dot / math.Sqrt(left*right)
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.embeddings.EmbeddingCreateParams;
import java.util.List;
var embeddings =
client
.embeddings()
.create(
EmbeddingCreateParams.builder()
.model("text-embedding-3-small")
.inputOfArrayOfStrings(List.of("negative", "positive", "Sample Review"))
.build())
.data();
List<Float> review = embeddings.get(2).embedding();
double negative = cosineSimilarity(review, embeddings.get(0).embedding());
double positive = cosineSimilarity(review, embeddings.get(1).embedding());
System.out.println(positive > negative ? "positive" : "negative");1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29using OpenAI.Embeddings;
string key = Environment.GetEnvironmentVariable("OPENAI_API_KEY")!;
string model = "text-embedding-3-small";
EmbeddingClient client = new(model, key);
float[] negative = await EmbedAsync(client, "negative");
float[] positive = await EmbedAsync(client, "positive");
float[] review = await EmbedAsync(client, "Sample Review");
double score = CosineSimilarity(review, positive) - CosineSimilarity(review, negative);
Console.WriteLine(score > 0 ? "positive" : "negative");
static async Task<float[]> EmbedAsync(EmbeddingClient client, string text)
{
OpenAIEmbedding result = await client.GenerateEmbeddingAsync(text);
return result.ToFloats().ToArray();
}
static double CosineSimilarity(float[] left, float[] right)
{
double dot = 0, leftNorm = 0, rightNorm = 0;
for (int i = 0; i < left.Length; i++)
{
dot += (double)left[i] * right[i];
leftNorm += (double)left[i] * left[i];
rightNorm += (double)right[i] * right[i];
}
return dot / Math.Sqrt(leftNorm * rightNorm);
}1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22require "openai"
client = OpenAI::Client.new
labels = ["negative", "positive"]
response = client.embeddings.create(
model: "text-embedding-3-small",
input: labels + ["The coffee arrived quickly and tastes great."]
)
review = response.data.fetch(-1).embedding
similarity = lambda do |embedding|
dot_product = embedding.zip(review).sum { |value, review_value| value * review_value }
magnitude = Math.sqrt(embedding.sum { |value| value**2 })
review_magnitude = Math.sqrt(review.sum { |value| value**2 })
dot_product / (magnitude * review_magnitude)
end
negative, positive = response.data.first(2).map do |embedding|
similarity.call(embedding.embedding)
end
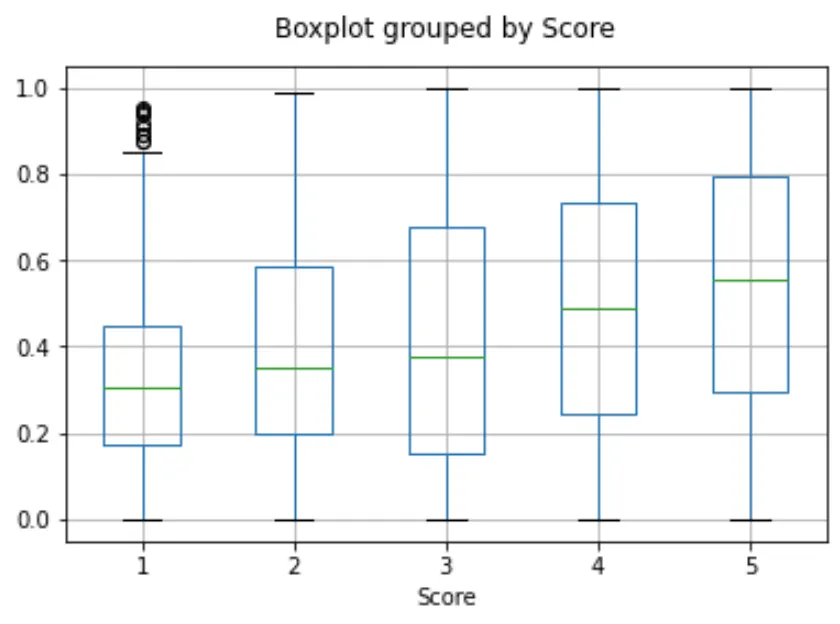
puts((positive > negative) ? "positive" : "negative")Pour obtenir le vecteur d’un utilisateur, nous calculons la moyenne des vecteurs de tous ses avis. De même, le vecteur d’un produit est la moyenne des vecteurs de tous les avis sur ce produit. Pour illustrer l’intérêt de cette approche, nous utilisons un sous-ensemble de 50 000 avis afin de disposer de davantage d’avis par utilisateur et par produit.
Nous évaluons l’utilité de ces vecteurs sur un jeu de test distinct. Nous y représentons la similarité entre le vecteur de l’utilisateur et celui du produit en fonction de la note. Cette approche permet de prédire, avec de meilleurs résultats que le hasard, si un produit plaira à un utilisateur avant même qu’il le reçoive.
user_embeddings = df.groupby("UserId").ada_embedding.apply(np.mean)
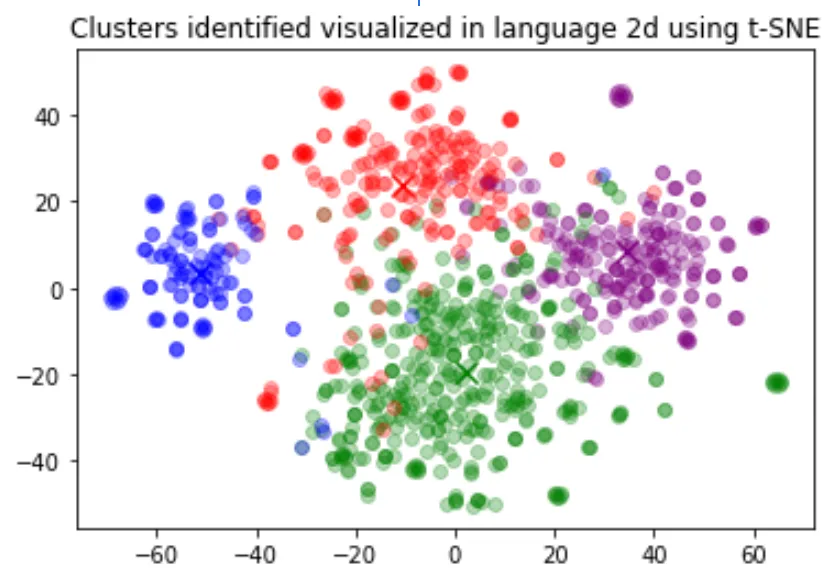
prod_embeddings = df.groupby("ProductId").ada_embedding.apply(np.mean)Le regroupement permet d’interpréter un grand volume de données textuelles. Les plongements vectoriels sont utiles pour cette tâche, car ils représentent le sens de chaque texte sous forme de vecteur. Le regroupement permet ainsi de découvrir, sans supervision, des groupes jusque-là invisibles dans le jeu de données.
Dans cet exemple, nous identifions quatre groupes distincts : l’un porte sur la nourriture pour chiens, un autre rassemble des avis négatifs et les deux derniers rassemblent des avis positifs.
1
2
3
4
5
6
7
8
9import numpy as np
from sklearn.cluster import KMeans

matrix = np.vstack(df.ada_embedding.values)
n_clusters = 4

kmeans = KMeans(n_clusters=n_clusters, init="k-means++", random_state=42)
kmeans.fit(matrix)
df["Cluster"] = kmeans.labels_
FAQ
Comment compter les tokens d’une chaîne avant de calculer son vecteur ?
En Python, vous pouvez découper une chaîne en tokens avec le tokenizer tiktoken d’OpenAI.
Exemple de code :
1
2
3
4
5
6
7
8
9
10
11import tiktoken


def num_tokens_from_string(string: str, encoding_name: str) -> int:
    """Returns the number of tokens in a text string."""
    encoding = tiktoken.get_encoding(encoding_name)
    num_tokens = len(encoding.encode(string))
    return num_tokens


num_tokens_from_string("tiktoken is great!", "cl100k_base")
Pour les modèles de plongement de troisième génération comme text-embedding-3-small, utilisez l’encodage cl100k_base.
Le guide de l’OpenAI Cookbook Compter les tokens avec tiktoken fournit davantage de détails et des exemples de code.
Comment retrouver rapidement les K vecteurs de plongement les plus proches ?
Pour effectuer rapidement une recherche parmi de nombreux vecteurs, nous recommandons d’utiliser une base de données vectorielle. Vous trouverez des exemples d’utilisation de bases de données vectorielles avec l’API OpenAI dans notre Cookbook sur GitHub.
Quelle fonction de distance utiliser ?
Nous recommandons la similarité cosinus. Le choix de la fonction de distance a généralement peu d’incidence.
Les vecteurs de plongement d’OpenAI sont normalisés de façon à avoir une norme égale à 1. Par conséquent :
- Un simple produit scalaire permet de calculer la similarité cosinus un peu plus rapidement.
- La similarité cosinus et la distance euclidienne donnent des classements identiques.
Puis-je partager mes plongements vectoriels en ligne ?
Oui. Les données que les clients envoient à nos modèles et les résultats qu’ils en obtiennent leur appartiennent, y compris dans le cas des plongements vectoriels. Il vous incombe de vérifier que le contenu que vous transmettez à notre API respecte la législation applicable et nos conditions d’utilisation.
Les modèles de plongement V3 connaissent-ils les événements récents ?
Non. Les modèles text-embedding-3-large et text-embedding-3-small n’ont pas connaissance des événements survenus après septembre 2021. Cette limite est généralement moins importante que pour les modèles de génération de texte, mais elle peut réduire les performances dans certains cas particuliers.